Matriz inversa: desfazendo transformações
Compreender a matriz inversa como a operação que desfaz uma transformação, conectando invertibilidade, determinante, sistemas lineares, perda de informação e computação numérica.

Compreender a matriz inversa como a operação que desfaz uma transformação, conectando invertibilidade, determinante, sistemas lineares, perda de informação e computação numérica. Pré-requisito: Aula 07 — Determinante.
Num editor de imagens, você gira uma foto 30°, amplia 2 vezes e aperta Ctrl+Z duas vezes: a foto volta exatamente ao que era. Agora converta a mesma foto para tons de cinza. O Ctrl+Z ainda funciona, mas só porque o editor guardou a original em algum lugar. Com apenas a versão cinza nas mãos, não há conta que devolva as cores: muitos tons diferentes de vermelho, verde e azul viram o mesmo cinza, e a informação que os distinguia sumiu.
As duas operações são transformações. A diferença é que a primeira tem caminho de volta e a segunda não. No artigo anterior da série, o determinante mostrou quando uma matriz esmaga uma dimensão. Aqui entra a operação que percorre o caminho de volta quando ele existe: a matriz inversa, $A^{-1}$.
Ao final, você vai conseguir calcular a inversa de uma matriz 2 × 2 e conferir o resultado; dizer quando ela não existe, pelo determinante, pela geometria e pela perda de informação; usar a inversa para resolver um sistema linear e entender por que, no código, se prefere np.linalg.solve a np.linalg.inv; reconhecer quando uma matriz invertível é, na prática, quase singular; e identificar onde $A^{-1}$ aparece em IA, da distância de Mahalanobis à regressão linear, e onde ela falta, como nos autoencoders.
solve, sem calcular $A^{-1}$, para não somar a esse erro outro que dá para evitar.1. A pergunta central
Nas últimas aulas, uma matriz virou uma regra que transforma uma representação em outra:
$$ x \rightarrow Ax $$
Agora a pergunta se inverte:
É possível desfazer essa transformação e recuperar o vetor original?
Se
$$ y=Ax $$
conhecemos $A$ e $y$, e queremos recuperar $x$. Quando existe uma transformação que desfaz $A$, ela é chamada de matriz inversa:
$$ \boxed{A^{-1}} $$
A ideia mais simples vem dos números. Se uma operação faz $x \rightarrow 2x$, ela é desfeita multiplicando por $1/2$. Com matrizes, queremos a mesma coisa: uma matriz que, aplicada depois de $A$, devolva tudo ao ponto de partida.
$$ \boxed{A^{-1}A=I} $$
Aqui $I$ é a matriz identidade, a transformação que não muda nenhum vetor (Goodfellow, Bengio & Courville, 2016). O caminho completo fica assim:
$$ x\xrightarrow{\;A\;}Ax\xrightarrow{\;A^{-1}\;}x $$
2. Um exemplo para conferir de cabeça
Considere a escala que já apareceu nas Aulas 06 e 07:
$$ A=\begin{bmatrix}2&0\\0&3\end{bmatrix} $$
Ela dobra a componente horizontal e triplica a vertical. A inversa precisa fazer o contrário, dividir a horizontal por 2 e a vertical por 3:
$$ A^{-1}=\begin{bmatrix}1/2&0\\0&1/3\end{bmatrix} $$
Multiplicando as duas, cada fator encontra o seu recíproco e sobra a identidade: $A^{-1}A=I$. Com um vetor concreto,
$$ \begin{aligned}x&=\begin{bmatrix}4\\6\end{bmatrix}\\[4pt]Ax&=\begin{bmatrix}8\\18\end{bmatrix}\\[4pt]A^{-1}(Ax)&=\begin{bmatrix}4\\6\end{bmatrix}\end{aligned} $$
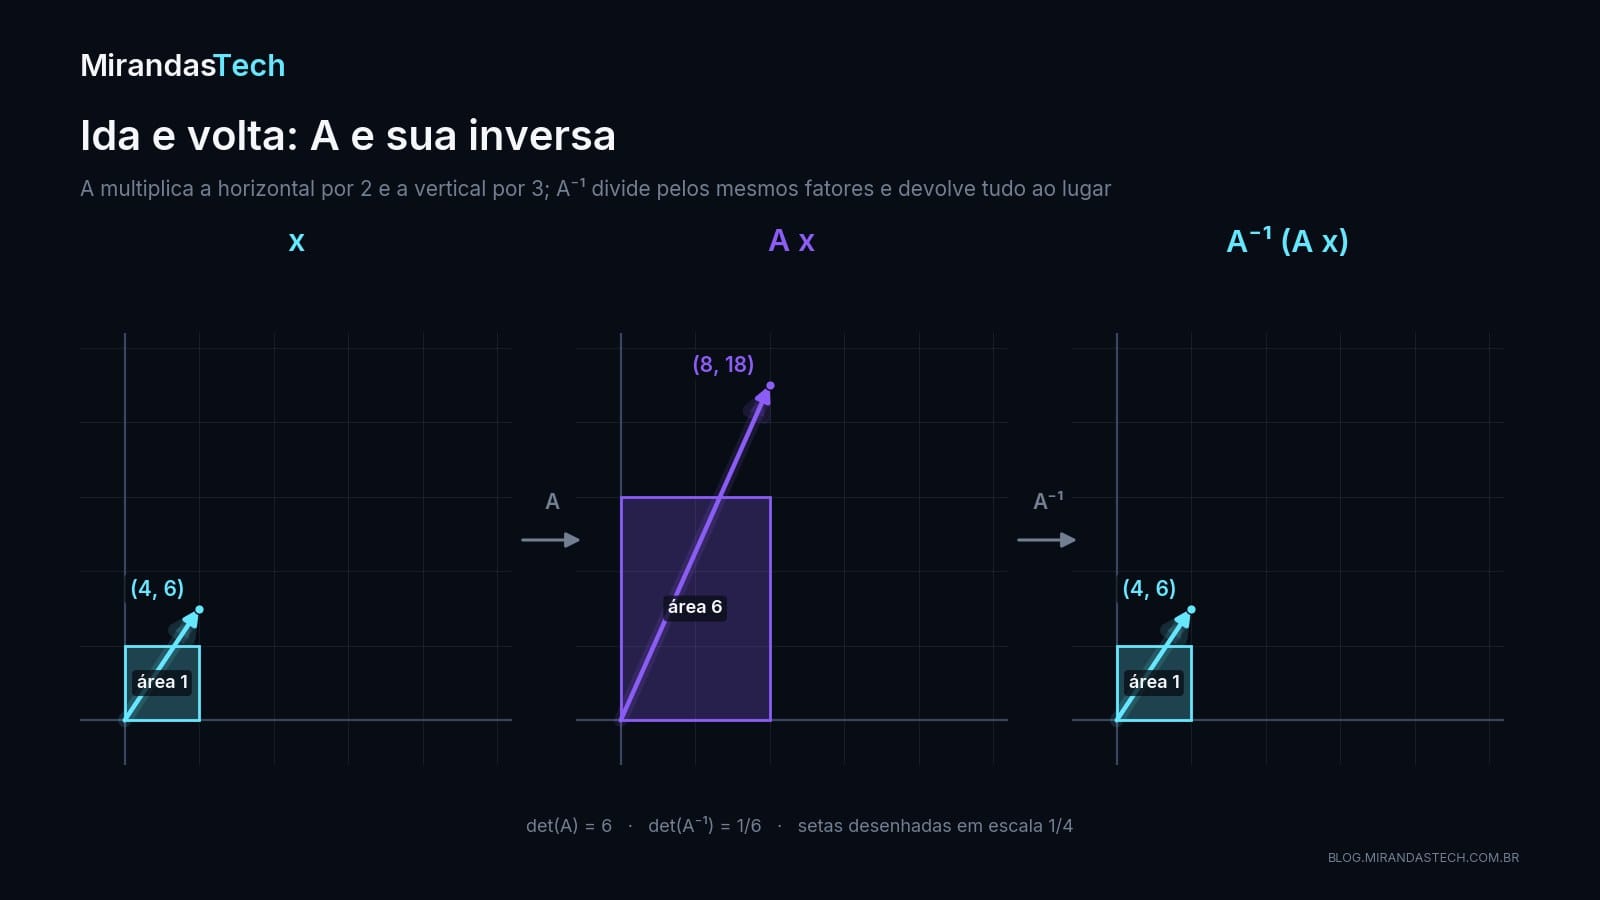
A figura mostra também o que acontece com as áreas. Como $\det(A)=6$, a transformação multiplica áreas por 6, e a inversa precisa dividi-las por 6. A seção 9 mostra que isso vale sempre.
3. Definição formal e quem tem inversa
Uma matriz quadrada $A$ é invertível se existe uma matriz $A^{-1}$ tal que:
$$ \boxed{A^{-1}A=AA^{-1}=I} $$
Quando existe, a inversa é única. Uma matriz que tem inversa também é chamada de regular ou não singular; uma que não tem é singular (Deisenroth, Faisal & Ong, 2020).
Nem toda matriz quadrada tem inversa. Na Aula 07 vimos que $\det(A)=0$ significa que a transformação colapsou alguma dimensão e perdeu informação. Para matrizes quadradas, vale a equivalência (Deisenroth, Faisal & Ong, 2020):
$$ \boxed{A\text{ invertível}\iff\det(A)\neq0} $$
4. Projeção: quando não há caminho de volta
A projeção sobre o eixo horizontal,
$$ P=\begin{bmatrix}1&0\\0&0\end{bmatrix} $$
leva $(x, y)$ a $(x, 0)$: apaga a componente vertical. Então
$$ \begin{bmatrix}3\\2\end{bmatrix}\rightarrow\begin{bmatrix}3\\0\end{bmatrix} \qquad\text{e também}\qquad \begin{bmatrix}3\\500\end{bmatrix}\rightarrow\begin{bmatrix}3\\0\end{bmatrix} $$
Duas entradas diferentes geraram a mesma saída. Se alguém entrega só $(3, 0)$, não há como saber se a entrada era $(3, 2)$, $(3, 500)$ ou qualquer outro ponto da reta vertical $x = 3$. A informação da componente vertical foi destruída, logo $P^{-1}$ não existe. De fato, $\det(P)=1\cdot0-0\cdot0=0$.
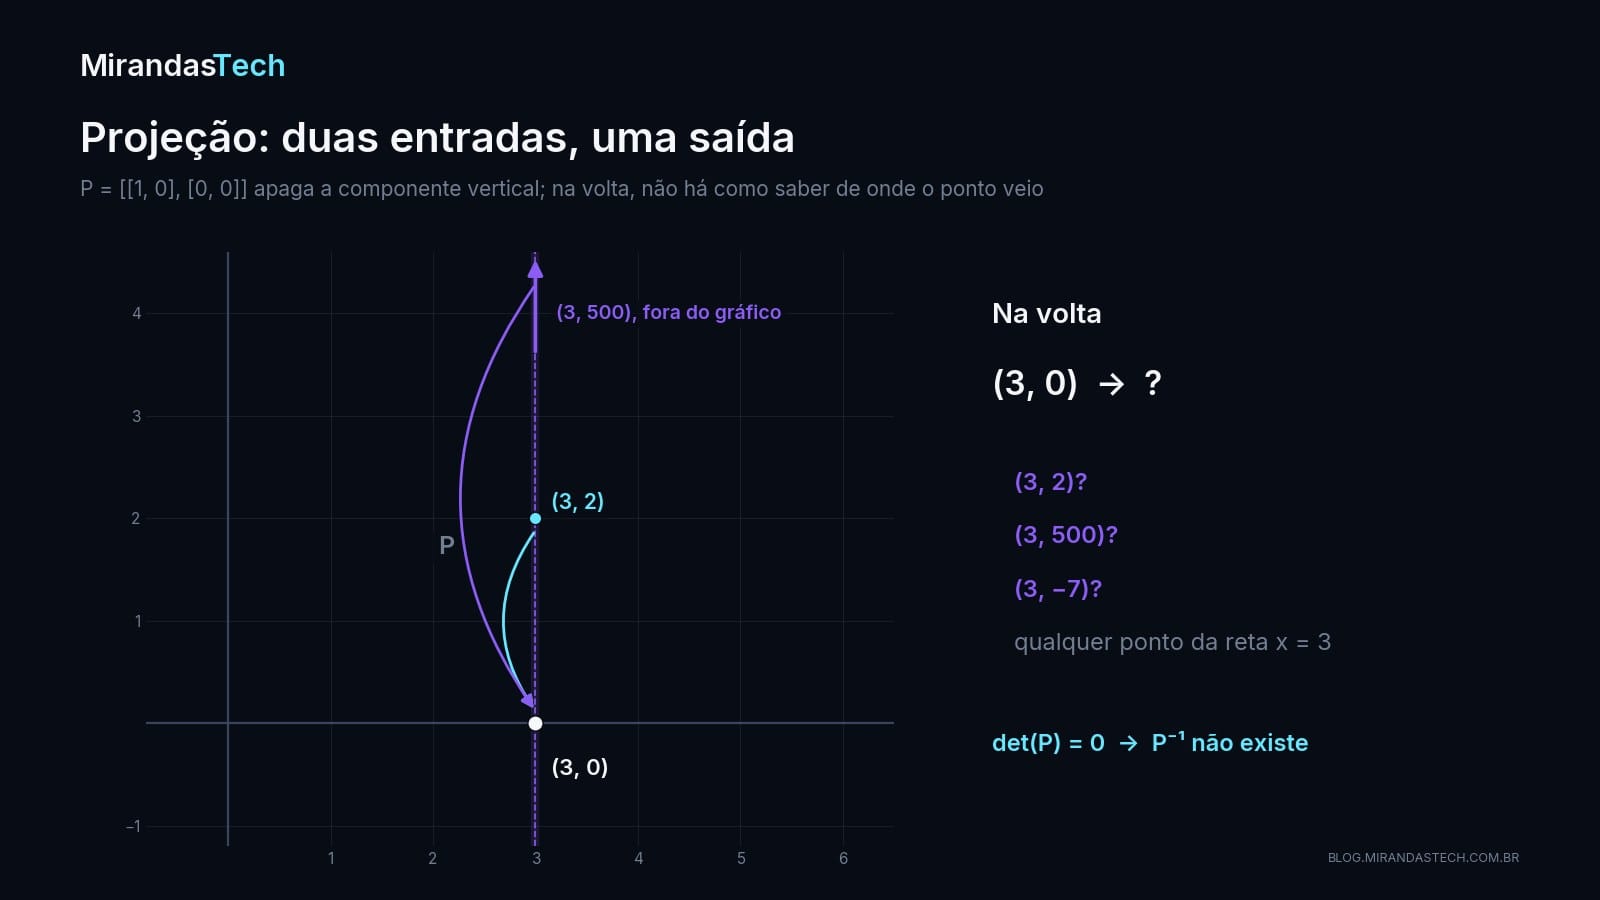
É a mesma situação da foto em tons de cinza. Uma transformação invertível pode esticar, girar, refletir ou deformar o espaço, mas preserva informação suficiente para existir um caminho de volta. Uma transformação singular pode levar o plano a uma linha, ou o espaço 3D a um plano, e aí diferenças entre vetores desaparecem.
5. A fórmula da inversa 2 × 2
Para uma matriz 2 × 2 qualquer,
$$ A=\begin{bmatrix}a&b\\c&d\end{bmatrix} \qquad\text{com}\qquad ad-bc\neq0 $$
a inversa é (Deisenroth, Faisal & Ong, 2020):
$$ \boxed{A^{-1}=\frac{1}{ad-bc}\begin{bmatrix}d&-b\\-c&a\end{bmatrix}} $$
A receita: troque de lugar as entradas da diagonal principal ($a$ e $d$), troque o sinal das outras duas ($b$ e $c$) e divida tudo pelo determinante $ad-bc$. A fórmula também mostra por que o determinante zero bloqueia a inversa: a divisão por $ad - bc$ deixaria de existir.
Um exemplo completo:
$$ A=\begin{bmatrix}2&1\\1&1\end{bmatrix} \qquad \det(A)=2\cdot1-1\cdot1=1 $$
Como o determinante é 1, a matriz é invertível, e a divisão nem altera nada:
$$ \boxed{A^{-1}=\begin{bmatrix}1&-1\\-1&2\end{bmatrix}} $$
Conferindo:
$$ AA^{-1}=\begin{bmatrix}2-1&-2+2\\1-1&-1+2\end{bmatrix}=\begin{bmatrix}1&0\\0&1\end{bmatrix}=I $$
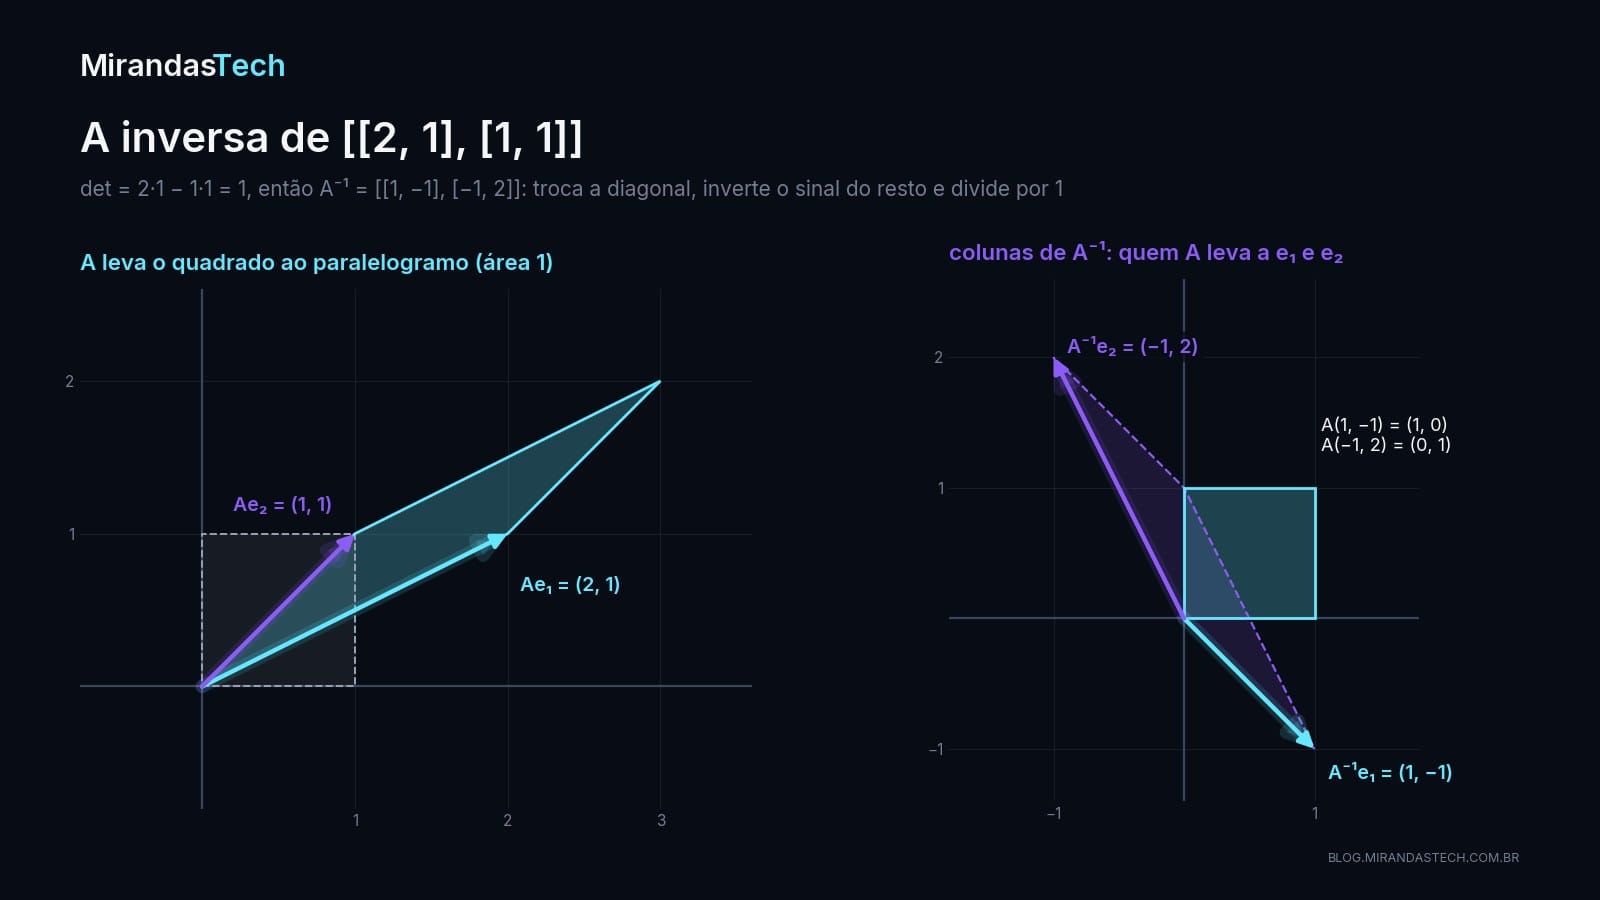
A figura dá uma leitura geométrica das colunas da inversa. Na Aula 06, as colunas de $A$ diziam para onde iam os vetores da base. As colunas de $A^{-1}$ respondem à pergunta oposta: quais vetores $A$ leva até $e_1$ e $e_2$? Aqui, $A(1,-1)=(1,0)$ e $A(-1,2)=(0,1)$.
A fórmula é útil para entender e para matrizes pequenas. Em matrizes maiores, usamos algoritmos numéricos, e a seção 11 mostra que, na maioria das vezes, nem é a inversa que queremos calcular.
6. Inversa e sistemas lineares
Um sistema linear se escreve como $Ax=b$. Se $A^{-1}$ existe, basta multiplicar os dois lados por ela:
$$ A^{-1}Ax=A^{-1}b \quad\Rightarrow\quad \boxed{x=A^{-1}b} $$
Essa é a forma conceitual de resolver sistemas lineares (Goodfellow, Bengio & Courville, 2016). Um exemplo:
$$ \begin{cases} 2x+y=5\\ x+y=3 \end{cases} $$
ou, na forma matricial,
$$ \begin{bmatrix}2&1\\1&1\end{bmatrix} \begin{bmatrix}x\\y\end{bmatrix} = \begin{bmatrix}5\\3\end{bmatrix} $$
A matriz é a da seção anterior, cuja inversa já conhecemos:
$$ \begin{bmatrix}x\\y\end{bmatrix} = \begin{bmatrix}1&-1\\-1&2\end{bmatrix} \begin{bmatrix}5\\3\end{bmatrix} = \begin{bmatrix}5-3\\-5+6\end{bmatrix} = \begin{bmatrix}2\\1\end{bmatrix} $$
Portanto, $x=2$ e $y=1$. Basta substituir para conferir: $2\cdot2+1=5$ e $2+1=3$.
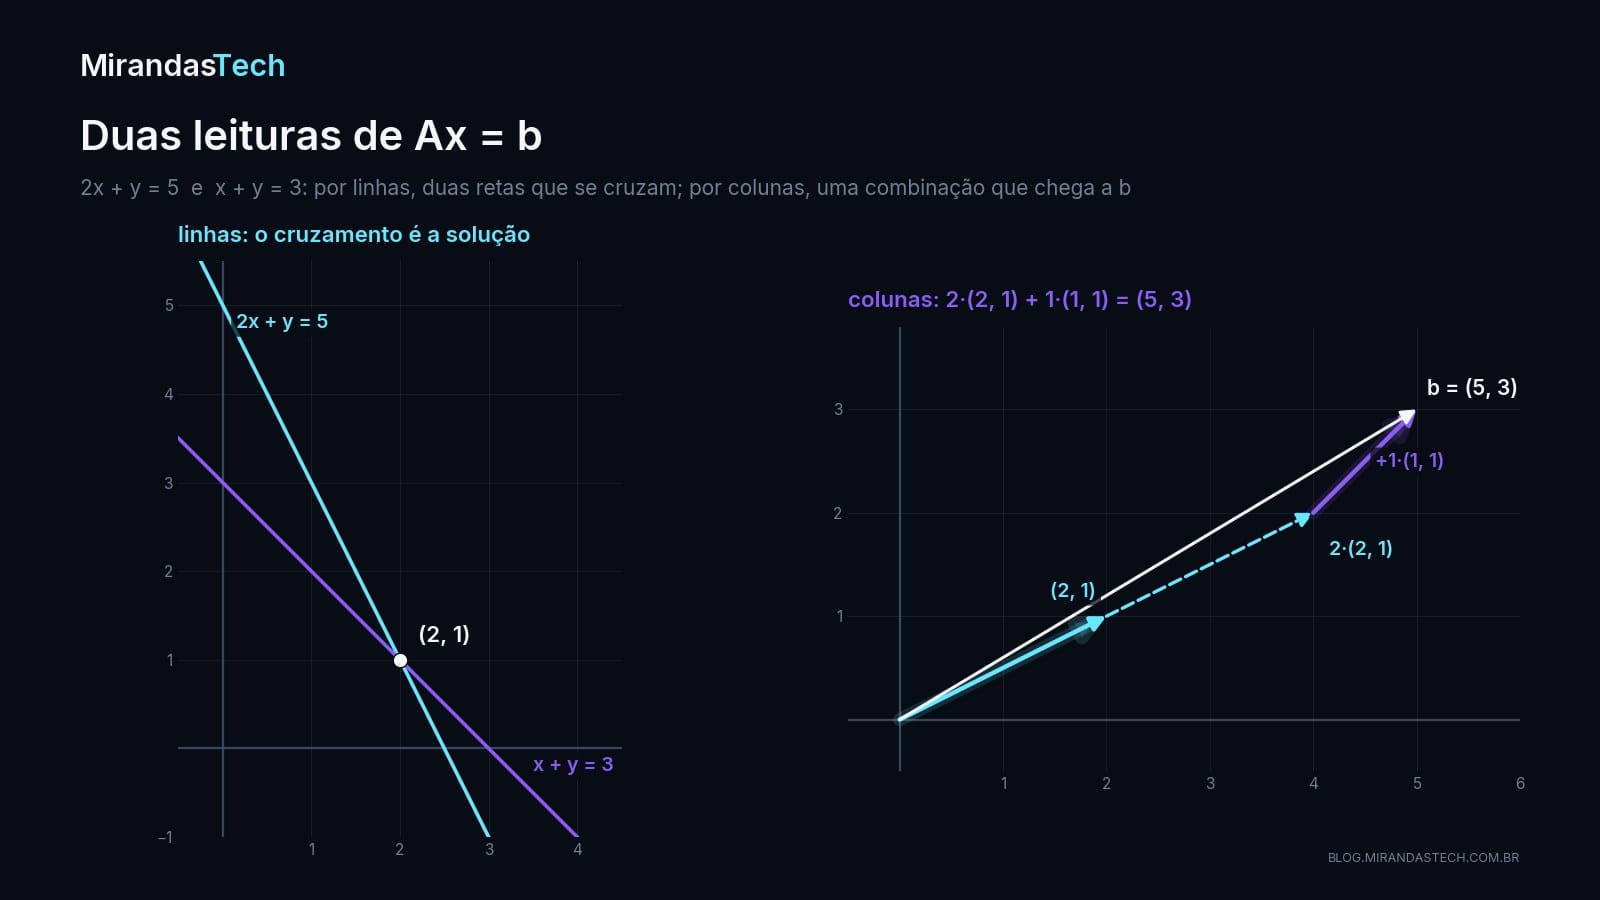
A leitura geométrica de Ax = b
A equação $Ax = b$ pode ser lida como uma pergunta:
Qual vetor $x$, quando transformado por $A$, produz $b$?
A inversa percorre a transformação no sentido contrário, de $b$ até $x$. No painel da direita da figura, a resposta $(2, 1)$ diz quanto de cada coluna de $A$ é preciso somar para chegar a $(5, 3)$.
Uma saída, uma entrada
Quando $A$ é invertível, cada saída tem exatamente uma entrada correspondente. Se duas entradas dessem a mesma saída,
$$ Ax_1=Ax_2 $$
bastaria aplicar $A^{-1}$ dos dois lados para concluir que $x_1=x_2$. Transformações assim são chamadas de um para um (injetoras). A projeção da seção 4 é o contraexemplo: $(3, 2)$ e $(3, 500)$ têm a mesma saída.
7. O teorema da matriz invertível, em prévia
Para uma matriz quadrada $A$ de tamanho $n \times n$, várias afirmações que parecem diferentes são, na verdade, a mesma. Ou todas são verdadeiras, ou todas são falsas (Goodfellow, Bengio & Courville, 2016; Deisenroth, Faisal & Ong, 2020):
- $A^{-1}$ existe;
- $\det(A)\neq0$;
- as colunas de $A$ são linearmente independentes;
- $Ax=0$ tem apenas a solução $x=0$;
- $Ax=b$ tem solução única para todo $b$;
- o posto de $A$ é $n$ (nenhuma direção é perdida).
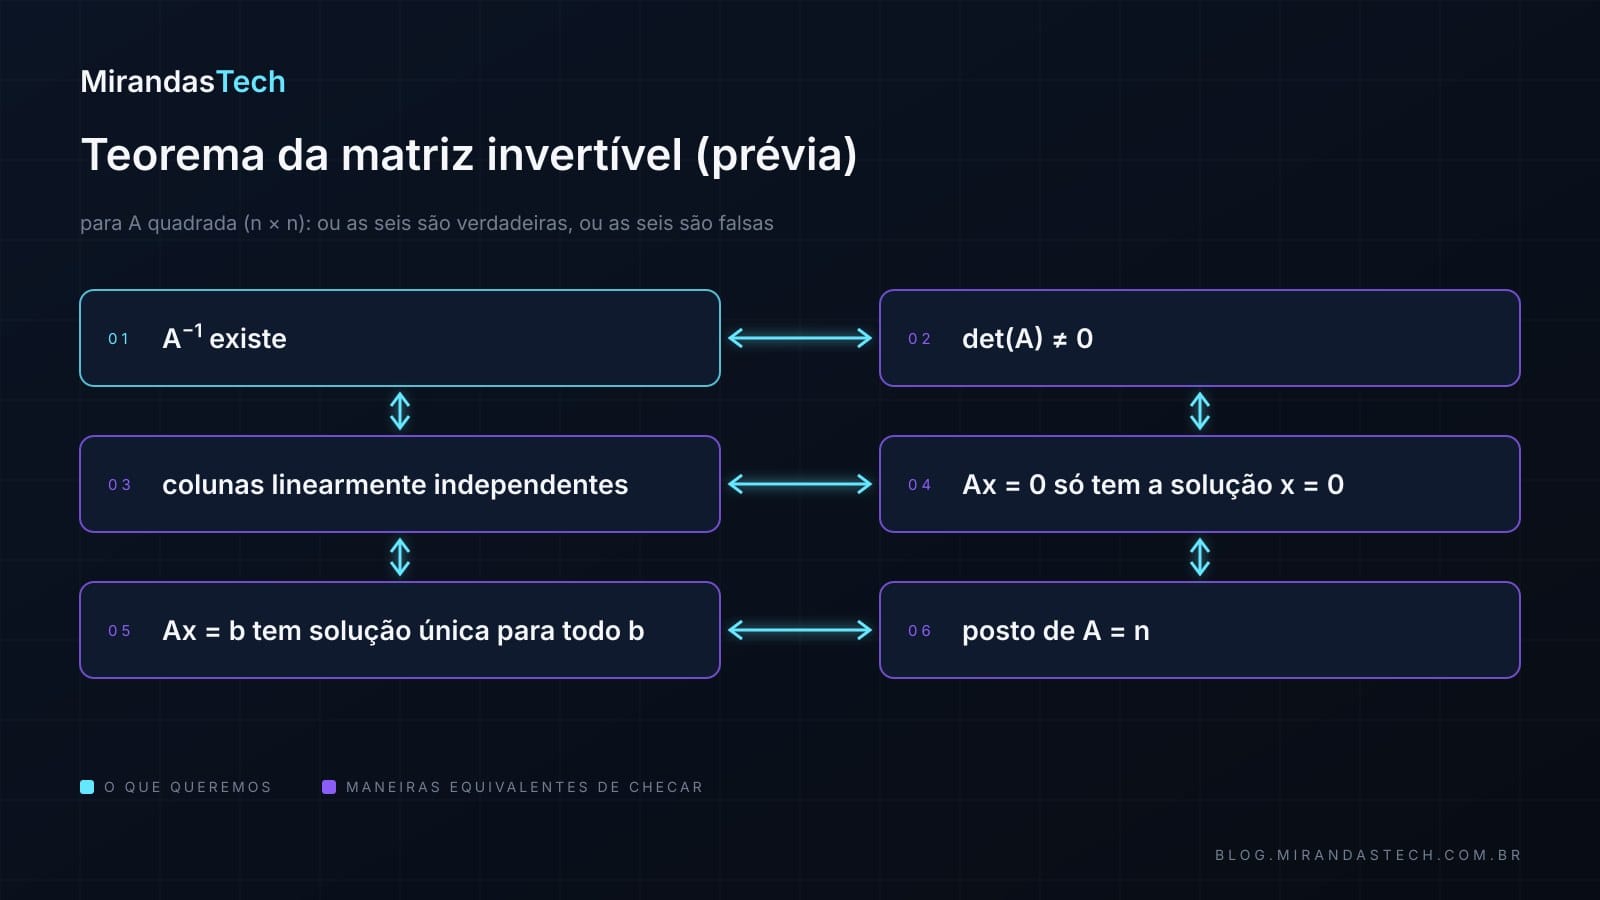
Esse teorema costura as aulas anteriores. A independência linear diz que as colunas cercam um volume de verdade (Aula 07). O determinante mede esse volume. E $Ax = 0$ só com $x = 0$ é a forma algébrica de "nenhuma entrada diferente de zero é esmagada até a origem". O último item, sobre o posto, antecipa a Aula 09.
8. Inversas que você já conhece
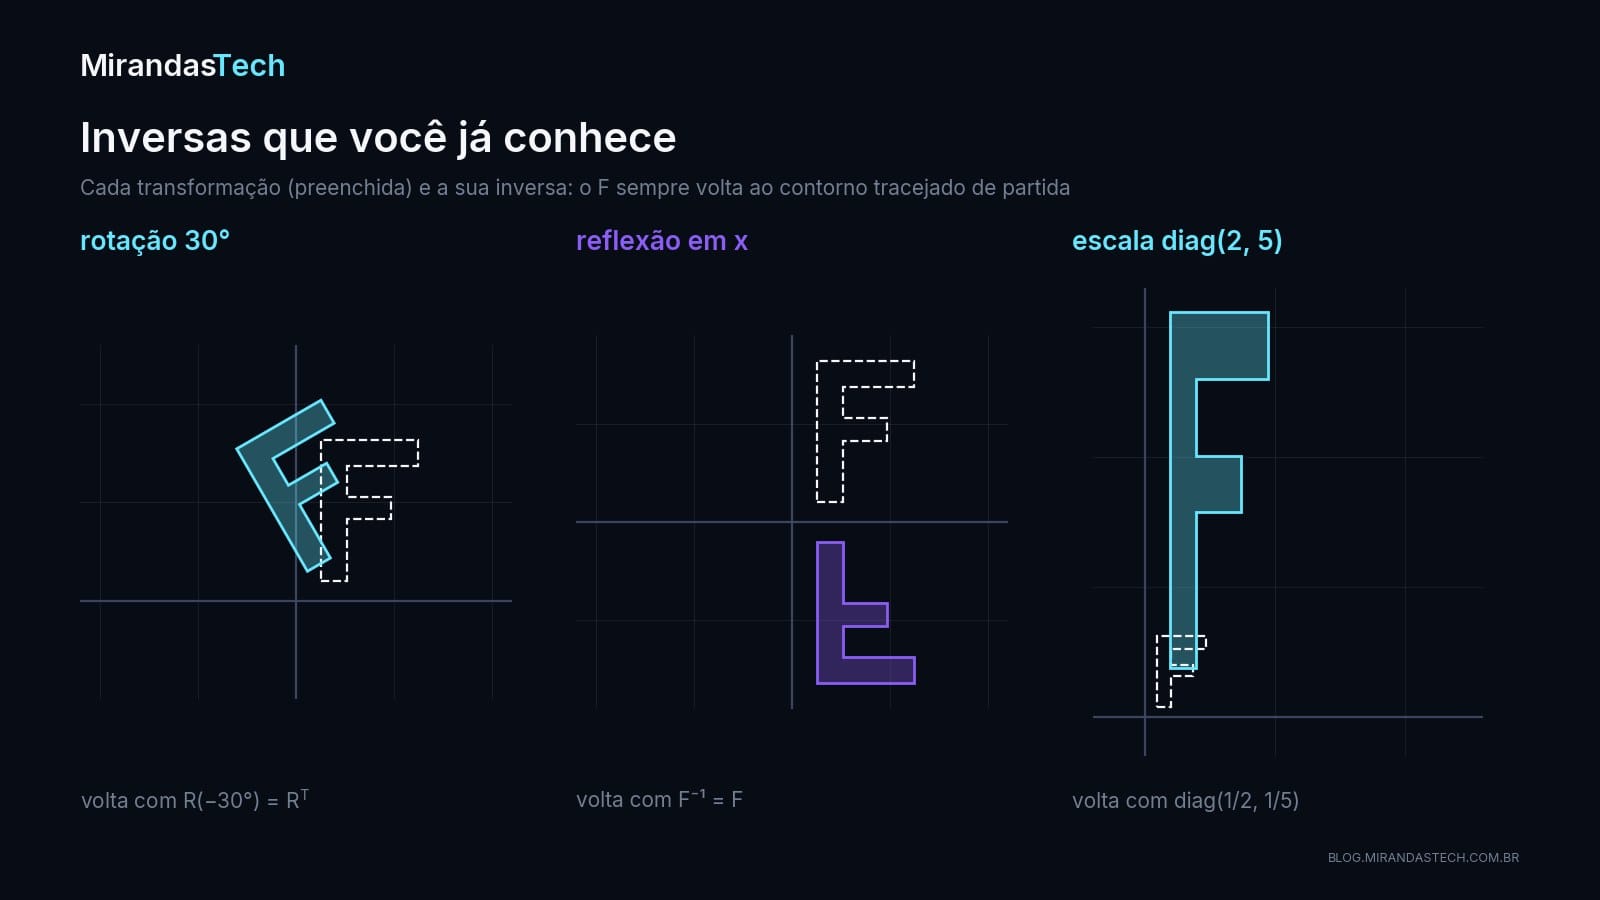
As transformações da Aula 06 têm inversas que dá para escrever sem conta nenhuma.
Rotação
Desfazer um giro de $\theta$ é girar $-\theta$:
$$ \boxed{R(\theta)^{-1}=R(-\theta)} $$
Como $\cos(-\theta)=\cos\theta$ e $\sin(-\theta)=-\sin\theta$, a matriz $R(-\theta)$ é exatamente a transposta de $R(\theta)$, isto é, a matriz com linhas e colunas trocadas:
$$ \boxed{R^{-1}=R^T} $$
Matrizes com essa propriedade, cujas colunas são ortonormais, se chamam matrizes ortogonais, e as rotações pertencem a essa classe (Deisenroth, Faisal & Ong, 2020). É uma propriedade valiosa: a inversa de uma matriz ortogonal sai de graça, só transpondo (Goodfellow, Bengio & Courville, 2016).
Reflexão
Para a reflexão no eixo horizontal,
$$ F=\begin{bmatrix}1&0\\0&-1\end{bmatrix} \qquad\Rightarrow\qquad \boxed{F^{-1}=F} $$
porque refletir duas vezes devolve o vetor original.
Escala
Para uma escala, a inversa divide pelos mesmos fatores:
$$ S=\begin{bmatrix}2&0\\0&5\end{bmatrix} \qquad\Rightarrow\qquad S^{-1}=\begin{bmatrix}1/2&0\\0&1/5\end{bmatrix} $$
9. Composição: a ordem se inverte
Se
$$ y=BAx $$
primeiro aplicamos $A$ e depois $B$. Para desfazer, é preciso começar pela última operação:
$$ \boxed{(BA)^{-1}=A^{-1}B^{-1}} $$
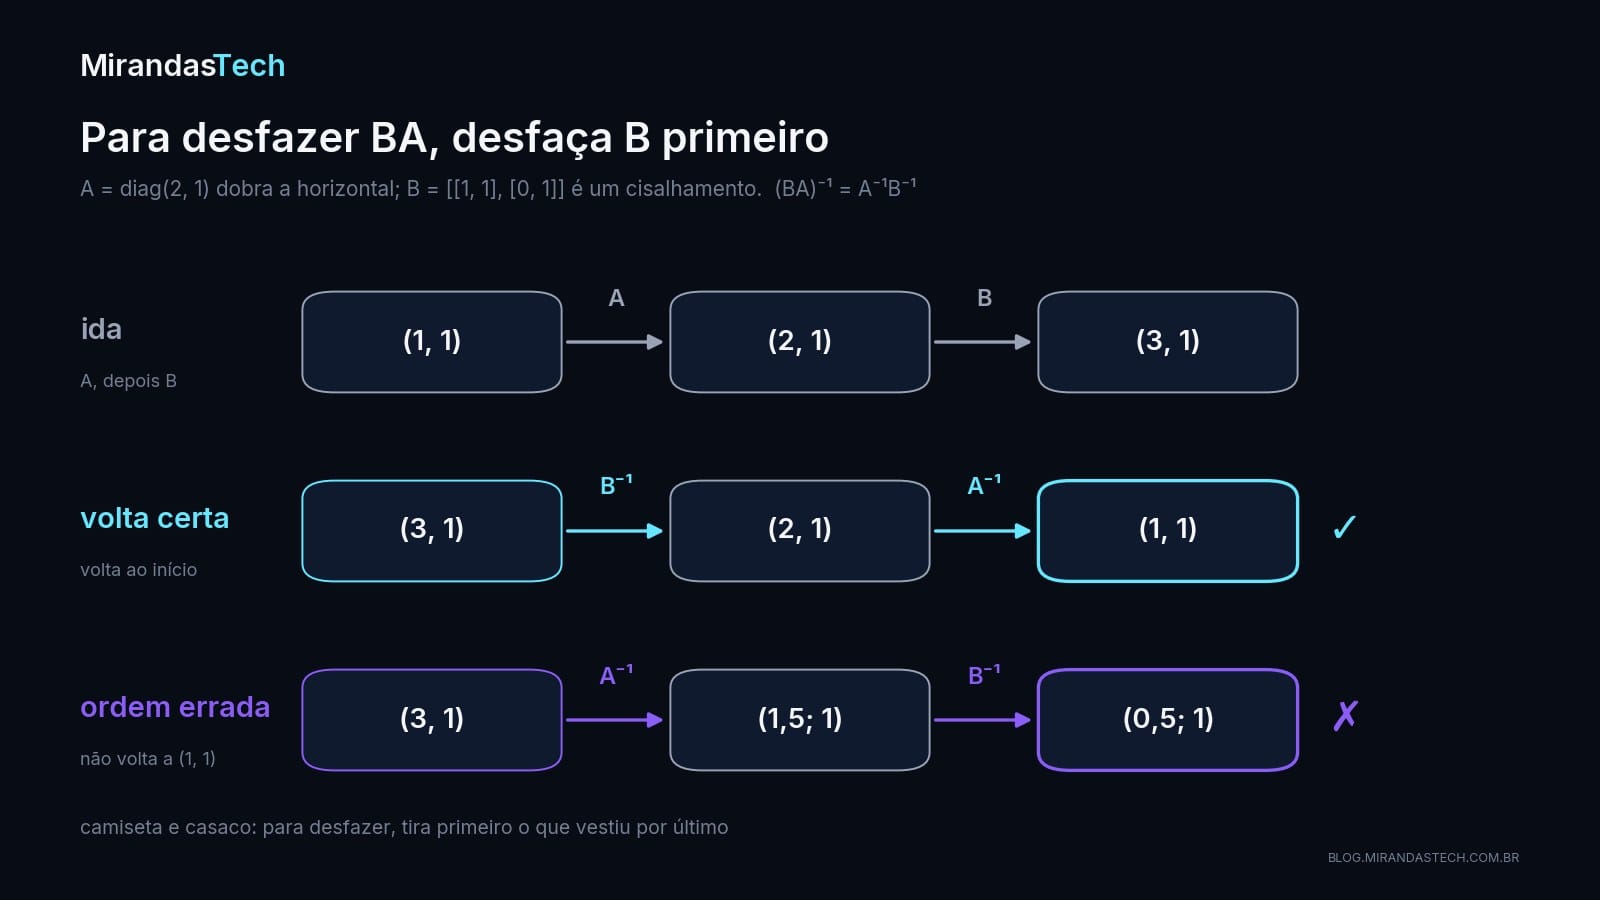
É a regra da roupa: você veste a camiseta e depois o casaco; para desfazer, tira primeiro o casaco e depois a camiseta. Algebricamente, basta conferir que $(A^{-1}B^{-1})(BA)=A^{-1}(B^{-1}B)A=A^{-1}A=I$ (Deisenroth, Faisal & Ong, 2020).
Um exemplo mostra que a ordem não é detalhe. Seja $A=\begin{bmatrix}2&0\\0&1\end{bmatrix}$ (dobra a horizontal) e $B=\begin{bmatrix}1&1\\0&1\end{bmatrix}$ (cisalhamento). O vetor $x=(1,1)$ vai a $Ax=(2,1)$ e depois a $y=BAx=(3,1)$. Desfazendo na ordem certa, $B^{-1}$ leva $(3,1)$ a $(2,1)$ e $A^{-1}$ leva $(2,1)$ a $(1,1)$. Na ordem errada, $A^{-1}$ primeiro leva $(3,1)$ a $(1{,}5;\,1)$, e $B^{-1}$ termina em $(0{,}5;\,1)$, longe do ponto de partida.
Também vale, como era de esperar,
$$ \boxed{(A^{-1})^{-1}=A} $$
desfazer o desfazer é refazer.
Determinante da inversa
Como $AA^{-1}=I$, $\det(I)=1$ e o determinante de um produto é o produto dos determinantes (Aula 07),
$$ \det(A)\det(A^{-1})=1 $$
e, portanto,
$$ \boxed{\det(A^{-1})=\frac{1}{\det(A)}} $$
Se $A$ multiplica áreas por 6, como a escala da seção 2, a inversa as multiplica por $1/6$ (Deisenroth, Faisal & Ong, 2020).
10. Quando A é singular: nenhuma ou infinitas soluções
Considere a matriz da Aula 07 cuja segunda coluna é o dobro da primeira:
$$ A=\begin{bmatrix}1&2\\2&4\end{bmatrix} \qquad \det(A)=1\cdot4-2\cdot2=0 $$
Ela não tem inversa. Mas o sistema $Ax=b$ ainda pode ser montado, e o que acontece com ele depende de $b$: ou não há solução nenhuma, ou há infinitas. Um sistema linear real nunca tem, por exemplo, exatamente duas soluções (Deisenroth, Faisal & Ong, 2020).
Infinitas soluções.
$$ \begin{cases} x+2y=4\\ 2x+4y=8 \end{cases} $$
A segunda equação é a primeira multiplicada por 2. Na verdade há uma equação só, e todo ponto da reta $x + 2y = 4$ serve: $(4, 0)$, $(0, 2)$, $(2, 1)$…
Nenhuma solução.
$$ \begin{cases} x+2y=4\\ 2x+4y=10 \end{cases} $$
Dividindo a segunda por 2, ela diz $x + 2y = 5$, o que contradiz a primeira. As duas retas são paralelas e nunca se cruzam.
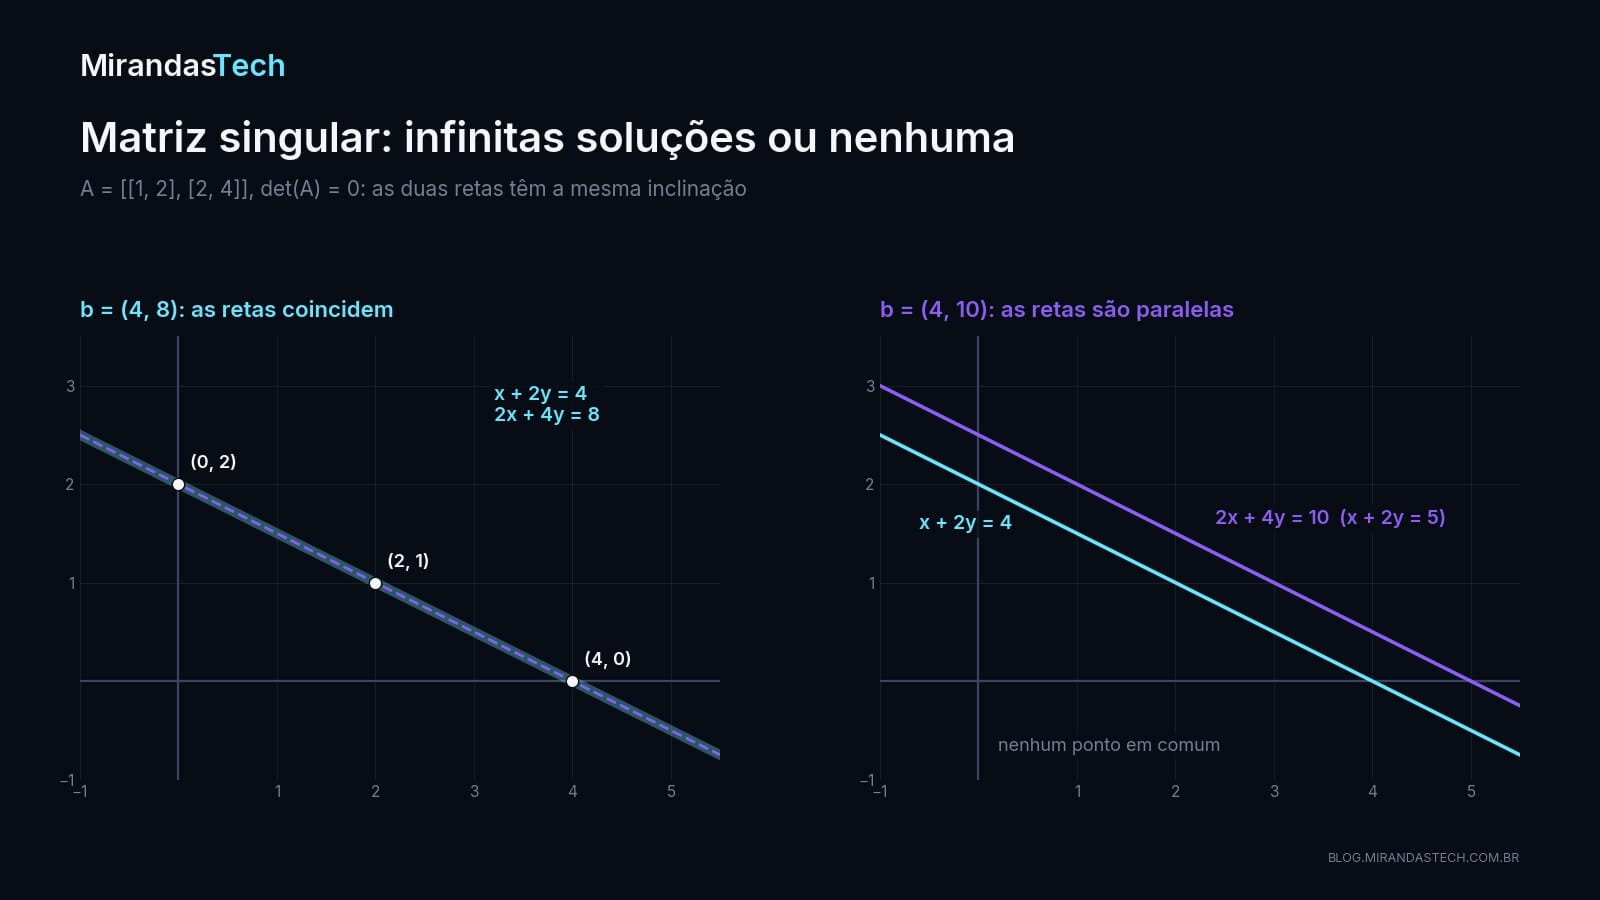
O motivo é o da Aula 07: as colunas $(1, 2)$ e $(2, 4)$ apontam na mesma direção, então $Ax$ só alcança os vetores dessa reta. Se $b$ está nela, como $(4, 8)$, há infinitas combinações que chegam lá; se não está, como $(4, 10)$, nenhuma chega. Para uma matriz quadrada:
$$ \boxed{\text{colunas independentes}\iff A\text{ invertível}} $$
e, se as colunas são dependentes, $\det(A)=0$.
Próxima grande ideia: o posto
Nem toda matriz é quadrada. Uma matriz $100\times50$, que leva vetores de 50 dimensões a 100, não tem inversa no sentido desta aula: a definição exige $A^{-1}A=AA^{-1}=I$ com matrizes quadradas. Precisamos de um conceito mais geral, o posto (rank), que mede quantas direções independentes realmente existem na transformação. Ele é o assunto da Aula 09 e volta em compressão, PCA, SVD, embeddings e redundância.
11. Na prática com NumPy
Em código, a inversa é uma chamada:
import numpy as np

A = np.array([
    [2.0, 1.0],
    [1.0, 1.0]
])

A_inv = np.linalg.inv(A)

print(A_inv)
print(A @ A_inv)
[[ 1. -1.]
 [-1.  2.]]
[[1. 0.]
 [0. 1.]]
Aqui a identidade saiu exata, porque todas as contas envolvem números pequenos e inteiros. Em geral, o ponto flutuante deixa valores minúsculos, como $10^{-16}$, onde a matemática diz zero; compare com np.allclose, não com ==.
O mini laboratório da aula faz a ida e volta completa:
import numpy as np

A = np.array([
    [2.0, 1.0],
    [1.0, 1.0]
])

x = np.array([2.0, 1.0])

y = A @ x
A_inv = np.linalg.inv(A)
x_recuperado = A_inv @ y

print("x original:", x)
print("y transformado:", y)
print("A inversa:")
print(A_inv)
print("x recuperado:", x_recuperado)
x original: [2. 1.]
y transformado: [5. 3.]
A inversa:
[[ 1. -1.]
 [-1.  2.]]
x recuperado: [2. 1.]
Repare que $y = (5, 3)$ é o lado direito do sistema da seção 6: transformar $(2, 1)$ por $A$ e resolver $Ax = (5, 3)$ são a mesma pergunta feita nos dois sentidos.
A regra de ouro: resolva, não inverta
Embora a matemática escreva $x=A^{-1}b$, quem programa raramente calcula a inversa só para resolver um sistema. Em vez de
x = np.linalg.inv(A) @ b
prefira
import numpy as np

A = np.array([
    [2.0, 1.0],
    [1.0, 1.0]
])

b = np.array([5.0, 3.0])

x = np.linalg.solve(A, b)

print(x)
[2. 1.]
O solve resolve o sistema diretamente pela rotina gesv do LAPACK (NumPy, 2026), que fatora $A$ por eliminação de Gauss com pivoteamento (a decomposição LU) e usa os fatores para chegar a $x$, sem nunca formar $A^{-1}$ (LAPACK, 2026). Moler (2004) explica o motivo com um sistema de uma equação só, $7x = 21$. A melhor forma de resolvê-lo é dividir: $x = 21/7 = 3$. Pela inversa, guardando $1/7$ com seis casas decimais, seria $x = 7^{-1}\times21 = 0{,}142857\times21 = 2{,}999997$: mais contas (uma divisão e uma multiplicação, em vez de uma divisão) e uma resposta menos precisa. A mesma lógica vale para sistemas grandes, e é por isso que Goodfellow, Bengio e Courville (2016) tratam $A^{-1}$ como ferramenta sobretudo teórica: algoritmos que usam o próprio $b$ costumam chegar a estimativas mais precisas de $x$. A seção 12 mostra a diferença num caso difícil.
Matriz singular
Com a matriz da seção 10, o NumPy reclama:
import numpy as np

A_singular = np.array([
    [1.0, 2.0],
    [2.0, 4.0]
])

print(np.linalg.det(A_singular))
np.linalg.inv(A_singular)
0.0
numpy.linalg.LinAlgError: Singular matrix
O np.linalg.solve levanta o mesmo erro para essa matriz, com qualquer $b$. Até aqui, tudo como a teoria manda. O problema é que nem sempre o NumPy percebe.
12. Armadilhas numéricas: singular escondida e quase singular
Os três exemplos desta seção não estão na aula; foram executados com NumPy 2.2.3 (Python 3.13) para mostrar o que a aula chama de matrizes quase singulares.
Uma singular que passa despercebida
import numpy as np

M = np.array([[1.0, 2.0, 3.0],
              [4.0, 5.0, 6.0],
              [7.0, 8.0, 9.0]])   # 3ª linha = 2·(2ª) − 1ª: singular

M_inv = np.linalg.inv(M)          # nenhum erro...
print(M_inv[0])                   # ...mas entradas da ordem de 10^15
print(M @ M_inv)                  # deveria ser a identidade
print(np.linalg.matrix_rank(M))
print(f"{np.linalg.cond(M):.1e}")
[-4.50359963e+15  9.00719925e+15 -4.50359963e+15]
[[ 0.  0.  0.]
 [-4.  0. -4.]
 [ 0.  0.  0.]]
2
3.8e+16
A matriz $M$ é singular: a terceira linha é o dobro da segunda menos a primeira, e o posto é 2. Mas o arredondamento impediu que o algoritmo encontrasse um pivô exatamente zero, e o inv devolveu, sem reclamar, uma "inversa" com entradas de $10^{15}$. O produto $MM^{-1}$, que deveria ser a identidade, não tem nada a ver com ela. A documentação avisa que, para matrizes mal condicionadas, o erro pode ou não ser levantado, e os resultados podem ser imprecisos (NumPy, 2026). Os valores exatos acima, e até a ocorrência do erro, podem variar com a biblioteca de álgebra linear instalada; o recado não varia: a ausência de erro não prova que a inversa está certa.
Quase singular: pequenas mudanças, grandes saltos
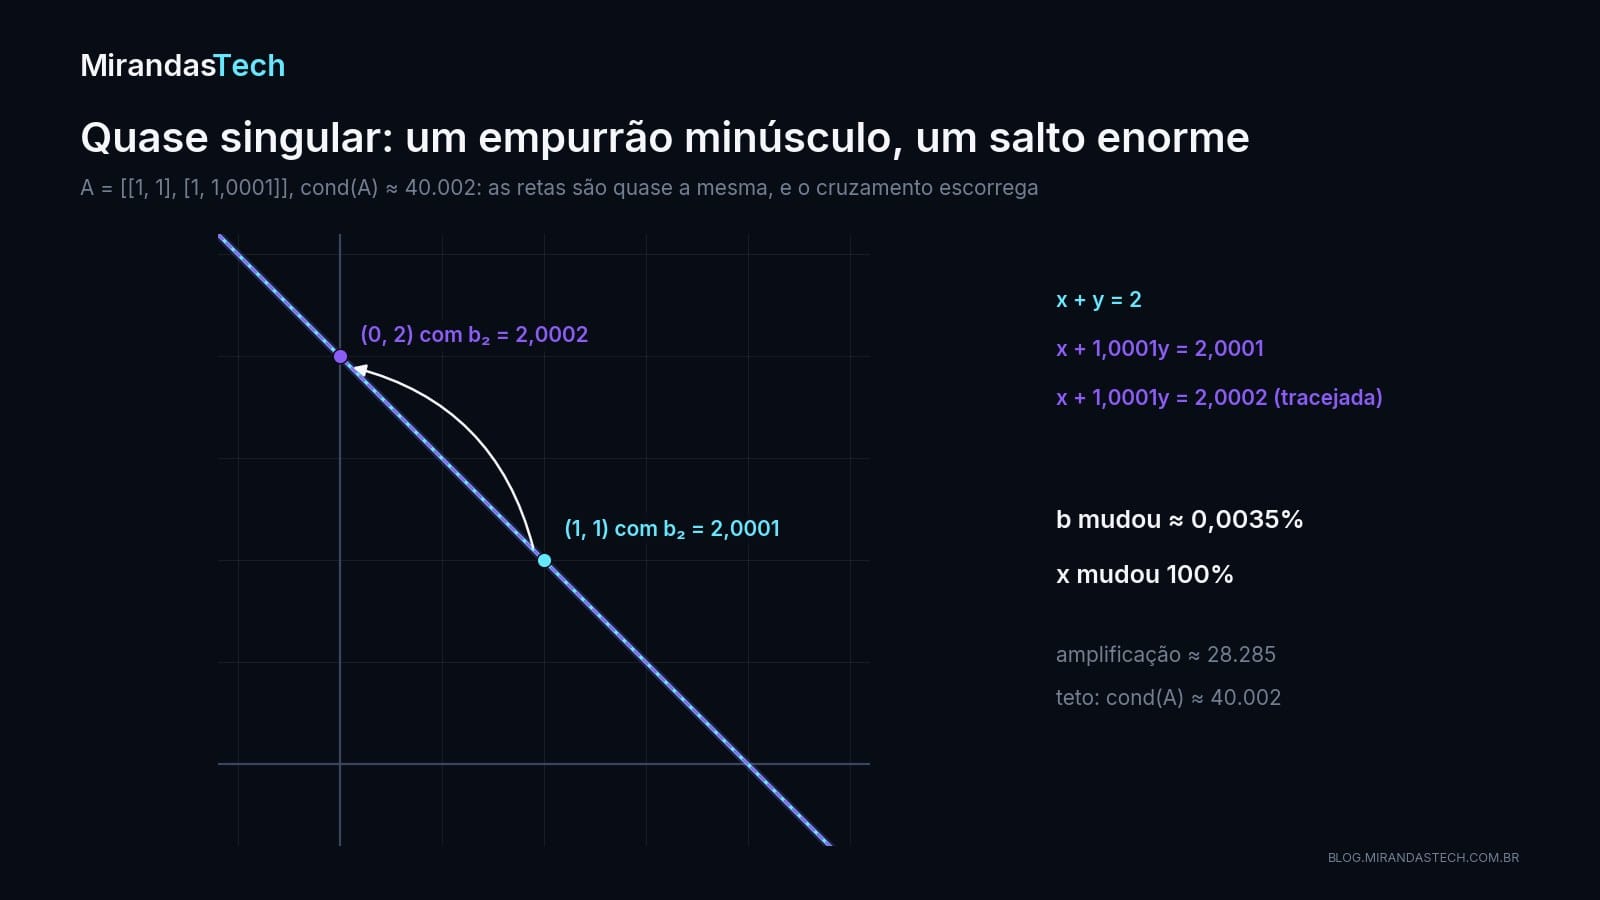
Uma matriz pode ter $\det(A)\neq0$ e ainda estar muito perto de ser singular. Se as colunas são quase paralelas, a transformação comprime muito alguma direção, e desfazê-la amplifica qualquer erro nos dados:
import numpy as np

A = np.array([[1.0, 1.0],
              [1.0, 1.0001]])    # colunas quase paralelas

print(np.linalg.solve(A, [2.0, 2.0001]))
print(np.linalg.solve(A, [2.0, 2.0002]))   # b mudou na 5ª casa
print(f"{np.linalg.cond(A):.0f}")
[1. 1.]
[0. 2.]
40002
Mudar a segunda componente de $b$ em $0{,}0001$, uma variação relativa de cerca de $0{,}0035\%$, levou a solução de $(1, 1)$ a $(0, 2)$, uma variação relativa de $100\%$. As duas retas são quase a mesma, e um empurrão minúsculo em uma delas faz o ponto de encontro escorregar para longe.
Quem mede essa sensibilidade é o número de condição:
$$ \kappa(A)=\|A\|\,\|A^{-1}\| $$
e ele limita quanto um erro em $b$ pode crescer em $x$:
$$ \frac{\|\delta x\|}{\|x\|}\le\kappa(A)\,\frac{\|\delta b\|}{\|b\|} $$
onde $\|\cdot\|$ é a norma (o tamanho) de um vetor ou de uma matriz, $\delta b$ é uma perturbação em $b$ e $\delta x$ a mudança que ela causa em $x$. A desigualdade diz que $\kappa(A)$ é um fator de amplificação: um erro relativo nos dados pode virar um erro até $\kappa(A)$ vezes maior na solução (Moler, 2004). No exemplo, a amplificação foi de cerca de 28 mil, abaixo do teto $\kappa(A)\approx40\,002$. Moler também propõe ler $\kappa(A)$ como o inverso da distância relativa da matriz até a matriz singular mais próxima: $\kappa$ grande, matriz quase singular. Ele vale no mínimo 1, o valor da identidade, e é infinito para matrizes singulares na aritmética exata (Moler, 2004; NumPy, 2026); em ponto flutuante, aparece como um número enorme, como os $3{,}8\times10^{16}$ de $M$. Como mostrou a Aula 07, o determinante não serve de termômetro para isso; o número de condição serve.
inv contra solve num caso difícil
A matriz de Hilbert, com entradas $H_{ij}=1/(i+j-1)$, é muito mal condicionada, como o próprio código vai mostrar. O código abaixo resolve o mesmo sistema pelos dois caminhos, sabendo de antemão que a resposta certa é um vetor de uns:
import numpy as np

n = 10
i = np.arange(n)
H = 1.0 / (i[:, None] + i[None, :] + 1)   # matriz de Hilbert 10 × 10
x_true = np.ones(n)
b = H @ x_true

x_inv = np.linalg.inv(H) @ b
x_sol = np.linalg.solve(H, b)

print(f"cond(H)        = {np.linalg.cond(H):.1e}")
print(f"resíduo  inv   = {np.linalg.norm(H @ x_inv - b):.1e}")
print(f"resíduo  solve = {np.linalg.norm(H @ x_sol - b):.1e}")
print(f"erro     inv   = {np.linalg.norm(x_inv - x_true):.1e}")
print(f"erro     solve = {np.linalg.norm(x_sol - x_true):.1e}")
cond(H)        = 1.6e+13
resíduo  inv   = 1.1e-04
resíduo  solve = 5.4e-16
erro     inv   = 1.3e-02
erro     solve = 5.2e-04
O resíduo $\|Hx-b\|$ mede se a resposta satisfaz o sistema. Com solve, ele fica no nível do arredondamento ($10^{-16}$), mesmo com $\kappa(H)\approx10^{13}$. É o que Moler (2004) descreve para a eliminação de Gauss com pivoteamento: o resíduo relativo costuma ficar do tamanho do erro de arredondamento, por pior que seja o condicionamento. Com inv, o resíduo é mais de $10^{11}$ vezes maior. O erro em relação à resposta verdadeira, por sua vez, é grande nos dois casos, porque nenhum algoritmo escapa de $\kappa(H)$. Moler (2004) limita o erro relativo da solução a algo da ordem de $\kappa(A)\,\epsilon$, onde $\epsilon\approx2{,}2\times10^{-16}$ é a precisão da máquina; aqui, $1{,}6\times10^{13}\times2{,}2\times10^{-16}\approx3{,}5\times10^{-3}$, ou seja, dos cerca de 16 algarismos da precisão dupla só restam dois ou três confiáveis. Neste exemplo, ainda assim, o solve errou cerca de 25 vezes menos.
Ficam duas lições separadas. O condicionamento é uma propriedade do problema: se $\kappa(A)$ é enorme, os dados precisam ser muito precisos para a resposta valer alguma coisa. O algoritmo é escolha sua: solve é mais barato e não acrescenta erro desnecessário. Calcular $A^{-1}$ explicitamente faz sentido quando você precisa da matriz inversa em si, não de $x$.
13. Onde isso aparece em IA
Modelos de IA trabalham com matrizes grandes, otimização, covariâncias, transformações, sistemas lineares e decomposições. Entender inversa e invertibilidade ajuda a responder perguntas práticas: quando uma informação pode ser recuperada, quando dimensões foram colapsadas, quando um sistema tem solução única, por que certas transformações são instáveis e como matrizes representam relações entre variáveis. Quatro lugares onde $A^{-1}$ aparece explicitamente:
Distância de Mahalanobis
Em estatística multivariada, a distância de um ponto $x$ até a média $\mu$ de uma nuvem de dados com covariância $\Sigma$ é medida por
$$ \Delta^2=(x-\mu)^T\,\Sigma^{-1}\,(x-\mu) $$
a distância de Mahalanobis, que se reduz à distância euclidiana quando $\Sigma$ é a identidade (Bishop, 2006). A inversa $\Sigma^{-1}$ "desfaz" o formato da nuvem: comprime as direções em que os dados variam muito e estica as direções em que variam pouco, antes de medir.
import numpy as np

mu = np.array([0.0, 0.0])
Sigma = np.array([[4.0, 1.8],
                  [1.8, 1.0]])         # covariância: x1 e x2 andam juntos

def mahalanobis(x, mu, Sigma):
    d = x - mu
    return np.sqrt(d @ np.linalg.solve(Sigma, d))   # sem inverter Sigma

p = np.array([2.0, 1.0])               # na direção em que os dados variam
q = np.array([-1.0, 2.0])              # contra a correlação

print(round(np.linalg.norm(p - mu), 3), round(np.linalg.norm(q - mu), 3))
print(round(mahalanobis(p, mu, Sigma), 2), round(mahalanobis(q, mu, Sigma), 2))
2.236 2.236
1.03 5.64
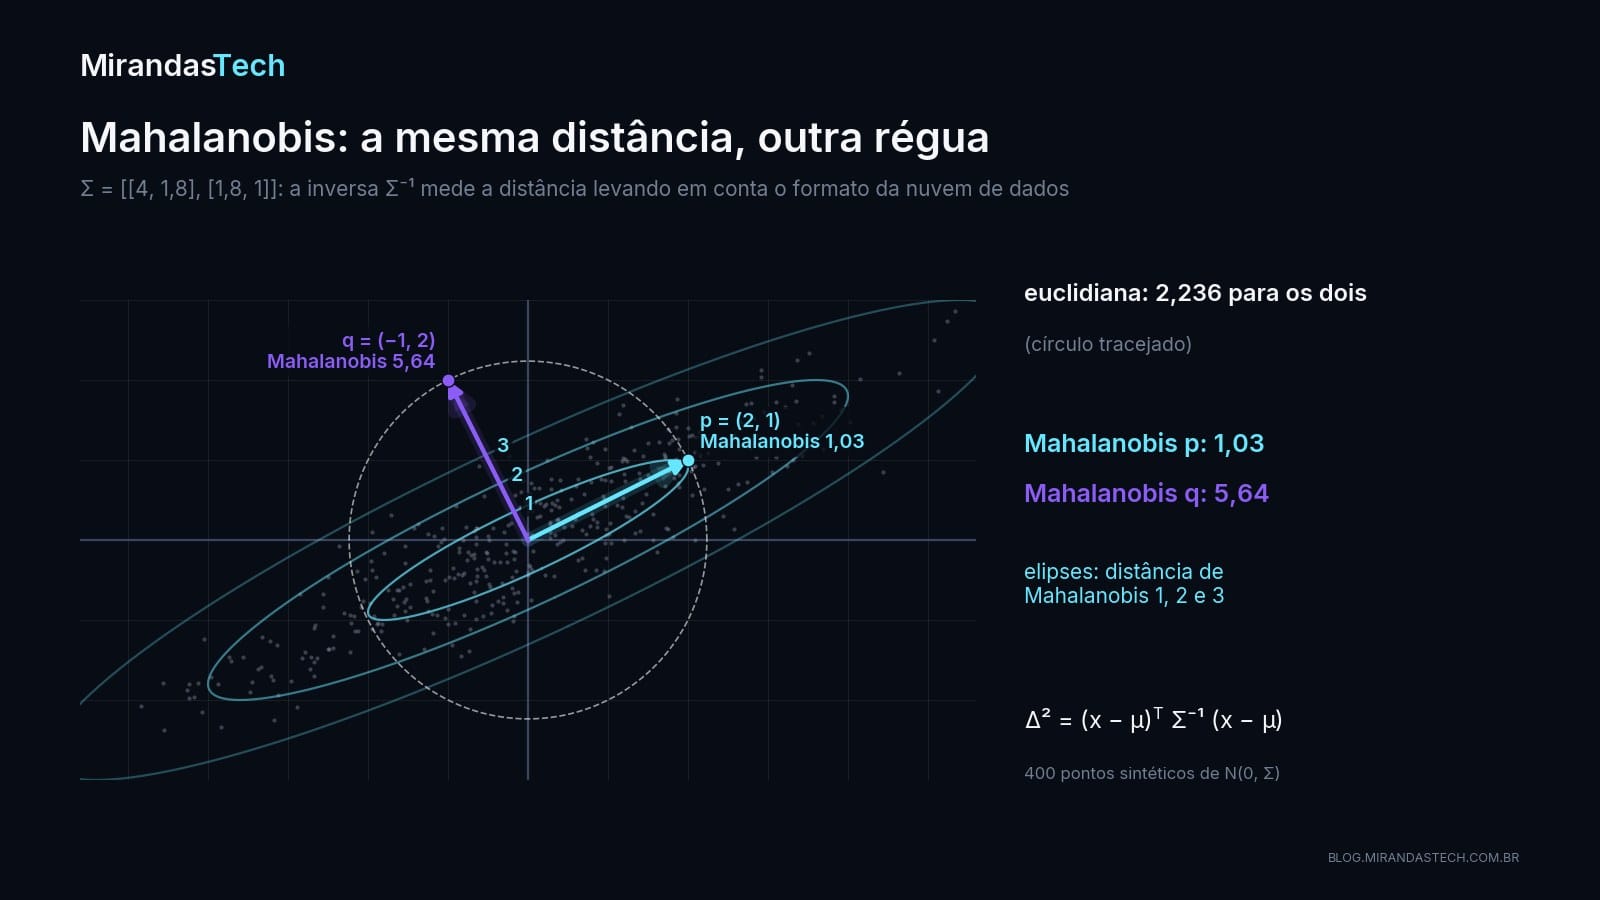
Os dois pontos estão à mesma distância euclidiana da média, mas $p$ acompanha a correlação dos dados e $q$ vai contra ela: para essa nuvem, $q$ é muito mais estranho. Repare que a função usa solve, a regra da seção 11 aplicada a um caso real. E se $\Sigma$ for singular (uma variável é combinação linear das outras), a distância nem está definida.
Regressão linear
Na regressão linear por mínimos quadrados, os coeficientes têm a forma fechada (Deisenroth, Faisal & Ong, 2020):
$$ \hat\beta=(X^TX)^{-1}X^Ty $$
onde $X$ é a matriz de dados (uma linha por exemplo) e $y$ o vetor de respostas. A inversa só existe se $X^TX$ for invertível, isto é, se as colunas de $X$ forem linearmente independentes; atributos redundantes quebram a fórmula. E, como na seção 11, a fórmula é conceitual: Deisenroth, Faisal e Ong (2020) observam que, por precisão numérica, em geral não se recomenda calcular a inversa, e o próprio texto deles trata $(X^TX)\hat\beta = X^Ty$ como um sistema a resolver. O artigo de regressão linear da trilha de Machine Learning desenvolve esse caminho; mais adiante nesta série, as decomposições QR e SVD mostram por que podem ser preferíveis.
Pseudoinversa
Quando a matriz é retangular ou singular, a inversa comum não existe, mas existe uma generalização, a pseudoinversa de Moore-Penrose, escrita $A^+$. Penrose (1955) mostrou que ela existe para qualquer matriz, inclusive retangular, e a usou para resolver equações matriciais lineares. Quando $Ax=y$ não tem solução, ela devolve o $x$ que deixa $Ax$ o mais perto possível de $y$; quando há infinitas soluções, devolve a de menor norma (Goodfellow, Bengio & Courville, 2016). Ela aparece em mínimos quadrados, em sistemas com mais equações que incógnitas (ou menos) e na SVD, e é calculada no NumPy por np.linalg.pinv, via SVD (NumPy, 2026).
Representações: quando dá para voltar
Se uma camada faz $z=Wx$ com $W$ quadrada e invertível, em princípio a representação original pode ser recuperada:
$$ x\xrightarrow{\;W\;}z\xrightarrow{\;W^{-1}\;}x $$
Se $W$ reduz a dimensão (por exemplo, de 768 para 128), a reconstrução perfeita deixa de ser possível sem estrutura adicional, pela mesma razão da projeção da seção 4. Um autoencoder aceita essa perda de propósito: um codificador comprime a entrada num código pequeno, e um decodificador aprende a reconstruí-la (Hinton & Salakhutdinov, 2006). O decodificador não é a inversa matemática do codificador; o modelo é construído justamente para copiar a entrada só de forma aproximada, e, ao escolher o que preservar, aprende propriedades úteis dos dados (Goodfellow, Bengio & Courville, 2016).
No extremo oposto estão as redes desenhadas para serem exatamente invertíveis, como os normalizing flows que apareceram na Aula 07. Na Real NVP, as camadas são transformações invertíveis e treináveis, o que permite calcular a verossimilhança de forma exata e percorrer o caminho nos dois sentidos, também de forma exata: do código aos dados, para gerar amostras, e dos dados ao código, para inferir as variáveis latentes (Dinh, Sohl-Dickstein & Bengio, 2017). O detalhe curioso é que cada camada de acoplamento é invertível mesmo usando, por dentro, redes $s$ e $t$ que não são: a inversa não exige inverter $s$ nem $t$, e o jacobiano da camada é triangular, de modo que o determinante da Aula 07 entra na verossimilhança como o produto da diagonal (Dinh, Sohl-Dickstein & Bengio, 2017). A pergunta desta aula, "existe caminho de volta?", vira ali um requisito de arquitetura.
14. Exercícios
1. Considere $A=\begin{bmatrix}2&0\\0&4\end{bmatrix}$. Qual deve ser $A^{-1}$? Explique usando a interpretação de escala.
2. Para $A=\begin{bmatrix}2&1\\1&1\end{bmatrix}$, calcule $\det(A)$ e diga se a matriz possui inversa.
3. Para $A=\begin{bmatrix}1&2\\2&4\end{bmatrix}$, explique por que ela não possui inversa usando: determinante, geometria e perda de informação.
4. Se $y=Ax$ e conhecemos $y$, qual operação permite recuperar $x$ quando $A$ é invertível?
5. Resolva:
$$ \begin{cases} 2x+y=5\\ x+y=3 \end{cases} $$
6. Se $C=BA$, qual é $C^{-1}$? Explique por que a ordem é invertida.
7. Por que, em programação, np.linalg.solve(A, b) costuma ser melhor do que np.linalg.inv(A) @ b quando o único objetivo é resolver $Ax=b$?
8. Questão principal. Explique com suas palavras a diferença entre transformar um vetor e desfazer uma transformação. Relacione
$$ x\xrightarrow{\;A\;}y\xrightarrow{\;A^{-1}\;}x $$
com a perda de informação quando a transformação é singular.
O que guardar
O mapa da aula cabe numa figura: o determinante decide se existe caminho de volta, e o caminho de volta é $A^{-1}$.
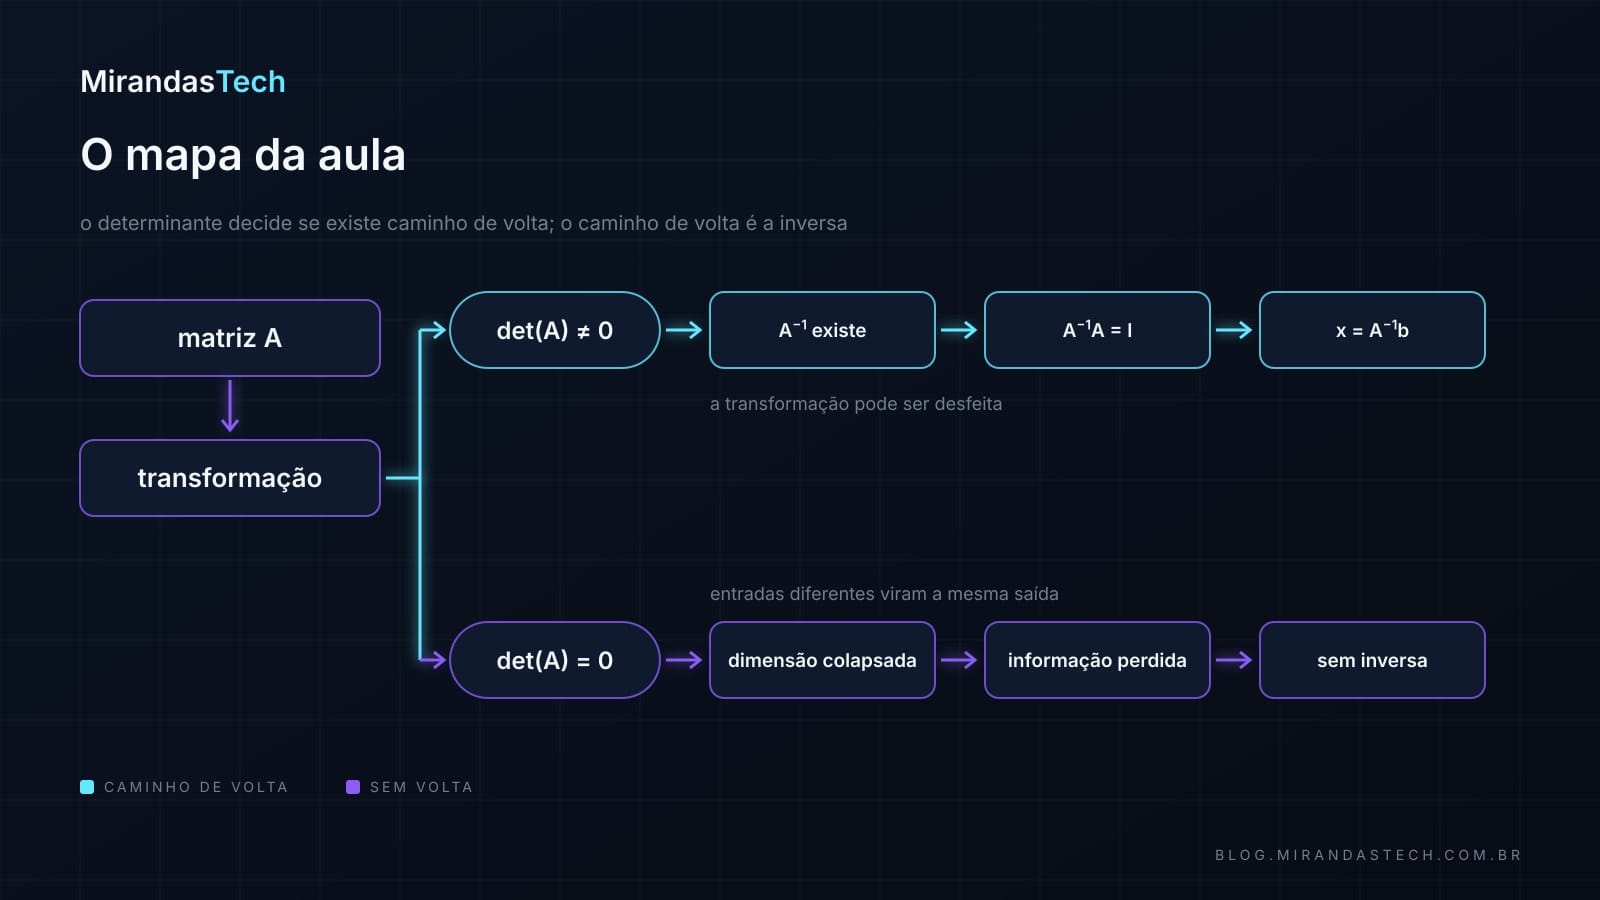
Quando olhar para $A^{-1}$, pense:
$$ \boxed{A^{-1}=\text{a transformação que desfaz }A} $$
- $A^{-1}A=AA^{-1}=I$.
- Para matrizes quadradas, $A^{-1}$ existe se e somente se $\det(A)\neq0$, se e somente se as colunas são independentes.
- $(BA)^{-1}=A^{-1}B^{-1}$ e $\det(A^{-1})=1/\det(A)$.
- Em código, resolva $Ax=b$ com
solve; reserveinvpara quando a inversa em si for o objetivo; e olhe o número de condição antes de confiar na resposta.
Uma transformação só pode ser desfeita perfeitamente quando não destruiu a informação necessária para reconstruir a entrada.
Com esta aula, a sequência da série fica assim:
- Aula 01 — vetores, matrizes e tensores.
- Aula 02 — norma e geometria vetorial.
- Aula 03 — produto escalar.
- Aula 04 — similaridade de cosseno.
- Aula 05 — $Wx+b$.
- Aula 06 — escala, rotação, reflexão e projeção.
- Aula 07 — determinante, volume e perda de informação.
- Aula 08 — $A^{-1}$, sistemas lineares e condicionamento.
Na Aula 09, Sistemas lineares, eliminação de Gauss e posto da matriz, o assunto é $Ax=b$ sem depender da inversa: sistemas determinados, superdeterminados e subdeterminados, eliminação de Gauss, escalonamento, pivôs, posto, dependência linear e as condições de existência e unicidade de solução.
Referências
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. MIT Press, 2016. Cap. 2 e cap. 14. www.deeplearningbook.org/contents/linear_algebra.html; www.deeplearningbook.org/contents/autoencoders.html
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. doi.org/10.1017/9781108679930
- NumPy. numpy.linalg.inv, numpy.linalg.solve, numpy.linalg.cond e numpy.linalg.pinv. Documentação oficial do NumPy, v2.5, 2026. Acesso em 2 out. 2026. numpy.org/doc/stable/reference/generated/numpy.linalg.inv.html; numpy.org/doc/stable/reference/generated/numpy.linalg.solve.html; numpy.org/doc/stable/reference/generated/numpy.linalg.cond.html; numpy.org/doc/stable/reference/generated/numpy.linalg.pinv.html
- LAPACK. DGESV: solução de sistemas lineares A·X = B. Documentação de referência, netlib. Acesso em 2 out. 2026. netlib.org/lapack/lapack-3.1.1/html/dgesv.f.html
- Moler, Cleve B. Numerical Computing with MATLAB. SIAM, 2004. Cap. 2, Linear Equations. doi.org/10.1137/1.9780898717952
- Bishop, Christopher M. Pattern Recognition and Machine Learning. Springer, 2006. microsoft.com/en-us/research/publication/pattern-recognition-machine-learning
- Penrose, Roger. A generalized inverse for matrices. Mathematical Proceedings of the Cambridge Philosophical Society, v. 51, n. 3, p. 406–413, 1955. doi.org/10.1017/S0305004100030401
- Hinton, Geoffrey E.; Salakhutdinov, Ruslan R. Reducing the Dimensionality of Data with Neural Networks. Science, v. 313, n. 5786, p. 504–507, 2006. doi.org/10.1126/science.1127647
- Dinh, Laurent; Sohl-Dickstein, Jascha; Bengio, Samy. Density estimation using Real NVP. International Conference on Learning Representations (ICLR), 2017. arxiv.org/abs/1605.08803

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/08-matriz-inversa-desfazendo-transformacoes.md.