
Regressão linear e mínimos quadrados: o primeiro modelo supervisionado
Ajustar, resolver e auditar a regressão linear: mínimos quadrados como projeção, solução numérica estável, baseline e diagnóstico pelos resíduos.

Ajustar, resolver e auditar o primeiro modelo supervisionado clássico: mínimos quadrados como projeção, solução numérica estável, avaliação contra um baseline e diagnóstico pelos resíduos. Pré-requisitos: Aula 02 — Do problema ao experimento e Aula 03 — Pré-processamento, pipelines e data leakage; vetores, matrizes e produto escalar; média e variância.
Toda tarde, a equipe de operação de um prédio comercial precisa de um número: quantos kWh o edifício vai consumir amanhã. Com ele se decide a programação da climatização, a contratação de demanda e o alerta de consumo anormal. As informações disponíveis na véspera são poucas e conhecidas: temperatura prevista, ocupação planejada, umidade. A pergunta não é só “qual o número”, mas também “por que esse número” e “quando não confiar nele”.
Uma regressão linear responde às três. Ela produz a previsão, mostra como cada variável entra na conta e, pelos próprios erros, denuncia quando a hipótese linear não basta. Por isso é o melhor primeiro modelo supervisionado da série: junta álgebra linear, otimização, estatística e avaliação fora da amostra num objeto pequeno o bastante para ser auditado linha a linha. No artigo anterior, protegemos a fronteira de fit com um pipeline. Aqui, usamos esse protocolo para ajustar o modelo. Ao final, você vai conseguir escrever o problema em forma matricial conferindo os shapes, derivar as equações normais, enxergar mínimos quadrados como projeção, resolver com lstsq sem inverter matrizes, reconhecer quando os coeficientes deixam de ser confiáveis, bater um baseline no teste e ler os resíduos sem confundir associação com causa.
1. O problema de previsão
Para cada dia, temos temperatura, ocupação e umidade, e queremos prever o consumo em kWh. Com $p$ features, a regressão linear prevê uma observação como uma soma ponderada:
$$ \widehat y=\beta_0+\beta_1x_1+\beta_2x_2+\cdots+\beta_px_p. $$
Aqui, $\widehat y$ é a previsão, $\beta_0$ é o intercepto, $\beta_j$ é o coeficiente da feature $j$ e $x_j$ é o valor observado dessa feature.
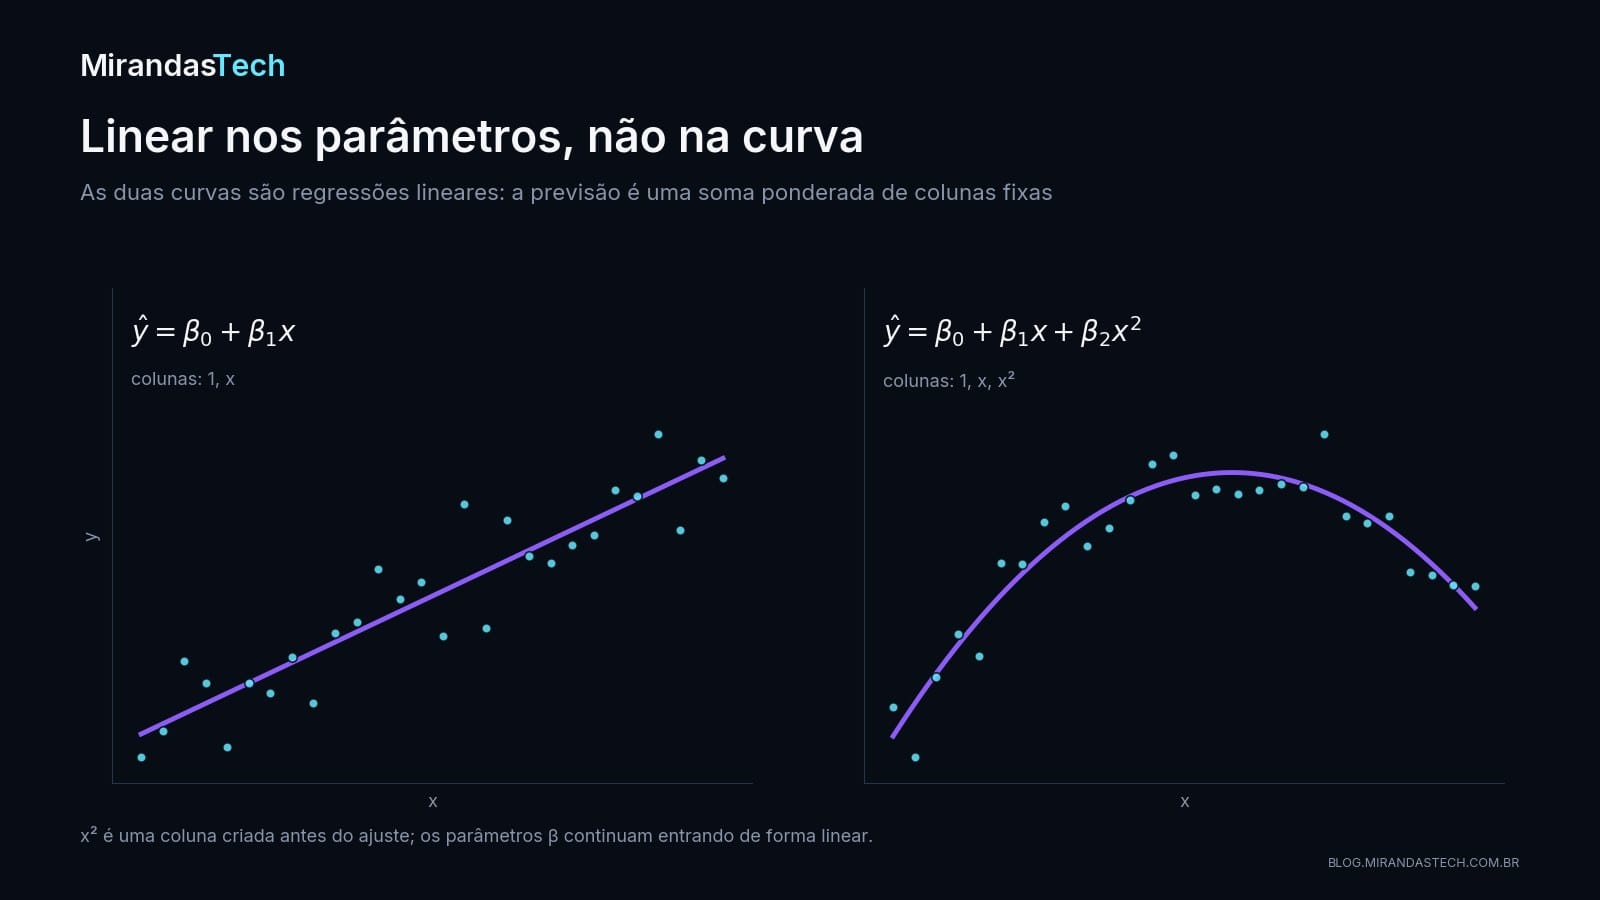
O modelo é linear nos parâmetros, não necessariamente na curva. As features podem incluir transformações definidas antes do ajuste, como $x^2$, $\log x$ ou interações. Por exemplo,
$$ \widehat y=\beta_0+\beta_1x+\beta_2x^2 $$
continua sendo uma regressão linear em $\beta_0,\beta_1,\beta_2$, embora a curva prevista não seja uma reta em $x$: basta tratar $x^2$ como mais uma coluna. Como criar boas colunas é assunto de feature engineering, mais adiante na série; aqui trabalhamos com a representação já definida.
2. Forma matricial e shapes
Com $n$ observações e $p$ features, empilhamos tudo numa matriz de projeto $X$ e incluímos uma coluna de uns para o intercepto. É a mesma equação $y=Wx+b$ de matrizes como transformações, com o bias absorvido pela coluna de uns:
$$ X= \begin{bmatrix} 1 & x_{11} & \cdots & x_{1p}\\ 1 & x_{21} & \cdots & x_{2p}\\ \vdots & \vdots & \ddots & \vdots\\ 1 & x_{n1} & \cdots & x_{np} \end{bmatrix}, $$
$$ \beta= \begin{bmatrix} \beta_0\\ \beta_1\\ \vdots\\ \beta_p \end{bmatrix}, \qquad \widehat y=X\beta. $$
Cada linha de $X$ é uma observação (um dia); cada coluna, uma feature. O produto $X\beta$ calcula, de uma vez, a previsão de todos os dias.
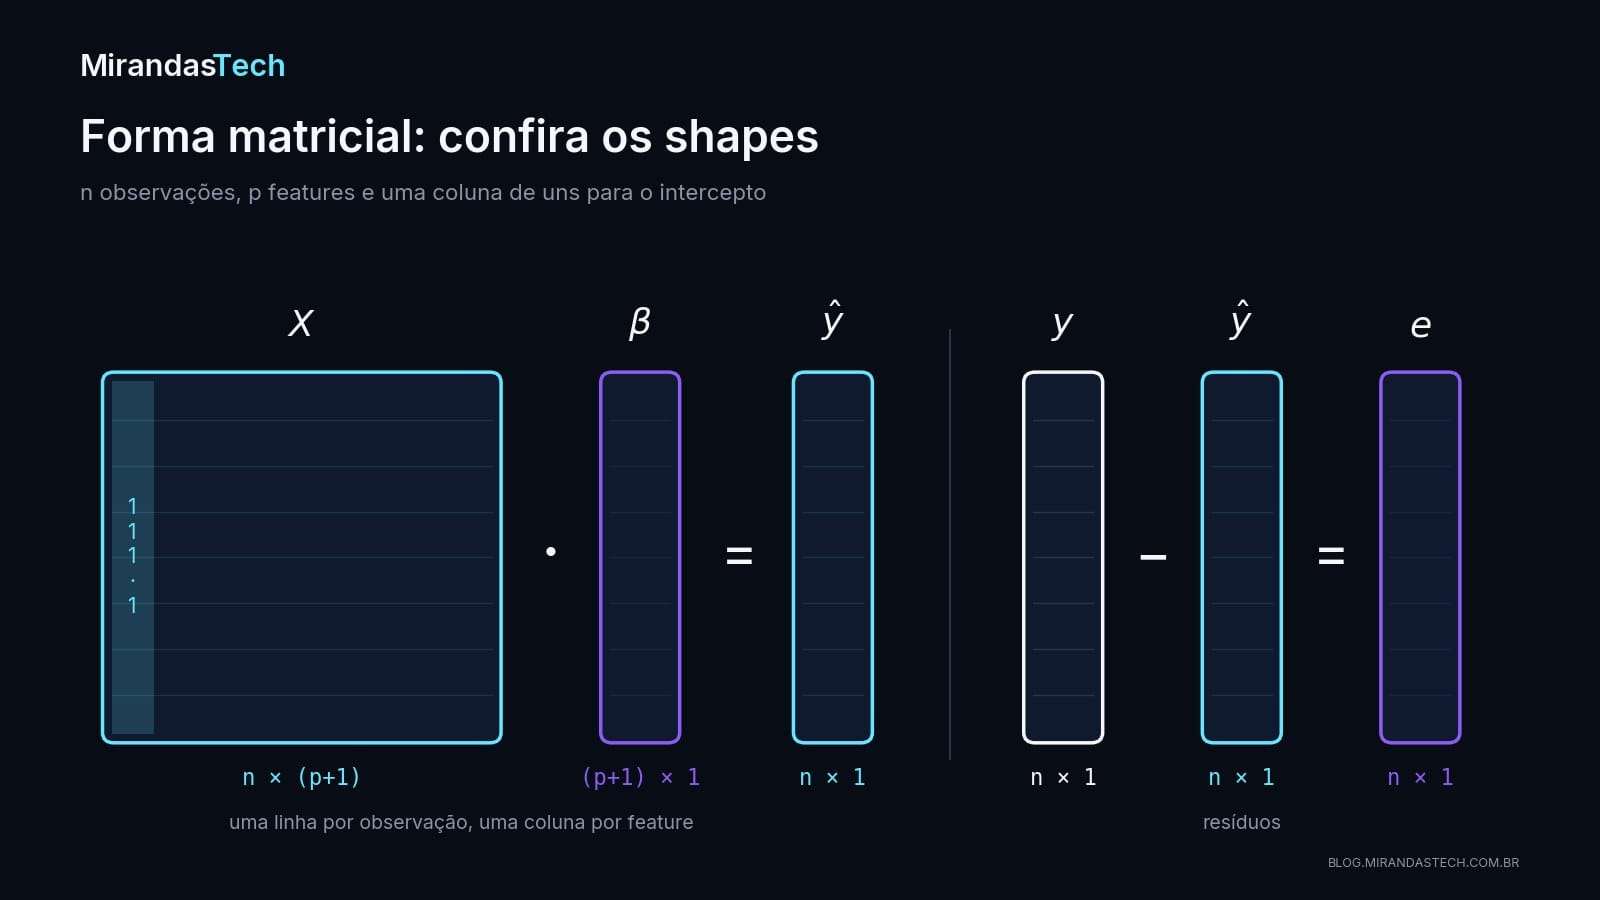
- $X$: $n\times(p+1)$, matriz de projeto com intercepto;
- $\beta$: $(p+1)\times1$, parâmetros;
- $y$ e $\widehat y$: $n\times1$, respostas observadas e previsões;
- $e=y-\widehat y$: $n\times1$, resíduos.
No scikit-learn, X deve ser bidimensional mesmo com uma única feature (use x.reshape(-1, 1)), e y costuma ter shape (n,). O LinearRegression cuida do intercepto por conta própria; com NumPy puro, a coluna de uns é sua responsabilidade.
3. O que significa cada coeficiente
Mantendo as outras features do modelo constantes, $\beta_j$ é a variação prevista em $y$ para uma unidade adicional de $x_j$. Suponha que o modelo ajustado, com temperatura em °C e ocupação como taxa de 0 a 1, seja:
$$ \widehat{\text{consumo}}=120+3{,}5\cdot\text{temp.}+18\cdot\text{ocup.} $$
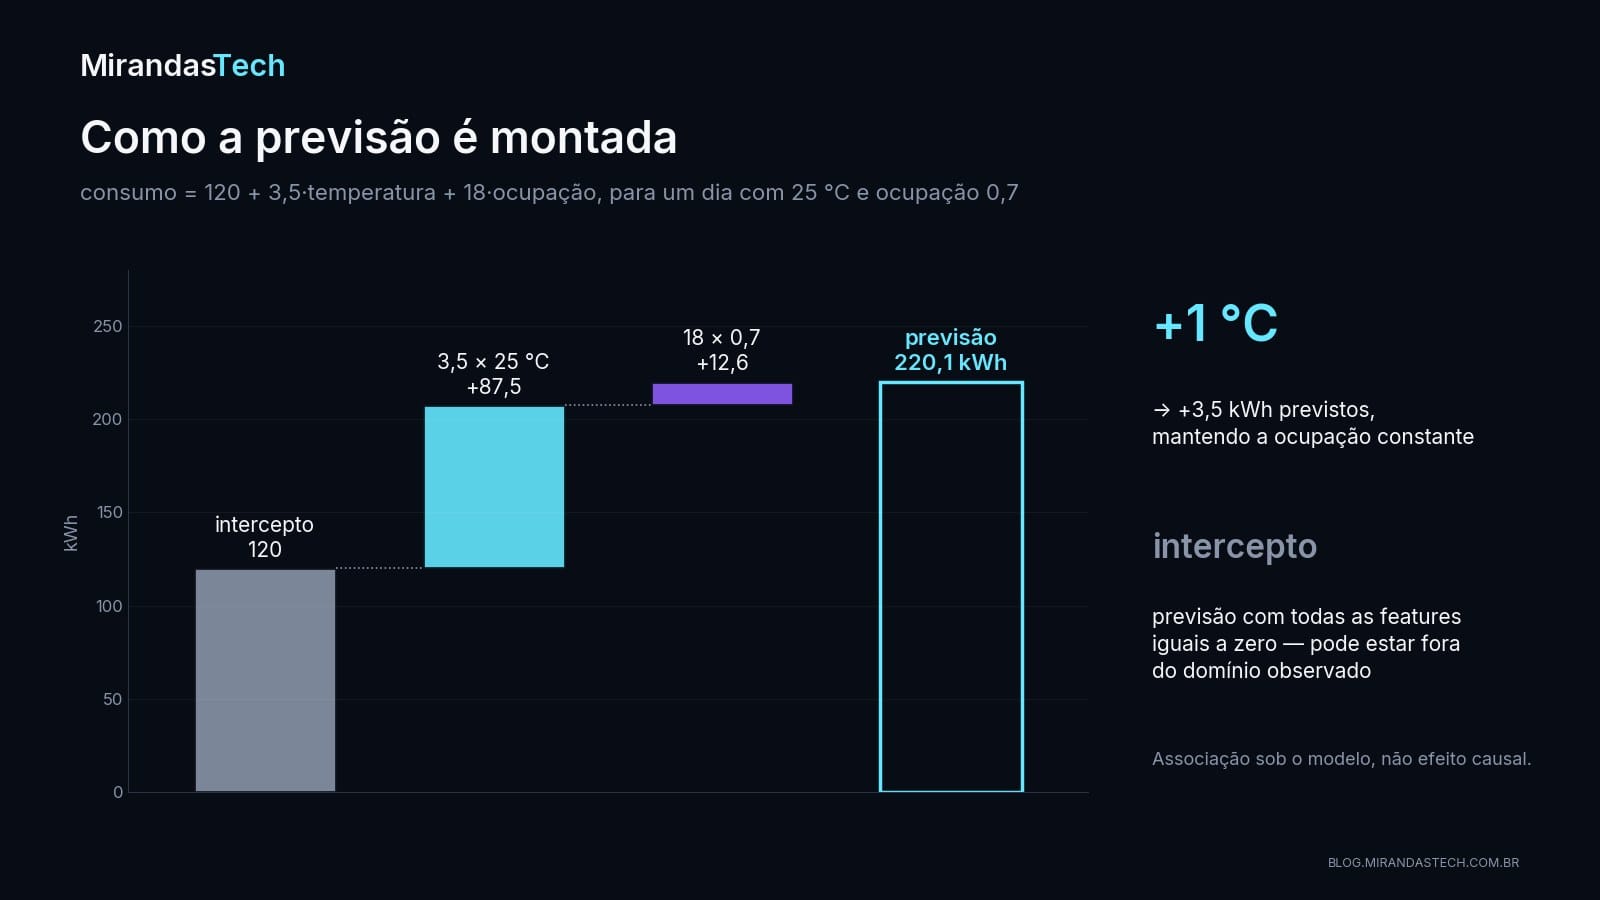
Sob esse modelo, 1 °C a mais está associado a 3,5 kWh a mais, mantendo a ocupação constante; uma unidade a mais na escala de ocupação está associada a 18 kWh; e 120 kWh é a previsão quando temperatura e ocupação valem zero. Esse último número pode não ter interpretação física: “zero grau e prédio vazio” pode estar fora de tudo o que foi observado. Centralizar as features (subtrair a média do treino) torna o intercepto a previsão de um dia típico.
Coeficientes dependem de unidade, codificação e do conjunto de variáveis incluídas. Medir uma feature em milhares de reais em vez de reais multiplica seu coeficiente por mil sem mudar nenhuma previsão. Incluir uma variável correlacionada com outra pode mudar os dois coeficientes sem alterar muito o que o modelo prevê. Por isso, “o coeficiente é 3,5” só significa algo acompanhado de “por unidade de quê” e “com quais outras variáveis no modelo”.
4. A função de perda
Para cada observação, o resíduo é a diferença entre o observado e o previsto, $e_i=y_i-\widehat y_i$. Mínimos quadrados ordinários (OLS, ordinary least squares) escolhe o $\beta$ que minimiza a soma dos quadrados desses resíduos:
$$ \begin{aligned} \widehat\beta &=\arg\min_{\beta}\operatorname{SSE}(\beta)\\ &=\arg\min_{\beta}\sum_{i=1}^{n}(y_i-x_i^T\beta)^2\\ &=\arg\min_{\beta}\lVert y-X\beta\rVert_2^2. \end{aligned} $$
Aqui, $x_i^T$ é a linha $i$ de $X$, $\lVert\cdot\rVert_2$ é a norma Euclidiana e SSE (sum of squared errors, também chamada RSS) é a soma dos resíduos ao quadrado. O critério tem mais de dois séculos, e sua invenção é objeto de uma das disputas de prioridade mais famosas da estatística, entre Legendre e Gauss (Stigler, 1981).
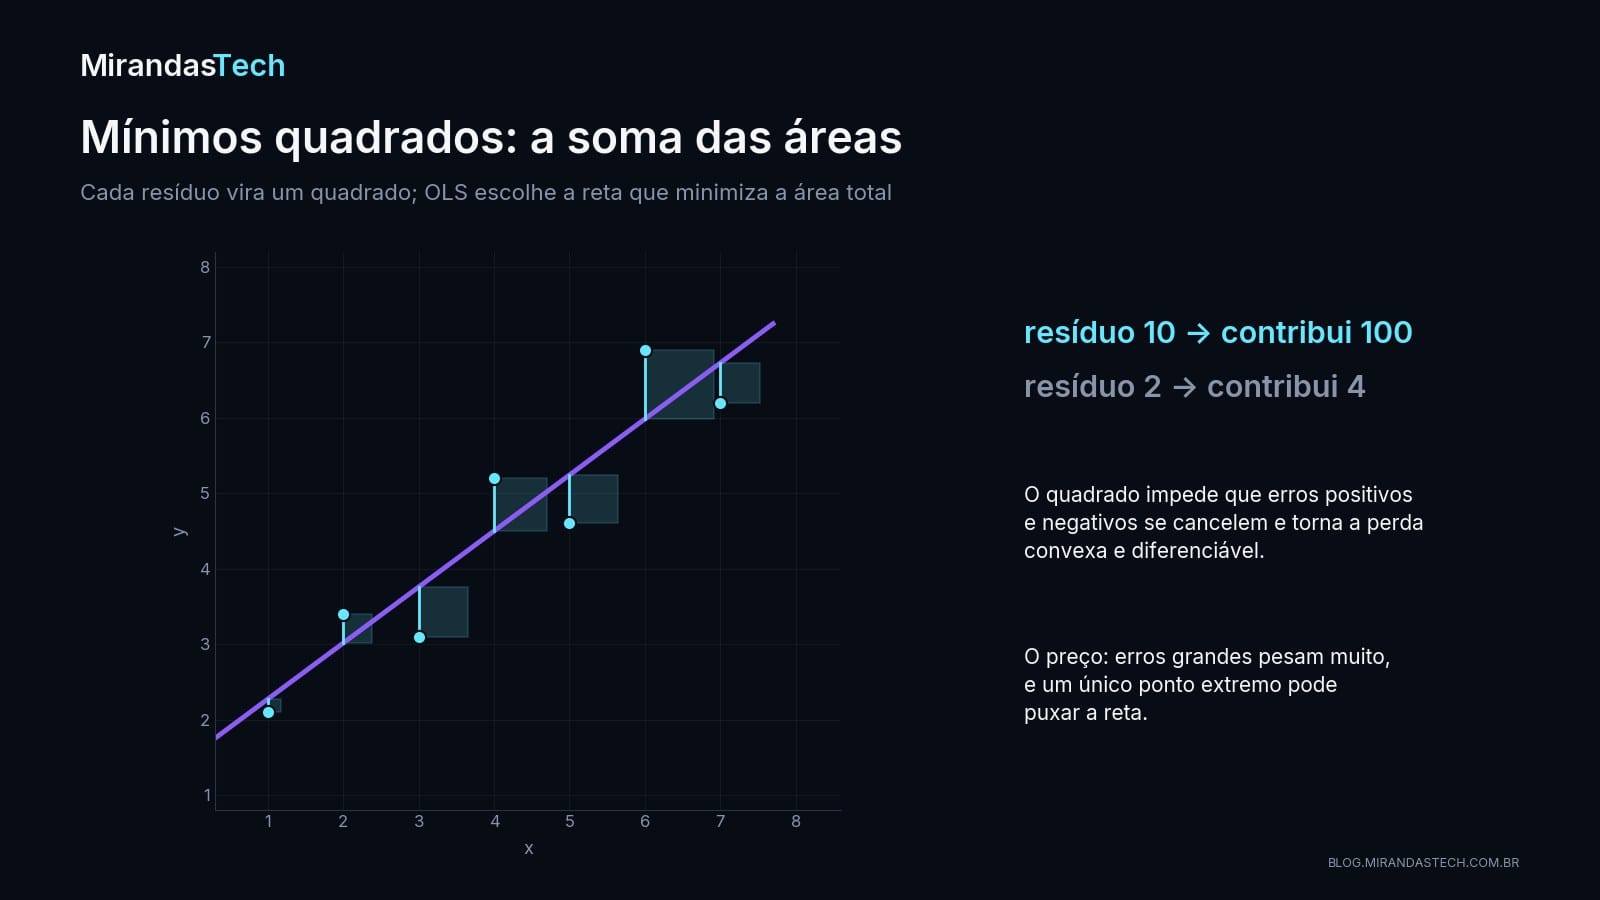
Elevar ao quadrado tem quatro consequências:
- impede que erros positivos e negativos se cancelem;
- penaliza erros grandes de forma quadrática;
- produz uma função convexa e diferenciável, com solução fechada;
- sob ruído Gaussiano independente, com variância constante, coincide com a estimativa de máxima verossimilhança (Hastie et al., 2009).
O preço é a sensibilidade a outliers: um resíduo de magnitude 10 contribui 100 para a SSE; um de magnitude 2, apenas 4. O MSE divide a SSE por $n$ e o RMSE tira a raiz; esses fatores não mudam o minimizador, mas mudam a unidade e a escala do número que você reporta.
5. Exemplo resolvido passo a passo
Considere os pontos $(0,1)$, $(1,3)$ e $(2,5)$. A matriz de projeto e o vetor de respostas são:
$$ X= \begin{bmatrix} 1&0\\ 1&1\\ 1&2 \end{bmatrix}, \qquad y= \begin{bmatrix} 1\\3\\5 \end{bmatrix}. $$
A cada unidade de $x$, $y$ cresce 2; quando $x=0$, $y=1$. O candidato é $\widehat y=1+2x$, ou seja, $\widehat\beta=[1;\,2]$. As previsões $X\widehat\beta=[1,3,5]$ coincidem com $y$, os resíduos são zero e a SSE também.
Agora troque o último alvo de 5 para 8. Nenhuma reta passa pelos três pontos, e a solução OLS passa a ser:
$$ \widehat y=0{,}5+3{,}5x. $$
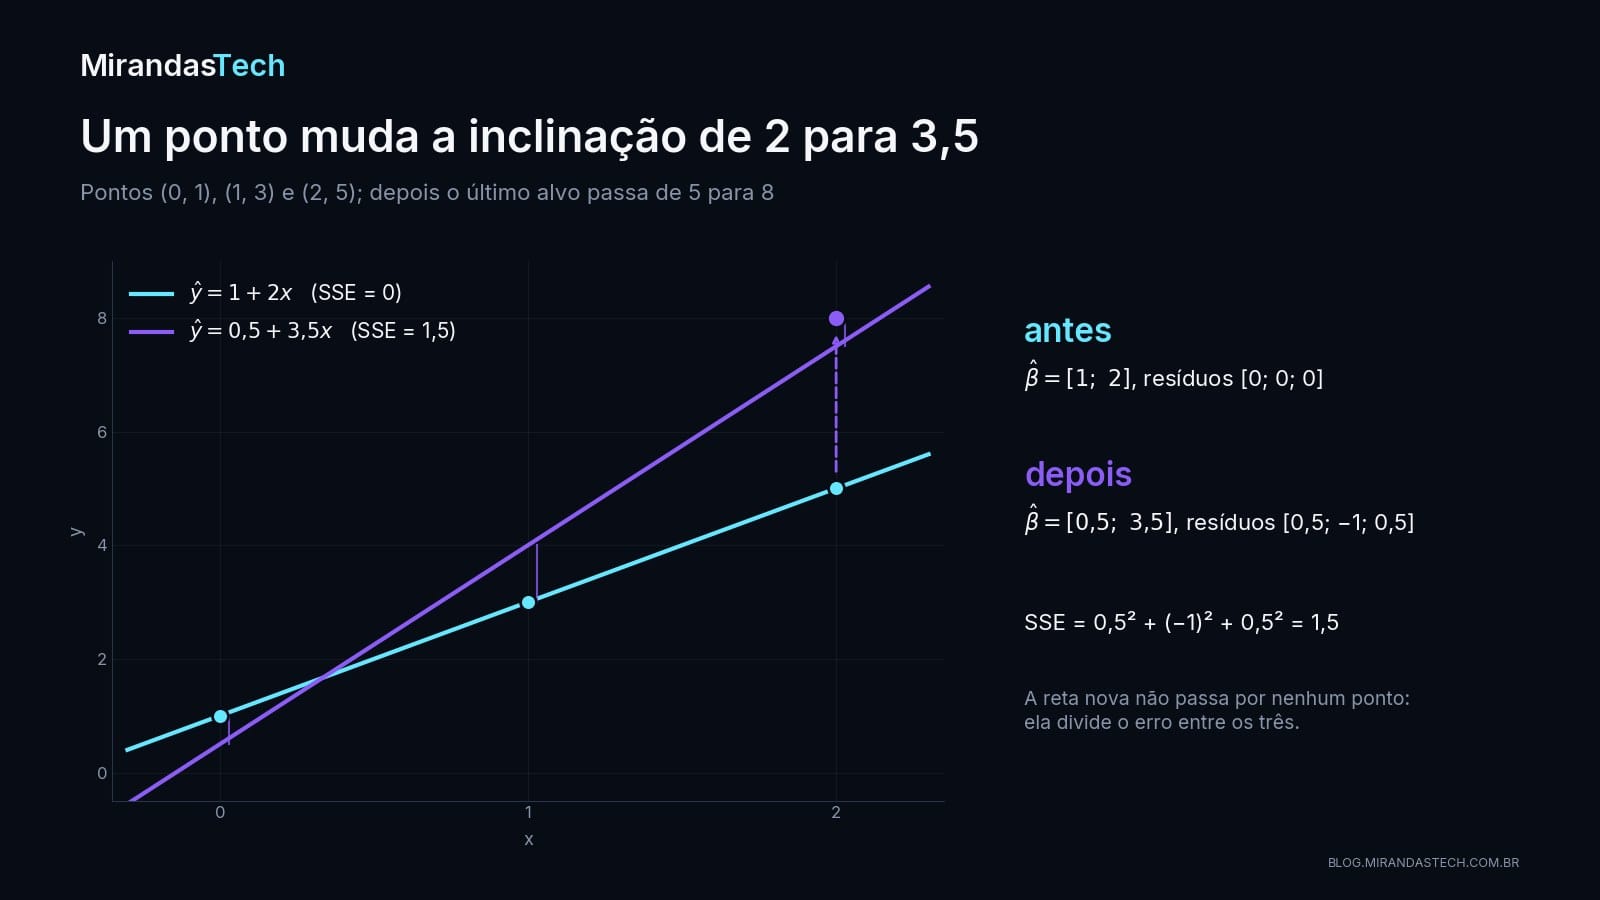
As previsões são $[0{,}5;\,4;\,7{,}5]$, os resíduos $[0{,}5;\,-1;\,0{,}5]$ e
$$ \operatorname{SSE}=0{,}5^2+(-1)^2+0{,}5^2=1{,}5. $$
Um único valor alterou a inclinação de 2 para 3,5. O exemplo é pequeno, mas mostra a influência quadrática de uma observação extrema. Conferindo com NumPy:
import numpy as np

X = np.array([[1, 0], [1, 1], [1, 2]], dtype=float)   # coluna de uns + x
for y in (np.array([1., 3., 5.]), np.array([1., 3., 8.])):
    beta, *_ = np.linalg.lstsq(X, y, rcond=None)
    e = y - X @ beta
    print("y =", y, "-> beta =", beta.round(3), "| resíduos =", e.round(3),
          "| SSE =", round(float(e @ e), 3))
y = [1. 3. 5.] -> beta = [1. 2.] | resíduos = [0. 0. 0.] | SSE = 0.0
y = [1. 3. 8.] -> beta = [0.5 3.5] | resíduos = [ 0.5 -1.   0.5] | SSE = 1.5
6. Derivando as equações normais
O exemplo acima foi resolvido “no olho”. Para o caso geral, escrevemos a perda em forma matricial e a expandimos:
$$ \begin{aligned} J(\beta)&=(y-X\beta)^T(y-X\beta)\\ &=y^Ty-2\beta^TX^Ty+\beta^TX^TX\beta. \end{aligned} $$
O gradiente em relação a $\beta$ é:
$$ \nabla_{\beta}J(\beta)=2X^T(X\beta-y). $$
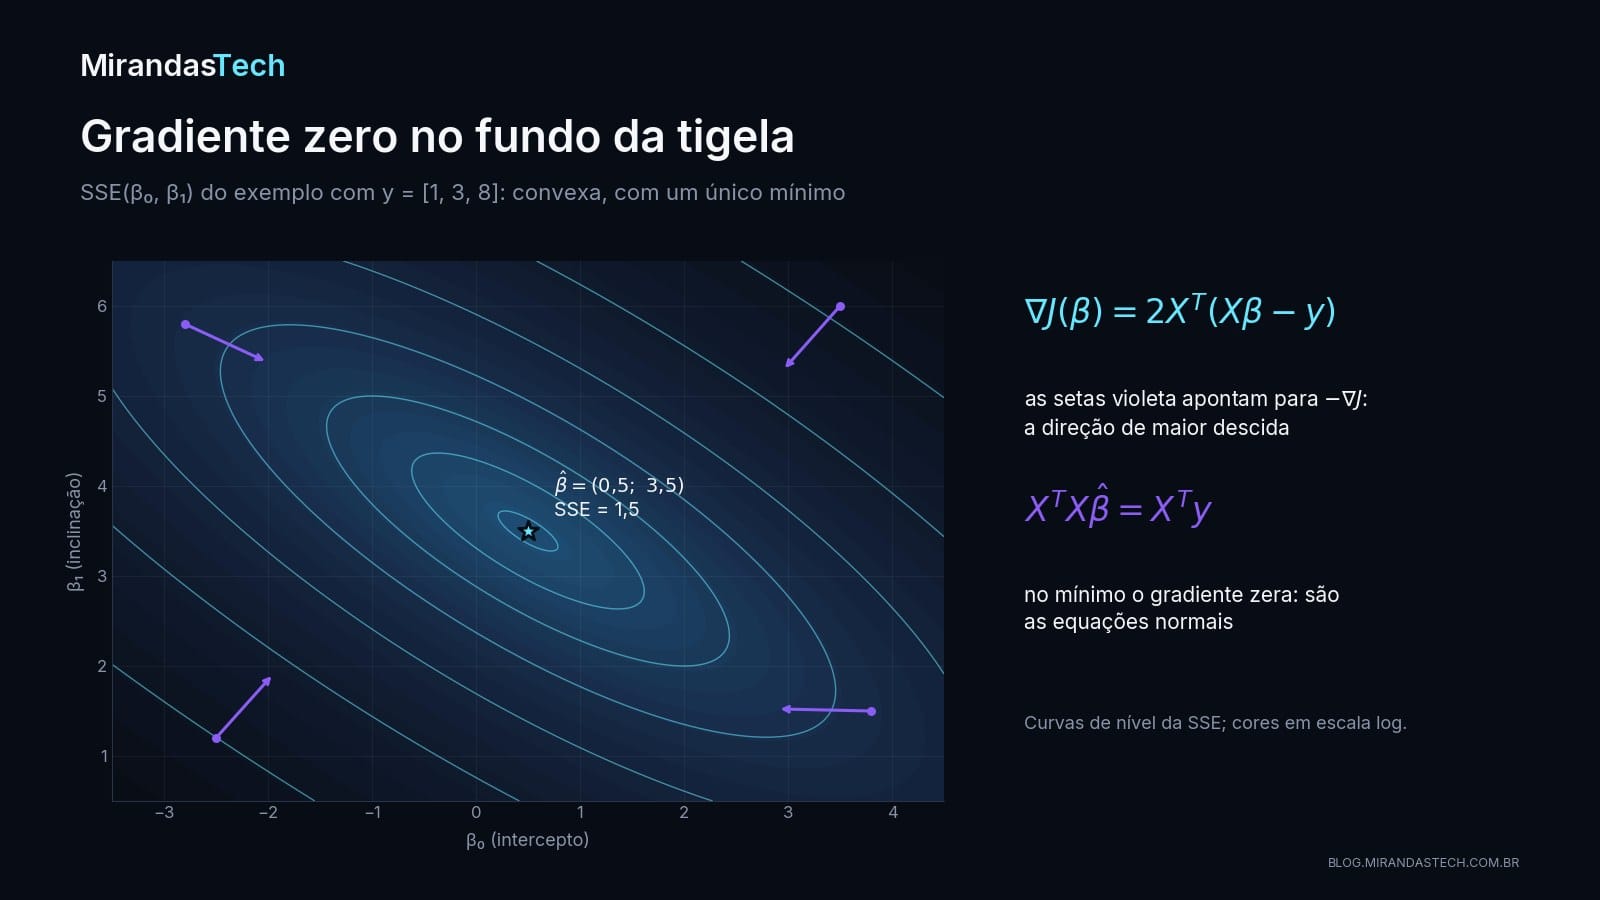
No mínimo, o gradiente vale zero:
$$ X^T(X\widehat\beta-y)=0 \quad\Longrightarrow\quad X^TX\widehat\beta=X^Ty. $$
Essas são as equações normais. Se as colunas de $X$ são linearmente independentes, $X^TX$ é inversível e podemos escrever:
$$ \widehat\beta=(X^TX)^{-1}X^Ty. $$
A expressão explica a solução, mas não é uma receita de cálculo. Formar $X^TX$ eleva ao quadrado o número de condição do problema, e a inversa explícita amplifica erros de arredondamento; fatorações QR e SVD resolvem o mesmo problema com mais estabilidade (Ford, 2015; Hastie et al., 2009, §3.9). Em NumPy, a rotina é numpy.linalg.lstsq:
beta, residuals, rank, singular_values = np.linalg.lstsq(X, y, rcond=None)
Além dos coeficientes, ela devolve o posto de $X$ e seus valores singulares, que servem de diagnóstico na seção 8.
7. A geometria: projeção ortogonal
O vetor de previsões $\widehat y=X\widehat\beta$ é sempre uma combinação das colunas de $X$: pertence ao espaço gerado por elas. OLS procura, nesse espaço, o ponto mais próximo de $y$. Esse ponto é a projeção ortogonal de $y$ sobre o espaço das colunas (Hastie et al., 2009).
A condição das equações normais, reescrita, diz exatamente isso:
$$ X^T(y-X\widehat\beta)=X^Te=0. $$
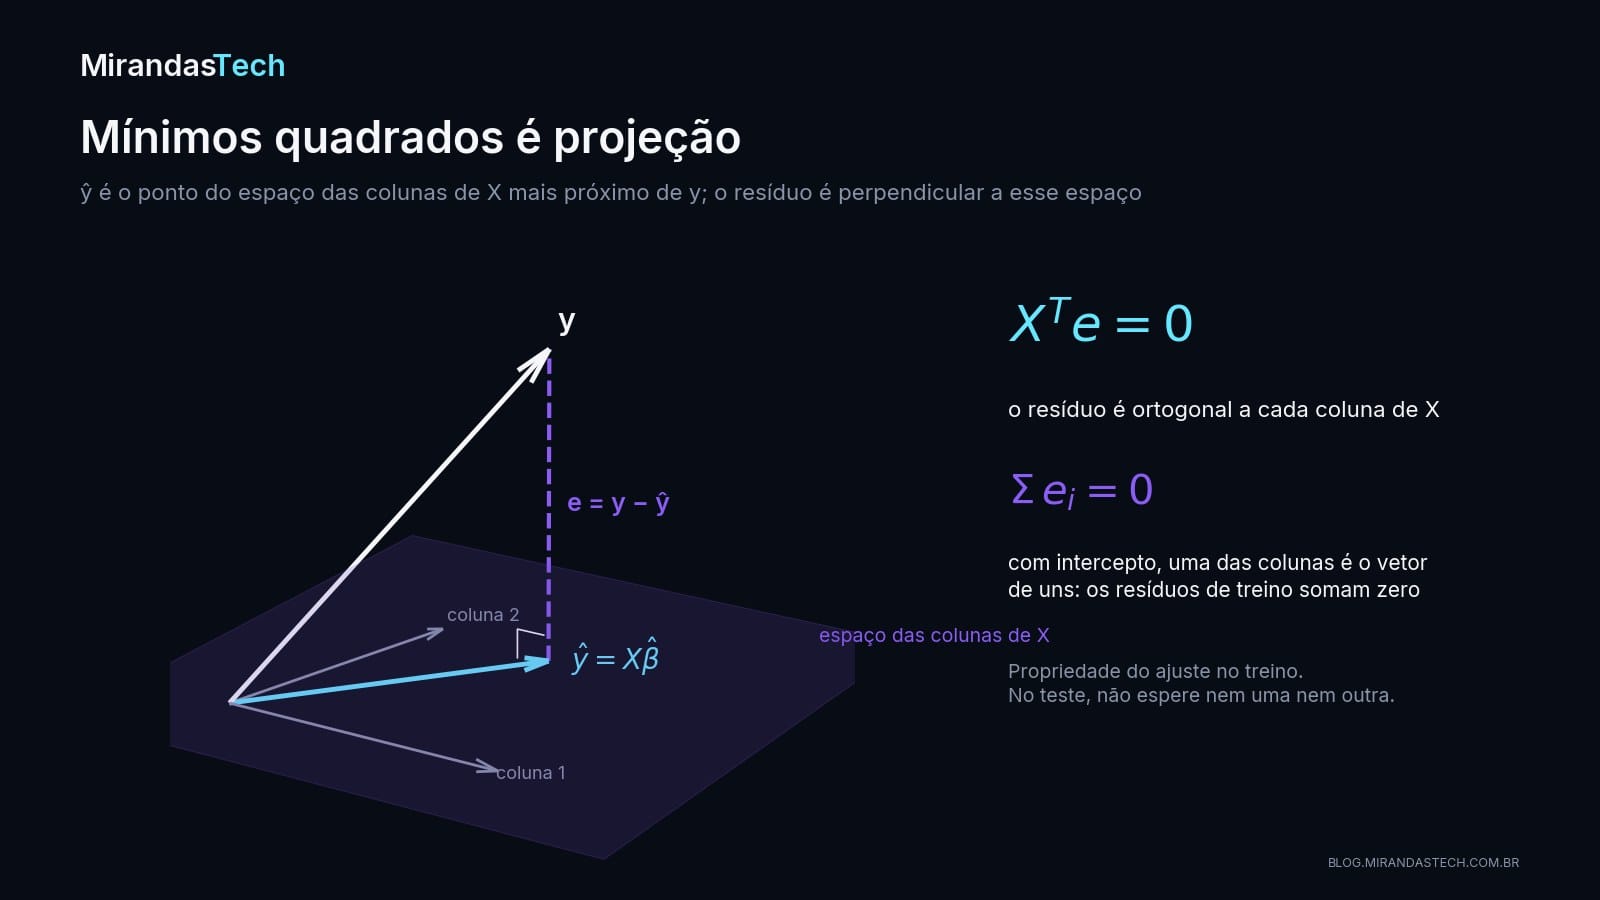
O resíduo é ortogonal a cada coluna de $X$: nenhuma direção que o modelo consegue representar reduz ainda mais o erro. Com intercepto, uma das colunas é o vetor de uns, e o produto interno do resíduo com ela é a soma dos resíduos:
$$ \sum_{i=1}^{n}e_i=0. $$
Na prática, “zero” significa zero até o erro de arredondamento. No laboratório da seção 11, o maior valor de $|X^Te|$ no treino é da ordem de $10^{-9}$. Atenção: a ortogonalidade é propriedade do ajuste no treino. Não espere soma zero nem ortogonalidade no teste.
8. Quando a solução não é única
Se uma coluna é combinação linear exata de outras, $X$ tem posto deficiente. Exemplo: incluir a temperatura em °C e a mesma temperatura em °F junto com o intercepto. Como $F=1{,}8C+32$, a coluna em °F é combinação da coluna em °C e da coluna de uns. Existem então infinitos vetores $\beta$ com exatamente as mesmas previsões, embora os valores ajustados continuem sendo a mesma projeção (Hastie et al., 2009, §3.2). A pseudoinversa, via SVD, devolve a solução de menor norma, mas os coeficientes envolvidos na dependência (aqui, intercepto, °C e °F) deixam de ser identificáveis individualmente; os das demais colunas continuam únicos.
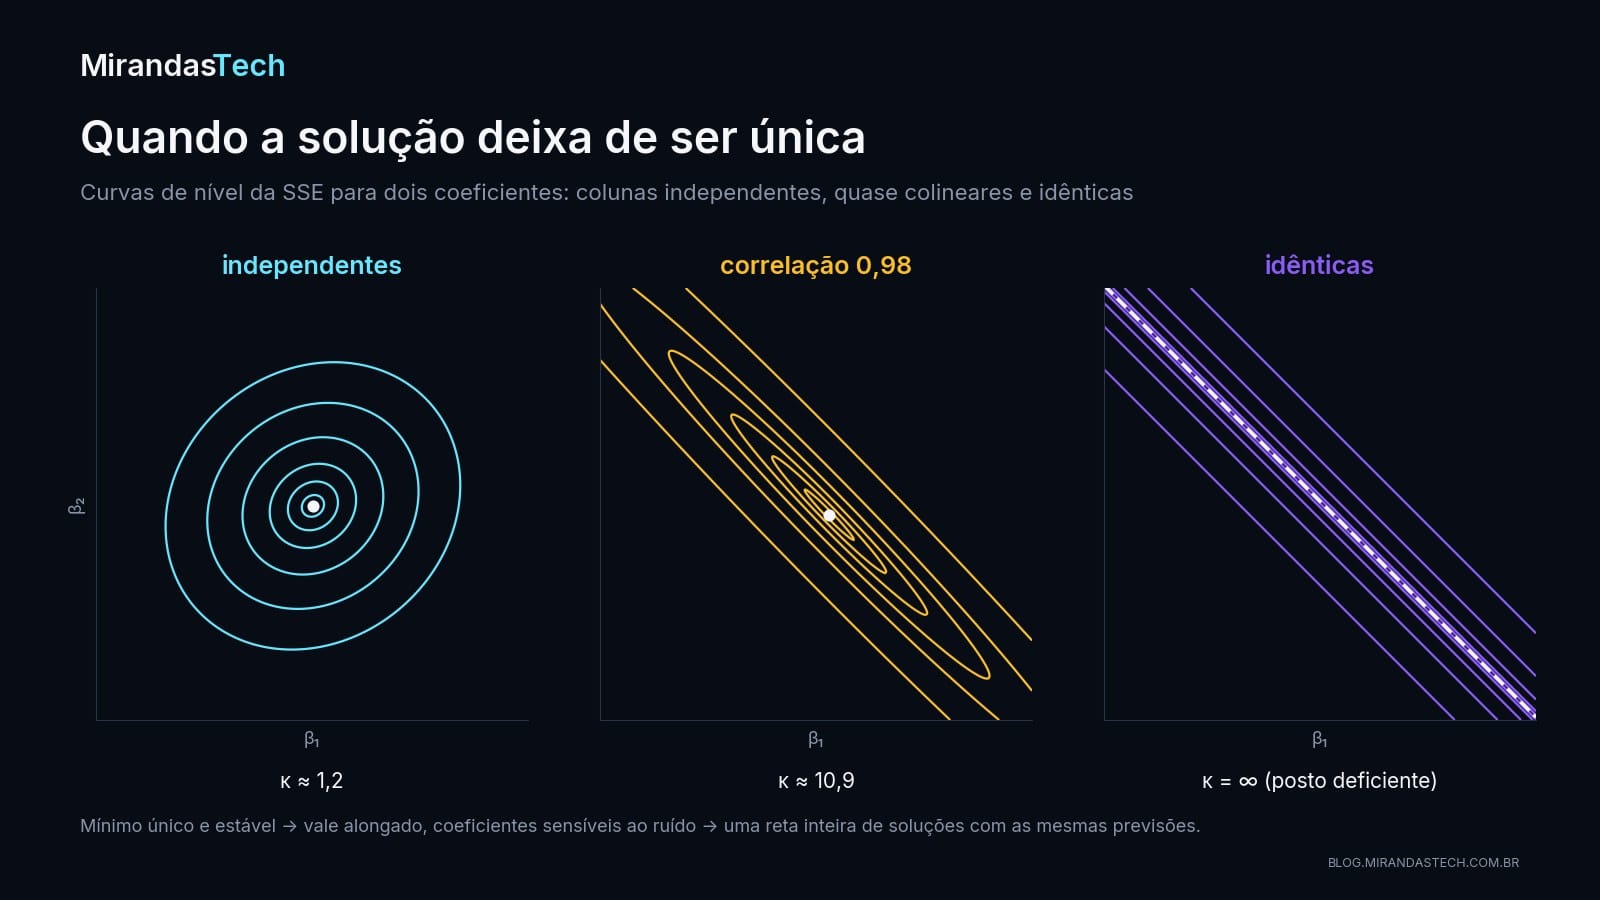
Mesmo sem dependência exata, colunas muito correlacionadas geram multicolinearidade. As consequências:
- pequenos ruídos nos dados alteram muito os coeficientes;
- sinais e magnitudes tornam-se instáveis;
- previsões dentro da região observada podem continuar razoáveis;
- extrapolação e interpretação tornam-se frágeis.
Com muitas variáveis correlacionadas, os coeficientes ficam mal determinados e com alta variância (Hastie et al., 2009, §3.4.1).
Colinearidade reduz a precisão das estimativas e infla o erro-padrão de cada coeficiente (James et al., 2021, §3.3.3). O número de condição, calculado com os valores singulares de $X$, mede essa sensibilidade:
$$ \kappa(X)=\frac{\sigma_{\max}}{\sigma_{\min}}. $$
Aqui, $\sigma_{\max}$ e $\sigma_{\min}$ são o maior e o menor valor singular. Quanto maior $\kappa$, maior a amplificação potencial de perturbações. Não existe limiar universal: unidade, precisão numérica e objetivo importam. No laboratório, a matriz original tem posto completo (4 de 4) e número de condição de cerca de 1.294, inflado sobretudo pela diferença de escala entre as colunas: com as features padronizadas no treino, ele cai para cerca de 1,9. Ao acrescentar a temperatura em °F, o posto cai para 4 de 5 e $\kappa$ salta para cerca de $2{,}3\times10^{17}$: dá para mover os coeficientes, sobretudo o intercepto, em até 998 unidades ao longo da direção nula e as previsões mudam só $3\times10^{-12}$ (a saída está na seção 11). No próximo artigo, veremos como a regularização estabiliza esse cenário.
9. Gradiente descendente
Também podemos minimizar o MSE de forma iterativa, sem resolver sistema algum:
$$ \begin{aligned} J(\beta)&=\frac{1}{n}\lVert X\beta-y\rVert_2^2,\\ \nabla J(\beta)&=\frac{2}{n}X^T(X\beta-y), \end{aligned} $$
$$ \beta^{(t+1)}=\beta^{(t)}-\eta\,\nabla J(\beta^{(t)}), $$
onde $\eta$ é a taxa de aprendizado e $t$ indica a iteração. A cada passo, $\beta$ anda um pouco na direção de maior descida da perda.
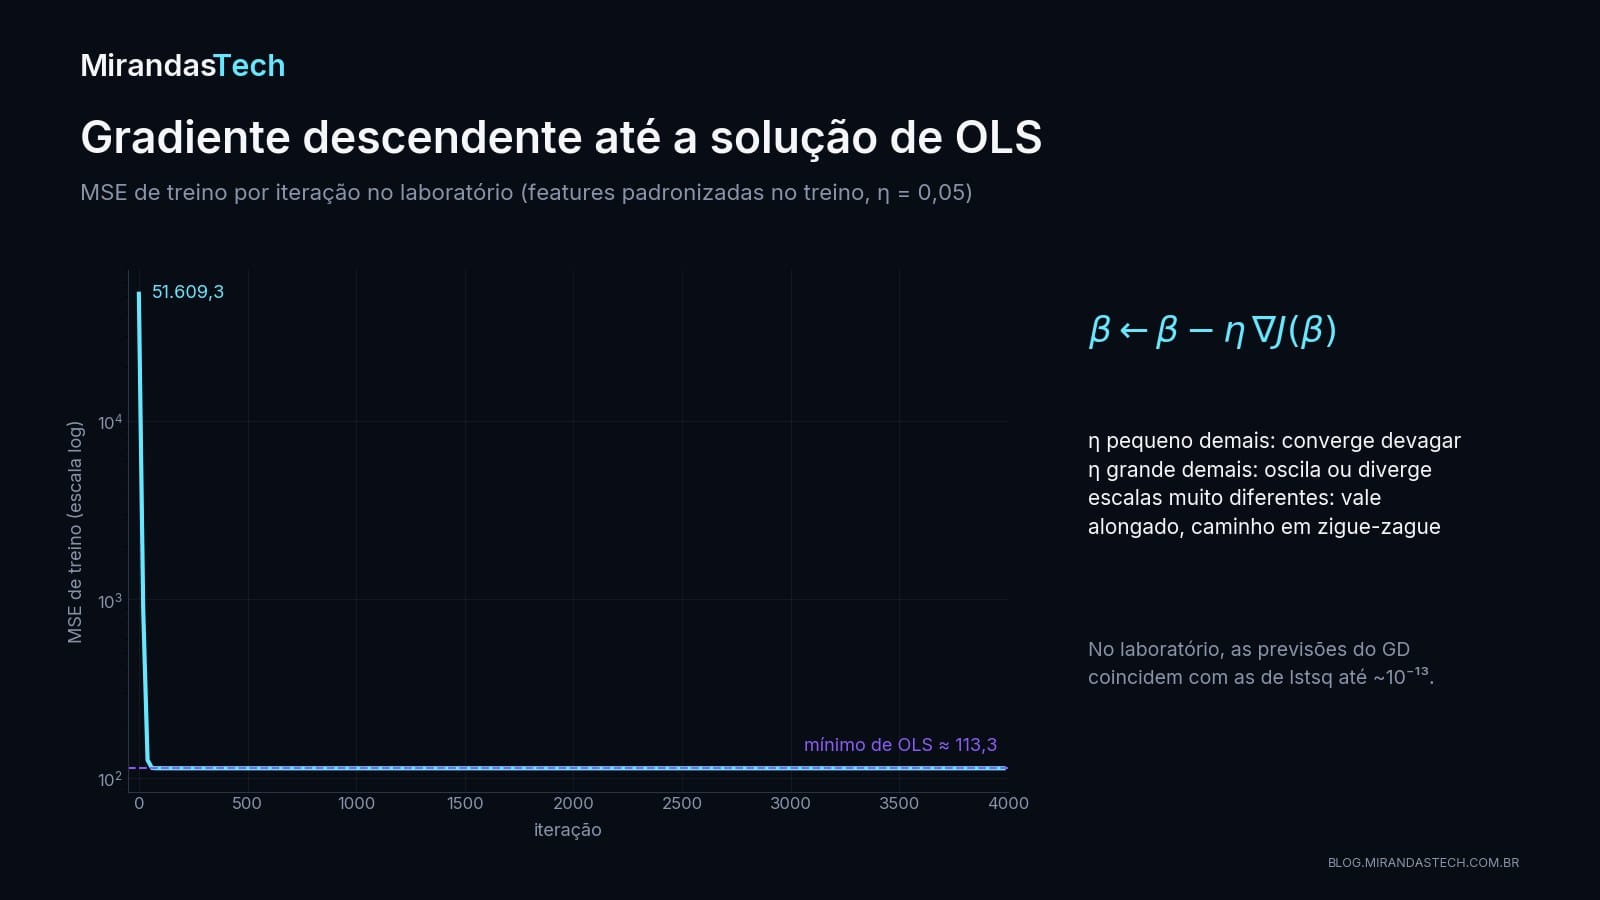
Para um problema pequeno de OLS, lstsq é preferível. O gradiente descendente é didático porque antecipa como modelos maiores, de redes neurais a LLMs, são treinados:
- taxa muito pequena converge devagar;
- taxa muito grande oscila ou diverge;
- features em escalas muito diferentes alongam as curvas de nível e tornam o caminho difícil;
- o critério de parada deve observar o gradiente, a melhoria da perda ou um número máximo de iterações.
Padronizar as features (com média e desvio aprendidos só no treino, como no artigo anterior) melhora o condicionamento do problema iterativo e acelera a convergência (LeCun et al., 2012, §4.3 e §5.3). O intercepto pode ser tratado pela coluna de uns ou separadamente.
10. Avaliação honesta e baseline
OLS minimiza o erro no treino. Isso não garante o menor erro em dados novos. O fluxo correto reutiliza a disciplina das aulas anteriores: primeiro o contrato e a unidade; o split antes de qualquer fit; baseline e pipeline com OLS comparados nas mesmas divisões; configuração congelada; avaliação final no teste, uma única vez; e, por fim, resíduos, limites e relatório.
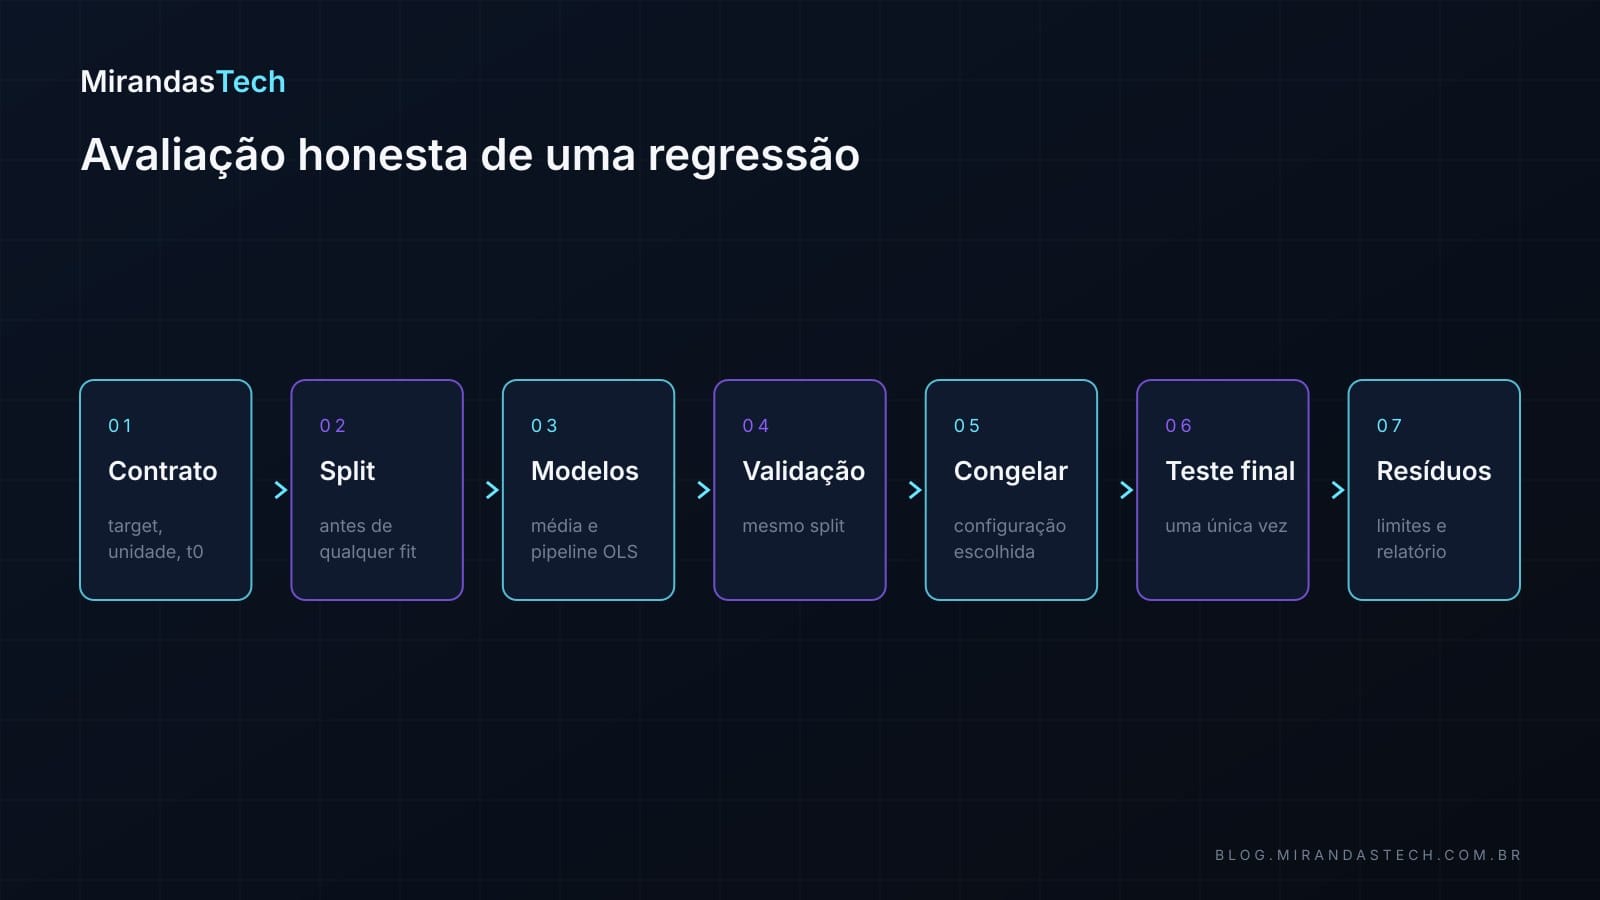
Para regressão, o baseline mais simples prevê a média do target de treino para todos os casos. O modelo precisa mostrar ganho fora da amostra numa métrica coerente com o custo do erro. Use pelo menos:
- MAE, para a magnitude absoluta típica do erro, na unidade do target;
- RMSE, quando erros grandes merecem peso maior;
- $R^2$, como ganho relativo à previsão pela média no mesmo conjunto.
$$ R^2=1-\frac{\sum_i(y_i-\widehat y_i)^2}{\sum_i(y_i-\bar y)^2}, $$
com $\bar y$ a média do mesmo conjunto avaliado. $R^2=0$ equivale a prever essa média; valores negativos significam fazer pior que ela.
As métricas de regressão terão um artigo próprio na série. Aqui, o essencial é comparar no mesmo split, reportar a unidade e nunca escolher configuração pelo teste.
11. Na prática: o consumo de energia do prédio
O laboratório da aula gera 420 dias sintéticos de um prédio. O consumo tem uma parte linear, uma curvatura moderada na temperatura (que um modelo linear nas features brutas não captura) e ruído cuja dispersão cresce nos dias quentes. Os primeiros 80% dos dias formam o treino; os últimos 20%, o teste temporal, reservado antes de qualquer ajuste. Os dados são sintéticos: demonstram mecanismos, não medem um prédio real.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# 1) Dados sintéticos: 420 dias de um prédio, com curvatura e ruído que cresce no calor
SEED = 20260908
rng = np.random.default_rng(SEED)
n = 420
day = np.arange(n)
temperatura = 23 + 7 * np.sin(2 * np.pi * day / 180) + rng.normal(0, 2.2, n)
ocupacao = np.clip(0.62 + 0.18 * np.sin(2 * np.pi * day / 7) + rng.normal(0, 0.08, n), 0.12, 1.0)
umidade = np.clip(68 - 0.65 * (temperatura - 23) + rng.normal(0, 5, n), 35, 92)
ruido = rng.normal(0, 7 + 0.28 * np.maximum(temperatura - 15, 0))
consumo = (115 + 4.2 * temperatura + 82 * ocupacao - 0.65 * umidade
           + 0.22 * (temperatura - 24) ** 2 + ruido)

# 2) Split temporal ANTES de qualquer ajuste: 80% primeiros dias / 20% últimos
X = np.column_stack([temperatura, ocupacao, umidade])
cut = int(0.8 * n)
X_train, X_test, y_train, y_test = X[:cut], X[cut:], consumo[:cut], consumo[cut:]

# 3) Baseline: a média do treino, repetida para todos os dias do teste
baseline = np.full_like(y_test, y_train.mean())

# 4) OLS com lstsq (coluna de uns para o intercepto, sem inversa explícita)
X_design = np.column_stack([np.ones(cut), X_train])
beta, _, rank, sv = np.linalg.lstsq(X_design, y_train, rcond=None)
e_train = y_train - X_design @ beta
print("beta (intercepto, temp, ocup, umid):", beta.round(3))
print("posto:", rank, "| número de condição:", round(sv[0] / sv[-1], 1))
print("max |X^T e| no treino:", f"{np.abs(X_design.T @ e_train).max():.1e}")

# 5) A mesma solução com scikit-learn
sk = LinearRegression().fit(X_train, y_train)
pred = sk.predict(X_test)
print("maior diferença lstsq x sklearn:",
      f"{np.abs(np.column_stack([np.ones(len(X_test)), X_test]) @ beta - pred).max():.1e}")

# 6) Avaliação final no teste reservado, mesmo split para os dois
for nome, p in [("baseline (média)", baseline), ("OLS", pred)]:
    print(f"{nome:17s} MAE={mean_absolute_error(y_test, p):6.2f} kWh"
          f"  RMSE={mean_squared_error(y_test, p) ** 0.5:6.2f} kWh"
          f"  R2={r2_score(y_test, p):6.3f}")
Saída real, com Python 3.13, NumPy 2.2 e scikit-learn 1.9:
beta (intercepto, temp, ocup, umid): [134.676   3.611  76.976  -0.595]
posto: 4 | número de condição: 1294.0
max |X^T e| no treino: 3.8e-09
maior diferença lstsq x sklearn: 1.3e-12
baseline (média)  MAE= 23.19 kWh  RMSE= 28.52 kWh  R2=-0.140
OLS               MAE=  9.18 kWh  RMSE= 11.77 kWh  R2= 0.806
Interpretação
Os coeficientes dizem que, sob este modelo e com as outras features constantes, cada grau a mais está associado a 3,6 kWh a mais, e cada 0,1 a mais na taxa de ocupação, a cerca de 7,7 kWh. O posto completo e $|X^Te|\approx4\times10^{-9}$ confirmam a seção 7; lstsq e LinearRegression concordam até $10^{-12}$.
No teste, o modelo erra em média 9,2 kWh contra 23,2 kWh do baseline, e o RMSE cai de 28,5 para 11,8 kWh. O $R^2$ negativo do baseline não é erro de conta: a média foi aprendida nos dias anteriores (225,5 kWh), e o período de teste tem outro nível de consumo (média de 235,5 kWh). Prever pela média antiga é pior que prever pela média do próprio teste, que é justamente a referência do $R^2$.
O mesmo laboratório tem quatro contraprovas. O bloco abaixo continua do anterior:
# continua do bloco anterior (X_train, y_train, X_design, beta, sk, cut, np, LinearRegression)
from sklearn.preprocessing import StandardScaler

# a) Gradiente descendente em features padronizadas (scaler ajustado só no treino)
Z = np.column_stack([np.ones(cut), StandardScaler().fit(X_train).transform(X_train)])
b = np.zeros(4)
for step in range(4_000):
    grad = (2 / cut) * Z.T @ (Z @ b - y_train)
    b -= 0.05 * grad
b_exato = np.linalg.lstsq(Z, y_train, rcond=None)[0]
print("GD: |gradiente| final =", f"{np.linalg.norm(grad):.1e}",
      "| maior diferença para lstsq =", f"{np.abs(Z @ b - Z @ b_exato).max():.1e}")

# b) Um único ponto extremo: +300 kWh no dia mais quente do treino
i = np.argmax(X_train[:, 0])
y_out = y_train.copy(); y_out[i] += 300
coef_out = LinearRegression().fit(X_train, y_out).coef_[0]
print(f"coef. temperatura: {sk.coef_[0]:.3f} -> {coef_out:.3f}",
      f"({(coef_out / sk.coef_[0] - 1) * 100:+.1f}%)")

# c) Colinearidade exata: a mesma temperatura em °F
X_col = np.column_stack([X_design, 1.8 * X_train[:, 0] + 32])
b_col, _, rank_col, sv_col = np.linalg.lstsq(X_col, y_train, rcond=None)
b_alt = b_col + 1_000 * np.linalg.svd(X_col, full_matrices=False)[2][-1]
print("posto:", rank_col, "de", X_col.shape[1], "| condição:", f"{sv_col[0] / sv_col[-1]:.1e}",
      "| coeficientes mudam até", round(np.abs(b_alt - b_col).max(), 1),
      "| previsões mudam até", f"{np.abs(X_col @ b_alt - X_col @ b_col).max():.1e}")

# d) Extrapolação: 50 °C, fora da faixa vista no treino
caso = [[50.0, np.median(X_train[:, 1]), np.median(X_train[:, 2])]]
print(f"faixa de temperatura no treino: {X_train[:, 0].min():.1f} a {X_train[:, 0].max():.1f} °C",
      f"| previsão a 50 °C: {sk.predict(caso)[0]:.1f} kWh (fora de suporte)")
GD: |gradiente| final = 2.6e-13 | maior diferença para lstsq = 3.4e-13
coef. temperatura: 3.611 -> 4.159 (+15.2%)
posto: 4 de 5 | condição: 2.3e+17 | coeficientes mudam até 997.9 | previsões mudam até 3.1e-12
faixa de temperatura no treino: 9.9 a 34.5 °C | previsão a 50 °C: 322.0 kWh (fora de suporte)
Cada linha fecha uma seção. O gradiente descendente chega à mesma solução de lstsq (seção 9). Um único dia com 300 kWh a mais, justamente o de temperatura mais alta, move o coeficiente de temperatura em 15% (seções 4 e 12). A coluna em °F derruba o posto e deixa os coeficientes livres sem mexer nas previsões (seção 8). E o modelo devolve um número a 50 °C sem reclamar (seção 13).
O notebook registra o protocolo antes de gerar os dados, plota a curva de convergência e os resíduos, e termina com asserts sobre split temporal, posto, ortogonalidade, equivalência entre lstsq, scikit-learn e gradiente descendente, ganho sobre o baseline, colinearidade e alerta de extrapolação.
12. Resíduos como instrumento de diagnóstico
Um RMSE de 11,8 kWh não conta a história toda. Plote os resíduos contra as previsões, contra as features importantes e contra o tempo. É ali que a hipótese linear mostra onde falha.
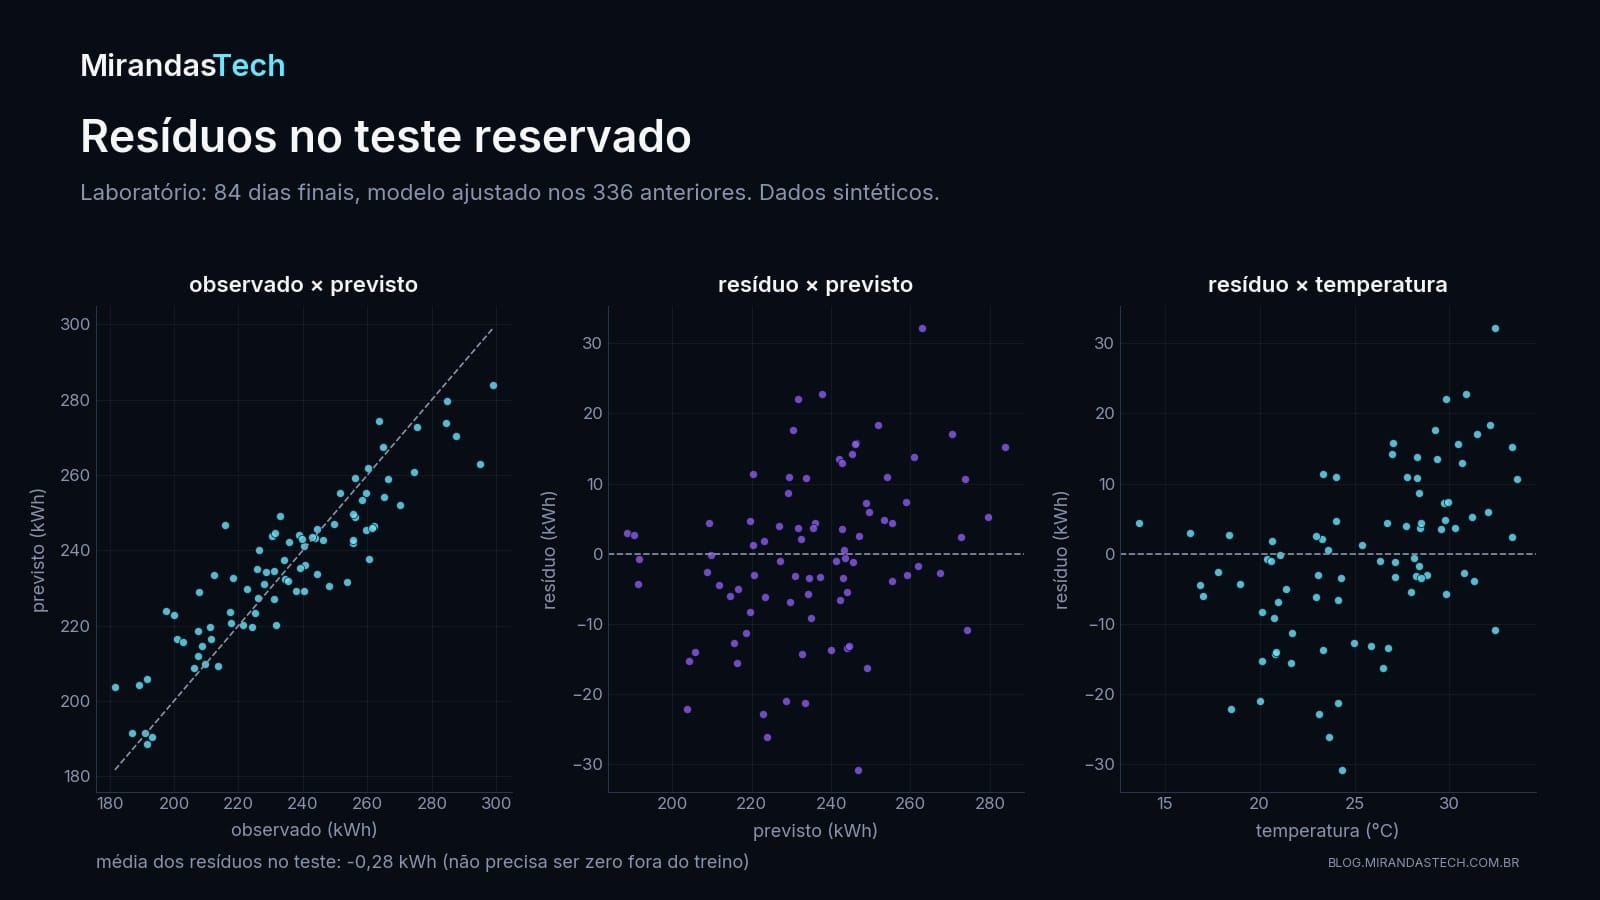
Os padrões mais comuns e o que investigar em cada um:
- curva em U: relação não linear; considere transformar a feature ou usar um modelo não linear;
- funil: a variância muda com o nível previsto; avalie a escala do target ou um modelo para a variância;
- sequência no tempo: autocorrelação ou drift; use split temporal e olhe os resíduos por período;
- poucos resíduos enormes: outliers, erro de dados ou cauda pesada; investigue a proveniência e considere um método robusto;
- grupos deslocados: variável omitida ou efeito por segmento; faça análise de erro estratificada;
- centro fora de zero no teste: viés sob nova distribuição; verifique calibração, drift ou intercepto.
Vale separar o que cada uso exige do modelo. Para prever, basta que a avaliação fora da amostra seja honesta. Erros-padrão clássicos dos coeficientes pedem erros não correlacionados e com variância constante (James et al., 2021, §3.3.3; White, 1980); intervalos e testes exatos pedem também erros Gaussianos (Hastie et al., 2009, §3.2). E a leitura causal de um coeficiente exige hipóteses adicionais sobre confundimento, que a seção 14 discute.
Resíduo não é o mesmo que erro irredutível. Ele mistura ruído, inadequação do modelo, erro de medição e informação omitida.
Heterocedasticidade
Quando a dispersão de $e_i$ muda com $x$ ou com $\widehat y$, temos heterocedasticidade. É o que o laboratório constrói de propósito: o ruído cresce com a temperatura (com 84 dias de teste, o efeito não aparece a olho, o que já é uma lição: ausência de funil no gráfico não prova variância constante). OLS ainda pode produzir previsões úteis, mas os erros-padrão clássicos dos coeficientes deixam de valer, e a inferência exige estimadores robustos (White, 1980). Para previsão, avalie o erro por faixa e considere transformar o target ou usar um modelo adequado.
Outliers e alavancagem
Um ponto com target extremo gera resíduo grande. Um ponto com features longe do centro tem alta alavancagem e pode puxar a reta mesmo terminando com resíduo moderado; a distância de Cook combina as duas coisas para medir a influência de cada observação (Cook, 1977). Foi o que a contraprova mostrou: o dia mais quente do treino, com 300 kWh a mais, alterou o coeficiente de temperatura em 15%. Remover automaticamente é inadequado: investigue origem, validade e população-alvo antes de decidir.
13. Interpolação e extrapolação
O treino do laboratório cobre temperaturas de 9,9 °C a 34,5 °C. Prever a 25 °C é interpolar; prever a 50 °C é extrapolar. A reta continua numericamente e devolve 322,0 kWh, mas nenhum dado validou que a relação permaneça linear naquela região. E, neste caso, sabemos que não permanece: o gerador tem um termo quadrático na temperatura, $0{,}22\,(T-24)^2$, que sozinho acrescentaria cerca de 149 kWh a 50 °C.
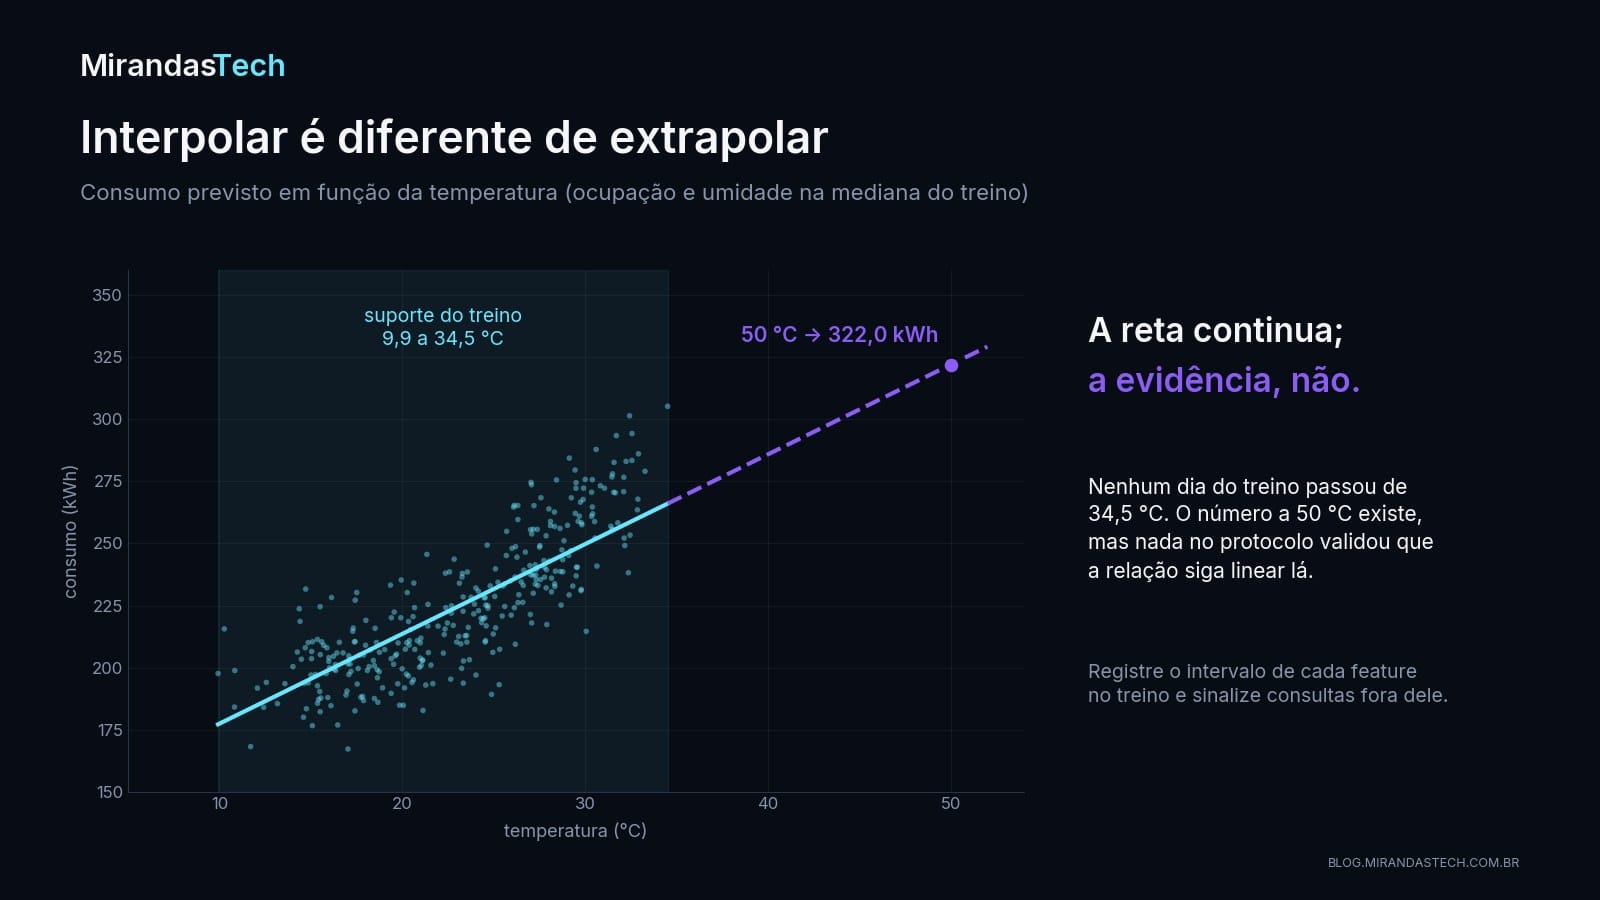
Registre os intervalos de cada feature observados no treino e sinalize previsões fora do suporte. Um $R^2$ alto no teste histórico não autoriza extrapolação arbitrária. Em sistemas de IA, a extrapolação aparece como carga muito acima da operação usual, um perfil de cliente novo, um sensor em faixa inédita ou uma política de preço fora do período de treinamento.
14. Predição não é causalidade
Um coeficiente descreve uma associação condicional ao conjunto de features e ao modelo. Não significa que intervir em $x_j$ causará uma mudança de $\beta_j$ em $y$. Confundimento, causalidade reversa, seleção e variáveis omitidas podem produzir coeficientes excelentes para prever e inúteis para explicar (Shmueli, 2010).
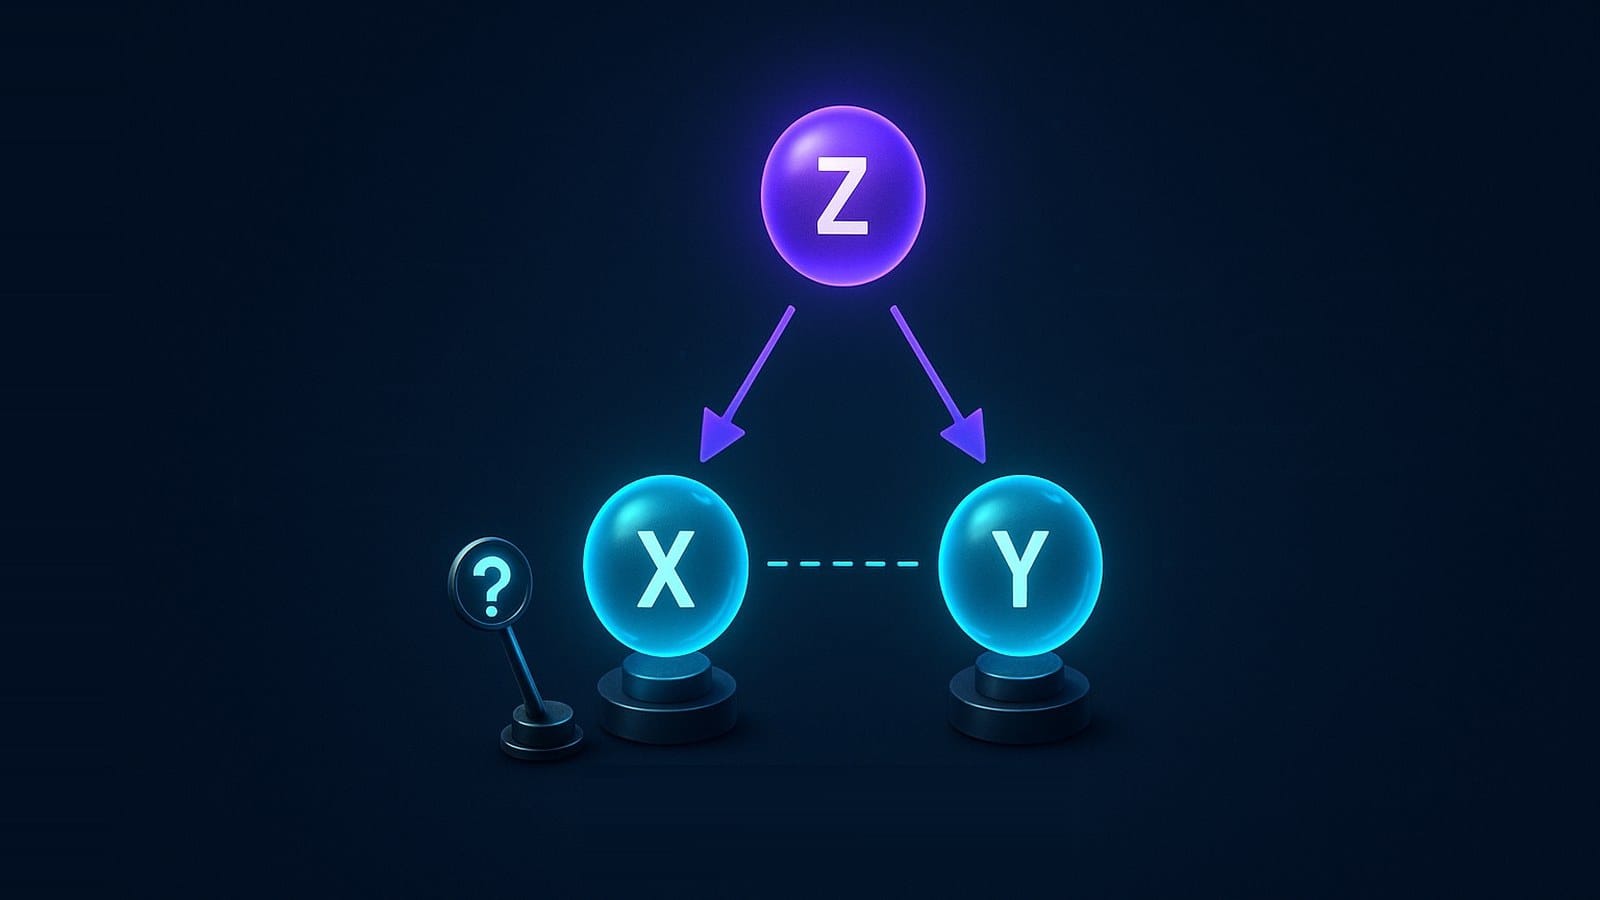
Dizer “ocupação está associada a maior consumo, mantendo as demais features do modelo constantes” é diferente de “aumentar a ocupação causará exatamente $\beta$ kWh a mais”. Um exemplo fora do prédio: se o coeficiente de “horas de treinamento recebidas” é positivo num modelo de produtividade, isso não prova que oferecer treinamento aumentará a produtividade. Quem recebe treinamento pode diferir em experiência, função, motivação ou na escolha do gestor. Para afirmar causa, são necessários desenho e hipóteses adicionais. O foco aqui é previsão fora da amostra.
15. Pipeline reproduzível
Para features numéricas em escalas diferentes e com possíveis ausências, o padrão do artigo anterior se aplica sem mudança:
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

model = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
    ("regressor", LinearRegression()),
])

model.fit(X_train, y_train)
prediction = model.predict(X_test)
OLS não precisa de escala para encontrar as mesmas previsões, em aritmética exata, quando as colunas apenas mudam de unidade. Ainda assim, a escala melhora o condicionamento, a otimização iterativa e a comparação de coeficientes padronizados, e será essencial ao aplicar penalização no próximo artigo. Se houver categorias, reutilize o ColumnTransformer. E salve o pipeline completo, não apenas os coeficientes.
16. Armadilhas comuns
As catorze armadilhas da aula se agrupam em quatro famílias, cada uma ligada a uma das seções anteriores.
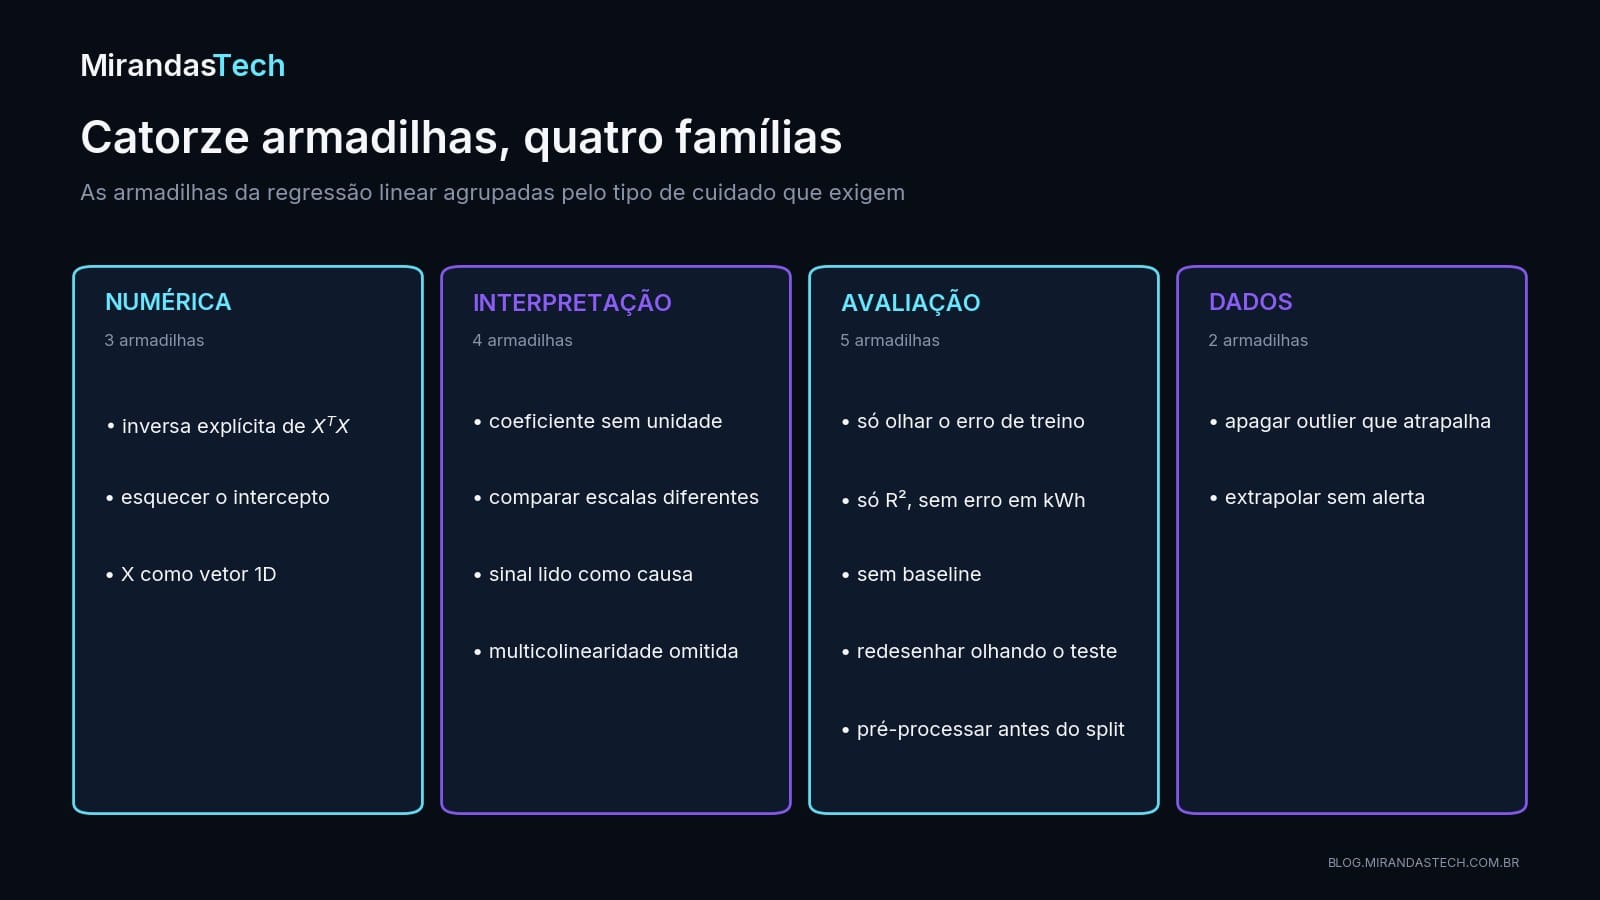
Numérica
- Calcular $(X^TX)^{-1}$ diretamente. Use
lstsq, QR ou SVD. - Esquecer o intercepto. Isso força a reta pela origem e muda os resíduos.
- Passar vetor 1D como $X$. Mantenha observações nas linhas e features nas colunas.
Interpretação
- Interpretar coeficiente sem unidade. Diga “por unidade de quê”.
- Comparar coeficientes em escalas diferentes. A magnitude bruta depende da unidade.
- Concluir causalidade pelo sinal do coeficiente. O modelo é associativo sem desenho causal.
- Omitir multicolinearidade. Previsões podem parecer estáveis enquanto os coeficientes não são.
Avaliação
- Confundir ajuste no treino com generalização. Avalie fora da amostra.
- Reportar apenas $R^2$. Inclua a magnitude do erro na unidade do target.
- Ignorar o baseline. Um modelo complexo pode perder para a média do treino.
- Olhar resíduos do teste para redesenhar o modelo repetidamente. Isso desgasta o teste.
- Pré-processar antes do split. Todo estado ajustável fica dentro do pipeline.
Dados
- Remover outlier porque piora a métrica. Investigue com regra definida, não por conveniência.
- Extrapolar sem alerta. Registre o suporte observado e monitore mudança de distribuição.
17. Checklist antes de confiar no modelo
Se algum item falhar, o número ainda não é evidência.
Formulação
- target contínuo, unidade, população e instante de predição estão definidos;
- baseline e custo dos erros foram registrados;
- as features estão disponíveis em $t_0$ e não contêm vazamento;
- o split representa o cenário de uso.
Matemática e implementação
- shapes de $X$, $y$, $\beta$ e $\widehat y$ estão corretos;
- o intercepto foi incluído ou deliberadamente removido;
- a solução numérica evita inversa explícita;
- posto, valores singulares ou condicionamento foram inspecionados;
- pré-processamento e modelo formam um único pipeline;
- baseline e modelo usam as mesmas partições.
Diagnóstico e comunicação
- MAE e RMSE têm unidade e interpretação;
- resíduos foram avaliados por previsão, feature, grupo e tempo, quando aplicável;
- outliers e pontos de alavancagem foram investigados, não apagados em silêncio;
- o intervalo das features no treino foi registrado para detectar extrapolação;
- coeficientes foram descritos como associações, não causas;
- limitações e hipóteses estão documentadas.
18. Onde isso aparece em IA aplicada
A regressão linear parece distante dos LLMs, mas aparece em pelo menos três lugares do trabalho com IA. O primeiro é o baseline: antes de colocar um modelo grande para prever consumo, demanda, custo, latência ou duração, uma regressão bem feita diz quanto do problema já está resolvido por uma combinação linear, e com resíduos que qualquer pessoa consegue auditar.
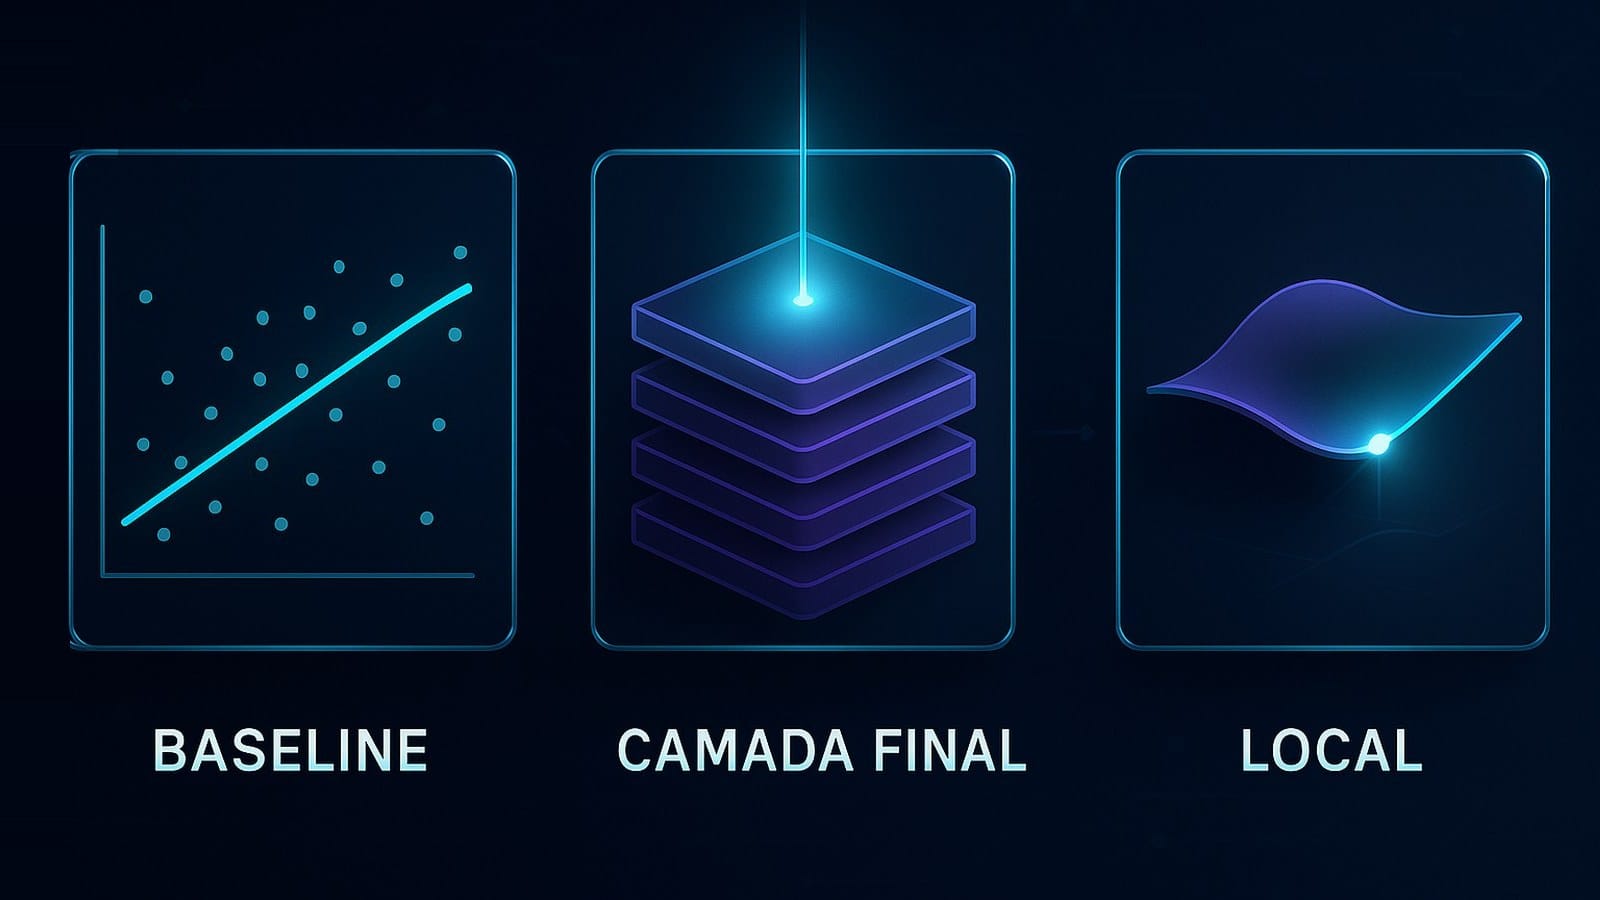
O segundo é a camada final. Uma rede que produz embeddings termina, muitas vezes, numa camada linear: a última etapa é um $W h+b$ sobre a representação $h$, exatamente a forma deste artigo. Treinar só um modelo linear sobre representações congeladas (no caso deles, um classificador linear) é também a maneira clássica de perguntar o que uma camada intermediária “sabe”: as sondas lineares de Alain e Bengio (2016) medem quanta informação está linearmente disponível em cada camada. O terceiro é a aproximação local: métodos como o LIME explicam a previsão de um modelo complexo ajustando, em volta daquele ponto, um modelo linear interpretável (Ribeiro et al., 2016). O coeficiente vira explicação local, com as mesmas ressalvas deste artigo sobre causalidade.
E as lições atravessam a escala. Mau condicionamento, taxa de aprendizado e padronização da seção 9 são os mesmos problemas do treino de redes profundas. A disciplina de extrapolação da seção 13 é o que falta quando um sistema recebe entradas que nunca viu. Uma implementação simples facilita a auditoria: features, unidades, coeficientes, intervalo de treino, versão e resíduos podem ser registrados. Simplicidade não elimina riscos, mas torna muitos deles observáveis.
Próximo passo
Quando há muitas features ou multicolinearidade, os coeficientes de OLS ficam instáveis, como vimos na seção 8. O próximo artigo da série apresenta Ridge, Lasso e Elastic Net: penalidades que controlam a magnitude dos coeficientes, introduzem um viés deliberado e compram estabilidade. A escolha da penalização vai continuar respeitando a mesma regra: nada de consultar o teste.
Referências
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer Series in Statistics, Springer, 2ª ed. (§2.6.3; §3.2 e Fig. 3.2; §3.4.1; §3.9), 2009. doi.org/10.1007/978-0-387-84858-7
- Stigler, Stephen M. Gauss and the Invention of Least Squares. The Annals of Statistics, 9(3), 1981. doi.org/10.1214/aos/1176345451
- Ford, William. Least-Squares Problems. In: Numerical Linear Algebra with Applications, Elsevier, p. 321–349, 2015. doi.org/10.1016/b978-0-12-394435-1.00016-8
- James, Gareth; Witten, Daniela; Hastie, Trevor et al. An Introduction to Statistical Learning: with Applications in R. Springer Texts in Statistics, Springer, 2ª ed. (§3.3.3 «Potential Problems»), 2021. doi.org/10.1007/978-1-0716-1418-1
- LeCun, Yann A.; Bottou, Léon; Orr, Genevieve B. et al. Efficient BackProp. In: Neural Networks: Tricks of the Trade, Lecture Notes in Computer Science, Springer, p. 9–48 (§4.3 e §5.3), 2012. doi.org/10.1007/978-3-642-35289-8_3
- White, Halbert. A Heteroskedasticity-Consistent Covariance Matrix Estimator and a Direct Test for Heteroskedasticity. Econometrica, 48(4), 1980. doi.org/10.2307/1912934
- Shmueli, Galit. To Explain or to Predict?. Statistical Science, 25(3), 2010. doi.org/10.1214/10-STS330
- Cook, R. Dennis. Detection of Influential Observation in Linear Regression. Technometrics, 19(1), 1977. doi.org/10.1080/00401706.1977.10489493
- Ribeiro, Marco Tulio; Singh, Sameer; Guestrin, Carlos. "Why Should I Trust You?": Explaining the Predictions of Any Classifier. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16), p. 1135–1144, 2016. doi.org/10.1145/2939672.2939778
- Alain, Guillaume; Bengio, Yoshua. Understanding intermediate layers using linear classifier probes. arXiv:1610.01644, 2016. arxiv.org/abs/1610.01644
- NumPy developers. numpy.linalg.lstsq. Documentação oficial do NumPy v2.5 (acesso em 25 set. 2026), 2026. numpy.org/doc/stable/reference/generated/numpy.linalg.lstsq.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/04-regressao-linear-minimos-quadrados.md.



