
Do problema ao experimento de ML: features, target, splits e baseline
Transformar uma necessidade real em um experimento de Machine Learning mensurável, reproduzível e coerente com o cenário de uso.

Transformar uma necessidade real em um experimento de Machine Learning mensurável, reproduzível e coerente com o cenário de uso. Pré-requisito: Aula 01 — Machine Learning: problemas, paradigmas e generalização.
Imagine que o pedido chega assim: “use IA para reduzir atrasos de entrega”. Alguém abre o banco, encontra uma tabela de pedidos com data prometida, data real e status final, treina um classificador e comemora 97% de acurácia. Semanas depois, em produção, o modelo não encontra atraso nenhum. O que aconteceu não foi um erro de algoritmo. Foi um erro de experimento: a coluna que mais “explicava” o atraso só existe depois que a entrega acontece, e a avaliação nunca perguntou se o modelo funcionaria para pedidos que ele ainda não viu.
Esse tipo de falha nasce antes do fit. Nasce na hora de decidir o que uma linha representa, qual desfecho será previsto, em que instante a previsão precisa existir e quais casos devem ser inéditos na avaliação. No artigo anterior da série, vimos que o objetivo de um modelo é generalizar para exemplos novos. Aqui, o objetivo é transformar essa ideia em protocolo: um contrato de predição, uma separação limpa entre features e target, um split que imite o uso real e um baseline que sirva de régua.
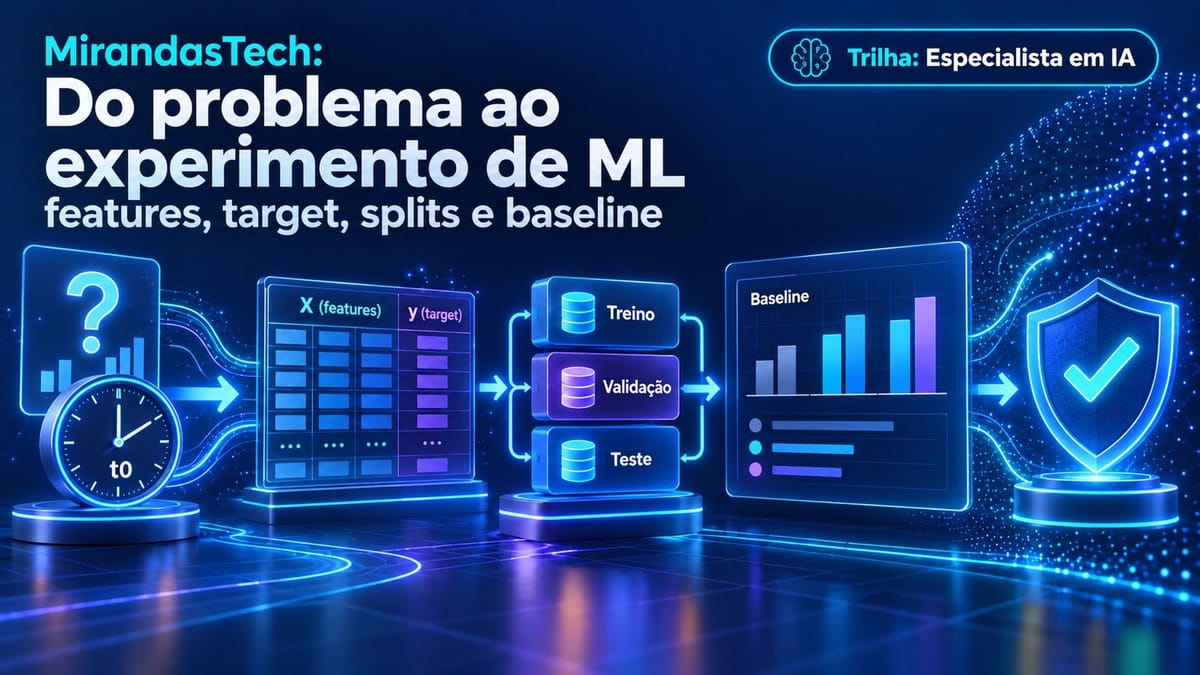
O caminho é sempre o mesmo: necessidade real → contrato de predição → features $X$ e target $y$ → a pergunta “quem ou quando deve ser inédito?” → split coerente → baseline → modelo candidato → validação durante o desenvolvimento → teste final intocado. Ao final, você vai conseguir escrever esse contrato, escolher entre split aleatório, estratificado, por grupo ou temporal, construir baselines que representem alternativas reais e reconhecer uma métrica enganosa antes de comemorá-la. Fechamos com um experimento em Python em que um resultado de 1,00 é a pior notícia possível.
1. O experimento começa antes do dataset
“Reduzir atraso” é uma intenção de negócio, não um problema de Machine Learning. Falta dizer qual previsão será feita, para quem, quando e para apoiar qual decisão. Compare três formulações do mesmo pedido:
- “Prever atrasos.” — ampla demais para orientar coleta ou avaliação.
- “Classificar se uma entrega atrasará.” — melhor, mas ainda sem instante nem horizonte.
- “No momento da expedição, estimar se cada entrega chegará mais de 24 horas após o prazo, para priorizar contato com a transportadora.” — testável.
A terceira formulação estabelece uma fronteira operacional. Ela informa quando a previsão precisa existir, qual desfecho será observado e qual ação poderá ser tomada. Uma boa pergunta preditiva segue este molde:
Para cada [unidade] elegível, no instante [t₀], usar [informações disponíveis] para estimar [desfecho] no horizonte [período], apoiando [decisão].
2. Escreva um contrato de predição
O contrato de predição é uma especificação curta que liga negócio, dados e avaliação. Ele cabe em uma tabela e deve ser escrito antes de qualquer linha de código de modelagem.
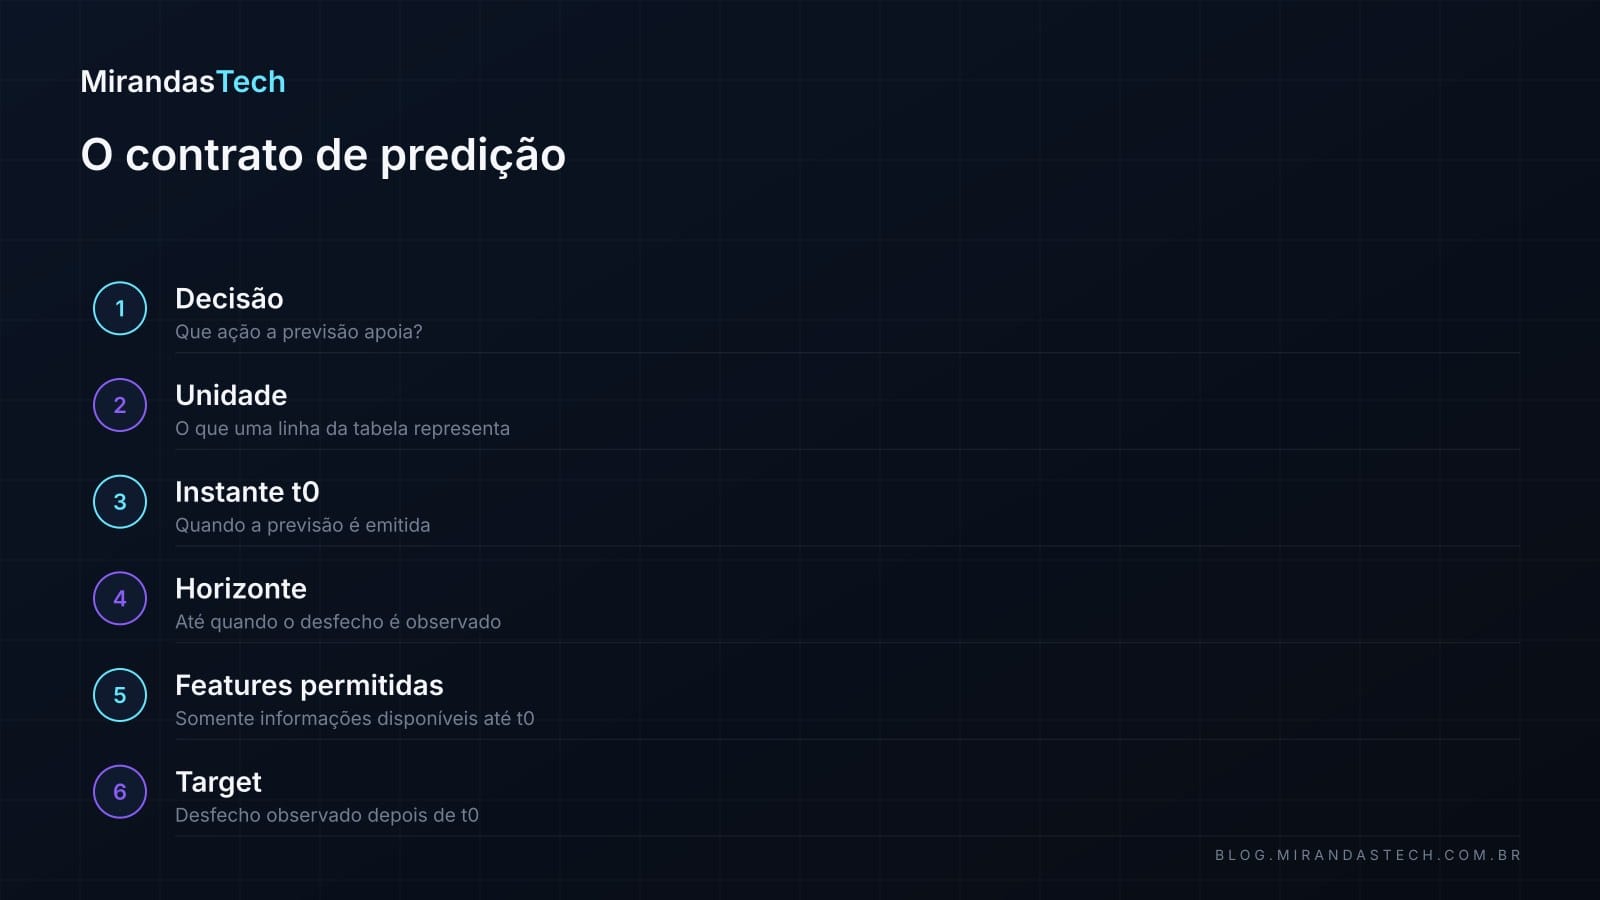
| Campo | Pergunta | Exemplo: atraso de entrega |
|---|---|---|
| Decisão | O que alguém fará com a previsão? | Priorizar contato preventivo com a transportadora |
| Unidade de análise | O que uma linha representa? | Uma entrega |
| População elegível | Quais casos recebem previsão? | Entregas expedidas e ainda não concluídas |
| Instante de predição $t_0$ | Quando o modelo será chamado? | Momento da expedição |
| Horizonte | Até quando observaremos o resultado? | Data prometida + 24 horas |
| Target | Qual desfecho será previsto? | 1 se o atraso exceder 24 h; 0 caso contrário |
| Features permitidas | O que existe até $t_0$? | Rota, transportadora, distância, dia, histórico anterior |
| Features proibidas | O que só existe depois? | Data real de entrega, status final, dias totais de atraso |
| Cenário de generalização | O que deve ser inédito na avaliação? | Entregas futuras; talvez novos clientes ou novas rotas |
| Métrica e guardrail | Como sucesso e dano serão medidos? | Métrica principal + limite de falsos alertas |
Unidade de análise: o significado de uma linha
Uma linha pode representar uma pessoa, transação, pedido, equipamento, imagem ou janela temporal. Essa escolha determina o significado das features, do target e do split.
Se uma pessoa gera dez transações, existem dez linhas, mas não dez pessoas independentes. Ignorar essa dependência pode colocar transações da mesma pessoa em treino e teste. O modelo então reconhece a identidade ou o comportamento já visto, embora o objetivo declarado talvez seja avaliar pessoas novas. Kapoor e Narayanan (2023) chamam esse caso de não independência entre treino e teste e o descrevem como “infelizmente comum”; no levantamento deles, vazamento de algum dos oito tipos que catalogam aparece em 294 artigos de 17 áreas.
3. Desenhe a linha do tempo: features antes, target depois
Defina $t_0$ como o instante em que a previsão será produzida. A partir dele, a linha do tempo de cada caso se organiza em quatro janelas, nesta ordem: histórico → janela de features → $t_0$ (previsão) → janela do target → ação e resultado.
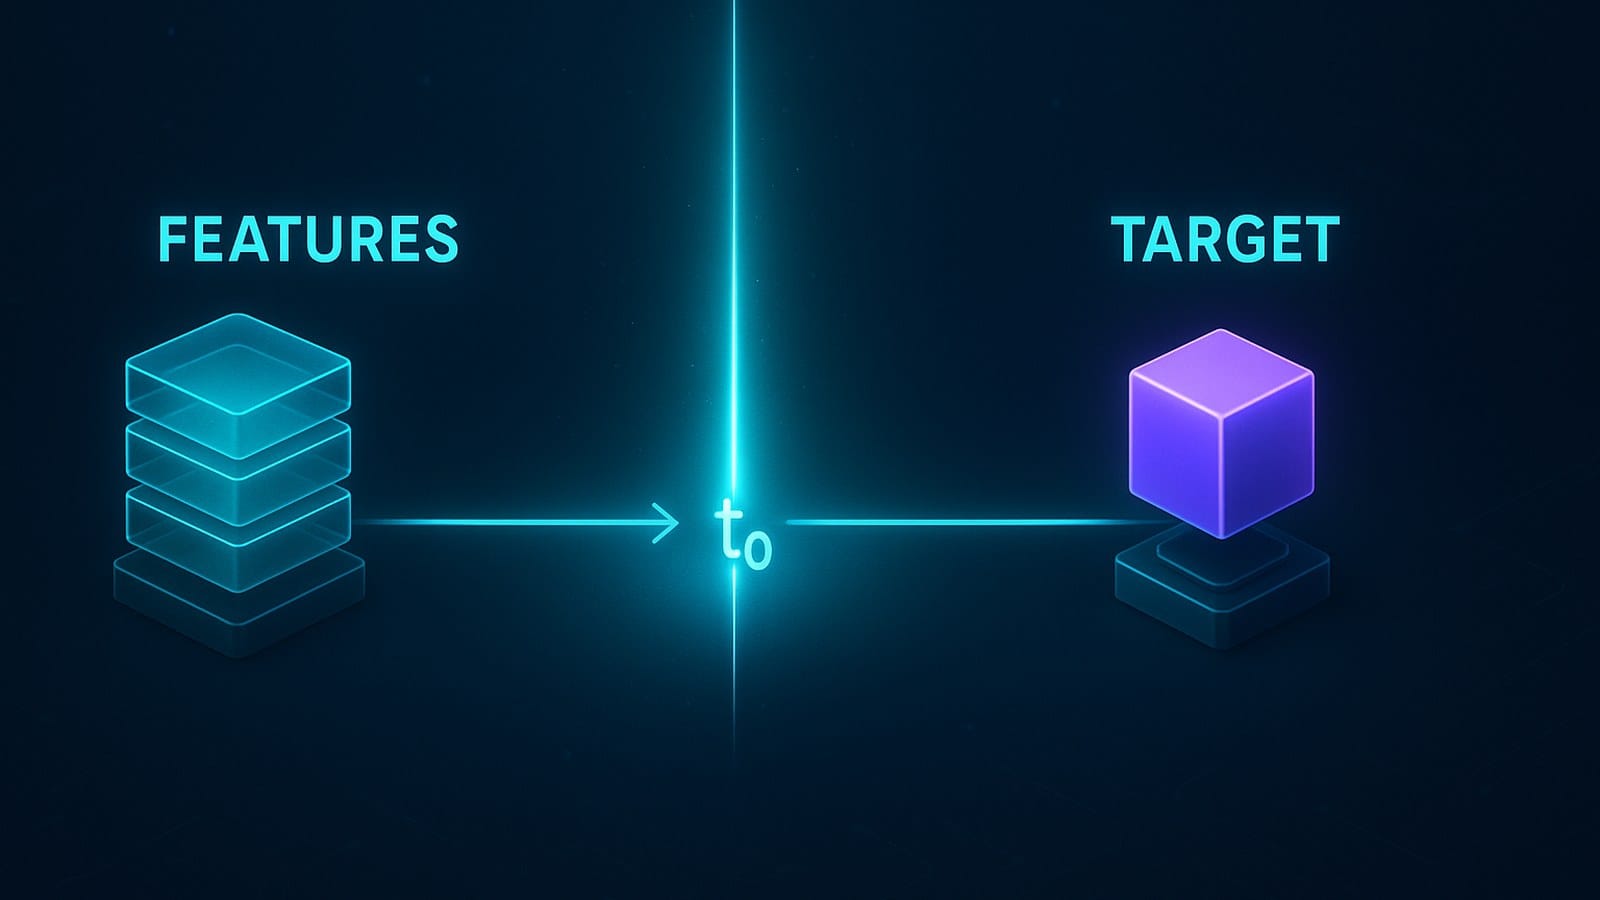
- Histórico e janela de features: apenas dados disponíveis até $t_0$.
- Instante $t_0$: momento em que o sistema recebe a entrada e emite a previsão.
- Janela do target: período posterior usado para definir o desfecho real.
- Horizonte de uso: período em que a previsão ainda permite uma ação útil.
Formalmente, um exemplo supervisionado pode ser escrito como $(x_i,y_i)$, em que:
$$ x_i=\text{informações do caso }i\text{ até }t_0 $$
e
$$ y_i=\text{desfecho após }t_0. $$
Aqui, $x_i$ é o vetor de features do caso $i$, $y_i$ é o desfecho que queremos prever, e $t_0$ é a fronteira que separa o que o modelo pode conhecer do que ele precisa estimar.
O vazamento mais fácil de ignorar
Imagine uma coluna dias_ate_entrega. Ela parece perfeita para prever atraso. Porém, só pode ser calculada depois que a entrega ocorreu. Durante o treinamento histórico a coluna existe; no uso real, não. Esse é um caso de target leakage: informação relacionada ao desfecho entra no conjunto de features de uma forma que não estará legitimamente disponível no momento da previsão (Kaufman et al., 2012).
Neste artigo, leakage é a violação da fronteira entre o que o modelo pode conhecer ao aprender e o que poderá conhecer ao prever — a separação aprender/prever (learn-predict separation) que Kaufman et al. (2012) propõem como regra de manejo dos dados. O próximo artigo da série mostra como evitá-lo dentro das transformações e dos pipelines.
4. Features e target: entradas não são respostas disfarçadas
Em aprendizagem supervisionada, organizamos os dados como:
$$ X\in\mathbb{R}^{n\times p},\qquad y\in\mathbb{R}^{n} $$
onde $n$ é o número de exemplos e $p$ o número de features. O modelo usa $X$ para produzir uma estimativa $\hat y$ e compara essa estimativa com $y$ durante o treinamento.
Para o problema de atraso:
| Variável | Papel | Disponível em $t_0$? | Usar? |
|---|---|---|---|
| Distância planejada | Feature | Sim | Sim |
| Transportadora | Feature | Sim | Sim |
| Atrasos anteriores da rota, calculados até ontem | Feature | Sim | Sim |
| Data real da entrega | Define o target | Não | Não como feature |
| Status “entrega concluída com atraso” | Resposta retrospectiva | Não | Não como feature |
| Identificador bruto do cliente | Identidade | Sim | Só com justificativa e split compatível |
Uma feature pode existir no banco de dados e ainda assim ser inválida. A pergunta correta não é “a coluna está preenchida?”, mas “essa informação existiria, com esse mesmo significado, quando o modelo fosse usado?”.
5. Treino, validação e teste têm papéis diferentes
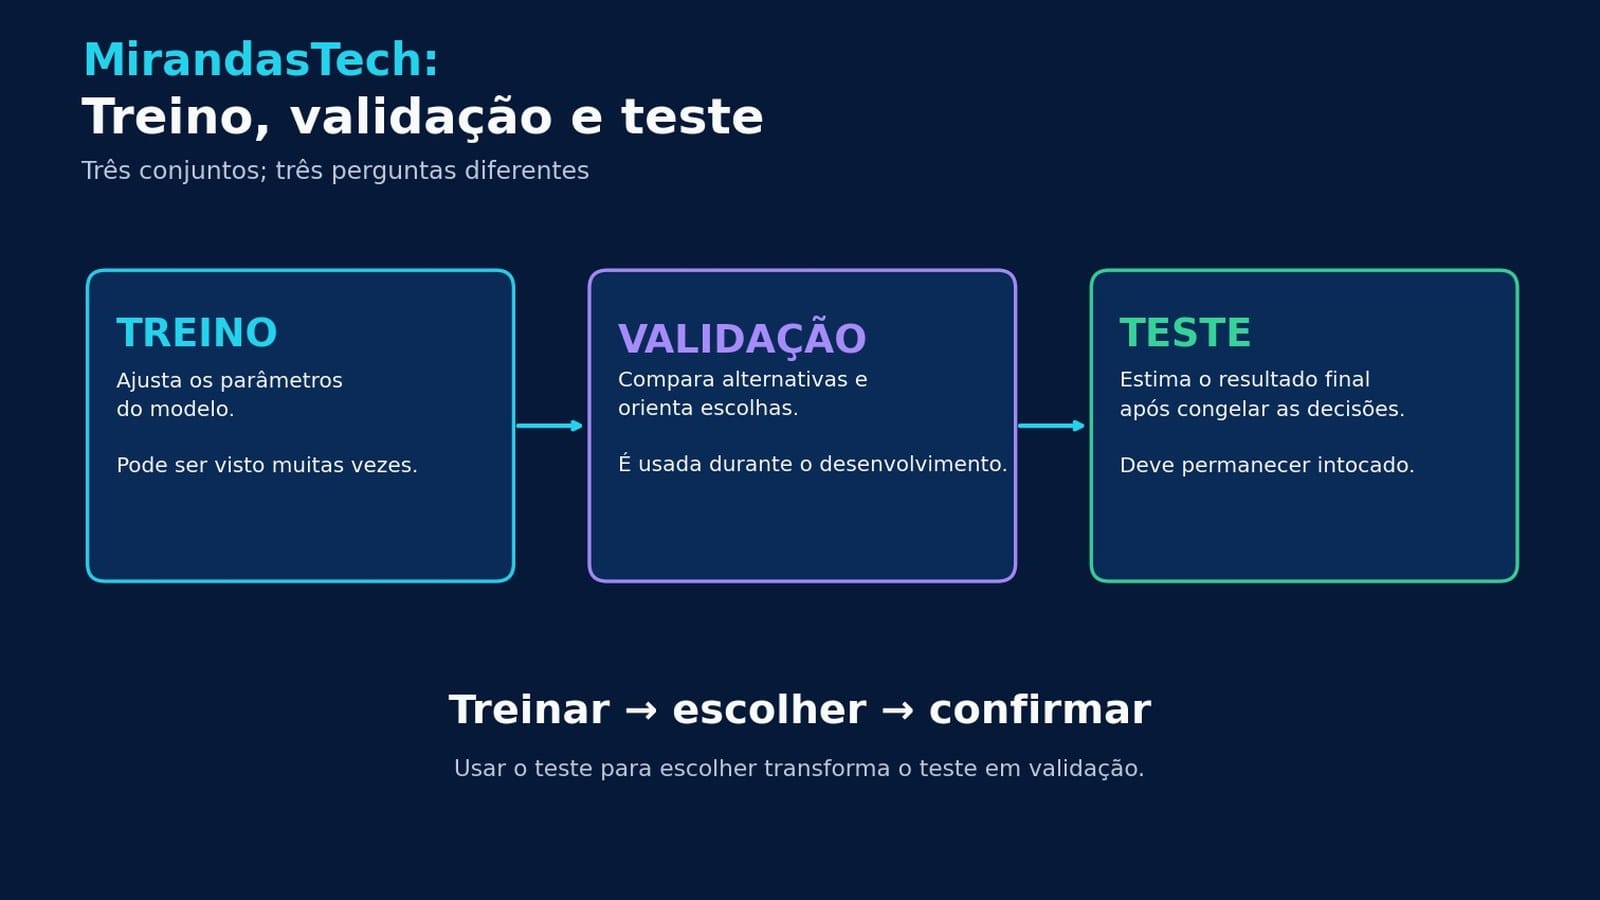
Com contrato, features e target definidos, chega a hora de dividir os dados. A divisão em três conjuntos é conhecida; o que costuma se perder é o papel de cada um.
Treino
O conjunto de treino ajusta os parâmetros do modelo. Uma regressão logística aprende pesos; uma árvore escolhe cortes. É esperado que o algoritmo observe esses exemplos repetidamente.
Validação
O conjunto de validação orienta decisões de desenvolvimento: quais features usar, qual família de modelo comparar, quais hiperparâmetros testar e quando interromper uma busca. Portanto, mesmo sem ajustar diretamente os parâmetros, o processo humano se adapta à validação.
Teste
O teste estima o desempenho do procedimento já escolhido. Ele deve ser consultado depois que contrato, features, transformação, algoritmo e hiperparâmetros estiverem congelados (Google, 2025; Hastie et al., 2009, §7.2).
Se você olha o teste e modifica o modelo, aquele conjunto passou a influenciar a escolha. Na prática, virou validação — o conjunto “se desgasta” com o uso repetido (Google, 2025). A solução não é fingir que isso não aconteceu; é registrar a decisão e reservar um novo conjunto realmente externo quando necessário.
Não existe proporção universal como 70/15/15 (Google, 2025). O tamanho depende do volume de dados, da variabilidade, da raridade do evento e da precisão necessária na estimativa final. A regra metodológica é preservar os papéis.
6. O splitter codifica o cenário de generalização
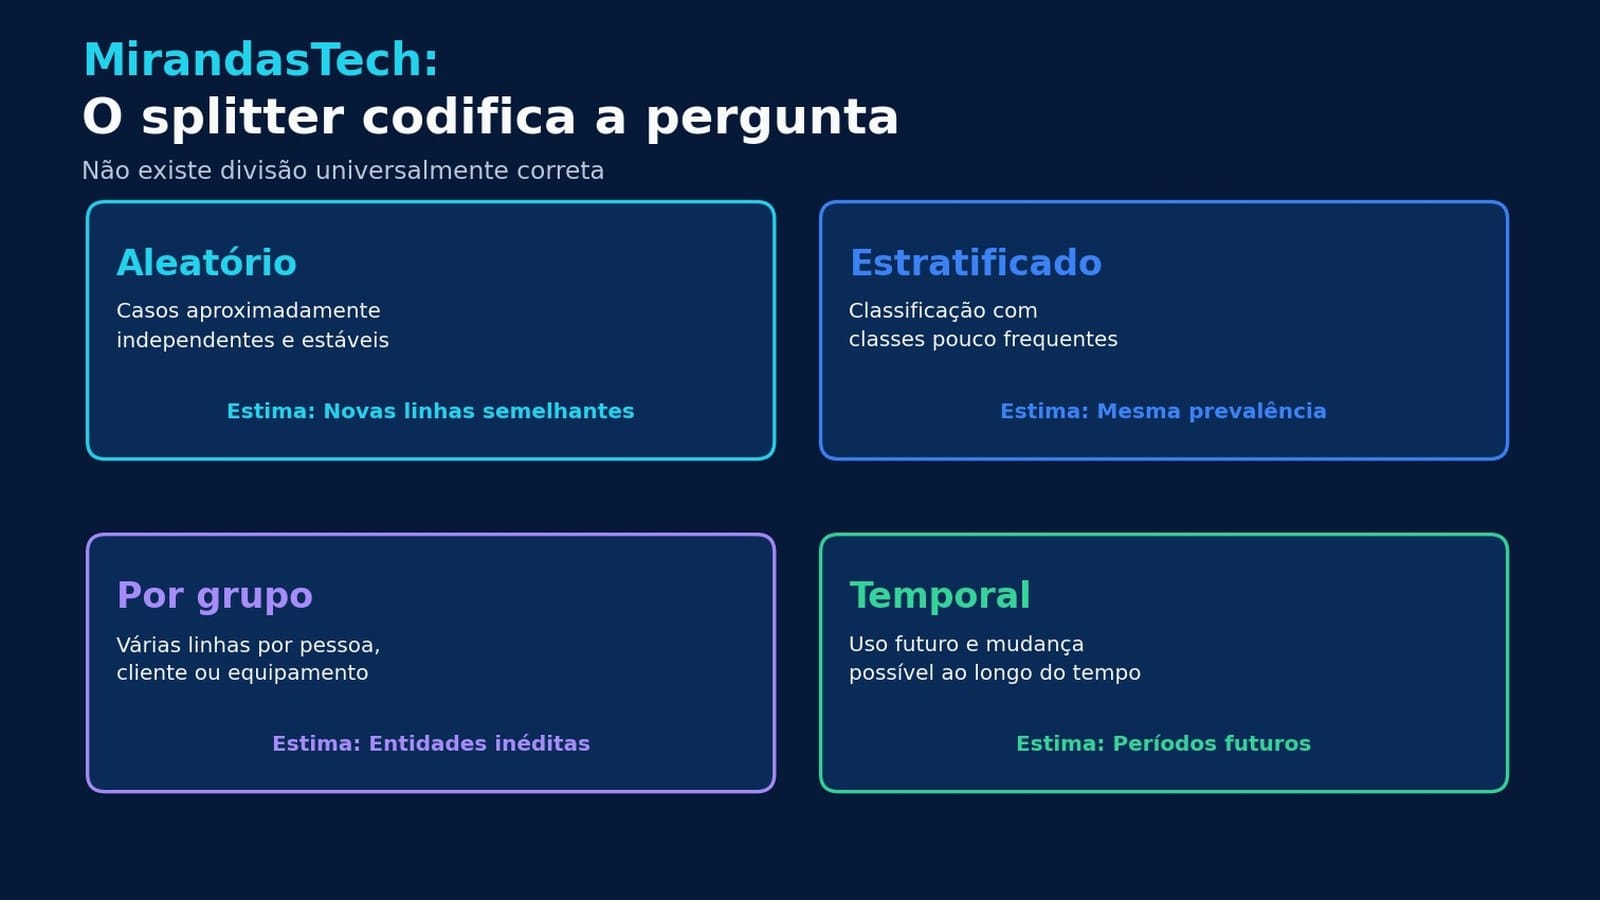
Saber que existem três conjuntos não diz como separá-los. O splitter deve imitar a fronteira que existirá entre passado conhecido e futuro desconhecido. Escolhê-lo exige responder: o que precisa ser novo no mundo real?
| Estratégia | Quando faz sentido | O que ela estima | Risco se usada incorretamente |
|---|---|---|---|
| Aleatória | Exemplos aproximadamente independentes e distribuição estável | Novas linhas da mesma população | Misturar entidades ou períodos dependentes |
| Estratificada | Classificação com classe pouco frequente | Novas linhas preservando aproximadamente a prevalência | Não resolve dependência por tempo ou grupo |
| Por grupo | Várias linhas por pessoa, cliente, equipamento, documento ou unidade | Generalização para grupos inéditos | Resultado otimista por identidade compartilhada |
| Temporal | A previsão será usada no futuro | Treinar no passado e avaliar em períodos posteriores | Treinar com o futuro e “prever” o passado |
Split aleatório
Use quando as linhas podem ser tratadas como aproximadamente independentes e o uso futuro se parece com a população amostrada. train_test_split(..., random_state=42) oferece um holdout simples e reproduzível.
Split estratificado
Em classificação, stratify=y ajuda a preservar a proporção das classes nas partições. Isso reduz o risco de uma classe rara desaparecer por acaso de uma partição pequena. Estratificação não corrige leakage temporal nem por grupo.
Split por grupo
Use quando várias linhas pertencem à mesma entidade e a avaliação deve representar entidades novas. Com GroupShuffleSplit, o tamanho do teste se refere à proporção de grupos, não necessariamente à proporção exata de linhas.
Split temporal
Se o sistema será treinado com o passado para operar no futuro, a avaliação deve respeitar a ordem temporal. Embaralhar datas pode permitir que padrões posteriores influenciem o treinamento — treinar com o futuro e avaliar o passado, um dos casos de leakage em que a hipótese de exemplos independentes é violada (Kaufman et al., 2012). No scikit-learn, TimeSeriesSplit existe exatamente para preservar essa ordem. Séries temporais, folds e cross-validation voltam em profundidade mais adiante na série.
Situações híbridas
Um hospital pode ter pacientes repetidos ao longo do tempo; uma frota pode ter equipamentos repetidos em meses sucessivos. Nesses casos, talvez seja necessário respeitar grupo e tempo ao mesmo tempo. A biblioteca pode não oferecer uma única função que expresse a regra exata; documente e teste o splitter construído para o domínio.
7. Baseline: a régua mínima do experimento
Definido o split, ainda falta a régua. Um número isolado não diz se um modelo agrega valor; compare-o com uma alternativa simples e plausível. Kapoor e Narayanan (2023) dão um exemplo incômodo: em predição de guerras civis, corrigido o vazamento, modelos complexos de ML não superaram de forma relevante uma regressão logística de décadas atrás. Boas referências, em ordem crescente de exigência:
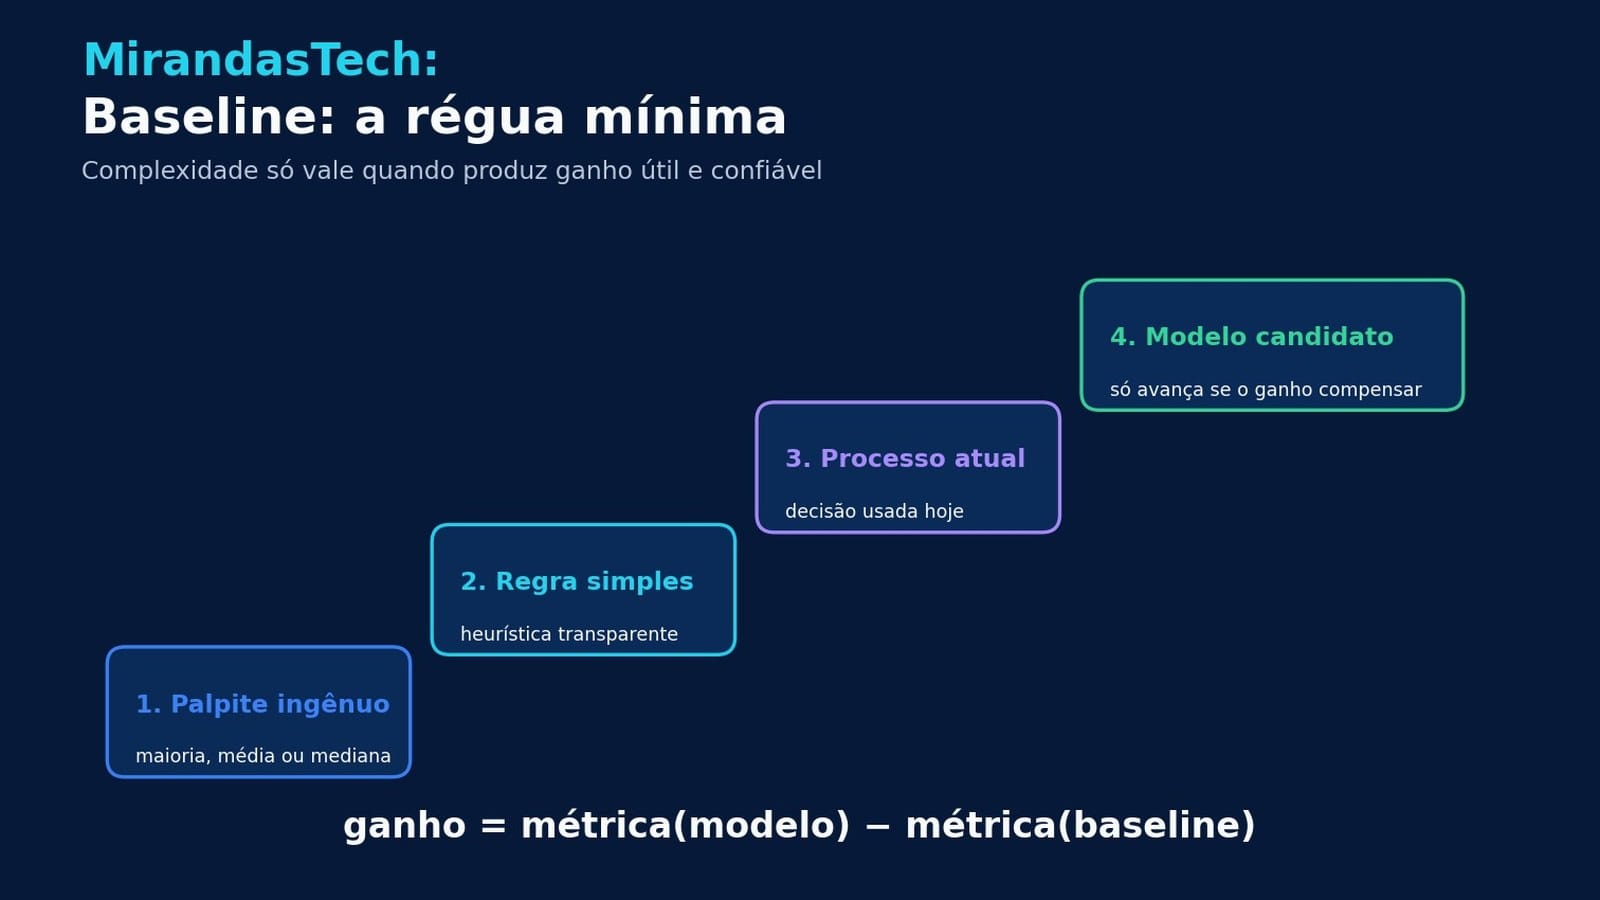
- baseline ingênuo: média ou mediana em regressão; classe majoritária em classificação;
- baseline temporal: último valor conhecido ou média móvel;
- regra simples: heurística transparente, como sinalizar rotas com taxa histórica acima de um limite;
- processo atual: regra, modelo ou decisão humana usada hoje.
O ganho observado é:
$$ \text{ganho}=\text{métrica(modelo)}-\text{métrica(baseline)}. $$
Para métricas em que menor é melhor, como MAE, inverta a subtração ou declare explicitamente a direção. O ganho técnico também precisa compensar custos de coleta, latência, manutenção, explicabilidade e erro operacional.
No scikit-learn, DummyClassifier e DummyRegressor implementam regras simples que ignoram as features. Eles não são candidatos de produção; são réguas de sanidade.
8. Métrica nasce do custo do erro
Suponha 1.000 entregas, das quais 200 atrasam. Prever sempre “no prazo” produz:
$$ \text{Accuracy}=\frac{800}{1000}=0{,}80. $$
O número parece alto, mas o sistema não encontra nenhuma entrega atrasada. Se a ação de negócio é intervir antes do atraso, esse baseline tem utilidade quase nula para o objetivo.
Antes de escolher uma métrica, responda:
- qual erro é mais caro: falso positivo ou falso negativo?
- existe capacidade limitada para agir sobre alertas?
- a previsão será uma classe, uma probabilidade ou um ranking?
- há grupos para os quais o dano precisa ser monitorado separadamente?
No experimento da seção 10, a métrica é balanced accuracy (média dos recalls por classe), apenas para que cada classe contribua igualmente. Precision, recall, F1, ROC, PR-AUC, calibração e escolha de limiar terão artigos próprios mais adiante na série.
9. Exemplo completo: o contrato de atraso fechado
Juntando tudo, o contrato do problema de atraso fica assim:
- decisão: priorizar contato preventivo com a transportadora;
- unidade: uma entrega;
- população: entregas expedidas e ainda em trânsito;
- $t_0$: instante de expedição;
- target: atraso superior a 24 horas em relação ao prazo prometido;
- features permitidas: rota, distância, tipo de serviço, transportadora, dia e histórico calculado antes de $t_0$;
- features proibidas: horário real de chegada, status final e qualquer agregação atualizada após $t_0$;
- split principal: temporal, se a operação usa o modelo em períodos futuros;
- controle adicional: por cliente ou rota, se o objetivo inclui entidades inéditas;
- baseline: regra vigente e
DummyClassifier; - métrica principal: escolhida conforme o custo operacional;
- teste: período futuro reservado e consultado apenas no encerramento.
Observe que nenhum algoritmo foi escolhido. Mesmo assim, grande parte do risco metodológico já foi tratada.
10. Na prática: quando 1,00 é um resultado ruim
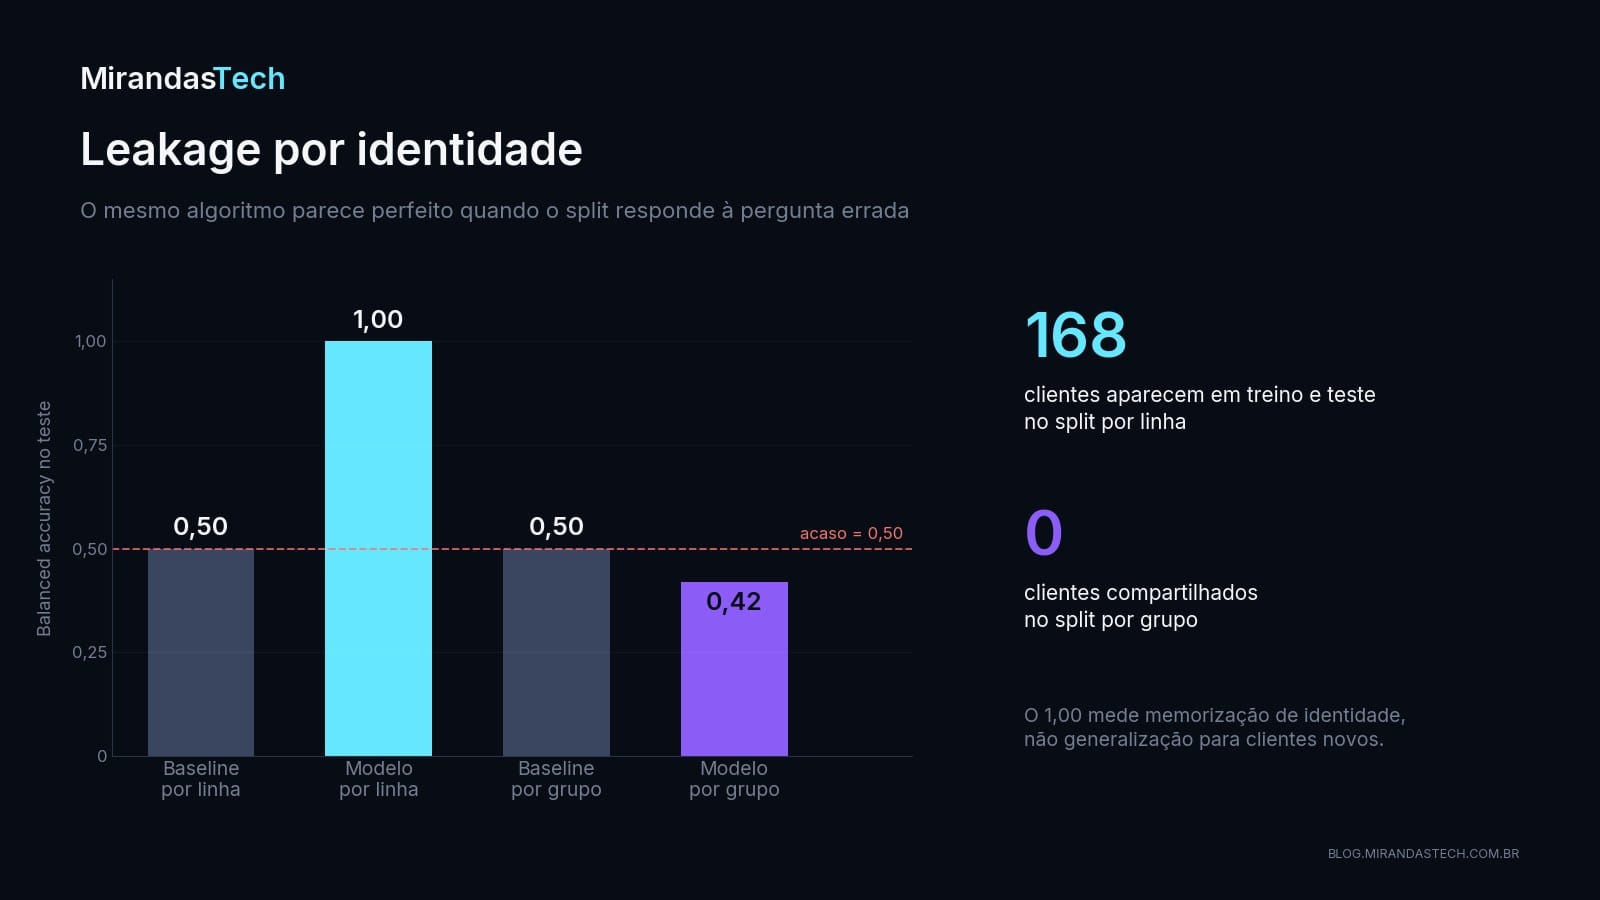
O experimento a seguir é sintético e deliberadamente extremo. Ele cria 240 clientes, cada um com cinco registros. Cada cliente recebe uma classe fixa e sorteada. O único “sinal” disponível é o identificador numérico do cliente. A pergunta: um modelo que memoriza clientes já vistos funciona para clientes inéditos?
Antes de executar, a hipótese:
- Com split por linha, o mesmo cliente aparecerá em treino e teste. Um vizinho mais próximo poderá memorizar sua classe e parecer perfeito.
- Com split por grupo, clientes de teste serão inéditos. Como as classes foram sorteadas, o identificador não contém um padrão generalizável e o desempenho deverá ficar próximo do acaso.
import numpy as np
from sklearn.dummy import DummyClassifier
from sklearn.metrics import balanced_accuracy_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split
from sklearn.neighbors import KNeighborsClassifier

rng = np.random.default_rng(42)
n_clientes = 240
linhas_por_cliente = 5

cliente_id = np.repeat(np.arange(n_clientes), linhas_por_cliente)
classe_do_cliente = rng.integers(0, 2, size=n_clientes)
y = np.repeat(classe_do_cliente, linhas_por_cliente)
X = cliente_id.reshape(-1, 1)
indices = np.arange(len(y))

# Cenário enganoso: embaralhar linhas
treino_linha, teste_linha = train_test_split(
    indices, test_size=0.20, stratify=y, random_state=42
)

# Cenário honesto para clientes novos: separar entidades
splitter = GroupShuffleSplit(n_splits=1, test_size=0.20, random_state=42)
treino_grupo, teste_grupo = next(splitter.split(X, y, groups=cliente_id))

def avaliar(treino, teste):
    baseline = DummyClassifier(strategy="most_frequent")
    modelo = KNeighborsClassifier(n_neighbors=1)

    baseline.fit(X[treino], y[treino])
    modelo.fit(X[treino], y[treino])

    return {
        "baseline": balanced_accuracy_score(y[teste], baseline.predict(X[teste])),
        "modelo": balanced_accuracy_score(y[teste], modelo.predict(X[teste])),
        "clientes_compartilhados": len(
            set(cliente_id[treino]) & set(cliente_id[teste])
        ),
    }

print("Split por linha:", avaliar(treino_linha, teste_linha))
print("Split por grupo:", avaliar(treino_grupo, teste_grupo))

assert set(cliente_id[treino_grupo]).isdisjoint(cliente_id[teste_grupo])
Saída real, com scikit-learn 1.9 e numpy 2.2:
Split por linha: {'baseline': 0.5, 'modelo': 1.0, 'clientes_compartilhados': 168}
Split por grupo: {'baseline': 0.5, 'modelo': 0.42328042328042326, 'clientes_compartilhados': 0}
Os dois splits produzem 960 linhas de treino e 240 de teste. No split por linha, 168 dos 240 clientes aparecem nos dois lados. No split por grupo, o teste contém 48 clientes que o modelo nunca viu.
Interpretação
1,00 não significa que descobrimos um fenômeno útil. Significa que o experimento permitiu reconhecer entidades já vistas. Ao mudar a pergunta para “generaliza para clientes novos?”, a habilidade desaparece.
O modelo não piorou entre um split e outro. Mudou o que foi medido. O primeiro protocolo mede memorização em clientes repetidos; o segundo estima transferência para identidades inéditas. Em dados reais, o vazamento pode ser parcial: a métrica não chega a 1,00, mas continua otimista (Kaufman et al., 2012; Kapoor & Narayanan, 2023).
11. Protocolo mínimo de um experimento honesto
O laboratório acima cabe em um protocolo que vale para qualquer problema supervisionado.
Antes de treinar:
- escreva o contrato de predição;
- declare a hipótese;
- congele a regra que cria o target;
- liste features permitidas e proibidas;
- escolha o splitter a partir do cenário de generalização;
- reserve o teste;
- defina baseline, métrica principal e guardrails.
Durante o desenvolvimento:
- ajuste apenas no treino;
- use validação para comparar alternativas;
- altere uma decisão relevante por vez;
- mantenha a mesma divisão nas comparações;
- registre seed, versões, parâmetros e origem dos dados;
- verifique automaticamente a separação de grupos ou tempo (o
assertdo laboratório faz isso).
Ao encerrar:
- congele a configuração;
- avalie uma vez no teste;
- reporte modelo e baseline;
- inspecione erros e subgrupos relevantes;
- declare limitações e o que o experimento não demonstra.
Um modelo de contrato para copiar e preencher no seu próximo projeto:
# Contrato de predição

- Decisão apoiada:
- Unidade de análise:
- População elegível:
- Instante de predição (t0):
- Horizonte:
- Target e regra de rotulação:
- Features permitidas:
- Features proibidas:
- Cenário de generalização:
- Split e justificativa:
- Baseline ingênuo:
- Baseline operacional:
- Métrica principal e direção:
- Guardrails:
- Limitações conhecidas:
12. Armadilhas comuns
“Embaralhar resolve tudo”
Embaralhar distribui linhas; não elimina dependência entre linhas da mesma pessoa nem respeita causalidade temporal.
“O identificador existe, então pode ser feature”
Um ID pode permitir memorização. Às vezes ele é necessário para separar grupos, mas não deve automaticamente entrar em $X$.
“O teste está separado, então posso consultá-lo sempre”
Escolhas repetidas com base no teste adaptam o processo às peculiaridades desse conjunto (Google, 2025). Separe validação de teste.
“Meu modelo tem 90%, então é bom”
Sem métrica, baseline, prevalência, protocolo e custo do erro, 90% é apenas um número.
“A mesma regra de target vale para produção”
Rótulos históricos podem chegar com atraso, ser revisados ou depender de processos indisponíveis online. Documente como e quando o target é observado.
“Cross-validation corrige um split errado”
Repetir várias divisões inadequadas produz várias estimativas inadequadas. Primeiro defina a unidade e as restrições; folds e cross-validation voltam mais adiante na série.
13. Onde isso aparece em IA aplicada
Nada do que foi dito depende de o modelo ser um vizinho mais próximo. Pense em um buscador semântico baseado em embeddings: na minha experiência, é fácil separar as perguntas por linha e deixar o mesmo documento aparecer nos dois lados sem perceber. O que se mede então é a capacidade de reencontrar documentos já vistos, não de recuperar documentos inéditos; o grupo, aqui, é o documento.
Em benchmarks de LLMs, o problema do “teste consultado várias vezes” aparece em escala: quando exemplos do benchmark entram no corpus de pré-treinamento, a métrica passa a medir reconhecimento, e o nome disso é contaminação (Sainz et al., 2023).
Um agente que toma decisões também tem contrato de predição: em qual instante ele decide, com quais informações do contexto, apoiando qual ação, e o que precisa ser inédito na avaliação, sejam usuários, ferramentas ou períodos. Mudam as ferramentas; a fronteira entre o que se pode conhecer e o que se quer estimar continua a mesma.
Próximo passo
Até aqui, você definiu o que será previsto e como a avaliação deve representar o mundo. O próximo artigo da série, sobre pré-processamento, pipelines e data leakage, protege essa fronteira dentro do código: imputação, escala e codificação sem deixar que estatísticas da validação ou do teste contaminem o treinamento.
Referências
- Kaufman, Shachar; Rosset, Saharon; Perlich, Claudia et al. Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 2012. doi.org/10.1145/2382577.2382579
- Kapoor, Sayash; Narayanan, Arvind. Leakage and the reproducibility crisis in machine-learning-based science. Patterns, 4(9), 100804, 2023. doi.org/10.1016/j.patter.2023.100804
- Sainz, Oscar; Campos, Jon Ander; García-Ferrero, Iker et al. NLP Evaluation in trouble: On the Need to Measure LLM Data Contamination for each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 2023. doi.org/10.18653/v1/2023.findings-emnlp.722
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer Series in Statistics, Springer, 2ª ed. (§7.2 «Bias, Variance and Model Complexity»), 2009. doi.org/10.1007/978-0-387-84858-7
- Google for Developers. Machine Learning Crash Course — Datasets: Dividing the original dataset. Documentação oficial (página atualizada em 2025-12-03; acesso em 12 set. 2026), 2025. developers.google.com/machine-learning/crash-course/overfitting/dividing-datasets
- scikit-learn developers. GroupShuffleSplit. Documentação oficial do scikit-learn 1.9.1 (acesso em 12 set. 2026), 2026. scikit-learn.org/stable/modules/generated/sklearn.model_selection.GroupShuffleSplit.html
- scikit-learn developers. DummyClassifier. Documentação oficial do scikit-learn 1.9.1 (acesso em 12 set. 2026), 2026. scikit-learn.org/stable/modules/generated/sklearn.dummy.DummyClassifier.html
- scikit-learn developers. TimeSeriesSplit. Documentação oficial do scikit-learn 1.9.1 (acesso em 12 set. 2026), 2026. scikit-learn.org/stable/modules/generated/sklearn.model_selection.TimeSeriesSplit.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/02-framing-dataset-split-baseline.md.



