Paper do mês: habilidades emergentes são reais ou miragem da métrica?
Habilidades emergentes de LLMs são saltos reais ou efeito da métrica e da amostra? Uma leitura crítica de Wei (2022) e Schaeffer (2023), do que veio depois e do que muda ao avaliar modelos e agentes.

O par: Wei et al. (2022), Emergent Abilities of Large Language Models × Schaeffer, Miranda e Koyejo (2023), Are Emergent Abilities of Large Language Models a Mirage?
Tese: o salto existe no gráfico; o que se discute é onde ele mora, se no modelo ou na régua. Para quem avalia modelos e agentes, as duas respostas cobram cuidados diferentes.
Uma equipe testa o seu agente em uma tarefa de vinte passos e conta só uma coisa: terminou certo ou não. A versão 1 acerta 0 de 50 tarefas. A versão 2, também 0. A versão 3 acerta 6. Na reunião, alguém diz que o agente "aprendeu a planejar". Talvez. Ou cada passo ficou um pouco mais confiável a cada versão, e a régua só enxergou a melhora quando ela passou de certo ponto.
Essa é, em miniatura, uma das discussões mais instrutivas da avaliação de LLMs. O roteiro de papers do AI Lab manda ler os dois papers em sequência: mostram uma afirmação forte contestada por método. Este é o primeiro "Paper do mês", faixa que alterna com a série MCP (ensaio anterior: MCP, A2A, ACP e ANP: os protocolos da futura Internet dos Agentes).
1. O que Wei et al. afirmam
O paper de Wei e outros quinze autores (Google, Stanford, UNC e DeepMind) saiu na TMLR em agosto de 2022, com o selo de Survey Certification. É um levantamento de resultados publicados com uma definição enxuta: uma habilidade é emergente se não está presente em modelos menores e está presente em modelos maiores. Por isso não poderia ser prevista extrapolando o desempenho dos menores (Wei et al., 2022).
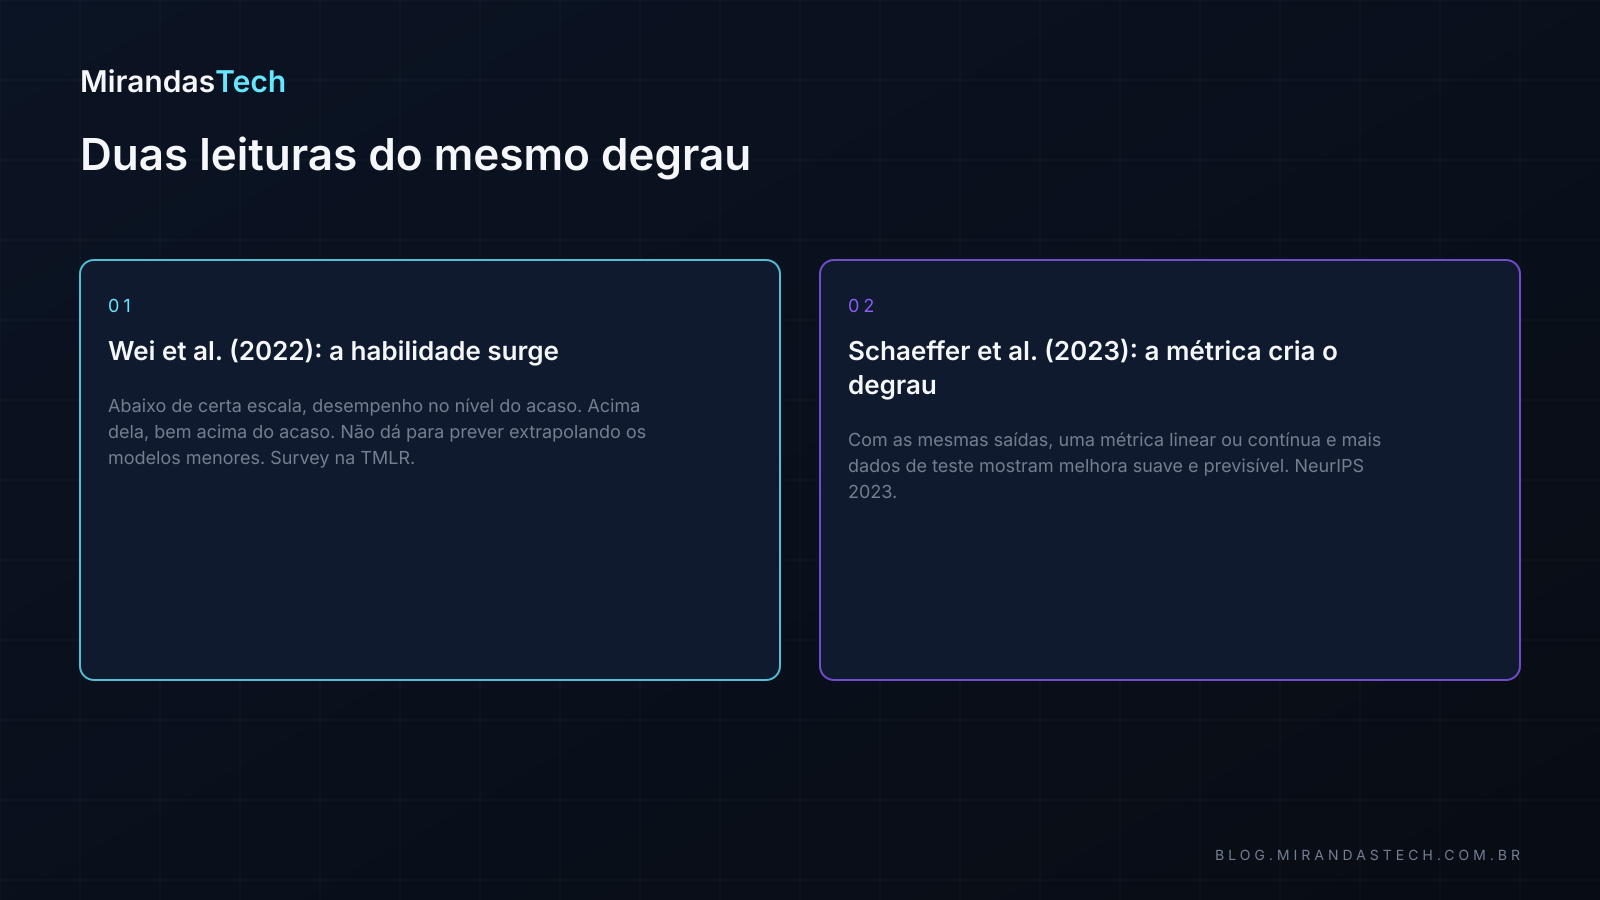
Os exemplos são as curvas que ficaram famosas. Na tarefa de aritmética do BIG-Bench (soma e subtração de três dígitos, multiplicação de dois), o GPT-3 fica perto de zero por várias ordens de grandeza de computação e salta a partir de cerca de 2·10²² FLOPs de treino (13 bilhões de parâmetros). No MMLU, modelos de até uns 10 bilhões de parâmetros ficam no nível do chute; entre 70 e 280 bilhões passam bem acima dele. Técnicas de prompt também entram: o chain-of-thought só supera o prompt comum por volta de 10²³ FLOPs (~100 bilhões de parâmetros).
Um detalhe costuma sumir nos resumos: Wei et al. já desconfiavam da métrica. Na seção 5.1 escrevem que o exact match em respostas longas pode disfarçar melhoras incrementais como emergência. No apêndice A mostram que a entropia cruzada melhora mesmo nos modelos pequenos, enquanto a métrica final fica parada no acaso. Mas concluem que isso não explica tudo: a emergência aparece também em tarefas de classificação e, em três tarefas generativas, sob todas as métricas que o BIG-Bench oferecia.
2. O argumento da métrica
Schaeffer, Miranda e Koyejo (2023) transformam essa suspeita em modelo. Suponha que a perda por token caia de forma suave com o número de parâmetros $N$. Então a probabilidade de acertar um token, $p(N)$, também sobe de forma suave. Agora escolha uma métrica que só dá ponto quando os $L$ tokens da resposta estão todos certos:
$$\begin{aligned} \text{exact match}(N) &\approx p(N)^{L} \\ \text{edição}(N) &\approx L\,\bigl(1 - p(N)\bigr) \end{aligned}$$
Aqui $p(N)$ é a chance de acertar um token, $L$ é o comprimento da resposta em tokens e edição é a distância de edição contada em tokens (Token Edit Distance), que em média conta quantos dos $L$ tokens saíram errados. A primeira métrica eleva $p$ à potência $L$; a segunda é linear em $p$. A conta assume que os erros dos tokens são independentes, e os próprios autores avisam numa nota que isso é falso. A aproximação serve para mostrar a forma das curvas, não para cravar números.
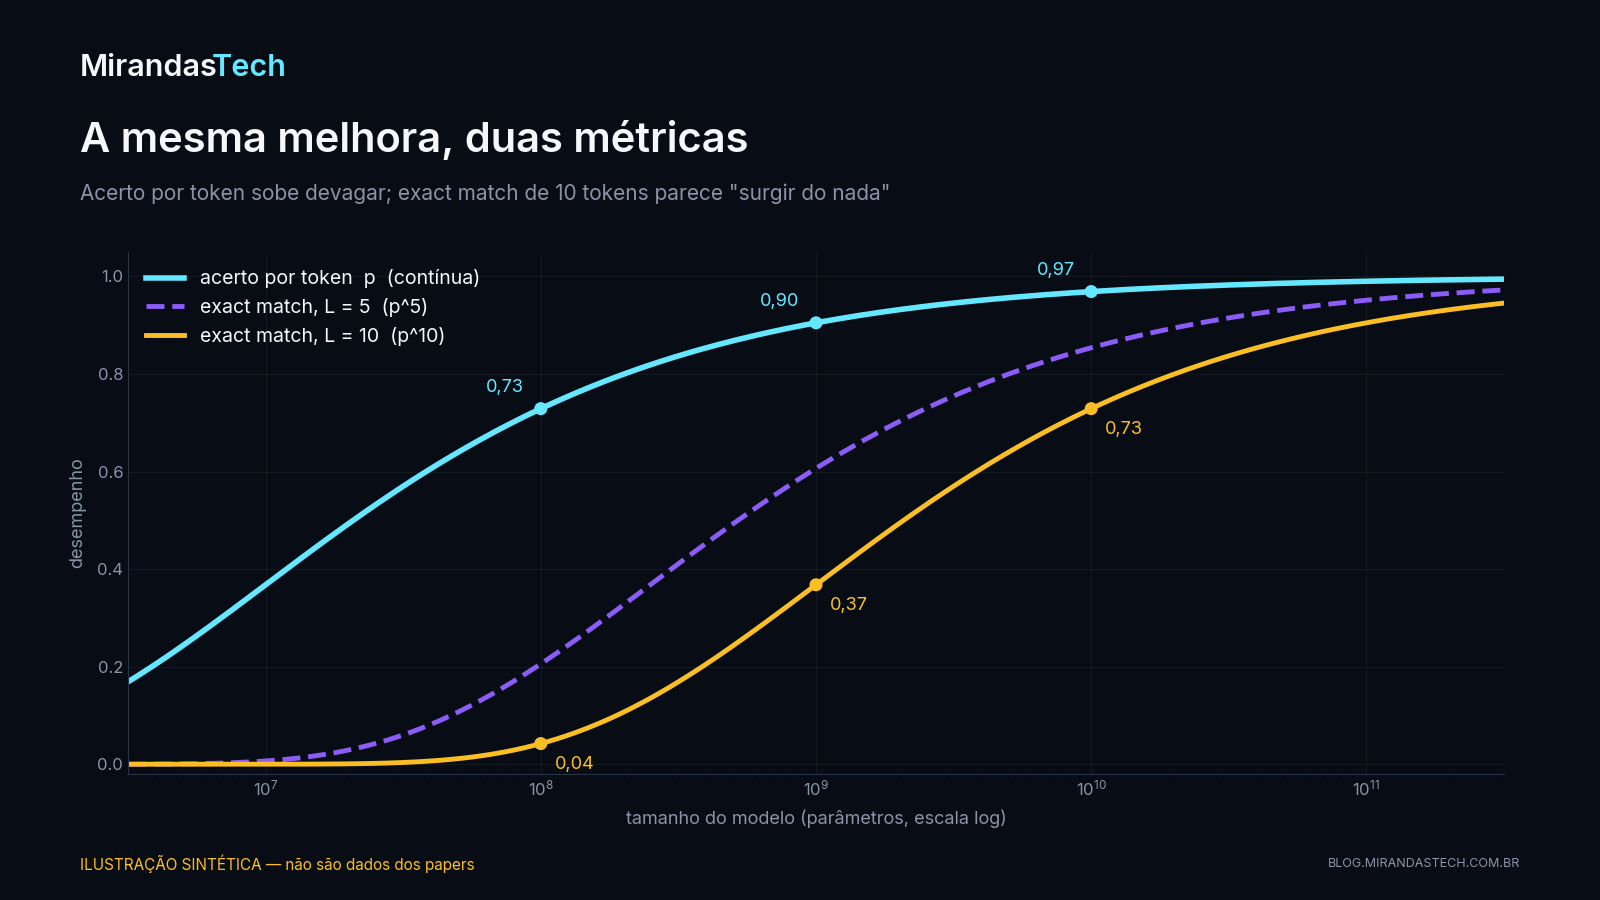
O gráfico é uma ilustração com a forma funcional do paper e constantes escolhidas por mim. De 10⁸ para 10⁹ parâmetros, o acerto por token vai de 0,73 para 0,90. O exact match de dez tokens vai de 0,04 para 0,37. Nada mudou de natureza no "modelo"; mudou a lente.
Há um segundo ingrediente, a resolução. Com $n$ questões no teste, a menor taxa de acerto que você consegue observar acima de zero é $1/n$. Abaixo disso, o mais provável é a medição devolver zero, mesmo que o valor verdadeiro seja positivo. Com taxa verdadeira $q$, a chance de zero acerto em $n$ questões é $(1-q)^{n}$. E, quando não dá zero, dá pelo menos $1/n$, que superestima $q$.
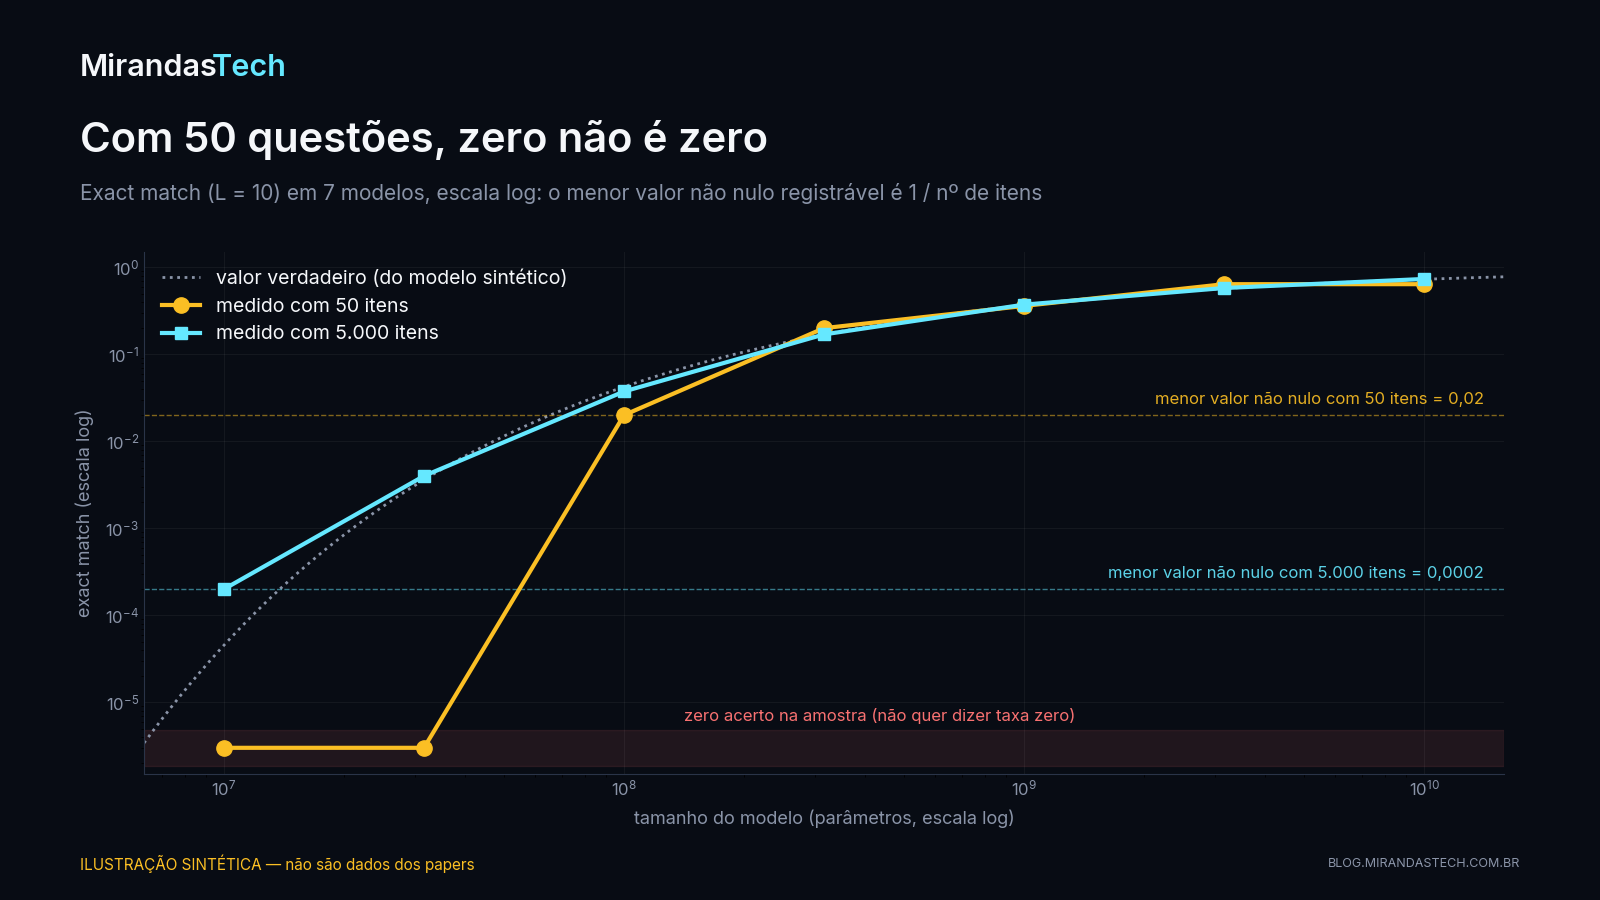
Na simulação, com 50 itens os dois menores modelos marcam zero e o terceiro marca 0,02, o mínimo possível. Com 5.000 itens, todos aparecem acima de zero e acompanham a curva verdadeira; o menor marca 0,0002, exatamente 1/5.000, quatro vezes o valor verdadeiro (0,00005). O "degrau" da primeira série é, em boa parte, falta de amostra.
3. O que Schaeffer et al. mostram de fato
O paper testa a explicação de três formas. Primeiro, com a família InstructGPT/GPT-3, a única, entre as famílias com emergência relatada, que dava para consultar pela API, em quatro tamanhos (350M, 1,3B, 6,7B e 175B). Em multiplicação e soma, o salto aparece quando a resposta tem 4 ou 5 dígitos e a métrica é acurácia. Com as mesmas saídas, trocar para a distância de edição em tokens dá curvas suaves. Com mais dados de teste, todos ficam acima do acaso mesmo na acurácia.
Segundo, uma meta-análise do BIG-Bench. Das 39 métricas preferidas, no máximo 5 exibem emergência pelo escore automático. Nas anotações manuais, mais de 92% das habilidades emergentes aparecem sob só duas métricas: Multiple Choice Grade (descontínua) e Exact String Match (não linear). No LaMDA, tarefas emergentes sob Multiple Choice Grade deixam de sê-lo sob o Brier score, contínuo.
Terceiro, eles fabricam emergência em visão: autoencoders (CIFAR-100), Transformers (Omniglot) e LeNet (MNIST) melhoram de forma suave, e basta uma métrica com limiar ou "acertar todos os K" para o salto aparecer. O paper recebeu um dos dois prêmios Outstanding Main Track Paper da NeurIPS 2023.
4. O que o paper não mostra
O próprio texto põe limites que a manchete "emergência é miragem" apaga. As duas versões avisam que nada ali deve ser lido como afirmação de que LLMs não podem ter habilidades emergentes. O que mudou foi a força da conclusão. Na seção de trabalhos relacionados, a versão 2 do arXiv dizia que a escolha da métrica era "provavelmente responsável por inteiro"; a versão publicada na NeurIPS passou a "possivelmente responsável por algumas" das habilidades relatadas.
Há mais quatro limites. O teste direto cobre aritmética em uma família com quatro pontos de escala; PaLM, Gopher e Chinchilla eram privados, e só restou reanalisar o publicado. O argumento das comparações múltiplas é uma estimativa, não um teste. Os autores falam em ~10⁶ trios tarefa-métrica-família no BIG-Bench, mas as próprias parcelas (≥ 220 tarefas × ~40 métricas × ~10 famílias) dão perto de 10⁵. De todo modo, é muita curva para nenhuma saltar por acaso. Uma métrica contínua que melhora pode estar medindo outra coisa que não a capacidade útil. E os autores admitem que a melhor métrica depende do que as pessoas valorizam, e dizem não conhecer estudo que meça se o julgamento humano tem limiar.
A crítica muda a explicação do salto, não a sua consequência para quem depende da resposta exata.
5. O que ficou em aberto
O debate mudou de pergunta: de "é real ou miragem?" para "que quantidade é suave, que transformação cria o limiar e como prever onde ele cai?".
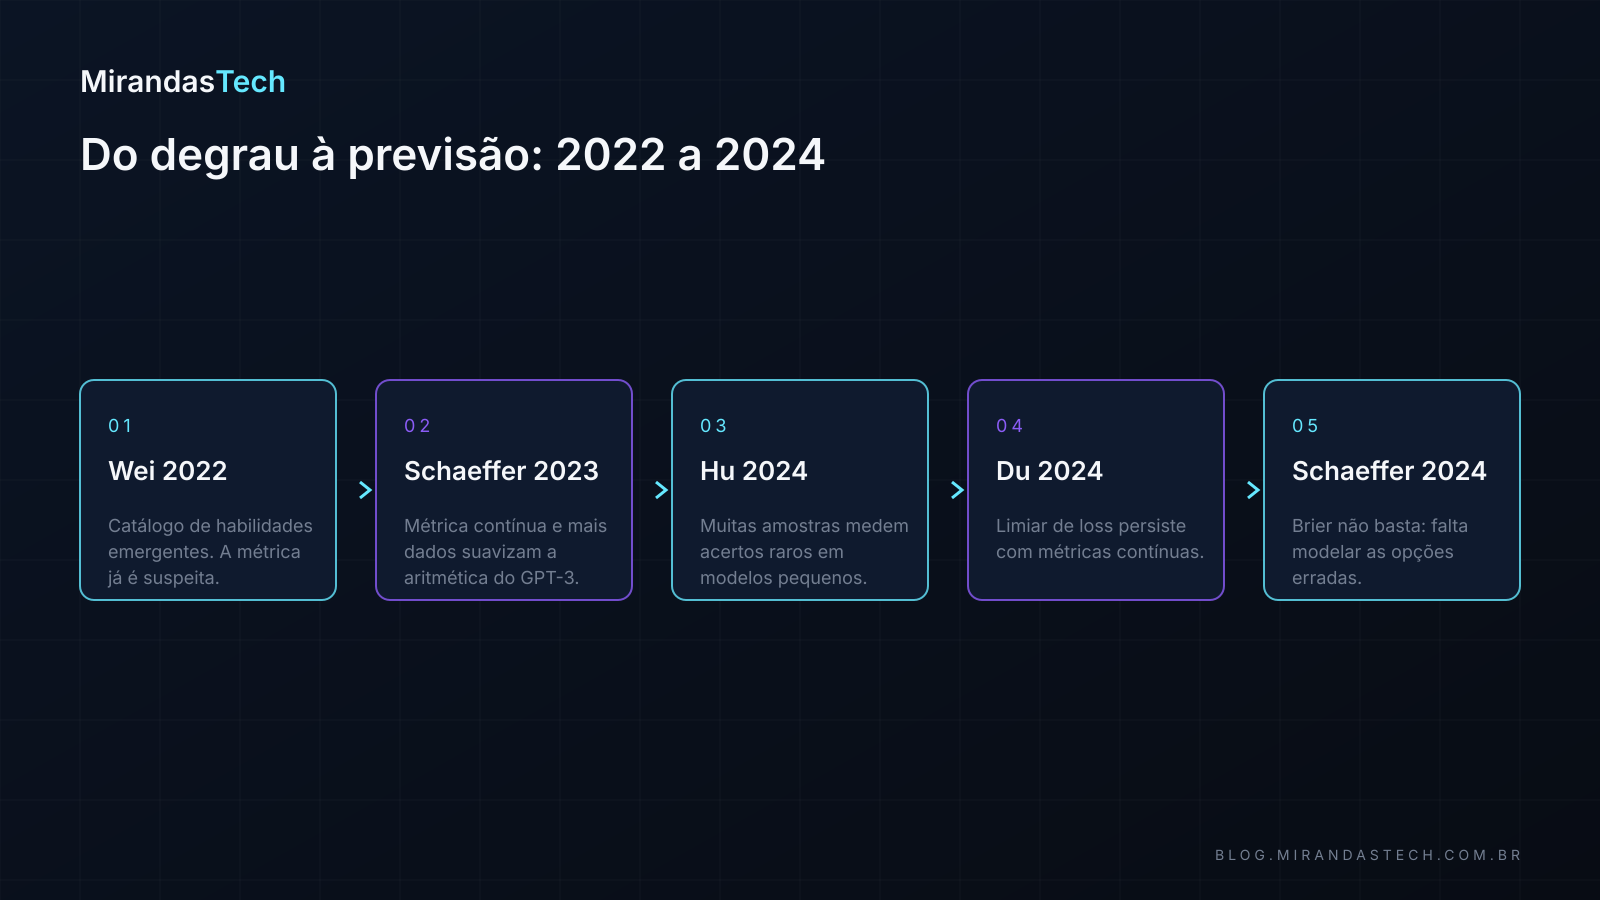
O BIG-Bench (Srivastava et al., 2023) já ligava "rupturas" a tarefas de vários passos ou métricas frágeis. Hu et al. (2024), com amostragem massiva, mediram desempenhos da ordem de 10⁻⁵ em modelos pequenos e previram o de um modelo de 2,4B em geração de código com desvio de 0,05%. Mas acharam também tarefas com "emergência acelerada", fora da lei de escala padrão.
Du et al. (2024) treinaram mais de 30 modelos com o mesmo corpus, tokenizador e arquitetura: mesma perda de pré-treino, mesmo desempenho, qualquer que seja o tamanho. No MMLU, C-Eval e GSM8K, o desempenho fica no acaso até a perda cair abaixo de cerca de 2,2, e o limiar persiste com métricas contínuas. Eles lembram que, com quatro alternativas, o Brier de quem chuta uniforme é 0,75. Acima disso, o Brier pode cair sem que o modelo distinga a opção certa: quem sempre responde (1, 0, 0, 0) marca 1,5, quem sempre responde (0,25, 0,25, 0,25, 0,25) marca 0,75, e nenhum dos dois aprendeu nada. Ressalva deles: a perda depende do tokenizador e do corpus.
Schaeffer et al. (2024) mostraram, em doze benchmarks de múltipla escolha, que prever exige modelar a massa nas opções erradas, e que trocar a acurácia pelo Brier não basta para recuperar a previsibilidade. Snell et al. (2024) preveem a emergência pelo fine-tuning, que a desloca para modelos menores, às vezes antecipando modelos com até 4 vezes mais computação.
6. O que muda para quem constrói
Para quem avalia modelos e agentes, ficam cinco regras.
Separe tarefa e métrica. Reporte a métrica do usuário (tarefa concluída, resposta exata) e, ao lado, uma de progresso parcial (passos certos, distância de edição, log-probabilidade da resposta correta). A primeira decide o produto; a segunda mostra para onde a curva vai.
Dimensione a amostra pela resolução. Com 50 casos, a menor taxa não nula que você registra é 2%, e zero acerto em 50 ainda é compatível com uma taxa verdadeira de até ~6% (limite superior de 95%, a "regra de três" 3/n). Para saber se a versão nova já resolve algo raro, use mais casos ou várias tentativas por caso.
Desconfie de degrau em agente de muitos passos. Se cada um dos $k$ passos dá certo com probabilidade $r$, e supondo independência, a tarefa inteira dá certo com $r^{k}$. A conta é a da probabilidade de eventos independentes, e a forma é a mesma do exact match.
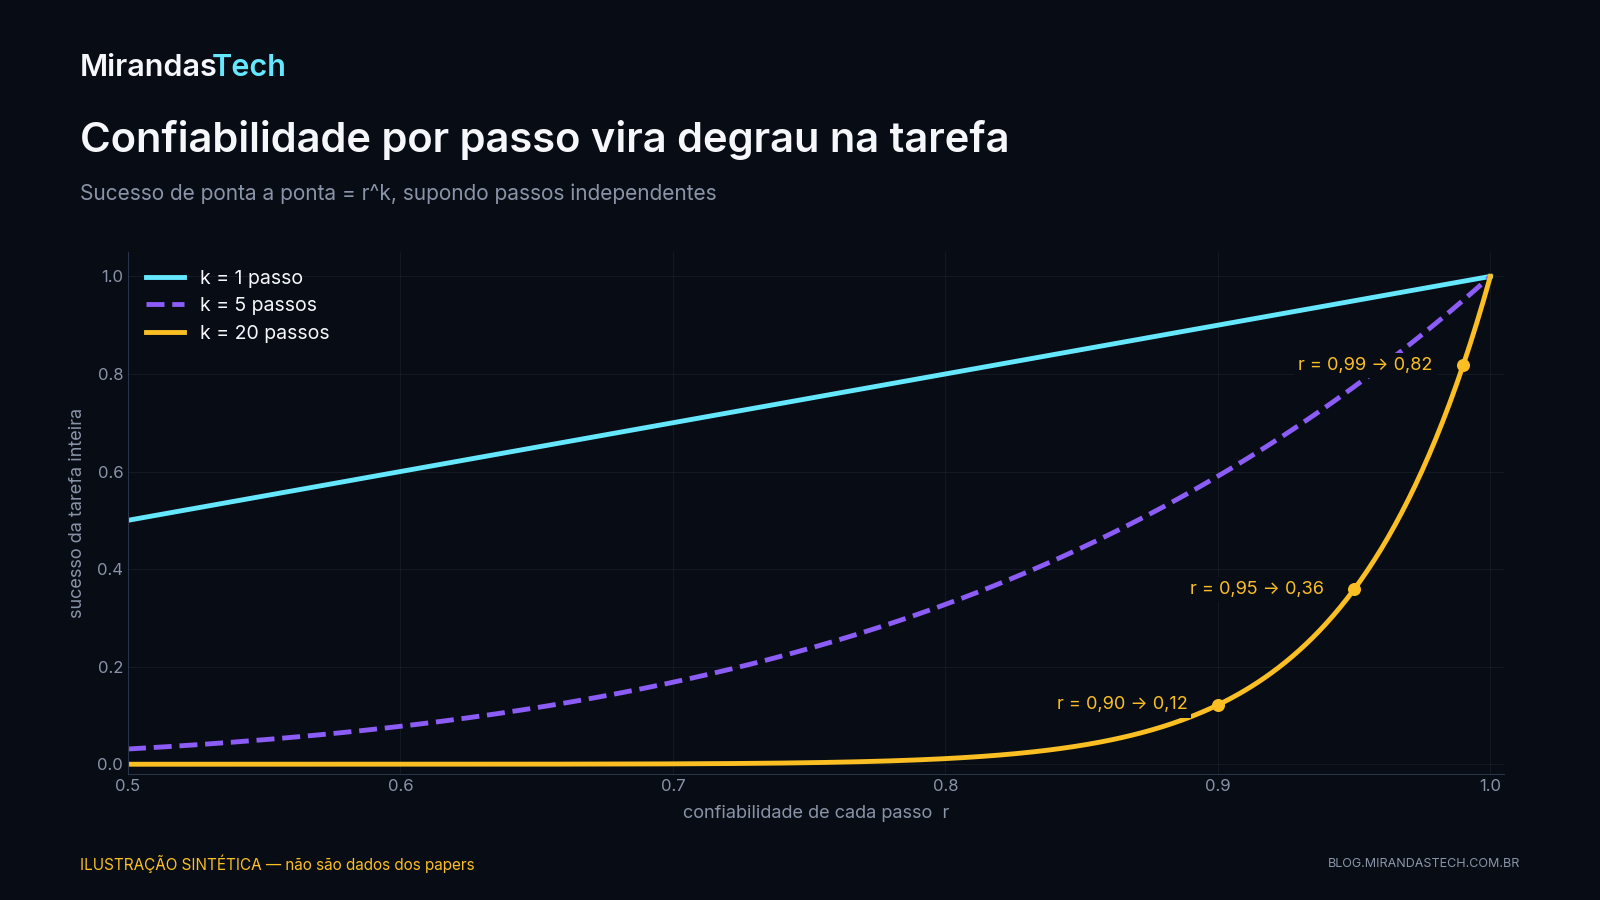
Com 20 passos, 0,90 por passo dá 0,12 na tarefa; 0,95 dá 0,36; 0,99 dá 0,82. Para o usuário o salto é real; o engenheiro deve acompanhar a confiabilidade por passo, que se mexe de forma previsível.
Cuidado com métricas contínuas sem linha de base. O Brier ou a probabilidade da resposta certa só dizem algo comparados com o acaso. Sem isso, você troca um degrau falso por uma rampa falsa (Du et al., 2024).
Conte as comparações. Um painel com 30 tarefas, 4 métricas e 6 versões tem 720 curvas. É provável que alguma salte por acaso. Fixe antes a métrica principal, como em qualquer experimento com baseline. Avaliação contínua, aliás, foi tema do Radar #2.
7. Fichamento lado a lado
Na espinha do template de fichamento do AI Lab, em versão curta:
- Problema. Wei: a escala melhora a perda de forma previsível, mas tarefas específicas não. Schaeffer: o salto foi lido como propriedade do modelo sem controlar a métrica.
- Pergunta. Wei: que habilidades só aparecem em modelos grandes? Schaeffer: o salto some se a métrica ou a amostra mudar?
- Hipótese. Wei: existem habilidades emergentes, imprevisíveis por extrapolação. Schaeffer: saltos relatados podem ser produzidos pela escolha de métricas não lineares ou descontínuas e pela baixa resolução, sem mudança de natureza no modelo. É uma explicação alternativa, e a versão publicada a aplica a "algumas" habilidades.
- Contribuição. Wei: definição e catálogo (survey). Schaeffer: modelo matemático, previsões testáveis, emergência induzida em visão.
- Método e dados. Wei: curvas publicadas de cinco famílias, sobretudo BIG-Bench e MMLU. Schaeffer: saídas do GPT-3 em aritmética, meta-análise do BIG-Bench, redes de visão.
- Baseline e métricas. Wei: o acaso; exact match, BLEU, acurácia e entropia cruzada. Schaeffer: as mesmas saídas sob acurácia × distância de edição e Multiple Choice Grade × Brier.
- Resultado. Wei: dezenas de habilidades com escala crítica. Schaeffer: o salto some na aritmética do GPT-3 e em tarefas do LaMDA; mais de 92% das emergências anotadas estão em duas métricas.
- Limitações admitidas. Wei: a escala crítica não é fixa e depende de dados e treino. Schaeffer: modelos privados, independência entre tokens falsa, preferência humana não medida.
- Threats to validity (leitura minha). Wei: classificação manual de "emergente" por dois coautores, poucos pontos de escala por família. Schaeffer: teste direto restrito a aritmética e a quatro modelos; métrica contínua sem linha de base pode apagar um limiar real, como argumentam Du et al. (2024).
O par ensina algo que vale além dos LLMs: um gráfico de escala é produto de três escolhas, o que se mede, quantas vezes e com quantos pontos de escala. Quando dois papers discordam, procure qual delas os separa.
Referências
- Wei, J.; Tay, Y.; Bommasani, R. et al. Emergent Abilities of Large Language Models. Transactions on Machine Learning Research, ago. 2022 (Survey Certification). openreview.net/forum?id=yzkSU5zdwD · arXiv:2206.07682
- Schaeffer, R.; Miranda, B.; Koyejo, S. Are Emergent Abilities of Large Language Models a Mirage? Advances in Neural Information Processing Systems 36 (NeurIPS 2023), Outstanding Main Track Paper (a v2 do arXiv, a mais recente lá, é anterior e mais assertiva que a versão publicada). proceedings.neurips.cc · arXiv:2304.15004
- Srivastava, A.; Rastogi, A.; Rao, A. et al. Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models. Transactions on Machine Learning Research, 2023. arXiv:2206.04615
- Hu, S.; Liu, X.; Han, X. et al. Predicting Emergent Abilities with Infinite Resolution Evaluation. ICLR 2024. arXiv:2310.03262
- Du, Z.; Zeng, A.; Dong, Y.; Tang, J. Understanding Emergent Abilities of Language Models from the Loss Perspective. NeurIPS 2024. arXiv:2403.15796
- Schaeffer, R.; Schoelkopf, H.; Miranda, B. et al. Why Has Predicting Downstream Capabilities of Frontier AI Models with Scale Remained Elusive? ICML 2025 (PMLR 267, p. 53177–53266). arXiv:2406.04391
- Snell, C.; Wallace, E.; Klein, D.; Levine, S. Predicting Emergent Capabilities by Finetuning. COLM 2024 (versão estendida no arXiv). arXiv:2411.16035

Este ensaio faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. O par Wei × Schaeffer está no roteiro de 14-papers; os gráficos sintéticos saem de um script com asserts guardado junto ao rascunho.