Probabilidade condicional e independência: do spam aos LLMs
Atualizar o universo de referência diante de informação observada e modelar quando eventos são dependentes, independentes ou independentes apenas sob uma condição.

Atualizar o universo de referência diante de informação observada e modelar quando eventos são dependentes, independentes ou independentes apenas sob uma condição. Pré-requisitos: a Aula 01 (incerteza, eventos e axiomas) e a Aula 02 (contagem e combinatória). Tempo sugerido: 3 a 4 horas, com o laboratório e os exercícios.
Um filtro de spam analisou 1 000 mensagens. Em 200 delas a classe real era spam; nas outras 800, mensagem legítima. Sem saber mais nada, a chance de uma mensagem qualquer ser spam é de 20%. Agora o filtro observa um detalhe: a mensagem contém um padrão de link suspeito. A chance muda? Muda, e muito: entre as mensagens com esse padrão, cerca de 65% são spam.
Nenhum registro foi alterado. O que mudou foi o grupo de mensagens que ainda são compatíveis com o que sabemos. Essa troca de grupo de referência é a probabilidade condicional, e ela está por trás de quase tudo o que um modelo probabilístico faz: classificar uma mensagem a partir de evidências, prever o próximo token a partir do prefixo, combinar alertas de sensores ou de agentes.
Na primeira aula da série definimos eventos e axiomas; na segunda, como contar casos sem enumerá-los. Aqui, o universo passa a ser restringido pelo que foi observado. Ao final, você vai saber calcular $P(A\mid B)$ em tabelas, conjuntos e árvores sem trocar o denominador; distinguir $P(A\mid B)$ de $P(B\mid A)$; usar a regra do produto, a regra da cadeia e a lei da probabilidade total; testar independência pela fatoração; separar independência de exclusão mútua; reconhecer uma hipótese de independência condicional, como a do Naive Bayes; e conferir tudo por simulação reproduzível em Python.
1. O denominador mudou
A tabela das mensagens cruza a classe real (spam ou legítima) com a presença do padrão de link suspeito. Chame de $S$ o evento “é spam” e de $L$ o evento “tem o link”.
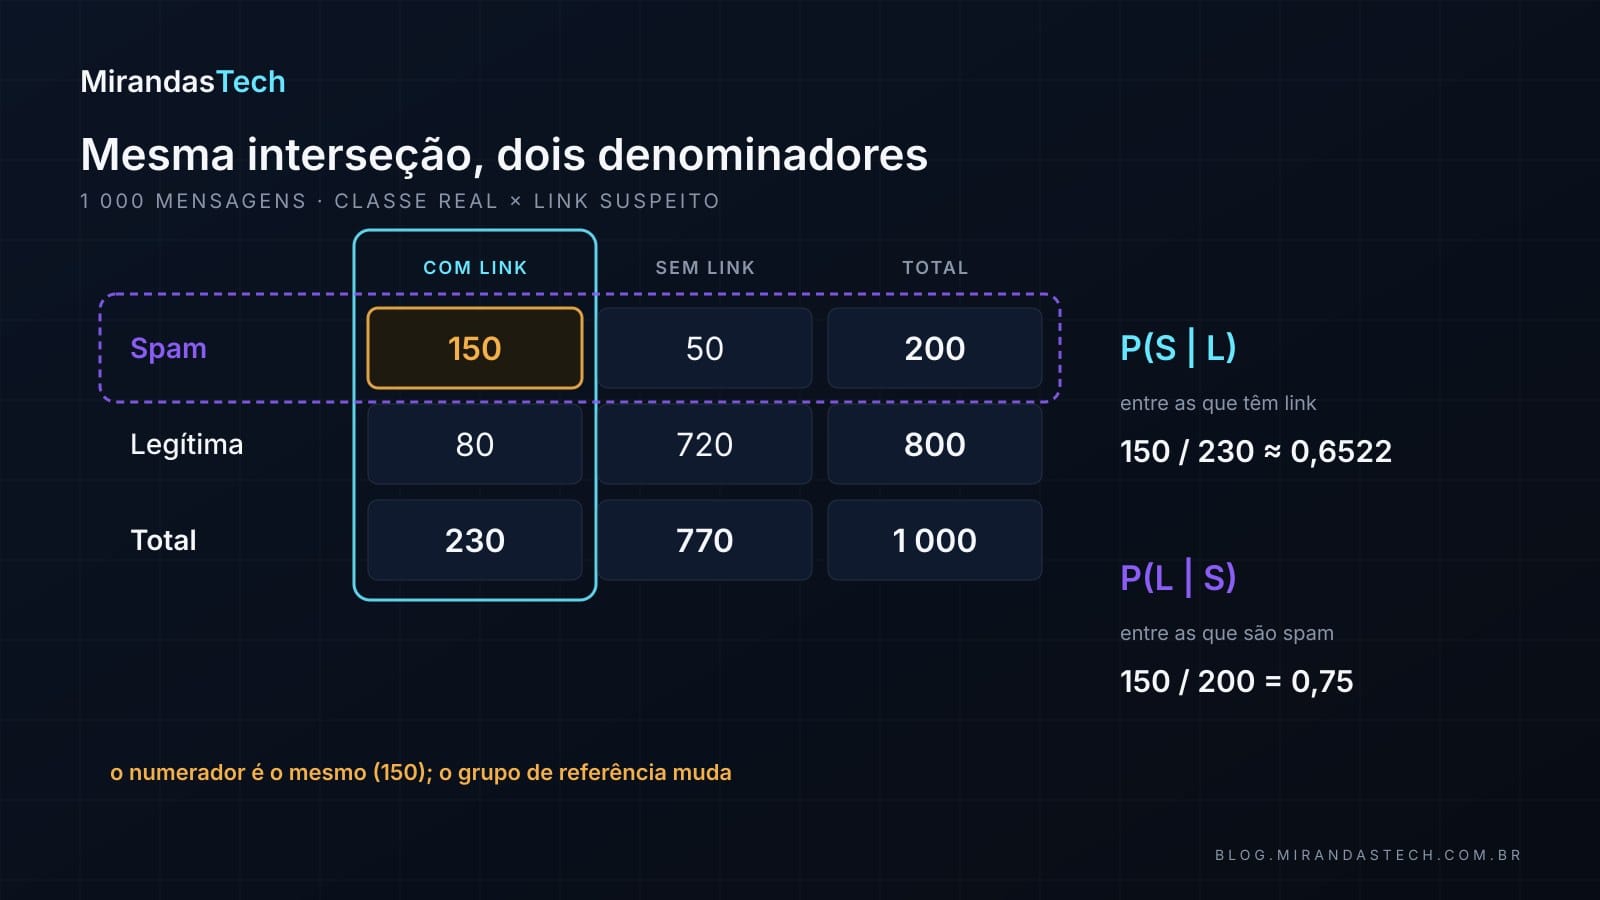
Os números da tabela, em lista:
- Spam: 150 com link, 50 sem link, 200 no total.
- Legítima: 80 com link, 720 sem link, 800 no total.
- Total: 230 com link, 770 sem link, 1 000 mensagens.
Antes de olhar o link, a proporção de spam é
$$P(S)=\frac{200}{1\,000}=0{,}20.$$
Depois de saber que a mensagem contém o padrão, o universo relevante deixa de ter 1 000 mensagens. Passamos a olhar só as 230 com link; dessas, 150 são spam:
$$P(S\mid L)=\frac{150}{230}\approx0{,}6522.$$
A informação $L$ elevou a probabilidade de spam de 20% para cerca de 65,22%. Agora inverta a pergunta e olhe só para as 200 mensagens de spam:
$$P(L\mid S)=\frac{150}{200}=0{,}75.$$
As duas razões usam a mesma interseção de 150 mensagens, mas denominadores diferentes. Confundi-las é um dos erros mais comuns em diagnóstico e classificação, e o caminho mais curto para evitá-lo é fazer o que a tabela já faz: pensar em contagens. Gigerenzer e Hoffrage (1995) mostraram que esse tipo de raciocínio fica computacionalmente mais simples quando a informação vem em frequências (“150 de 230”) do que em probabilidades, e que, nesse formato, participantes sem treino estatístico chegaram à resposta por um raciocínio bayesiano em até metade das inferências.
Um procedimento seguro para ler qualquer tabela de contingência:
- circule a condição, à direita da barra;
- use o total dessa linha ou coluna como denominador;
- use a célula de interseção como numerador;
- verifique se o resultado está entre 0 e 1;
- escreva a interpretação com palavras.
Para $P(S\mid L)$: “entre as mensagens com link suspeito, cerca de 65,22% são spam”. A probabilidade conjunta, sem condição nenhuma, é outra coisa: $P(S\cap L)=150/1\,000=0{,}15$, a fração de todas as mensagens que são spam e têm o link.
2. A definição: restringir e renormalizar
Três nomes aparecem o tempo todo daqui em diante. A probabilidade marginal é a de um evento sem fixar outro, como $P(S)$. A conjunta é a de eventos que ocorrem juntos, como $P(S\cap L)$. A condicional é a de um evento no universo restrito por outro, como $P(S\mid L)$. A barra vertical se lê “dado que”; ela não é uma divisão por si só. A divisão aparece na definição. Para eventos $A$ e $B$ com $P(B)>0$:
$$P(A\mid B)=\frac{P(A\cap B)}{P(B)}.$$
Em palavras: $A$ é o evento cuja chance queremos; $B$ é o que sabemos que aconteceu; $A\cap B$ são os resultados que satisfazem os dois; $P(B)$ é a massa do novo universo. A fórmula faz três movimentos: $B$ restringe os resultados ainda possíveis; $A\cap B$ seleciona, entre eles, os que também satisfazem $A$; e a divisão por $P(B)$ renormaliza o novo universo para que sua massa total volte a ser 1 (Bertsekas & Tsitsiklis, 2008; Goodfellow et al., 2016).
Quando os resultados elementares são equiprováveis, a definição vira uma contagem:
$$P(A\mid B)=\frac{|A\cap B|}{|B|}.$$
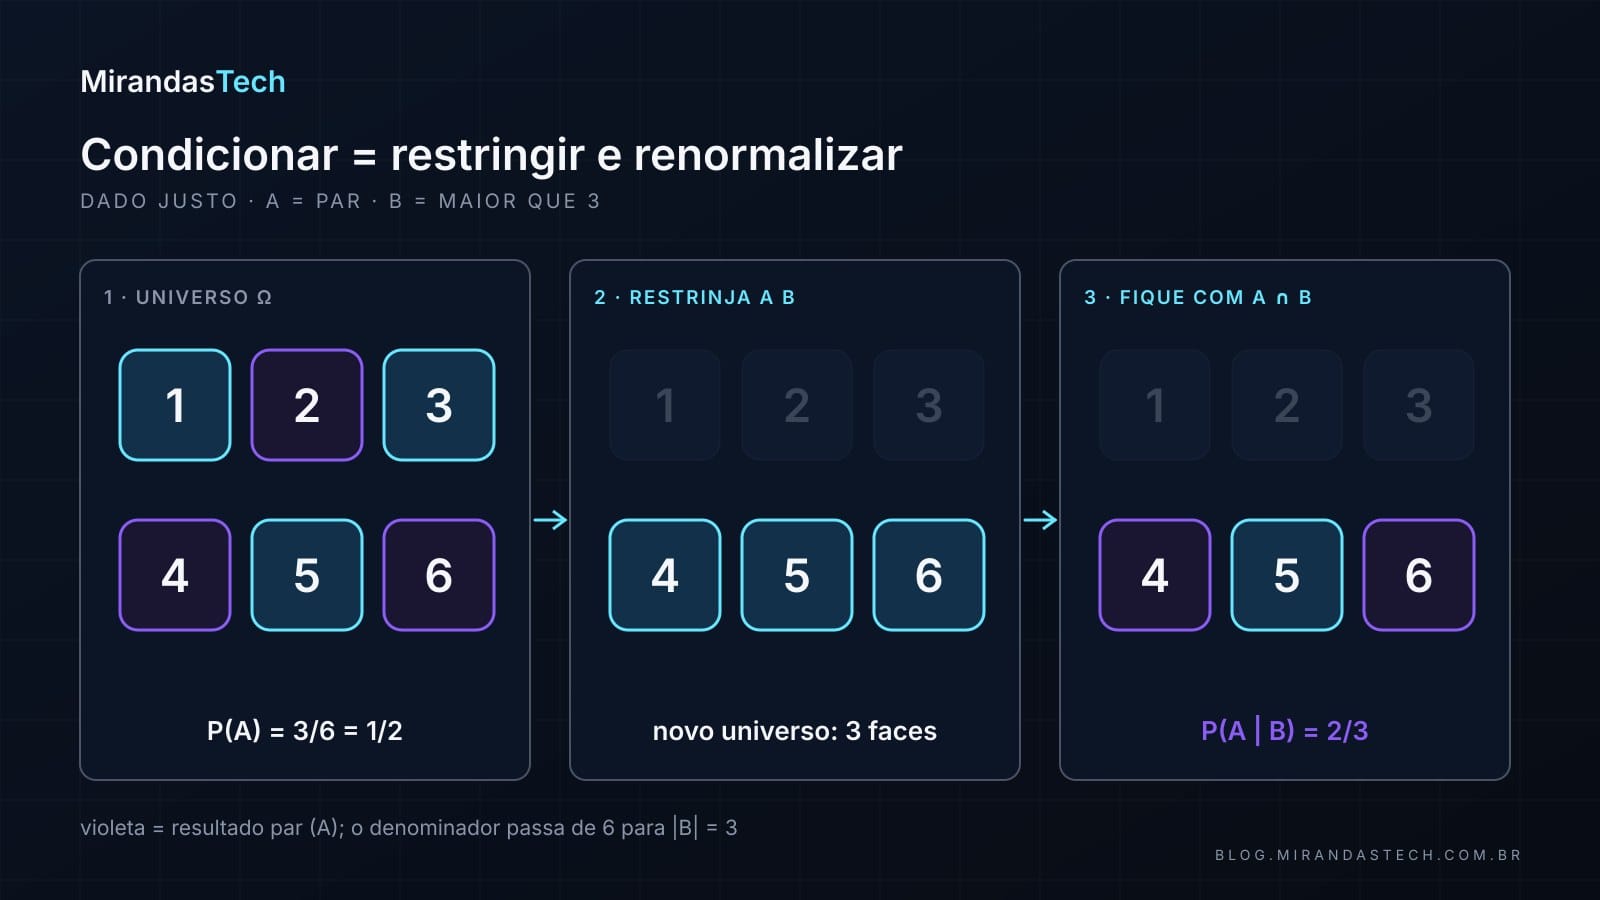
O denominador é $|B|$, não $|\Omega|$. Num dado justo, com $\Omega=\{1,2,3,4,5,6\}$, tome $A=\{2,4,6\}$ (resultado par) e $B=\{4,5,6\}$ (resultado maior que 3). Sabendo que $B$ ocorreu, o novo universo é $\{4,5,6\}$; nele, os pares são $\{4,6\}$:
$$P(A\mid B)=\frac{|A\cap B|}{|B|}=\frac{2}{3}.$$
Sem a informação, $P(A)=3/6=1/2$. Observar $B$ aumentou a chance de $A$.
Condicionamento não implica causalidade. Saber que o resultado é maior que 3 informa sobre a paridade, mas não “causa” o número a ser par.
E se $P(B)=0$? A razão não é definida, porque exigiria dividir por zero. Em modelos contínuos, condicionar num valor pontual exige densidades ou construções mais gerais, e isso não autoriza trocar o denominador por um número qualquer. Daqui em diante, todo evento condicionante tem probabilidade positiva.
3. Regra do produto: dois ases seguidos
Reorganizando a definição, a probabilidade de dois eventos juntos sai de uma condicional:
$$\begin{aligned}P(A\cap B)&=P(B)\,P(A\mid B)\\&=P(A)\,P(B\mid A).\end{aligned}$$
O raciocínio é “probabilidade de chegar à condição” vezes “probabilidade de continuar até o evento desejado”. Num baralho comum de 52 cartas, qual a chance de as duas primeiras serem ases? Seja $A_1$ “a primeira é ás” e $A_2$ “a segunda é ás”.
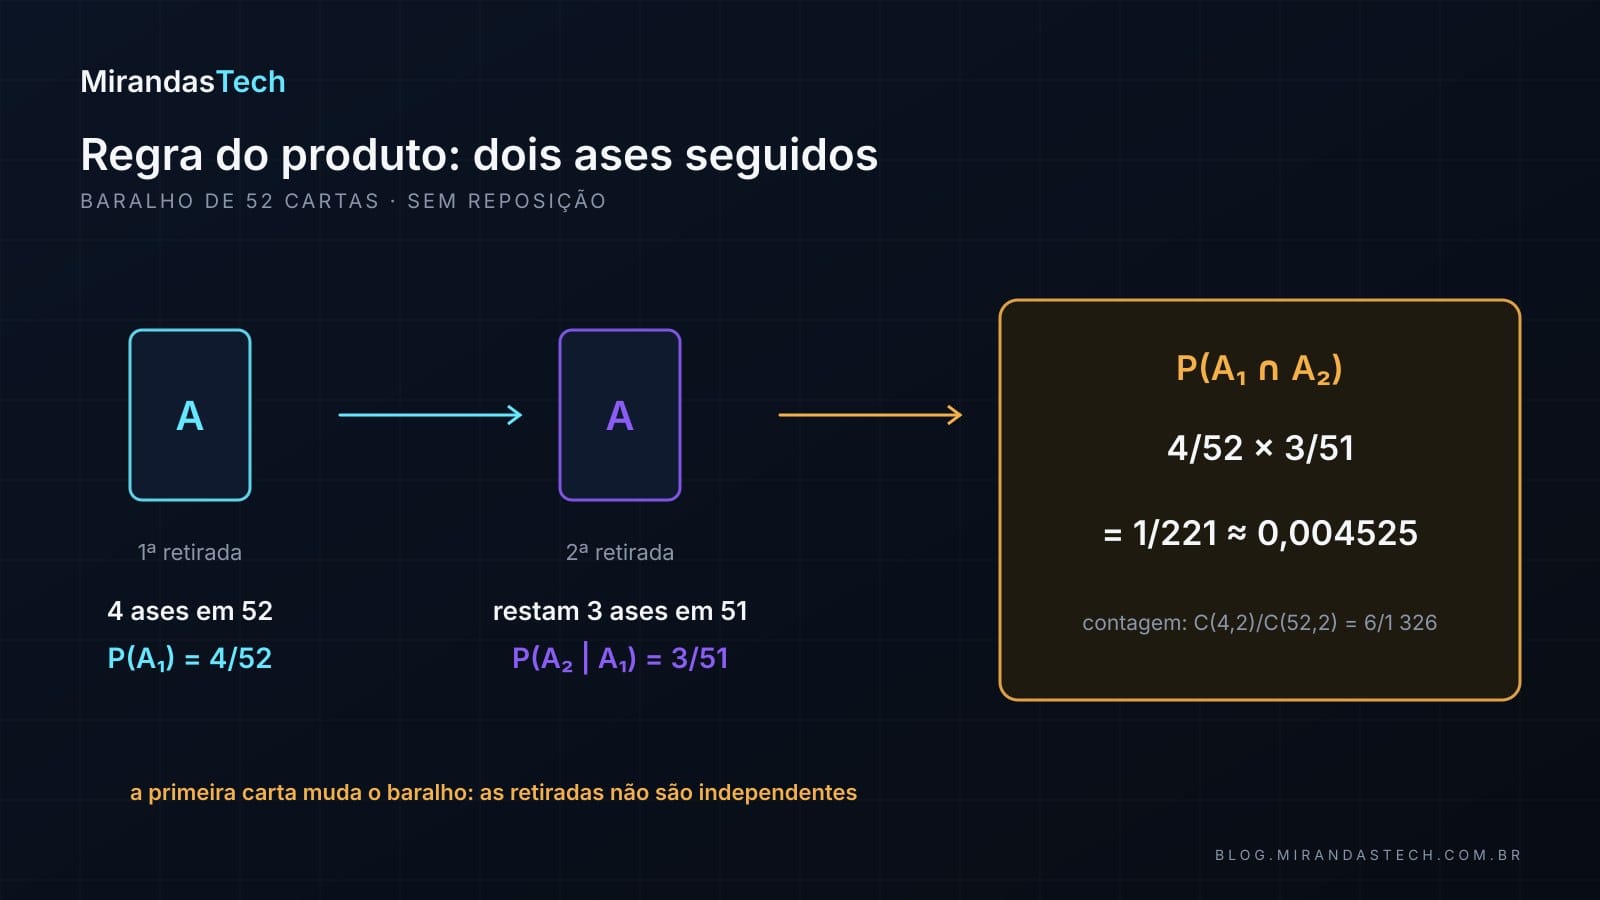
$$P(A_1)=\frac{4}{52},\qquad P(A_2\mid A_1)=\frac{3}{51},$$ $$P(A_1\cap A_2)=\frac{4}{52}\cdot\frac{3}{51}=\frac{1}{221}\approx0{,}004525.$$
Pela combinatória da aula anterior, o resultado é o mesmo: $\binom{4}{2}/\binom{52}{2}=6/1\,326=1/221$. As retiradas não são independentes, porque a primeira modifica a composição do baralho; por isso o segundo fator é $3/51$, e não $4/52$.
4. Regra da cadeia e modelos de linguagem
Aplicando a regra do produto várias vezes, três eventos viram uma sequência de condicionais:
$$\begin{aligned}P(A\cap B\cap C)=\;&P(A)\,P(B\mid A)\\&\cdot P(C\mid A\cap B).\end{aligned}$$
Para uma sequência $X_1,\ldots,X_T$, a mesma ideia dá a regra da cadeia (Goodfellow et al., 2016, §3.6):
$$P(X_1,\ldots,X_T)=\prod_{t=1}^{T}P(X_t\mid X_1,\ldots,X_{t-1}).$$
O símbolo $\prod$ é o produto dos $T$ fatores; cada fator é a probabilidade do elemento $t$ dado todo o prefixo antes dele (para $t=1$, o prefixo é vazio e o fator é só $P(X_1)$). Essa fatoração não assume independência: ela apenas decompõe uma distribuição conjunta em condicionais.
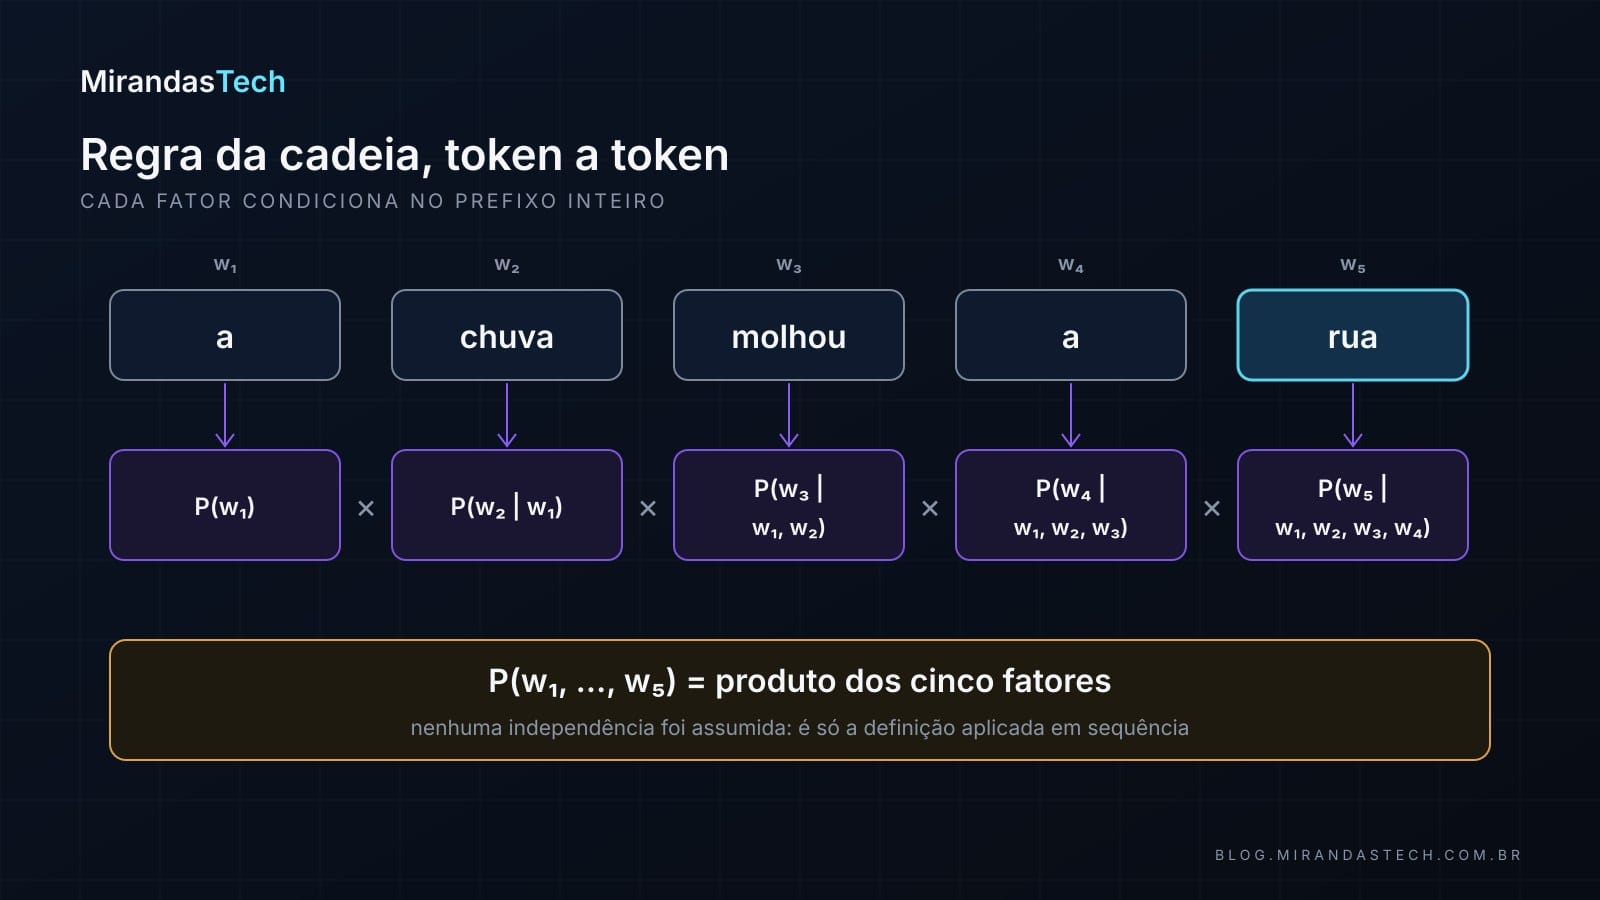
É exatamente assim que um modelo de linguagem autorregressivo atribui probabilidade a uma sequência de tokens:
$$P(w_1,\ldots,w_T)=\prod_{t=1}^{T}P(w_t\mid w_1,\ldots,w_{t-1}).$$
Bengio et al. (2003) partem dessa mesma decomposição para definir um modelo estatístico de linguagem, e lembram que os modelos n-grama a aproximam condicionando cada palavra só nas $n-1$ anteriores. Os grandes modelos de linguagem do tipo decoder-only, como GPT-3 e PaLM, são treinados justamente para prever cada token a partir dos anteriores, maximizando $\sum_t \log P(w_t\mid w_{<t})$, que é o logaritmo dessa mesma fatoração (Zhao et al., 2026). O que muda em relação aos n-gramas é como cada fator é calculado e quanto do prefixo cabe no contexto. Na prática, o contexto é limitado pelo modelo e as probabilidades dependem da tokenização. A equação explica por que o próximo token é condicionado ao prefixo; ela não afirma que tokens distantes sejam causalmente relacionados.
5. Árvores de probabilidade
Uma árvore deixa os caminhos condicionais à vista. Para as mensagens, o primeiro nível separa spam de legítima; o segundo, com e sem link, já condicionado à classe.
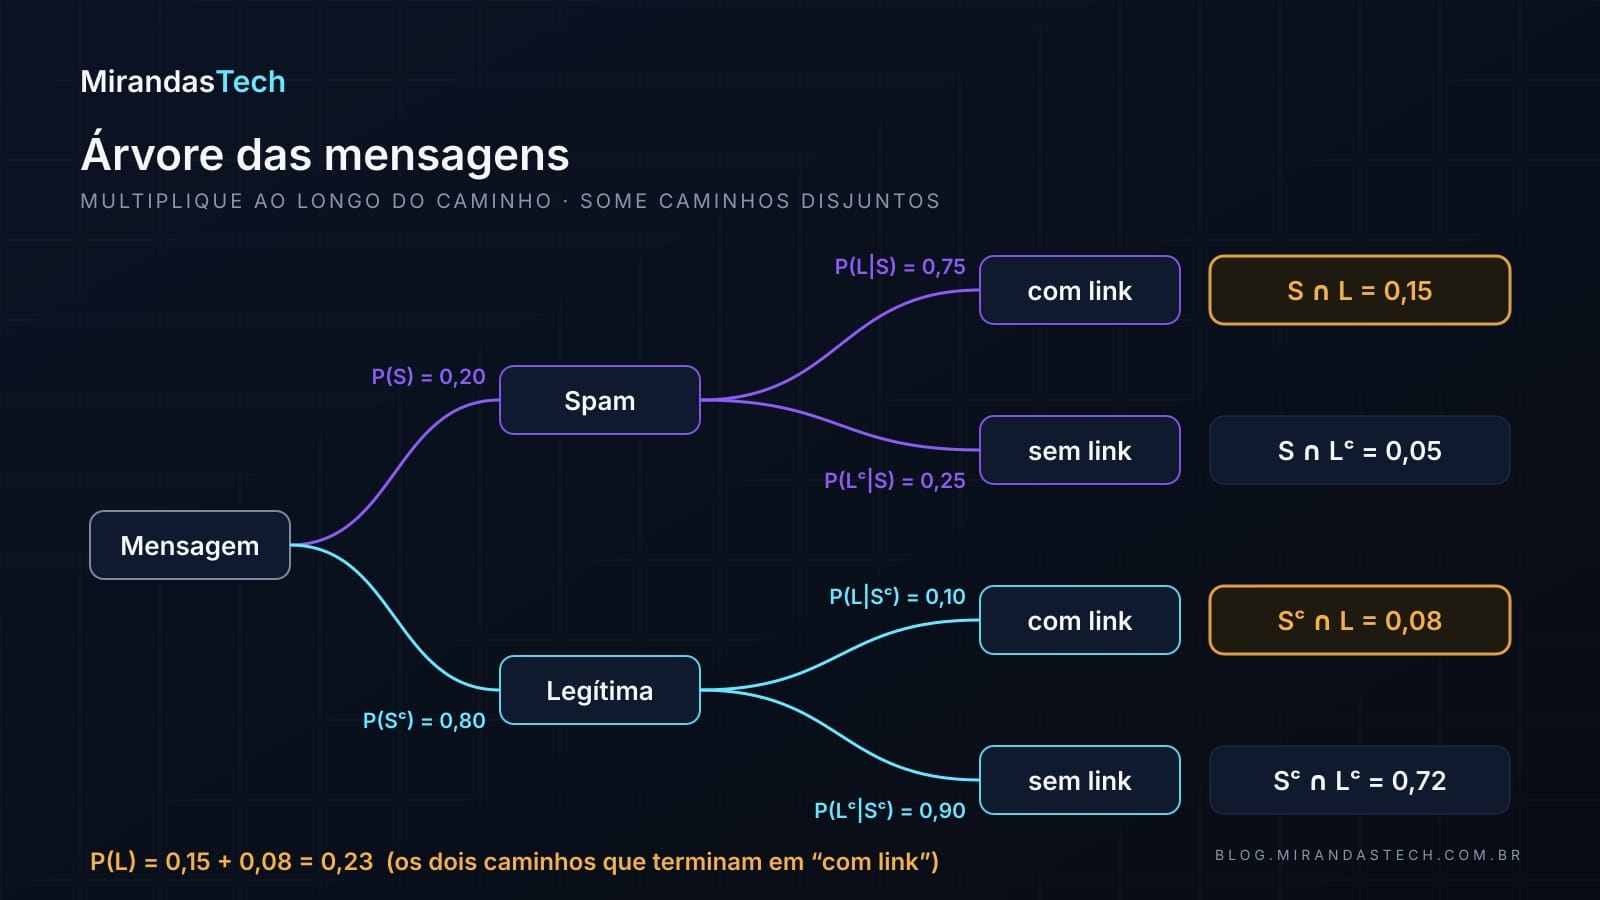
Os valores dos ramos de baixo vêm da tabela: $P(L\mid S)=150/200=0{,}75$ e $P(L\mid S^c)=80/800=0{,}10$, onde $S^c$ é o complemento de $S$ (a mensagem é legítima). Multiplicando ao longo de um caminho:
$$P(S\cap L)=0{,}20\cdot0{,}75=0{,}15.$$
As quatro folhas somam 1 (0,15 + 0,05 + 0,08 + 0,72), como toda partição completa deve somar. Quando um evento pode ser alcançado por mais de uma rota, somam-se os caminhos disjuntos que terminam nele. É o próximo passo.
6. Lei da probabilidade total
Se $B_1,\ldots,B_k$ formam uma partição de $\Omega$, então, para qualquer evento $A$:
$$P(A)=\sum_{i=1}^{k}P(A\mid B_i)\,P(B_i).$$
Cada $B_i$ é um cenário; $P(B_i)$ é o peso do cenário; $P(A\mid B_i)$ é a chance de $A$ dentro dele. Uma partição exige que os cenários não se sobreponham ($B_i\cap B_j=\varnothing$ para $i\neq j$), que juntos cubram tudo ($\bigcup_i B_i=\Omega$) e que cada um tenha probabilidade positiva para que a condicional esteja definida.
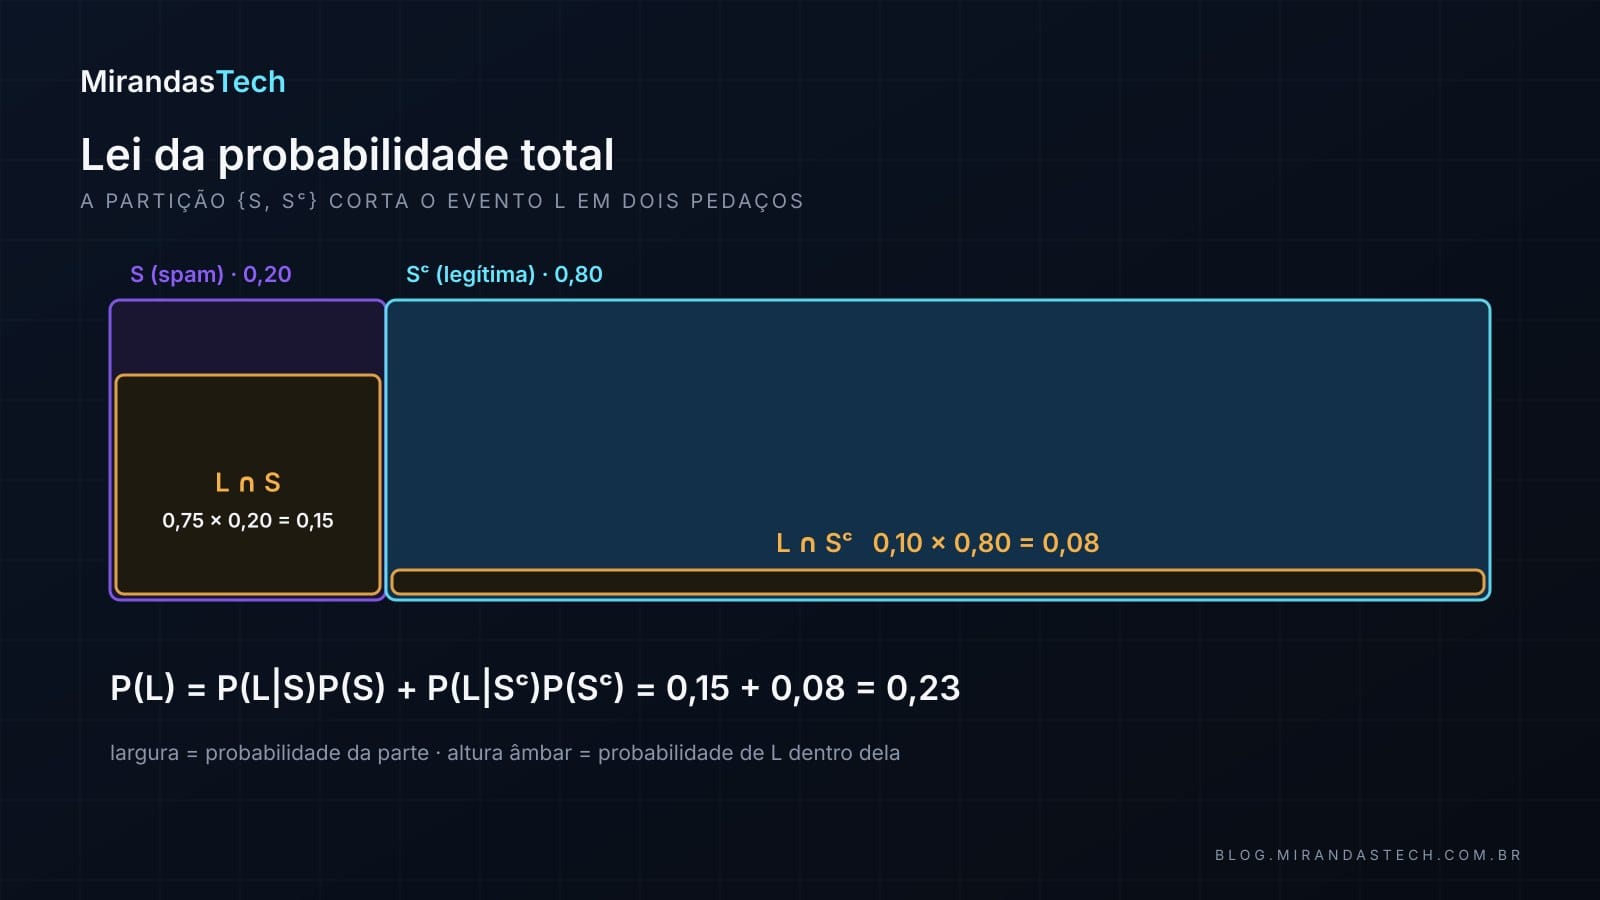
As classes spam e legítima particionam as mensagens, então a fração de mensagens com link é
$$\begin{aligned}P(L)&=P(L\mid S)\,P(S)+P(L\mid S^c)\,P(S^c)\\&=0{,}75\cdot0{,}20+0{,}10\cdot0{,}80\\&=0{,}15+0{,}08=0{,}23.\end{aligned}$$
É o mesmo 230/1 000 da tabela, agora reconstruído a partir de condicionais. A lei total constrói uma probabilidade marginal ponderando cenários, e é ela que relaciona condicionais a probabilidades não condicionais (Bertsekas & Tsitsiklis, 2008, §1.4). Na Aula 04 da série, esse mesmo denominador será usado para inverter condicionais de forma sistemática, com o Teorema de Bayes.
7. Independência
Os eventos $A$ e $B$ são independentes quando
$$P(A\cap B)=P(A)\,P(B),$$
e escrevemos $A\perp B$. Quando $P(B)>0$, isso equivale a $P(A\mid B)=P(A)$: saber que $B$ ocorreu não altera a chance de $A$. Quando $P(A)>0$, equivale também a $P(B\mid A)=P(B)$. A independência é, portanto, simétrica. Bertsekas e Tsitsiklis (2008) adotam a forma do produto como definição justamente porque ela continua válida quando $P(B)=0$, caso em que a condicional nem existe.
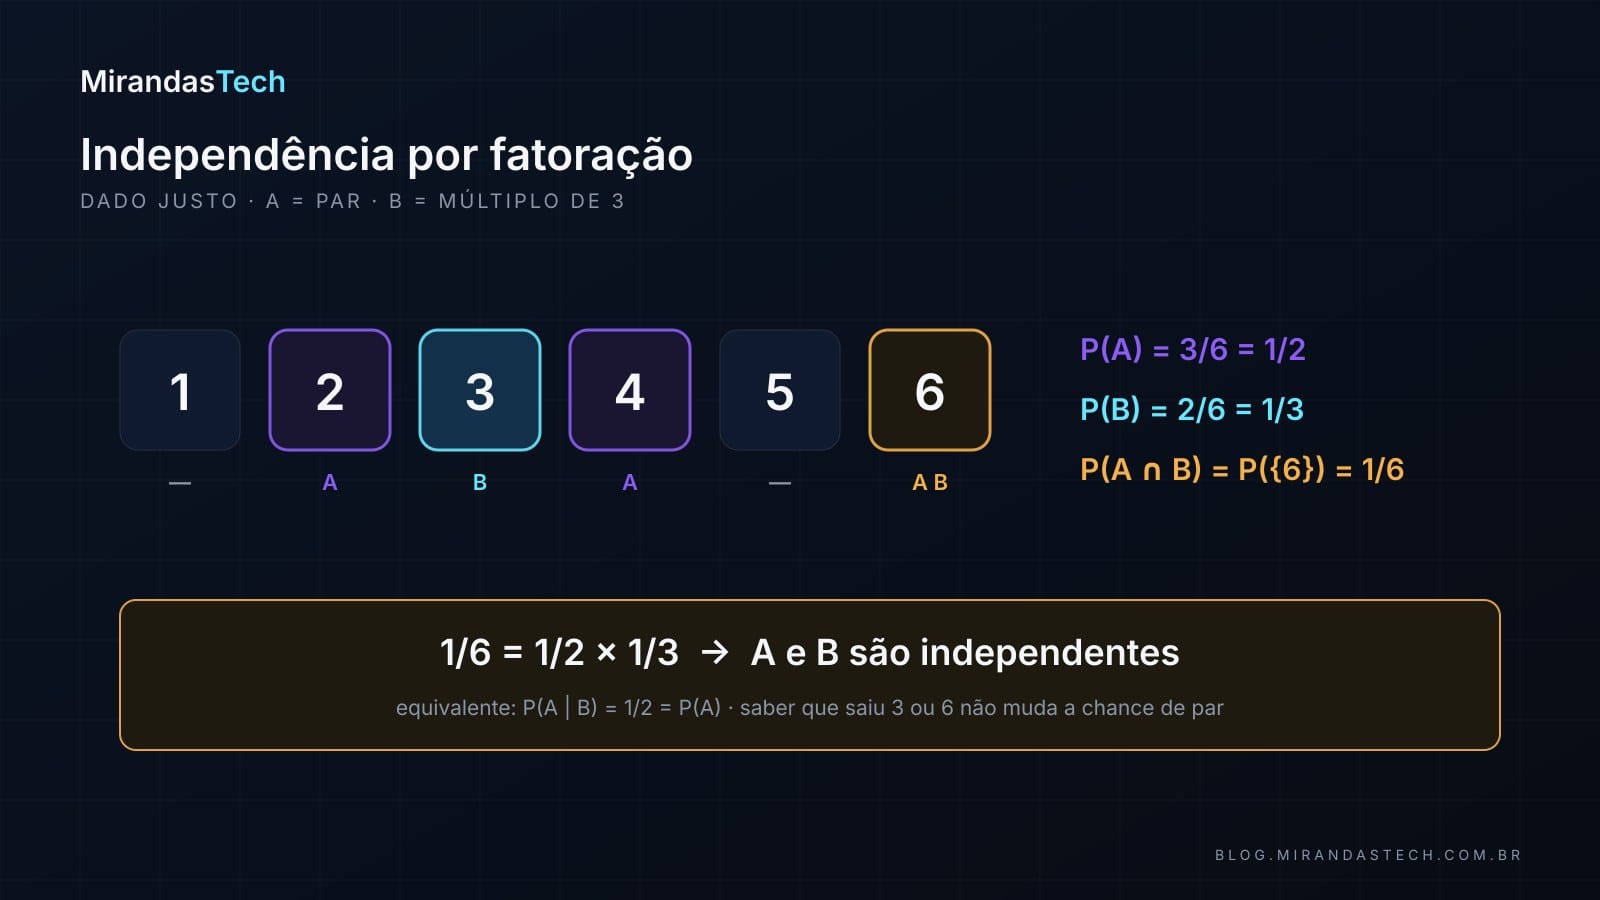
No dado justo, tome $A=\{2,4,6\}$ (par) e $B=\{3,6\}$ (múltiplo de 3):
$$P(A)=\frac{1}{2},\qquad P(B)=\frac{1}{3},$$ $$P(A\cap B)=P(\{6\})=\frac{1}{6}=\frac{1}{2}\cdot\frac{1}{3}.$$
Os eventos são independentes nesse modelo. Saber que saiu 3 ou 6 deixa a chance de par em $1/2$, a mesma de antes.
Independência é uma propriedade da distribuição, não da aparência dos nomes ou da ausência de uma seta causal óbvia.
8. Independência não é exclusão mútua
Eventos disjuntos (mutuamente exclusivos) não ocorrem juntos: $A\cap B=\varnothing$, logo $P(A\cap B)=0$. Eventos independentes podem ocorrer juntos; o que não acontece é um alterar a probabilidade do outro. As duas relações costumam ser confundidas, e Bertsekas e Tsitsiklis (2008) observam que a verdade é o oposto da intuição: dois eventos disjuntos com probabilidades positivas nunca são independentes.
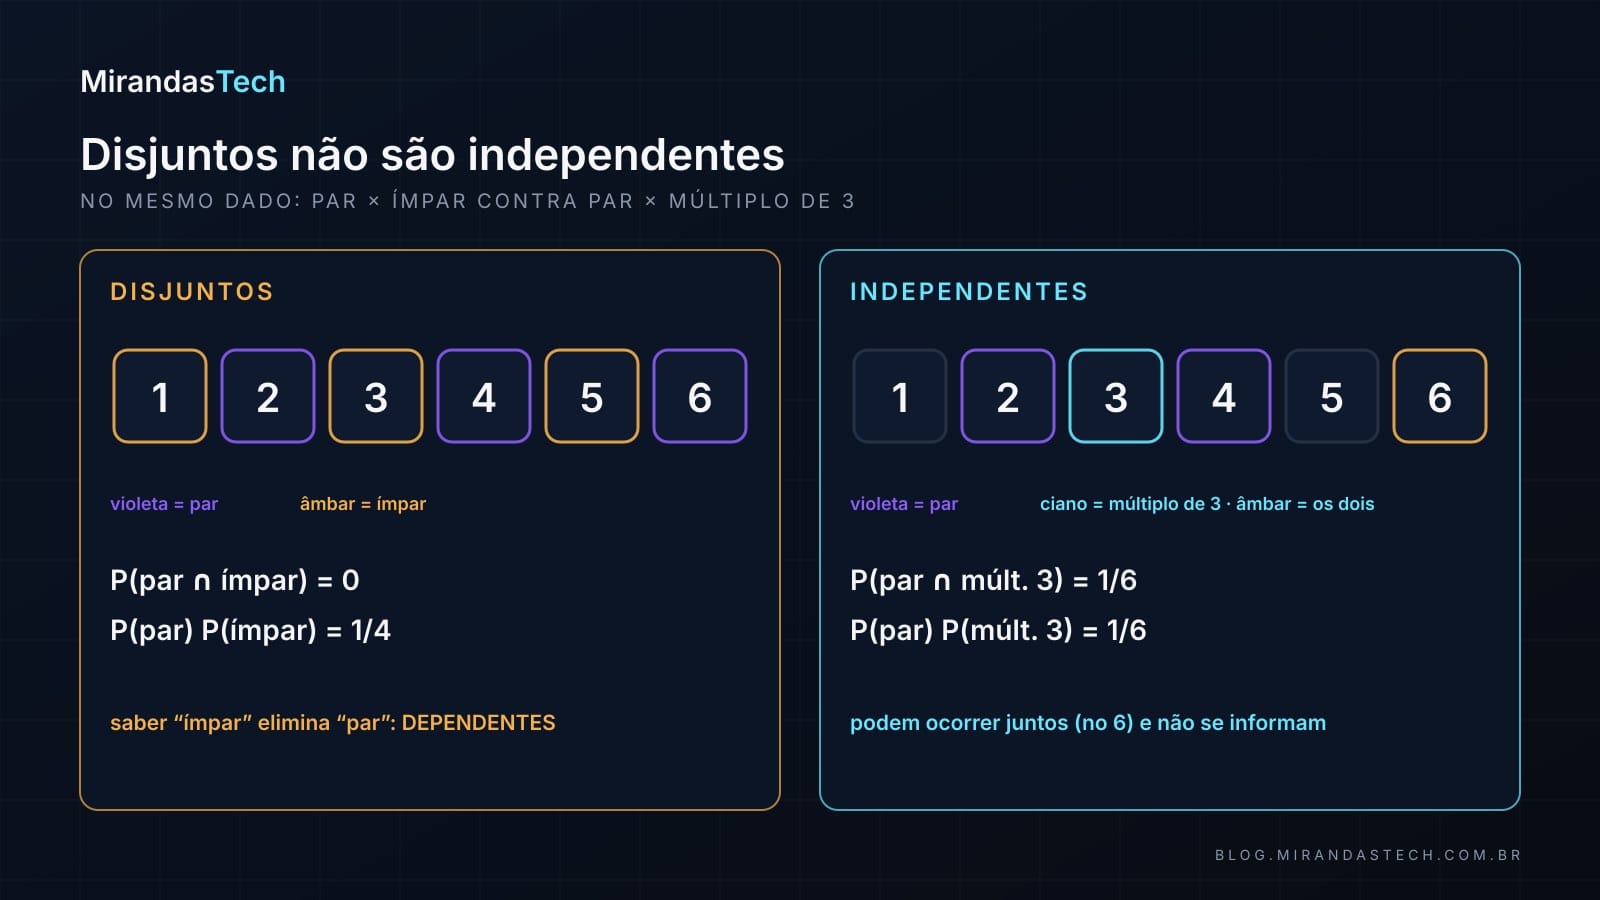
O argumento é curto. Se $A$ e $B$ são disjuntos e ambos têm probabilidade positiva,
$$P(A\mid B)=\frac{P(A\cap B)}{P(B)}=0\neq P(A).$$
Saber que $B$ ocorreu elimina $A$, e isso é a dependência mais forte possível. No dado, “par” e “ímpar” são disjuntos e dependentes. Já “par” e “múltiplo de 3” ocorrem juntos no resultado 6 e são independentes.
9. Hipótese de independência: útil, mas precisa ser defendida
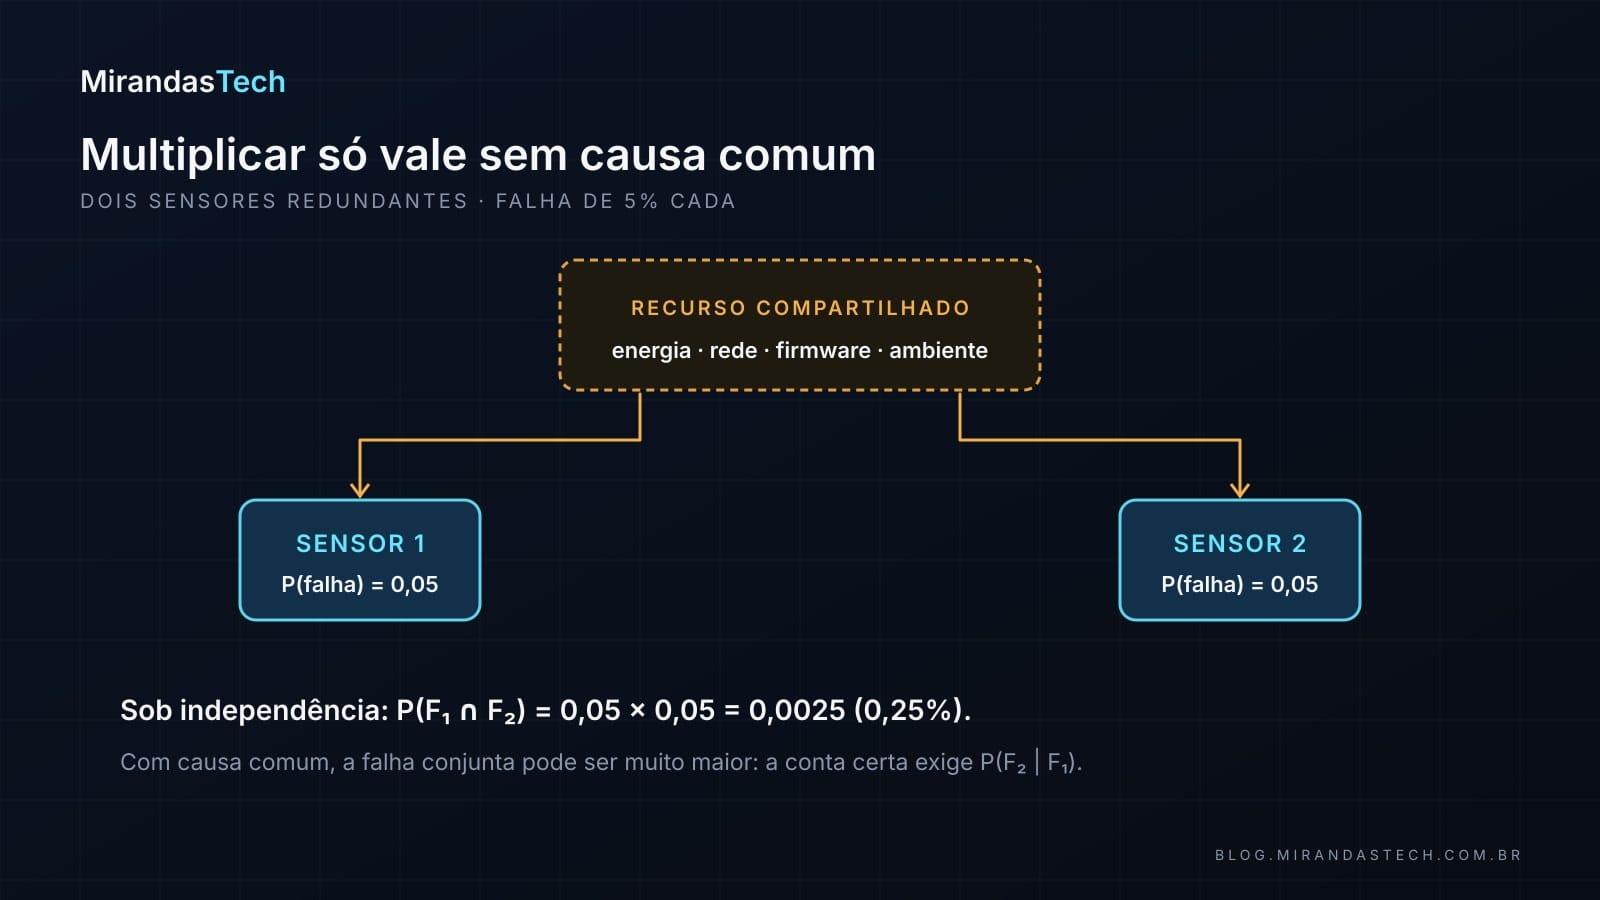
Dois sensores redundantes, cada um com probabilidade de falha de 0,05. Se as falhas forem independentes:
$$P(F_1\cap F_2)=0{,}05\cdot0{,}05=0{,}0025,$$
ou 0,25%. A conta é tentadora porque a redundância parece reduzir o risco em vinte vezes. Mas ela só vale se nada ligar as duas falhas. Se os sensores compartilham energia, rede, firmware ou ambiente, uma causa comum pode derrubar os dois ao mesmo tempo, e a falha conjunta fica muito acima de 0,25%.
Antes de multiplicar probabilidades, pergunte:
- há causa comum?
- há recurso compartilhado?
- uma observação altera fisicamente as próximas?
- houve amostragem por grupos, tempo ou local?
- a independência vale no domínio de produção ou apenas no conjunto de teste?
O problema não é só de engenharia de confiabilidade. Clemen e Winkler (1985) analisaram o que acontece quando informações vêm de fontes que não são independentes e concluíram que a dependência positiva entre as fontes pode reduzir de forma séria a precisão e o valor do conjunto: com dependência, o valor acrescentado por cada fonte nova pode cair muito depressa. Uma fórmula correta aplicada a uma hipótese falsa produz uma resposta enganosa.
10. Independência condicional
Dois eventos podem ser dependentes no conjunto total e independentes depois de fixar uma condição $C$. Para um evento $C$ com $P(C)>0$, dizemos que $A$ e $B$ são condicionalmente independentes dado $C$, e escrevemos $A\perp B\mid C$, quando
$$P(A\cap B\mid C)=P(A\mid C)\,P(B\mid C),$$
(Bertsekas & Tsitsiklis, 2008; Goodfellow et al., 2016, §3.7). Quando a condição é uma variável, como o estado do tempo, a igualdade precisa valer em cada um dos seus valores; no exemplo abaixo, em $C$ e em $C^c$. Compare as duas afirmações, escrevendo $P(A,B)$ para $P(A\cap B)$, como é comum: $A\perp B$ diz que $P(A,B)=P(A)P(B)$; $A\perp B\mid C$ diz que $P(A,B\mid C)=P(A\mid C)P(B\mid C)$. Uma não implica a outra.
A intuição clássica é a causa comum. Imagine, num exemplo didático, dois sensores externos que disparam alerta com probabilidade 0,8 quando chove e 0,1 quando não chove, e que chove em 30% dos dias. Dentro de cada estado do tempo, os alertas são independentes. Sem olhar o tempo, porém, eles andam juntos.
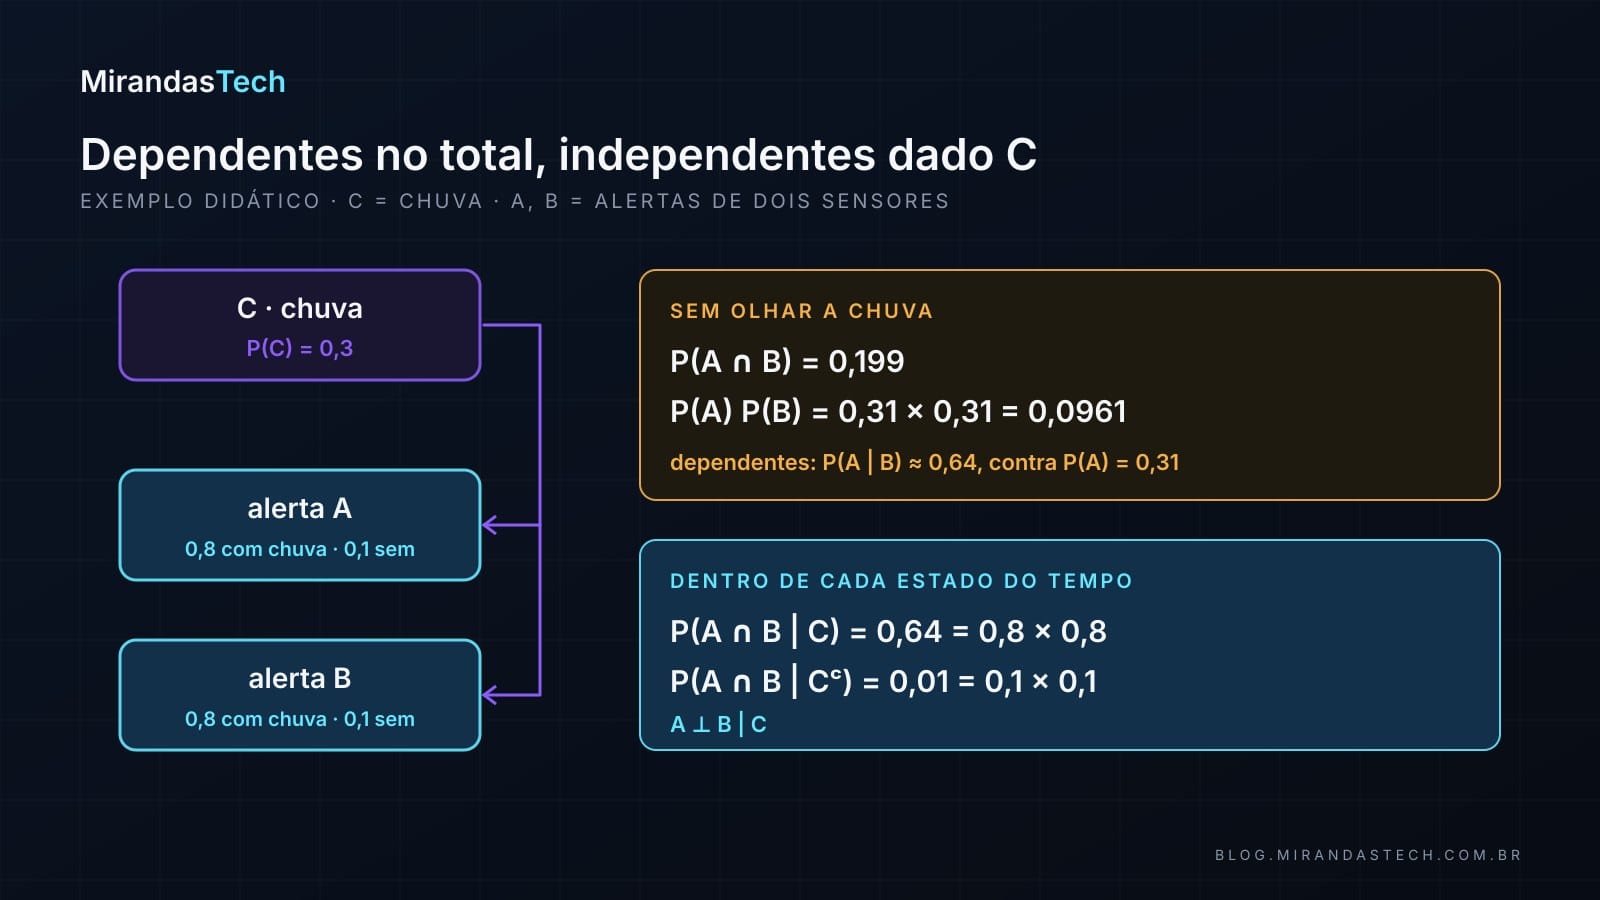
Pela lei total, cada alerta dispara em $P(A)=0{,}3\cdot0{,}8+0{,}7\cdot0{,}1=0{,}31$ dos dias. Os dois juntos disparam em
$$\begin{aligned}P(A\cap B)&=0{,}3\cdot0{,}8^2+0{,}7\cdot0{,}1^2\\&=0{,}192+0{,}007=0{,}199,\end{aligned}$$
mais que o dobro do produto $P(A)P(B)=0{,}0961$. Saber que $B$ disparou leva a chance de $A$ de 0,31 para $0{,}199/0{,}31\approx0{,}64$. Mas, fixado o tempo, $P(A\cap B\mid C)=0{,}64=0{,}8\cdot0{,}8$ e $P(A\cap B\mid C^c)=0{,}01=0{,}1\cdot0{,}1$. A associação inteira vinha da chuva. Bertsekas e Tsitsiklis (2008) dão um exemplo com a mesma estrutura: escolher ao acaso uma de duas moedas viciadas e lançá-la duas vezes; dada a moeda, os lançamentos são independentes; sem saber qual moeda foi escolhida, o primeiro resultado informa sobre o segundo. O caminho inverso também acontece, e o exemplo está na próxima seção: dois bits justos $X$ e $Y$ são independentes, mas, sabendo que $Z=X\oplus Y=1$, um determina o outro: $P(X=1,Y=1\mid Z=1)=0$, enquanto $P(X=1\mid Z=1)\,P(Y=1\mid Z=1)=1/4$ (Bertsekas & Tsitsiklis, 2008, Ex. 1.20).
A hipótese do Naive Bayes
O classificador Naive Bayes assume que os atributos $X_1,\ldots,X_d$ são condicionalmente independentes dada a classe $Y$:
$$P(X_1,\ldots,X_d\mid Y)=\prod_{j=1}^{d}P(X_j\mid Y).$$
Em vez de estimar uma distribuição conjunta com todas as combinações de atributos, o modelo, para cada classe, estima $d$ distribuições de um atributo só. O “naive” refere-se à força dessa hipótese, não a uma garantia de que os atributos sejam de fato independentes (scikit-learn, 2026). E aqui há uma sutileza que vale guardar: Domingos e Pazzani (1997) mostraram que o classificador pode errar pouco, e até ser ótimo na taxa de erro, mesmo quando a hipótese é violada com folga; já as probabilidades que ele produz só são ótimas (sob perda quadrática) se a hipótese valer. A documentação do scikit-learn resume o efeito prático: o Naive Bayes é um classificador razoável, mas um mau estimador de probabilidades, e a saída de predict_proba não deve ser levada muito a sério. A Aula 04 da série apresenta a inversão que leva de $P(\text{evidência}\mid\text{classe})$ a $P(\text{classe}\mid\text{evidência})$.
11. Independência aos pares não garante independência conjunta
Tome dois bits justos e independentes, $X$ e $Y$, e defina $Z=X\oplus Y$ (o XOR: $Z=1$ quando exatamente um dos dois vale 1). Os quatro pares $(X,Y)$ têm probabilidade $1/4$ cada, e $Z$ fica determinado em cada um deles.
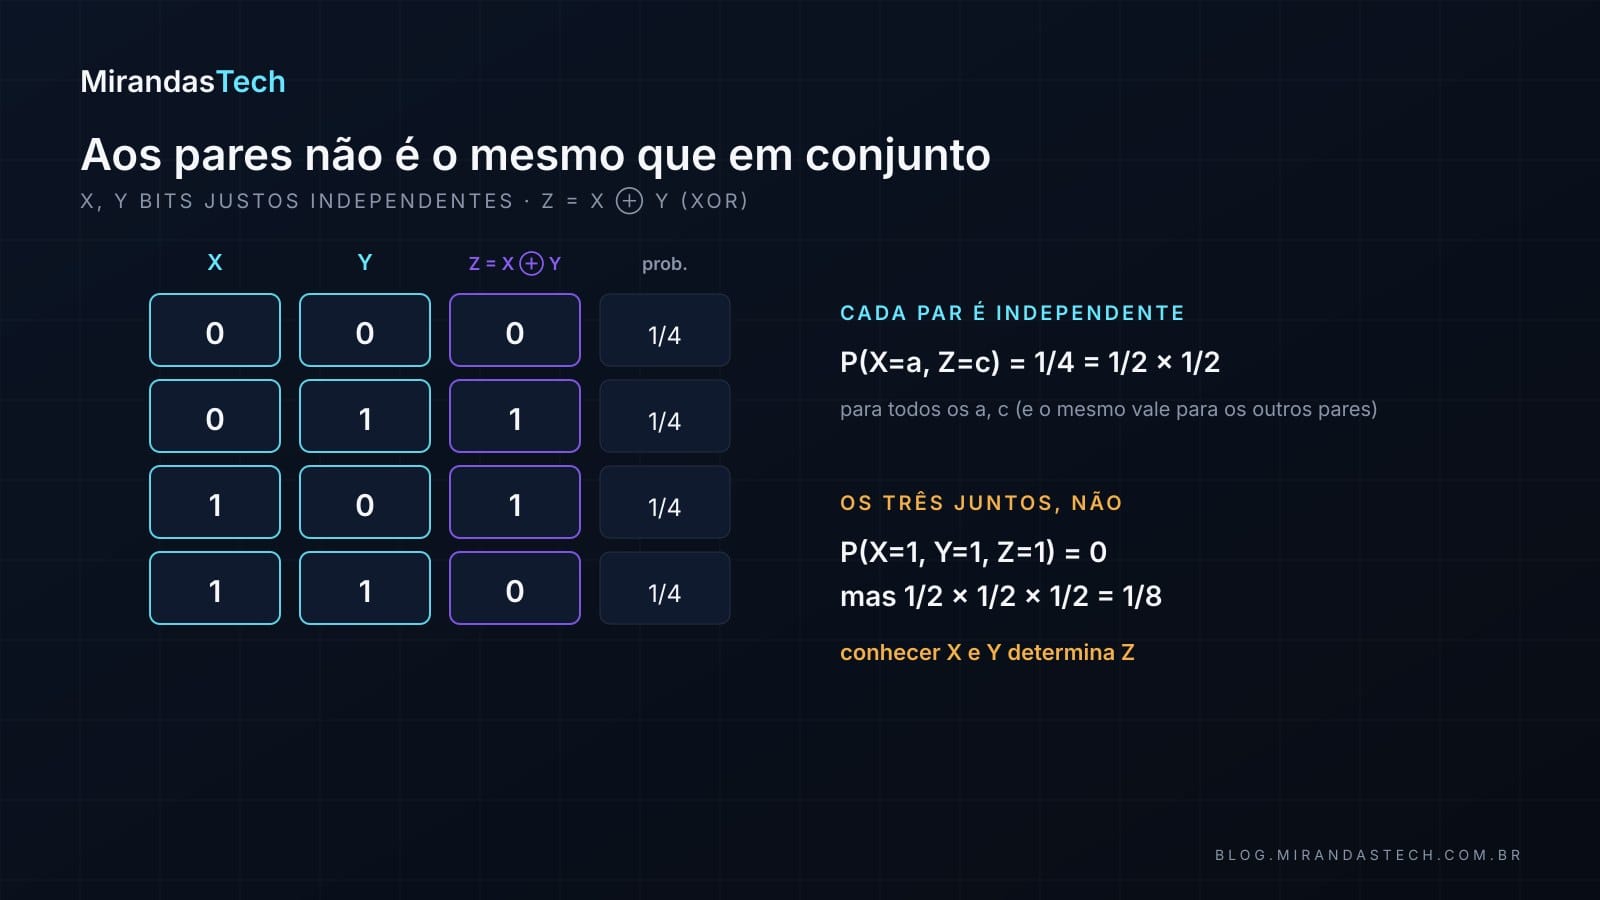
Qualquer par entre $X$, $Y$ e $Z$ é independente: por exemplo, $P(X=1,Z=1)=1/4=(1/2)(1/2)$. Mas o trio não é: $P(X=1,Y=1,Z=1)=0$, enquanto o produto das três marginais seria $1/8$. Conhecer dois bits determina completamente o terceiro. Para eventos $A_1,\ldots,A_n$, a independência mútua exige a fatoração de todas as interseções, não apenas dos pares. Bertsekas e Tsitsiklis (2008) trazem o mesmo contraexemplo com duas moedas e o evento “os lançamentos dão resultados diferentes”, que é o XOR com outro nome.
O detalhe importa em sistemas com muitos atributos: testes par a par podem não revelar uma restrição conjunta.
12. Onde isso aparece em IA
As ideias deste artigo voltam em quase todo sistema probabilístico. Cinco lugares concretos:
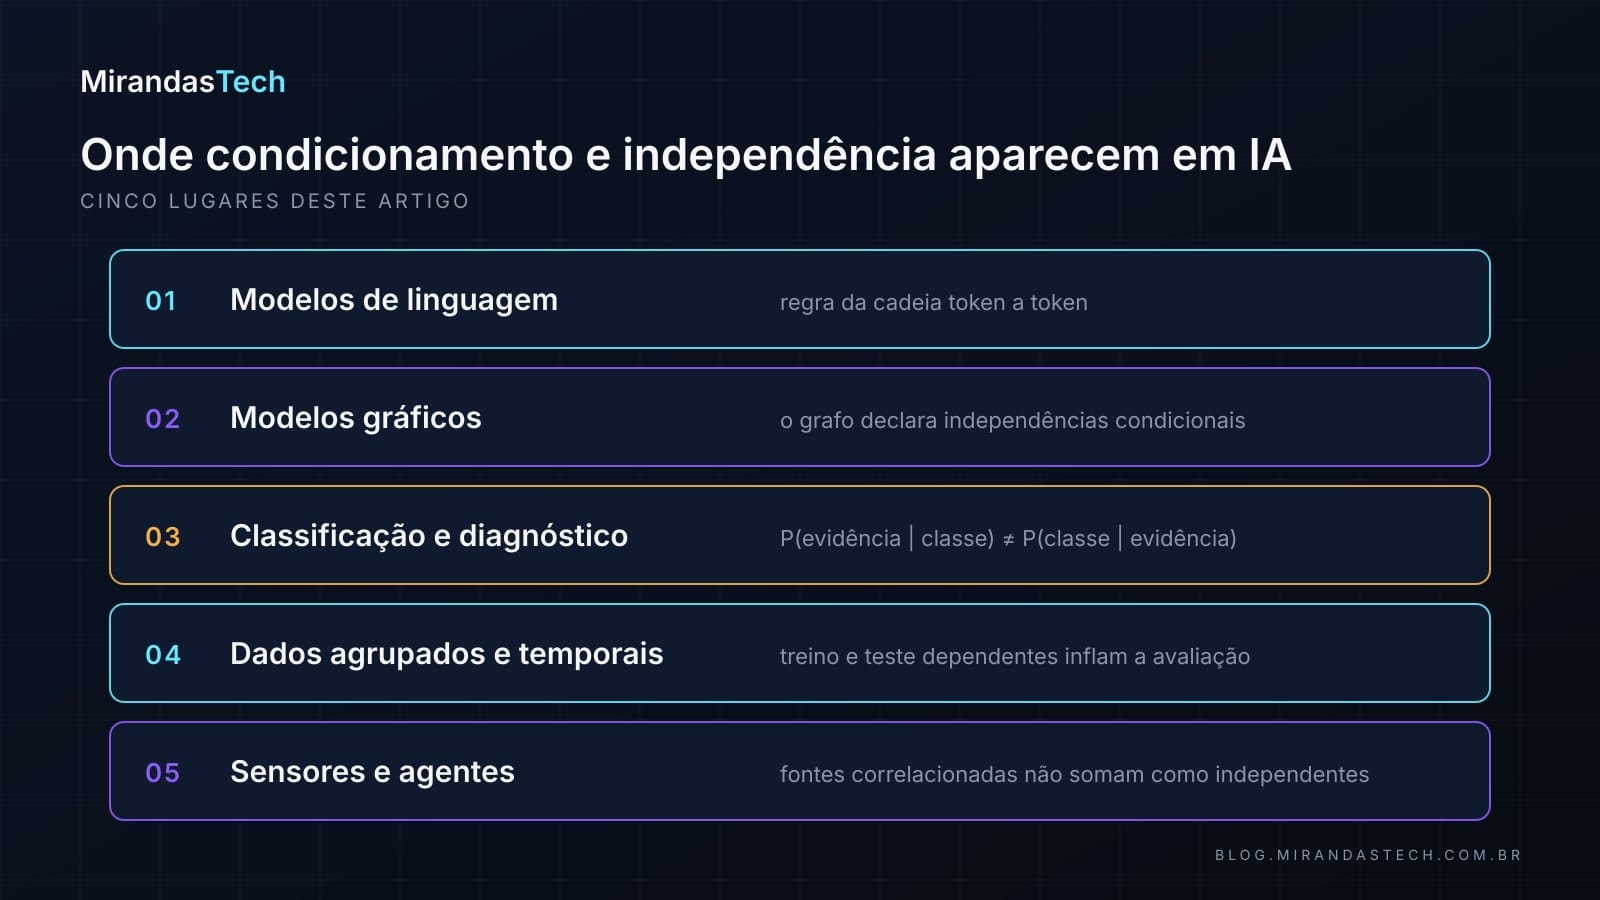
- Modelos autorregressivos. A regra da cadeia sustenta a fatoração token a token da seção 4. Tratar tokens como independentes apagaria contexto e ordem.
- Modelos gráficos probabilísticos. Distribuições sobre muitas variáveis costumam envolver interações diretas entre poucas delas, e descrever tudo com uma única função conjunta é ineficiente. Os grafos codificam essas fatorações: a ausência de uma aresta declara uma independência condicional, e cada fator passa a depender de poucas variáveis, o que pode reduzir muito o número de parâmetros necessários para descrever a distribuição (Goodfellow et al., 2016, §3.14).
- Classificação e diagnóstico. Confundir $P(\text{evidência}\mid\text{classe})$ com $P(\text{classe}\mid\text{evidência})$ ignora a prevalência da classe. Na tabela, 75% do spam tem o link, mas só 65% das mensagens com link são spam; mantidas as taxas de link em cada classe, um spam mais raro derrubaria o segundo número sem mexer no primeiro. A Aula 04 mostra como corrigir a direção.
- Dados agrupados e temporais. Registros da mesma pessoa, equipamento ou intervalo de tempo podem ser dependentes. Separá-los aleatoriamente entre treino e teste aproxima observações relacionadas e infla a avaliação. Kapoor e Narayanan (2023) listam a não independência entre amostras de treino e de teste como um dos tipos de vazamento que encontraram em trabalhos de ML publicados, e Roberts et al. (2017) mostram que a validação cruzada aleatória em dados com estrutura temporal, espacial ou hierárquica subestima seriamente o erro de previsão. O tema de vazamento de dados em pipelines já apareceu no blog, e a Aula 12 desta série volta a ele pelo lado da amostragem.
- Fusão de sensores e agentes. Combinar alertas como se fossem independentes produz excesso de confiança quando há fonte de dados, infraestrutura ou prompt compartilhado. É a seção 9 de novo: dependência positiva entre as fontes reduz o valor de cada fonte adicional (Clemen & Winkler, 1985). Dependências devem ser modeladas ou tratadas como limitação explícita.
13. Na prática em Python
O primeiro trecho reconstrói as probabilidades da tabela, com uma função que recusa entradas impossíveis em vez de devolver um número sem sentido, e confere a lei total.
import numpy as np

# linhas: spam, legítima; colunas: com link, sem link
contagens = np.array([[150,  50],
                      [ 80, 720]])
N = contagens.sum()
p_spam = contagens[0].sum() / N
p_link = contagens[:, 0].sum() / N
p_conj = contagens[0, 0] / N

def prob_condicional(p_intersecao, p_condicao):
    if not 0 <= p_intersecao <= p_condicao <= 1:
        raise ValueError("Exija 0 ≤ P(A∩B) ≤ P(B) ≤ 1.")
    if p_condicao == 0:
        raise ZeroDivisionError("P(A|B) exige P(B) > 0.")
    return p_intersecao / p_condicao

print(f"P(S|L) = {prob_condicional(p_conj, p_link):.4f}")
print(f"P(L|S) = {prob_condicional(p_conj, p_spam):.4f}")

# lei total: P(L) = P(L|S)P(S) + P(L|Sᶜ)P(Sᶜ)
p_link_spam = contagens[0, 0] / contagens[0].sum()
p_link_leg = contagens[1, 0] / contagens[1].sum()
total = p_link_spam * p_spam + p_link_leg * (1 - p_spam)
print(f"P(L) pela lei total = {total:.4f}")
Saída:
P(S|L) = 0.6522
P(L|S) = 0.7500
P(L) pela lei total = 0.2300
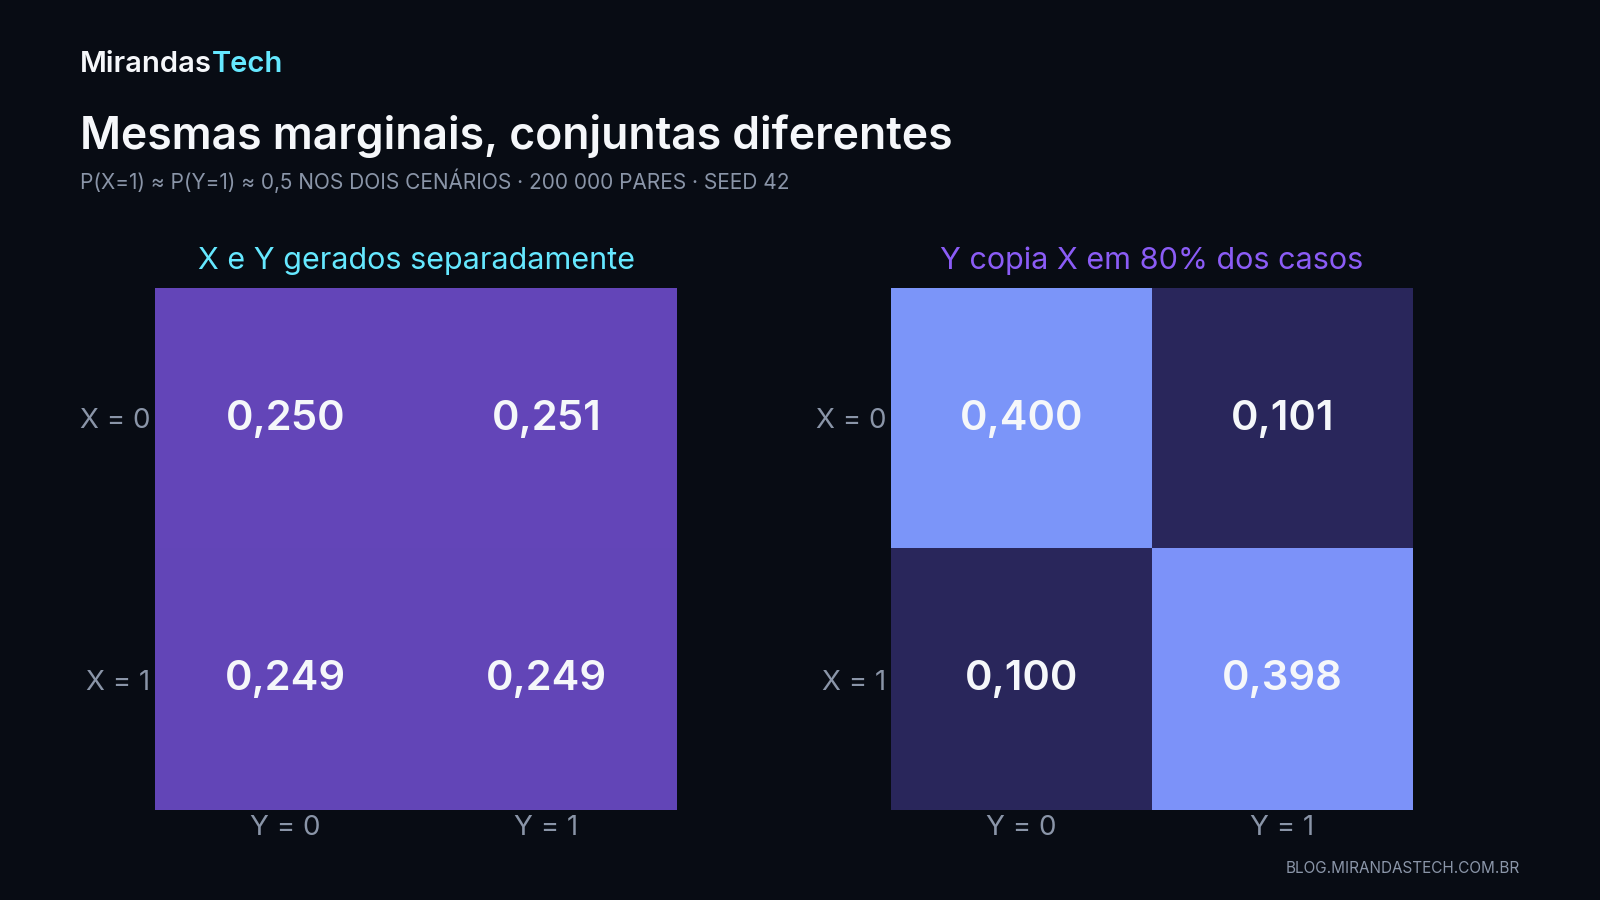
O segundo trecho simula o mecanismo com seed fixa: primeiro sorteia a classe e depois o link, com probabilidade que depende da classe (0,75 para spam e 0,10 para legítima). Em seguida, compara dois cenários com as mesmas marginais: num, $Y$ é sorteado separado de $X$; no outro, $Y$ copia $X$ em 80% dos casos.
import numpy as np

rng = np.random.default_rng(42)
n = 200_000

# mecanismo: a classe vem primeiro; o link depende dela
spam = rng.random(n) < 0.20
link = rng.random(n) < np.where(spam, 0.75, 0.10)
print(f"P̂(S|L) = {(spam & link).sum() / link.sum():.4f}")
print(f"P̂(L|S) = {(spam & link).sum() / spam.sum():.4f}")

# mesmas marginais, conjuntas diferentes
x = rng.integers(0, 2, size=n)
y_ind = rng.integers(0, 2, size=n)
# y_dep copia x em 80% dos casos
y_dep = np.where(rng.random(n) < 0.80, x, 1 - x)

for nome, y in [("independente", y_ind),
                ("dependente  ", y_dep)]:
    a, b = x == 1, y == 1
    dif = (a & b).mean() - a.mean() * b.mean()
    print(f"{nome}: P(Y=1)={b.mean():.3f}"
          f"  P(A∩B)−P(A)P(B)={dif:+.4f}")
Saída (Python 3.13.3, NumPy 2.2.3):
P̂(S|L) = 0.6531
P̂(L|S) = 0.7488
independente: P(Y=1)=0.500  P(A∩B)−P(A)P(B)=-0.0002
dependente  : P(Y=1)=0.499  P(A∩B)−P(A)P(B)=+0.1492
As estimativas oscilam em torno dos valores do modelo (0,6522 e 0,75) sem coincidir com eles: são frequências de uma amostra, não a lei verdadeira. No segundo cenário, as marginais quase não mudam (perto de 0,5 nos dois casos), mas a diferença $P(A\cap B)-P(A)P(B)$, com $A=\{X=1\}$ e $B=\{Y=1\}$ como no código, salta de praticamente zero para cerca de 0,15, que é o valor teórico ($0{,}5\cdot0{,}8-0{,}25=0{,}15$). A dependência é invisível nas marginais e aparece inteira na distribuição conjunta.
O notebook completo da aula, com mais testes e os desafios, está no Google Colab; para rodar localmente, bastam NumPy e Matplotlib. A tolerância que ele usa para comparar estimativas e valores teóricos (0,005) é declarada antes dos testes: ela verifica compatibilidade aproximada, não transforma a amostra na lei verdadeira.
14. Erros comuns
- Inverter a condicional. Em geral, $P(A\mid B)\neq P(B\mid A)$. Escreva a pergunta em palavras e identifique o grupo condicionado antes de calcular.
- Usar o denominador original. Depois de condicionar em $B$, o universo tem massa $P(B)$, ou $|B|$ no caso equiprovável. Manter $|\Omega|$ calcula uma conjunta, não a condicional.
- Multiplicar marginais sem justificar independência. $P(A\cap B)=P(A)P(B)$ não é a regra geral. A regra geral contém a condicional: $P(A\cap B)=P(A)\,P(B\mid A)$.
- Confundir disjunção e independência. Eventos disjuntos de probabilidade positiva são dependentes: observar um torna o outro impossível.
- Inferir causalidade de uma condicional alta. $P(A\mid B)>P(A)$ mostra associação no modelo, não prova que $B$ causa $A$.
- Ignorar mudança de distribuição. Uma condicional estimada num período ou numa população pode não valer em produção. Registre recorte, fonte, tempo e processo de coleta.
- Tratar estimativa como igualdade exata. Frequências amostrais variam; compare com tolerância declarada.
Antes de fechar qualquer cálculo condicional, vale uma checagem rápida: escrevi em palavras o evento procurado e a condição; conferi que $P(B)>0$; usei $A\cap B$ no numerador e $B$ como novo universo; separei conjunta, marginal e condicional; usei a regra geral do produto antes de assumir independência; se usei probabilidade total, os casos formam uma partição; se assumi independência, declarei o mecanismo e os limites; se usei dados, registrei população, período e processo de amostragem.
15. Exercícios
- No dado justo, calcule $P(\text{par}\mid\text{resultado}>2)$.
- Na tabela das mensagens, calcule $P(L^c\mid S)$ e interprete em uma frase.
- Use a regra do produto para calcular a probabilidade de retirar três reis seguidos de um baralho, sem reposição.
- Uma fábrica A produz 60% das peças e tem taxa de defeito de 1%; a fábrica B produz 40% e tem taxa de 3%. Qual a probabilidade marginal de uma peça ser defeituosa?
- Num dado justo, os eventos “resultado menor que 3” e “resultado maior que 4” são independentes? Justifique.
- Dois lançamentos de uma moeda justa: $A=$ “o primeiro é cara” e $B=$ “o segundo é cara” são independentes? Mostre pela fatoração.
- Se $A$ e $B$ são disjuntos, $P(A)=0{,}4$ e $P(B)=0{,}3$, calcule $P(A\mid B)$. Eles são independentes?
- Um sistema tem dois serviços com indisponibilidade de 2% cada. Qual a indisponibilidade conjunta sob independência? Cite uma situação que invalida essa hipótese.
- Explique, sem usar o Teorema de Bayes, por que $P(S\mid L)$ e $P(L\mid S)$ diferem na tabela das mensagens.
- Dê um exemplo de dependência produzida por uma causa comum e indique qual variável poderia tornar os eventos condicionalmente independentes.
Respostas comentadas
- Condicionado a $\{3,4,5,6\}$, os pares são $\{4,6\}$; portanto, $2/4=1/2$.
- $P(L^c\mid S)=50/200=0{,}25$. Entre as mensagens de spam, 25% não têm o padrão de link.
- $P=\frac{4}{52}\cdot\frac{3}{51}\cdot\frac{2}{50}=\frac{1}{5\,525}\approx0{,}000181$.
- Pela probabilidade total, $0{,}60\cdot0{,}01+0{,}40\cdot0{,}03=0{,}018$, ou 1,8%.
- Não. A interseção é vazia, então sua probabilidade é 0, mas o produto das marginais é $(2/6)(2/6)=1/9$.
- Sim. $P(A\cap B)=1/4$ e $P(A)P(B)=(1/2)(1/2)=1/4$.
- $P(A\mid B)=0$, porque a interseção é vazia e $P(B)>0$. Não são independentes, pois $0\neq0{,}4$.
- Sob independência, $0{,}02^2=0{,}0004$, ou 0,04%. Fonte de energia, rede, região ou implantação compartilhada pode criar falha comum.
- As duas razões usam a mesma interseção de 150 mensagens, mas denominadores diferentes: 230 mensagens com link e 200 mensagens de spam.
- Chuva pode elevar ao mesmo tempo os alertas de dois sensores. O estado do tempo é candidato a condição comum; a independência condicional ainda precisa ser avaliada, não presumida.
Desafio de transferência
Escolha dois alertas do seu contexto, como sensores, agentes, classificadores ou serviços, e responda por escrito: quais são os eventos $A$ e $B$; quanto valem $P(A)$, $P(B)$, $P(A\cap B)$ e $P(A\mid B)$; se são independentes, e com que evidência; qual seria uma causa comum $C$; se a independência poderia valer dado $C$; que limitação os dados têm; e que decisão muda conforme a resposta.
O que guardar
Condicionar em $B$ restringe o universo a $B$ e renormaliza sua massa: o numerador é $A\cap B$, o denominador é $B$. $P(A\mid B)$ e $P(B\mid A)$ compartilham a interseção, mas não o denominador. A regra geral do produto é $P(A\cap B)=P(A)\,P(B\mid A)$; aplicada em sequência, vira a regra da cadeia que os modelos de linguagem usam token a token. A probabilidade total soma os caminhos disjuntos de uma partição. Independência exige fatoração, não é sinônimo de disjunção e, aos pares, não garante independência conjunta. Independência condicional é outra afirmação, e é a hipótese que torna o Naive Bayes e os modelos gráficos tratáveis. Toda hipótese de independência precisa de justificativa no domínio.
Na Aula 04, Teorema de Bayes e atualização de crenças, condicionais, probabilidade total e prevalência se juntam para inverter a direção da pergunta: de $P(\text{dados}\mid\text{hipótese})$ para $P(\text{hipótese}\mid\text{dados})$.
Referências
- Bertsekas, Dimitri P.; Tsitsiklis, John N. Introduction to Probability. 2. ed. Athena Scientific, 2008. Cap. 1, §1.3 “Conditional Probability”, §1.4 “Total Probability Theorem and Bayes’ Rule” e §1.5 “Independence” (exemplos 1.20 a 1.22). Capítulo 1 aberto pela editora: athenasc.com/Prob-2nd-Ch1.pdf
- Blitzstein, Joseph K.; Hwang, Jessica. Introduction to Probability. 2. ed. Boca Raton: Chapman and Hall/CRC, 2019. Cap. 2, “Conditional probability”, p. 45–101. doi.org/10.1201/9780429428357-2
- Orloff, Jeremy; Bloom, Jonathan. Conditional Probability, Independence and Bayes’ Theorem (Class 3 Reading). MIT OpenCourseWare, 18.05 Introduction to Probability and Statistics, primavera de 2022. ocw.mit.edu/…/mit18_05_s22_class03-prep.pdf
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. Cambridge, MA: MIT Press, 2016. Cap. 3, §3.5 “Conditional Probability”, §3.6 “The Chain Rule of Conditional Probabilities”, §3.7 “Independence and Conditional Independence” e §3.14 “Structured Probabilistic Models”. www.deeplearningbook.org/contents/prob.html
- Bengio, Yoshua; Ducharme, Réjean; Vincent, Pascal; Jauvin, Christian. A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3, 1137–1155, 2003. jmlr.org/papers/v3/bengio03a.html
- Zhao, Wayne Xin; Zhou, Kun; Li, Junyi et al. A Survey of Large Language Models. Frontiers of Computer Science, 2026. doi.org/10.1007/s11704-026-60308-3 (versão aberta: arXiv:2303.18223)
- Domingos, Pedro; Pazzani, Michael. On the Optimality of the Simple Bayesian Classifier under Zero-One Loss. Machine Learning, 29(2–3), 103–130, 1997. doi.org/10.1023/a:1007413511361
- Gigerenzer, Gerd; Hoffrage, Ulrich. How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704, 1995. doi.org/10.1037/0033-295x.102.4.684
- Clemen, Robert T.; Winkler, Robert L. Limits for the Precision and Value of Information from Dependent Sources. Operations Research, 33(2), 427–442, 1985. doi.org/10.1287/opre.33.2.427
- Kapoor, Sayash; Narayanan, Arvind. Leakage and the reproducibility crisis in machine-learning-based science. Patterns, 4(9), 100804, 2023. doi.org/10.1016/j.patter.2023.100804 (versão aberta: arXiv:2207.07048)
- Roberts, David R.; Bahn, Volker; Ciuti, Simone et al. Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography, 40(8), 913–929, 2017. doi.org/10.1111/ecog.02881
- scikit-learn. 1.9. Naive Bayes. User Guide, versão 1.9.1, acesso em 2 out. 2026. scikit-learn.org/stable/modules/naive_bayes.html
- NumPy. Random Generator (
default_rng,Generator.random,Generator.integers). Documentação oficial, acesso em 2 out. 2026. numpy.org/doc/stable/reference/random/generator.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 02-statistics/aulas/03-condicional-independencia.md.