
Pré-processamento, pipelines e data leakage em Machine Learning
Proteger, dentro do código, a fronteira entre treino e avaliação: toda transformação que aprende com dados faz fit apenas no treino, e um Pipeline torna essa ordem explícita e repetível.

Proteger, dentro do código, a fronteira entre treino e avaliação: toda transformação que aprende com dados faz
fit apenas no treino. Pré-requisitos: Aula 01 — Machine Learning: problemas, paradigmas e generalização e Aula 02 — Do problema ao experimento; média, mediana, desvio-padrão e quantis; dados tabulares com pandas.O modelo atingiu 96% na validação. A equipe comemorou, colocou em produção e, três semanas depois, o acerto mal supera o acaso. Ninguém errou o algoritmo. O que aconteceu foi mais silencioso: antes de dividir os dados, alguém padronizou as colunas numéricas com a média e o desvio de toda a tabela, preencheu as ausências com a mediana global e escolheu as vinte features mais correlacionadas com o alvo. Cada uma dessas operações “aprendeu” algo com linhas que depois foram usadas para avaliar o modelo. A avaliação passou a medir um sistema que já tinha visto o gabarito.
No artigo anterior da série, definimos o contrato de predição, a unidade de análise, o instante de decisão e o split. Aqui, o objetivo é proteger essa fronteira dentro do código. Ao final, você vai conseguir distinguir transformação fixa de transformação ajustável, imputar, escalar e codificar dados sem contaminar a avaliação, montar um Pipeline com ColumnTransformer que mantém o pré-processamento dentro de cada fold, reconhecer os tipos de vazamento que um pipeline não resolve e escrever testes automáticos que protegem o protocolo. Fechamos com um experimento em que dados sem nenhum sinal alcançam ROC AUC de 0,92.
fit somente na partição de treinamento disponível naquele momento. Isso vale para imputação, escala, vocabulário de categorias, seleção de atributos, redução de dimensionalidade e o próprio modelo.1. Pré-processamento também é aprendizado
Um StandardScaler parece uma conta inofensiva: subtrai a média, divide pelo desvio. Mas a média e o desvio vêm de algum lugar. Se vierem de todas as linhas, o teste ajudou a decidir como o treino é visto. Considere uma transformação parametrizada $T_{\phi}$. O treinamento correto estima seus parâmetros apenas no treino:
$$ \begin{aligned} \widehat\phi &= \operatorname{fit}(X_{\text{treino}}),\\ Z_{\text{treino}} &= T_{\widehat\phi}(X_{\text{treino}}),\\ Z_{\text{teste}} &= T_{\widehat\phi}(X_{\text{teste}}). \end{aligned} $$
Aqui, $X$ contém os atributos, $Z$ é a representação transformada e $\widehat\phi$ é o estado aprendido. Num padronizador, $\widehat\phi=(\mu_{treino},\sigma_{treino})$. Num imputador pela mediana, é a mediana de cada coluna. Num one-hot encoder, é o conjunto e a ordem das categorias observadas. Repare que o teste só aparece na última linha, e só recebe a transformação: nunca participa da estimativa de $\widehat\phi$.
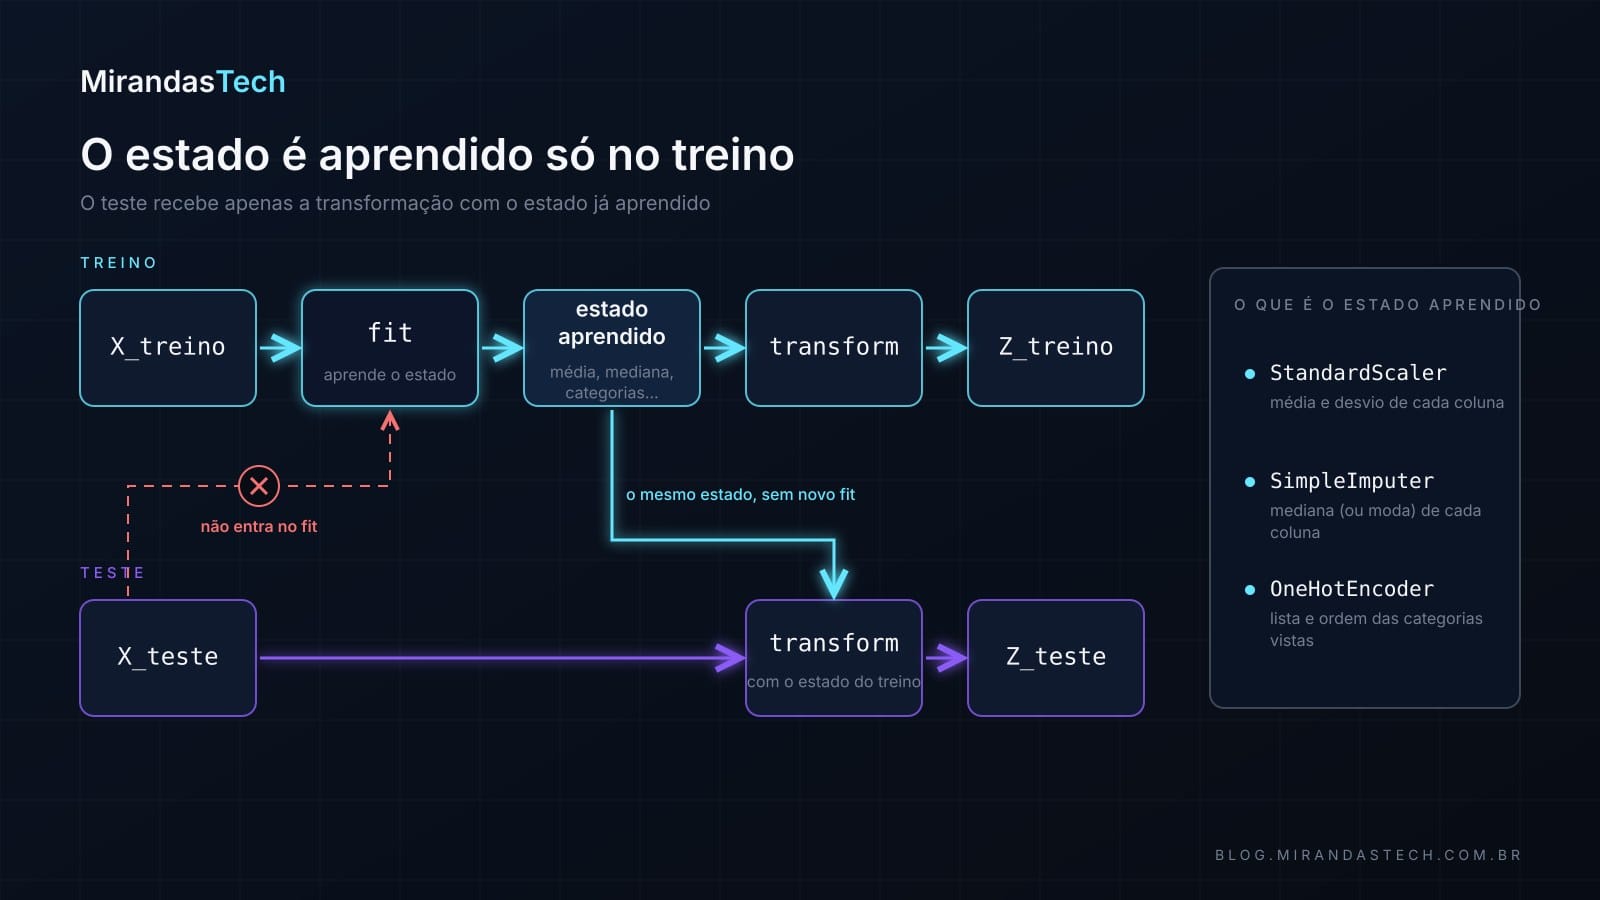
É isso que a API do scikit-learn codifica em três verbos. fit aprende estado a partir dos dados (média, mediana, categorias, coeficientes). transform aplica a um conjunto o estado já aprendido. fit_transform faz as duas coisas no mesmo conjunto: apropriado no treino, perigoso no teste. Um transformador é o objeto que conserva esse estado; um estimador é o objeto ajustável na ponta, como um classificador ou regressor.
Uma transformação realmente fixa — converter quilômetros em metros multiplicando por 1.000, por exemplo — não aprende estado. Já “recortar nos percentis 1 e 99” aprende quantis e, portanto, deve ser ajustada apenas no treino.
Exemplo numérico resolvido
Treino: $[1,2,3]$. Teste: $[100]$. No treino:
$$ \begin{aligned} \mu_{treino}&=2,\\ \sigma_{treino}&=\sqrt{\tfrac{(1-2)^2+(2-2)^2+(3-2)^2}{3}}\approx0{,}8165. \end{aligned} $$
Logo:
$$ z_{teste}=\frac{100-2}{0{,}8165}\approx120{,}02. $$
O valor é extremo porque a distribuição mudou. Se ajustarmos o scaler nos quatro valores, a média passa a 26,5 e o desvio a aproximadamente 42,44; o teste vira cerca de 1,73 desvios. O próprio caso de teste ensinou ao pré-processamento como parecer menos surpreendente. Em Python, com o desvio populacional que o StandardScaler usa:
import numpy as np

treino, teste = np.array([1., 2., 3.]), np.array([100.])
mu, sigma = treino.mean(), treino.std()  # ddof=0, como o StandardScaler
print("fit só no treino:     z =", round((teste[0] - mu) / sigma, 2))

tudo = np.concatenate([treino, teste])
print("fit em treino+teste:  z =", round((teste[0] - tudo.mean()) / tudo.std(), 2))
fit só no treino:     z = 120.02
fit em treino+teste:  z = 1.73
O problema não é a fórmula. É quem participou da estimação — a separação aprender/prever de Kaufman et al. (2012).
2. Imputação: ausência também tem significado
Valores ausentes podem surgir por falha de sensor, campo opcional, processo operacional ou decisão humana. Cada mecanismo conta uma história diferente, e preencher sem perguntar apaga essa história. Antes de imputar, responda:
- por que o valor está ausente?
- esse mecanismo muda entre treino e produção?
- a ausência em si ajuda a prever o alvo?
- qual estatística estará disponível no instante de predição?
Para uma coluna numérica assimétrica, a mediana costuma ser mais robusta que a média. Para uma categoria, moda ou uma categoria explícita "ausente" são opções. A escolha é parte do modelo e deve ser validada.
SimpleImputer(add_indicator=True) pode acrescentar um indicador de ausência. Isso preserva o sinal “estava faltando”, mas não elimina viés de seleção nem recria informação que nunca foi coletada. Um detalhe da implementação: uma coluna sem ausências no treino não ganha indicador, mesmo que apareçam ausências no teste.
Nunca calcule a mediana em treino mais teste. Em validação cruzada, cada fold precisa aprender sua própria mediana usando apenas a parte de treino daquele fold.
3. Escala: quando e por quê
Depois de preencher as ausências, a pergunta seguinte é se as colunas numéricas precisam falar a mesma língua. O StandardScaler aplica:
$$ z_j=\frac{x_j-\mu_j}{\sigma_j}, $$
para a feature $j$, com média $\mu_j$ e desvio $\sigma_j$ aprendidos no treino.
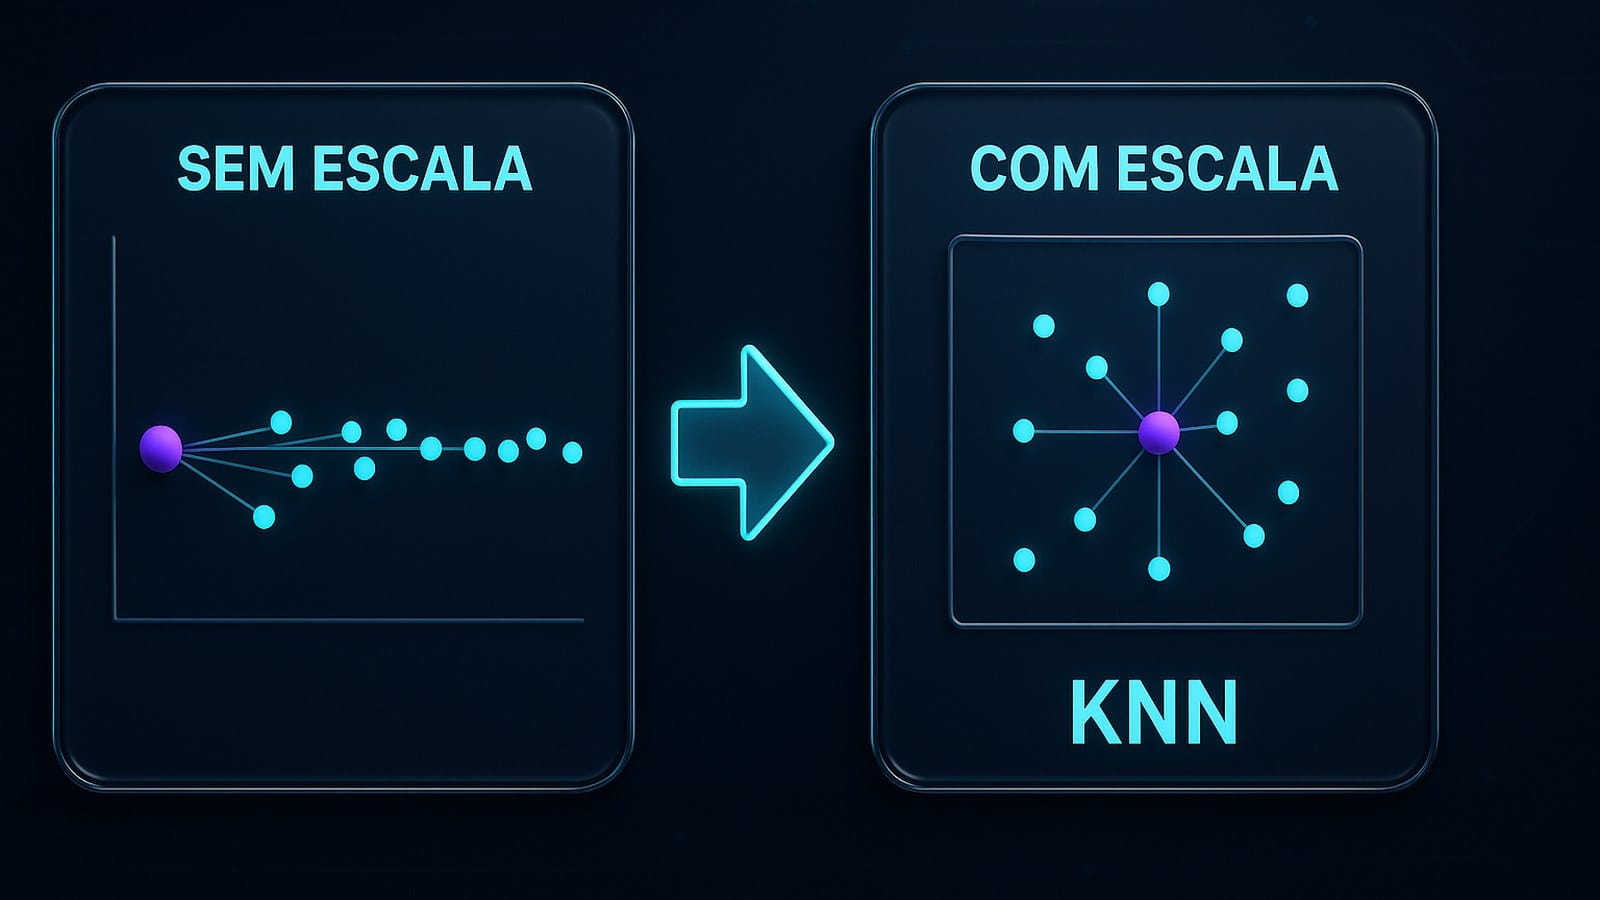
Escala é especialmente importante quando o algoritmo usa distâncias, produtos internos ou penalidades compartilhadas entre coeficientes, como KNN, SVM, regressão logística regularizada e redes neurais (Hastie et al., 2009, §3.4.1 e §13.3). Árvores de decisão normalmente são invariantes a transformações monotônicas de uma feature (Hastie et al., 2009, Tabela 10.1) e não exigem padronização para criar seus cortes.
| Transformação | Quando considerar | Limite importante |
|---|---|---|
StandardScaler |
distribuição sem caudas muito extremas | média e desvio são sensíveis a outliers |
RobustScaler |
presença plausível de outliers | ainda aprende mediana e IQR no treino |
MinMaxScaler |
intervalo limitado ou exigência do modelo | novos valores podem sair de $[0,1]$ |
| transformação log | variável positiva e muito assimétrica | requer política para zero e negativos |
| nenhuma escala | árvores ou unidade original já adequada | confirme empiricamente no protocolo |
Escalar não torna uma relação linear nem corrige mudança de distribuição. Um z-score enorme no teste pode ser um diagnóstico útil, não um erro a esconder.
4. Codificação categórica sem inventar ordem
Categorias nominais como estado, canal ou tipo de dispositivo não possuem ordem natural. O one-hot encoding cria uma coluna binária por categoria aprendida. Para uma categoria $c_k$:
$$ z_k=\mathbb{1}(x=c_k). $$
Aqui, $\mathbb{1}(\cdot)$ é a função indicadora: vale 1 quando o valor $x$ é a categoria $c_k$ e 0 caso contrário.
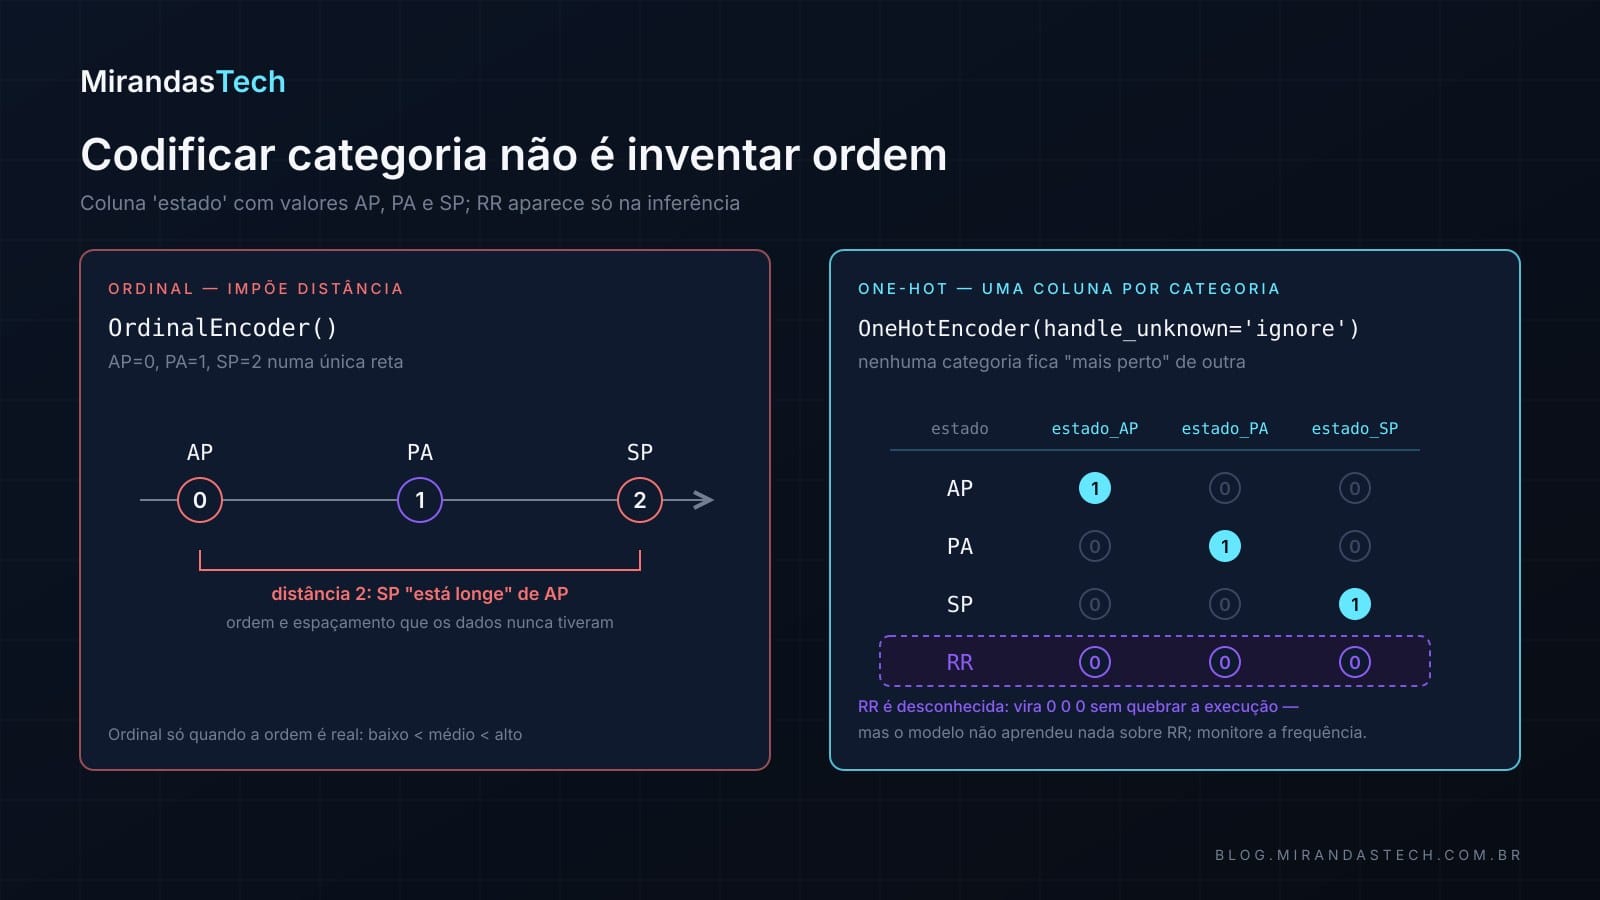
Use OneHotEncoder(handle_unknown="ignore") quando novas categorias puderem aparecer. Uma categoria desconhecida será representada por zeros nas colunas conhecidas. Isso evita falha de execução, mas o modelo não aprendeu o comportamento específico daquele valor; monitore frequência e impacto de categorias novas.
Não use OrdinalEncoder apenas para economizar colunas: mapear AP=0, PA=1, SP=2 impõe distâncias artificiais. Uma codificação ordinal é adequada quando a ordem é real, como baixo < médio < alto, e ainda exige decisão sobre espaçamentos.
Codificação por frequência, média do alvo ou target encoding aprende estatísticas. Quando usa $y$, precisa de construção out-of-fold no treino e política para categorias raras. Calcular a média do alvo em todas as linhas antes do split é vazamento direto.
5. ColumnTransformer: uma tabela, tratamentos diferentes
Dados reais misturam números, categorias e, às vezes, texto ou datas. Cada tipo pede o tratamento das seções anteriores, e um ColumnTransformer permite declarar essas rotas explicitamente:
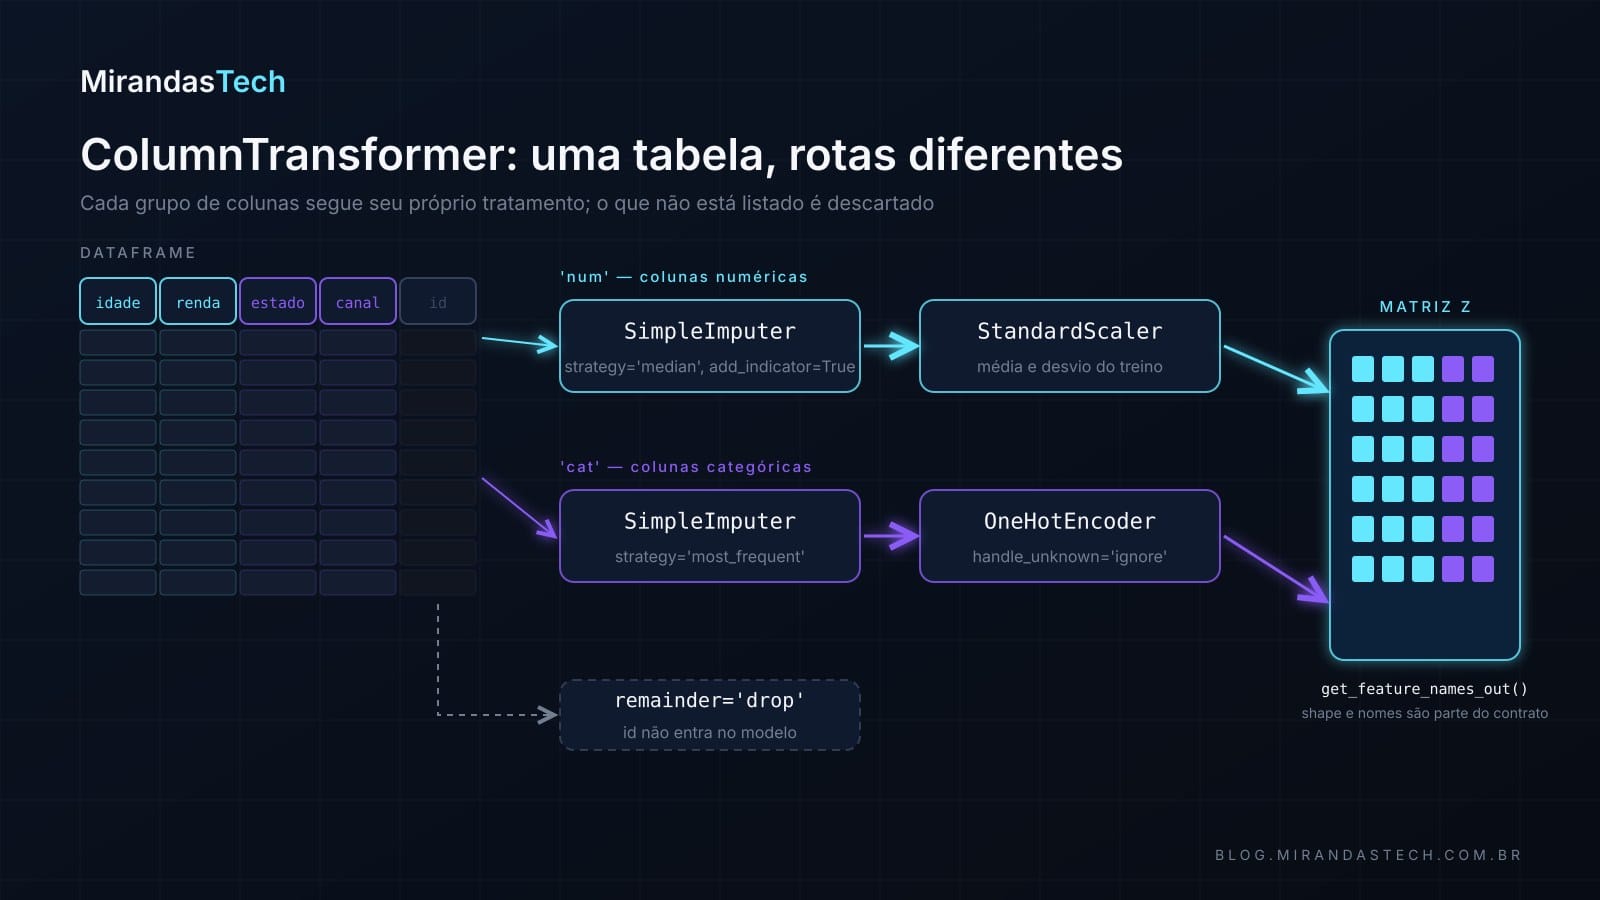
numeric = Pipeline([
    ("imputer", SimpleImputer(strategy="median", add_indicator=True)),
    ("scaler", StandardScaler()),
])

categorical = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore")),
])

preprocess = ColumnTransformer([
    ("num", numeric, numeric_features),
    ("cat", categorical, categorical_features),
], remainder="drop")
remainder="drop" torna explícito que colunas não listadas serão descartadas. Essa escolha é segura para uma lista autorizada de features. remainder="passthrough" pode deixar um identificador, timestamp futuro ou coluna-alvo atravessar silenciosamente; use-o apenas após auditoria de schema.
Após o ajuste, inspecione get_feature_names_out() para verificar a representação produzida. Shape e nomes são parte do contrato entre dados e modelo.
6. Pipeline: a fronteira executável
O ColumnTransformer organiza o pré-processamento; o Pipeline conecta esse pré-processamento ao modelo e garante que os dois sejam ajustados na ordem certa, com os mesmos dados:
model = Pipeline([
    ("preprocess", preprocess),
    ("classifier", LogisticRegression(max_iter=2_000)),
])

model.fit(X_train, y_train)
pred = model.predict_proba(X_test)[:, 1]
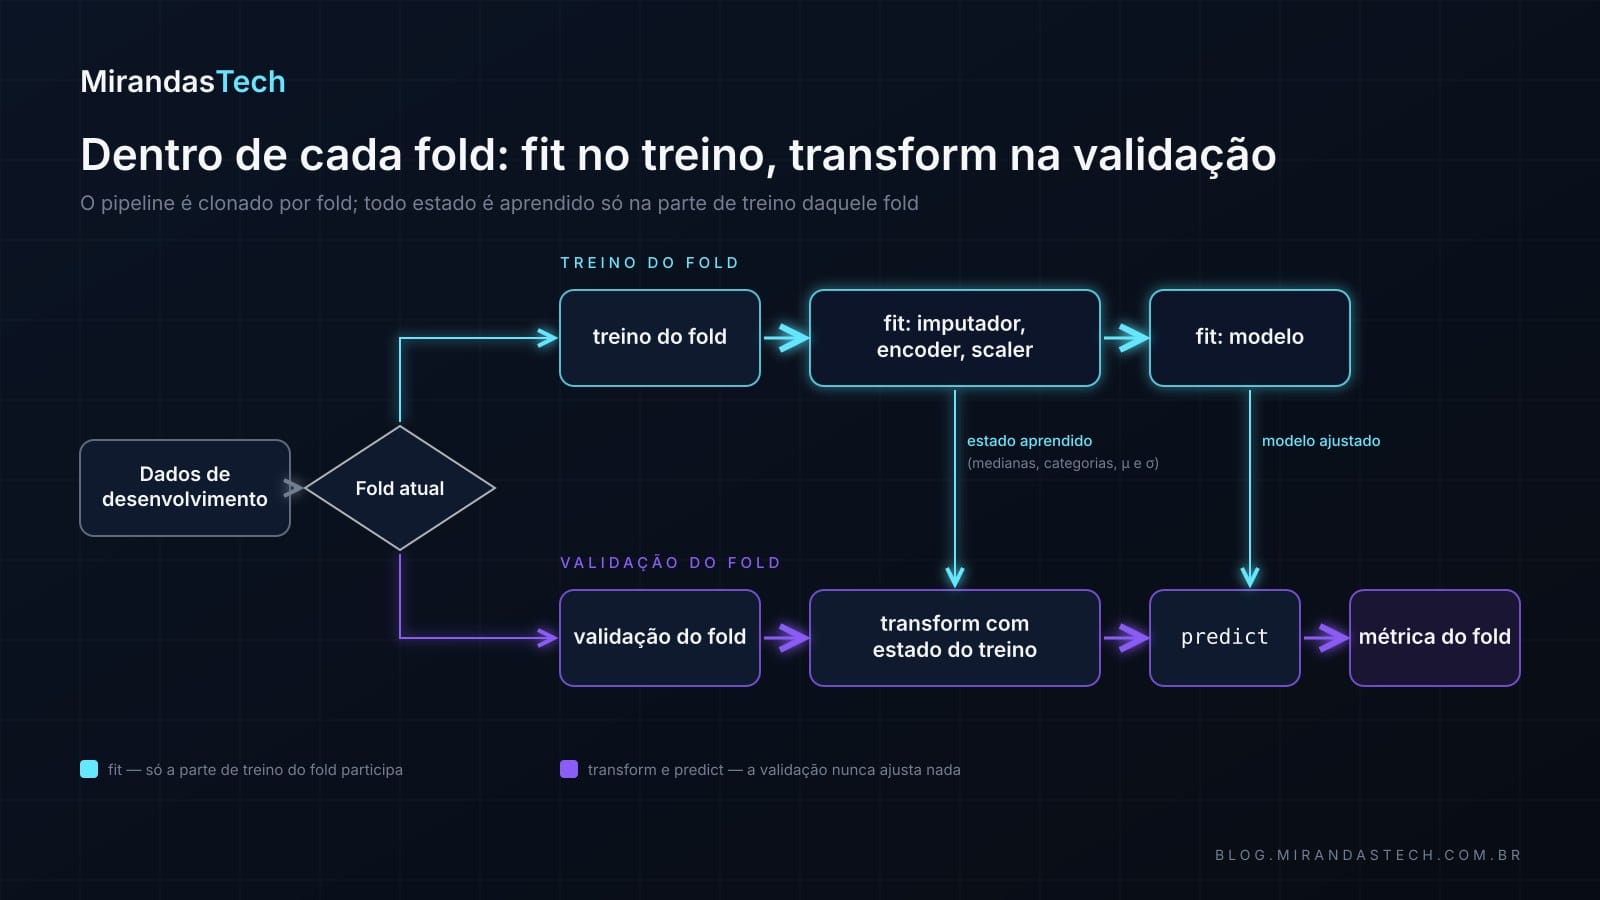
Durante fit, o pipeline ajusta o pré-processamento em X_train, transforma X_train e ajusta o classificador. Durante predict_proba, apenas transform é chamado antes da previsão. O teste não altera imputador, scaler, encoder nem classificador.
Em validação cruzada, o scikit-learn clona o pipeline para cada divisão. Cada clone aprende estado apenas no subconjunto de treino daquele fold: os dados de desenvolvimento entram no fold atual; a parte de treino passa por fit do imputador, do encoder, do scaler e, por fim, do modelo; a parte de validação recebe apenas transform com o estado do treino e vai para predict; daí sai a métrica do fold.
Se SelectKBest, PCA ou imputação forem executados antes de cross_validate, o pipeline já recebe dados contaminados (Hastie et al., 2009, §7.10.2). Estar “antes do modelo” não significa estar “fora do treinamento”. Hastie et al. admitem uma ressalva estreita: uma triagem inicial de colunas que não olha o rótulo (ficar só com as de maior variância, por exemplo) não dá às features a vantagem injusta de já ter visto $y$. É uma ressalva sobre viés de seleção, não uma licença geral: escala, imputação e PCA também não usam $y$ e, mesmo assim, devem ser ajustados só no treino, porque seus parâmetros são aplicados às linhas de validação. Na dúvida, a triagem também vai para o pipeline (VarianceThreshold).
7. Taxonomia prática de leakage
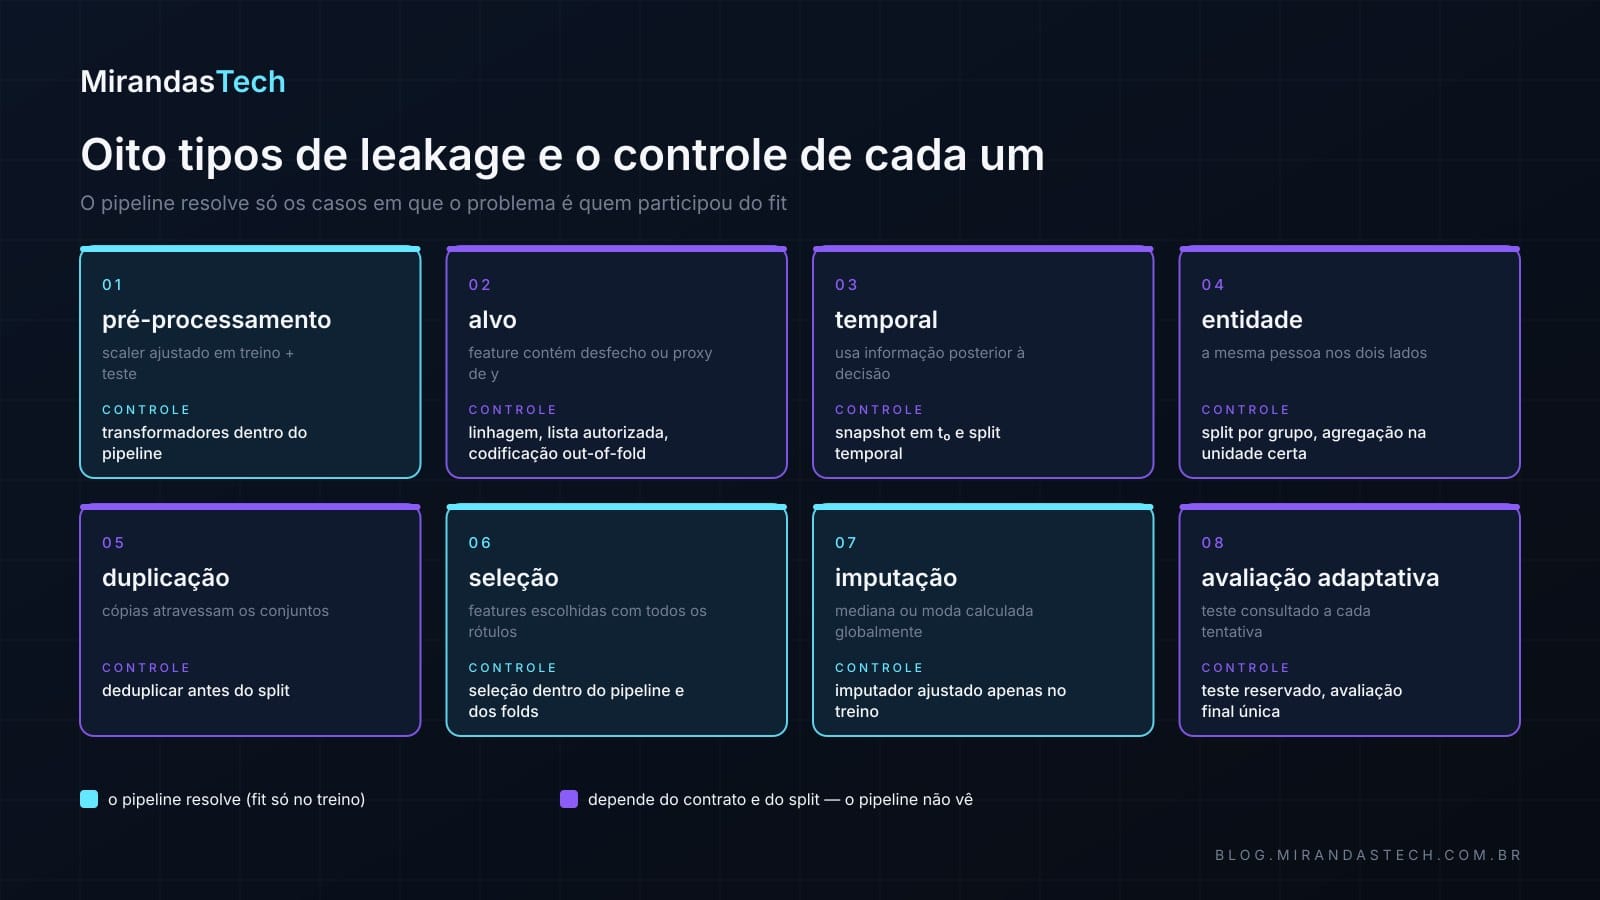
Vazamento de pré-processamento é só um dos tipos. A tabela abaixo adapta a taxonomia de oito tipos de Kapoor e Narayanan (2023), cujo levantamento da literatura reúne 294 artigos de 17 áreas com vazamento já documentado, e a definição de Kaufman et al. (2012): informação sobre o alvo que não estaria legitimamente disponível no momento da previsão. Repare que o pipeline resolve apenas as linhas em que o problema é quem participou do fit.
| Tipo | Exemplo | Controle principal |
|---|---|---|
| pré-processamento | scaler ajustado em treino + teste | ajustar transformadores dentro do pipeline |
| alvo | feature contém desfecho, proxy ou estatística de $y$ global | linhagem, lista autorizada e codificação out-of-fold |
| temporal | usar saldo após a decisão para prever inadimplência | snapshot no instante $t_0$ e split temporal |
| entidade | registros da mesma pessoa nos dois lados | split por grupo e agregação na unidade correta |
| duplicação | cópias ou quase cópias atravessam conjuntos | deduplicar antes do split ou agrupar equivalentes |
| seleção | escolher features usando todos os rótulos | seleção dentro do pipeline e dos folds |
| imputação | mediana ou moda calculada globalmente | imputador ajustado apenas no treino |
| avaliação adaptativa | consultar o teste a cada tentativa | teste reservado e avaliação final única (Dwork et al., 2015) |
Vazamento de disponibilidade
Uma feature pode existir no banco hoje e ainda ser inválida. A pergunta é: ela existia e estava consolidada no instante $t_0$ em que a previsão seria emitida?
Exemplo: prever cancelamento de pedido no momento da compra usando motivo_cancelamento. A coluna não é proibida por ser muito correlacionada; é proibida porque nasce depois do evento.
Vazamento por agregação
“Número total de compras do cliente” é ambíguo. Se o total inclui compras posteriores à linha prevista, contém futuro. A feature correta seria uma agregação as-of: apenas eventos com timestamp anterior a $t_0$.
Vazamento por entidade
Um pipeline não sabe que dez linhas pertencem ao mesmo paciente (Kapoor & Narayanan, 2023). Se o objetivo é generalizar para pacientes novos, o splitter deve manter cada paciente em um único lado. O pipeline protege o estado aprendido depois que o split correto foi definido.
8. Na prática: um experimento que denuncia o problema
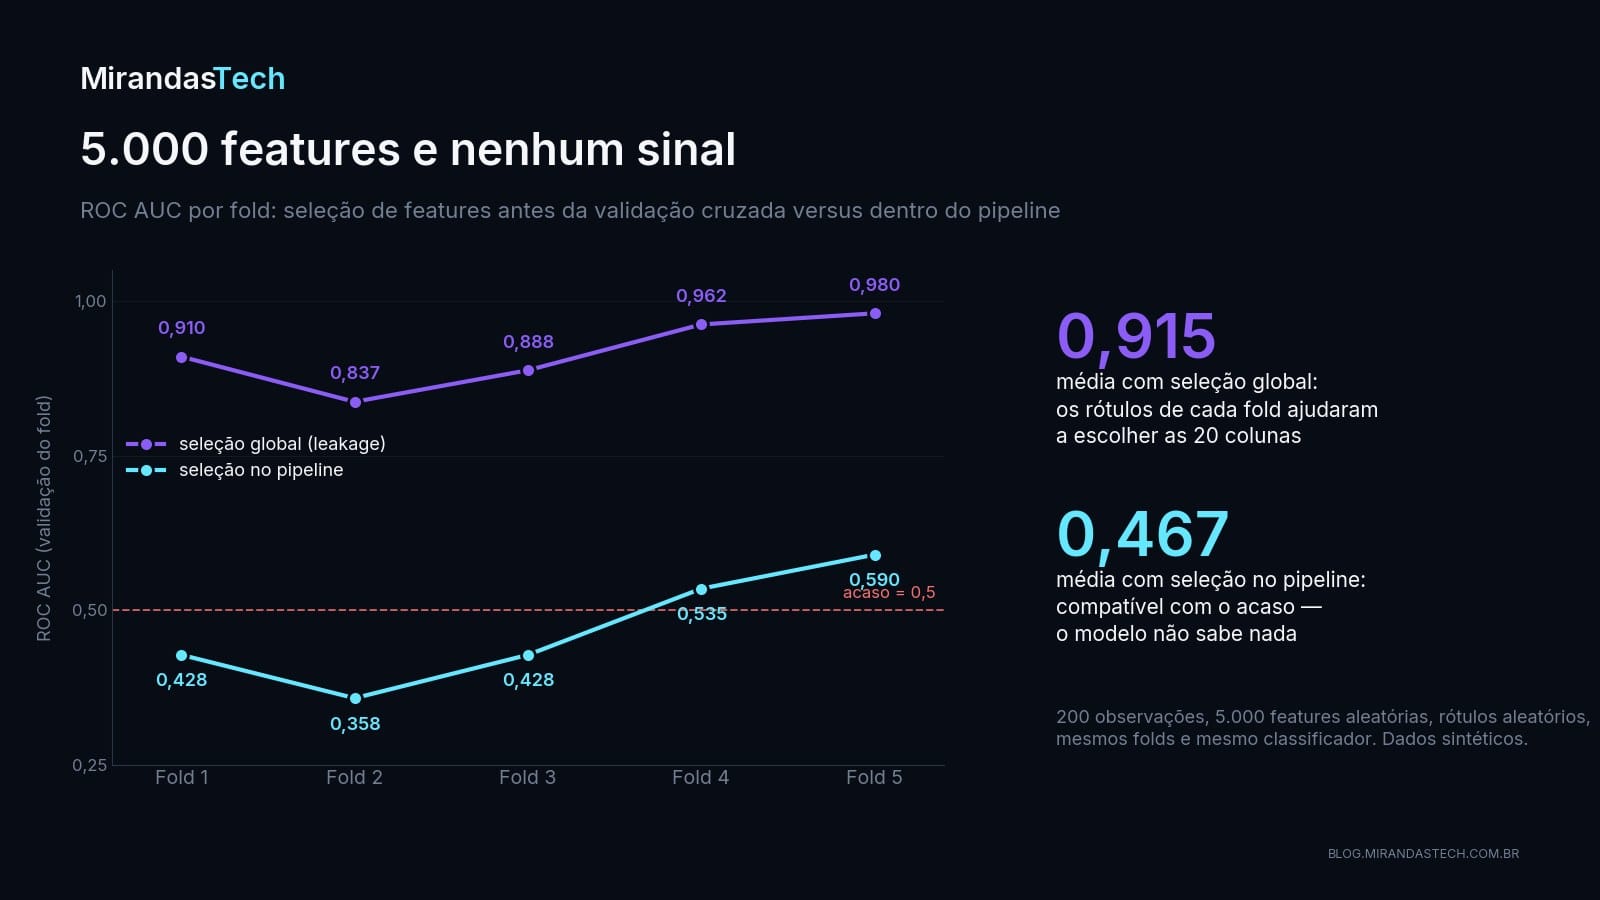
Considere 200 observações, 5.000 features aleatórias e rótulos aleatórios. Não existe sinal real. Ainda assim, entre milhares de features algumas terão correlação espúria com $y$. A pergunta: selecionar as 20 “melhores” antes ou dentro da validação cruzada faz diferença?
Procedimento incorreto:
- aplicar
SelectKBestusando todas as observações e rótulos; - conservar as features mais correlacionadas;
- executar validação cruzada sobre a matriz já selecionada.
Cada fold de validação ajudou a escolher as colunas antes de ser avaliado. A métrica pode ficar muito acima de 0,5. Hastie et al. (2009, §7.10.2) mostram o mesmo mecanismo com 50 amostras e 5.000 preditores independentes do rótulo: selecionando os 100 mais correlacionados fora da validação cruzada, o erro estimado cai a 3% quando o erro real é 50%. Em dados de expressão gênica, Ambroise e McLachlan (2002) chamaram esse efeito de viés de seleção e mostraram que, corrigido, o erro “zero” desaparece.
Procedimento correto:
- colocar
SelectKBestdentro do pipeline; - em cada fold, selecionar usando apenas o treino;
- transformar e avaliar a validação com aquela seleção local.
Sem sinal real, a média deve oscilar em torno do acaso. Os dois procedimentos abaixo usam os mesmos folds e o mesmo classificador; a única diferença é a fronteira de fit do seletor. Os dados são sintéticos: demonstram o mecanismo, não o desempenho de um produto real.
import numpy as np
import pandas as pd
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_validate
from sklearn.pipeline import Pipeline

SEED = 20260908
rng = np.random.default_rng(SEED + 1)
n, p = 200, 5_000
X_noise = rng.normal(size=(n, p))
y_noise = np.array([0, 1] * (n // 2))
rng.shuffle(y_noise)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)

# Procedimento incorreto: seleção com todas as linhas e rótulos ANTES da CV
X_sel = SelectKBest(score_func=f_classif, k=20).fit_transform(X_noise, y_noise)
contaminada = cross_validate(
    LogisticRegression(max_iter=2_000, C=0.5), X_sel, y_noise,
    cv=cv, scoring="roc_auc",
)["test_score"]

# Procedimento correto: seletor dentro do pipeline, refeito no treino de cada fold
pipe = Pipeline([
    ("select", SelectKBest(score_func=f_classif, k=20)),
    ("model", LogisticRegression(max_iter=2_000, C=0.5)),
])
correta = cross_validate(pipe, X_noise, y_noise, cv=cv, scoring="roc_auc")["test_score"]

tabela = pd.DataFrame({
    "fold": range(1, 6),
    "selecao_global_contaminada": contaminada,
    "selecao_dentro_do_pipeline": correta,
})
print(tabela.round(3).to_string(index=False))
print("\nMédias:", {k: round(v, 3) for k, v in tabela.drop(columns="fold").mean().items()})
Saída real, com scikit-learn 1.9 e numpy 2.2:
 fold  selecao_global_contaminada  selecao_dentro_do_pipeline
    1                       0.910                       0.428
    2                       0.837                       0.358
    3                       0.888                       0.428
    4                       0.962                       0.535
    5                       0.980                       0.590

Médias: {'selecao_global_contaminada': 0.915, 'selecao_dentro_do_pipeline': 0.467}
Interpretação
ROC AUC média de 0,92 em dados que, por construção, não têm relação alguma com o rótulo. Nenhum fold ficou abaixo de 0,83. O classificador é o mesmo, os folds são os mesmos; o que mudou foi que, na versão contaminada, os rótulos de cada fold de validação participaram da escolha das 20 colunas antes de aquele fold ser avaliado.
Na versão correta, a média cai para 0,47 e os folds oscilam entre 0,36 e 0,59, o que é compatível com a variabilidade esperada do acaso com 40 observações por fold. O pipeline não “piorou” o modelo. Ele mostrou o que o modelo realmente sabe: nada (Hastie et al., 2009; Ambroise & McLachlan, 2002).
O notebook vai além desta contraprova: gera dados tabulares mistos, separa desenvolvimento e teste antes de qualquer fit, compara DummyClassifier e regressão logística com pipeline, mostra imputação, escala, one-hot e categoria desconhecida, valida schema, classes, IDs e estado aprendido, e abre o teste uma única vez após congelar a configuração, com gráfico, versões, seed e asserts verificáveis.
9. O que um pipeline não resolve
Depois do experimento anterior, a tentação é concluir que basta colocar tudo dentro do Pipeline. Não basta. Pipeline é um mecanismo de composição, não um auditor semântico. Ele não detecta automaticamente:
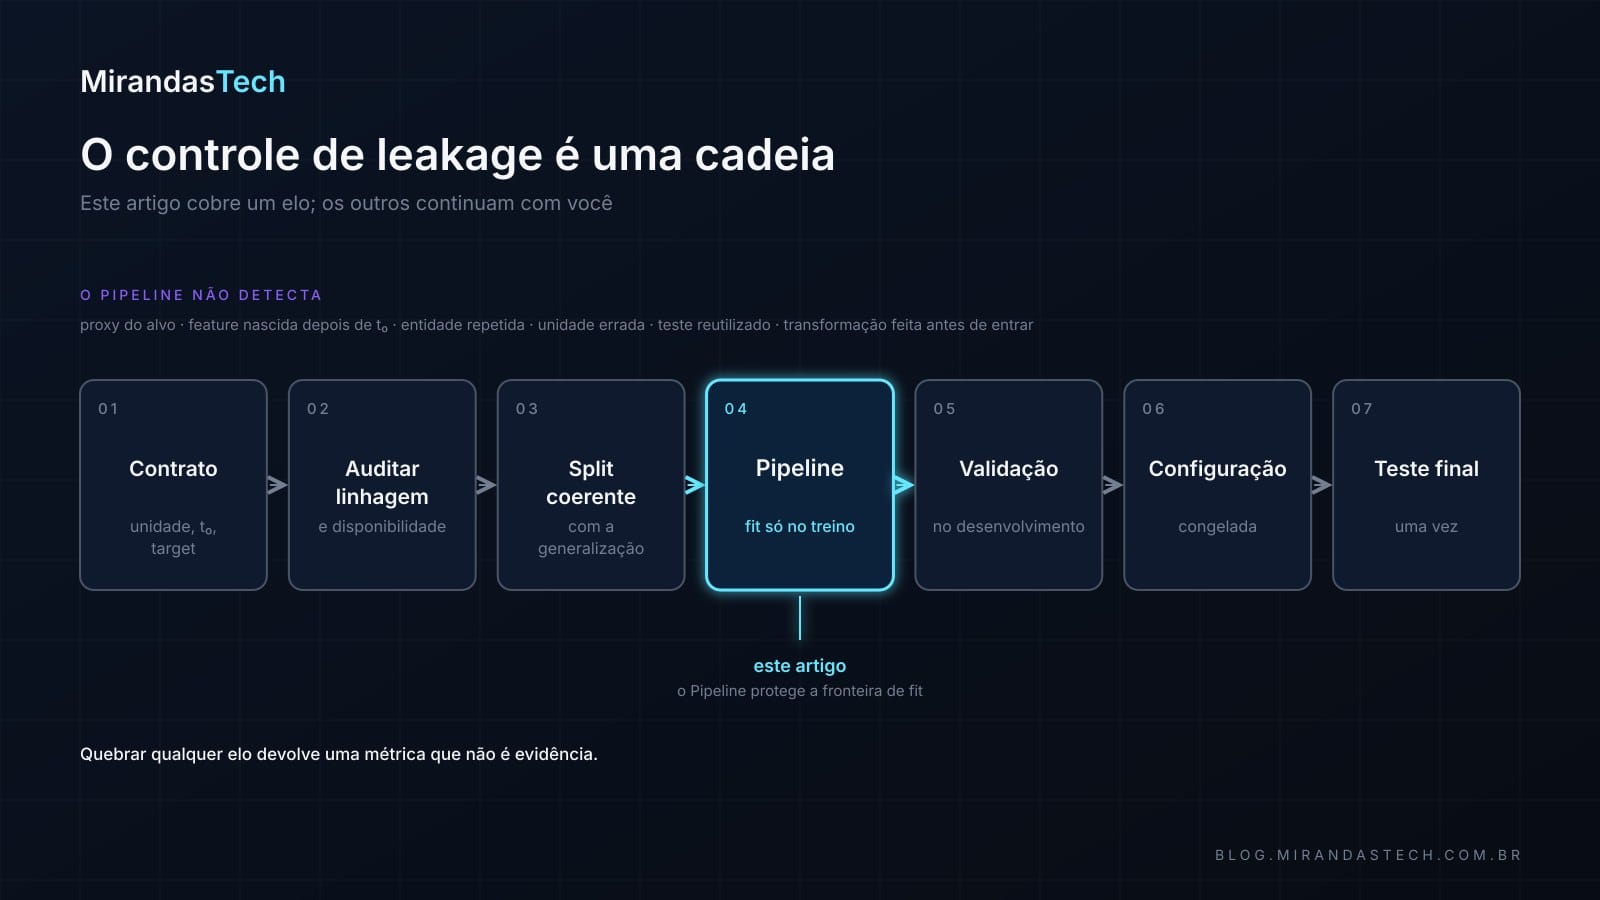
- coluna que é cópia ou proxy do alvo;
- feature produzida depois de $t_0$;
- entidade repetida entre treino e teste;
- escolha inadequada da unidade de análise;
- benchmark contaminado;
- teste reutilizado durante desenvolvimento;
- transformação externa feita antes de os dados entrarem no pipeline.
O controle completo é uma cadeia: contrato (unidade, $t_0$, target) → auditoria de linhagem e disponibilidade de cada feature → split coerente com o cenário de generalização → pipeline com fit só no treino → validação no desenvolvimento → configuração congelada → teste final uma vez. O pipeline é um elo; os outros continuam sendo responsabilidade do experimento.
10. Padrão de implementação auditável
O código abaixo junta as peças das seções 2 a 6 em um padrão que pode ser copiado para um problema tabular real: listas explícitas de colunas, um pipeline por tipo, ColumnTransformer, modelo na ponta e validação cruzada estratificada sobre os dados de desenvolvimento.
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_validate
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

numeric_features = ["idade", "renda", "meses_relacionamento"]
categorical_features = ["regiao", "canal"]

num_pipe = Pipeline([
    ("impute", SimpleImputer(strategy="median", add_indicator=True)),
    ("scale", StandardScaler()),
])
cat_pipe = Pipeline([
    ("impute", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore")),
])

preprocess = ColumnTransformer([
    ("num", num_pipe, numeric_features),
    ("cat", cat_pipe, categorical_features),
])

pipeline = Pipeline([
    ("preprocess", preprocess),
    ("model", LogisticRegression(max_iter=2_000)),
])

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=20260908)
scores = cross_validate(
    pipeline, X_development, y_development,
    cv=cv,
    scoring=["roc_auc", "average_precision"],
    return_train_score=False,
)
Rodei esse padrão sobre os dados sintéticos do laboratório (900 clientes; colunas idade, renda, meses_relacionamento, regiao e canal; 72 ausências em renda e 36 em região; 25% reservados para teste antes de qualquer fit). Em seguida, inspecionei o estado aprendido e passei uma linha com a região Centro-Oeste, que não existe no treino:
# continua do bloco anterior, sobre os dados do notebook (X_dev, y_dev, SEED, pd, DummyClassifier)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)
scoring = ["roc_auc", "average_precision"]
dummy = cross_validate(DummyClassifier(strategy="prior"), X_dev, y_dev, cv=cv, scoring=scoring)
scores = cross_validate(pipeline, X_dev, y_dev, cv=cv, scoring=scoring)
print("Dummy   ROC AUC:", dummy["test_roc_auc"].mean().round(3),
      " AP:", dummy["test_average_precision"].mean().round(3))
print("Pipeline ROC AUC:", scores["test_roc_auc"].mean().round(3),
      "±", scores["test_roc_auc"].std(ddof=1).round(3),
      " AP:", scores["test_average_precision"].mean().round(3))

pipeline.fit(X_dev, y_dev)  # ajuste final só no desenvolvimento
fitted = pipeline.named_steps["preprocess"]
imputer = fitted.named_transformers_["num"].named_steps["impute"]
encoder = fitted.named_transformers_["cat"].named_steps["onehot"]
print("Medianas aprendidas:", dict(zip(numeric_features, [round(float(v), 2) for v in imputer.statistics_])))
print("Categorias aprendidas:", {c: cats.tolist() for c, cats in zip(categorical_features, encoder.categories_)})
print("Features transformadas:", fitted.get_feature_names_out().tolist())

nova = pd.DataFrame({"idade": [37.0], "renda": [5_500.0], "meses_relacionamento": [12],
                     "regiao": ["Centro-Oeste"], "canal": ["app"]})
z = fitted.transform(nova)
print("Linha com 'Centro-Oeste' -> shape", z.shape, "| colunas de regiao:", z[0, 4:8])
Dummy   ROC AUC: 0.5  AP: 0.341
Pipeline ROC AUC: 0.689 ± 0.027  AP: 0.525
Medianas aprendidas: {'idade': 40.74, 'renda': 5188.43, 'meses_relacionamento': 61.0}
Categorias aprendidas: {'regiao': ['Nordeste', 'Norte', 'Sudeste', 'Sul'], 'canal': ['app', 'telefone', 'web']}
Features transformadas: ['num__idade', 'num__renda', 'num__meses_relacionamento', 'num__missingindicator_renda', 'cat__regiao_Nordeste', 'cat__regiao_Norte', 'cat__regiao_Sudeste', 'cat__regiao_Sul', 'cat__canal_app', 'cat__canal_telefone', 'cat__canal_web']
Linha com 'Centro-Oeste' -> shape (1, 11) | colunas de regiao: [0. 0. 0. 0.]
Três coisas para observar. O pipeline supera o baseline (0,69 contra 0,50) sem que o teste tenha sido tocado. As medianas e as categorias vêm só do desenvolvimento, e get_feature_names_out() mostra as 11 colunas resultantes, inclusive o indicador de ausência de renda. E a categoria inédita virou quatro zeros nas colunas de região, sem quebrar e sem alterar o vocabulário do encoder: o sistema seguiu funcionando, mas não aprendeu nada sobre o Centro-Oeste.
Por enquanto, use validação cruzada para observar a fronteira de fit. A escolha detalhada de folds, incerteza e validação aninhada será aprofundada mais adiante na série.
11. Testes automáticos de integridade
Além de testar código, teste o protocolo. Cada premissa metodológica do contrato pode virar uma linha executável:
assert set(train_ids).isdisjoint(test_ids)
assert set(train_groups).isdisjoint(test_groups)
assert target_column not in feature_columns
assert forbidden_future_columns.isdisjoint(feature_columns)
assert X_train.columns.tolist() == X_test.columns.tolist()
Depois do ajuste:
fitted_scaler = pipeline.named_steps["preprocess"] \
    .named_transformers_["num"].named_steps["scale"]
assert len(fitted_scaler.mean_) >= len(numeric_features)
Em dados temporais, teste também train_time.max() < test_time.min() quando essa for a política. Em dados agrupados, compare identificadores de entidade. Esses asserts transformam premissas em evidência executável.
12. Checklist antes de confiar na métrica
Antes de reportar um número, percorra três blocos. Se qualquer item falhar, a métrica ainda não é evidência.
Contrato e dados
- unidade de análise, $t_0$, horizonte e target estão definidos;
- cada feature possui origem, timestamp e regra de disponibilidade;
- identificadores e colunas futuras estão fora da lista autorizada;
- duplicatas e grupos foram tratados antes do split;
- o teste permaneceu isolado durante desenvolvimento.
Pré-processamento
- imputadores, scalers, encoders e seletores estão no pipeline;
- nenhuma transformação ajustável foi executada antes do split;
- categorias desconhecidas possuem política explícita;
- treino e inferência usam o mesmo artefato de pipeline;
- nomes e shape das features transformadas foram inspecionados.
Validação e reprodução
- o splitter representa o cenário de generalização;
- cada fold ajusta todo estado apenas no treino do fold;
- seed, versões, hiperparâmetros e schema foram registrados;
- existem asserts para separação e ausência de colunas proibidas;
- baseline e distribuição das métricas foram reportados;
- limitações e riscos residuais de leakage estão documentados.
13. Armadilhas comuns
Quase todas as armadilhas abaixo são variações da mesma pergunta da seção 1: quem participou da estimação?
- Normalizar antes de dividir. O scaler já viu a avaliação.
- Imputar no DataFrame inteiro. A estatística global contamina o teste.
- Selecionar features antes da CV. Os rótulos dos folds influenciam a seleção.
- Usar
get_dummiesglobal sem pensar. O vocabulário pode revelar categorias da avaliação; prefira encoder ajustado no treino. - Confundir
handle_unknown="ignore"com aprendizado de categoria nova. O sistema apenas evita erro. - Passar todas as colunas por
remainder="passthrough". Um ID ou proxy pode escapar da auditoria. - Acreditar que pipeline resolve tempo e grupos. O splitter continua sendo responsabilidade do experimento.
- Gerar agregações sem corte temporal. Totais futuros vazam para o passado.
- Fazer SMOTE antes da CV. Reamostragem supervisionada também deve ocorrer dentro do fluxo de treino (Kapoor & Narayanan, 2023); o tema volta mais adiante na série.
- Serializar só o modelo. Em produção, salve o pipeline completo para repetir exatamente a transformação; a divergência entre o código que gera features no treino e o que gera na inferência tem nome, training/serving skew (Breck et al., 2017).
- Consultar o teste para ajustar categorias ou limites. Isso transforma teste em validação informal.
- Celebrar métrica perfeita sem auditoria. Resultados bons demais pedem investigação de linhagem, duplicação e proxies.
14. Onde isso aparece em IA aplicada
Nada do que foi dito depende de o modelo ser uma regressão logística. Em um sistema de busca semântica ou RAG, o vocabulário de um vetorizador TF-IDF, os parâmetros de uma redução de dimensionalidade sobre embeddings ou a média usada para centralizá-los são estado aprendido, exatamente como $\widehat\phi$. Se esse estado for ajustado com o corpus inteiro, inclusive os documentos e as perguntas de avaliação, a métrica de recuperação passa a medir um sistema que já viu o gabarito.
A linha “avaliação adaptativa” da taxonomia é, em escala, o problema dos benchmarks de LLM: quando o conjunto de teste é consultado a cada iteração de prompt ou de fine-tuning, ele deixa de ser teste: o holdout reutilizado de forma adaptativa perde a validade estatística (Dwork et al., 2015), e treinar no split de teste de um benchmark é a forma mais grave de contaminação (Sainz et al., 2023). E a regra “serialize o pipeline completo” tem um paralelo direto: tokenizador, normalização de texto e modelo precisam ser versionados juntos (Breck et al., 2017), porque o modelo só sabe ler a representação com a qual foi treinado.
Um agente que decide com base em ferramentas também tem um $t_0$. As informações que o contexto traz naquele instante são as features permitidas; o resultado da ação, que só existe depois, é o alvo. Montar um conjunto de avaliação com trajetórias em que o “estado do mundo” já inclui a consequência da decisão é vazamento de disponibilidade com outro nome.
Próximo passo
Com o pipeline protegendo a fronteira de fit, o próximo artigo da série constrói o primeiro modelo supervisionado clássico, a regressão linear por mínimos quadrados, conectando álgebra linear, função de perda e análise de resíduos. O pipeline desta aula será reutilizado para garantir que o modelo veja, no treino e na inferência, a mesma representação sem contaminação.
Referências
- Kaufman, Shachar; Rosset, Saharon; Perlich, Claudia et al. Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 2012. doi.org/10.1145/2382577.2382579
- Kapoor, Sayash; Narayanan, Arvind. Leakage and the reproducibility crisis in machine-learning-based science. Patterns, 4(9), 100804, 2023. doi.org/10.1016/j.patter.2023.100804
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer Series in Statistics, Springer, 2ª ed. (§7.10.2 «The Wrong and Right Way to Do Cross-validation»; Tabela 10.1; §3.4.1; §13.3), 2009. doi.org/10.1007/978-0-387-84858-7
- Ambroise, Christophe; McLachlan, Geoffrey J. Selection bias in gene extraction on the basis of microarray gene-expression data. Proceedings of the National Academy of Sciences, 99(10), 2002. doi.org/10.1073/pnas.102102699
- Dwork, Cynthia; Feldman, Vitaly; Hardt, Moritz et al. The reusable holdout: Preserving validity in adaptive data analysis. Science, 349(6248), 2015. doi.org/10.1126/science.aaa9375
- Sainz, Oscar; Campos, Jon Ander; García-Ferrero, Iker et al. NLP Evaluation in trouble: On the Need to Measure LLM Data Contamination for each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 2023. doi.org/10.18653/v1/2023.findings-emnlp.722
- Breck, Eric; Cai, Shanqing; Nielsen, Eric et al. The ML test score: A rubric for ML production readiness and technical debt reduction. 2017 IEEE International Conference on Big Data, 2017. doi.org/10.1109/BigData.2017.8258038
- scikit-learn developers. Common pitfalls and recommended practices. Documentação oficial do scikit-learn 1.9.1, cap. 12 (acesso em 18 set. 2026), 2026. scikit-learn.org/stable/common_pitfalls.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/03-preprocessamento-pipelines-leakage.md.



