
Ridge, Lasso e Elastic Net: regularização para controlar overfitting
Controlar a complexidade de modelos lineares com Ridge, Lasso e Elastic Net, escolhendo a força da penalidade só com validação cruzada, sem tocar no teste.

Controlar a complexidade de modelos lineares com Ridge, Lasso e Elastic Net, escolhendo a força da penalidade só com dados de desenvolvimento. Pré-requisitos: Aula 04 — Regressão linear e mínimos quadrados, Aula 03 — Pré-processamento, pipelines e data leakage e as normas $L_1$ e $L_2$ de vetores como objetos geométricos.
Uma equipe prevê o consumo de uma planta a partir de 30 sensores. Vários medem quase a mesma coisa: dois termômetros no mesmo duto, dois medidores de vazão em série. Ela ajusta dois modelos com erro de treino parecido. No primeiro, os coeficientes são enormes e trocam de sinal quando poucas linhas do histórico são substituídas: um termômetro ganha +12, o vizinho −8. O segundo aceita um pequeno viés, divide o peso entre os dois termômetros e quase não se mexe quando os dados mudam. Qual deles merece ir para produção?
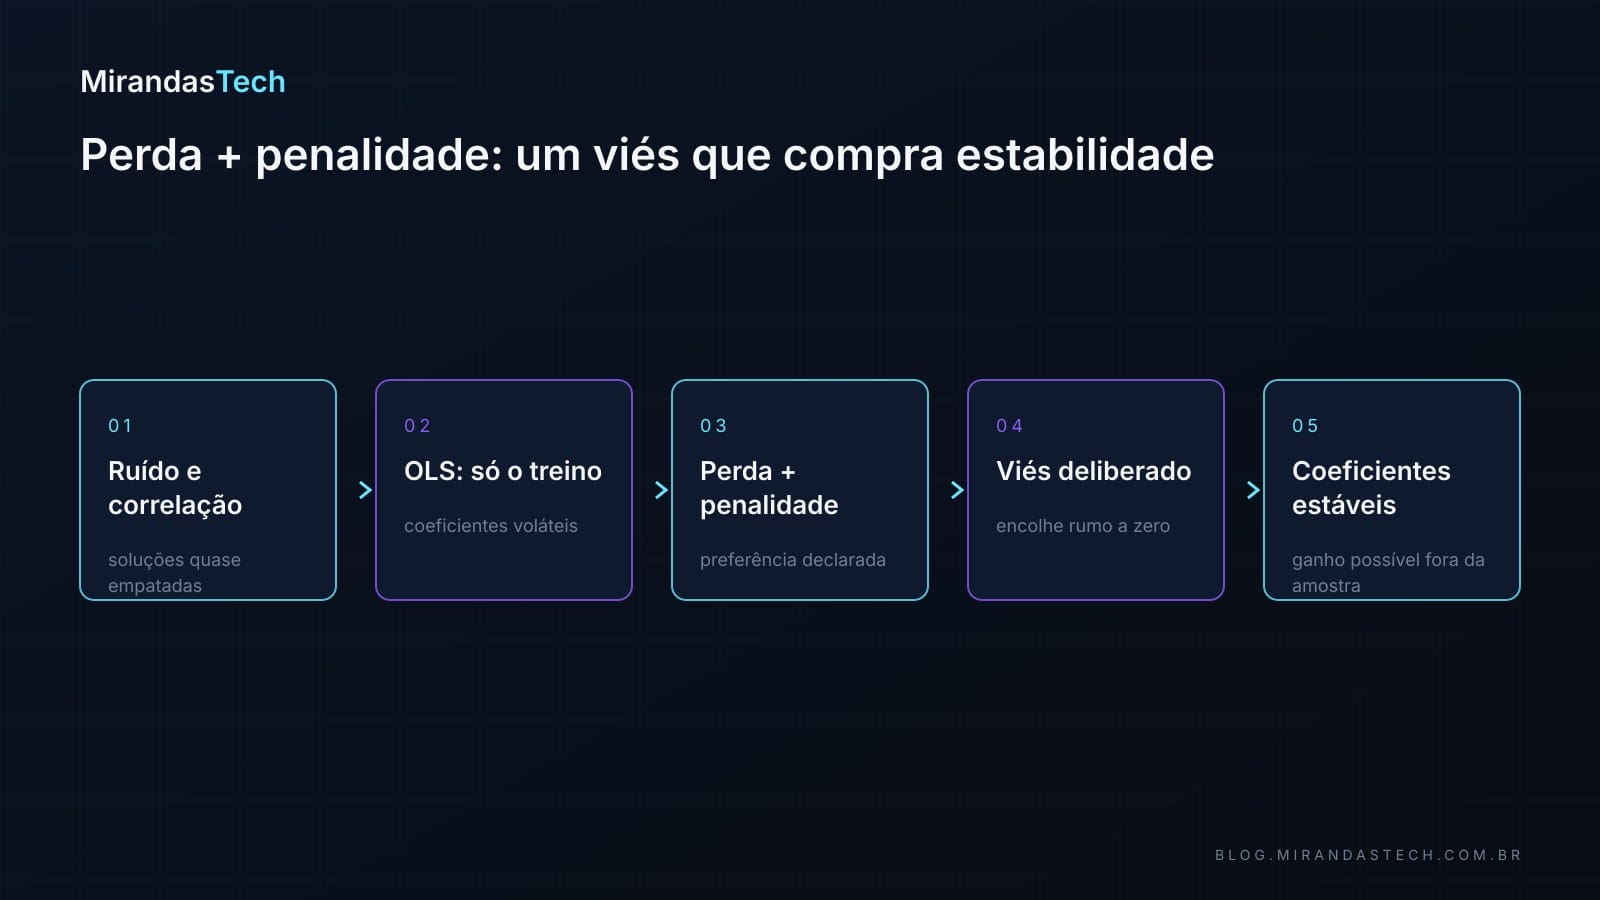
No artigo anterior, ajustamos a regressão linear por mínimos quadrados ordinários (OLS) e vimos, na seção sobre colinearidade, que colunas quase redundantes deixam os coeficientes mal determinados. Aqui entra a regularização: uma preferência explícita por coeficientes menores, somada à perda. Regularizar não é apagar coeficientes arbitrariamente. É declarar, antes de olhar o teste, quanto ajuste nos dados de desenvolvimento estamos dispostos a trocar por estabilidade. Ridge, Lasso e Elastic Net fazem essa troca de três maneiras diferentes. Ao final, você vai conseguir escrever e ler as três funções objetivo, distinguir contração de seleção de features, explicar por que a padronização precisa morar dentro do pipeline, escolher alpha por validação cruzada sem tocar no teste e ler caminhos de coeficientes e estabilidade sem tirar conclusão causal de um zero.
alpha, é um hiperparâmetro escolhido por validação, nunca pelo teste.1. O problema que OLS não resolve sozinho
OLS escolhe $\widehat\beta$ para minimizar a soma dos quadrados dos resíduos:
$$ \operatorname{RSS}(\beta)=\sum_{i=1}^{n}\left(y_i-\beta_0-x_i^T\beta\right)^2. $$
Aqui, $y_i$ é a resposta observada, $x_i$ é o vetor de features da observação $i$, $\beta_0$ é o intercepto e $\beta$ é o vetor de coeficientes. Se duas colunas de $X$ carregam quase a mesma informação, muitas combinações de coeficientes geram previsões parecidas. Uma pequena mudança na amostra pode deslocar muito peso de uma coluna para a outra. O erro de treino quase não muda, mas a interpretação e a previsão fora da amostra podem mudar.
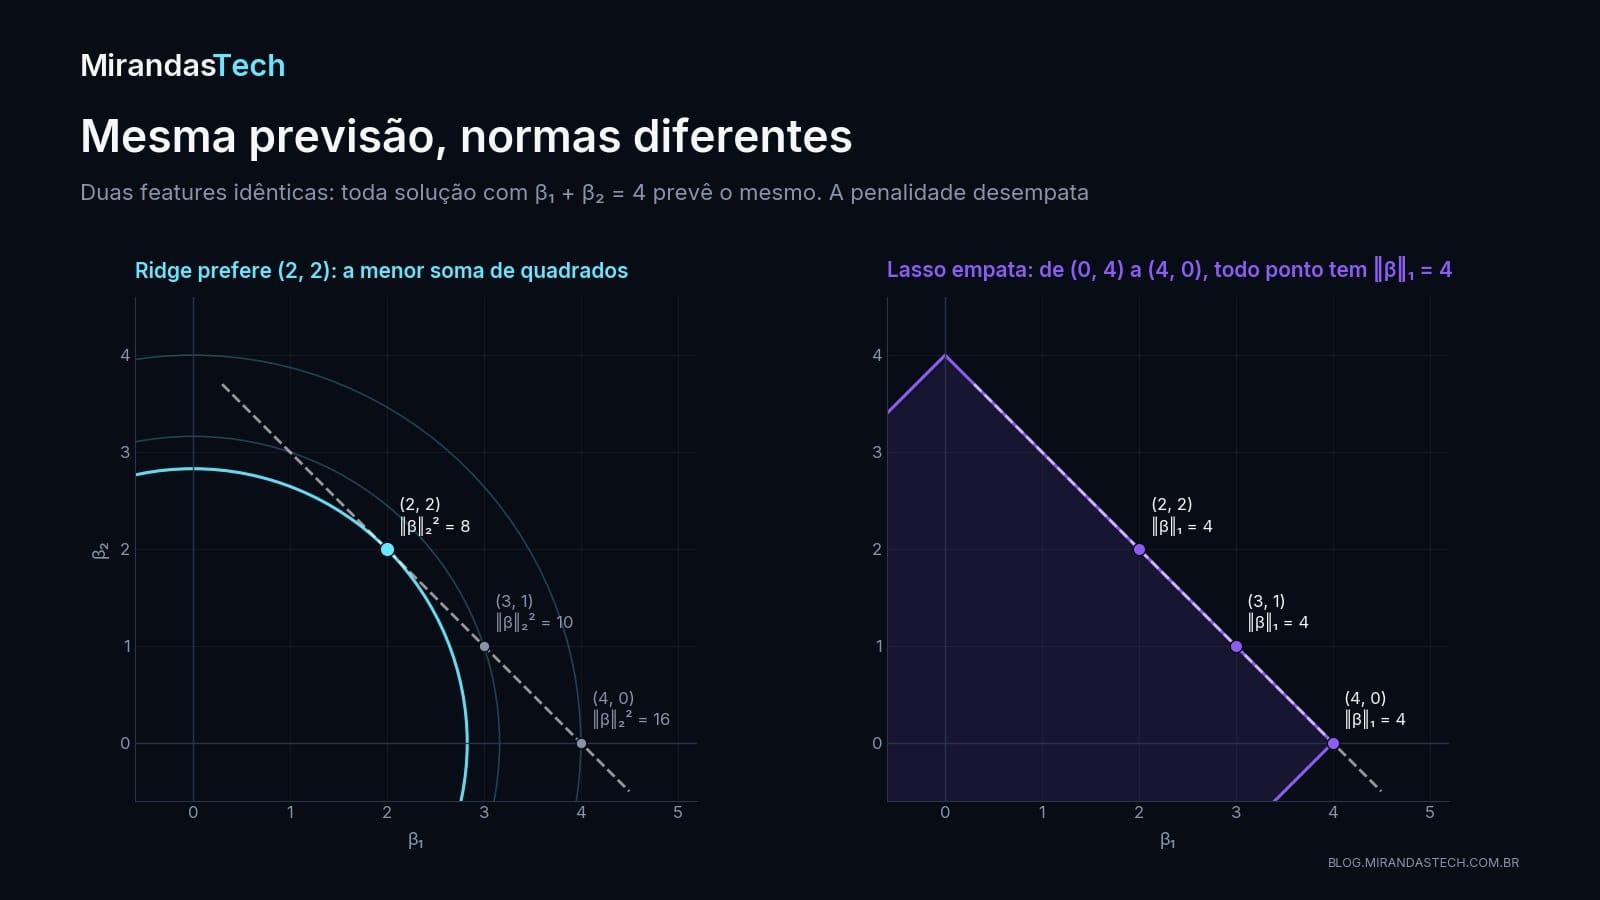
Considere o caso extremo: duas features idênticas e uma previsão que depende de $4x$.
$$ \widehat y=\beta_1x+\beta_2x,\qquad \beta_1+\beta_2=4. $$
As soluções $(4,0)$, $(3,1)$ e $(2,2)$ fazem a mesma previsão. OLS não tem motivo preditivo para preferir uma delas. Ridge, que penaliza a soma dos quadrados, prefere $(2,2)$, porque
$$ 2^2+2^2=8<3^2+1^2=10<4^2+0^2=16. $$
Já a soma dos valores absolutos, que é a penalidade do Lasso, vale $4$ nas três: ela não desempata. Essa diferença, que parece um detalhe aritmético, explica boa parte do comportamento dos dois métodos com features correlacionadas. Com colunas quase idênticas, e não exatamente iguais, o efeito aparece num experimento curto:
import numpy as np
from sklearn.linear_model import Lasso, LinearRegression, Ridge

rng = np.random.default_rng(20260908)
n = 200
x = rng.normal(size=n)
X = np.column_stack([x, x + rng.normal(0, 0.01, n)])  # duas colunas quase idênticas
y = 4 * x + rng.normal(0, 0.5, n)

print("correlação entre as colunas:", round(np.corrcoef(X.T)[0, 1], 5))
for nome, modelo in [("OLS", LinearRegression()),
                     ("Ridge", Ridge(alpha=1.0)),
                     ("Lasso", Lasso(alpha=0.1))]:
    b = modelo.fit(X, y).coef_
    print(f"{nome:5s} coeficientes={b.round(3)}  soma={b.sum():.3f}")

# mesmos x e y, outro ruído de medição na 2ª coluna: OLS muda de ideia
X2 = np.column_stack([x, x + rng.normal(0, 0.01, n)])
print("OLS, nova perturbação:", LinearRegression().fit(X2, y).coef_.round(3))
Saída real, com Python 3.13, NumPy 2.2 e scikit-learn 1.9:
correlação entre as colunas: 0.99995
OLS   coeficientes=[3.    0.953]  soma=3.953
Ridge coeficientes=[1.981 1.962]  soma=3.943
Lasso coeficientes=[3.855 0.   ]  soma=3.855
OLS, nova perturbação: [12.286 -8.342]
As três somas ficam perto de 4, porque a previsão depende só da soma. O que muda é a divisão. OLS põe 3,0 numa coluna e 0,95 na outra; basta trocar o ruído de medição da segunda coluna, sem mexer em $y$, para ele passar a 12,3 e −8,3. Ridge divide quase meio a meio. Lasso fica com uma coluna e zera a outra. A penalidade torna explícita uma preferência entre soluções que ajustam os dados de forma semelhante.
2. A ideia central: perda mais penalidade
A forma normalizada que usamos neste artigo é
$$ \begin{aligned} \underset{\beta_0,\,\beta}{\operatorname{minimizar}}\quad &\frac{1}{2n}\sum_{i=1}^{n}\left(y_i-\beta_0-x_i^T\beta\right)^2\\ &+\alpha\,\Omega(\beta). \end{aligned} $$
O que cada símbolo significa:
- $n$: número de observações;
- $x_i$: vetor de features da observação $i$; $y_i$: resposta observada;
- $\beta_0$: intercepto; $\beta$: vetor de coeficientes;
- $\Omega(\beta)$: penalidade, uma medida do tamanho de $\beta$;
- $\alpha\geq0$: força da regularização.
Com $\alpha=0$, recuperamos OLS. Ao aumentar $\alpha$, aceitamos mais erro de ajuste em troca de coeficientes menores. Se $\alpha$ for excessivo, o modelo sofre underfitting: todos os coeficientes vão para perto de zero e a previsão vira, no limite, a média de $y$.
Há convenções diferentes para o fator diante da perda e da penalidade, e por isso valores de alpha não são comparáveis entre bibliotecas nem entre formulações. O exemplo mais próximo está no próprio scikit-learn: Lasso e ElasticNet usam o fator $\frac{1}{2n}$ acima, mas Ridge minimiza $\|y-Xw\|_2^2+\alpha\|w\|_2^2$, sem dividir por $n$ (scikit-learn developers, 2026). O mesmo número significa coisas diferentes nas duas classes. Compare o comportamento do modelo e leia a função objetivo da implementação.
O intercepto fica fora de $\Omega$. Ele representa o nível médio da resposta, não a sensibilidade às features; penalizá-lo deslocaria as previsões sem justificativa. Nos estimadores do scikit-learn tratados aqui, com fit_intercept=True, isso vale, e dá para conferir: com alpha enorme, os coeficientes vão a zero e o intercepto pousa exatamente na média de $y$ (última linha da saída na seção 4).
3. Ridge: penalidade quadrática L₂
Ridge usa a norma $L_2$ ao quadrado:
$$ \Omega(\beta)=\frac{1}{2}\|\beta\|_2^2=\frac{1}{2}\sum_{j=1}^{p}\beta_j^2, $$
e sua função objetivo é
$$ \underset{\beta_0,\,\beta}{\operatorname{minimizar}}\quad \frac{1}{2n}\left\|y-\beta_0\mathbf{1}-X\beta\right\|_2^2+\frac{\alpha}{2}\|\beta\|_2^2, $$
em que $p$ é o número de features e $\mathbf{1}$ é o vetor de uns. A derivada da penalidade em relação a $\beta_j$ é $\alpha\beta_j$: cresce com o tamanho do coeficiente. Coeficientes grandes recebem pressão maior; em geral, Ridge os aproxima de zero, mas não os zera exatamente.
Com $X$ e $y$ centralizados (o que elimina o intercepto) e escrevendo a função objetivo como $\|y-X\beta\|_2^2+\lambda\|\beta\|_2^2$, sem o fator $\frac{1}{2n}$ na perda, como faz o Ridge do scikit-learn, a solução fechada é
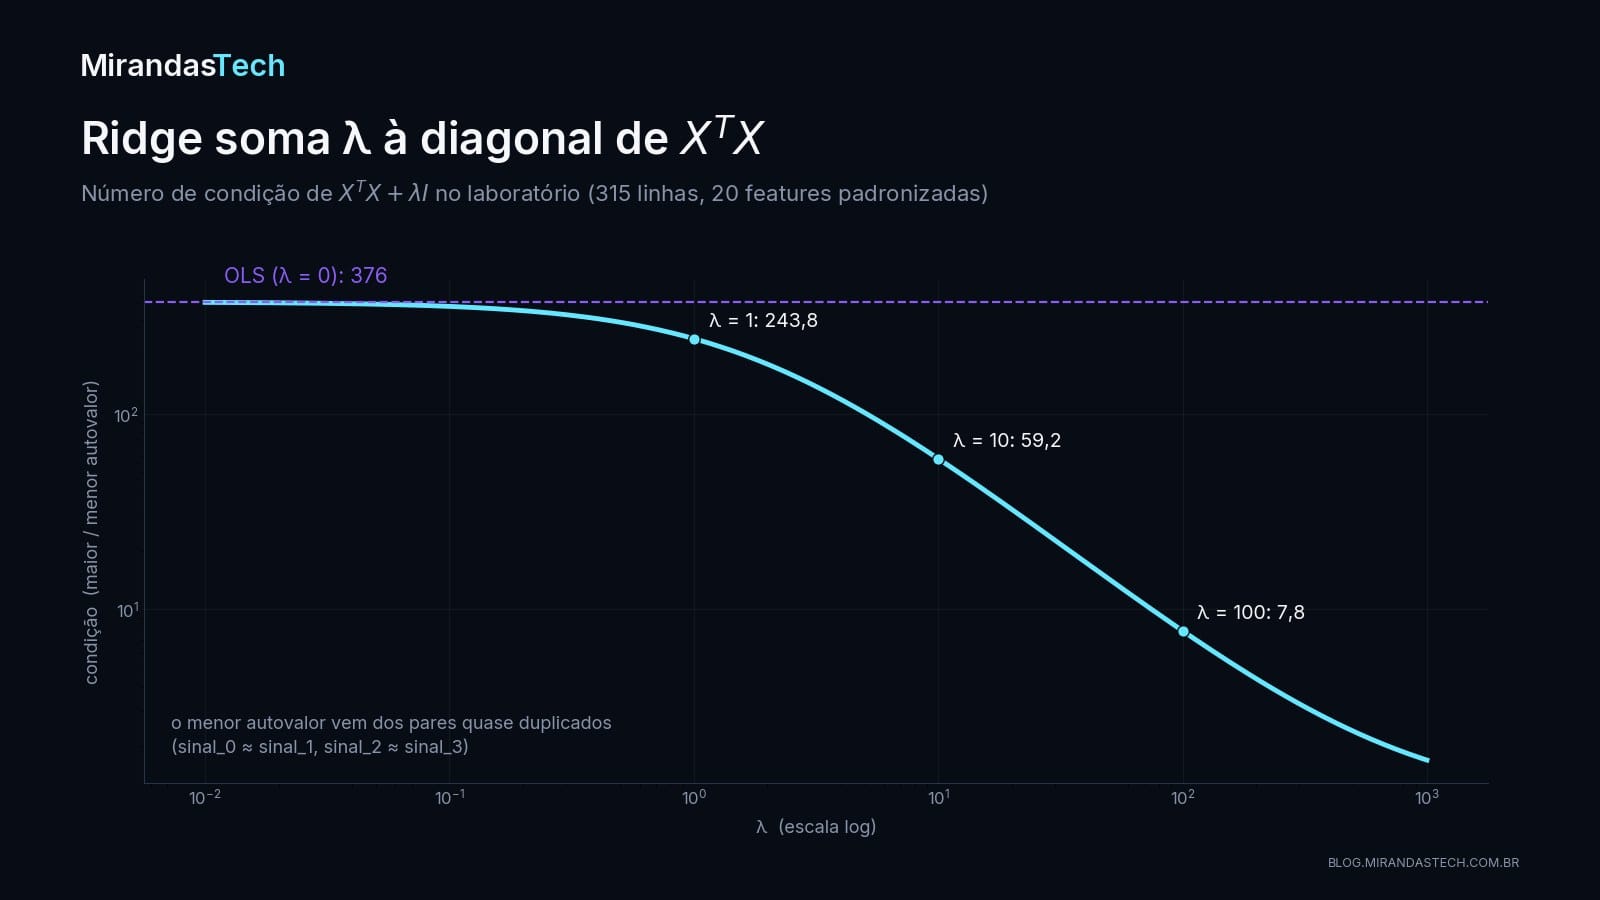
$$ \widehat\beta_{\text{ridge}}=\left(X^TX+\lambda I\right)^{-1}X^Ty . $$
Na forma normalizada acima, $\lambda=n\alpha$. O termo $\lambda I$ soma $\lambda$ a toda a diagonal de $X^TX$. Foi exatamente essa a proposta de Hoerl e Kennard (1970): acrescentar pequenas quantidades positivas à diagonal de $X^TX$ para obter estimativas viesadas, mas com erro quadrático médio menor quando as colunas não são ortogonais. Somar $\lambda$ a todos os autovalores de $X^TX$ afasta o menor deles de zero e melhora o condicionamento.
A expressão serve para compreender o método. Em código, não calcule a inversa: resolva o sistema linear, ou deixe o solver da biblioteca fazer isso. O bloco da seção 4 confere que np.linalg.solve e Ridge concordam até $4{,}4\times10^{-16}$.
Quando Ridge é uma boa escolha
- muitas features têm efeitos pequenos e distribuídos;
- há multicolinearidade;
- previsão e estabilidade importam mais que uma lista curta de variáveis;
- deseja-se manter todas as features no modelo.
Limite importante
Ridge reduz magnitude, mas não faz seleção: no laboratório, os 20 coeficientes continuam diferentes de zero. E um coeficiente pequeno depende da unidade da feature; interpretá-lo exige padronização e contexto (seção 6).
4. Lasso: penalidade absoluta L₁
Lasso (Least Absolute Shrinkage and Selection Operator) usa a norma $L_1$:
$$ \Omega(\beta)=\|\beta\|_1=\sum_{j=1}^{p}|\beta_j|, $$
e, portanto,
$$ \underset{\beta_0,\,\beta}{\operatorname{minimizar}}\quad \frac{1}{2n}\left\|y-\beta_0\mathbf{1}-X\beta\right\|_2^2+\alpha\|\beta\|_1 . $$
O valor absoluto tem uma quina em zero. Geometricamente, a região $\|\beta\|_1\leq t$ é um losango cujas pontas ficam sobre os eixos, e as curvas de nível do erro quadrático tendem a encostar nele justamente numa ponta, onde algum coeficiente vale zero. A região de Ridge é um disco, sem pontas: o encontro acontece num ponto liso, em geral fora dos eixos. Tibshirani (1996) descreve o efeito na proposta original: pela natureza da restrição, o Lasso tende a produzir alguns coeficientes exatamente iguais a zero, o que dá modelos interpretáveis. Por isso ele combina contração e seleção de features.
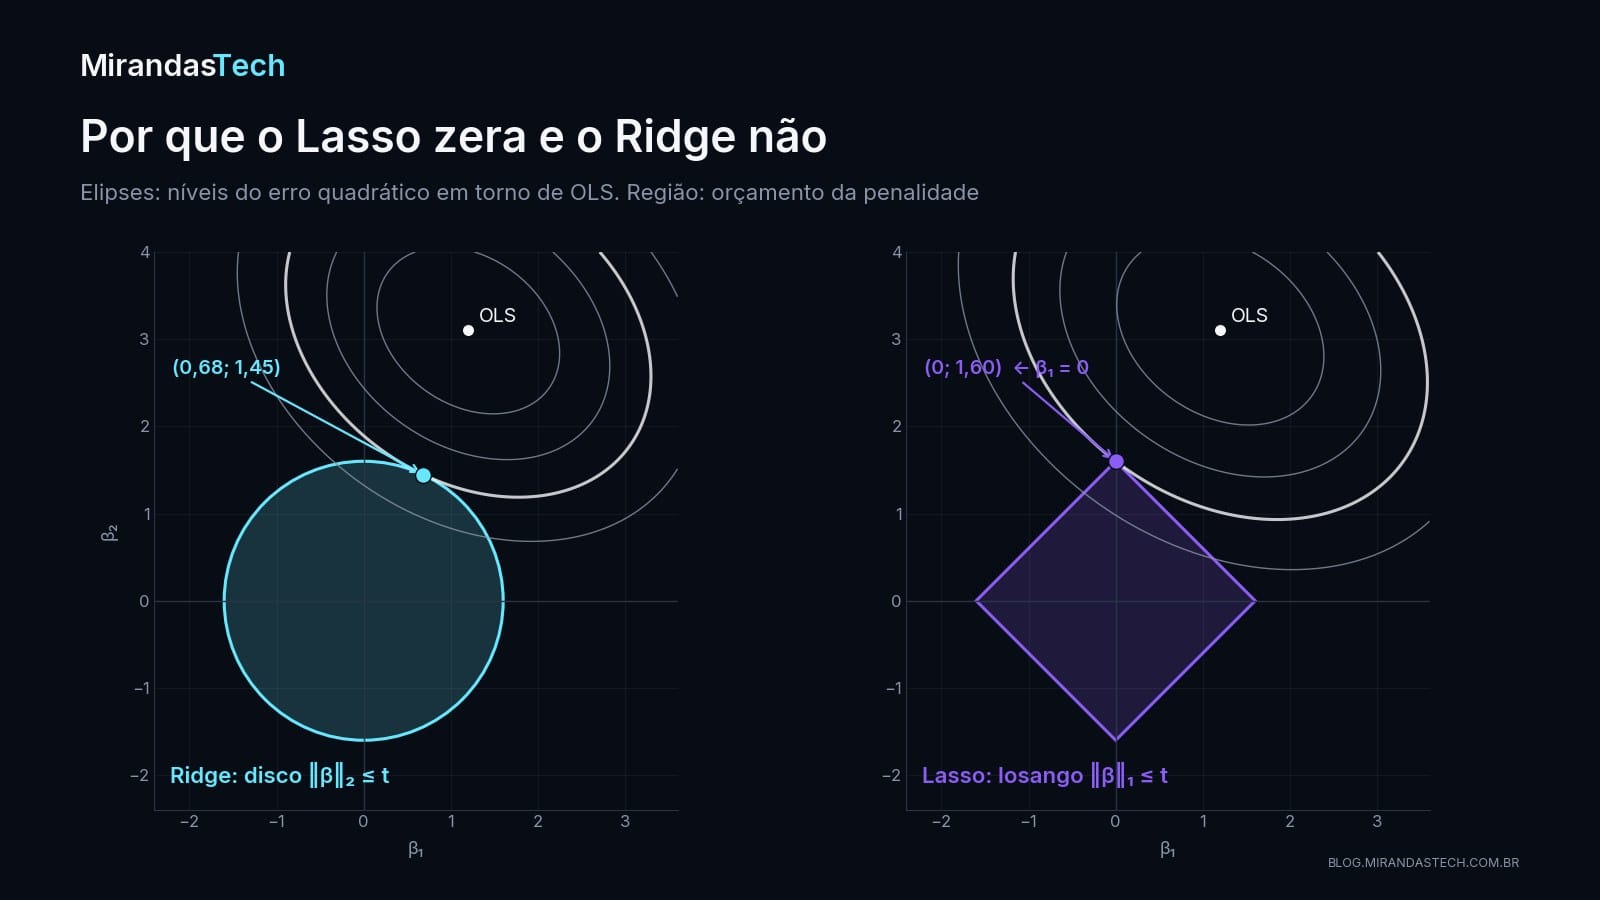
A conta fica explícita no caso ortogonal: features padronizadas e não correlacionadas, de modo que $X^TX/n=I$. Nesse caso, cada coeficiente do Lasso é uma limiarização suave do coeficiente OLS correspondente, $z_j$:
$$ \widehat\beta_j^{\,\text{lasso}}=\operatorname{sign}(z_j)\,\max\!\left(|z_j|-\alpha,\;0\right). $$
Se $|z_j|\leq\alpha$, o resultado é zero; acima disso, o coeficiente é puxado $\alpha$ unidades na direção de zero. Na mesma situação, o Ridge da forma normalizada divide: $\widehat\beta_j^{\,\text{ridge}}=z_j/(1+\alpha)$, que encolhe mas nunca zera. O bloco abaixo confere as duas contas contra o scikit-learn:
import numpy as np
from sklearn.linear_model import Lasso, Ridge

rng = np.random.default_rng(20260908)
n, p = 100, 4

# Ridge: solução fechada x scikit-learn (dados centralizados, sem intercepto)
X = rng.normal(size=(n, p)); X -= X.mean(axis=0)
y = X @ np.array([3.0, -2.0, 0.5, 0.0]) + rng.normal(0, 1, n); y -= y.mean()
lam = 5.0
fechada = np.linalg.solve(X.T @ X + lam * np.eye(p), X.T @ y)   # solve, não inv
sk = Ridge(alpha=lam, fit_intercept=False).fit(X, y).coef_
print("Ridge: maior diferença fechada x sklearn:", f"{np.abs(fechada - sk).max():.1e}")

# Lasso no caso ortogonal: X^T X / n = I  =>  limiarização suave do OLS
Q, _ = np.linalg.qr(rng.normal(size=(n, p)))
Xo = np.sqrt(n) * Q                                   # colunas ortogonais, X^T X = n I
yo = Xo @ np.array([3.0, -2.0, 0.5, 0.05]) + rng.normal(0, 1, n)
z = Xo.T @ yo / n                                      # coeficientes OLS
alpha = 0.3
limiar = np.sign(z) * np.maximum(np.abs(z) - alpha, 0)
lasso = Lasso(alpha=alpha, fit_intercept=False, tol=1e-12, max_iter=100_000).fit(Xo, yo).coef_
print("OLS z:      ", z.round(4))
print("limiarização:", limiar.round(4))
print("Lasso:       ", lasso.round(4))
print("maior diferença:", f"{np.abs(limiar - lasso).max():.1e}")

# Intercepto fora da penalidade: com alpha enorme, coeficientes -> 0 e intercepto -> média de y
Xi = rng.normal(size=(n, p)) + 5
yi = Xi @ np.array([1.0, 2.0, 3.0, 0.0]) + 10 + rng.normal(0, 1, n)
r = Ridge(alpha=1e12).fit(Xi, yi)
print("Ridge(alpha=1e12): |coef| máx", f"{np.abs(r.coef_).max():.1e}",
      "| intercepto", round(r.intercept_, 4), "| média de y", round(yi.mean(), 4))
Ridge: maior diferença fechada x sklearn: 4.4e-16
OLS z:       [ 2.9536 -2.2168  0.4312  0.0076]
limiarização: [ 2.6536 -1.9168  0.1312  0.    ]
Lasso:        [ 2.6536 -1.9168  0.1312  0.    ]
maior diferença: 2.7e-15
Ridge(alpha=1e12): |coef| máx 3.0e-10 | intercepto 40.3336 | média de y 40.3336
O coeficiente OLS de 0,0076 cai abaixo do limiar $\alpha=0{,}3$ e vira zero; os outros três são puxados exatamente 0,3 na direção de zero. A solução fechada de Ridge e a da biblioteca coincidem, e o intercepto, como prometido na seção 2, fica de fora da penalidade.
Fora do caso ortogonal não há fórmula fechada geral: como $|\beta_j|$ não é diferenciável em zero, não basta igualar o gradiente a zero, como no Ridge. O problema continua convexo, e algoritmos como a descida por coordenadas o resolvem de forma eficiente, inclusive ao longo de uma grade inteira de valores de $\alpha$ (Friedman; Hastie; Tibshirani, 2010). É o algoritmo usado pelas classes Lasso e ElasticNet do scikit-learn.
Quando Lasso é atraente
- acredita-se que poucos preditores carregam a maior parte do sinal;
- um modelo esparso reduz custo de medição ou de comunicação;
- seleção de variáveis é útil como etapa preditiva exploratória.
O perigo das features correlacionadas
Se duas features são substitutas, o Lasso pode ficar com uma e zerar a outra, e outra amostra pode mudar essa escolha. A documentação do scikit-learn resume: diante de várias features correlacionadas entre si, o Lasso tende a escolher uma delas ao acaso, enquanto o Elastic Net tende a manter as duas (scikit-learn developers, 2026). Foi o que vimos na seção 1, e a seção 10 mostra o mesmo com reamostragens. O modelo pode prever bem e ainda ser instável como mecanismo de seleção. E coeficiente zero não significa ausência de associação no mundo real, nem ausência de efeito causal: significa que, com esses dados e esse $\alpha$, a coluna não foi necessária para prever.
5. Elastic Net: combinar L₁ e L₂
Elastic Net mistura as duas penalidades:
$$ \begin{aligned} \underset{\beta_0,\,\beta}{\operatorname{minimizar}}\quad &\frac{1}{2n}\left\|y-\beta_0\mathbf{1}-X\beta\right\|_2^2\\ &+\alpha\rho\,\|\beta\|_1\\ &+\frac{\alpha(1-\rho)}{2}\|\beta\|_2^2 . \end{aligned} $$
- $\alpha$ controla a força total;
- $\rho$, chamado
l1_rationo scikit-learn, controla a mistura; - $\rho=1$ reproduz o Lasso;
- $\rho=0$ corresponde à penalidade Ridge nessa parametrização, embora a classe
ElasticNetnão seja a opção numérica recomendada para Ridge puro.
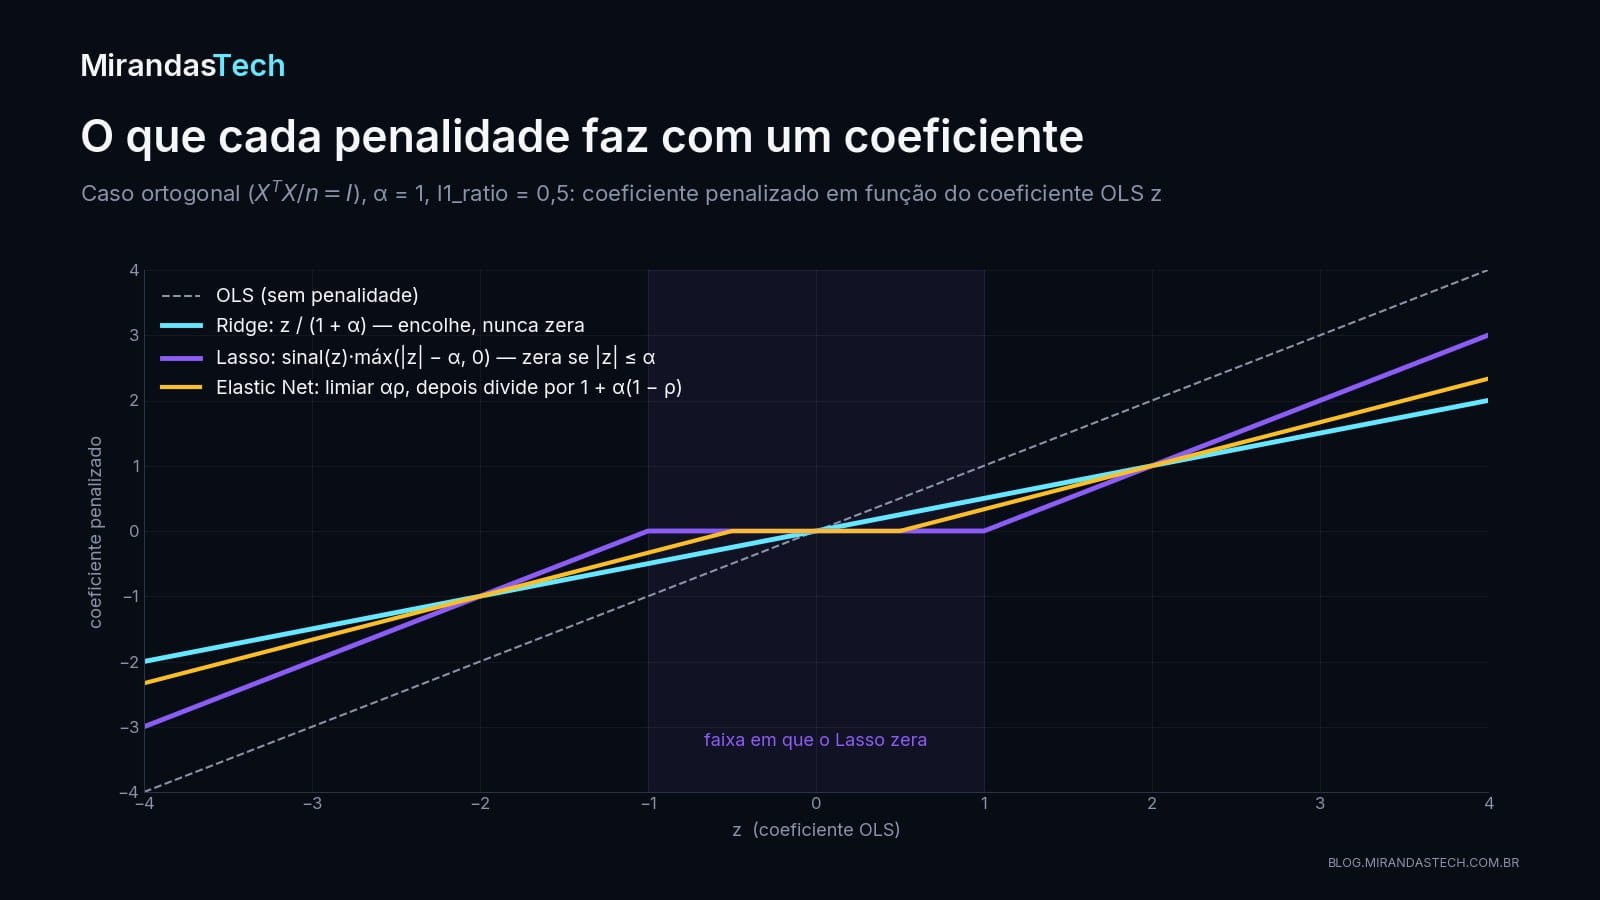
No caso ortogonal, a regra do Elastic Net é a composição das duas anteriores: primeiro a limiarização com limiar $\alpha\rho$, depois a divisão por $1+\alpha(1-\rho)$. O gerador da figura confere essa expressão contra a classe ElasticNet. Por isso ele pode produzir zeros e, graças ao componente $L_2$, tende a ser mais estável quando features correlacionadas formam grupos. Zou e Hastie (2005), que propuseram o método, chamam isso de efeito de agrupamento: preditores fortemente correlacionados tendem a entrar ou sair do modelo juntos. Os autores também o recomendam quando o número de preditores é muito maior que o de observações, situação em que o Lasso não é um método de seleção satisfatório.
O preço é um hiperparâmetro a mais. Se l1_ratio também for selecionado, essa busca tem de acontecer dentro do mesmo protocolo de validação que escolhe alpha.
Lado a lado:
- OLS: sem penalidade; não zera; com colunas correlacionadas, pode ser instável; serve de baseline e funciona bem com poucos preditores bem condicionados.
- Ridge ($L_2$): raramente zera; divide o peso entre correlacionadas, com mais estabilidade; indicado para sinal distribuído e colinearidade.
- Lasso ($L_1$): zera; entre correlacionadas, pode escolher uma arbitrariamente; indicado quando a hipótese é esparsa e a seleção preditiva interessa.
- Elastic Net ($L_1+L_2$): zera; favorece o efeito de agrupamento; indicado para esparsidade com grupos correlacionados, por exemplo 200 variáveis derivadas de 20 sensores.
6. Por que a escala muda a penalidade
Suponha que uma distância esteja em quilômetros. Representada em metros, a coluna é multiplicada por 1.000 e, para preservar a previsão, seu coeficiente é dividido por 1.000. A previsão não muda, mas a penalidade vê números diferentes: a parcela de Ridge daquele coeficiente cai um milhão de vezes. Sem padronização, uma feature medida em escala grande usa um coeficiente numericamente pequeno e quase não é penalizada. O ajuste passa a depender da unidade de medida, e não do fenômeno.
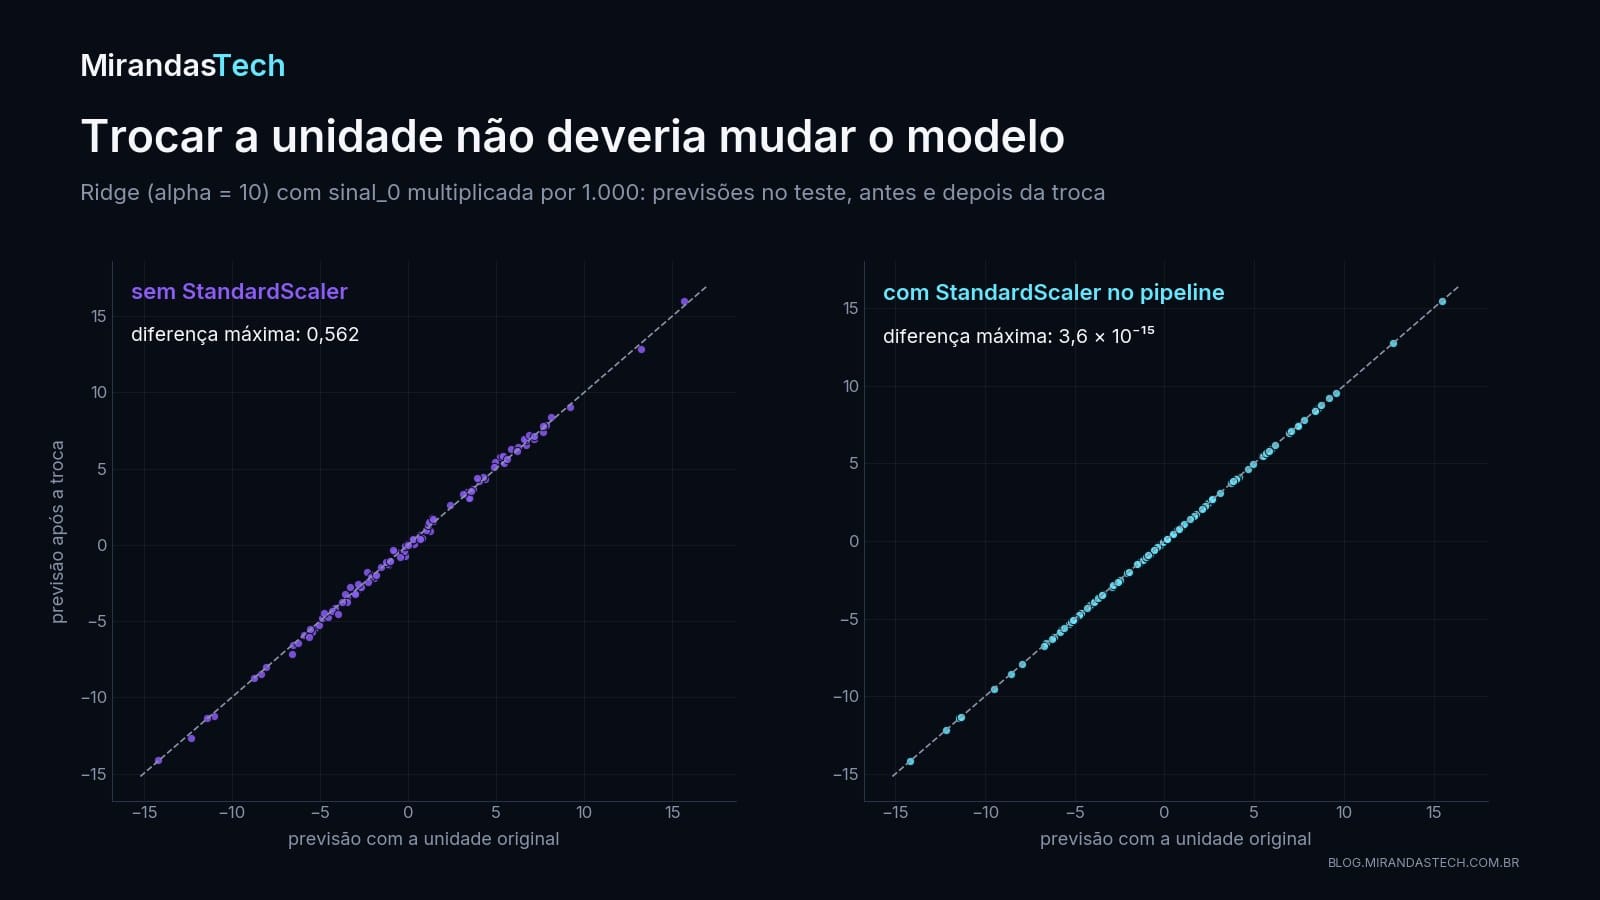
A saída é padronizar cada coluna usando apenas o treino de cada fold:
$$ z_{ij}=\frac{x_{ij}-\mu_j^{(\text{treino})}}{s_j^{(\text{treino})}}, $$
em que $\mu_j^{(\text{treino})}$ e $s_j^{(\text{treino})}$ são a média e o desvio-padrão da coluna $j$ calculados só nas linhas de treino. Como vimos no artigo sobre pipelines e data leakage, o StandardScaler deve estar dentro de um Pipeline. Durante a validação cruzada, cada fold aprende $\mu_j$ e $s_j$ apenas em sua parte de treino. Padronizar o conjunto inteiro antes da validação vaza informação das partições de validação.
Features binárias podem ou não ser escaladas, conforme a representação e a interpretação desejadas. O ponto metodológico é decidir conscientemente e manter o ajuste dentro da fronteira de treino.
7. Selecionar alpha sem usar o teste
alpha não é aprendido pela minimização que estima os coeficientes. É um hiperparâmetro, e o conjunto de teste não participa de sua escolha.
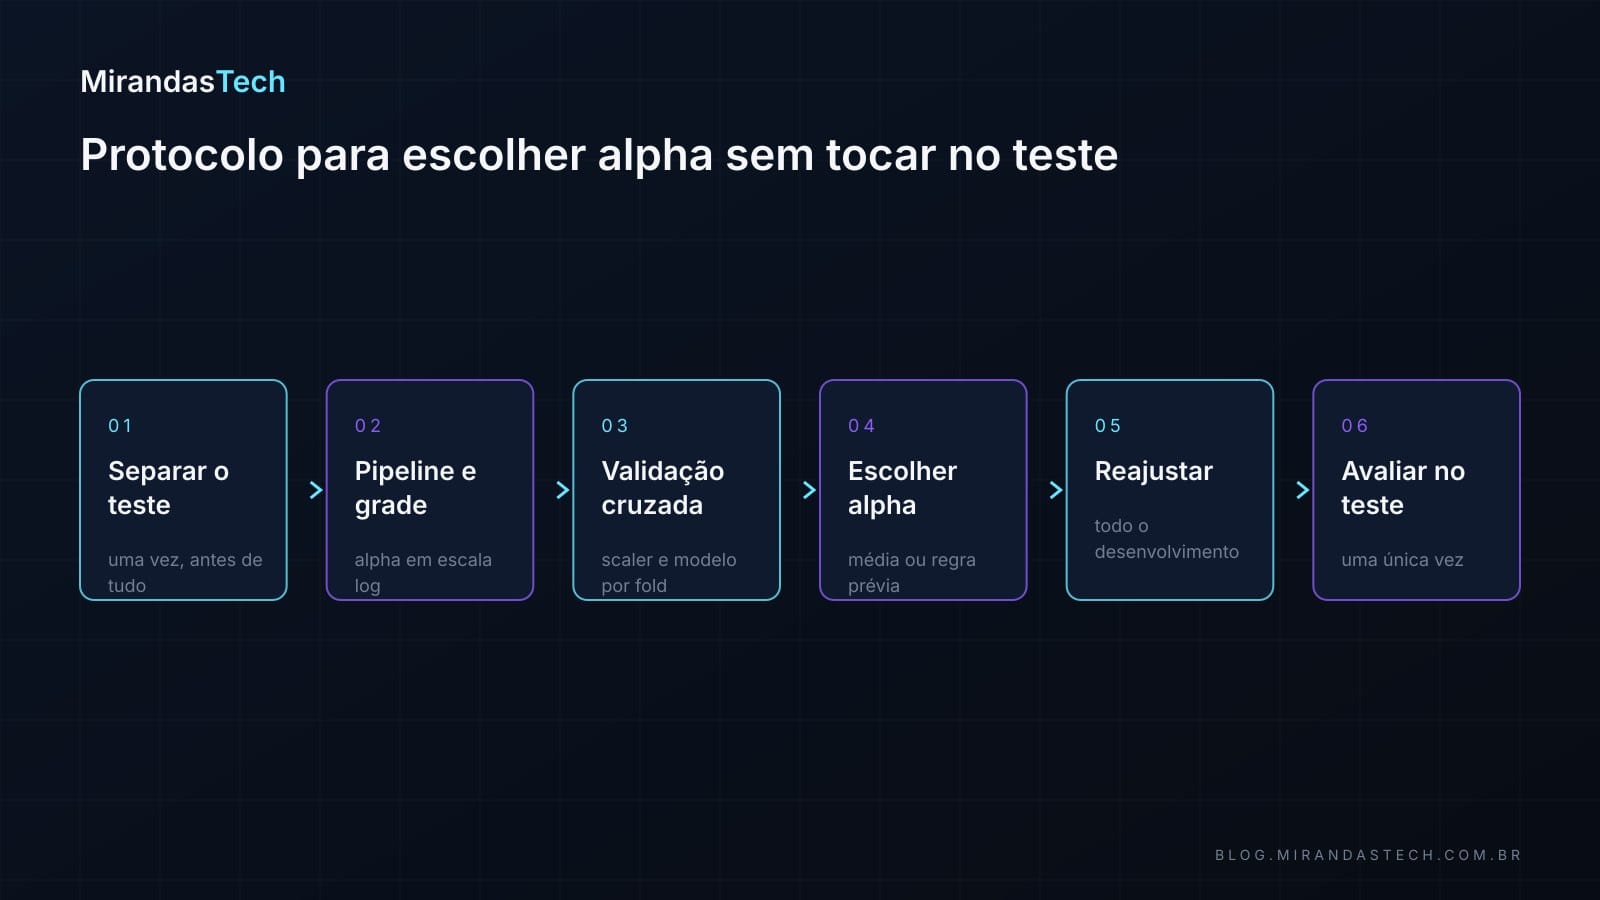
Um protocolo mínimo:
- separe o teste antes de explorar os hiperparâmetros;
- escolha uma métrica coerente com o problema, como RMSE;
- defina a grade de
alphaem escala logarítmica; - para cada candidato, execute validação cruzada com todo o pré-processamento dentro do pipeline;
- escolha o candidato pelo desempenho médio ou por uma regra definida antes;
- ajuste o pipeline escolhido em todos os dados de desenvolvimento;
- avalie uma única vez no teste.
Grades logarítmicas são naturais porque o efeito relevante pode aparecer em ordens de grandeza diferentes. Se o melhor valor cair na borda da grade, amplie-a e repita a busca, sempre só no desenvolvimento.
Há incerteza na própria validação. Diferenças mínimas entre candidatos não justificam uma narrativa de superioridade. Uma alternativa é a regra de um erro-padrão: escolher a solução mais regularizada cujo erro esteja a até um erro-padrão do mínimo (Hastie; Tibshirani; Friedman, 2009, §7.10). Ela favorece a simplicidade, mas precisa ser definida antes da inspeção final.
alpha, escolheu o de menor RMSE no teste e publicou esse mesmo RMSE. Qual é o problema? O teste virou validação. O menor de 20 valores aproveita flutuações favoráveis e tende a ser otimista. Selecione alpha por validação cruzada no desenvolvimento, reajuste e use o teste uma única vez.8. Caminhos de coeficientes e diagnóstico
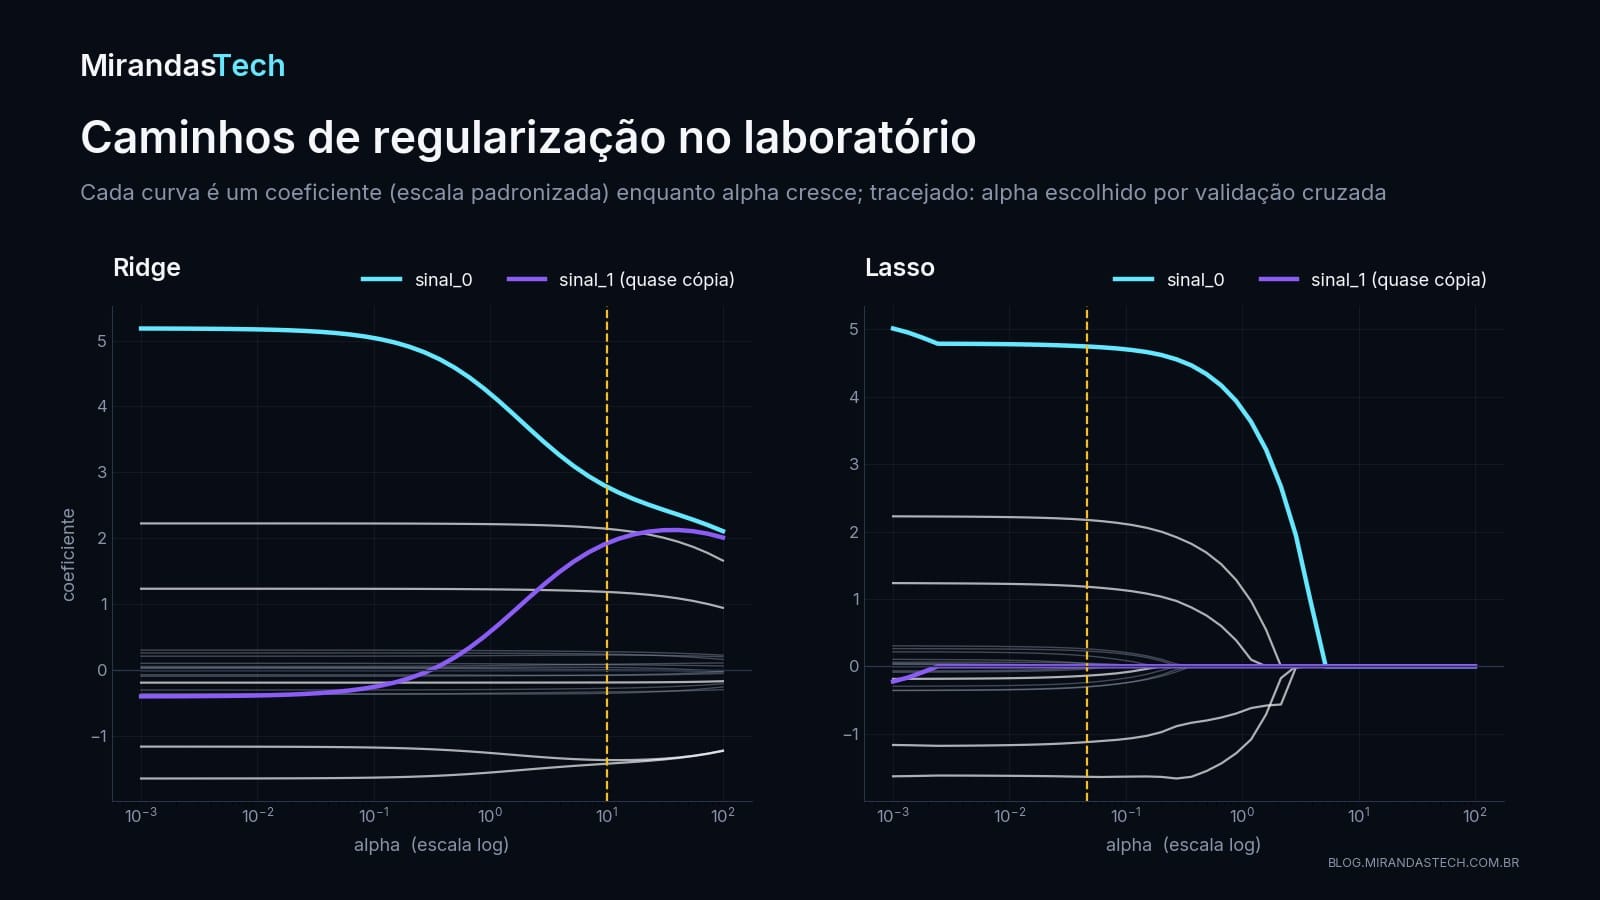
Um único alpha esconde a dinâmica. No caminho de regularização, cada curva mostra um coeficiente enquanto alpha varia. A ideia é antiga: Hoerl e Kennard (1970) já propunham o ridge trace para mostrar, em duas dimensões, o efeito da não ortogonalidade das colunas.
- em
alphapequeno, a solução se aproxima de OLS; - em Ridge, as curvas variam de forma contínua e o tamanho total $\|\beta\|_2$ diminui à medida que
alphacresce, mas um coeficiente isolado pode crescer ou trocar de sinal (comosinal_1na figura); nenhum chega exatamente a zero; - em Lasso, algumas curvas atingem zero;
- entradas e saídas instáveis entre features correlacionadas são um alerta interpretativo.
Avalie mais que o RMSE. Cada pergunta pede uma evidência:
- O modelo generaliza? Validação cruzada e teste reservado.
- Supera uma regra simples? Baseline da média ou do domínio.
- É estável? Dispersão dos coeficientes em reamostragens. Meinshausen e Bühlmann (2010) levaram essa ideia adiante na stability selection, que combina subamostragem com o algoritmo de seleção e oferece, via controle do erro de falsas seleções, um princípio transparente para escolher a quantidade de regularização.
- É esparso? Número de coeficientes não nulos, com tolerância declarada.
- Depende da unidade? Teste de invariância após reescala.
- Extrapola perigosamente? Faixa das features e análise de resíduos.
Em problemas temporais ou agrupados, troque o KFold aleatório por um particionamento compatível com a unidade de generalização. A regularização não corrige um desenho experimental inadequado.
9. Exemplo resolvido: escolher entre as três penalidades
De volta à equipe dos 30 sensores, vários deles medindo fenômenos semelhantes.
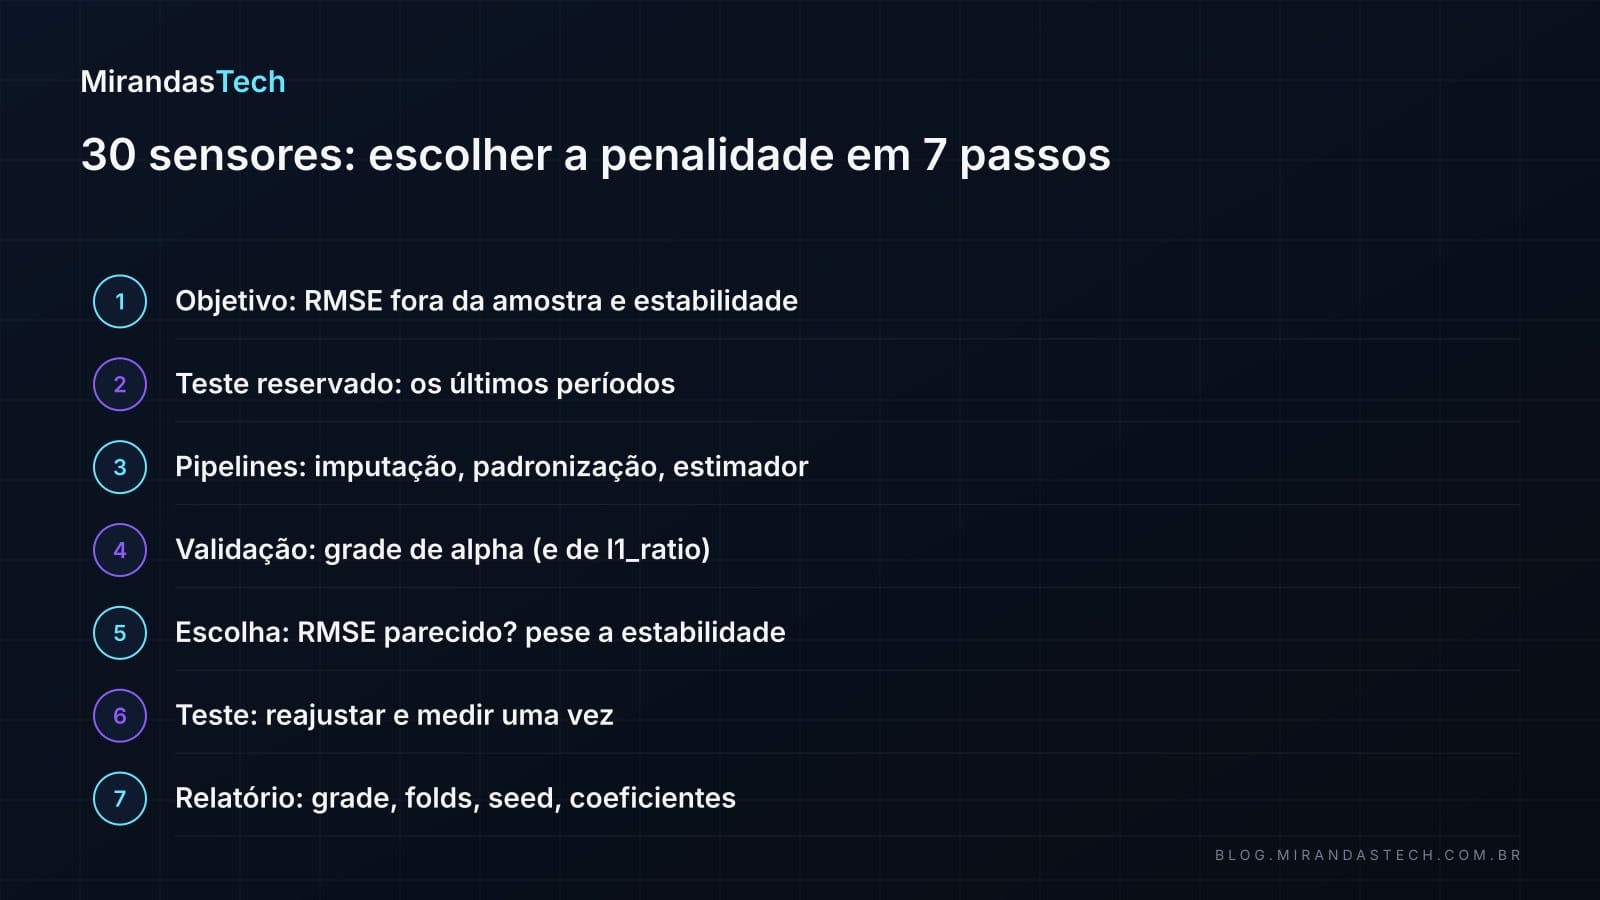
- Objetivo. Minimizar o RMSE fora da amostra; a estabilidade é um requisito operacional.
- Teste reservado. Como o uso real é temporal, os últimos períodos são isolados. Nenhuma decisão sobre
alphaconsulta esse teste. - Pipelines. Cada candidato contém imputação, padronização e estimador. A imputação só é omitida se os dados forem comprovadamente completos.
- Validação. Avaliam-se valores de
alphanuma grade logarítmica, com folds que respeitam o tempo. O Elastic Net também fixa ou validal1_ratio. - Escolha. Se Ridge e Lasso tiverem RMSE quase igual, mas o Lasso alternar os sensores selecionados entre folds, Ridge atende melhor ao requisito de estabilidade. Se manter sensores custa caro, um Elastic Net esparso e estável pode ser preferível.
- Teste. O pipeline escolhido é reajustado no desenvolvimento completo e medido uma vez no teste. Essa estimativa não volta para orientar nova busca.
- Relatório. Registre grade, folds, seed, métrica, coeficientes na escala padronizada, baseline e resultado do teste.
O “melhor” regularizador depende do objetivo, da estrutura de correlação e do custo dos erros. Não existe vencedor universal, e o laboratório a seguir mostra por quê.
10. Na prática: o laboratório da aula
O laboratório gera 420 observações sintéticas com estrutura conhecida. Cinco fatores latentes produzem as features: sinal_0 e sinal_1 são duas medições ruidosas do mesmo fator (correlação 0,993, primeira linha da saída), assim como sinal_2 e sinal_3; sinal_4 está multiplicada por 100 e sinal_5 dividida por 100; sinal_6 mede um fator que não entra na resposta; e 13 colunas são puro ruído, com escalas de 0,1 a 10. A resposta depende de quatro fatores, com ruído de desvio-padrão 2,8. O teste (25%) é separado antes de qualquer escolha. Os dados são sintéticos: demonstram mecanismos, não medem uma planta real.
import numpy as np
from sklearn.linear_model import ElasticNet, Lasso, LinearRegression, Ridge
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import KFold, cross_val_score, train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# 1) Dados sintéticos: 5 fatores latentes, pares quase duplicados, escalas x100 e /100, 13 colunas de ruído
SEED = 20260908
rng = np.random.default_rng(SEED)
n = 420
z = rng.normal(size=(n, 5))
sinais = np.column_stack([
    z[:, 0] + rng.normal(0, 0.08, n),
    z[:, 0] + rng.normal(0, 0.08, n),            # quase duplicada de sinal_0
    z[:, 1] + rng.normal(0, 0.12, n),
    z[:, 1] + rng.normal(0, 0.12, n),            # quase duplicada de sinal_2
    100 * (z[:, 2] + rng.normal(0, 0.10, n)),    # escala x100
    0.01 * (z[:, 3] + rng.normal(0, 0.10, n)),   # escala /100
    z[:, 4] + rng.normal(0, 0.15, n),            # fator sem efeito em y
])
ruido = rng.normal(size=(n, 13)) * np.logspace(-1, 1, 13)
X = np.column_stack([sinais, ruido])
y = 5.0 * z[:, 0] - 3.2 * z[:, 1] + 2.0 * z[:, 2] + 1.3 * z[:, 3] + rng.normal(0, 2.8, n)
print("correlação sinal_0 x sinal_1:", round(np.corrcoef(X[:, 0], X[:, 1])[0, 1], 3))

# 2) Teste separado ANTES de qualquer escolha; CV só no desenvolvimento
X_dev, X_test, y_dev, y_test = train_test_split(X, y, test_size=0.25, random_state=SEED)
cv = KFold(n_splits=5, shuffle=True, random_state=SEED)
alphas = np.logspace(-3, 2, 16)

def pipeline(nome, alpha=None):
    est = {"OLS": lambda: LinearRegression(),
           "Ridge": lambda: Ridge(alpha=alpha),
           "Lasso": lambda: Lasso(alpha=alpha, max_iter=100_000, tol=1e-7, random_state=SEED),
           "Elastic Net": lambda: ElasticNet(alpha=alpha, l1_ratio=0.5, max_iter=100_000,
                                             tol=1e-7, random_state=SEED)}[nome]()
    return make_pipeline(StandardScaler(), est)   # scaler reajustado dentro de cada fold

# 3) Grade de alpha com validação cruzada (RMSE médio nos 5 folds)
escolhido = {}
for nome in ["Ridge", "Lasso", "Elastic Net"]:
    rmse = [-cross_val_score(pipeline(nome, a), X_dev, y_dev, cv=cv,
                             scoring="neg_root_mean_squared_error").mean() for a in alphas]
    escolhido[nome] = alphas[int(np.argmin(rmse))]
    print(f"{nome:11s} alpha={escolhido[nome]:8.4f}  RMSE_cv={min(rmse):.3f}")

# 4) Reajuste no desenvolvimento completo e UMA avaliação no teste
print(f"{'Baseline':11s} RMSE_teste={mean_squared_error(y_test, np.full_like(y_test, y_dev.mean())) ** 0.5:.3f}")
modelos = {"OLS": pipeline("OLS"), **{k: pipeline(k, a) for k, a in escolhido.items()}}
for nome, m in modelos.items():
    m.fit(X_dev, y_dev)
    coef = m[-1].coef_
    print(f"{nome:11s} RMSE_teste={mean_squared_error(y_test, m.predict(X_test)) ** 0.5:.3f}"
          f"  ativos={int((np.abs(coef) > 1e-8).sum()):2d}/20"
          f"  sinal_0={coef[0]:6.3f}  sinal_1={coef[1]:6.3f}")
Saída real, com Python 3.13, NumPy 2.2, pandas 3.0 e scikit-learn 1.9:
correlação sinal_0 x sinal_1: 0.993
Ridge       alpha= 10.0000  RMSE_cv=2.931
Lasso       alpha=  0.0464  RMSE_cv=2.911
Elastic Net alpha=  0.1000  RMSE_cv=2.922
Baseline    RMSE_teste=6.485
OLS         RMSE_teste=3.052  ativos=20/20  sinal_0= 5.184  sinal_1=-0.397
Ridge       RMSE_teste=3.099  ativos=20/20  sinal_0= 2.785  sinal_1= 1.924
Lasso       RMSE_teste=3.035  ativos=16/20  sinal_0= 4.746  sinal_1= 0.000
Elastic Net RMSE_teste=3.092  ativos=17/20  sinal_0= 2.597  sinal_1= 2.026
Interpretação
Os três penalizados ficam praticamente empatados na validação cruzada: 2,911, 2,922 e 2,931, diferenças de 0,02 para erros-padrão de cerca de 0,13 a 0,14 entre folds (coluna erro_padrao do notebook e figura abaixo). No teste, todos cortam o RMSE do baseline (6,485) para pouco mais de 3. E OLS não perde: com 315 linhas para 20 colunas, há dados suficientes para que a variância extra de OLS custe pouco em erro de previsão. Neste problema, o ganho da regularização não está no RMSE. Está no que acontece com os coeficientes.
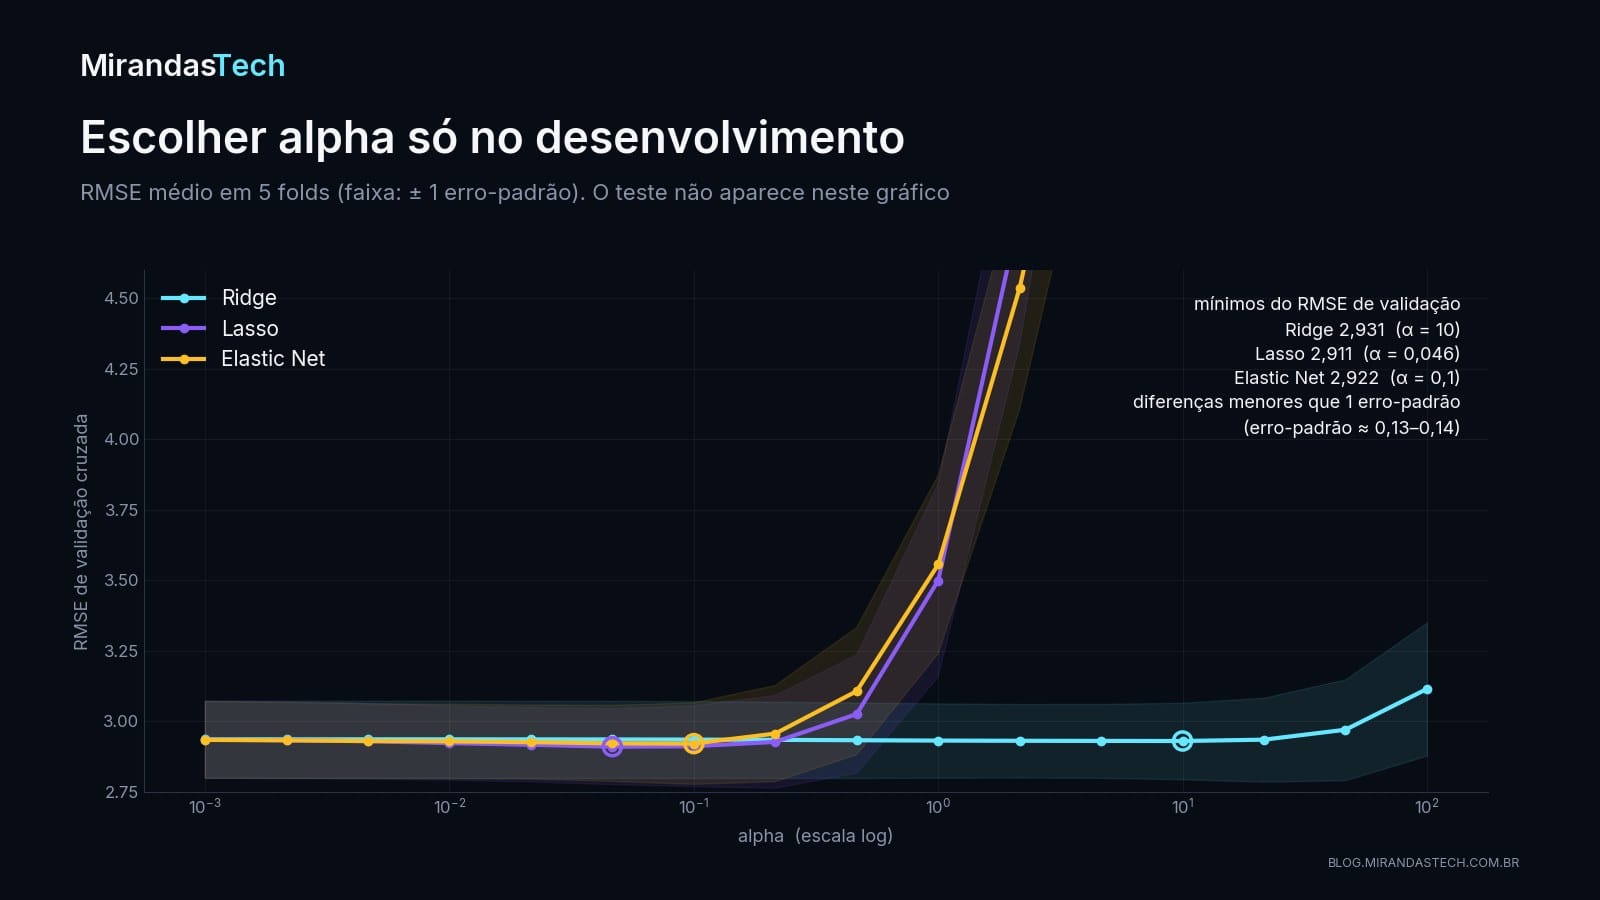
Olhe para a dupla sinal_0 e sinal_1, duas medições do mesmo fator. OLS dá 5,184 a uma e −0,397 à outra, um sinal negativo que não tem leitura física. Ridge divide em 2,785 e 1,924. O Lasso fica com sinal_0 (4,746) e zera sinal_1. O Elastic Net divide como o Ridge (2,597 e 2,026) e zera três colunas de ruído (próximo bloco). A soma das duas fica entre 4,6 e 4,8 em todos: o que muda é a história contada pelos coeficientes.
Repare também nos valores escolhidos de alpha. O 10 do Ridge e o 0,046 do Lasso não são comparáveis, pelo motivo da seção 2: o Ridge do scikit-learn não divide a perda por $n$. Com as 315 linhas do desenvolvimento, Ridge(alpha=10) corresponde a $\alpha=10/315\approx0{,}032$ na forma normalizada; durante a validação cruzada, cada fold treina em 252 linhas, e o mesmo Ridge(alpha=10) equivale a $10/252\approx0{,}040$. A força normalizada do Ridge muda com $n$, mais um motivo para não comparar valores de alpha.
Quatro contraprovas fecham o laboratório. O bloco abaixo continua do anterior:
# continua do bloco anterior (X_dev, X_test, y_dev, modelos, escolhido, pipeline, SEED, np)
from sklearn.base import clone

nomes = [f"sinal_{i}" for i in range(7)] + [f"ruido_{i}" for i in range(13)]
for nome in ["Lasso", "Elastic Net"]:
    print(f"{nome} zerou:", [nomes[j] for j in np.flatnonzero(np.abs(modelos[nome][-1].coef_) <= 1e-8)])

# a) Troca de unidade: sinal_0 numa unidade 1.000 vezes menor (valores x1000)
Xa, Xb = X_dev.copy(), X_test.copy()
Xa[:, 0] *= 1_000; Xb[:, 0] *= 1_000
for rotulo, prot in [("sem scaler", Ridge(alpha=10.0)),
                     ("com scaler", pipeline("Ridge", 10.0))]:
    p1 = clone(prot).fit(X_dev, y_dev).predict(X_test)
    p2 = clone(prot).fit(Xa, y_dev).predict(Xb)
    print(f"Ridge {rotulo}: previsões mudam até {np.abs(p1 - p2).max():.3g}")

# b) Estabilidade: 160 reamostragens bootstrap do desenvolvimento
rng_boot = np.random.default_rng(SEED + 1)
coefs = {"OLS": [], "Ridge(alpha=10)": [], "Lasso": []}
protos = {"OLS": pipeline("OLS"), "Ridge(alpha=10)": pipeline("Ridge", 10.0),
          "Lasso": pipeline("Lasso", escolhido["Lasso"])}
for _ in range(160):
    idx = rng_boot.integers(0, len(X_dev), len(X_dev))
    for nome, prot in protos.items():
        coefs[nome].append(clone(prot).fit(X_dev[idx], y_dev[idx])[-1].coef_)
coefs = {k: np.asarray(v) for k, v in coefs.items()}
dp = {k: v.std(axis=0, ddof=1).mean() for k, v in coefs.items() if k != "Lasso"}
print(f"desvio-padrão médio dos coeficientes: OLS {dp['OLS']:.3f} | Ridge {dp['Ridge(alpha=10)']:.3f}"
      f" | razão {dp['OLS'] / dp['Ridge(alpha=10)']:.2f}x")
L = np.abs(coefs["Lasso"][:, :2]) > 1e-8
print("Lasso, em 160 reamostragens: só sinal_0", int((L[:, 0] & ~L[:, 1]).sum()),
      "| só sinal_1", int((~L[:, 0] & L[:, 1]).sum()), "| ambos", int((L[:, 0] & L[:, 1]).sum()))
Lasso zerou: ['sinal_1', 'ruido_1', 'ruido_3', 'ruido_11']
Elastic Net zerou: ['ruido_1', 'ruido_3', 'ruido_11']
Ridge sem scaler: previsões mudam até 0.562
Ridge com scaler: previsões mudam até 3.55e-15
desvio-padrão médio dos coeficientes: OLS 0.380 | Ridge 0.184 | razão 2.06x
Lasso, em 160 reamostragens: só sinal_0 103 | só sinal_1 0 | ambos 57
As duas primeiras linhas mostram que esparsidade não é recuperar a estrutura verdadeira. O Lasso zerou sinal_1, que carrega sinal (é o mesmo fator de sinal_0), e só 3 das 13 colunas de ruído; manteve 10 colunas de ruído e sinal_6, cujo fator não entra na resposta. O Elastic Net zerou as mesmas três colunas de ruído e preservou a dupla. Na troca de unidade, Ridge sem scaler muda as previsões em até 0,56, enquanto o pipeline com scaler as mantém idênticas até $10^{-15}$.
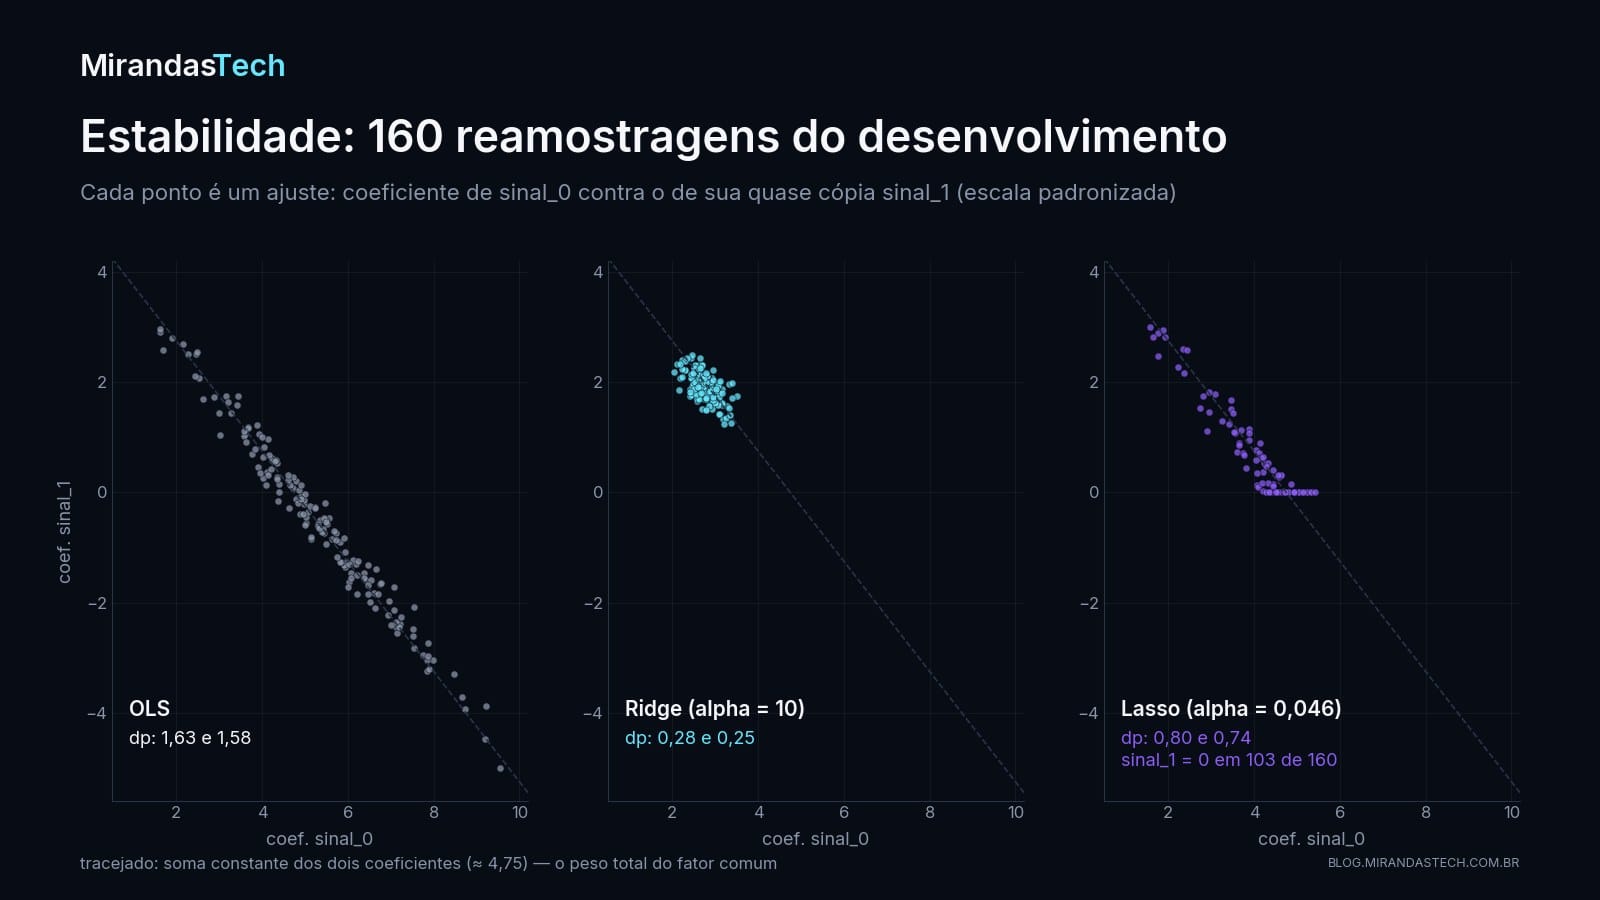
A estabilidade é a contraprova mais eloquente. Em 160 reamostragens bootstrap, o desvio-padrão médio dos coeficientes de OLS é 2,06 vezes o de Ridge. O peso total da dupla fica quase constante, mas OLS o desliza de uma coluna para a outra a cada amostra. E o Lasso não decide de forma estável: mantém só sinal_0 em 103 reamostragens e as duas em 57. A pergunta “qual sensor importa?” não tem resposta firme nesses dados, e um único ajuste do Lasso esconderia isso.
O notebook completo traz ainda as curvas de validação, os caminhos de coeficientes, a tabela de RMSE, MAE e $R^2$ no teste e asserts que conferem cada propriedade metodológica e numérica. A seed é 20260908, e as dependências mínimas são Python 3.10, NumPy 1.24, pandas 2.0, Matplotlib 3.7 e scikit-learn 1.4.
11. Armadilhas e erros comuns
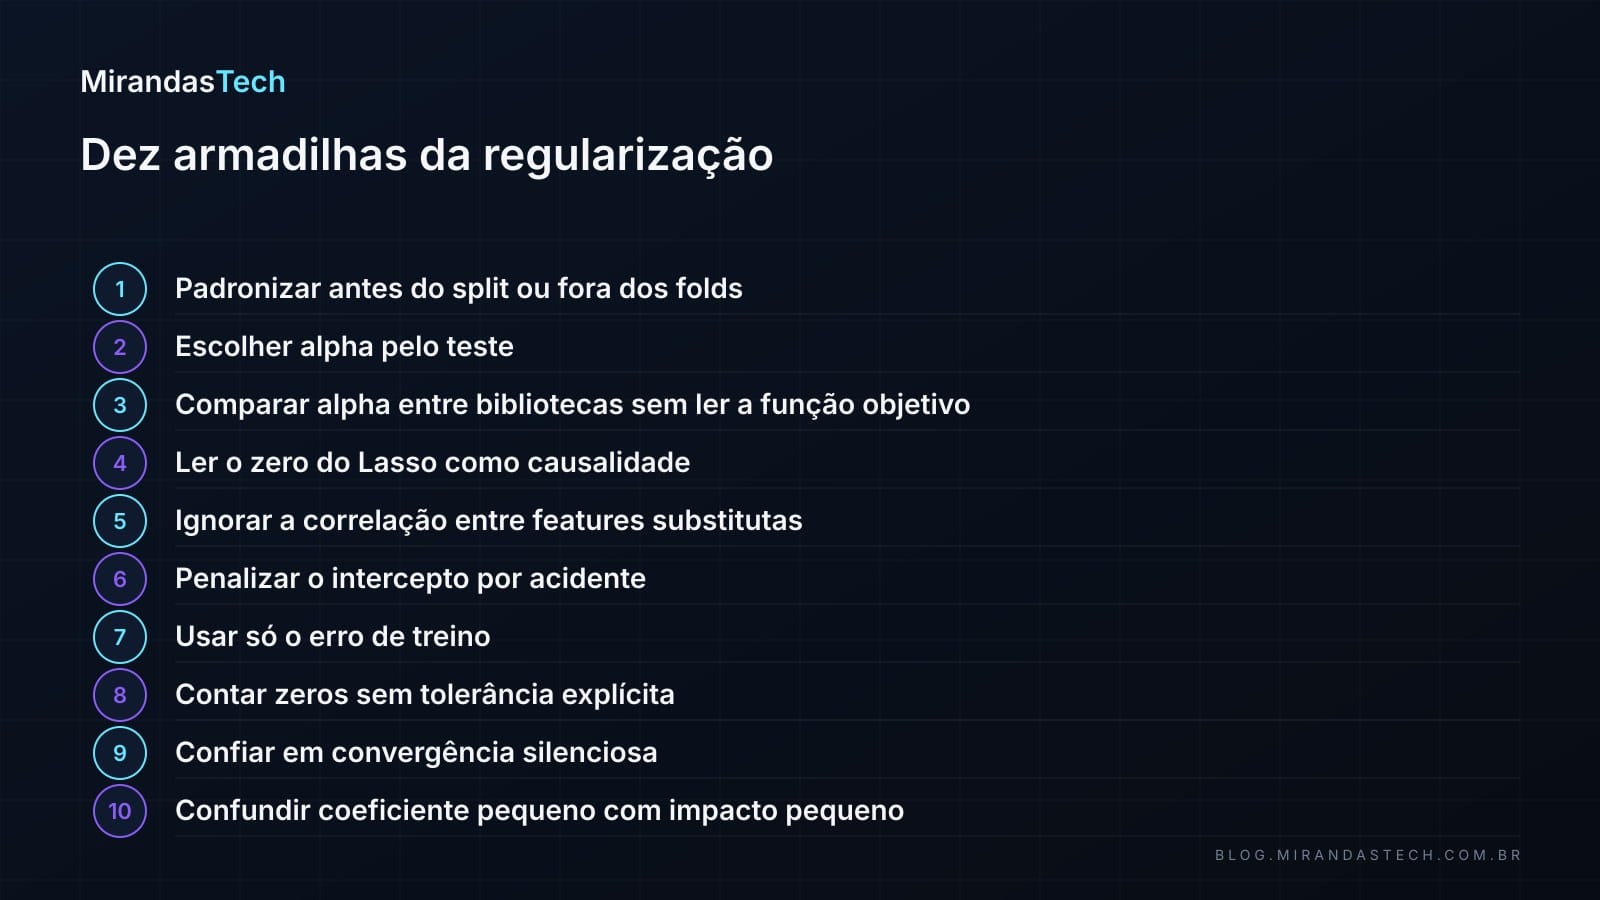
- Padronizar antes do split ou fora dos folds. O scaler aprende estatísticas que não deveria conhecer.
- Escolher
alphapelo teste. O teste deixa de ser uma estimativa final honesta. - Comparar
alphaentre bibliotecas sem conferir a função objetivo. Fatores de escala mudam o significado numérico, até dentro da mesma biblioteca, como entreRidgeeLasso. - Interpretar o zero do Lasso como causalidade. Seleção preditiva não identifica efeitos causais.
- Ignorar correlação. O Lasso pode trocar arbitrariamente uma feature por outra substituta.
- Penalizar o intercepto por acidente. Isso desloca o nível médio sem justificativa.
- Usar apenas erro de treino. A regularização é escolhida por generalização, não por ajuste aparente.
- Declarar esparsidade com igualdade de ponto flutuante. Use uma tolerância explícita, por exemplo $|\beta_j|>10^{-8}$, como no laboratório.
- Confiar em convergência silenciosa. Aumente
max_iter, inspecione avisos e confiradual_gap_quando aplicável. - Confundir coeficiente pequeno com impacto pequeno. Escala, distribuição da feature e interações importam.
12. Checklist prático
- Separei o teste antes da busca?
- Minha divisão respeita tempo, grupos e unidade de análise?
- Todo o pré-processamento está dentro do pipeline?
- A grade cobre várias ordens de grandeza, e o melhor
alphanão ficou preso à borda? - A métrica foi escolhida antes de olhar os resultados?
- Registrei a convenção da função objetivo e a versão da biblioteca?
- Comparei contra baseline e OLS?
- Analisei estabilidade, correlação e caminho dos coeficientes?
- Avaliei o teste apenas uma vez?
- Evitei interpretações causais indevidas?
13. Onde isso aparece em IA aplicada
A mesma ideia atravessa a IA moderna. O exemplo mais direto é o weight decay no treino de redes neurais: a cada passo, os pesos são encolhidos um pouco na direção de zero. Ele se relaciona à penalização $L_2$, mas só sob condições específicas. Loshchilov e Hutter (2019) mostraram que $L_2$ e weight decay são equivalentes para o gradiente descendente estocástico padrão (com a constante reescalada pela taxa de aprendizado), mas não para otimizadores adaptativos como o Adam. Muitas implementações chamavam de weight decay o que era $L_2$, e os autores propuseram desacoplar o decaimento do passo do gradiente, o que melhorou a generalização do Adam nos experimentos deles.
A lição é a mesma da seção 2, em outra escala: o nome do hiperparâmetro não garante o que ele faz. Antes de comparar ou transferir um valor, confira a função objetivo e o otimizador. Equivalências não devem ser assumidas sem olhar a implementação.
A esparsidade também reaparece. Modelos com poucos componentes ativos custam menos para medir, armazenar e explicar, e a pergunta de estabilidade da seção 10 continua valendo: um conjunto de features, de neurônios ou de atributos “selecionados” só merece confiança se sobreviver a reamostragens. Por fim, toda regularização expressa uma preferência sobre soluções antes de ver o teste. Em modelos grandes, essas preferências estão espalhadas pela arquitetura, pelos dados e pelo otimizador; nos modelos lineares, elas cabem numa linha da função objetivo, o que os torna o melhor lugar para aprender a pensar nelas.
Próximo passo
O próximo artigo da série passa para a regressão logística e a classificação probabilística. A regularização continua presente, agora aplicada a uma perda de classificação baseada em log-verossimilhança. O foco novo será transformar uma combinação linear em probabilidade, interpretar log-odds e separar probabilidade estimada de decisão por limiar.
Referências
- scikit-learn developers. Linear Models (seções 1.1.2 Ridge, 1.1.3 Lasso e 1.1.5 Elastic-Net). Documentação oficial do scikit-learn 1.9 (acesso em 2 out. 2026), 2026. scikit-learn.org/stable/modules/linear_model.html
- Hoerl, Arthur E.; Kennard, Robert W. Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 12(1), p. 55–67, 1970. doi.org/10.1080/00401706.1970.10488634
- Tibshirani, Robert. Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), p. 267–288, 1996. doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Friedman, Jerome; Hastie, Trevor; Tibshirani, Robert. Regularization Paths for Generalized Linear Models via Coordinate Descent. Journal of Statistical Software, 33(1), p. 1–22, 2010. doi.org/10.18637/jss.v033.i01
- Zou, Hui; Hastie, Trevor. Regularization and Variable Selection via the Elastic Net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), p. 301–320, 2005. doi.org/10.1111/j.1467-9868.2005.00503.x
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer Series in Statistics, Springer, 2ª ed. (§7.10, p. 244), 2009. doi.org/10.1007/978-0-387-84858-7
- Meinshausen, Nicolai; Bühlmann, Peter. Stability Selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(4), p. 417–473, 2010. doi.org/10.1111/j.1467-9868.2010.00740.x
- Loshchilov, Ilya; Hutter, Frank. Decoupled Weight Decay Regularization. International Conference on Learning Representations (ICLR 2019). arXiv:1711.05101, 2019. arxiv.org/abs/1711.05101

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/05-regularizacao-ridge-lasso-elastic-net.md.



