
Probabilidade para IA: incerteza, eventos e axiomas de Kolmogorov
Construir um modelo probabilístico coerente para representar incerteza e usar eventos e axiomas sem depender de fórmulas decoradas.

Construir um modelo probabilístico coerente para representar incerteza e usar eventos e axiomas sem depender de fórmulas decoradas. Pré-requisitos: aritmética básica, noção de conjuntos e leitura de gráficos. Tempo sugerido: 3 a 4 horas, com o laboratório e os exercícios.
Um sistema antifraude recebe uma transação de cartão e devolve três números:
normal       0,72
suspeita     0,21
fraude       0,07
Quem opera o sistema precisa decidir: aprova, bloqueia ou manda para revisão manual? Os números parecem fáceis de ler, mas cada um deles esconde uma pergunta. As três categorias cobrem tudo o que pode acontecer com a transação? Elas se excluem mutuamente? Os valores somam 1 por construção ou por coincidência? O 0,07 é uma probabilidade de fraude ou apenas um score que o modelo produziu? E o evento que interessa à decisão é “fraude” ou “suspeita ou fraude”?
Nenhuma dessas perguntas é sobre o algoritmo. Todas são sobre a linguagem que usamos para descrever resultados possíveis, agrupar os que interessam e atribuir medidas coerentes a esses grupos. Essa linguagem é a teoria da probabilidade, e é por ela que começa a série de Probabilidade, Estatística e Teoria da Informação do AI Lab: 24 aulas que vão da incerteza básica até entropia e divergência, sempre com a pergunta “onde isso aparece em um modelo de IA?” no horizonte. Na trilha de Matemática, o primeiro passo foi transformar o mundo em números; aqui, o passo seguinte é lidar com o fato de que esses números carregam incerteza.
Ao final, você vai conseguir transformar uma situação real em experimento, espaço amostral e eventos; traduzir “ou”, “e” e “não” para operações com conjuntos; enunciar os três axiomas de Kolmogorov e deduzir deles as regras do complemento e da união; reconhecer quando “casos favoráveis sobre casos possíveis” pode ser usado; distinguir a probabilidade do modelo da frequência observada em uma simulação reproduzível; e explicar por que tudo isso está por trás de um softmax.
1. Por que começar pela incerteza?
Probabilidade não elimina a incerteza. O que ela oferece é um caminho disciplinado para trabalhar com ela: declarar o que está sendo considerado possível, quantificar a incerteza sob um modelo explícito, combinar eventos sem produzir contradições, comparar previsões com observações e escolher ações levando em conta custos e riscos.
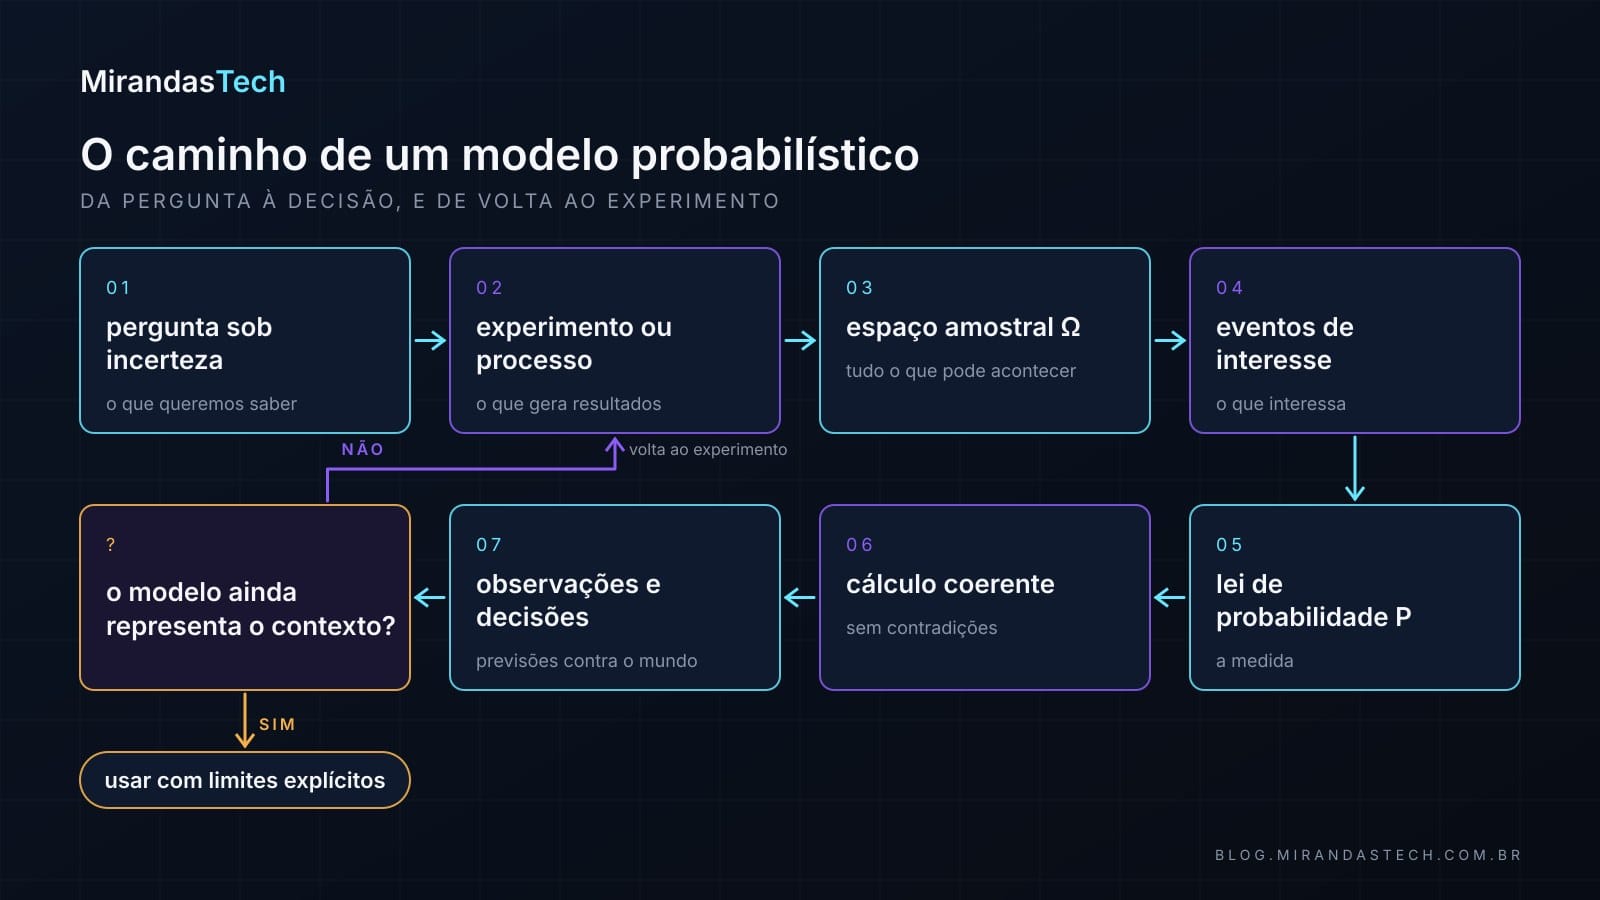
Esse caminho tem uma ordem. Primeiro existe uma pergunta sob incerteza; depois, um experimento ou processo que gera resultados; desses resultados se define o espaço amostral; dentro dele, os eventos de interesse; sobre os eventos, uma lei de probabilidade; só então vem o cálculo, as observações e as decisões. E o ciclo se fecha com uma pergunta que raramente aparece nos livros: o modelo ainda representa o contexto? Se não, volta-se ao experimento.
Um número entre 0 e 1 não vira probabilidade apenas por estar nessa escala. A interpretação depende do modelo, dos dados e de como o número foi produzido e validado.
O restante do artigo constrói essa cadeia peça por peça, começando pelo vocabulário.
2. O vocabulário que sustenta todo o módulo
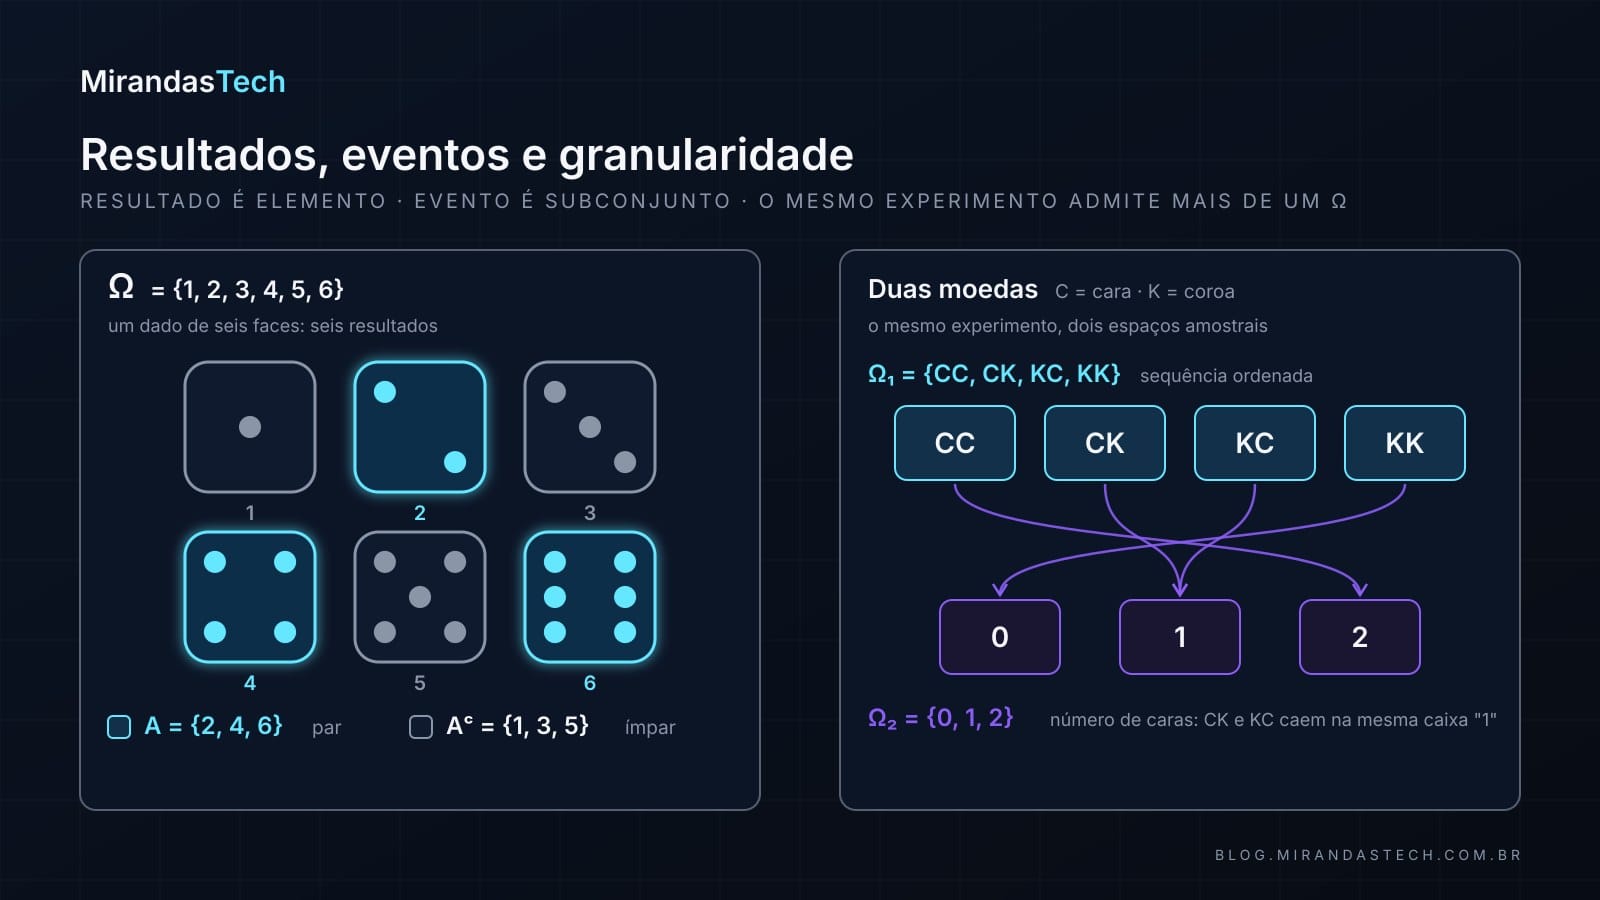
O exemplo mais simples é o lançamento de um dado comum de seis faces. Ele é pequeno o bastante para enumerar tudo e rico o bastante para mostrar cada conceito.
| Conceito | Símbolo | Significado | Exemplo |
|---|---|---|---|
| Experimento aleatório | — | Processo cujo resultado não se conhece antes de executar | Lançar o dado uma vez |
| Resultado elementar | $\omega$ | Um resultado individual possível | Obter a face 4 |
| Espaço amostral | $\Omega$ | Conjunto de todos os resultados considerados possíveis | $\{1,2,3,4,5,6\}$ |
| Evento | $A$ | Conjunto de resultados com uma propriedade de interesse | “resultado par” $=\{2,4,6\}$ |
| Lei de probabilidade | $P$ | Regra que atribui uma probabilidade a cada evento permitido | $P(A)=3/6$ para um dado justo |
O ponto mais importante da tabela cabe em uma linha:
$$ \text{resultado }\omega\in\Omega, \qquad \text{evento }A\subseteq\Omega. $$
Um resultado é um elemento do espaço amostral; um evento é um subconjunto dele. Confundir os dois é o erro mais comum de quem começa, e ele se manifesta em frases como “a probabilidade do 4 ou do par”, que misturam um elemento com um conjunto.
Alguns eventos recebem nomes próprios. Um evento simples contém um único resultado, como $\{4\}$. Um evento composto reúne vários, como “obter número par”, $\{2,4,6\}$. O evento certo é o próprio $\Omega$, e o evento impossível é o conjunto vazio, $\varnothing$.
O espaço amostral depende da pergunta
Ao lançar duas moedas, podemos registrar a ordem em que os resultados aparecem:
$$ \Omega_1=\{CC,CK,KC,KK\}, $$
onde $C$ significa cara e $K$, coroa. Se a pergunta for apenas “quantas caras saíram?”, outro espaço serve:
$$ \Omega_2=\{0,1,2\}. $$
Os dois modelos descrevem o mesmo procedimento em granularidades diferentes. A diferença não é cosmética: em $\Omega_2$, os três resultados não são equiprováveis, porque “uma cara” pode ocorrer como $CK$ ou como $KC$, enquanto “duas caras” só ocorre como $CC$. Quem assume que os três resultados de $\Omega_2$ têm a mesma chance já errou antes de fazer qualquer conta.
Definir $\Omega$ não é burocracia. Uma representação inadequada pode apagar informação ou induzir a suposição errada de que todos os resultados têm a mesma chance.
3. Eventos são conjuntos: aprenda a traduzir frases
Se evento é conjunto, então “ou”, “e” e “não” são operações entre conjuntos. Ainda no dado de seis faces, defina dois eventos:
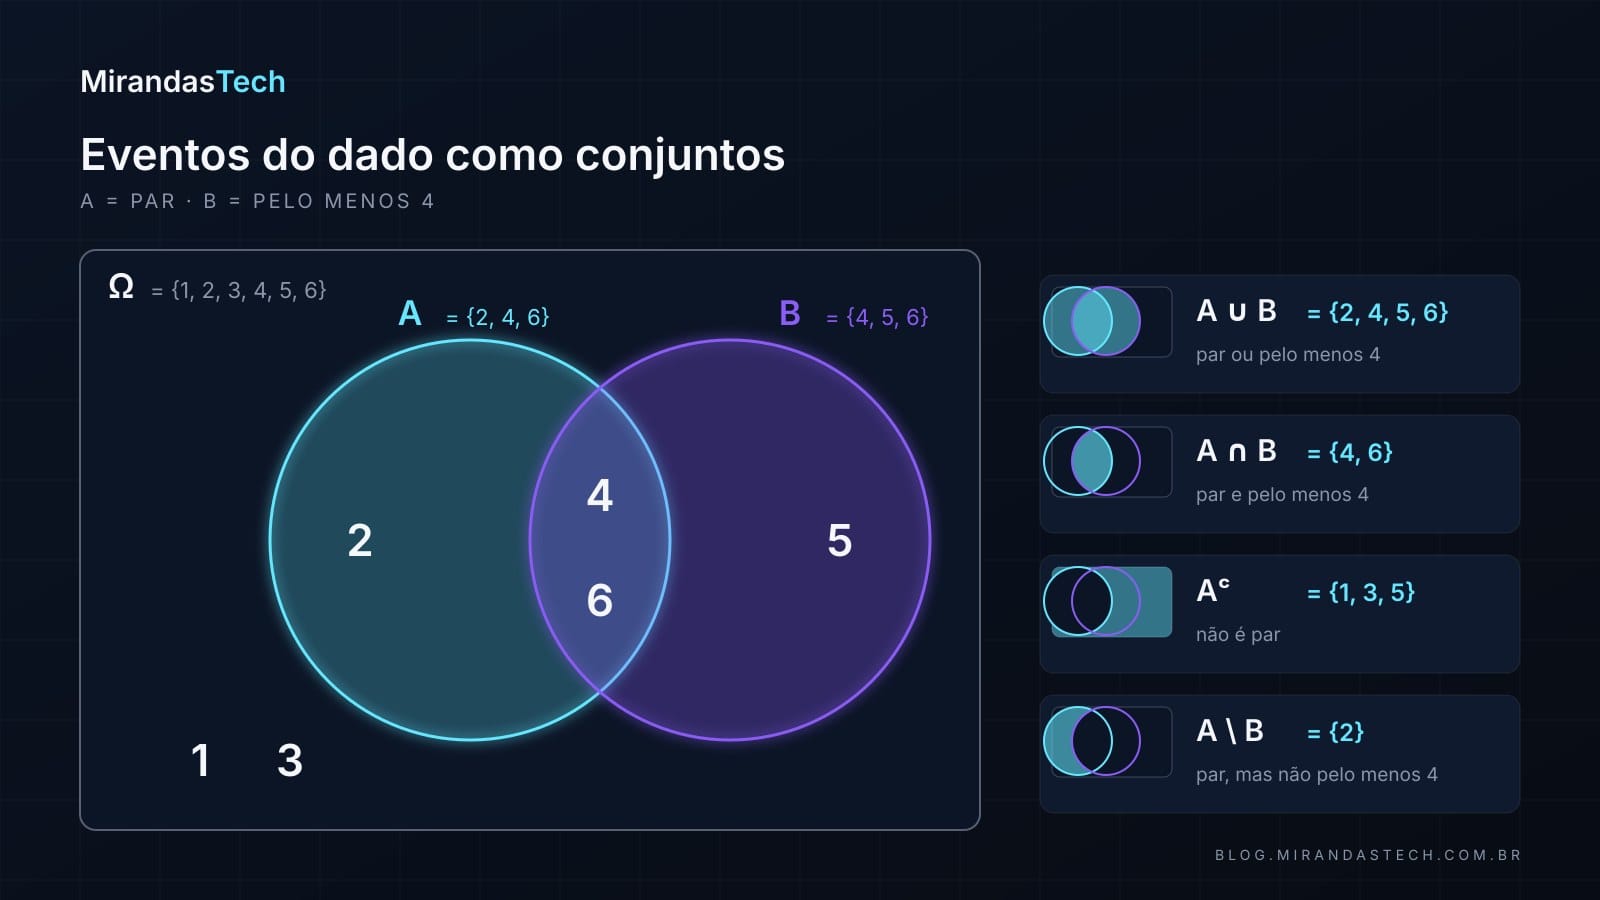
$$ A=\{2,4,6\}\quad\text{(resultado par)} $$
e
$$ B=\{4,5,6\}\quad\text{(resultado pelo menos 4)}. $$
| Linguagem comum | Operação | Resultado no exemplo |
|---|---|---|
| “A ou B”, incluindo a possibilidade de ambos | $A\cup B$ | $\{2,4,5,6\}$ |
| “A e B” | $A\cap B$ | $\{4,6\}$ |
| “não A” | $A^c$ | $\{1,3,5\}$ |
| “A, mas não B” | $A\setminus B$ | $\{2\}$ |
| A e B não podem ocorrer juntos | $A\cap B=\varnothing$ | eventos disjuntos |
Um detalhe que atrapalha quem vem da linguagem cotidiana: na probabilidade, o “ou” normalmente é inclusivo. $A\cup B$ contém os resultados que estão em $A$, em $B$ ou em ambos. É exatamente o caso do sistema antifraude da abertura: “suspeita ou fraude” é a união das duas classes.
Leis de De Morgan
Duas identidades evitam muitos erros ao negar frases compostas:
$$ (A\cup B)^c=A^c\cap B^c $$
e
$$ (A\cap B)^c=A^c\cup B^c. $$
Em palavras: “não ocorreu A nem B” significa “não A e não B”; “não ocorreram A e B simultaneamente” significa “não A ou não B”. A negação troca união por interseção, e vice-versa.
Com isso, resolver um problema de eventos vira um procedimento com ordem fixa: pegue a frase do problema, defina $\Omega$, liste os eventos $A$, $B$, …, traduza os “ou/e/não” em operações, simplifique os conjuntos e só então calcule $P$. A maioria dos erros vem de pular direto para o último passo.
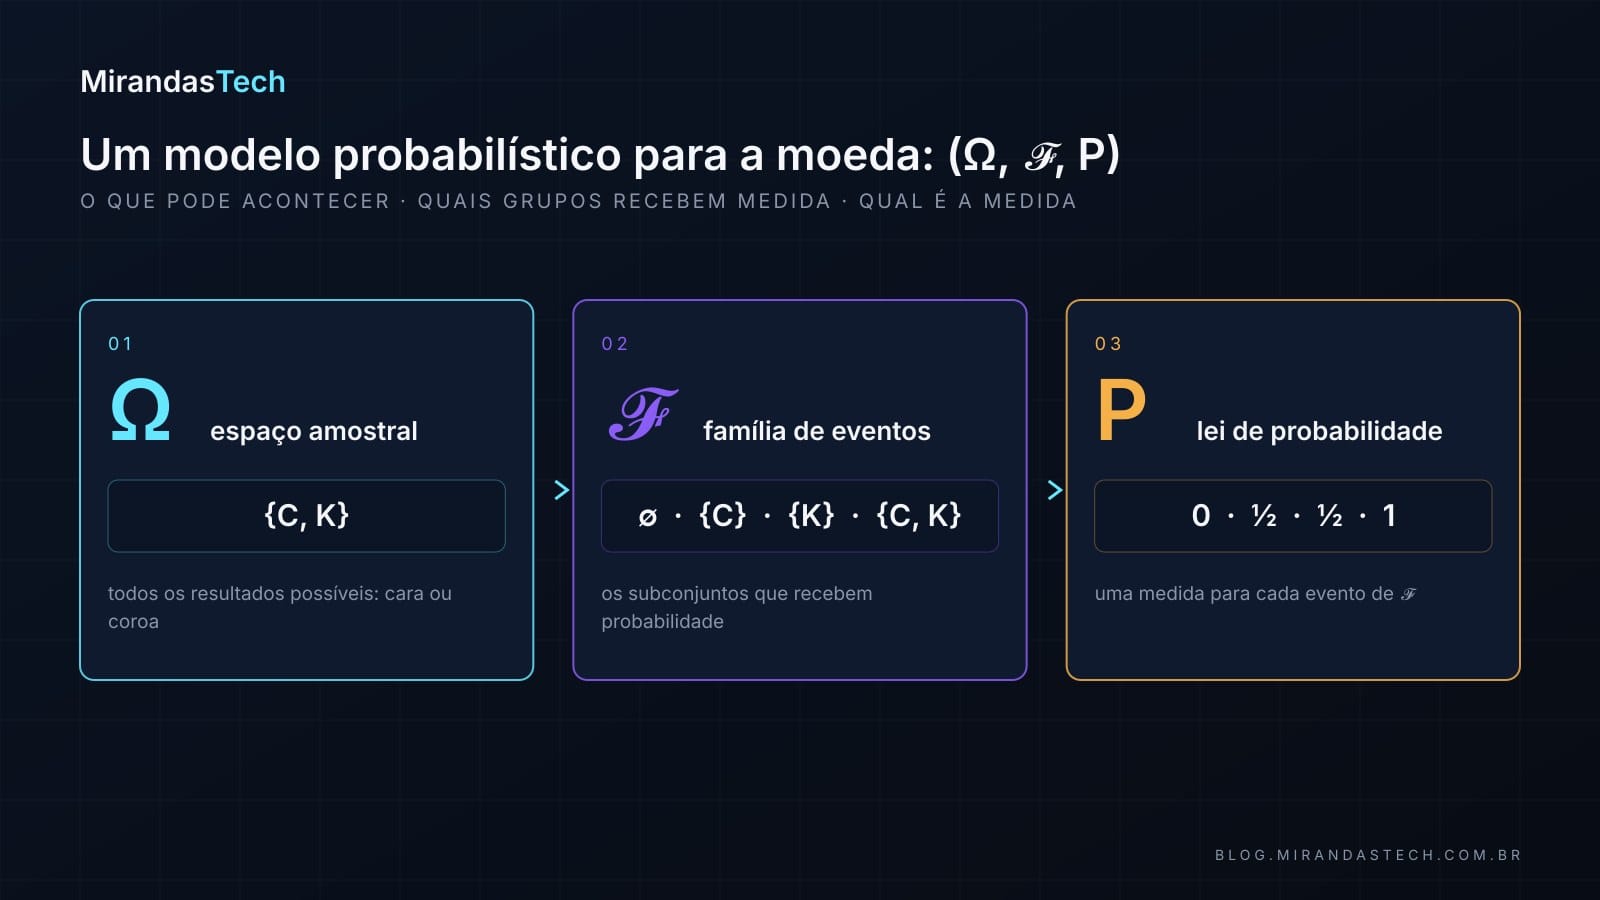
4. O modelo probabilístico: (Ω, 𝓕, P)
Com o vocabulário no lugar, podemos dar nome ao objeto completo. Um modelo probabilístico é representado pela tríade
$$ (\Omega,\mathcal F,P), $$
em que $\Omega$ é o espaço amostral, $\mathcal F$ é a coleção de eventos aos quais podemos atribuir probabilidade, e $P$ é a lei, ou medida, de probabilidade.
Nos espaços finitos deste artigo, podemos usar $\mathcal F=2^\Omega$, o conjunto de todos os subconjuntos de $\Omega$. Para uma moeda, com $\Omega=\{C,K\}$:
$$ \mathcal F=\{\varnothing,\{C\},\{K\},\{C,K\}\}. $$
Quatro eventos: o impossível, cara, coroa e o certo. Cada um deles recebe uma probabilidade de $P$.
Modelo não é o fenômeno
A tríade registra escolhas de quem modela: quais resultados serão distinguidos, quais hipóteses serão assumidas, que probabilidades serão atribuídas e em que população, período e condição operacional a interpretação vale. Uma moeda física, por exemplo, não é “justa” por definição. Usar $P(C)=P(K)=1/2$ é uma hipótese sobre o mecanismo e sobre as condições do lançamento, não uma propriedade que a moeda carrega consigo.
5. Os três axiomas de Kolmogorov
O que faz de $P$ uma lei de probabilidade, e não uma função qualquer? Três exigências, formalizadas por Kolmogorov (1933) e hoje apresentadas nesta forma compacta; Shafer e Vovk (2006) contam de onde ele tirou cada peça. Para qualquer evento $A\in\mathcal F$:
Axioma 1 — não negatividade
$$ P(A)\geq 0. $$
Probabilidade negativa não pertence ao modelo probabilístico clássico.
Axioma 2 — normalização
$$ P(\Omega)=1. $$
Algum resultado previsto pelo espaço amostral deve ocorrer. É a exigência que faz os três scores da abertura precisarem somar 1, se forem tratados como probabilidades.
Axioma 3 — aditividade enumerável
Se $A_1,A_2,\ldots$ são eventos dois a dois disjuntos, então
$$ P\!\left(\bigcup_{i=1}^{\infty}A_i\right) =\sum_{i=1}^{\infty}P(A_i). $$
Em um caso finito com dois eventos, se $A\cap B=\varnothing$:
$$ P(A\cup B)=P(A)+P(B). $$
A probabilidade de eventos que não se sobrepõem se soma. Os axiomas são poucos, mas impõem toda a coerência básica do cálculo. Repare no que eles não fazem: não dizem qual probabilidade atribuir a cada fenômeno. Dizem apenas quais propriedades uma atribuição deve respeitar. O conteúdo vem do modelo; a coerência vem dos axiomas.
6. Consequências que você não precisa decorar
As regras que costumam ser memorizadas em cursos introdutórios são todas dedutíveis dos três axiomas. Vale ver as deduções uma vez, porque elas mostram que não há nada além dos axiomas sustentando o cálculo.
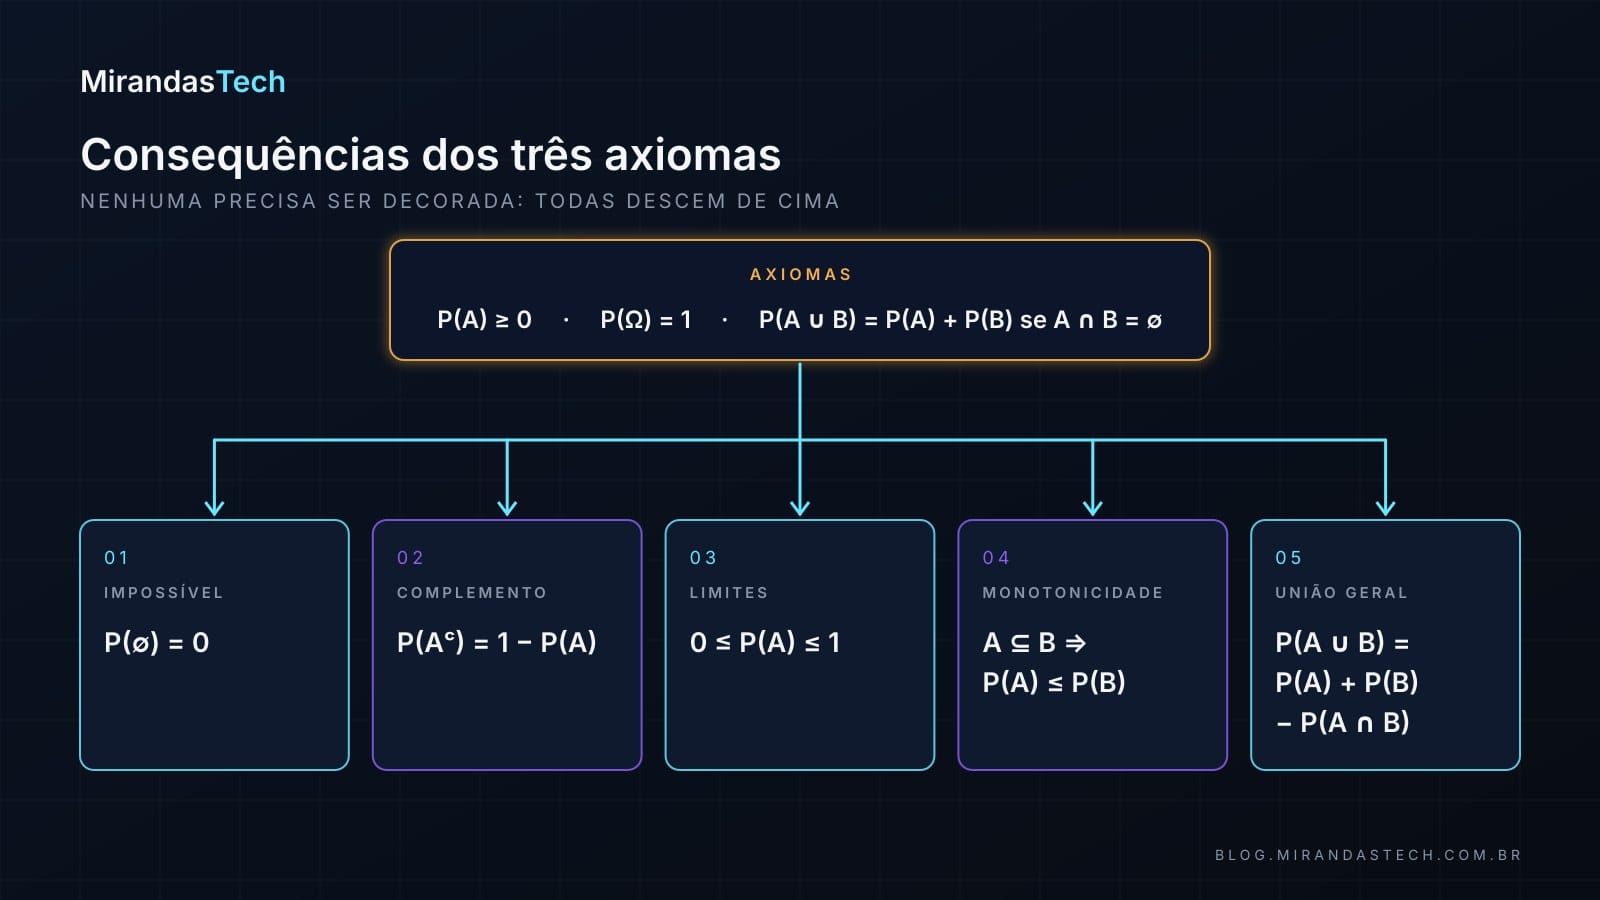
6.1 O evento impossível tem probabilidade zero
Como $\Omega$ e $\varnothing$ são disjuntos e $\Omega\cup\varnothing=\Omega$, o Axioma 3 dá:
$$ P(\Omega)=P(\Omega)+P(\varnothing). $$
Logo,
$$ P(\varnothing)=0. $$
6.2 Regra do complemento
$A$ e $A^c$ são disjuntos e juntos formam $\Omega$:
$$ P(A)+P(A^c)=P(\Omega)=1. $$
Portanto,
$$ P(A^c)=1-P(A). $$
É a regra que permite calcular “pelo menos uma fraude” a partir de “nenhuma fraude”, quase sempre mais fácil.
6.3 Toda probabilidade está entre 0 e 1
O primeiro axioma garante $P(A)\geq0$. Como $P(A^c)\geq0$ e $P(A)=1-P(A^c)$:
$$ 0\leq P(A)\leq1. $$
Repare que o limite superior não é um axioma: ele decorre da normalização combinada com a não negatividade do complemento.
6.4 Monotonicidade
Se $A\subseteq B$, então $B=A\cup(B\setminus A)$, uma união disjunta. Assim:
$$ P(B)=P(A)+P(B\setminus A)\geq P(A). $$
Um evento contido em outro não pode ter probabilidade maior que o evento mais abrangente.
6.5 Regra geral da união
Quando $A$ e $B$ podem se sobrepor, somar $P(A)+P(B)$ conta a interseção duas vezes. Corrigimos subtraindo-a uma vez:
$$ P(A\cup B)=P(A)+P(B)-P(A\cap B). $$
Essa identidade vale para quaisquer dois eventos. A soma simples do Axioma 3 é apenas o caso especial em que $A\cap B=\varnothing$.
7. Exemplo resolvido: eventos que se sobrepõem
De volta ao dado justo, com os mesmos dois eventos:
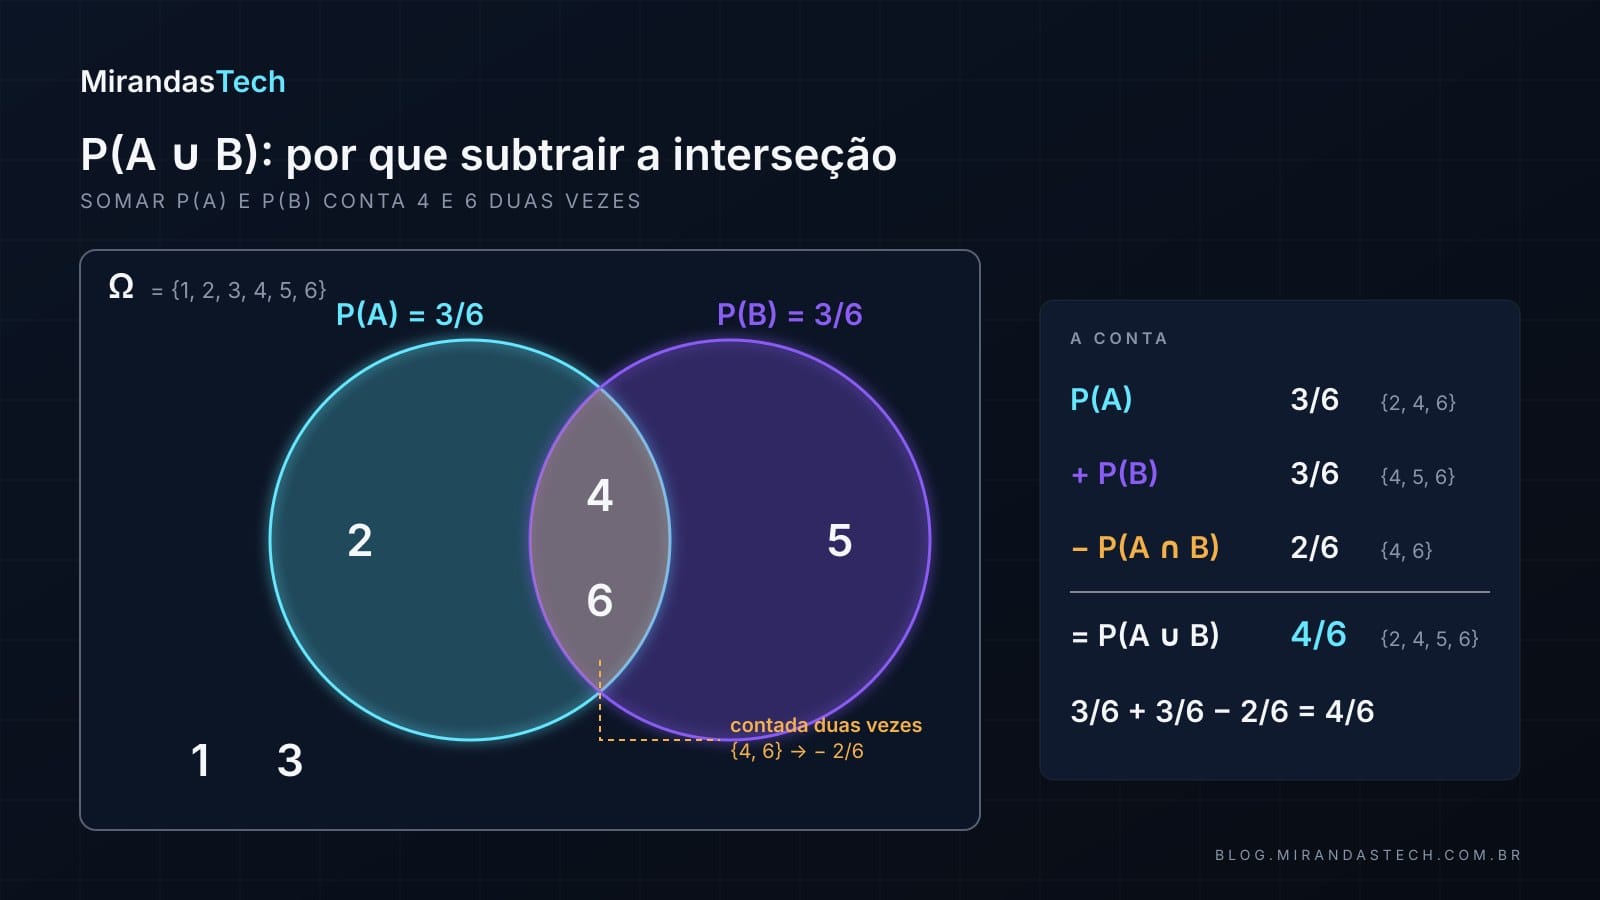
$$ \begin{gathered} \Omega=\{1,2,3,4,5,6\},\\ A=\{2,4,6\},\qquad B=\{4,5,6\}. \end{gathered} $$
Como as seis faces são assumidas equiprováveis:
$$ P(A)=\tfrac{3}{6},\quad P(B)=\tfrac{3}{6},\quad P(A\cap B)=\tfrac{2}{6}. $$
Logo:
$$ P(A\cup B)=\frac{3}{6}+\frac{3}{6}-\frac{2}{6} =\frac{4}{6}=\frac{2}{3}. $$
Conferindo diretamente, $A\cup B=\{2,4,5,6\}$ realmente possui quatro das seis faces. O erro típico seria escrever $3/6+3/6=1$, o que afirmaria que “par ou pelo menos 4” é um evento certo. Essa soma contou as faces 4 e 6 duas vezes.
8. “Casos favoráveis sobre casos possíveis” tem condição
No exemplo anterior, calculamos probabilidades contando faces. Isso funcionou porque assumimos o dado justo. Para um espaço finito e equiprovável:
$$ P(A)=\frac{|A|}{|\Omega|}. $$
Aqui $|A|$ é o número de resultados em $A$ e $|\Omega|$ é o número total de resultados. Essa fórmula não é a definição universal de probabilidade. Ela é uma consequência dos axiomas quando cada resultado elementar possui a mesma probabilidade, e só então.
Considere uma moeda enviesada com
$$ P(C)=0{,}7,\qquad P(K)=0{,}3. $$
O evento $\{C\}$ contém um de dois resultados, mas sua probabilidade é $0{,}7$, não $1/2$. A contagem “um caso favorável em dois possíveis” daria a resposta errada porque a hipótese de equiprobabilidade não vale.
Sempre que aparecer contagem, quatro perguntas revelam a suposição escondida: os resultados elementares foram definidos na mesma granularidade? Existe justificativa para tratá-los como equiprováveis? O mecanismo pode favorecer alguns resultados? Os dados empíricos são compatíveis com a hipótese adotada? A Aula 02 vai aprofundar as técnicas de contagem; aqui, o objetivo é saber quando a contagem pode ser convertida em probabilidade.
9. Probabilidade teórica e frequência empírica
A última pergunta da seção anterior, sobre compatibilidade com os dados, exige separar dois objetos que costumam ser confundidos. Se um evento $A$ ocorre $N_A(n)$ vezes em $n$ repetições, sua frequência relativa é
$$ \widehat p_n=\frac{N_A(n)}{n}. $$
$P(A)$ pertence ao modelo; $\widehat p_n$ é calculada a partir dos dados observados. Elas não são a mesma coisa.
| Objeto | Origem | Muda ao repetir o experimento? |
|---|---|---|
| $P(A)$ | Lei probabilística assumida ou estimada | Não, enquanto o modelo for mantido |
| $\widehat p_n$ | Amostra observada | Sim |
Com poucas repetições, a frequência pode ficar longe da probabilidade teórica. Com muitas repetições sob condições adequadas, ela tende a se estabilizar perto do valor esperado. A figura abaixo mostra isso para uma moeda com $P(C)=0{,}62$ simulada 50 000 vezes: nos primeiros lançamentos a frequência oscila entre 0 e 0,5; depois de mil, ela já não sai de perto da linha tracejada.
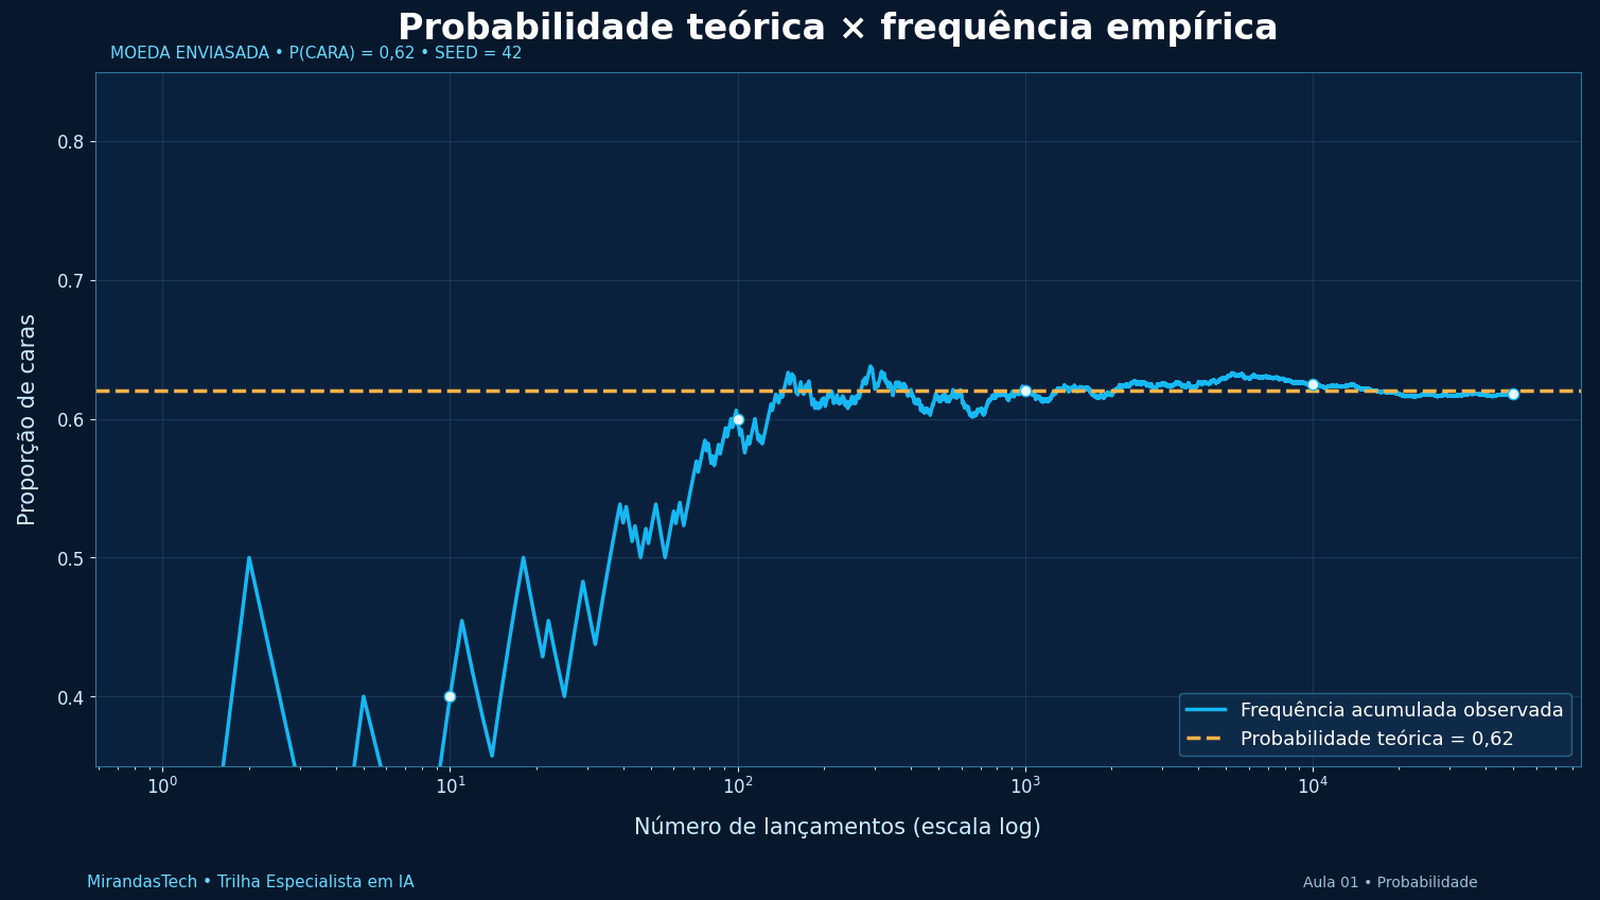
A trajetória não precisa se aproximar de forma monotônica. Ela oscila, e outra seed produzirá outro caminho. A formulação rigorosa desse comportamento, a Lei dos Grandes Números, aparecerá na Aula 10. Por ora, basta a intuição e a disciplina de nunca chamar $\widehat p_n$ de $P(A)$.
Essa distinção é a mesma que aparece quando um classificador é avaliado em um conjunto de teste, como no experimento com split e baseline da série de Machine Learning: a taxa de acerto medida ali é uma frequência observada em uma amostra, não uma propriedade garantida do modelo em produção.
10. Na prática: eventos e simulação em Python
Duas coisas dá para verificar em código: as regras de eventos, com aritmética exata, e a estabilização da frequência, com uma simulação reproduzível. O notebook completo está no Google Colab; localmente, basta pip install numpy matplotlib.
Primeiro, os eventos do dado como conjuntos do Python. Os operadores &, | e - são exatamente $\cap$, $\cup$ e $\setminus$:
import math

omega = set(range(1, 7))
A = {2, 4, 6}       # resultado par
B = {4, 5, 6}       # resultado >= 4

def prob_uniforme(evento, espaco):
    if not evento <= espaco:
        raise ValueError("O evento deve estar contido no espaço amostral.")
    return len(evento) / len(espaco)

p_a = prob_uniforme(A, omega)
p_b = prob_uniforme(B, omega)
p_intersecao = prob_uniforme(A & B, omega)
p_uniao = prob_uniforme(A | B, omega)

print(f"P(A)       = {p_a:.3f}")
print(f"P(B)       = {p_b:.3f}")
print(f"P(A ∩ B)   = {p_intersecao:.3f}")
print(f"P(A ∪ B)   = {p_uniao:.3f}")

# regra geral da união e regra do complemento
assert math.isclose(p_uniao, p_a + p_b - p_intersecao)
assert prob_uniforme(omega - A, omega) == 1 - p_a
P(A)       = 0.500
P(B)       = 0.500
P(A ∩ B)   = 0.333
P(A ∪ B)   = 0.667
Os valores batem com a conta da seção 7, e os dois assert confirmam a regra geral da união e a regra do complemento. A comparação usa math.isclose porque $0{,}5+0{,}5-1/3$ e $4/6$ diferem no último bit em ponto flutuante; a igualdade matemática é exata, a de float não.
Agora a moeda enviesada. A seed fixa torna o resultado reproduzível:
import numpy as np

SEED = 42
N = 50_000
P_CARA = 0.62

rng = np.random.default_rng(SEED)
caras = rng.random(N) < P_CARA
frequencia_acumulada = np.cumsum(caras) / np.arange(1, N + 1)

for n in [10, 100, 1_000, 10_000, 50_000]:
    print(f"n={n:>6}: frequência={frequencia_acumulada[n - 1]:.4f}")
n=    10: frequência=0.4000
n=   100: frequência=0.6000
n=  1000: frequência=0.6200
n= 10000: frequência=0.6250
n= 50000: frequência=0.6179
Em dez lançamentos, a frequência foi 0,40 para uma moeda cuja probabilidade de cara é 0,62. Em mil, chegou a 0,62; em dez mil, passou para 0,625; em cinquenta mil, recuou para 0,618. São os cinco pontos marcados na figura da seção 9. A seed torna a execução reproduzível naquele ambiente (Python 3.13, NumPy 2.2); ela não transforma resultados pseudoaleatórios em uma propriedade teórica nem garante o mesmo fluxo de bits entre todas as versões futuras do gerador, como declara a própria política de compatibilidade do NumPy.
Para ir além, altere uma variável por vez: use P_CARA = 0.50 e depois 0.20; compare N = 20, 200, 2_000 e 50_000; execute as seeds de 0 a 9 e compare as trajetórias; simule um dado não uniforme com rng.choice e probabilidades que somem 1; crie dois eventos que se sobreponham e verifique a regra geral da união empiricamente.
Limite da simulação: observar um milhão de repetições compatíveis com uma regra não substitui uma demonstração matemática. A simulação investiga comportamento e testa implementação; os axiomas e deduções estabelecem a coerência do modelo.
11. O que isso tem a ver com Inteligência Artificial?
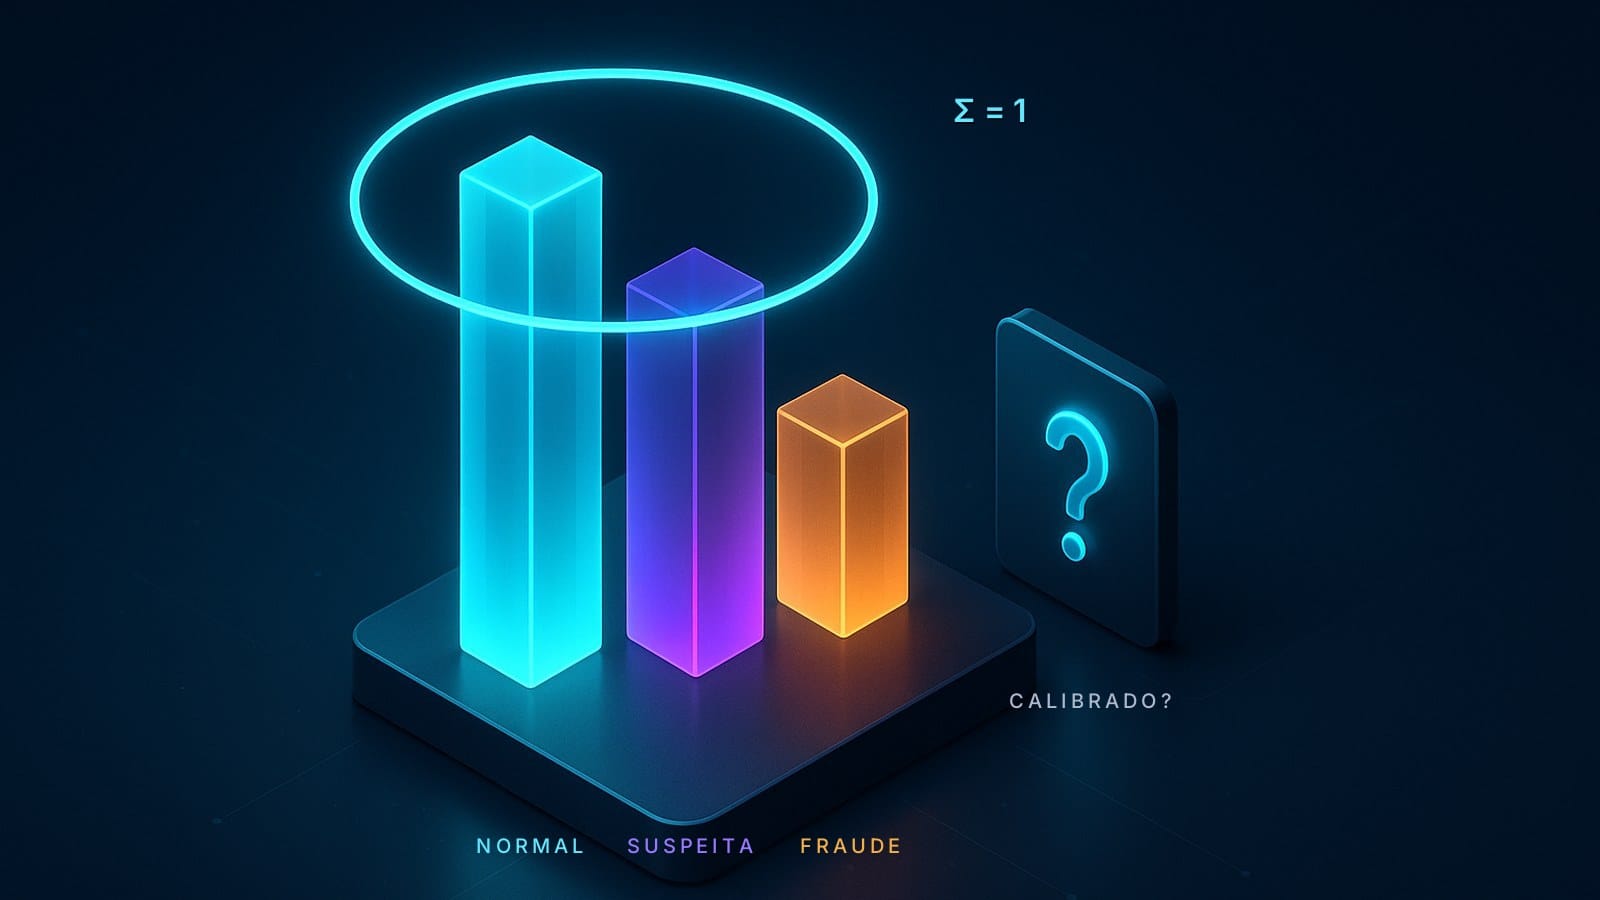
Volte aos três números da abertura. Eles saem, na maioria dos classificadores modernos, de uma função softmax (Bridle, 1990; Goodfellow, Bengio & Courville, 2016) aplicada às saídas brutas do modelo. O que o softmax faz é exatamente construir uma lei de probabilidade sobre um espaço amostral finito:
import numpy as np

z = np.array([1.5, 0.3, -0.8])        # saídas brutas para normal, suspeita, fraude
p = np.exp(z) / np.exp(z).sum()      # softmax
print(np.round(p, 3), p.sum())
[0.714 0.215 0.072] 1.0
Os três valores são não negativos e somam 1. Em outras palavras, satisfazem os axiomas para $\Omega=\{\text{normal},\text{suspeita},\text{fraude}\}$, com as três classes tratadas como eventos disjuntos e exaustivos:
$$ \begin{aligned} &P(Y=\text{normal}\mid x)+P(Y=\text{suspeita}\mid x)\\ &\quad+P(Y=\text{fraude}\mid x)=1. \end{aligned} $$
Se a política operacional for revisar transações suspeitas ou fraudulentas, o evento “revisar” é a união de duas classes disjuntas, e o Axioma 3 dá a resposta sem nenhuma fórmula extra:
$$ \begin{aligned} P(\text{revisar}\mid x) &= P(\text{suspeita}\mid x)\\ &\quad+P(\text{fraude}\mid x). \end{aligned} $$
A barra vertical em $P(\cdot\mid x)$ indica “dado que observamos a transação $x$”; a interpretação condicional será formalizada na Aula 03.
Modelos generativos fazem o mesmo em escala maior. Um modelo de linguagem atribui probabilidades a todos os possíveis próximos tokens: o vocabulário funciona como o espaço amostral daquele passo, a distribuição precisa ser normalizada, e amostrar dessa distribuição é escolher um resultado segundo as massas atribuídas (Holtzman et al., 2020). A mesma pergunta da abertura vale aqui: a massa atribuída a um token é um score normalizado por construção; se ela corresponde à frequência com que aquele token seria o correto é outra questão, e uma questão empírica: Guo et al. (2017) mostraram, para classificadores de imagem e de texto, que redes modernas saem miscalibradas mesmo com softmax na saída.
Decisão sob risco é o passo seguinte. A probabilidade descreve incerteza; a decisão também depende das consequências. Duas ações podem reagir de modo diferente ao mesmo $P(A)$ quando os custos de falso positivo e falso negativo são diferentes (Murphy, 2022, cap. 5): bloquear uma compra legítima custa uma coisa, aprovar uma fraude custa outra.
E o cuidado essencial com scores. Softmax produz números não negativos que somam 1, mas isso não garante que a confiança declarada corresponda à frequência observada em uso. Nada no exemplo acima garante que, entre as transações que recebem 0,07 de fraude, cerca de 7% sejam de fato fraudes. Essa correspondência entre $P(A)$ do modelo e $\widehat p_n$ do mundo envolve qualidade dos dados, mudança de distribuição e calibração (Guo et al., 2017), tema que a série de Machine Learning retoma. Um número satisfazer os axiomas é condição necessária para ser probabilidade; não é condição suficiente para ser uma probabilidade boa.
12. Dois tipos úteis de incerteza
Sem entrar ainda em métodos de estimação, vale separar de onde a incerteza vem, porque a resposta muda o que fazer com ela.
| Tipo | Ideia | Exemplo |
|---|---|---|
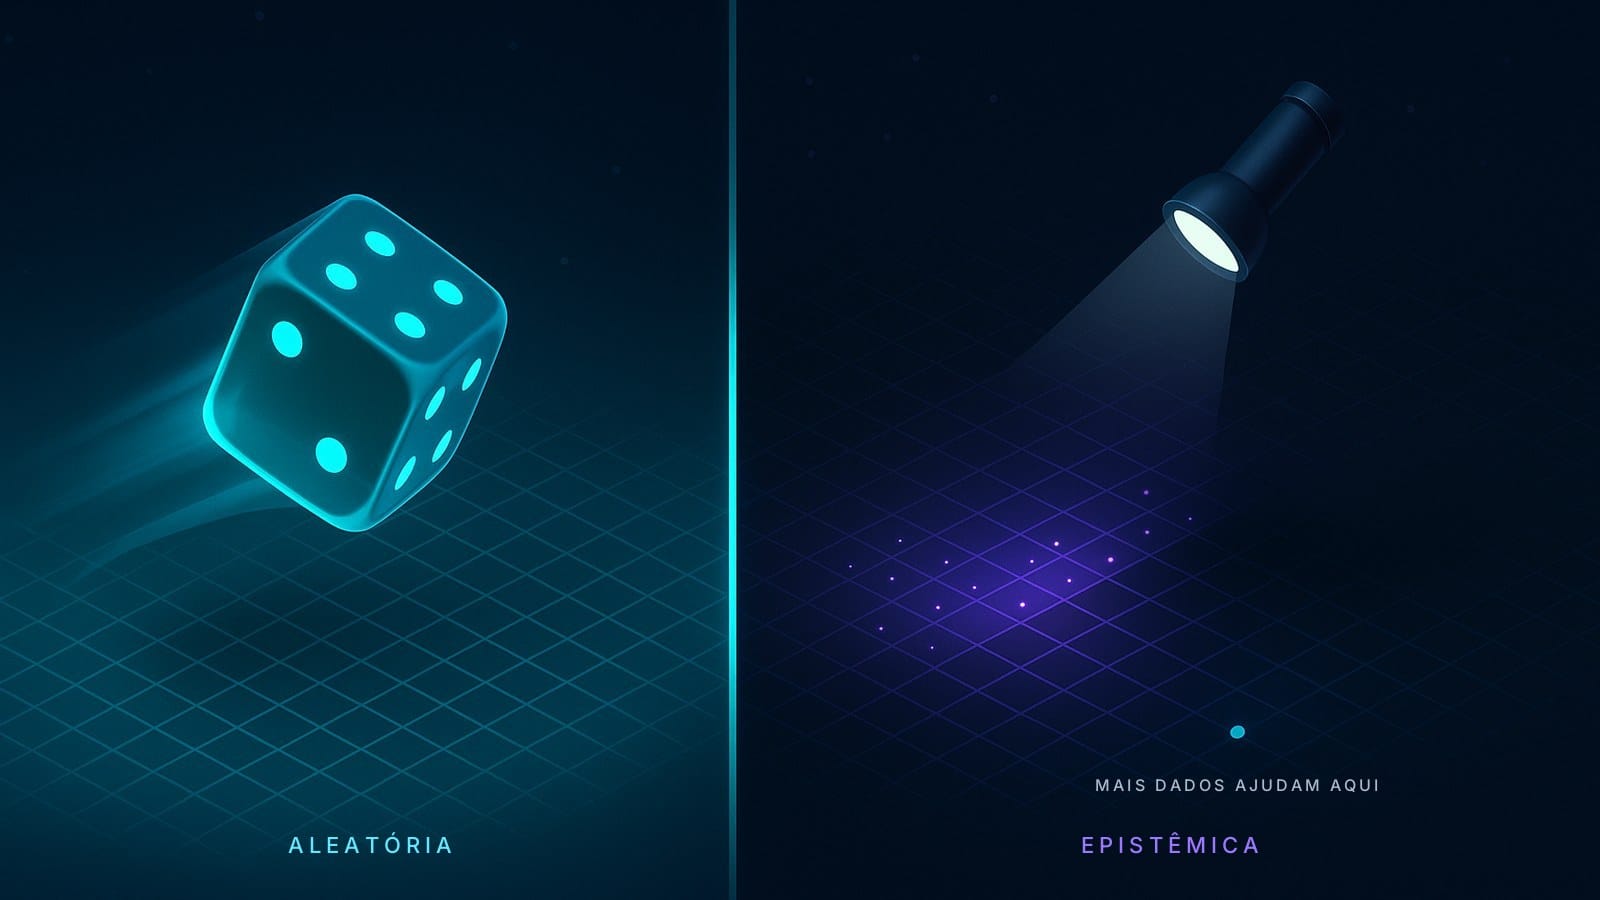
| Aleatória (aleatoric) | Variação que permanece mesmo com o modelo bem especificado | Ruído de medição ou resultados diferentes sob condições semelhantes |
| Epistêmica | Incerteza por conhecimento, dados ou modelo insuficientes | Poucos exemplos de uma nova região operacional |
A distinção nem sempre é observável de forma perfeita (Hüllermeier & Waegeman, 2021), mas orienta respostas diferentes. Mais dados ou um modelo melhor podem reduzir parte da incerteza epistêmica (Kendall & Gal, 2017). Coletar a feature relevante pode reduzir a incerteza causada por informação ausente. Já a variação intrínseca não desaparece apenas aumentando a complexidade do algoritmo: nenhuma rede neural prevê o resultado de um dado honesto.
13. Erros comuns e como corrigi-los
- Confundir resultado e evento.
4é resultado; “par” é o evento $\{2,4,6\}$. - Omitir o espaço amostral. Sem $\Omega$, “não A” fica indefinido.
- Assumir equiprobabilidade por conveniência. Conte resultados apenas depois de justificar pesos iguais.
- Somar eventos sobrepostos. Use a interseção para corrigir a dupla contagem.
- Confundir disjunção e independência. Disjuntos não ocorrem juntos; independência trata de informação. O segundo conceito será estudado na Aula 03.
- Achar que probabilidade zero sempre significa impossibilidade. Em modelos contínuos, um ponto isolado pode ter probabilidade zero embora algum valor pontual seja observado. Intervalos carregam probabilidade.
- Tratar frequência curta como verdade do mecanismo. Amostras pequenas oscilam.
- Usar simulação como prova. Código pode apoiar a intuição, não substituir axiomas e demonstrações.
- Interpretar qualquer score como probabilidade calibrada. Normalização algébrica e validade empírica são questões diferentes.
- Alterar o modelo depois de ver o resultado sem registrar a mudança. Isso dificulta auditoria e pode transformar análise em justificativa retrospectiva.
Antes de calcular qualquer probabilidade, dez perguntas fecham o modelo: qual é o experimento ou processo? O que conta como uma repetição? Qual é o espaço amostral e sua granularidade? Os eventos de interesse estão definidos como subconjuntos? O “ou” é inclusivo, e existe sobreposição? Os resultados elementares são realmente equiprováveis? As probabilidades são não negativas e normalizadas? A população, o período e as condições do modelo foram declarados? Estou usando probabilidade teórica, estimativa ou frequência observada? O que mudaria a validade desse modelo no mundo real?
14. Exercícios
- No lançamento de duas moedas com ordem registrada, escreva $\Omega$ e o evento $A=$ “exatamente uma cara”.
- Para um dado justo, sejam $A=$ “resultado ímpar” e $B=$ “resultado maior que 3”. Calcule $A\cap B$, $A\cup B$ e suas probabilidades.
- Uma roleta possui três setores de tamanhos diferentes. É válido calcular a probabilidade de cada setor como $1/3$? Explique.
- Alguém afirma: “$P(A\cup B)=P(A)+P(B)$ para quaisquer eventos”. Construa um contraexemplo.
- Verifique se a atribuição $P(\{a\})=0{,}5$, $P(\{b\})=0{,}4$ e $P(\{c\})=0{,}3$ define uma lei válida em $\Omega=\{a,b,c\}$.
- Se $A\subseteq B$, pode ocorrer $P(A)>P(B)$? Justifique pelos axiomas.
- Em 20 lançamentos de uma moeda modelada com $P(C)=0{,}5$, ocorreram 15 caras. Isso prova que o modelo está errado?
- Um classificador retorna
[0.8, 0.2]. Que perguntas devem ser respondidas antes de chamar esses valores de probabilidades confiáveis?
Respostas comentadas
- $\Omega=\{CC,CK,KC,KK\}$ e $A=\{CK,KC\}$.
- $A=\{1,3,5\}$, $B=\{4,5,6\}$, $A\cap B=\{5\}$ e $A\cup B=\{1,3,4,5,6\}$. Logo, $P(A\cap B)=1/6$ e $P(A\cup B)=5/6$.
- Não apenas pelo número de setores. A regra de contagem exige resultados equiprováveis; áreas ou mecanismos diferentes podem produzir pesos diferentes.
- Use $A=\{2,4,6\}$ e $B=\{4,5,6\}$ no dado. A soma simples conta $\{4,6\}$ duas vezes.
- Não. Como os eventos elementares são disjuntos e formam $\Omega$, as massas deveriam somar 1, mas somam 1,2.
- Não. Escreva $B=A\cup(B\setminus A)$. Pela não negatividade e aditividade, $P(B)=P(A)+P(B\setminus A)\geq P(A)$.
- Não. É uma observação possível sob o modelo. Para avaliar incompatibilidade, seria necessário um procedimento inferencial definido; uma única frequência não é prova automática.
- Entre outras: como o score foi produzido, se as classes são exaustivas e disjuntas, em qual população foi avaliado, se existe calibração empírica e se ocorreu mudança de distribuição.
Desafio de transferência. Escolha um processo do seu contexto, como alerta de sensor, inspeção, triagem, atendimento ou falha de serviço, e preencha a ficha abaixo. Se você não consegue definir o espaço amostral e o evento de interesse, ainda não está pronto para calcular a probabilidade.
| Campo | Sua definição |
|---|---|
| Experimento/processo | |
| Resultado elementar | |
| Espaço amostral | |
| Evento operacional principal | |
| Evento complementar | |
| Hipótese de equiprobabilidade? | |
| Origem das probabilidades | |
| Condições de validade | |
| Decisão apoiada | |
| Consequência de um erro |
O que guardar
Um modelo probabilístico é a tríade $(\Omega,\mathcal F,P)$: o que pode acontecer, quais grupos de resultados recebem medida e qual é a medida. Os três axiomas de Kolmogorov, não negatividade, normalização e aditividade para eventos disjuntos, são tudo o que sustenta as regras do complemento, da monotonicidade e da união. “Casos favoráveis sobre casos possíveis” só vale sob equiprobabilidade. $P(A)$ é do modelo; $\widehat p_n$ é dos dados. E um softmax entrega uma lei de probabilidade válida pelos axiomas, o que ainda não diz se ela é uma boa descrição do mundo.
Se ficar com uma pergunta para cada número entre 0 e 1 que encontrar, que seja esta: qual é o espaço amostral, e como esse número foi produzido e validado?
Na Aula 02, Contagem e combinatória para probabilidade, aprenderemos a contar configurações sem enumerá-las uma a uma, com princípio multiplicativo, permutações e combinações em espaços finitos equiprováveis.
Referências
- Kolmogorov, Andrei N. Grundbegriffe der Wahrscheinlichkeitsrechnung. Berlin: Springer, 1933. doi.org/10.1007/978-3-642-49888-6. Tradução inglesa: Foundations of the Theory of Probability, 2. ed., New York: Chelsea, 1956.
- Shafer, Glenn; Vovk, Vladimir. The Sources of Kolmogorov's Grundbegriffe. Statistical Science, 21(1), 2006. doi.org/10.1214/088342305000000467. Versão longa (104 p.): The origins and legacy of Kolmogorov's Grundbegriffe, arxiv.org/abs/1802.06071.
- Bertsekas, Dimitri P.; Tsitsiklis, John N. Introduction to Probability. 2. ed. Belmont, MA: Athena Scientific, 2008.
- Blitzstein, Joseph K.; Hwang, Jessica. Introduction to Probability. 2. ed. Boca Raton: Chapman and Hall/CRC, 2019. doi.org/10.1201/9780429428357. Curso Harvard Stat 110: stat110.hsites.harvard.edu.
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. Cambridge, MA: MIT Press, 2016. Cap. 6, §6.2.2.3. www.deeplearningbook.org/contents/mlp.html
- Murphy, Kevin P. Probabilistic Machine Learning: An Introduction. Cambridge, MA: MIT Press, 2022. Cap. 5. probml.github.io/pml-book/book1.html
- Bridle, John S. Probabilistic Interpretation of Feedforward Classification Network Outputs, with Relationships to Statistical Pattern Recognition. In: Soulié, F. F.; Hérault, J. (eds.). Neurocomputing: Algorithms, Architectures and Applications. NATO ASI Series F, v. 68. Berlin: Springer, 1990. doi.org/10.1007/978-3-642-76153-9_28
- Guo, Chuan; Pleiss, Geoff; Sun, Yu et al. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning (ICML), PMLR 70, 2017. arxiv.org/abs/1706.04599
- Hüllermeier, Eyke; Waegeman, Willem. Aleatoric and epistemic uncertainty in machine learning: an introduction to concepts and methods. Machine Learning, 110(3), 457–506, 2021. doi.org/10.1007/s10994-021-05946-3
- Kendall, Alex; Gal, Yarin. What Uncertainties Do We Need in Bayesian Deep Learning for Computer Vision?. Advances in Neural Information Processing Systems 30 (NeurIPS), 2017. arxiv.org/abs/1703.04977
- Holtzman, Ari; Buys, Jan; Du, Li et al. The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR), 2020. arxiv.org/abs/1904.09751
- NumPy. Random Generator e Compatibility policy (NEP 19). Documentação oficial, v2.5, acesso em 18 set. 2026. numpy.org/doc/stable/reference/random/generator.html; numpy.org/doc/stable/reference/random/compatibility.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 02-statistics/aulas/01-incerteza-eventos-axiomas.md.



