
Combinatória para IA: permutações, combinações e probabilidade
Contar configurações sem enumerá-las uma a uma e transformar contagens em probabilidades apenas quando os resultados elementares forem equiprováveis.

Contar configurações sem enumerá-las uma a uma e transformar contagens em probabilidades apenas quando os resultados elementares forem equiprováveis. Pré-requisitos: a Aula 01 (incerteza, eventos e axiomas), aritmética básica e conjuntos. Tempo sugerido: 3 a 4 horas, com o laboratório e os exercícios.
Um lote de 20 peças chega à bancada de testes. Num cenário de validação, você sabe que 5 delas são defeituosas. O detector que está sendo avaliado vai receber 4 peças sorteadas do lote, sem reposição, e a pergunta da equipe é direta: qual a chance de a amostra conter exatamente duas peças defeituosas?
Dá para responder listando todas as amostras possíveis e marcando as que servem. O problema é o tamanho da lista: são 4 845 grupos diferentes de quatro peças. E o lote é pequeno. Com 200 peças e amostras de 10, a lista passaria de 22 quatrilhões de grupos. Ninguém enumera isso; conta-se.
Na aula anterior desta série, vimos que “casos favoráveis sobre casos possíveis” só vale quando todos os resultados têm a mesma chance. Faltou a outra metade do problema: como obter esses dois números quando os casos são milhares, milhões ou mais. É disso que trata a combinatória, e ela reaparece em IA sempre que alguém pergunta quantas sequências de tokens, quantos subconjuntos de atributos ou quantas combinações de hiperparâmetros existem.
Ao final, você vai saber decidir entre somar e multiplicar; usar fatorial, permutações e combinações sem confundi-los; contar ordenações com letras repetidas; resolver o problema do lote por casos favoráveis e possíveis; conferir cada fórmula por enumeração em Python num caso pequeno; e reconhecer quando uma contagem enorme não diz nada sobre a probabilidade de cada resultado.
1. Antes da fórmula, o objeto: o que estamos contando?
Uma contagem correta começa pela definição da unidade. Três pessoas escolhidas entre dez podem ser um pódio (ouro, prata e bronze) ou uma comissão (três membros sem cargo). As palavras “três entre dez” são as mesmas; os objetos contados, não.
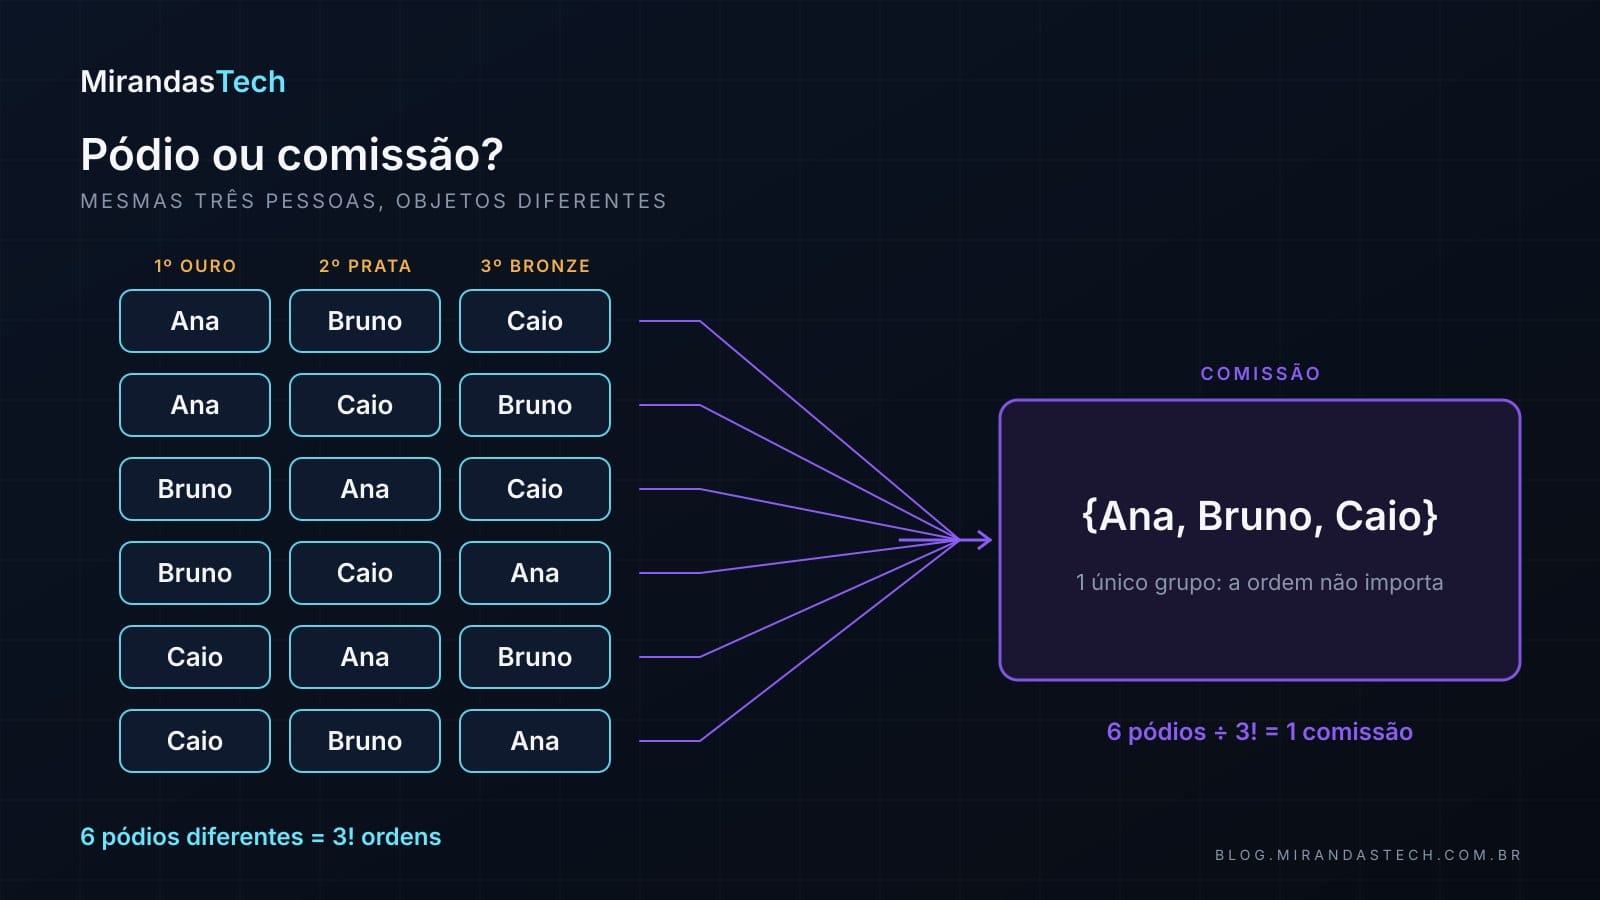
Ana–Bruno–Caio e Caio–Bruno–Ana são dois pódios diferentes, porque quem ganhou o ouro mudou. Numa comissão, são o mesmo grupo. Trocar “sequência” por “grupo” muda a resposta, e é por isso que a pergunta sobre a ordem vem antes de qualquer conta.
Alguns exemplos, com as duas perguntas da ideia-chave respondidas:
- PIN de 4 dígitos: sequência de quatro posições. A ordem importa (1234 não é 4321) e dígitos podem repetir.
- Pódio com 3 de 10 pessoas: sequência de ocupantes de ouro, prata e bronze. A ordem importa; ninguém ocupa dois degraus.
- Comissão com 3 de 10 pessoas: subconjunto. A ordem não importa; ninguém entra duas vezes.
- Subconjunto de atributos de um modelo: subconjunto. Sem ordem, sem repetição.
- Sequência de 8 tokens de um vocabulário com $V$ tokens: sequência. A ordem importa e o mesmo token pode aparecer várias vezes.
O vocabulário mínimo para o resto do artigo é curto. Uma configuração é um resultado completo do processo de escolha; uma etapa é uma decisão parcial dentro dela (uma posição, um item). Há repetição (ou reposição) quando um item pode voltar a ser escolhido. Permutação é uma ordenação; combinação é uma escolha sem ordem. E um espaço é equiprovável quando todos os resultados elementares têm a mesma probabilidade.
A palavra “arranjo” varia de livro para livro. Aqui, $P(n,k)$ é sempre uma seleção ordenada de $k$ elementos distintos entre $n$.
2. Somar ou multiplicar: os dois princípios
Quase toda contagem se reduz a duas operações. A pergunta que decide qual delas usar é: a configuração vem de uma entre várias alternativas ou de várias escolhas feitas em sequência?
Princípio aditivo: alternativas que não se sobrepõem
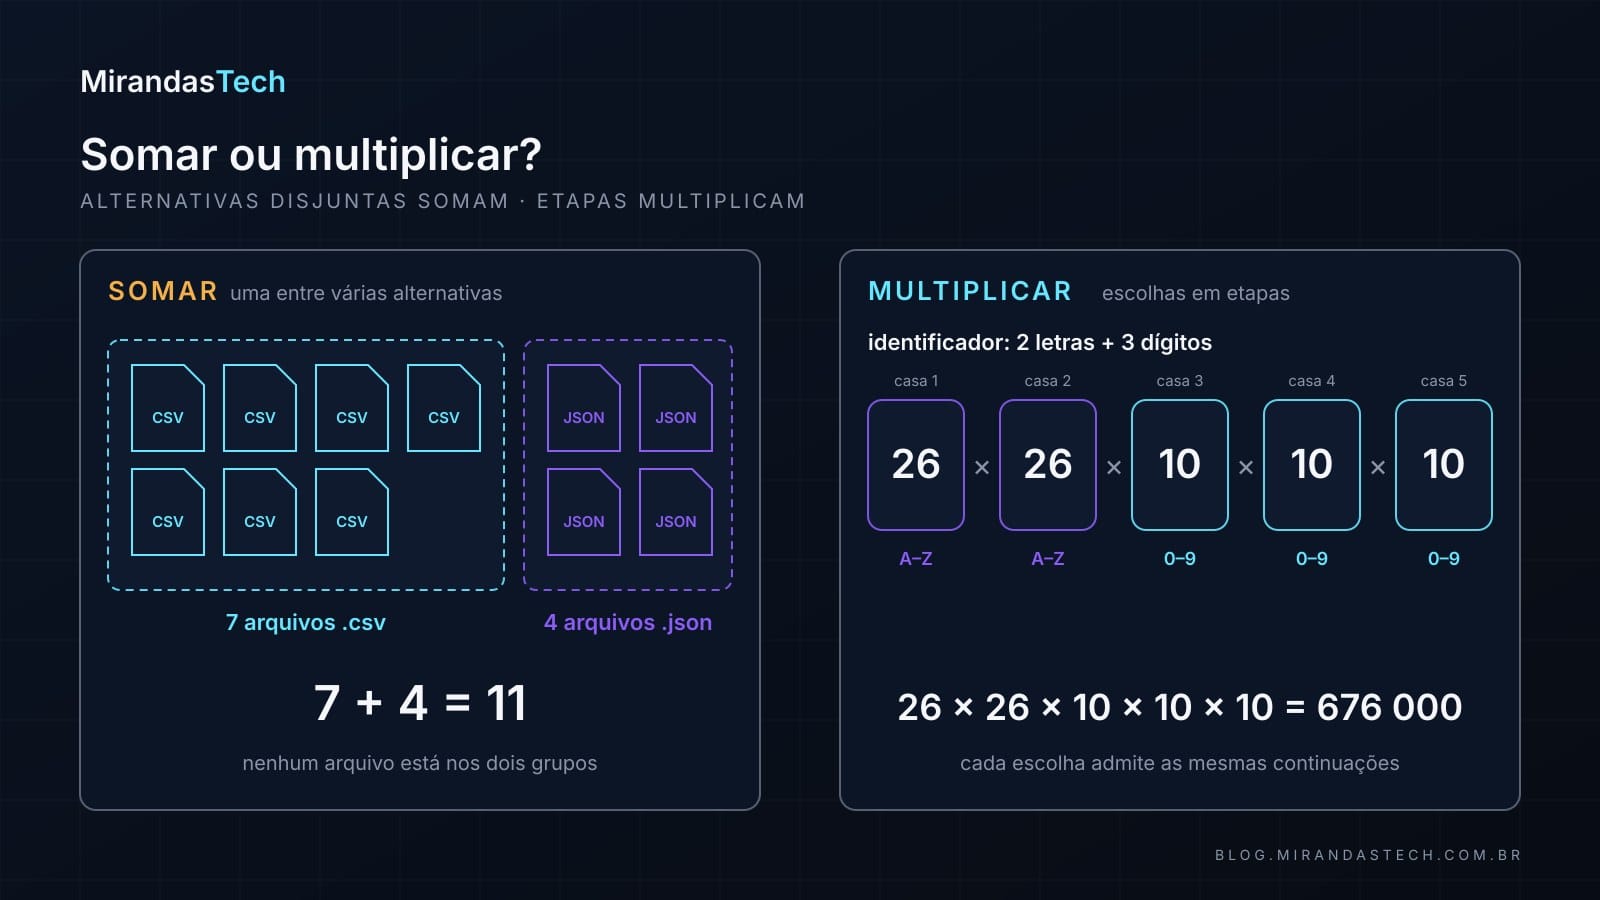
Uma pasta tem 7 arquivos .csv e 4 arquivos .json, e nenhum arquivo está nas duas categorias. Para escolher um arquivo de um desses formatos há $7+4=11$ opções. Em geral, se há $m$ resultados do tipo A e $n$ do tipo B, e nenhum pertence aos dois tipos,
$$ N(A\text{ ou }B)=m+n. $$
A condição “nenhum pertence aos dois” não é detalhe. Se as categorias se sobrepõem, a soma direta conta a interseção duas vezes, e a correção é a mesma regra da união da aula anterior:
$$ |A\cup B|=|A|+|B|-|A\cap B|. $$
Princípio multiplicativo: escolhas em etapas
Um identificador de experimento tem duas letras maiúsculas seguidas de três dígitos, com repetição permitida. A primeira casa tem 26 opções; para cada uma delas, a segunda tem outras 26; para cada par de letras, o primeiro dígito tem 10; e assim por diante. O total é o produto:
$$ 26^2\cdot10^3=676\,000. $$
Se a segunda letra não pudesse repetir a primeira, a segunda casa teria 25 opções e o total cairia para $26\cdot25\cdot10^3=650\,000$. A fórmula mudou porque o número de continuações mudou. Para $k$ etapas com $n_1,n_2,\ldots,n_k$ opções,
$$ N=n_1n_2\cdots n_k=\prod_{i=1}^{k}n_i, $$
desde que cada escolha de uma etapa admita o mesmo número de continuações na seguinte. Essa condição é o que faz a multiplicação ser honesta.
3. Fatorial: todas as ordens possíveis
Para ordenar $n$ elementos distintos, há $n$ candidatos para a primeira posição, $n-1$ para a segunda, e assim até sobrar um. Pelo princípio multiplicativo,
$$ n!=n(n-1)(n-2)\cdots2\cdot1. $$
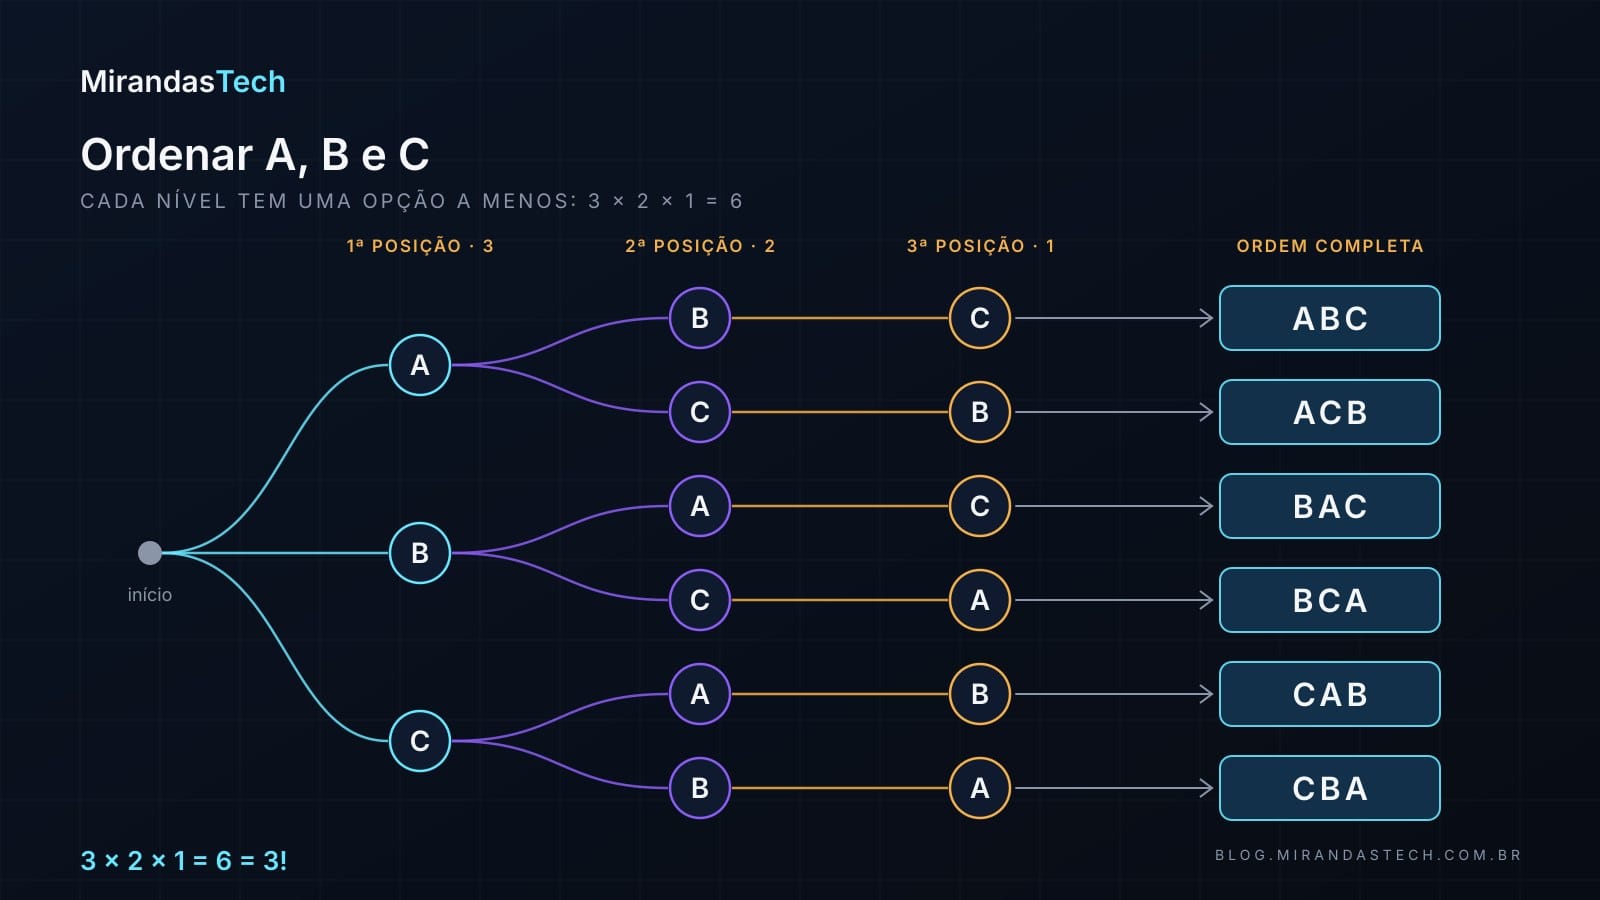
Assim, $4!=4\cdot3\cdot2\cdot1=24$ e $1!=1$. Define-se também $0!=1$, e isso não é capricho: existe exatamente uma forma de ordenar nenhum elemento, a sequência vazia. A definição mantém identidades que veremos adiante, como
$$ \binom n0=\frac{n!}{0!\,n!}=1. $$
O fatorial cresce depressa: $5!=120$, $10!=3\,628\,800$ e $20!=2\,432\,902\,008\,176\,640\,000$, perto de $2{,}4\times10^{18}$. Enumerar todas as ordens de 20 objetos está fora de questão; calcular quantas são leva um instante.
4. Quando a ordem importa: $P(n,k)$ e $n^k$
Nem sempre se ordenam todos os elementos. Entre 10 modelos candidatos, uma equipe quer registrar só o primeiro, o segundo e o terceiro colocados. A primeira posição tem 10 candidatos, a segunda 9, a terceira 8. Isso é uma permutação de $k$ entre $n$:
$$ \begin{aligned} P(n,k)&=n(n-1)\cdots(n-k+1)\\ &=\frac{n!}{(n-k)!}. \end{aligned} $$
No exemplo, $P(10,3)=10\cdot9\cdot8=720$ pódios. Os mesmos três modelos em outra ordem formam outro pódio. Quando $k=n$, voltamos ao fatorial: $P(n,n)=n!$.
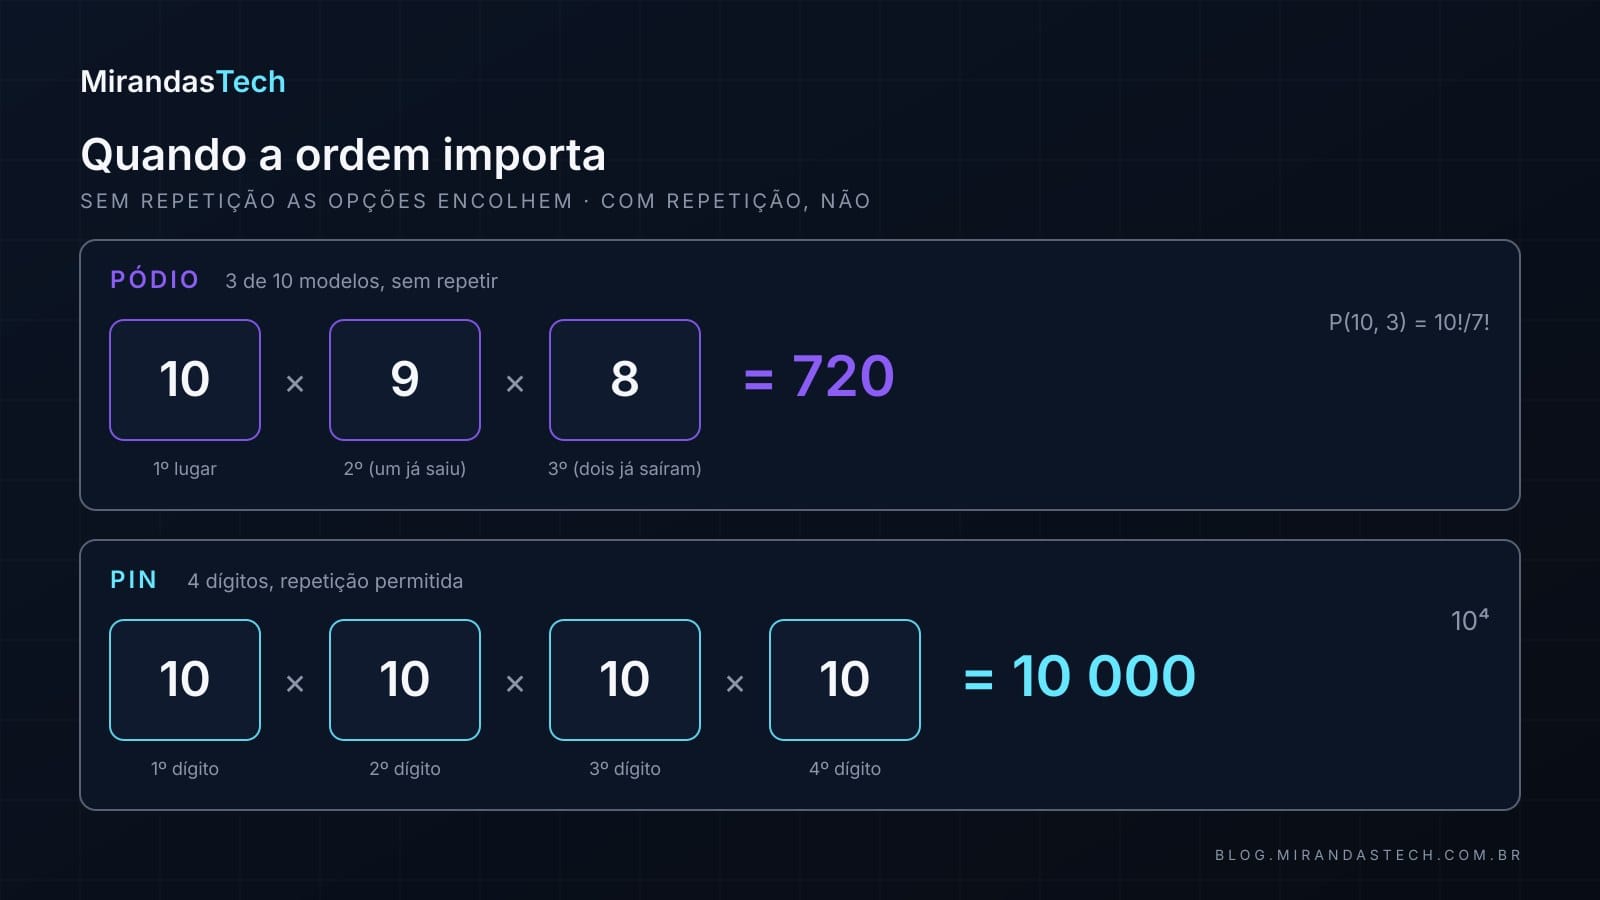
Se cada posição pode receber qualquer um dos $n$ símbolos, independentemente das anteriores, as opções não encolhem, e o total é $n^k$. Um PIN de quatro dígitos, com zeros à esquerda, tem $10^4=10\,000$ sequências, de 0000 a 9999.
O mesmo raciocínio vale para texto. Um vocabulário com $V$ tokens admite $V^L$ sequências de comprimento exatamente $L$, antes de qualquer restrição. É por isso que buscar exaustivamente sobre textos é impraticável. Mas cuidado com a leitura: contar $V^L$ sequências possíveis não diz que elas sejam igualmente prováveis. Um modelo de linguagem atribui probabilidades muito diferentes a cada uma, e voltaremos a isso na seção 11.
5. Quando a ordem não importa: combinações
A fórmula das combinações sai de um truque: contar com ordem e depois desfazer a ordem. Primeiro contamos as seleções ordenadas de $k$ elementos, que são $P(n,k)$. Cada grupo não ordenado aparece nessa contagem $k!$ vezes, uma para cada ordem interna. Dividindo,
$$ \binom nk=\frac{n!}{k!\,(n-k)!},\qquad 0\le k\le n. $$
Lê-se “$n$ escolhe $k$”; muitos textos escrevem $C(n,k)$. Uma equipe de avaliação com três pessoas entre dez, sem cargos, pode ser formada de
$$ \binom{10}{3}=\frac{10\cdot9\cdot8}{3\cdot2\cdot1}=120 $$
maneiras. Compare com os 720 pódios: cada equipe corresponde a $3!=6$ ordens, e $720/6=120$.
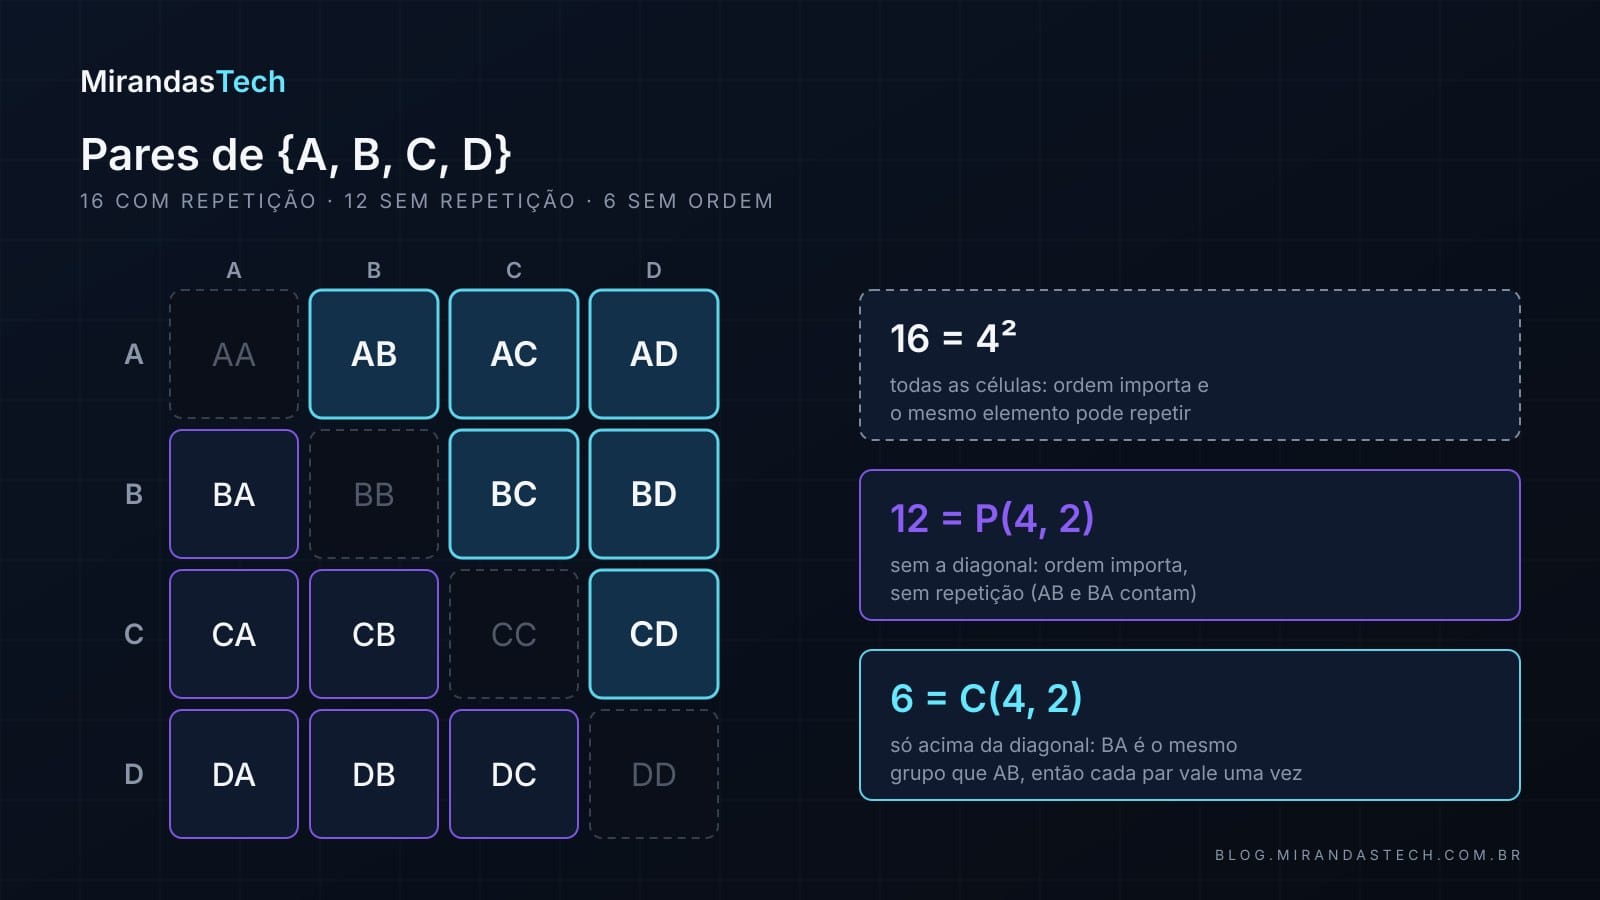
A grade acima mostra os três casos para $n=4$ e $k=2$ de uma vez. Com ordem e repetição, são $4^2=16$ pares. Tirando a diagonal (não se pode repetir), sobram $P(4,2)=12$. E como AB e BA são o mesmo grupo, cada combinação aparece duas vezes entre as 12; ficam $\binom42=6$.
Simetria
Escolher $k$ elementos para entrar é o mesmo que escolher $n-k$ para ficar de fora:
$$ \binom nk=\binom n{n-k}. $$
Por isso $\binom{10}{3}=\binom{10}{7}=120$: cada equipe de três define, sem ambiguidade, as sete pessoas que ficaram fora.
6. Quantos subconjuntos existem?
Um conjunto com $n$ elementos tem quantos subconjuntos, de todos os tamanhos? Para cada elemento há duas decisões, incluir ou não incluir. Pelo princípio multiplicativo, são
$$ 2^n $$
subconjuntos, contando o vazio e o próprio conjunto completo.
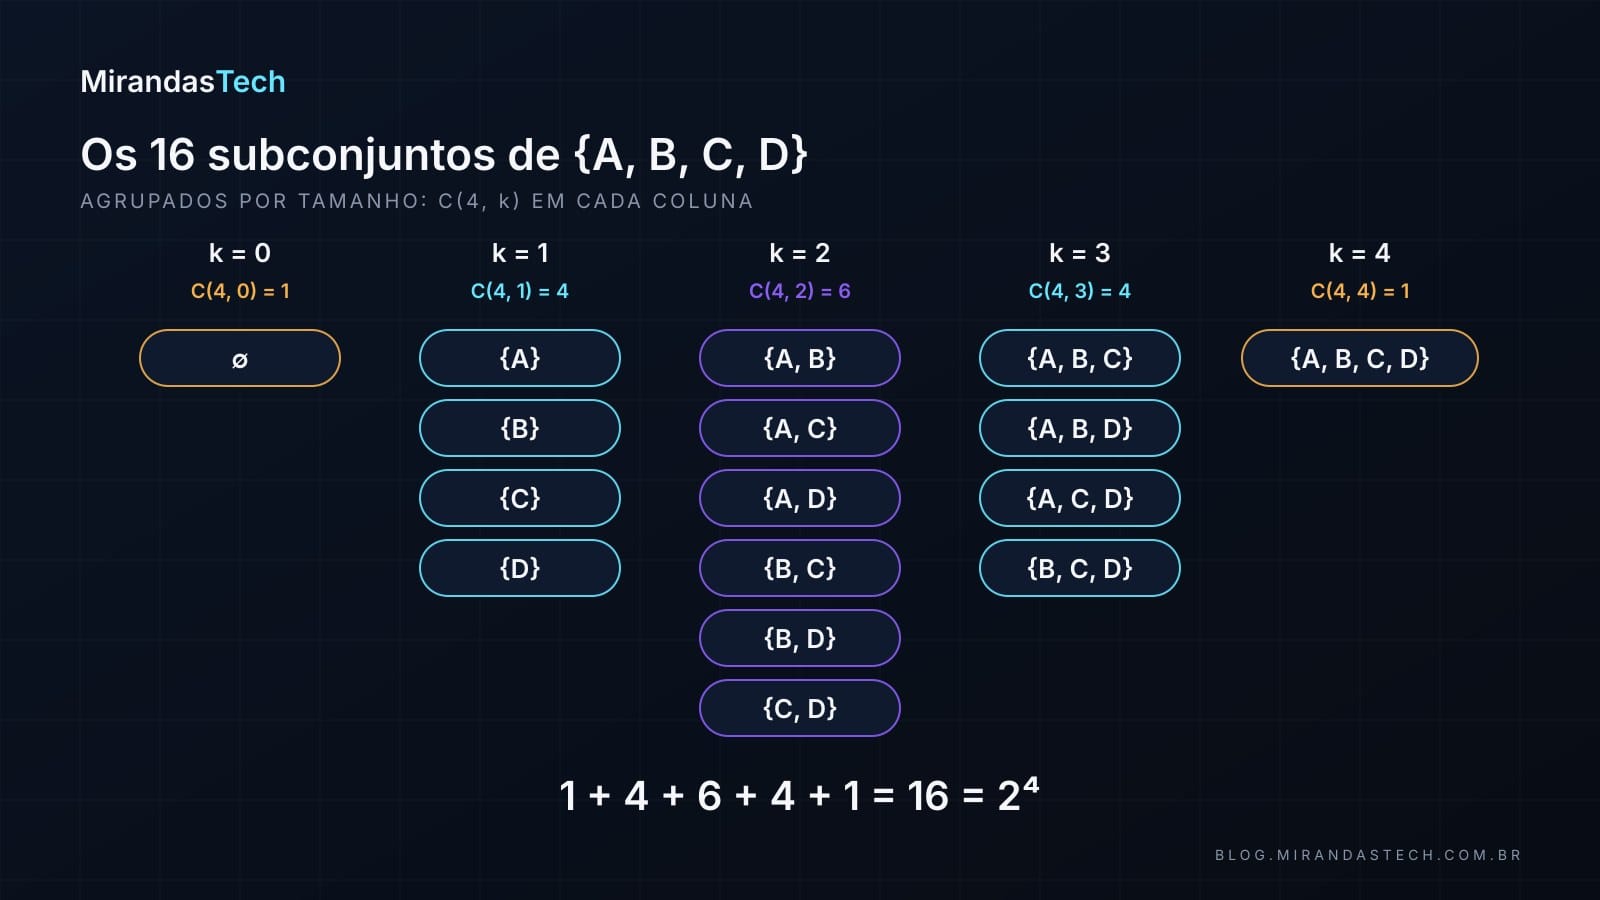
A mesma conclusão aparece somando os subconjuntos por tamanho, que é o que a figura faz para $n=4$:
$$ \sum_{k=0}^{n}\binom nk=2^n. $$
Com 30 atributos candidatos, já existem $2^{30}=1\,073\,741\,824$ subconjuntos. Se o vazio não for uma solução válida, restam $2^{30}-1$. Essa explosão é a razão pela qual seleção exaustiva de atributos costuma ser inviável e existem métodos que exploram só uma parte do espaço (Kohavi & John, 1997).
7. Elementos repetidos: a palavra DADO
Quantas palavras diferentes, com ou sem sentido, se formam com as letras de DADO? São quatro letras, e $4!=24$ ordenações se as letras fossem todas distinguíveis. Mas o D aparece duas vezes, e trocar um D pelo outro não cria palavra nova.
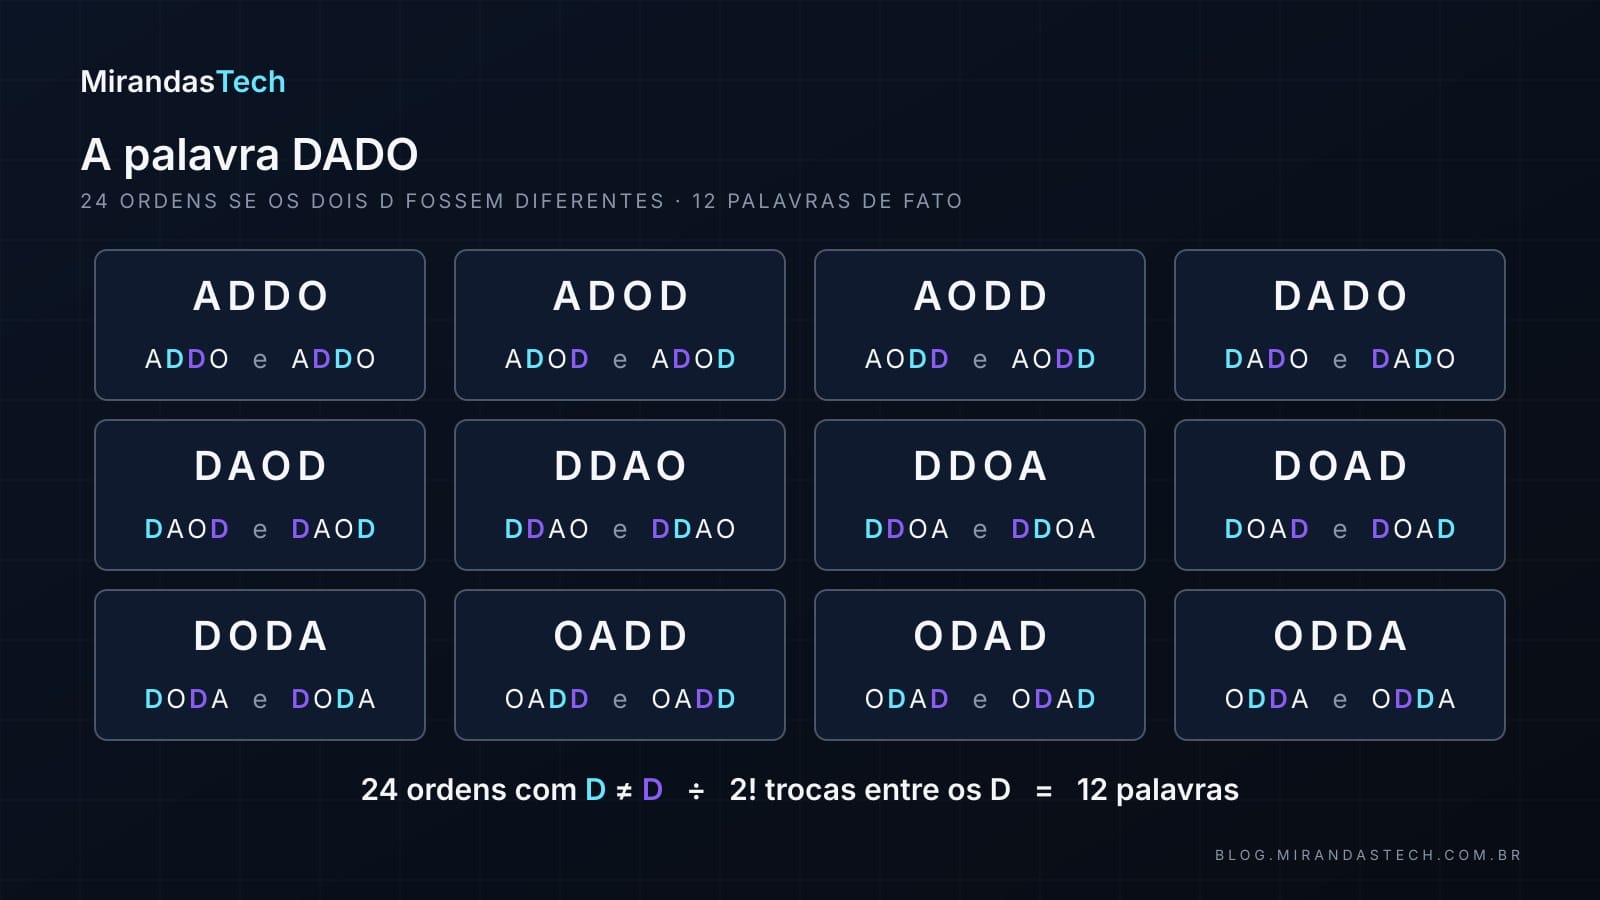
As 24 permutações contam cada palavra duas vezes, uma para cada ordem dos dois D. Portanto há $4!/2!=12$ palavras distintas. Em geral, se $n$ posições contêm grupos de objetos indistinguíveis com quantidades $n_1,n_2,\ldots,n_r$, com $n_1+\cdots+n_r=n$, o número de sequências distintas é
$$ \frac{n!}{n_1!\,n_2!\cdots n_r!}. $$
Esse quociente é o coeficiente multinomial e volta a aparecer na Aula 07 da série, na distribuição multinomial.
8. Qual fórmula usar?
Com as duas perguntas da ideia-chave, as fórmulas deixam de ser uma lista para decorar e viram uma árvore de decisão. As quatro primeiras e a multinomial estão nos capítulos de contagem dos livros-texto (Bertsekas & Tsitsiklis, 2008; Blitzstein & Hwang, 2019); a de multiconjuntos, em Stanley (2011).
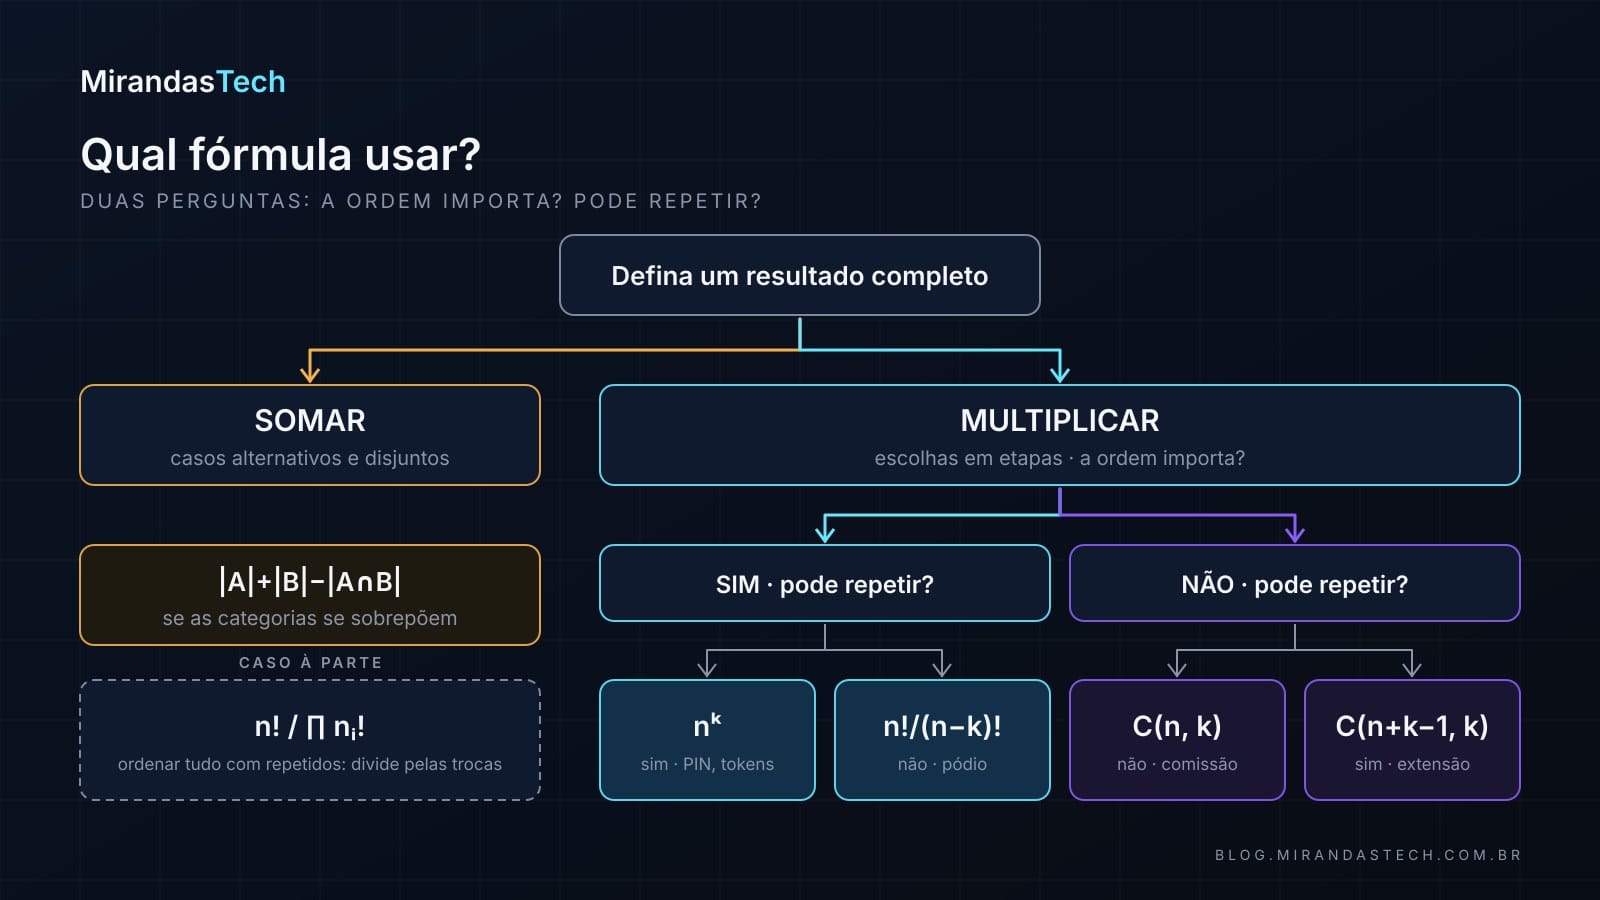
- Ordem importa, repetição permitida: sequência de $k$ posições, $n$ opções em cada: $n^k$.
- Ordem importa, sem repetição: $k$ posições com elementos distintos: $P(n,k)=\dfrac{n!}{(n-k)!}$.
- Ordem não importa, sem repetição: subconjunto de tamanho $k$: $\dbinom nk=\dfrac{n!}{k!\,(n-k)!}$.
- Ordem não importa, repetição permitida: multiconjunto de tamanho $k$ entre $n$ tipos: $\dbinom{n+k-1}{k}$ (Stanley, 2011).
- Ordenar tudo, com objetos repetidos em quantidades $n_i$: $\dfrac{n!}{\prod_i n_i!}$.
O caso das combinações com repetição entra aqui como extensão: os tipos são distinguíveis, a ordem das escolhas não importa e cada tipo pode aparecer várias vezes. Para $n=4$ tipos e $k=2$, são $\binom{5}{2}=10$ multiconjuntos: os 6 pares da grade da seção 5 mais os 4 da diagonal.
Antes de escolher a fórmula, vale seguir sete passos, nesta ordem. Defina o que é um resultado completo: sequência, grupo, grade, distribuição? Separe casos disjuntos e some-os. Separe etapas e multiplique-as. Pergunte se trocar posições gera outro resultado (ordem). Pergunte se um elemento pode reaparecer (reposição). Teste num caso pequeno, enumerando à mão ou em código. E só então converta a contagem em probabilidade, depois de confirmar que os resultados são equiprováveis.
9. De contagem para probabilidade: o problema do lote
Se $\Omega$ é finito e seus resultados elementares são equiprováveis,
$$ P(A)=\frac{|A|}{|\Omega|}. $$
Contar corretamente não basta; a hipótese de equiprobabilidade é indispensável. Com as duas peças na mão, dá para voltar ao lote da abertura: 20 peças, 5 defeituosas e 15 adequadas, uma amostra uniforme de 4 sem reposição e o evento $A$ = “exatamente 2 defeituosas”.
Passo 1, total de amostras. A ordem de retirada não faz parte do resultado final; o que importa é quais peças estão na amostra. Então
$$ |\Omega|=\binom{20}{4}=4\,845. $$
Passo 2, amostras favoráveis. Escolhemos 2 das 5 defeituosas e 2 das 15 adequadas. O “e” entre duas escolhas feitas em etapas separadas é o princípio multiplicativo:
$$ |A|=\binom52\binom{15}{2}=10\cdot105=1\,050. $$
Passo 3, probabilidade. Como a amostra é uniforme entre todos os subconjuntos de tamanho quatro,
$$ P(A)=\frac{1\,050}{4\,845}=\frac{70}{323}\approx0{,}2167. $$
A chance é de aproximadamente 21,67%. O mesmo raciocínio vale para qualquer número de defeituosas na amostra, de 0 a 4, e o resultado é uma distribuição inteira, que a figura compara com uma simulação.
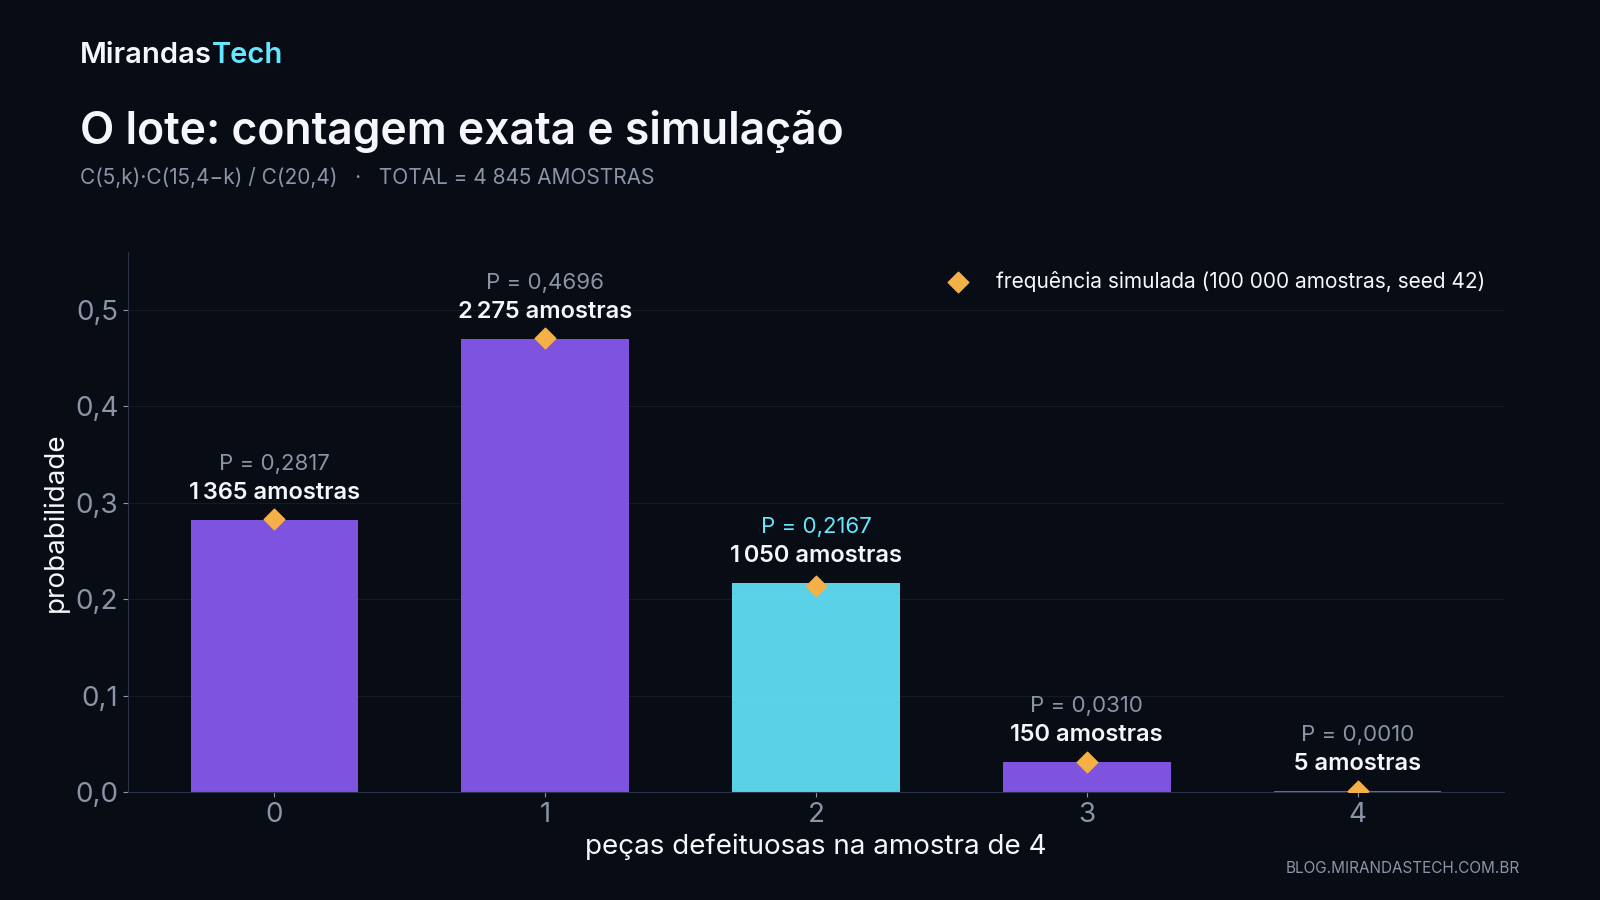
Essa distribuição, a do número de defeituosas numa amostra uniforme sem reposição, tem nome: hipergeométrica. Ela é o modelo de qualquer amostragem aleatória simples sem reposição, em que todo grupo de mesmo tamanho tem a mesma chance, de uma população com dois tipos de item (Bertsekas & Tsitsiklis, 2008), como auditoria de lotes ou amostras de rotulagem para conferência humana.
Por que não multiplicar direto $(5/20)(4/19)$? Porque isso descreve só duas retiradas e ignora em que posições as peças adequadas aparecem. A abordagem sequencial exige somar todas as $\binom42=6$ ordens compatíveis; a combinatória agrupa essas ordens de um jeito mais limpo, e as duas dão o mesmo $70/323$.
10. Possível não é provável
Um classificador acerta um caso com probabilidade $0{,}8$ em cada execução, e as execuções são independentes. Em três execuções, qual a probabilidade de pelo menos um acerto? O caminho mais curto é o complemento: “nenhum acerto” só acontece na sequência FFF, e
$$ \begin{aligned} &P(\text{ao menos um acerto})\\ &\quad=1-P(\text{nenhum})\\ &\quad=1-(0{,}2)^3=0{,}992. \end{aligned} $$
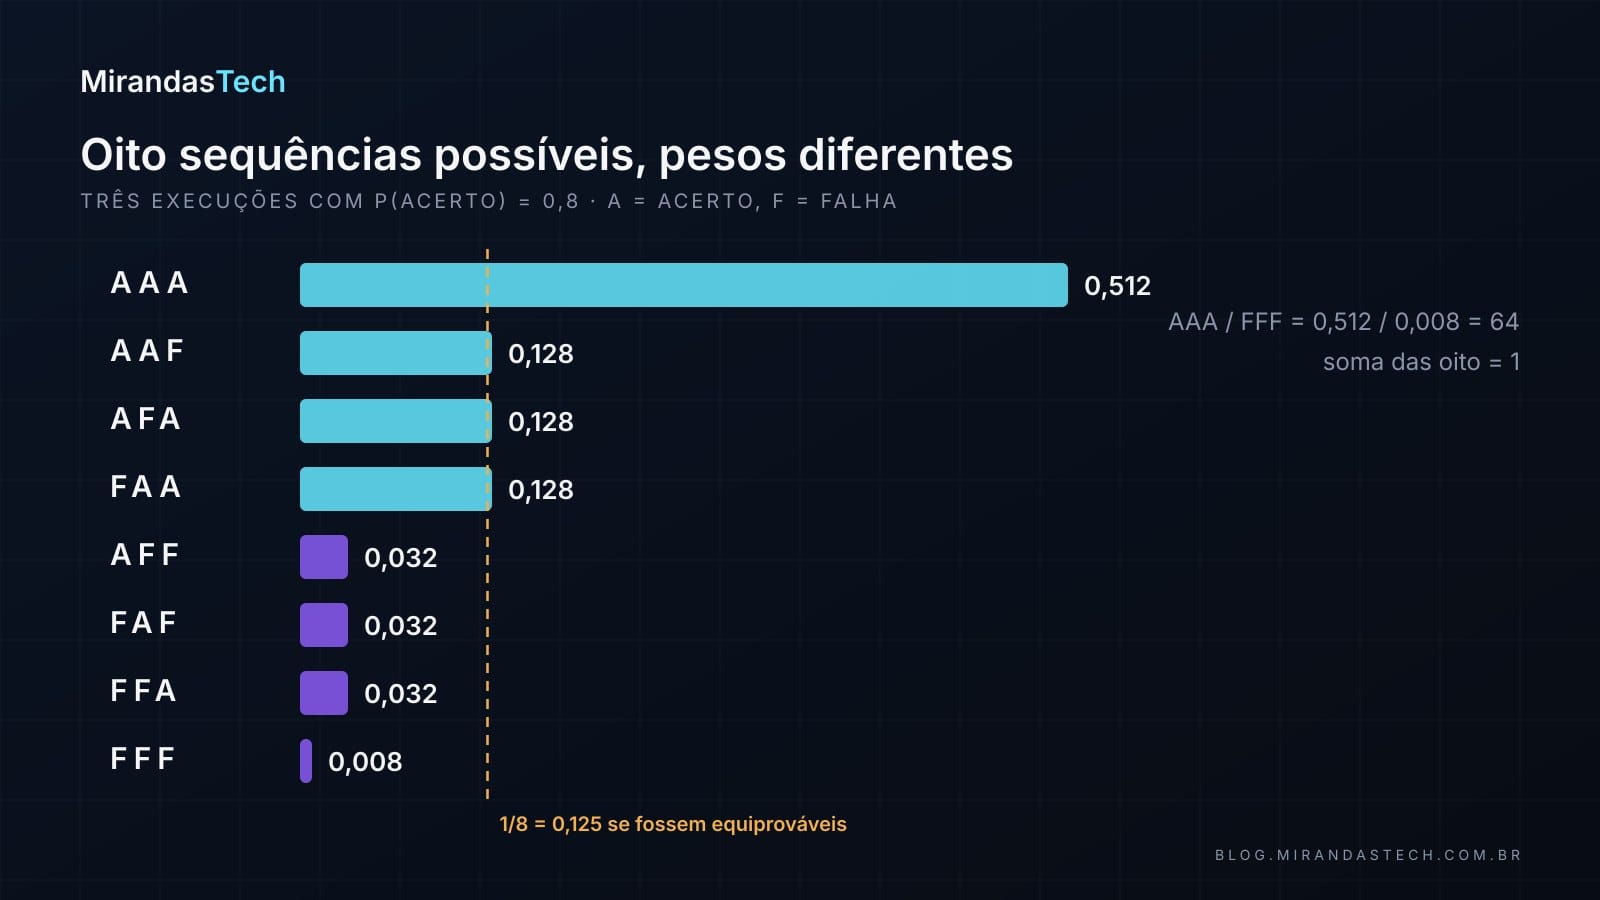
O exemplo mostra que contagem e probabilidade não são a mesma operação. As oito sequências de acerto e falha são todas possíveis, mas não equiprováveis quando $P(\text{acerto})=0{,}8$: AAA tem probabilidade $0{,}512$ e FFF, $0{,}008$. Contar 7 sequências com pelo menos um acerto entre 8 possíveis e dividir daria $7/8=0{,}875$, um número errado com cara de certo. A independência será formalizada na Aula 03, e a distribuição binomial, que conta essas sequências com pesos, na Aula 07.
11. Onde a combinatória aparece em IA
As quatro situações abaixo têm o mesmo formato: um espaço de configurações que cresce por multiplicação e uma tentação de tratá-lo como se todas as configurações fossem iguais.
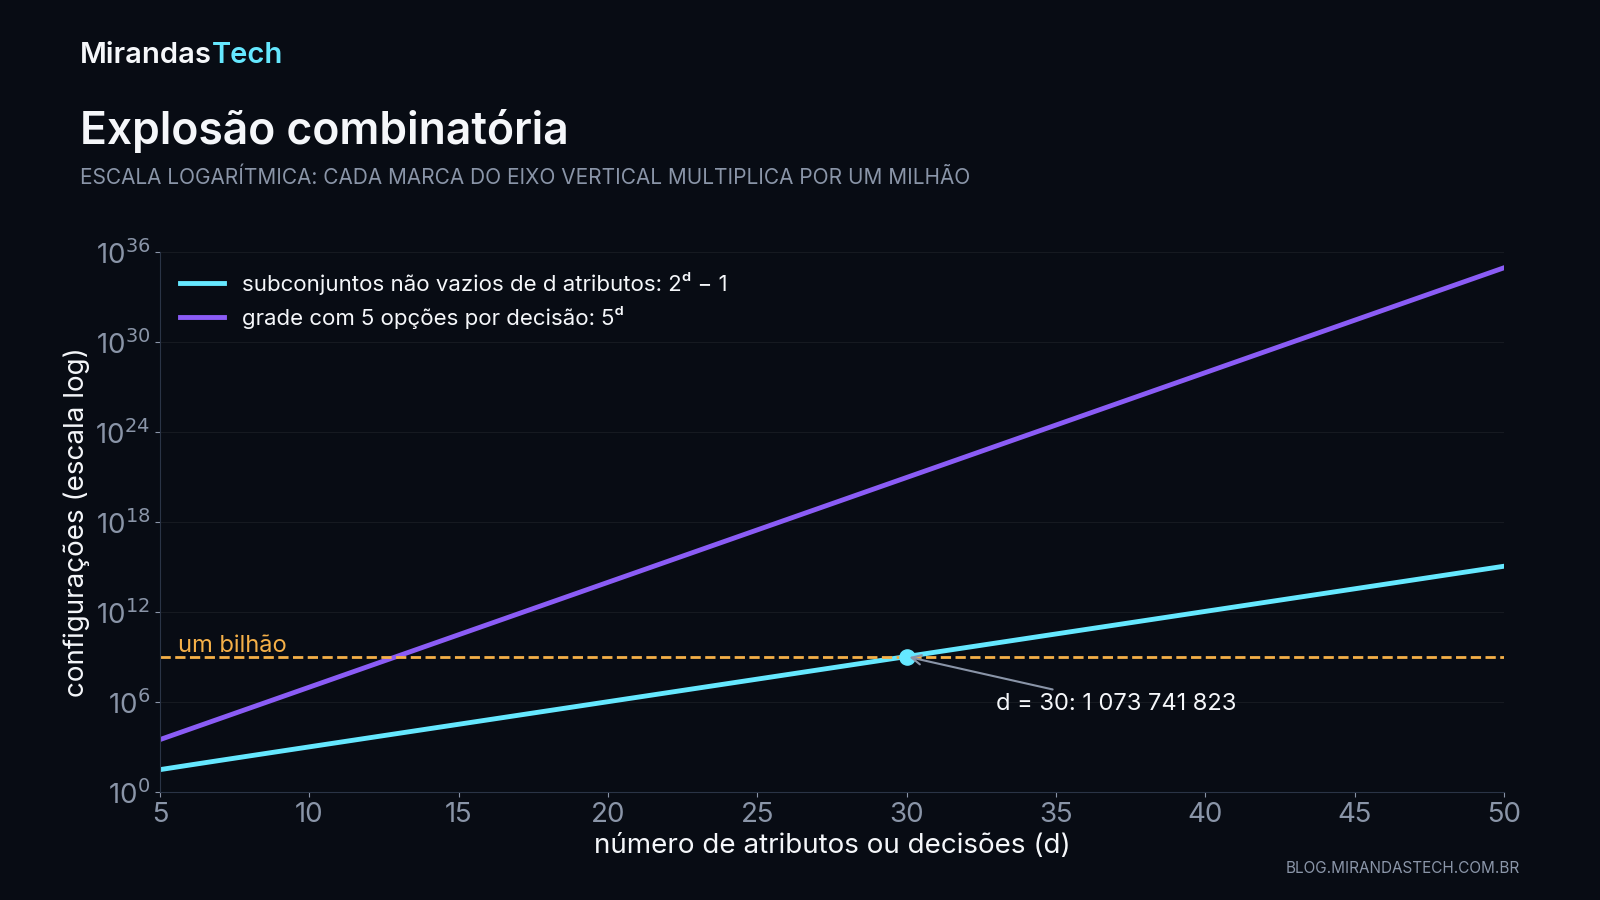
Espaço de sequências. Um vocabulário de 50 mil tokens tem $50\,000^{20}\approx9{,}5\times10^{93}$ sequências brutas de comprimento 20. Modelos de linguagem não enumeram esse espaço: fatoram a probabilidade de uma sequência em probabilidades condicionais, token a token, e usam estratégias de decodificação para escolher o que gerar (Bengio et al., 2003; Holtzman et al., 2020). É o exemplo mais claro de por que “quantas existem” e “quão prováveis são” são perguntas separadas.
Seleção de atributos. Com $d$ atributos, há $2^d-1$ subconjuntos não vazios. Testar todos pode ser caro e, se a escolha for feita olhando o conjunto de teste, produz uma estimativa otimista do desempenho (Cawley & Talbot, 2010). Esse vazamento aparece com mais detalhe no artigo sobre pré-processamento, pipelines e data leakage.
Divisões de dados. Para $n$ observações distintas, escolher $n_{tr}$ para treino e depois $n_{val}$ entre as restantes gera
$$ \binom{n}{n_{tr}}\binom{n-n_{tr}}{n_{val}} $$
divisões rotuladas treino, validação e teste. A contagem não garante que uma divisão seja boa: grupos, tempo, estratificação e dependência entre observações impõem restrições que nenhum sorteio uniforme respeita sozinho. É o tema do artigo sobre features, target, split e baseline.
Busca de hiperparâmetros. Uma grade com 4 taxas de aprendizado, 3 tamanhos de lote e 5 valores de regularização tem $4\cdot3\cdot5=60$ configurações. Cada nova dimensão multiplica o custo da busca, e é por isso que busca aleatória costuma render mais por avaliação do que a grade completa quando poucos hiperparâmetros importam de fato (Bergstra & Bengio, 2012).
12. Na prática: contar, enumerar e simular em Python
O laboratório da aula, no notebook do AI Lab no Google Colab, faz três coisas: calcula contagens exatas, confere as fórmulas por enumeração num caso pequeno e compara a probabilidade exata do lote com uma simulação reproduzível. Precisa só de Python 3.10 ou mais recente e NumPy.
Contagens exatas e enumeração como teste
from math import comb, factorial, perm
from itertools import combinations, permutations, product

print(factorial(5), perm(10, 3), comb(10, 3))
assert factorial(0) == 1
assert comb(10, 3) == comb(10, 7)
assert sum(comb(10, k) for k in range(11)) == 2**10

itens = "ABCD"
# com ordem e repetição; com ordem, sem repetição; sem ordem
print(len(list(product(itens, repeat=2))),
      len(list(permutations(itens, 2))),
      len(list(combinations(itens, 2))))
assert len(list(combinations(itens, 2))) == comb(4, 2)

# ordenações distintas de DADO
print(len(set(permutations("DADO"))))
Saída (Python 3.13):
120 720 120
16 12 6
12
math.comb e math.perm devolvem inteiros exatos, sem construir fatoriais enormes nem passar por ponto flutuante. A segunda linha é a grade da seção 5 contada por itertools; a terceira, as 12 palavras de DADO, obtidas gerando as 24 permutações e jogando fora as repetidas com set. Materializar listas assim serve para validar fórmulas em casos pequenos. Para espaços grandes, calcule a quantidade sem gerar as configurações.
O lote: probabilidade exata contra simulação
from math import comb
import numpy as np

total = comb(20, 4)
favoraveis = comb(5, 2) * comb(15, 2)
p_exata = favoraveis / total
print(total, favoraveis, f"{p_exata:.6f}")

rng = np.random.default_rng(42)
N = 100_000
# uma nota aleatória por item; as 4 menores formam a amostra
pontuacoes = rng.random((N, 20))
amostras = np.argpartition(pontuacoes, 3, axis=1)[:, :4]
# índices 0 a 4 = defeituosas
qtd_defeituosos = (amostras < 5).sum(axis=1)
p_simulada = np.mean(qtd_defeituosos == 2)
print(f"{p_simulada:.6f}", f"{abs(p_simulada - p_exata):.6f}")
Saída (Python 3.13, NumPy 2.2):
4845 1050 0.216718
0.214010 0.002708
A simulação sorteia uma nota contínua para cada uma das 20 peças e fica com as quatro menores. Como empates são praticamente impossíveis (probabilidade da ordem de $10^{-14}$), cada subconjunto de quatro índices tem a mesma chance de ser escolhido: é uma amostra uniforme sem reposição. Os índices 0 a 4 fazem o papel das defeituosas. Em 100 mil repetições, a frequência de “exatamente duas” ficou em 0,2140, a 0,0027 do valor exato, cerca de dois erros-padrão (com 100 mil repetições, o erro-padrão é $\sqrt{0{,}217\cdot0{,}783/100\,000}\approx0{,}0013$). A seed torna a execução reproduzível; ela não é uma hipótese do modelo. E a simulação aproxima o valor exato, não o substitui: quem prova o $70/323$ é a contagem.
Para ir além: troque itens por cinco símbolos e confira $5^2$, $P(5,2)$ e $\binom52$; valide por enumeração que BANANA tem 60 ordenações distintas; e refaça o lote com 30 peças, 6 defeituosas e amostra de 5, calculando e simulando a probabilidade de exatamente uma defeituosa.
13. Erros comuns e como corrigi-los
Contar a ordem quando ela não importa. Usar $P(10,3)=720$ para formar uma equipe de três pessoas conta cada equipe $3!=6$ vezes. A resposta é $\binom{10}{3}=120$.
Ignorar a reposição. Uma senha pode repetir símbolos; uma amostra sem reposição, não. Escrever $n^k$ no segundo caso mantém opções que já deveriam ter desaparecido.
Somar casos sobrepostos. $|A|+|B|$ só funciona direto para categorias disjuntas. Com sobreposição, subtraia $|A\cap B|$.
Dividir contagens sem equiprobabilidade. Numa roleta com setores de áreas diferentes, três setores não implicam probabilidade $1/3$ para cada um. O mesmo vale para as sequências de acerto e falha da seção 10.
Materializar um espaço enorme. list(product(vocabulario, repeat=20)) esgota a memória muito antes de terminar. Prefira fórmulas e iteradores, e use a enumeração só como teste.
Usar fatorial em ponto flutuante. Fatoriais crescem rápido demais para float. Para contagens, use inteiros exatos (math.comb, math.perm). Em modelos probabilísticos de grande escala, probabilidades de sequências longas são produtos de muitos números pequenos e costumam ser tratadas no domínio logarítmico para evitar underflow (Goodfellow et al., 2016); o tema volta nas aulas de teoria da informação.
Misturar “possível” com “provável”. A contagem diz quantos resultados satisfazem uma descrição. A probabilidade exige, além disso, uma lei que dê peso a cada resultado. Antes de aceitar uma contagem, confirme: defini o resultado completo; separei casos disjuntos e etapas; decidi explicitamente sobre ordem e reposição; corrigi objetos indistinguíveis; validei um caso pequeno; e, antes de dividir, justifiquei a equiprobabilidade.
14. Exercícios
- Um menu oferece 3 entradas, 5 pratos principais e 2 sobremesas. Quantas refeições com um item de cada categoria existem?
- Quantos códigos de três letras podem ser formados com o alfabeto de 26 letras: (a) com repetição; (b) sem repetição?
- De oito modelos candidatos, quantos pódios de três posições existem? Quantos grupos de três, sem posição?
- Quantas ordenações distintas existem para a palavra
BANANA? - Um dataset tem 12 atributos. Quantos subconjuntos não vazios de atributos podem ser testados?
- Cinco itens são escolhidos uniformemente, sem reposição, de um lote com 30 itens, dos quais 6 são defeituosos. Qual a probabilidade de obter exatamente um defeituoso?
- Uma moeda com $P(C)=0{,}7$ é lançada duas vezes. É correto dizer que as quatro sequências
CC,CK,KC,KKtêm probabilidade $1/4$ porque existem quatro? Explique e calcule suas probabilidades, assumindo lançamentos independentes. - Uma equipe de três pessoas deve conter exatamente uma pessoa de segurança, escolhida entre 4 especialistas de segurança, e as outras duas entre 8 especialistas de dados. Quantas equipes são possíveis?
- Explique por que $\binom n0=1$ e por que isso é coerente com $0!=1$.
- Uma grade de hiperparâmetros tem 5 arquiteturas, 4 taxas de aprendizado, 3 seeds e 2 estratégias de regularização. Quantas execuções são necessárias para testar o produto cartesiano inteiro? Cite uma razão metodológica para não escolher o melhor resultado olhando apenas o teste.
Respostas comentadas
- Pelo princípio multiplicativo, $3\cdot5\cdot2=30$ refeições.
- (a) $26^3=17\,576$. (b) $P(26,3)=26\cdot25\cdot24=15\,600$.
- Pódios: $P(8,3)=8\cdot7\cdot6=336$. Grupos: $\binom83=56$. Cada grupo corresponde a $3!=6$ pódios.
- São 6 letras, com
Arepetido 3 vezes eN2 vezes: $6!/(3!\,2!)=60$. - $2^{12}-1=4\,095$. Subtrai-se o conjunto vazio.
- Favoráveis: $\binom61\binom{24}{4}=63\,756$. Total: $\binom{30}{5}=142\,506$. Logo, $P\approx0{,}4474$.
- Não. Possibilidade não implica equiprobabilidade. Sob independência: $P(CC)=0{,}49$, $P(CK)=P(KC)=0{,}21$ e $P(KK)=0{,}09$.
- Uma das 4 pessoas de segurança e duas das 8 de dados: $\binom41\binom82=4\cdot28=112$.
- Existe uma única escolha de zero elementos: o conjunto vazio. Pela fórmula, $\binom n0=n!/(0!\,n!)$ só vale 1 se $0!=1$.
- $5\cdot4\cdot3\cdot2=120$ execuções. Usar repetidamente o teste para escolher configurações vaza informação do teste para a seleção e produz uma estimativa otimista; a Aula 12 da série aprofunda o tema.
Desafio de transferência
Escolha um problema do seu contexto, como seleção de sensores, escalas de equipe, configurações de pipeline ou amostragem para auditoria, e responda por escrito: o que é um resultado completo; quais são as etapas de escolha; se a ordem importa, e por quê; se há repetição ou reposição; quais restrições existem; qual a fórmula candidata; qual caso pequeno serve para validá-la; se os resultados são equiprováveis; e o que a contagem não informa sobre o problema.
O que guardar
Contar é decidir o que conta como resultado diferente. Alternativas disjuntas somam; etapas multiplicam. A ordem importar ou não, e a repetição ser permitida ou não, escolhem entre $n^k$, $P(n,k)$, $\binom nk$ e $\binom{n+k-1}{k}$; objetos repetidos dividem por $\prod n_i!$. Um conjunto de $n$ elementos tem $2^n$ subconjuntos. Contagem vira probabilidade por $|A|/|\Omega|$ só quando os resultados são equiprováveis, e é justamente isso que falta nos grandes espaços da IA: há $V^L$ sequências de tokens, mas um modelo de linguagem não as trata como iguais.
Na Aula 03, Probabilidade condicional e independência, o universo de referência passa a ser restringido pelo que foi observado: $P(A\mid B)$, regra do produto, probabilidade total e a diferença entre eventos independentes e eventos mutuamente exclusivos.
Referências
- Blitzstein, Joseph K.; Hwang, Jessica. Introduction to Probability. 2. ed. Boca Raton: Chapman and Hall/CRC, 2019. Cap. 1, “Probability and counting”, p. 1–43. doi.org/10.1201/9780429428357
- Bertsekas, Dimitri P.; Tsitsiklis, John N. Introduction to Probability. 2. ed. Athena Scientific, 2008. §1.6, “Counting”, e Problema 61* (hipergeométrica). Capítulo 1 aberto pela editora: athenasc.com/Prob-2nd-Ch1.pdf
- Orloff, Jeremy; Bloom, Jonathan. Counting and Sets (Class 1b Reading). MIT OpenCourseWare, 18.05 Introduction to Probability and Statistics, primavera de 2022. ocw.mit.edu/courses/18-05-…/classes-reading-and-in-class-materials/
- Stanley, Richard P. Enumerative Combinatorics, Volume 1. 2. ed. Cambridge University Press, 2011. §1.2, “Sets and multisets”. doi.org/10.1017/cbo9781139058520
- Kohavi, Ron; John, George H. Wrappers for feature subset selection. Artificial Intelligence, 97(1–2), 273–324, 1997. doi.org/10.1016/s0004-3702(97)00043-x
- Cawley, Gavin C.; Talbot, Nicola L. C. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 11(70), 2079–2107, 2010. jmlr.org/papers/v11/cawley10a.html
- Bergstra, James; Bengio, Yoshua. Random Search for Hyper-Parameter Optimization. Journal of Machine Learning Research, 13(10), 281–305, 2012. jmlr.org/papers/v13/bergstra12a.html
- Bengio, Yoshua; Ducharme, Réjean; Vincent, Pascal; Jauvin, Christian. A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3, 1137–1155, 2003. jmlr.org/papers/v3/bengio03a.html
- Holtzman, Ari; Buys, Jan; Du, Li et al. The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR), 2020. arxiv.org/abs/1904.09751
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. Cambridge, MA: MIT Press, 2016. Cap. 4, §4.1, “Overflow and Underflow”, e cap. 5, §5.5, “Maximum Likelihood Estimation”. www.deeplearningbook.org/contents/numerical.html; www.deeplearningbook.org/contents/ml.html
- Python Software Foundation. math (funções
comb,perm,factorial) e itertools (product,permutations,combinations,combinations_with_replacement). Documentação oficial, Python 3.14, acesso em 25 set. 2026. docs.python.org/3/library/math.html; docs.python.org/3/library/itertools.html - NumPy. Random Generator (
default_rng,Generator.random) e numpy.argpartition. Documentação oficial, v2.5, acesso em 25 set. 2026. numpy.org/doc/stable/reference/random/generator.html; numpy.org/doc/stable/reference/generated/numpy.argpartition.html

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 02-statistics/aulas/02-contagem-combinatoria.md.



