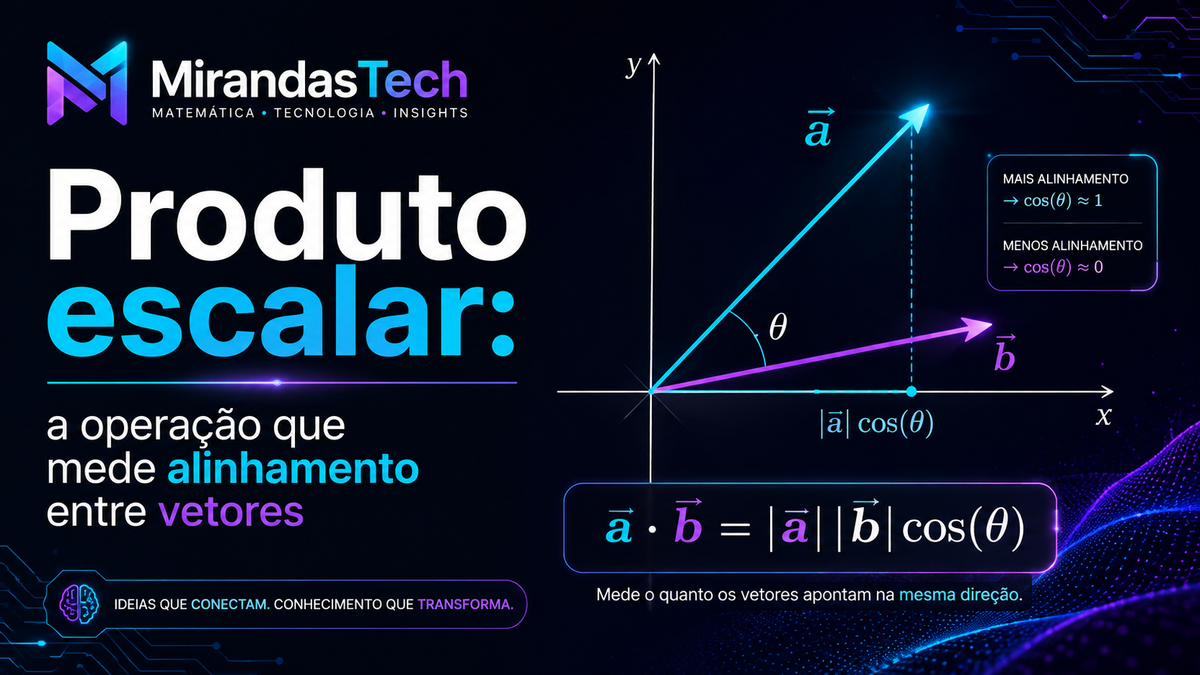
Produto escalar: a operação que mede alinhamento entre vetores
Entenda o produto escalar, sua interpretação geométrica e por que essa operação aparece em redes neurais, embeddings, busca vetorial, RAG e Transformers.

Matemática para IA - Parte 03
Na aula anterior, passamos a enxergar vetores como objetos geométricos: setas com direção e magnitude. Agora chegamos a uma operação simples na aparência, mas fundamental para compreender redes neurais, embeddings, busca vetorial e até o mecanismo de atenção dos Transformers: o produto escalar.
O produto escalar transforma dois vetores em um número que carrega informação sobre o alinhamento entre eles — mas também é influenciado por suas magnitudes.
Essa distinção será importante porque ela nos levará diretamente à similaridade de cosseno, uma das ferramentas mais conhecidas para comparar embeddings.
1. A conta básica: multiplicar e somar
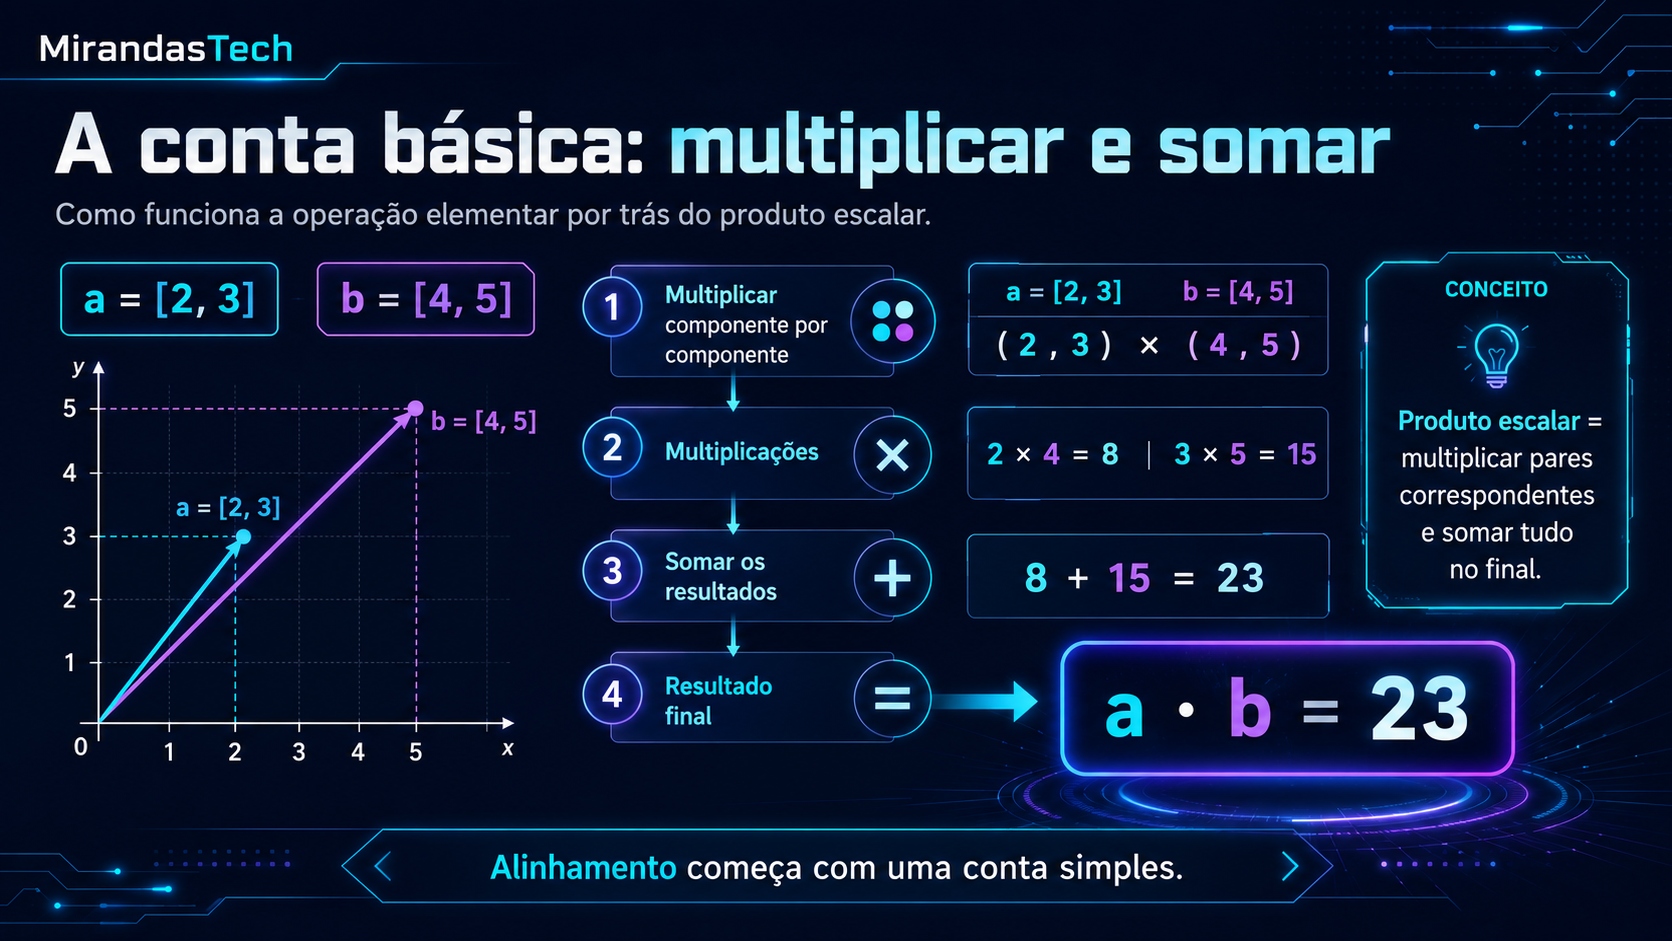
Considere dois vetores:
a = [2, 3]
b = [4, 1]
O produto escalar é calculado multiplicando componentes correspondentes e somando os resultados:
a · b = (2 × 4) + (3 × 1)
      = 8 + 3
      = 11
Entraram dois vetores e saiu apenas um número. Por isso o nome produto escalar.
Para vetores de dimensão n, a ideia geral é:
a · b = a₁b₁ + a₂b₂ + ... + aₙbₙ2. Produto escalar em NumPy
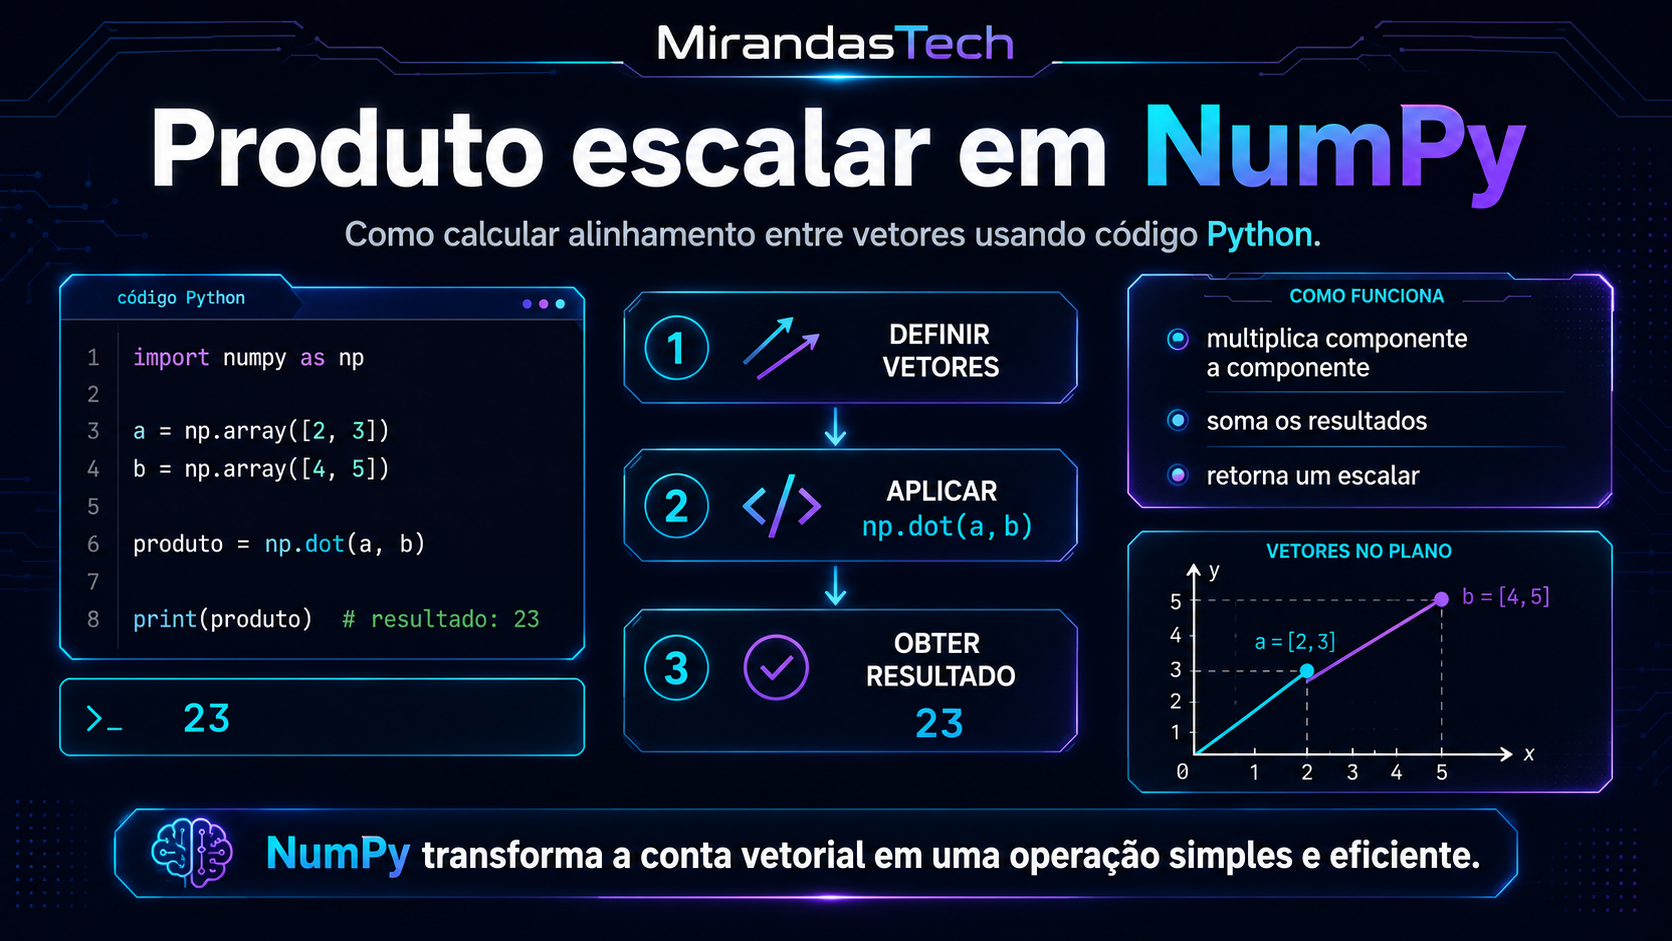
Em Python, usando NumPy:
import numpy as np

a = np.array([2, 3])
b = np.array([4, 1])

print(np.dot(a, b))
# 11

print(a @ b)
# 11
Para vetores, np.dot(a, b) e a @ b podem ser usados para calcular o produto escalar.
3. A interpretação geométrica
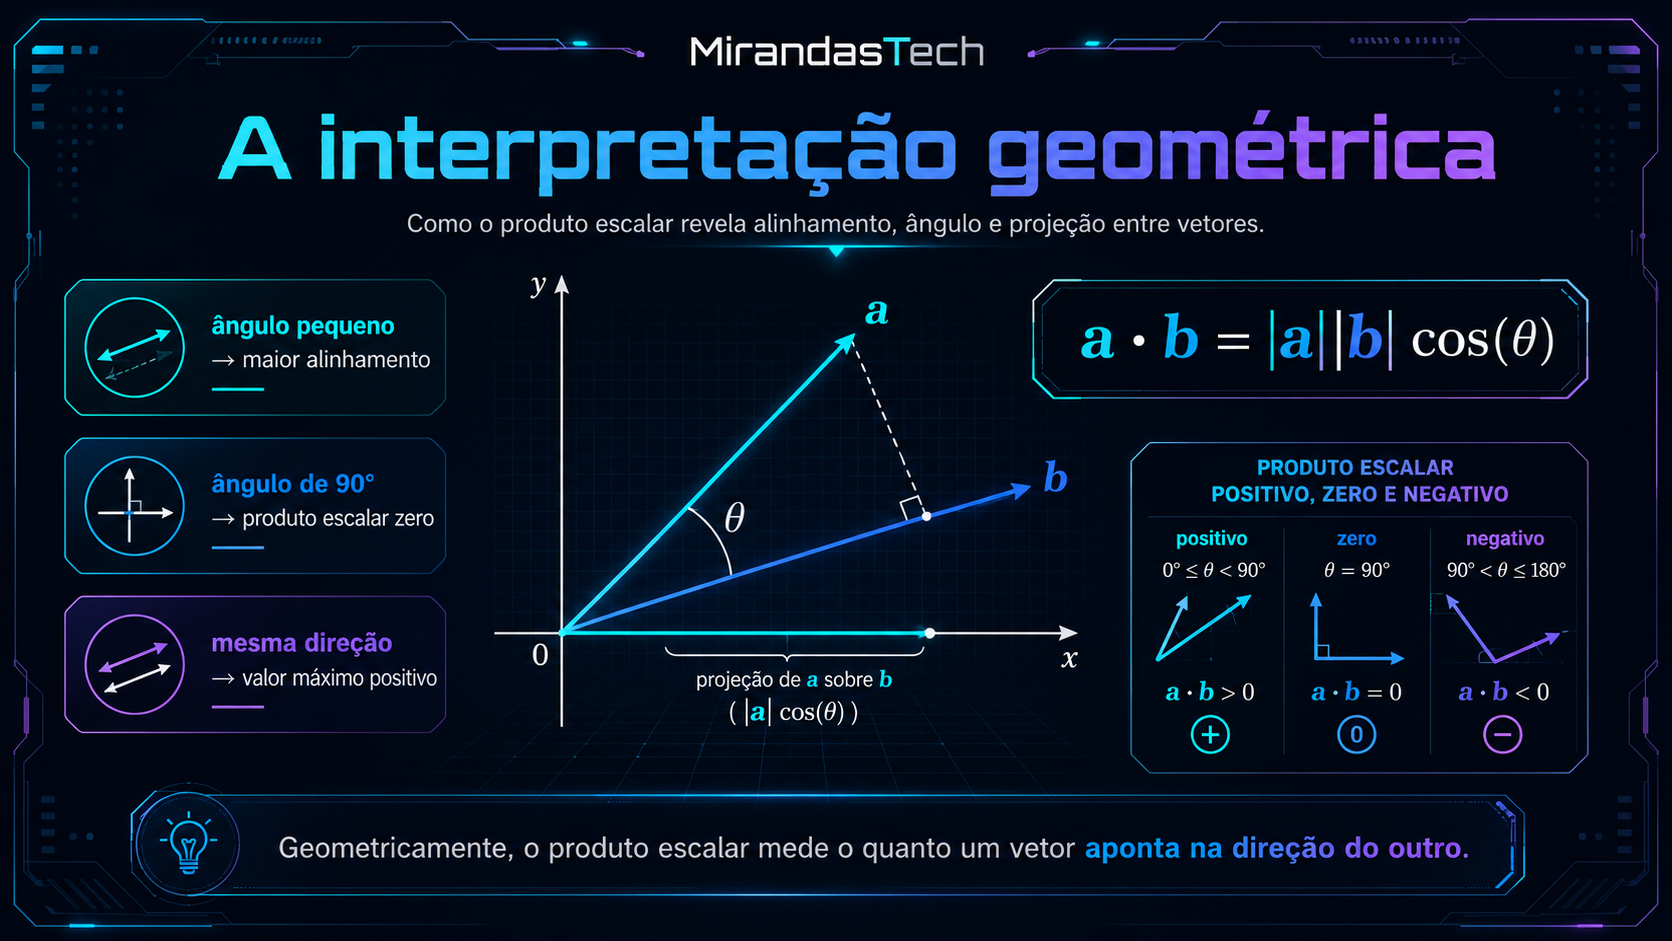
A importância dessa operação aparece quando usamos outra forma de escrevê-la:
a · b = ||a|| ||b|| cos(θ)Nessa expressão:
||a||é a magnitude do vetora;||b||é a magnitude do vetorb;θé o ângulo entre os dois vetores.
Ou seja, uma operação feita apenas com números também contém informação sobre a geometria entre os vetores.
4. O sinal do produto escalar
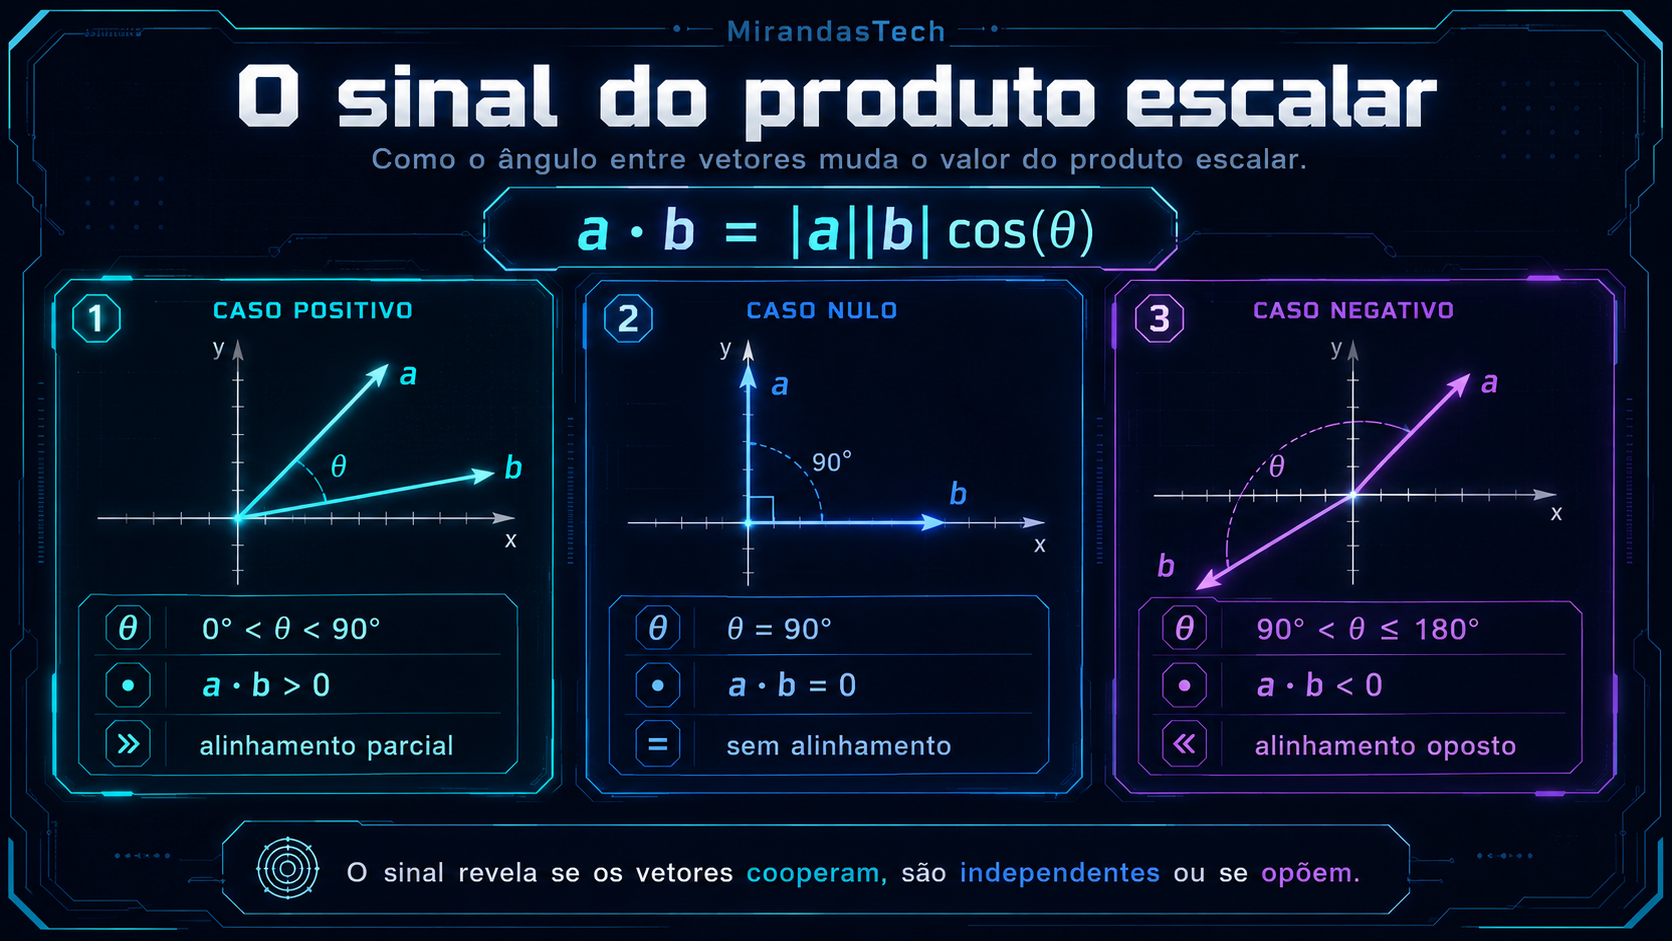
O sinal do resultado fornece uma pista imediata sobre o ângulo entre os vetores.
- Produto positivo: o ângulo entre eles é menor que 90°.
- Produto igual a zero: os vetores são perpendiculares.
- Produto negativo: o ângulo entre eles é maior que 90°.
Nos casos extremos, vetores na mesma direção possuem ângulo de 0°, enquanto vetores exatamente opostos possuem ângulo de 180°.
5. Mesma direção
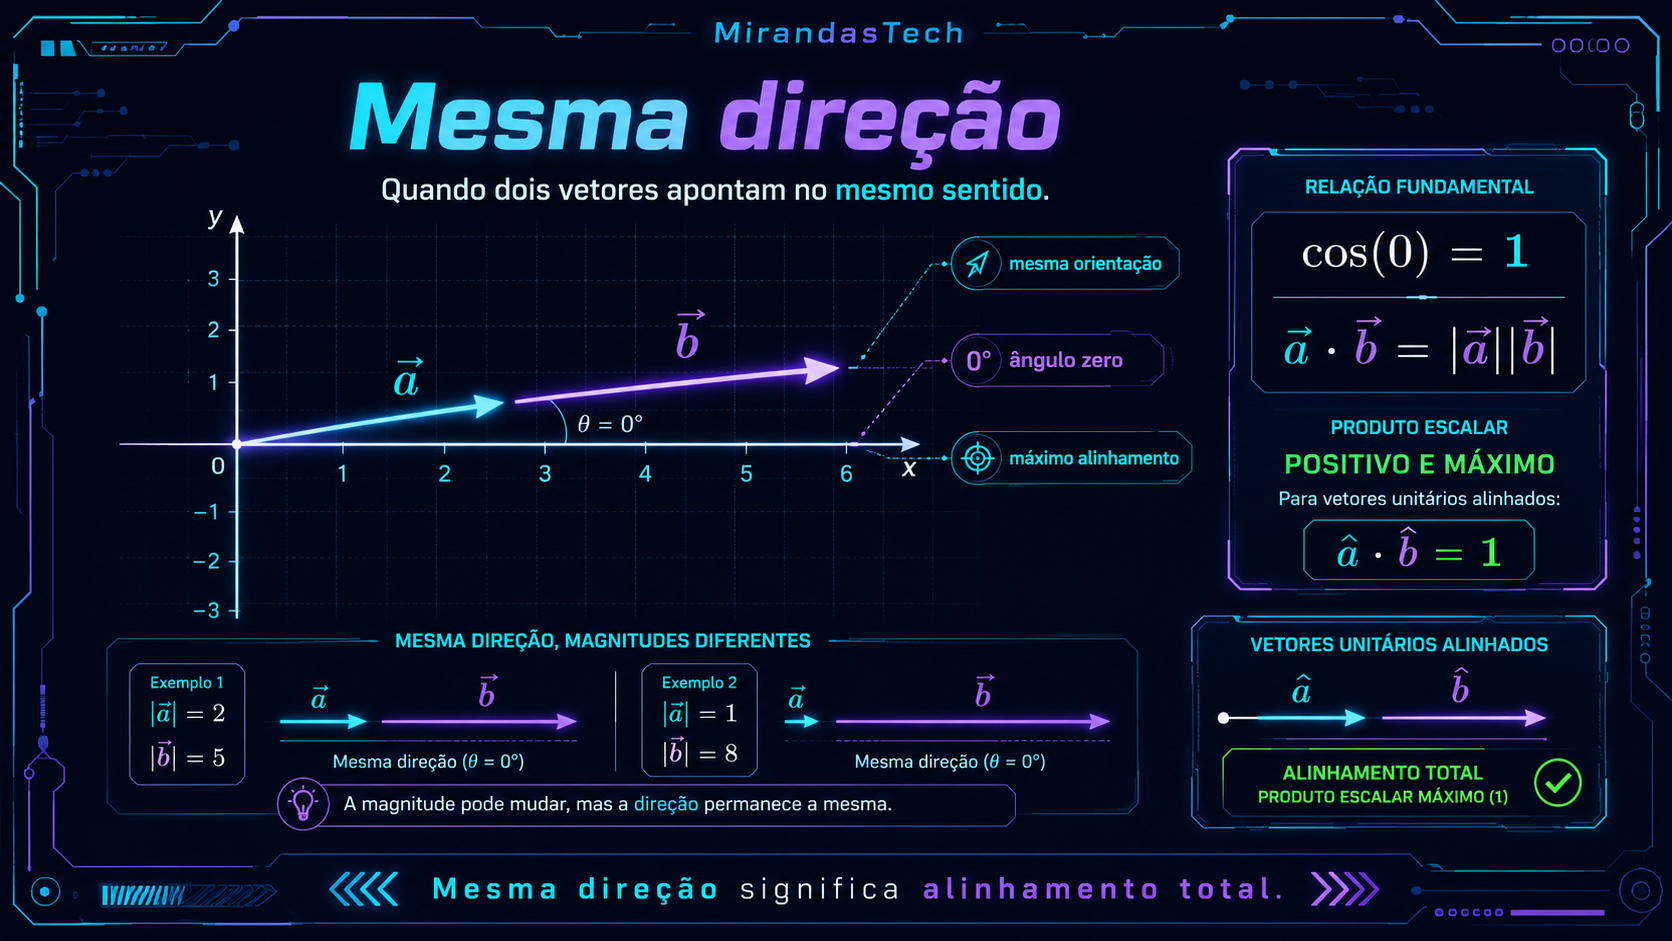
Considere:
a = [1, 2]
b = [2, 4]
O vetor b é exatamente duas vezes a:
b = 2aLogo, os dois apontam para a mesma direção.
a · b = (1 × 2) + (2 × 4)
      = 2 + 8
      = 10
O resultado é positivo. Como o ângulo é 0°, temos cos(0°) = 1.
6. Vetores perpendiculares
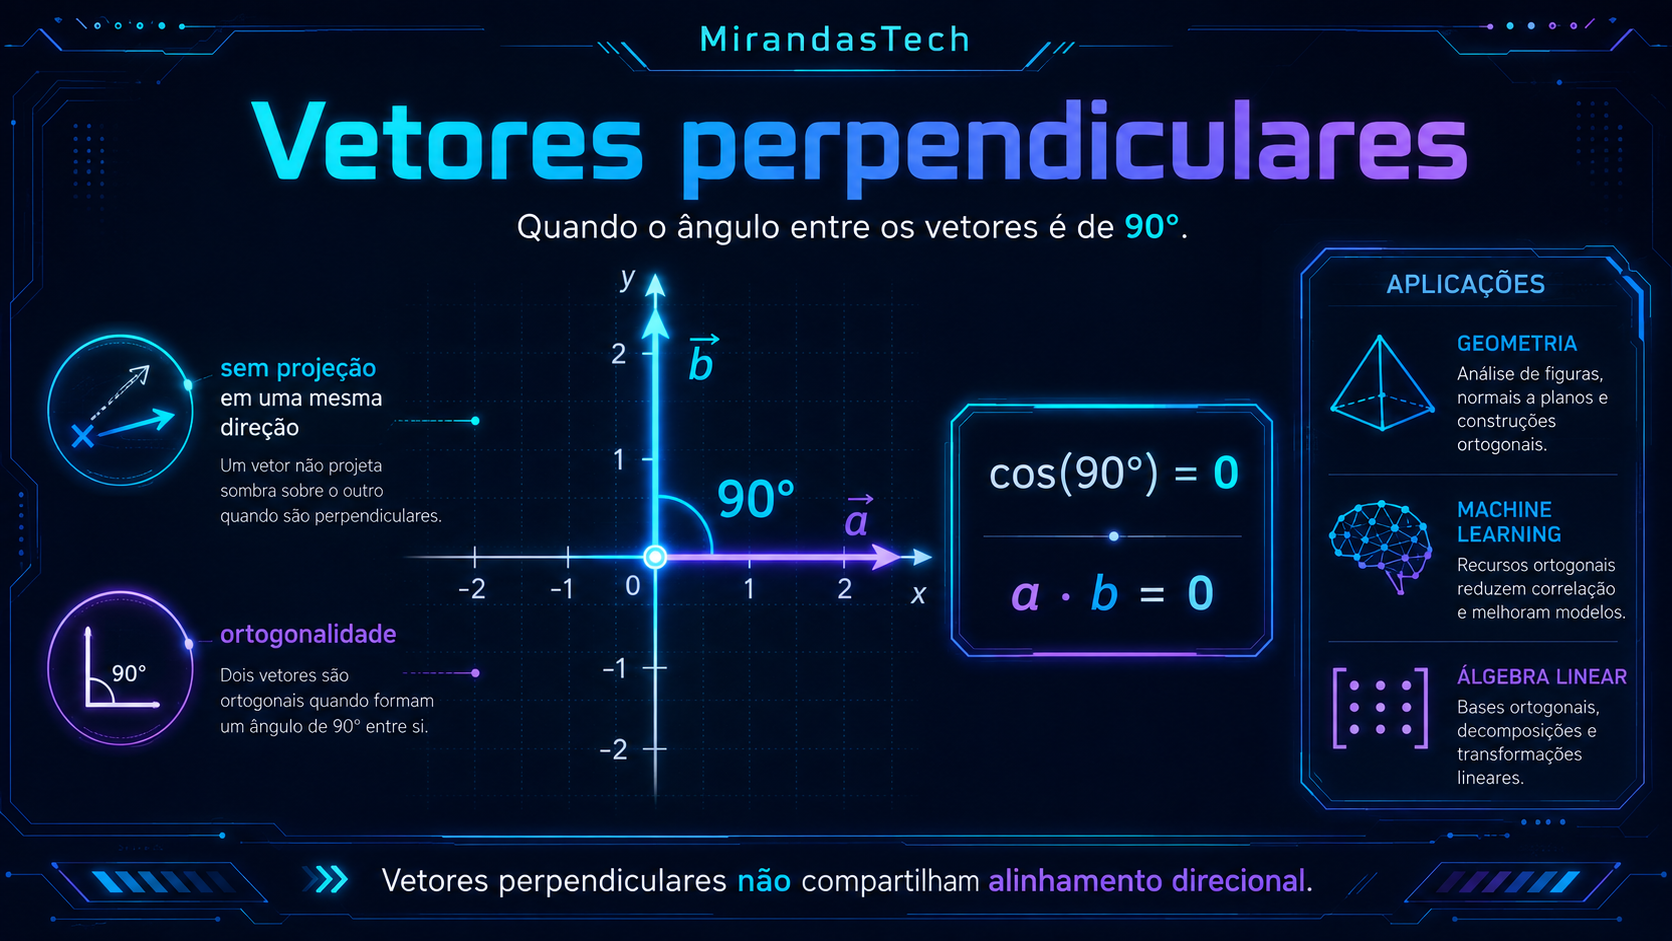
Agora considere:
a = [1, 0]
b = [0, 1]
Geometricamente, um vetor aponta no eixo horizontal e o outro no vertical. O ângulo entre eles é 90°.
a · b = (1 × 0) + (0 × 1)
      = 0
Portanto:
Vetores ortogonais possuem produto escalar igual a zero.
7. Direções opostas
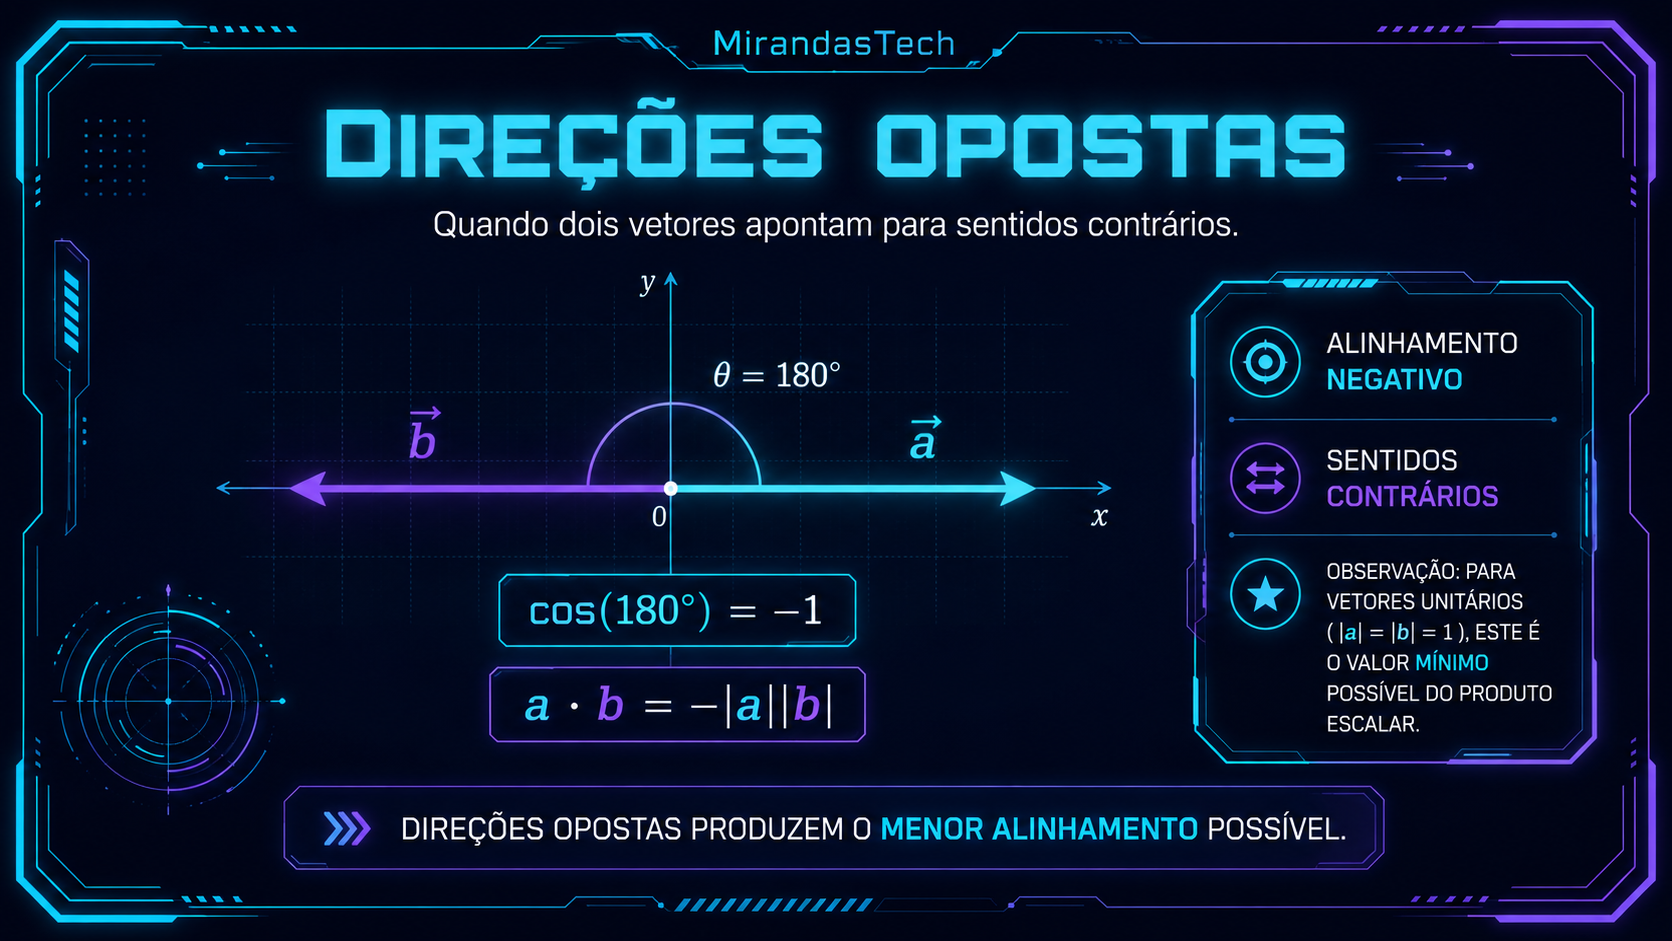
Considere:
a = [1, 0]
b = [-1, 0]
Os dois vetores estão sobre a mesma linha, mas apontam para sentidos opostos.
a · b = -1O ângulo entre eles é 180° e cos(180°) = -1.
8. O detalhe importante: a magnitude também interfere
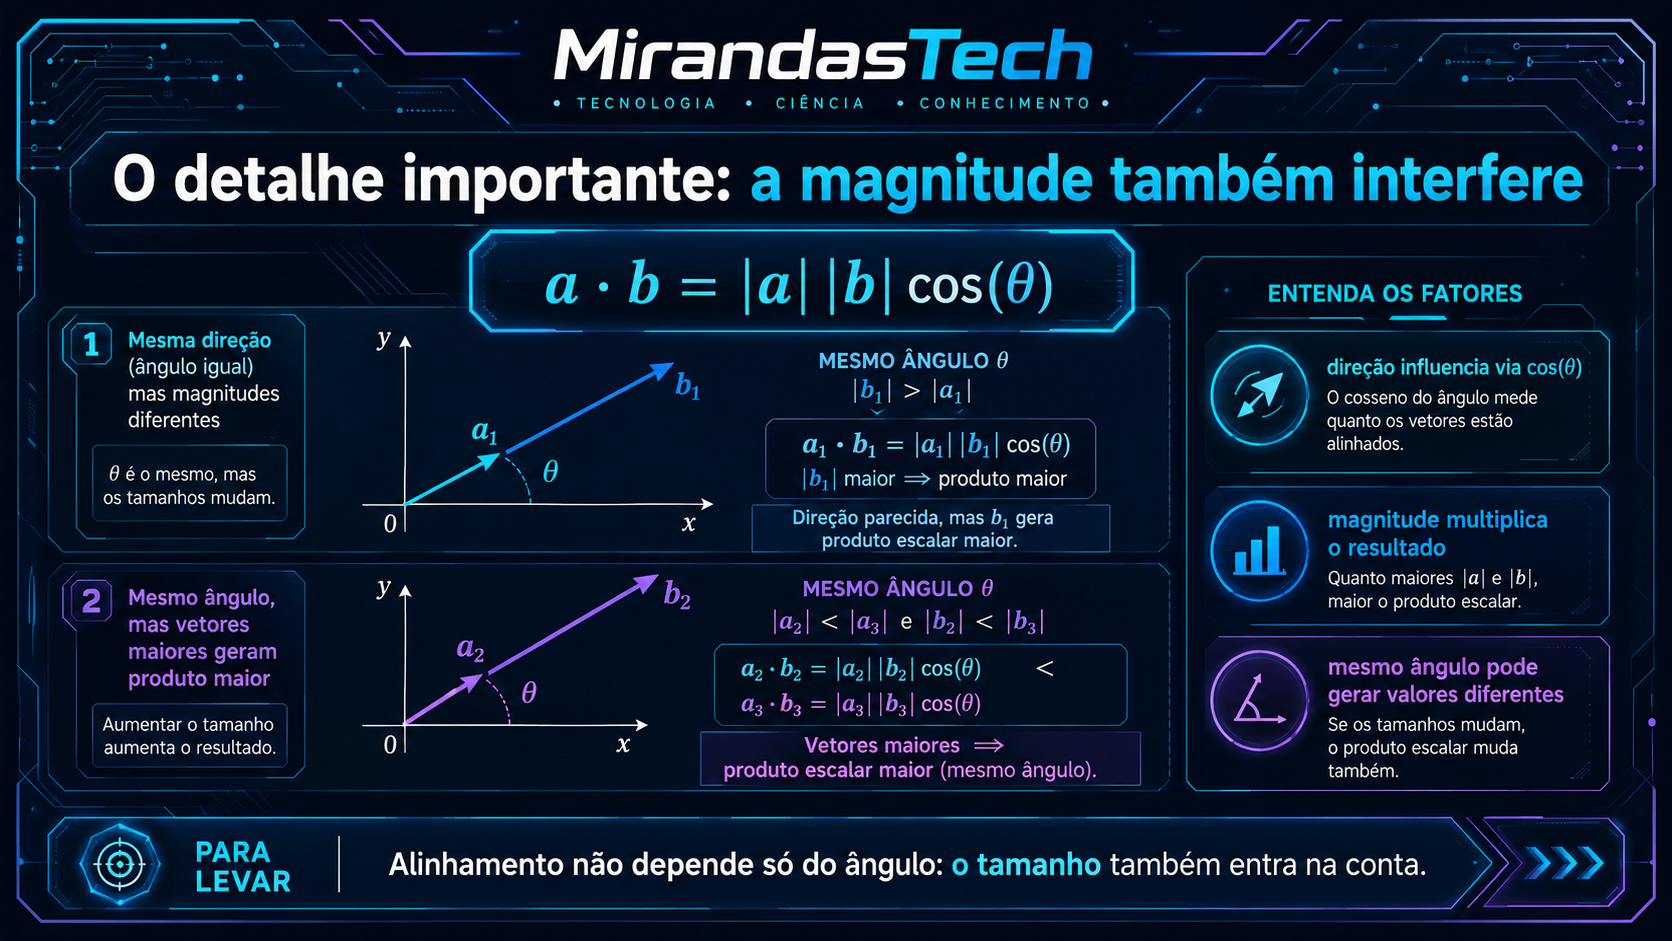
Considere novamente:
a = [1, 2]
b = [2, 4]
c = [100, 200]
Os vetores b e c apontam exatamente para a mesma direção de a. Mas:
a · b = 10

a · c = 500
Se a direção é a mesma, por que os resultados são tão diferentes?
Porque o produto escalar não mede apenas direção. Ele incorpora também as magnitudes:
a · b = ||a|| ||b|| cos(θ)Assim, aumentar o tamanho de um vetor pode aumentar muito o produto escalar, mesmo que sua direção não mude.
9. Daí nasce a similaridade de cosseno
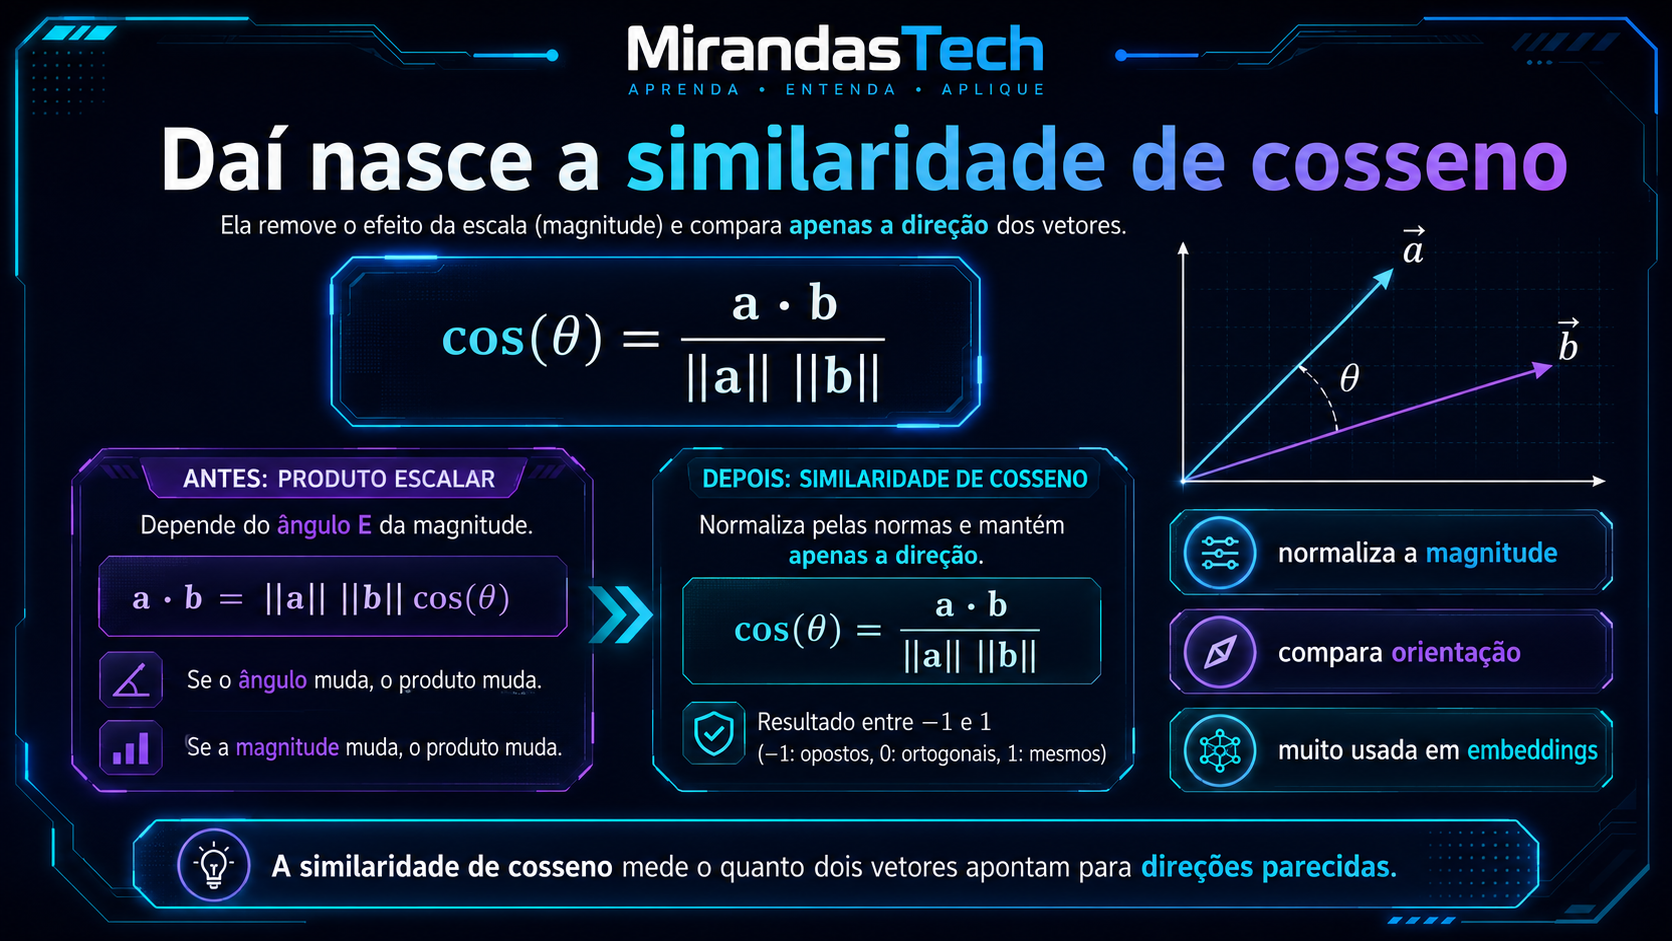
Se queremos concentrar a comparação na direção dos vetores, podemos remover o efeito das magnitudes.
Partimos de:
a · b = ||a|| ||b|| cos(θ)e isolamos o cosseno:
cos(θ) = (a · b) / (||a|| ||b||)Essa expressão é a base da similaridade de cosseno.
Observe a diferença conceitual:
- Produto escalar: alinhamento influenciado também pelo tamanho dos vetores.
- Similaridade de cosseno: alinhamento das direções após normalizar o efeito das magnitudes.
10. Exemplo: vetores na mesma direção
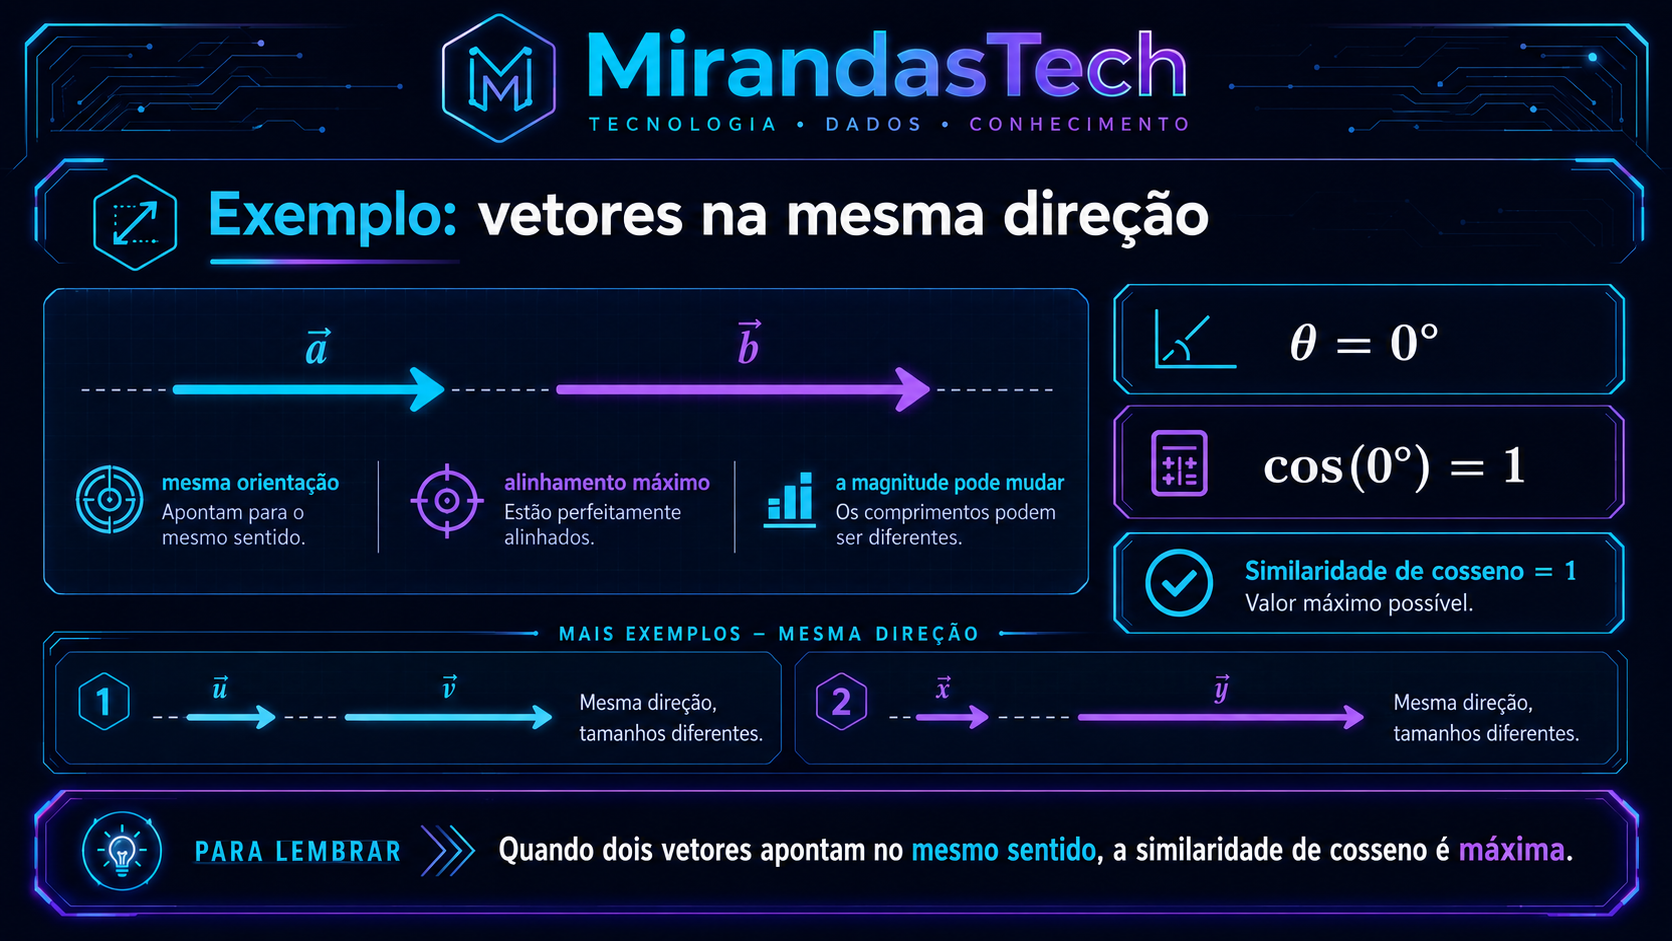
Para:
a = [1, 2]
b = [2, 4]
já calculamos:
a · b = 10As normas são:
||a|| = √5
||b|| = √20
Então:
cos(θ) = 10 / (√5 × √20)
       = 10 / 10
       = 1
O resultado 1 confirma que os vetores apontam exatamente para a mesma direção.
11. Como isso aparece em embeddings?
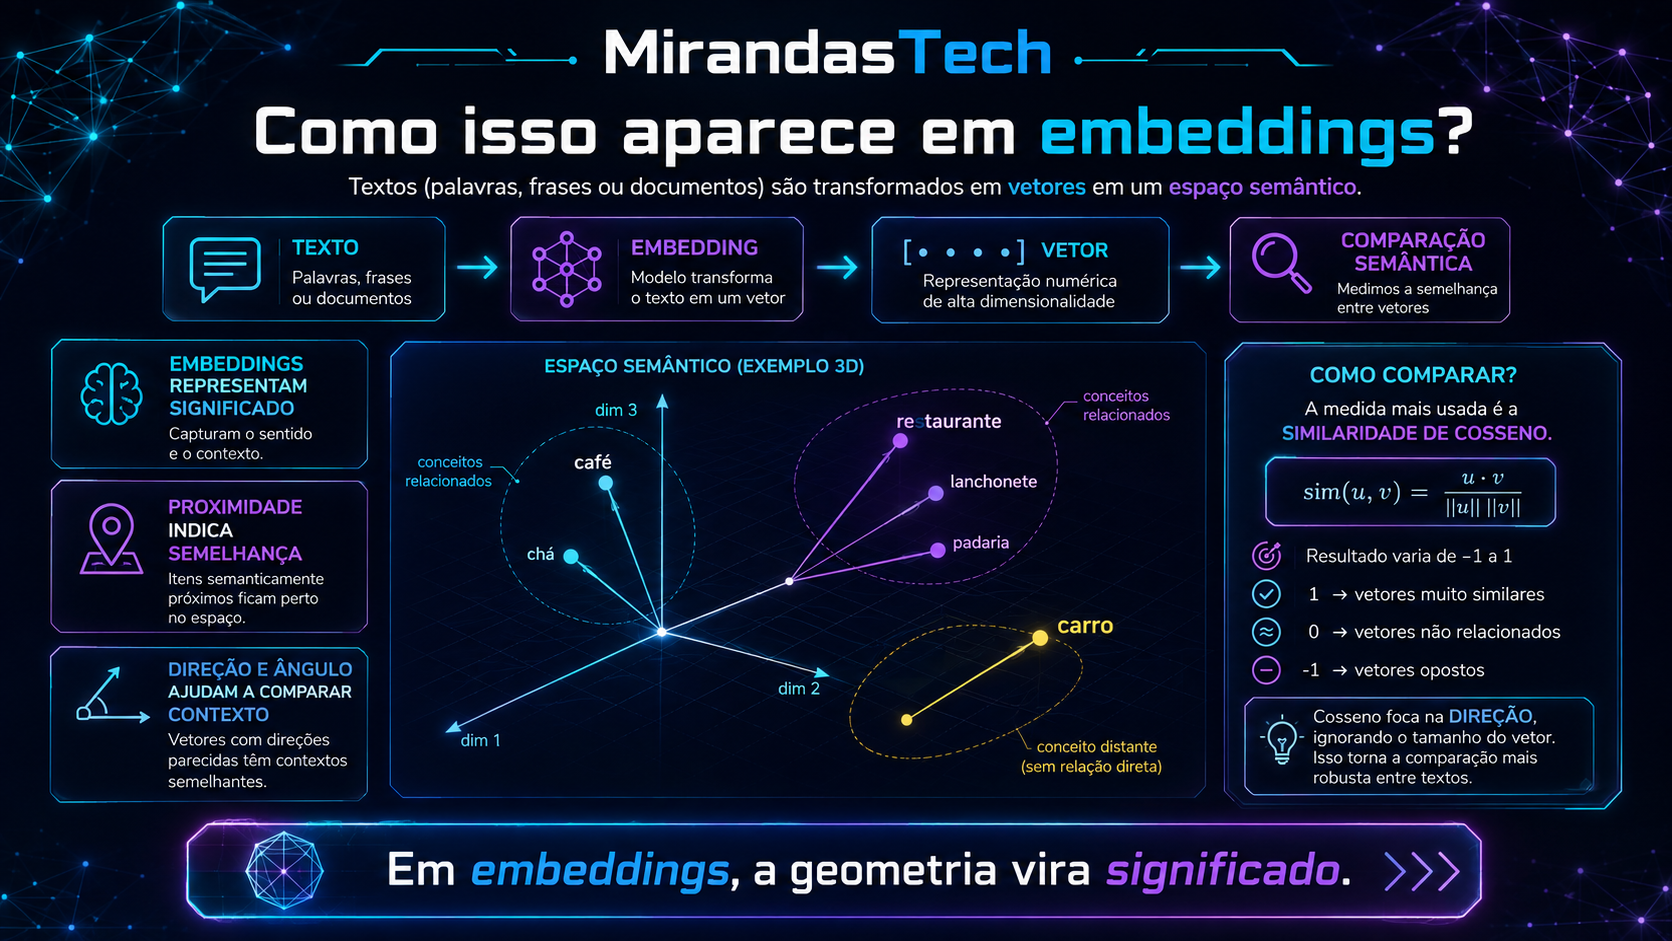
Modelos de IA representam palavras, frases, documentos e outros objetos usando vetores de alta dimensão.
Imagine, de forma simplificada:
"café"      → [0.72, 0.41, 0.88, ...]
"chá"       → [0.69, 0.39, 0.84, ...]
"automóvel" → [-0.42, 0.91, -0.35, ...]
Para comparar essas representações, precisamos de operações que indiquem o grau de proximidade ou alinhamento entre os vetores.
O produto escalar participa diretamente dessa família de comparações e também está por trás da similaridade de cosseno.
12. Busca semântica
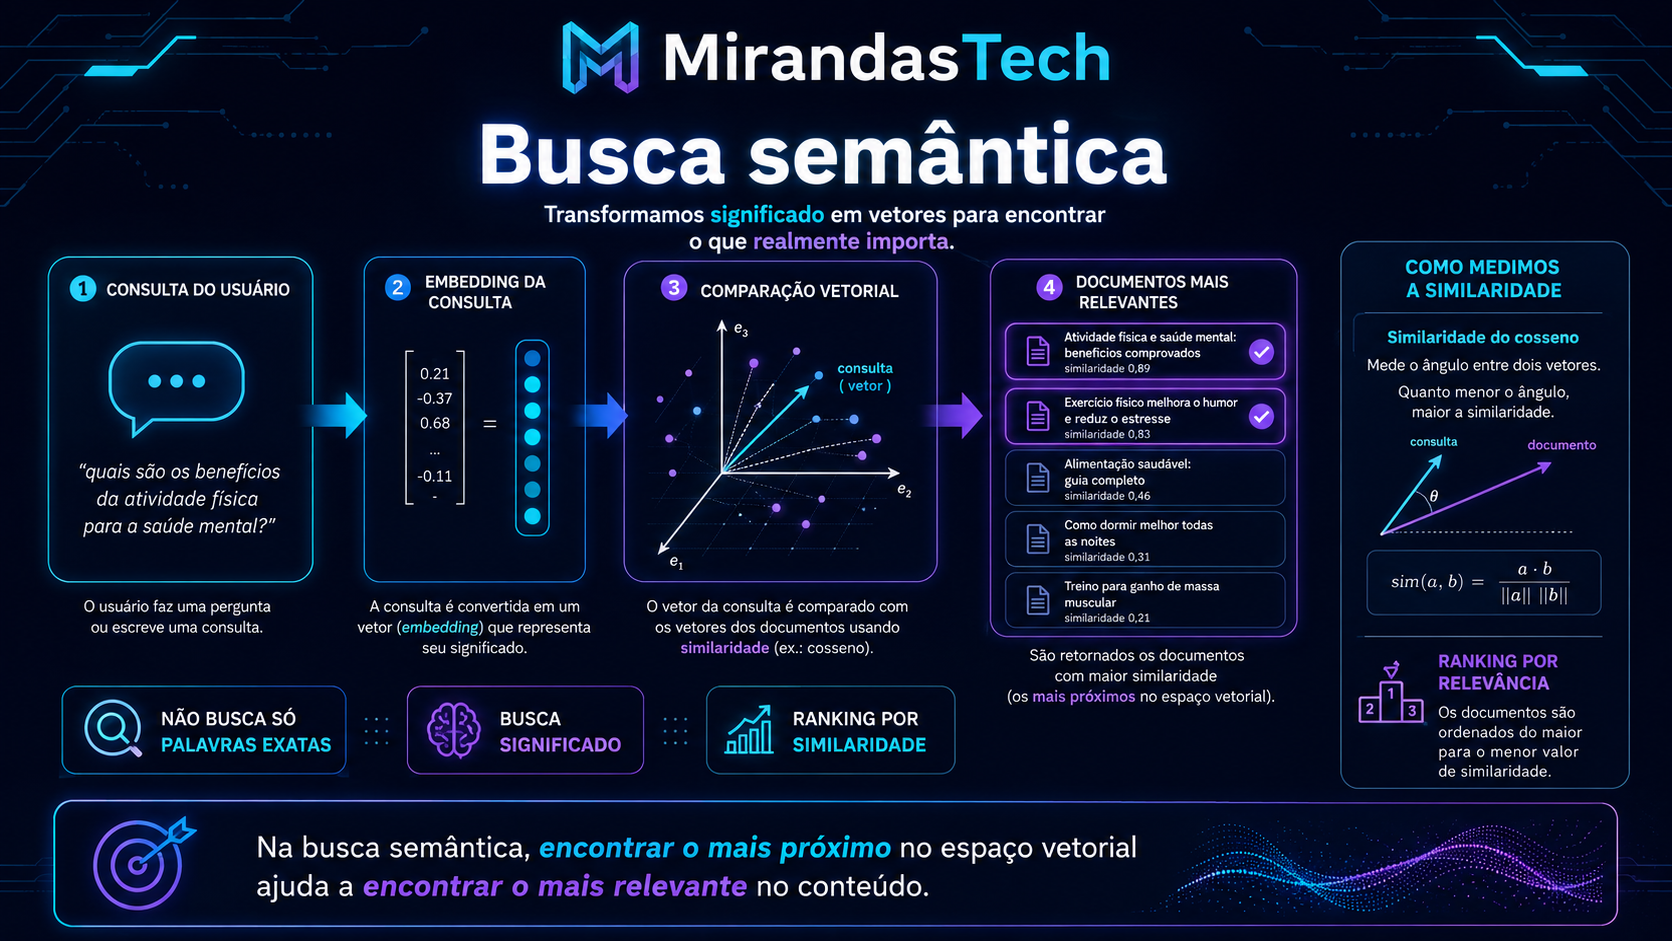
Imagine que um usuário faça a pergunta:
“Quais são os benefícios do café?”
A pergunta pode ser transformada em um embedding q. Os documentos da base também são representados por vetores d₁, d₂, ..., dₙ.
pergunta
   ↓
embedding q
   ↓
comparação com d₁, d₂, d₃, ...
   ↓
ranking de similaridade
   ↓
documentos mais relevantes
Esse tipo de comparação vetorial está na base de mecanismos de busca semântica e bancos de dados vetoriais.
13. E onde isso entra em RAG?
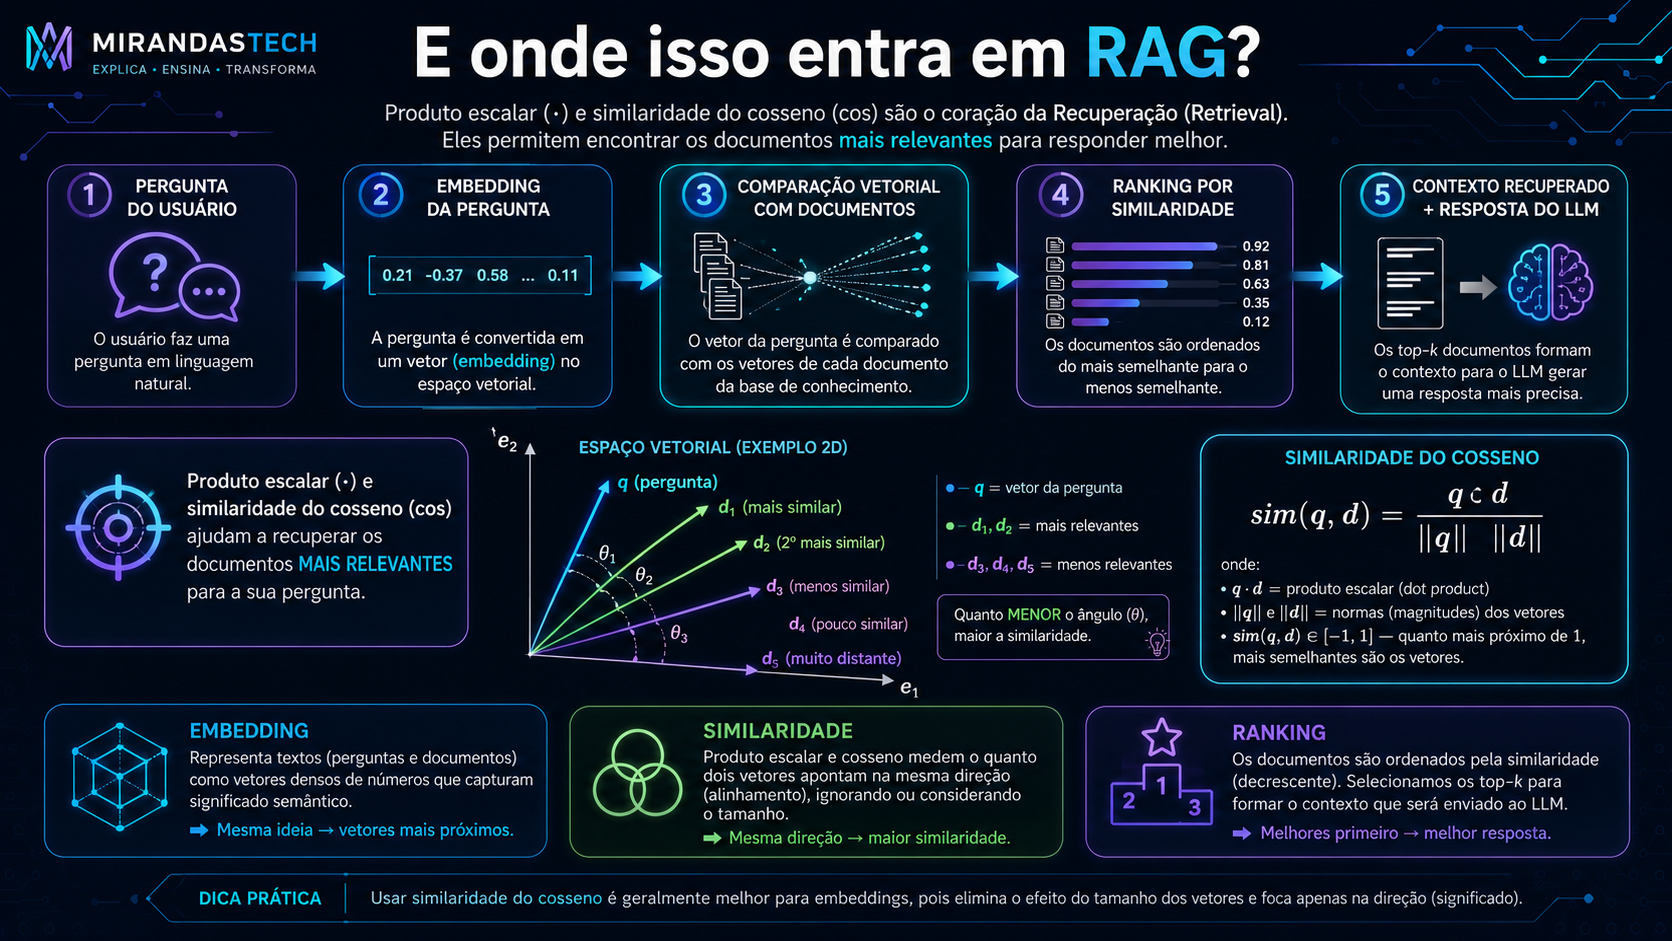
Um pipeline simplificado de RAG pode ser representado assim:
Usuário
   ↓
Pergunta
   ↓
Embedding
   ↓
Busca vetorial
   ↓
Top-K documentos
   ↓
LLM
   ↓
Resposta contextualizada
O sistema precisa decidir quais documentos possuem vetores mais relacionados ao vetor da pergunta. É nesse processo que medidas baseadas em produto escalar, cosseno e distância aparecem na prática.
14. Produto escalar dentro de redes neurais
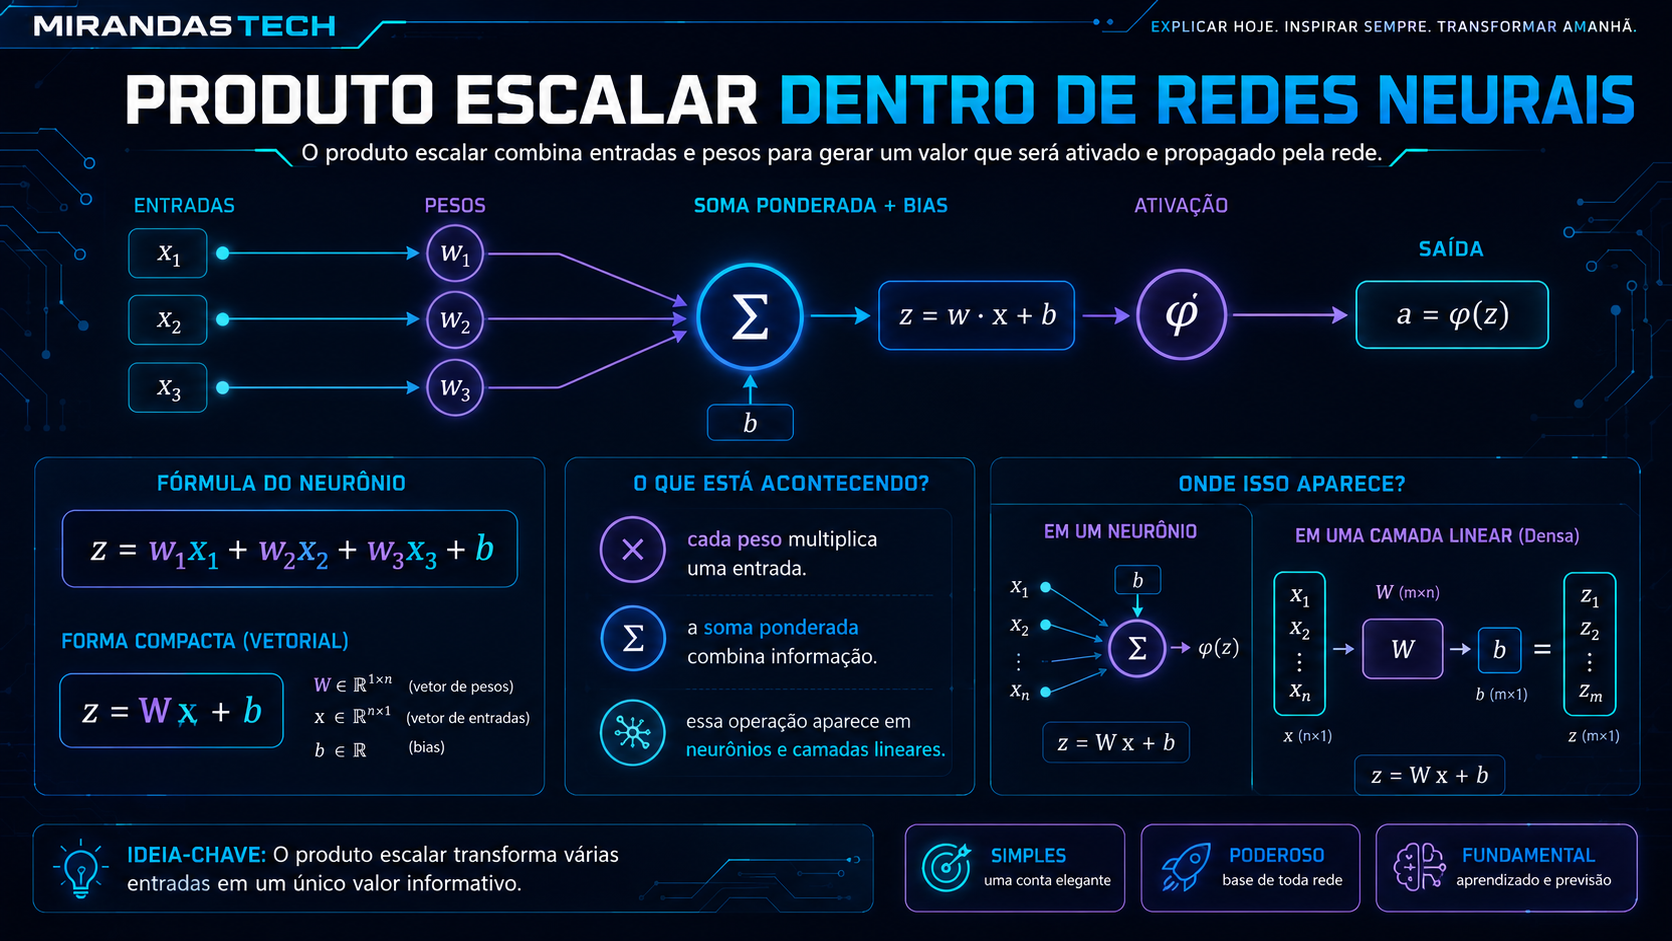
Na primeira aula vimos a transformação:
z = Wx + bConsidere uma linha de W:
w = [w₁, w₂, w₃]e uma entrada:
x = [x₁, x₂, x₃]Uma das saídas da multiplicação matricial é formada por:
w · x = w₁x₁ + w₂x₂ + w₃x₃Ou seja:
Multiplicações matriciais utilizadas em redes neurais são compostas por muitos produtos escalares.
15. Uma prévia dos Transformers
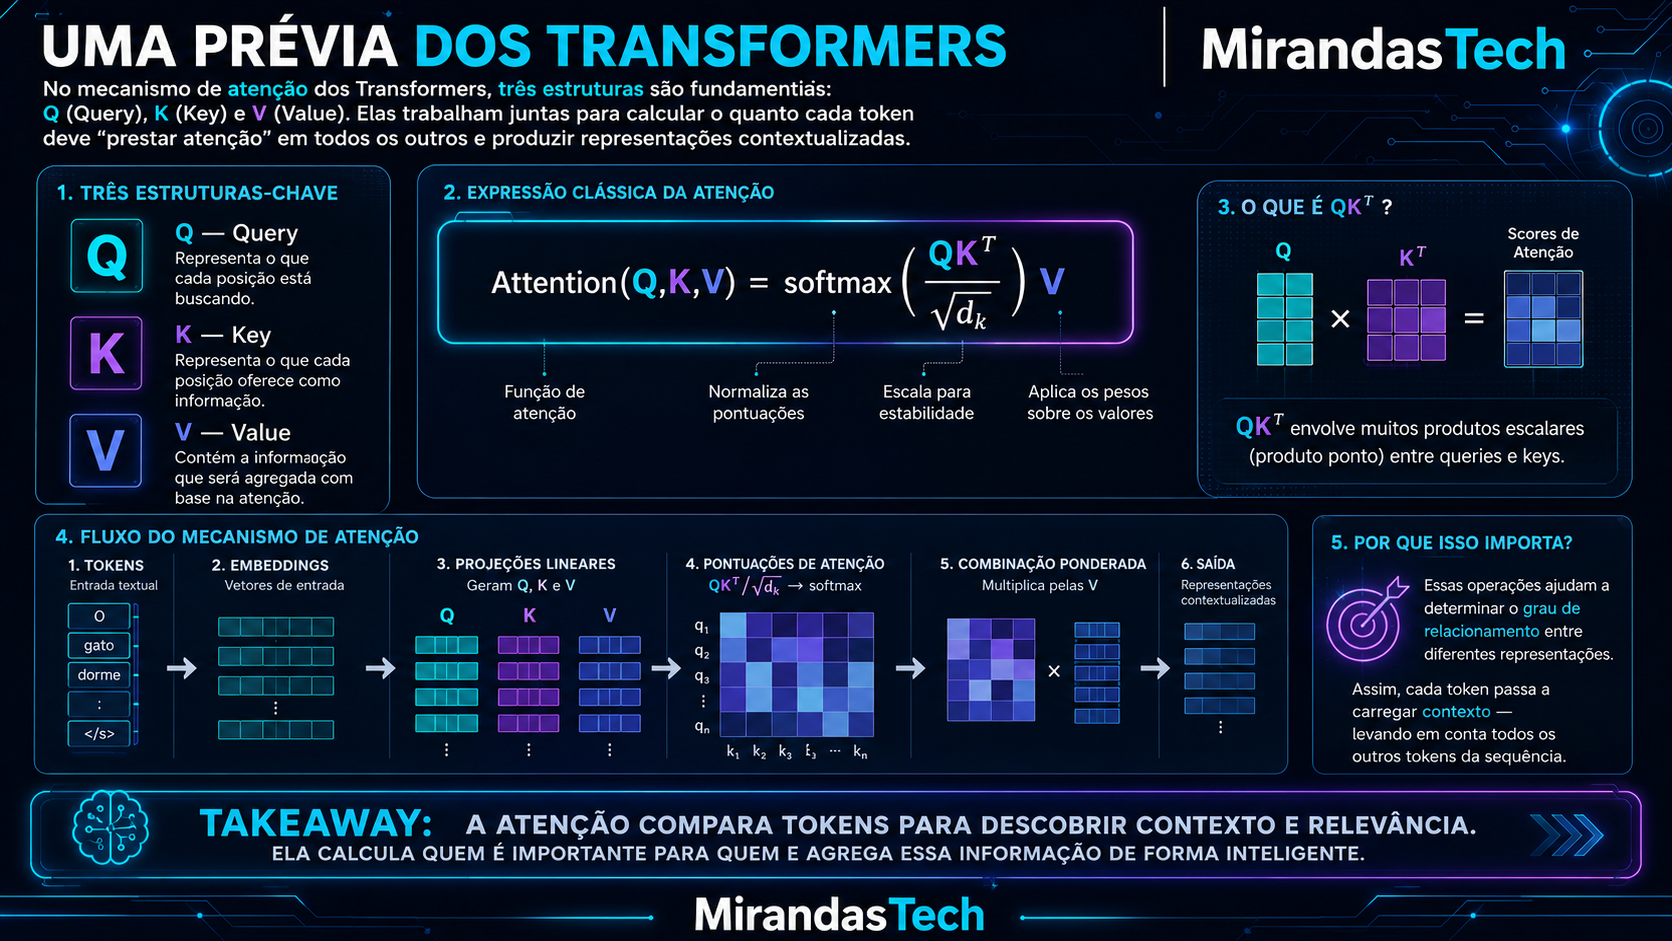
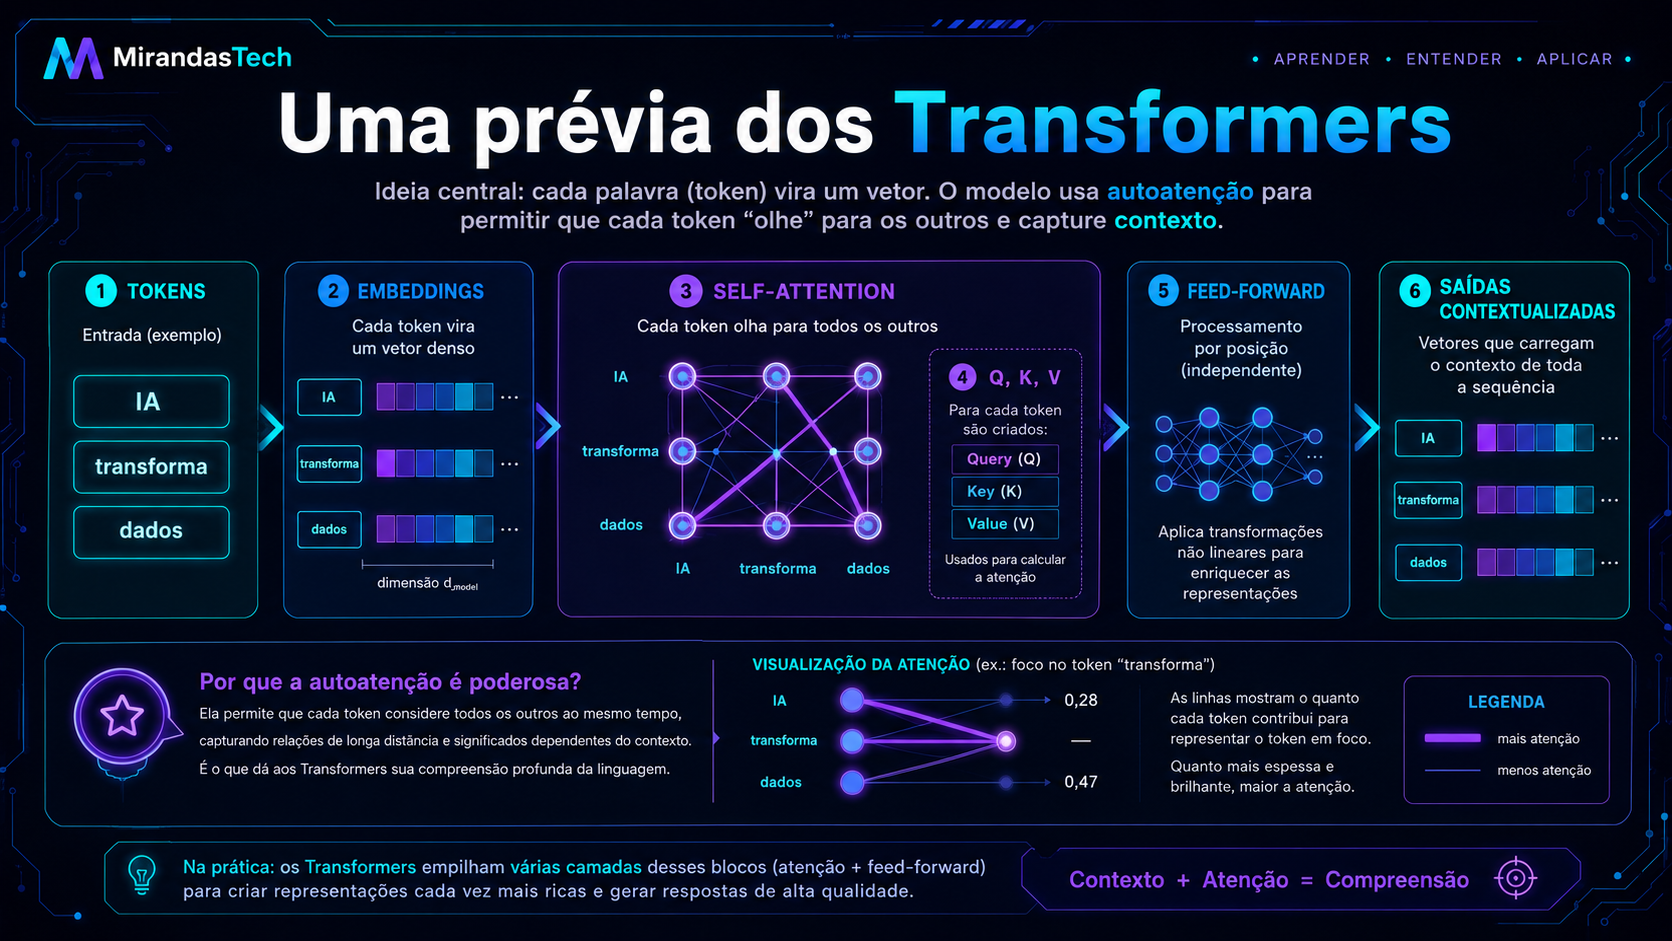
No mecanismo de atenção dos Transformers aparecem três estruturas que estudaremos mais adiante:
Q— Query;K— Key;V— Value.
A expressão clássica da atenção é:
Attention(Q,K,V) = softmax(QKᵀ / √dₖ) VNão precisamos dominar essa fórmula agora. O importante é reconhecer que QKᵀ envolve muitos produtos escalares entre queries e keys.
Em uma interpretação inicial, essas operações ajudam a determinar o grau de relacionamento entre diferentes representações.
16. A representação mental que vale guardar
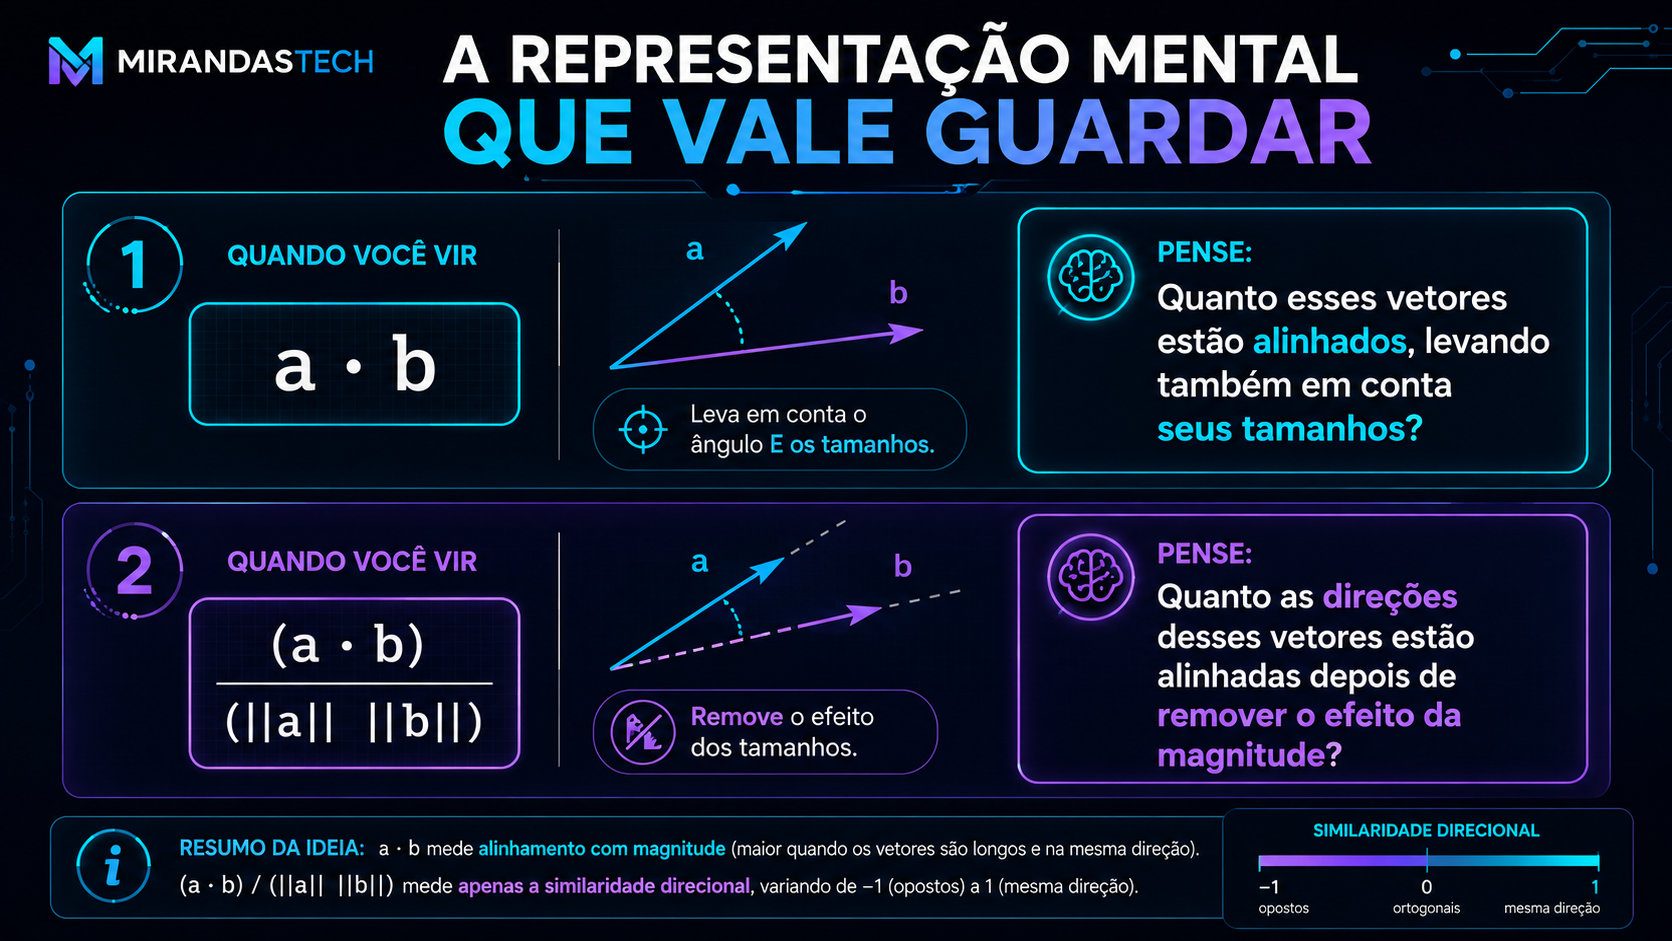
Quando você vir:
a · bpense:
Quanto esses vetores estão alinhados, levando também em conta seus tamanhos?
Quando você vir:
(a · b) / (||a|| ||b||)pense:
Quanto as direções desses vetores estão alinhadas depois de remover o efeito da magnitude?
17. Exercício de fixação
- Calcule o produto escalar entre
a = [2,3]eb = [5,4]. - Se
a = [1,0]eb = [0,5], quanto valea · be o que isso significa geometricamente? - Se o produto escalar entre dois vetores for negativo, o que isso indica sobre o ângulo entre suas direções?
- Por que o produto escalar bruto pode ser problemático para comparar embeddings de magnitudes muito diferentes?
- Explique com suas palavras a diferença entre
a · be(a · b)/(||a|| ||b||).
18. O que vem depois?
Já aprendemos vetores, norma, distância e produto escalar. Agora temos todos os ingredientes necessários para aplicar esses conceitos diretamente a embeddings.
Na próxima aula veremos similaridade de cosseno na prática: embeddings, busca semântica e RAG.
Este artigo faz parte da série Fundamentos Matemáticos para Inteligência Artificial, do MirandasTech.