
Matrizes como transformações: entendendo de verdade y = Wx + b
Compreender matrizes como transformações de vetores e conectar essa interpretação diretamente às camadas de uma rede neural.

Compreender matrizes como transformações de vetores e conectar essa interpretação diretamente às camadas de uma rede neural. Pré-requisitos: vetores, norma, produto escalar e similaridade de cosseno (Aula 04 — Similaridade de cosseno na prática).
Quem já escreveu nn.Linear(768, 512) no PyTorch e imprimiu layer.weight.shape viu torch.Size([512, 768]). Quem já passou um vetor do tamanho errado para essa camada viu a outra face da mesma moeda: RuntimeError: mat1 and mat2 shapes cannot be multiplied. As duas mensagens falam do mesmo objeto: uma matriz W com 512 linhas e 768 colunas, que recebe um vetor de 768 números e devolve um vetor de 512 (PyTorch, 2026).
Enquanto W for “uma tabela de números”, essas dimensões parecem detalhe de biblioteca, algo a acertar por tentativa e erro. Quando W passa a ser lida como uma transformação, que pega uma representação e produz outra, o shape deixa de ser detalhe e vira a própria arquitetura do modelo: quantas características entram, quantas saídas são produzidas, quantos parâmetros a camada aprende.
No artigo anterior da série, a similaridade de cosseno comparou vetores pela direção em que apontam. Aqui damos o passo seguinte: o que acontece quando uma matriz transforma esses vetores. Ao final, você vai conseguir ler $y = Wx + b$ como uma camada de rede neural, calcular a saída na mão e em NumPy, diagnosticar um erro de shape pela regra das dimensões, contar os parâmetros de uma camada e entender por que uma pilha de camadas precisa de funções de ativação.
W = parâmetros aprendíveis dessa transformação. Ler $y = Wx + b$ é ler “pegue uma representação, transforme-a com pesos aprendidos e desloque o resultado com um bias”.1. A equação que aparece desde a primeira aula
Desde o início da trilha uma expressão se repete:
$$ \boxed{y = Wx + b} $$
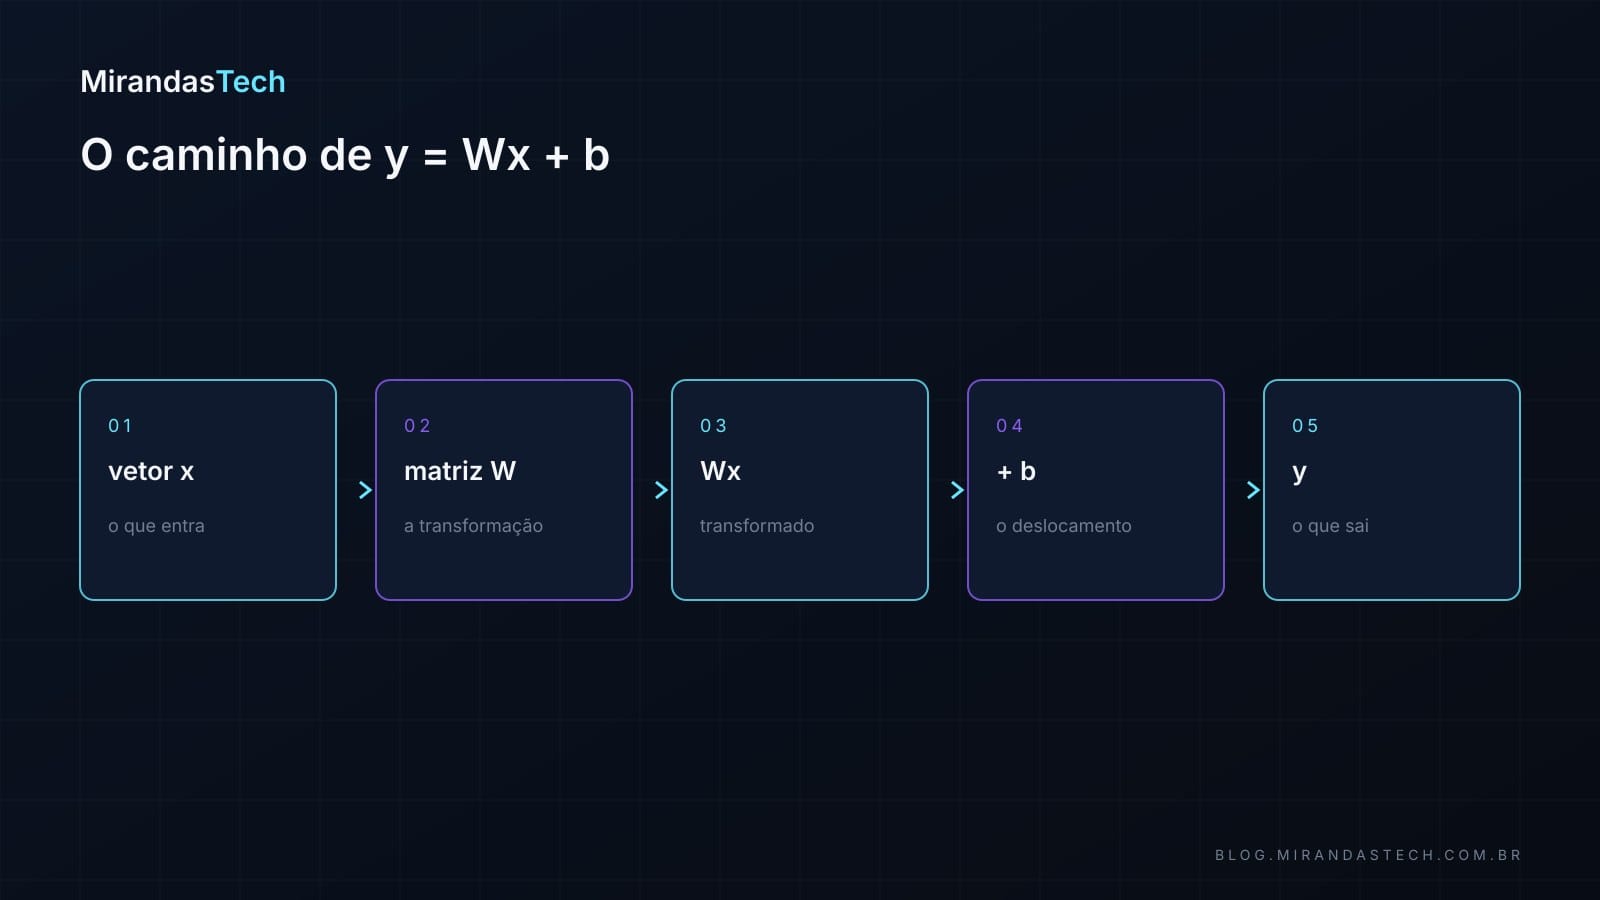
Uma primeira interpretação, suficiente até agora, é:
xé a entrada;Wcontém os pesos;bé o bias;yé a saída.
Com vetores, norma e produto escalar já estudados, podemos ir além dessa leitura:
Uma matriz pode ser interpretada como uma transformação que recebe um vetor e produz outro vetor.
Com essa lente, a equação descreve um fluxo: o vetor de entrada x passa pela transformação W, vira Wx, recebe o deslocamento b e sai como y. Essa estrutura aparece continuamente em redes neurais, e o restante do artigo desmonta cada etapa dela.
2. Do escalar à matriz: uma máquina que transforma vetores
Antes da matriz, vale relembrar a transformação mais simples que um vetor pode sofrer. Considere:
$$ x = \begin{bmatrix}2\\3\end{bmatrix} $$
Multiplicando por 2:
$$ 2x = \begin{bmatrix}4\\6\end{bmatrix} $$
O vetor ficou maior e manteve a mesma direção. Um escalar altera o tamanho, e só isso. Uma matriz pode realizar transformações muito mais gerais. Considere:
$$ W = \begin{bmatrix}2&0\\0&1\end{bmatrix},\quad x = \begin{bmatrix}1\\1\end{bmatrix} $$
Então:
$$ Wx = \begin{bmatrix}2&0\\0&1\end{bmatrix} \begin{bmatrix}1\\1\end{bmatrix} = \begin{bmatrix}2\\1\end{bmatrix} $$
O vetor (1,1) virou (2,1): a matriz esticou o espaço horizontalmente. A mesma regra vale para qualquer vetor. Se:
$$ x = \begin{bmatrix}3\\2\end{bmatrix} $$
então:
$$ Wx = \begin{bmatrix}6\\2\end{bmatrix} $$
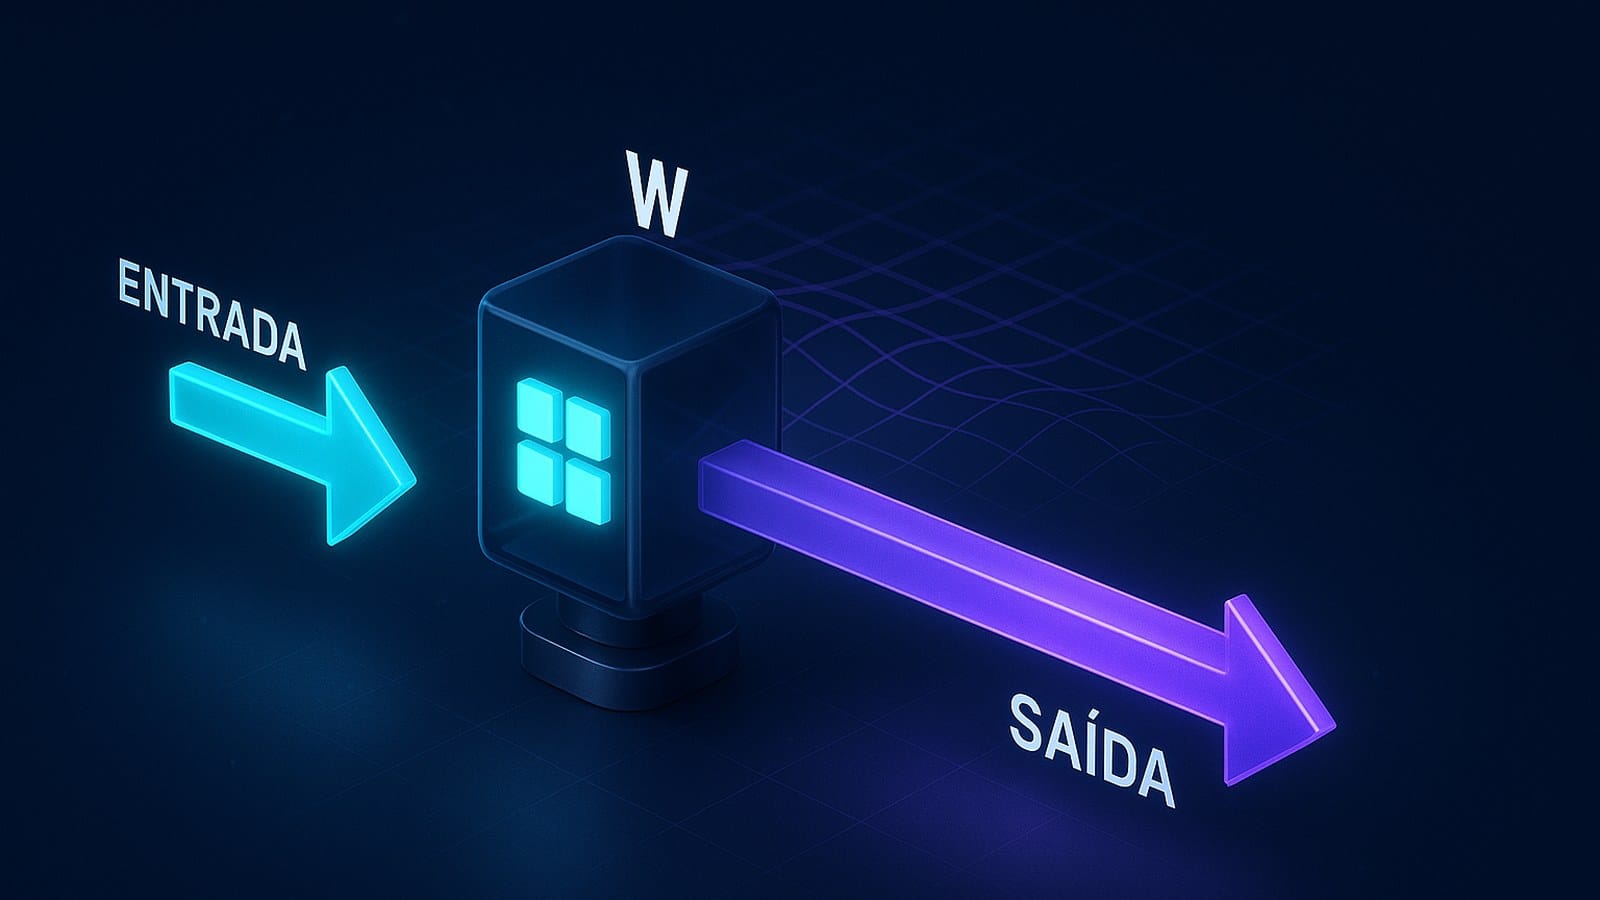
A transformação duplica a componente horizontal e preserva a vertical. Daí a representação mental mais útil deste artigo: a matriz é uma máquina. Ela recebe uma representação x e produz outra representação, y. O que a máquina faz depende inteiramente dos números dentro dela.
3. Cada linha de W é um produto escalar
Para entender o que acontece dentro da máquina, basta olhar linha por linha. Considere:
$$ W= \begin{bmatrix} 2&1\\ -1&3 \end{bmatrix},\quad x=\begin{bmatrix}4\\2\end{bmatrix} $$
A primeira saída é:
$$ 2(4)+1(2)=10 $$
A segunda:
$$ -1(4)+3(2)=2 $$
Logo:
$$ Wx=\begin{bmatrix}10\\2\end{bmatrix} $$
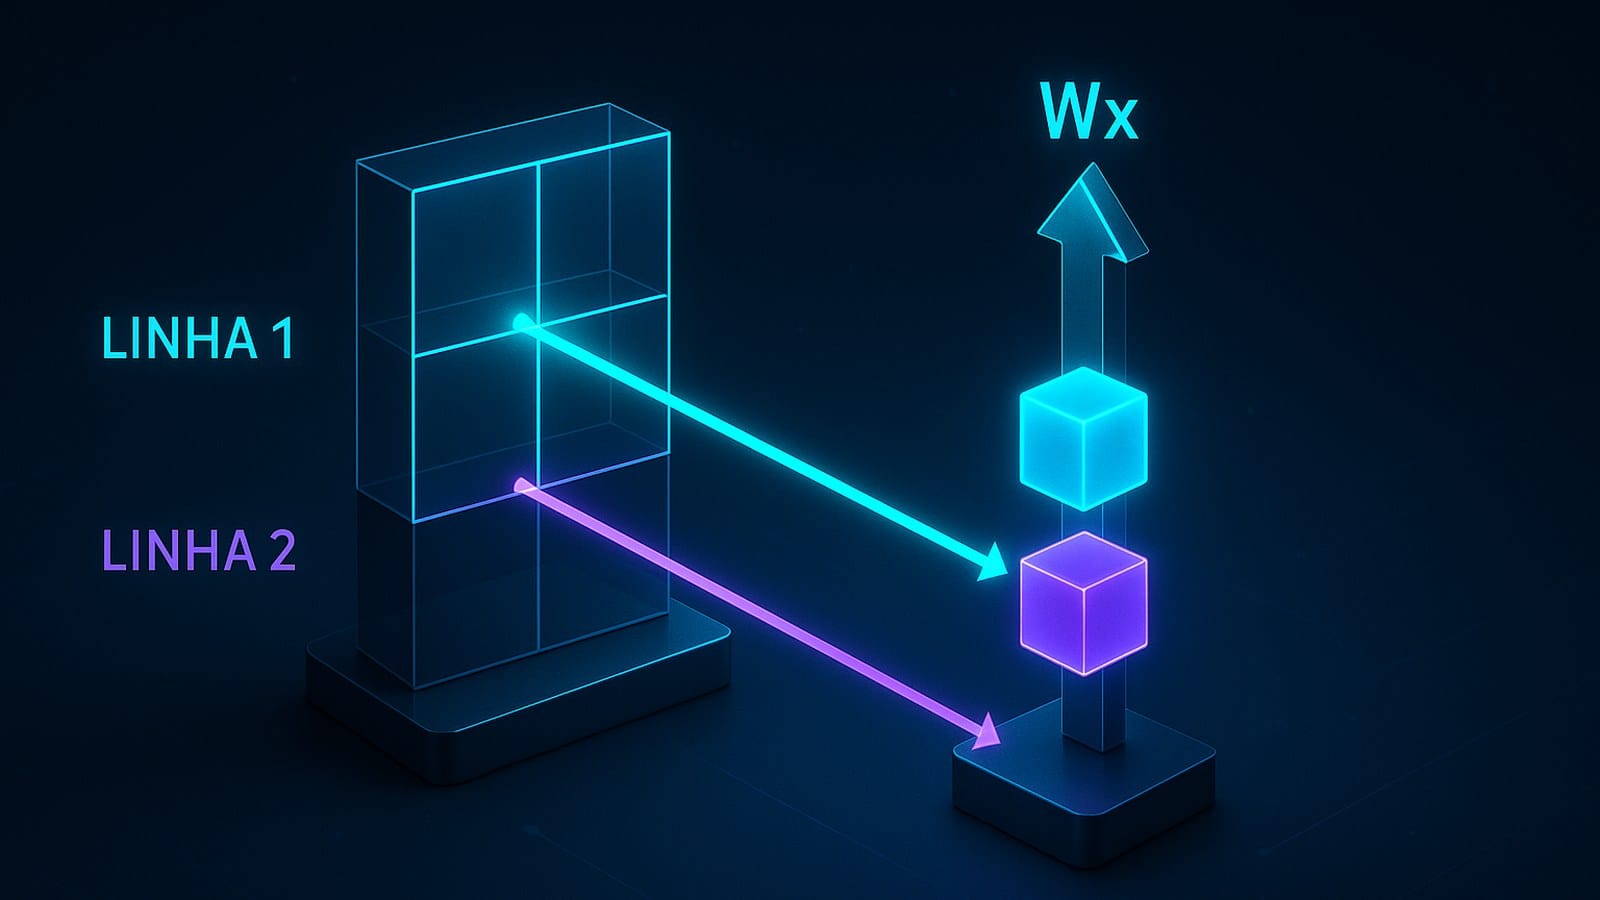
Repare no que cada linha de W fez: um produto escalar com x, exatamente a operação da Aula 03:
$$ [2,1]\cdot[4,2]=10 $$
$$ [-1,3]\cdot[4,2]=2 $$
Portanto:
$$ \boxed{\text{multiplicação matriz-vetor} = \text{vários produtos escalares}} $$
Em geral, se as linhas de W forem w_1,w_2,w_3,..., então:
$$ Wx= \begin{bmatrix} w_1\cdot x\\ w_2\cdot x\\ w_3\cdot x\\ \vdots \end{bmatrix} $$
Cada componente da saída mede o alinhamento entre a entrada e uma linha da matriz. Essa interpretação é central em redes neurais, e é o que vai transformar “matriz de pesos” em “camada de neurônios” na seção 5.
4. Dimensões: por que erros de shape são tão comuns
Se cada linha faz um produto escalar com x, cada linha precisa ter o mesmo número de elementos que x. É daí que vem toda a regra de dimensões. Considere:
$$ W= \begin{bmatrix} 1&2&3\\ 4&5&6 \end{bmatrix} $$
Então:
$$ W\in\mathbb{R}^{2\times3} $$
Se:
$$ x=\begin{bmatrix}7\\8\\9\end{bmatrix}\in\mathbb{R}^{3} $$
então:
$$ (2\times3)(3\times1)\rightarrow(2\times1) $$
Logo:
$$ Wx\in\mathbb{R}^{2} $$
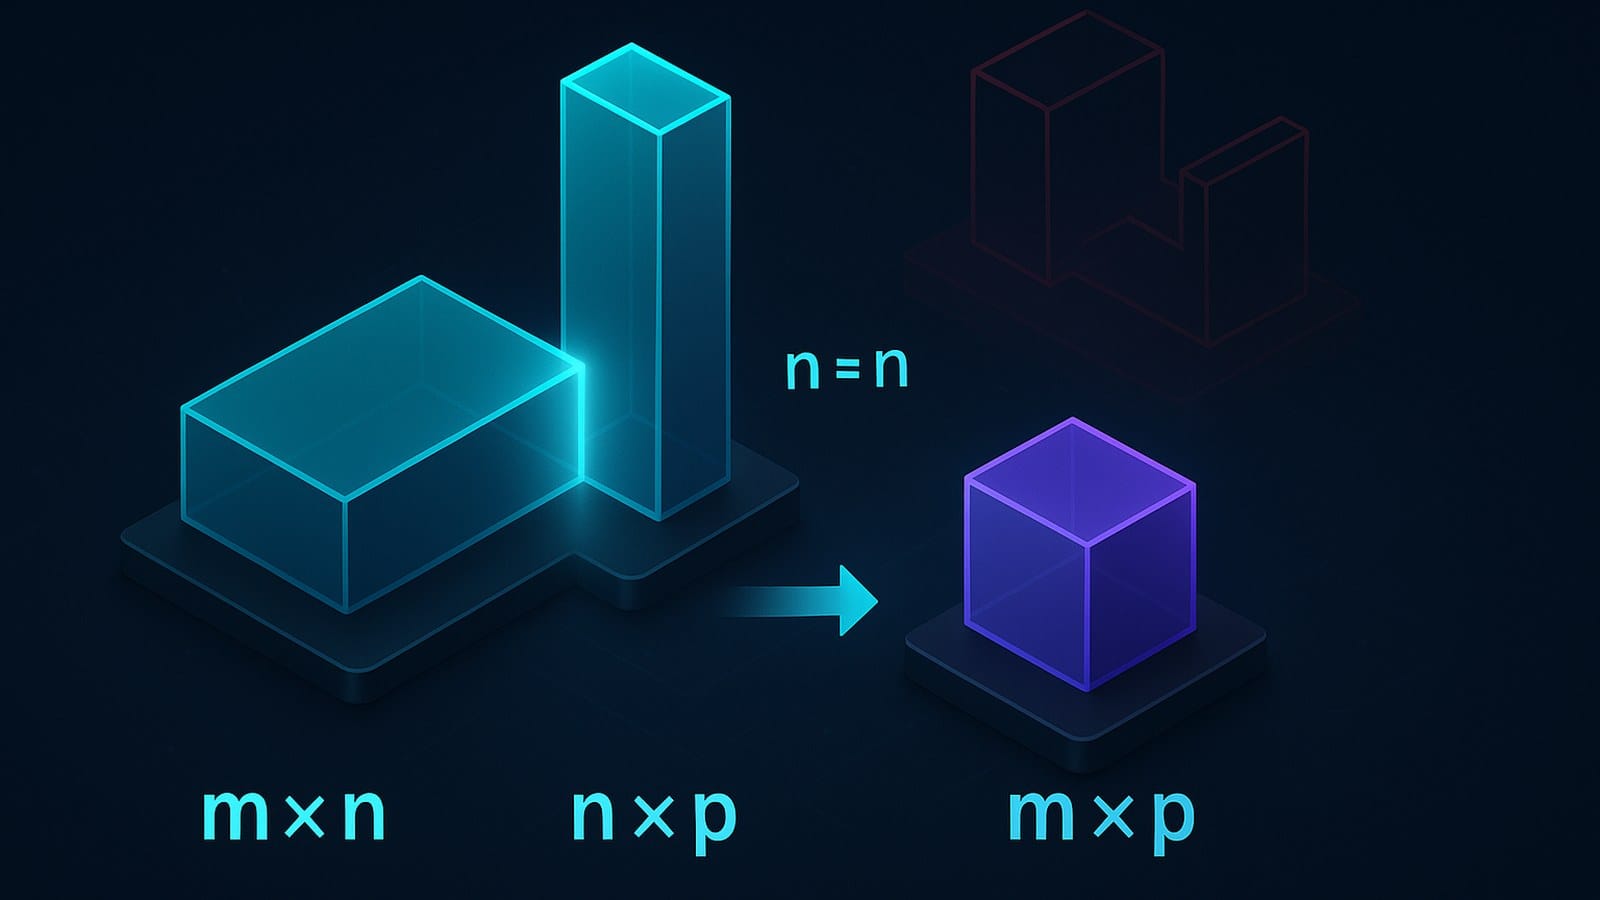
A regra geral das dimensões é:
$$ (m\times n)(n\times p)\rightarrow(m\times p) $$
Aqui, $m$ é o número de linhas de W (quantas saídas), $n$ é o número de colunas de W e de elementos de x (quantas entradas), e $p$ é o número de colunas do segundo fator (1, no caso de um vetor). As dimensões internas precisam coincidir. Se:
$$ W\in\mathbb{R}^{4\times3},\quad x\in\mathbb{R}^{5} $$
teríamos:
$$ (4\times3)(5\times1) $$
Como 3 ≠ 5, a multiplicação não é definida. É exatamente isso que a biblioteca reclama:
import numpy as np

W = np.ones((4, 3))   # 4 saídas, 3 entradas
x = np.ones(5)        # 5 entradas: incompatível

print(W.shape, x.shape)
print(W @ x)
(4, 3) (5,)
ValueError: matmul: Input operand 1 has a mismatch in its core dimension 0, with gufunc signature (n?,k),(k,m?)->(n?,m?) (size 5 is different from 3)
A mensagem diz, em outras palavras, que a dimensão interna não bate: size 5 is different from 3. Diante de qualquer erro desse tipo, duas perguntas resolvem mais do que qualquer tentativa às cegas. Primeiro: o que cada dimensão representa? Depois: as dimensões internas são compatíveis? Shapes descrevem a arquitetura matemática, não apenas um detalhe de programação.
5. De um neurônio a uma camada: o papel de W
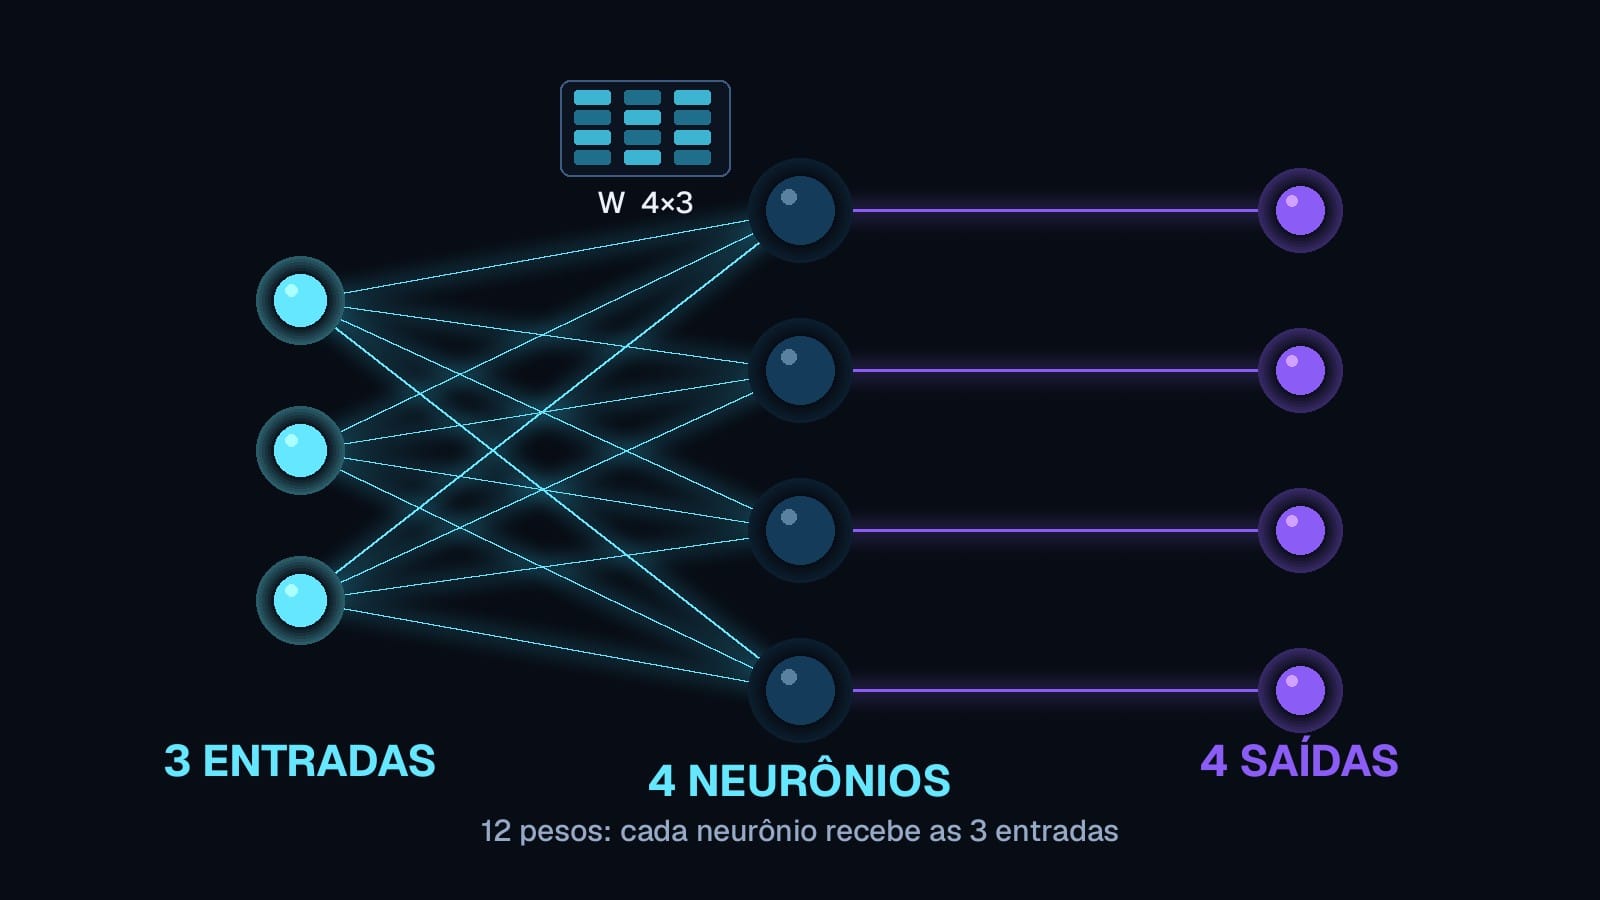
Agora o salto para redes neurais. Se uma entrada possui três características:
$$ x\in\mathbb{R}^{3} $$
e queremos quatro saídas, podemos usar:
$$ W\in\mathbb{R}^{4\times3} $$
Então:
$$ Wx\in\mathbb{R}^{4} $$
Cada linha de W produz uma saída: 3 entradas passam por uma matriz 4 × 3 e viram 4 saídas. O nome que damos a cada uma dessas linhas é neurônio. Um neurônio individual recebe:
$$ x=\begin{bmatrix}x_1\\x_2\\x_3\end{bmatrix} $$
possui pesos:
$$ w=\begin{bmatrix}w_1\\w_2\\w_3\end{bmatrix} $$
calcula:
$$ w\cdot x=w_1x_1+w_2x_2+w_3x_3 $$
Depois soma um bias:
$$ \boxed{z=w\cdot x+b} $$
Isso é um neurônio linear. Se temos quatro neurônios com pesos w_1,...,w_4, podemos empilhar esses vetores nas linhas de uma matriz:
$$ W= \begin{bmatrix} w_1^T\\ w_2^T\\ w_3^T\\ w_4^T \end{bmatrix} $$
Em vez de calcular cada neurônio separadamente, fazemos:
$$ \boxed{Wx} $$
Uma operação matricial processa muitos produtos escalares de uma vez. É por isso que a camada inteira cabe em uma única multiplicação.
6. O bias: transformar e deslocar
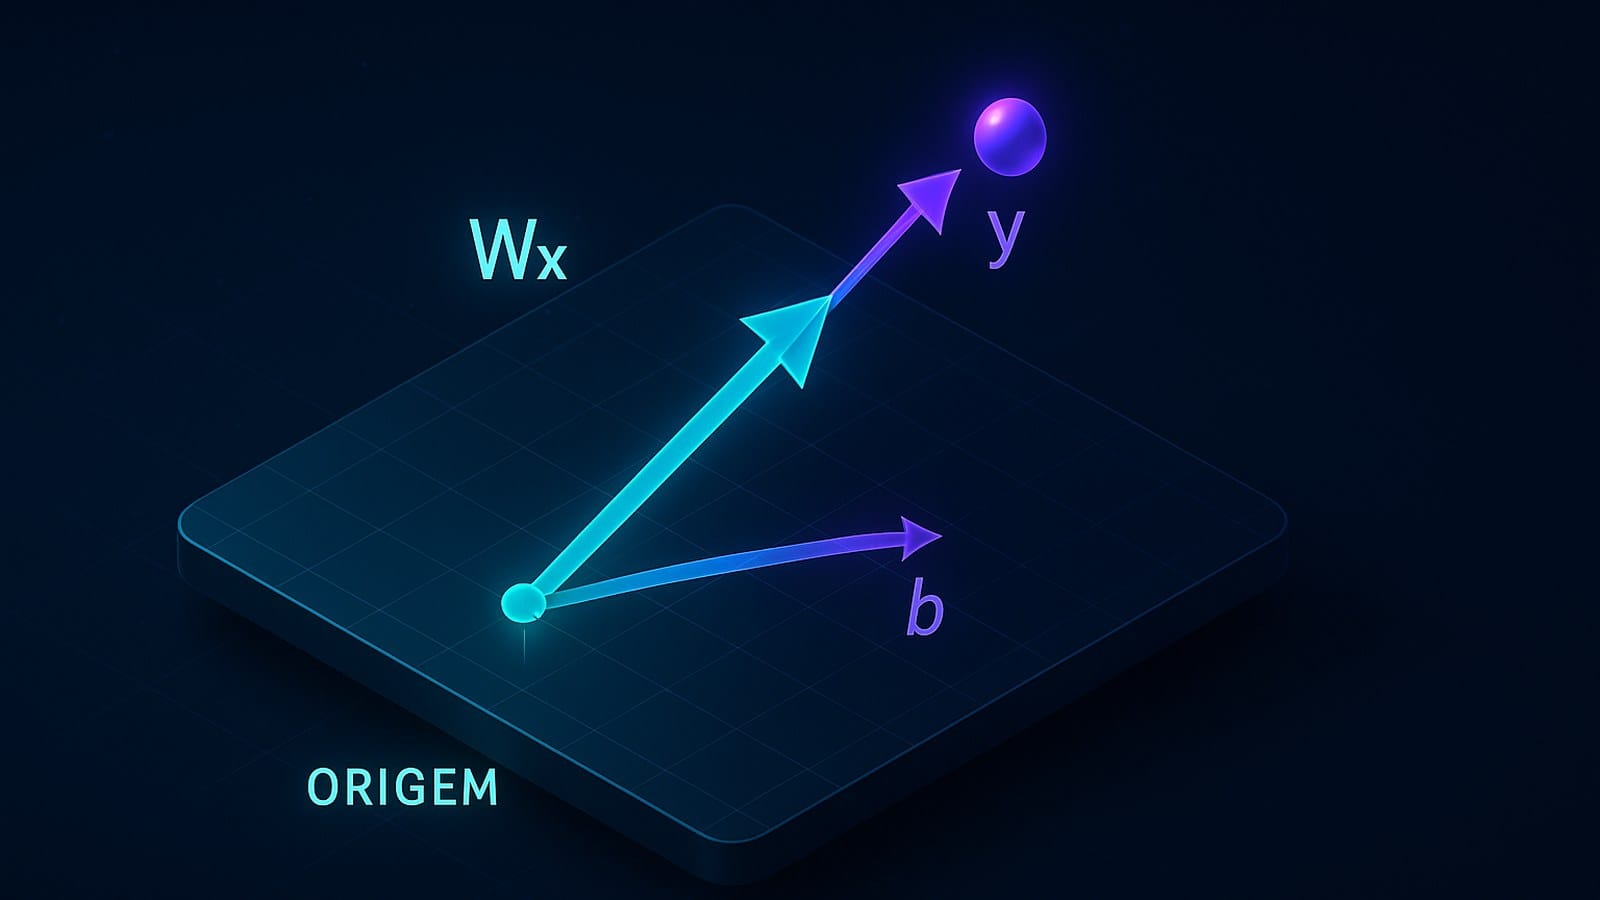
Falta a última letra da equação. Com o bias, a camada completa é:
$$ \boxed{y=Wx+b} $$
Suponha:
$$ Wx=\begin{bmatrix}2\\5\end{bmatrix},\quad b=\begin{bmatrix}1\\-2\end{bmatrix} $$
Então:
$$ y=\begin{bmatrix}3\\3\end{bmatrix} $$
O bias desloca o resultado da transformação. Tecnicamente, Wx é uma transformação linear e Wx+b é uma transformação afim (Deisenroth, Faisal & Ong, 2020). Uma forma simples de guardar: Wx transforma; Wx + b transforma e desloca.
Por que precisamos desse deslocamento? Em uma função:
$$ y=wx $$
quando x=0, necessariamente y=0. A reta passa pela origem, e nenhuma escolha de w muda isso. Já:
$$ y=wx+b $$
permite:
$$ x=0\Rightarrow y=b $$
O bias aumenta a flexibilidade da transformação: a camada pode ter uma saída diferente de zero mesmo quando a entrada é zero.
7. Na prática: o exemplo completo em NumPy
Um exemplo pequeno o bastante para conferir à mão. Considere:
$$ x=\begin{bmatrix}2\\1\end{bmatrix} $$
$$ W= \begin{bmatrix} 0.5&1.0\\ -1.0&2.0 \end{bmatrix} $$
$$ b=\begin{bmatrix}0.2\\0.5\end{bmatrix} $$
Calculando linha por linha:
$$ Wx= \begin{bmatrix} 0.5(2)+1(1)\\ -1(2)+2(1) \end{bmatrix} = \begin{bmatrix}2\\0\end{bmatrix} $$
Somando o bias:
$$ y= \begin{bmatrix}2\\0\end{bmatrix} + \begin{bmatrix}0.2\\0.5\end{bmatrix} = \boxed{\begin{bmatrix}2.2\\0.5\end{bmatrix}} $$
Em NumPy, a equação inteira é uma linha, e o operador @ faz a multiplicação matriz-vetor:
import numpy as np

x = np.array([2, 1])

W = np.array([
    [0.5, 1.0],
    [-1.0, 2.0]
])

b = np.array([0.2, 0.5])

y = W @ x + b
print(y)
Resultado:
[2.2 0.5]
O mesmo valor da conta à mão. Essa correspondência entre a fórmula e o código é o que vale levar adiante: W @ x + b é literalmente $y = Wx + b$.
8. Da matriz 2 × 2 aos LLMs
A matemática não muda quando a escala muda. Em um modelo de linguagem, podemos ter:
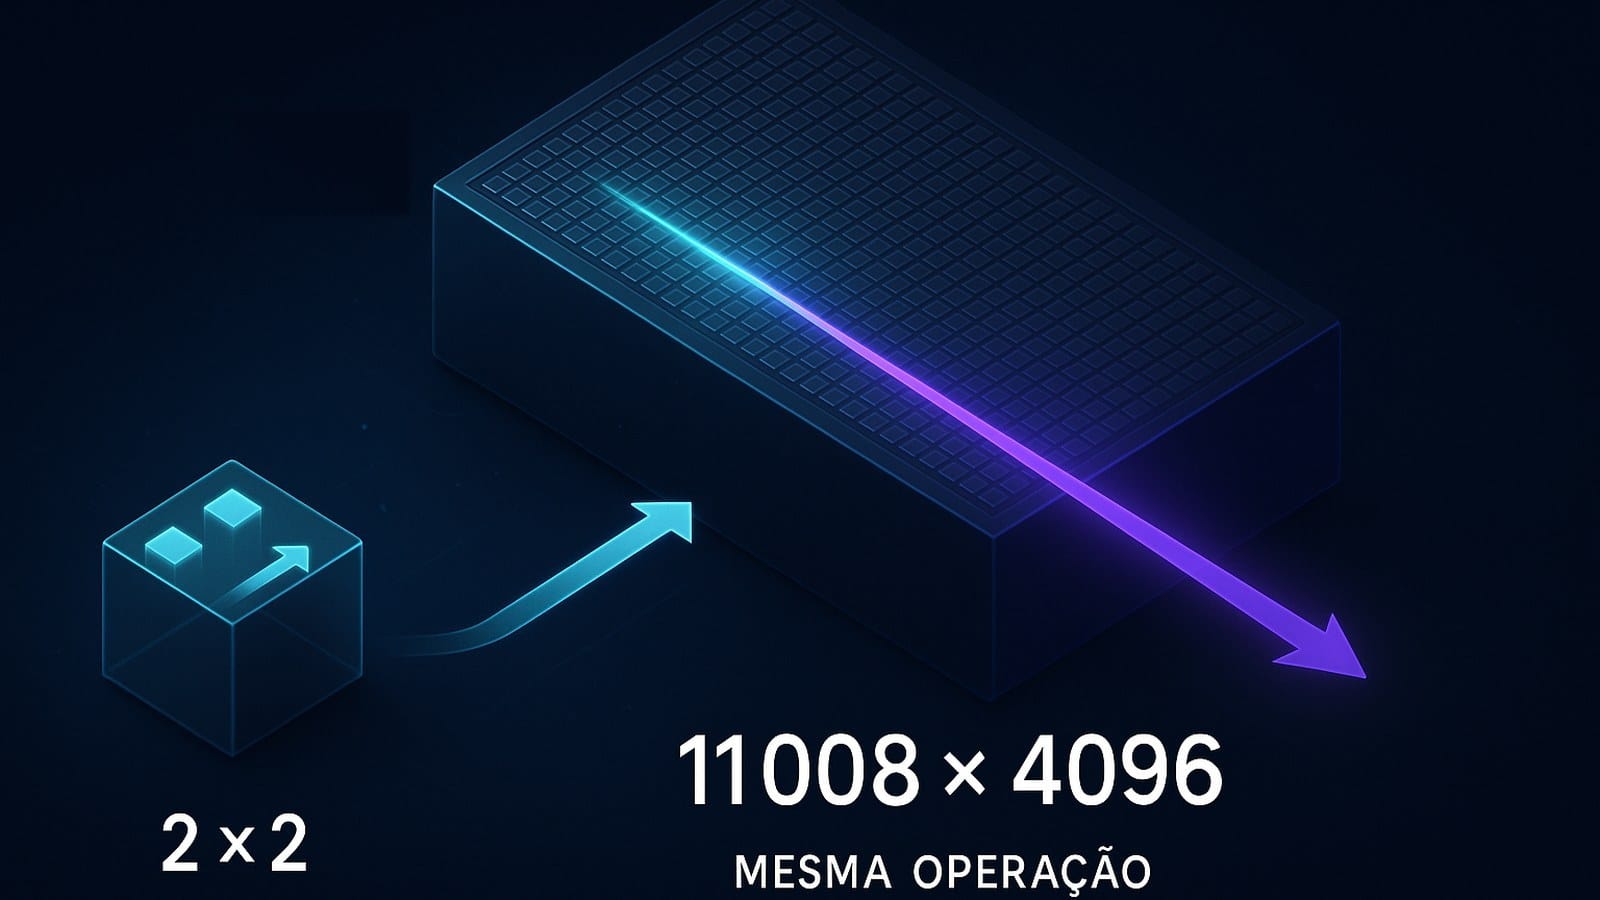
$$ x\in\mathbb{R}^{4096} $$
$$ W\in\mathbb{R}^{11008\times4096} $$
Então:
$$ Wx\in\mathbb{R}^{11008} $$
São as dimensões de uma camada real: 4096 é a dimensão da representação e 11008 é a dimensão interna do feed-forward do LLaMA-7B (Touvron et al., 2023; Meta AI, 2023). A matemática é a mesma da matriz 2×2; apenas a escala mudou. Transformers usam matrizes constantemente. Mais adiante na trilha veremos expressões como:
$$ XW_Q,\quad XW_K,\quad XW_V $$
Essas matrizes aprendidas transformam representações em Queries, Keys e Values, o coração do mecanismo de atenção (Vaswani et al., 2017). Matrizes do mesmo tipo também aparecem em:
- projeções de atenção;
- feed-forward networks;
- embeddings;
- projeções de saída.
LLMs são intensivamente construídos sobre multiplicações de matrizes.
Repare que, no exemplo acima, a entrada tem 4096 dimensões e a saída tem 11008. Uma matriz pode mudar a dimensão da representação. Se:
$$ x\in\mathbb{R}^{3} $$
e:
$$ W\in\mathbb{R}^{2\times3} $$
então:
$$ Wx\in\mathbb{R}^{2} $$
Três dimensões entraram, duas saíram. Se W∈R^{10×3}, a mesma entrada de 3 dimensões vira uma representação de 10 dimensões. É assim que, em Machine Learning, uma matriz converte características originais em novas representações úteis. Em visão computacional, a sequência de camadas leva de pixels a bordas, de bordas a formas e de formas a objetos (Zeiler & Fergus, 2014). Em linguagem, leva de tokens a embeddings, de embeddings a representações contextuais e, por fim, à predição do próximo token (Vaswani et al., 2017). Cada seta dessas cadeias é, no fundo, uma transformação como as deste artigo.
9. De onde vêm os valores de W (e quantos são)
Até aqui os números dentro de W foram dados. Em um modelo real, ninguém os escolhe: no início do treinamento, W começa com valores inicializados numericamente, e o modelo ainda não sabe quais são os melhores pesos.
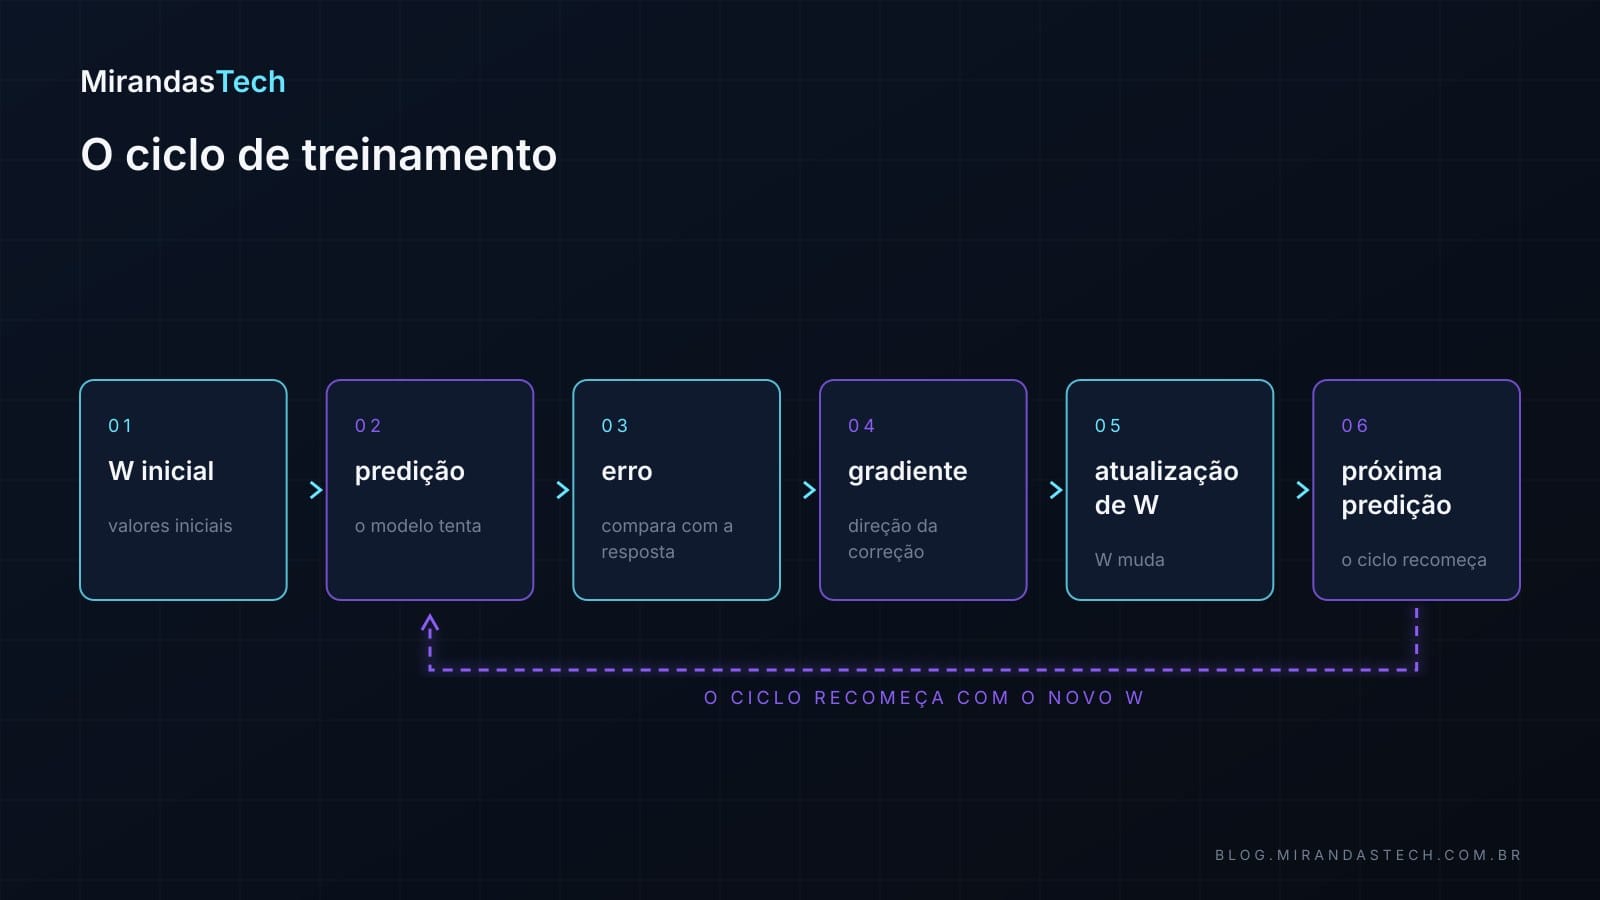
Durante o treinamento, o ciclo se repete: a partir de um W inicial, o modelo faz uma predição; a predição é comparada com a resposta esperada e produz um erro; do erro calcula-se um gradiente; o gradiente atualiza W; com o novo W, uma nova predição. Isso nos levará, mais adiante, ao gradient descent.
Grande parte do que o modelo aprende fica codificada nos valores das matrizes de pesos.
Quantos valores são esses? Se:
$$ W\in\mathbb{R}^{4\times3} $$
há 4×3=12 pesos. Se:
$$ b\in\mathbb{R}^{4} $$
há mais quatro parâmetros. Total:
$$ 12+4=16 $$
Uma matriz 4096×4096 sozinha contém:
$$ 4096^2=16\,777\,216 $$
pesos. É assim que modelos modernos chegam rapidamente a milhões ou bilhões de parâmetros. Quando se diz “modelo de 7 bilhões de parâmetros”, significa aproximadamente:
$$ 7\,000\,000\,000 $$
valores ajustáveis distribuídos por matrizes de pesos, vetores de bias (quando existem) e outros parâmetros do modelo; o LLaMA-7B, por exemplo, tem 6,7 bilhões (Touvron et al., 2023). Esses números aprendidos determinam como as representações são transformadas.
10. Só Wx + b não basta: ativação e arquitetura
Há um limite no que vimos até agora. Uma sequência formada apenas por transformações lineares/afins continua limitada: aplicar uma matriz depois da outra equivale a aplicar uma única transformação afim (Deisenroth, Faisal & Ong, 2020). Para redes profundas aprenderem relações complexas, introduzimos funções não lineares entre as camadas (Cybenko, 1989).
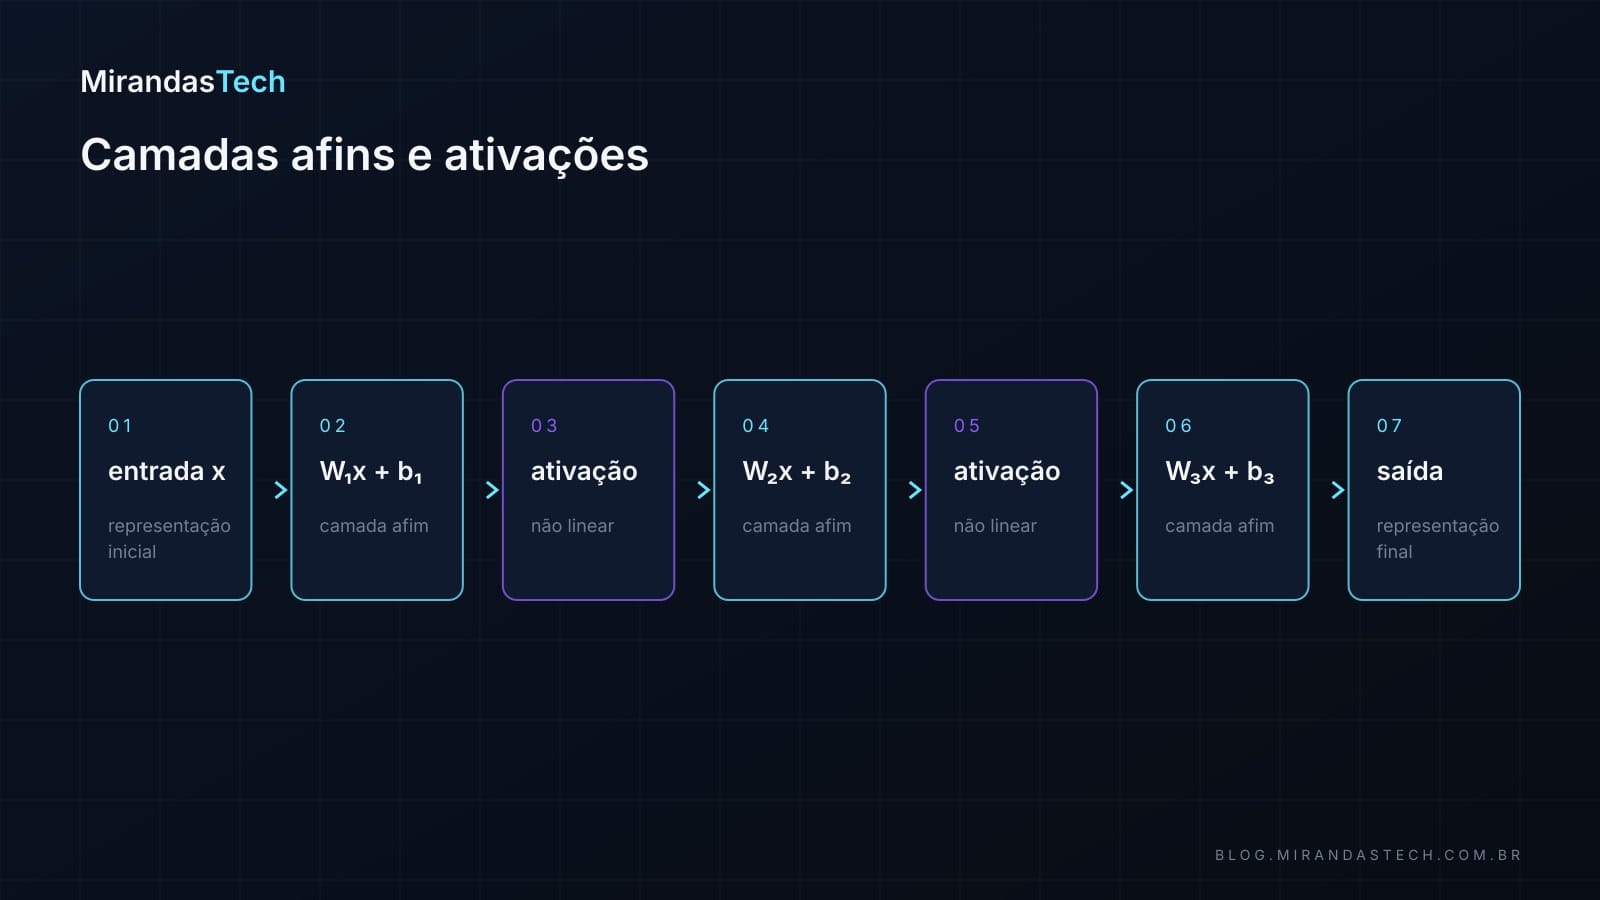
Assim, uma camada típica passa a ser:
$$ \boxed{y=f(Wx+b)} $$
onde f pode ser, por exemplo:
- ReLU, sigmoid ou tanh (Goodfellow, Bengio & Courville, 2016);
- GELU (Hendrycks & Gimpel, 2016);
- SiLU (Elfwing, Uchibe & Doya, 2018).
A mais simples delas é a ReLU:
$$ ReLU(x)=\max(0,x) $$
Se:
$$ z=\begin{bmatrix}2.2\\-0.5\\3.1\end{bmatrix} $$
então:
$$ ReLU(z)=\begin{bmatrix}2.2\\0\\3.1\end{bmatrix} $$
Em NumPy, é uma comparação elemento a elemento:
import numpy as np

z = np.array([2.2, -0.5, 3.1])
print(np.maximum(0, z))
[2.2 0. 3.1]
Com esse ingrediente, a arquitetura começa a aparecer: a entrada x passa por W₁x + b₁ e por uma ativação; o resultado passa por W₂x + b₂ e por outra ativação; depois por W₃x + b₃, que produz a saída. Isso já é a estrutura básica de uma rede neural multicamadas, e cada bloco dela é a equação que este artigo desmontou.
11. Ligando as aulas e a pergunta para sempre fazer
Este artigo fecha o primeiro arco da trilha. Cada aula acrescentou uma peça:
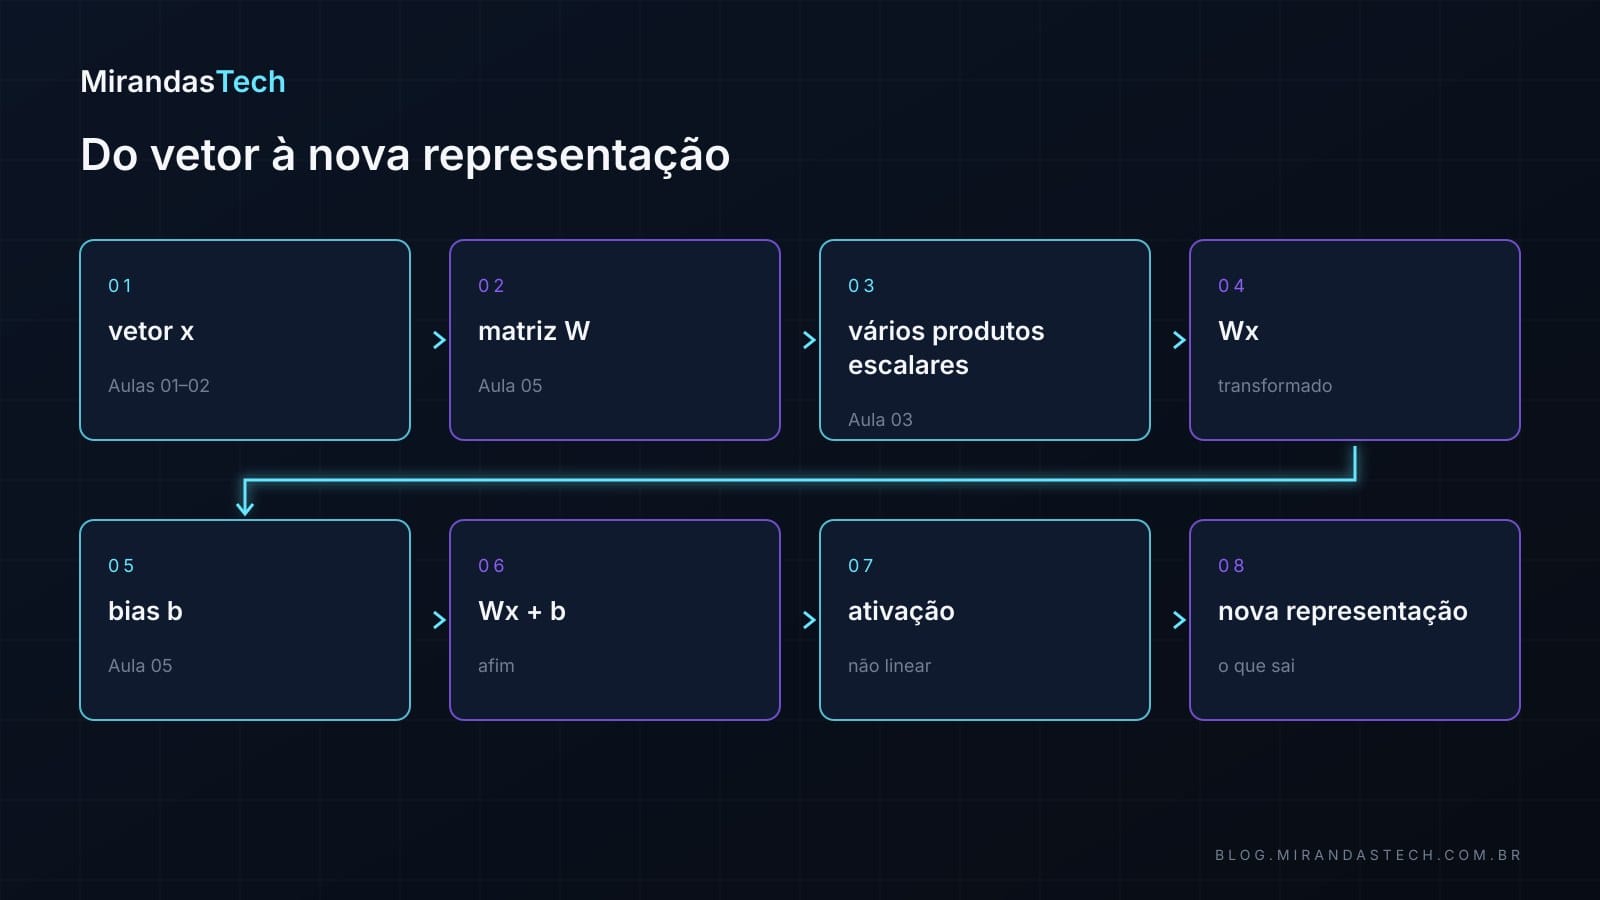
- Aula 01 — vetores, matrizes e tensores;
- Aula 02 — norma e geometria;
- Aula 03 — produto escalar;
- Aula 04 — similaridade de cosseno;
- Aula 05 — transformações
y=Wx+b.
A progressão pode ser resumida em uma linha: um vetor x encontra uma matriz W; a multiplicação é um conjunto de produtos escalares que produz Wx; o bias b desloca para Wx + b; a ativação produz uma nova representação. Tudo o que vem depois na trilha, de transformações geométricas a gradient descent, opera sobre essa cadeia.
Fica também um hábito. Quando encontrar algo como:
W.shape = (512, 768)
x.shape = (768,)
pergunte:
- O que representam as 768 dimensões?
- Por que estamos produzindo 512 valores?
- O que essa transformação está tentando aprender?
É exatamente o que nn.Linear(768, 512) da abertura constrói: uma matriz W de shape (512, 768) e um bias de 512 posições. Não trate shapes como detalhes da biblioteca. Eles expressam a arquitetura do modelo.
12. Exercícios
1. Escala em dois eixos. Considere:
$$ W=\begin{bmatrix}2&0\\0&3\end{bmatrix},\quad x=\begin{bmatrix}2\\1\end{bmatrix} $$
Calcule Wx e explique geometricamente o que aconteceu.
2. Multiplicação matriz-vetor.
$$ W=\begin{bmatrix}1&2\\3&4\end{bmatrix},\quad x=\begin{bmatrix}2\\1\end{bmatrix} $$
Calcule Wx.
3. Shapes. Se:
$$ W\in\mathbb{R}^{5\times3},\quad x\in\mathbb{R}^{3} $$
qual a dimensão de Wx?
4. Compatibilidade. É possível multiplicar:
$$ W\in\mathbb{R}^{4\times5} $$
por:
$$ x\in\mathbb{R}^{3} $$
? Explique.
5. Bias. Se:
$$ Wx=\begin{bmatrix}3\\-2\end{bmatrix},\quad b=\begin{bmatrix}1\\4\end{bmatrix} $$
calcule Wx+b.
6. Dimensão de uma camada. Uma camada recebe 768 valores e produz 512. Qual deve ser a dimensão de W, usando a convenção:
$$ y=Wx $$
?
7. Questão principal. Explique com suas palavras o que significa dizer:
“Uma matriz de pesos representa uma transformação aprendida.”
Relacione sua resposta com:
$$ x\rightarrow Wx\rightarrow y $$
Mini desafio em NumPy. Parta do código da seção 7:
import numpy as np

x = np.array([2, 1])

W = np.array([
    [0.5, 1.0],
    [-1.0, 2.0]
])

b = np.array([0.2, 0.5])

y = W @ x + b
print(y)
Depois altere manualmente os valores de W e observe como a saída muda. A pergunta a responder: o que acontece com a transformação quando mudamos os pesos?
O que guardar
Não memorize matriz apenas como uma tabela de números. Guarde:
$$ \boxed{\text{matriz}=\text{transformação}} $$
E:
$$ \boxed{W=\text{parâmetros aprendíveis dessa transformação}} $$
Assim:
$$ \boxed{y=Wx+b} $$
significa:
Pegue uma representação, transforme-a usando pesos aprendidos e desloque o resultado usando um bias.
Na Aula 06, Transformações geométricas: escala, rotação, reflexão e projeção, vamos visualizar como matrizes conseguem esticar, comprimir, rotacionar, refletir, projetar e deformar um espaço, transformando a multiplicação matricial de uma operação abstrata em algo visual e intuitivo.
Referências
- PyTorch. torch.nn.Linear. Documentação oficial do PyTorch, v2.14, 2026. Acesso em 13 set. 2026. docs.pytorch.org/docs/stable/generated/torch.nn.Linear.html
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. doi.org/10.1017/9781108679930
- Touvron, Hugo; Lavril, Thibaut; Izacard, Gautier et al. LLaMA: Open and Efficient Foundation Language Models. arXiv, 2023. arxiv.org/abs/2302.13971
- Meta AI. llama: código-fonte oficial do LLaMA, arquivo llama/model.py (tag llama_v1). GitHub, 2023. Acesso em 13 set. 2026. github.com/meta-llama/llama/blob/llama_v1/llama/model.py
- Vaswani, Ashish; Shazeer, Noam; Parmar, Niki et al. Attention Is All You Need. arXiv (NeurIPS 2017), 2017. arxiv.org/abs/1706.03762
- Zeiler, Matthew D.; Fergus, Rob. Visualizing and Understanding Convolutional Networks. Computer Vision – ECCV 2014, Lecture Notes in Computer Science, Springer, pp. 818–833, 2014. doi.org/10.1007/978-3-319-10590-1_53
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. MIT Press, 2016. www.deeplearningbook.org
- Cybenko, George. Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals, and Systems, v. 2, n. 4, pp. 303–314, 1989. doi.org/10.1007/BF02551274
- Hendrycks, Dan; Gimpel, Kevin. Gaussian Error Linear Units (GELUs). arXiv, 2016. arxiv.org/abs/1606.08415
- Elfwing, Stefan; Uchibe, Eiji; Doya, Kenji. Sigmoid-weighted linear units for neural network function approximation in reinforcement learning. Neural Networks, v. 107, pp. 3–11, 2018. doi.org/10.1016/j.neunet.2017.12.012

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/05-matrizes-transformacoes-y-wx-b.md.



