Similaridade de cosseno na prática: embeddings, busca semântica e RAG
Entenda como a similaridade de cosseno transforma geometria vetorial em embeddings, busca semântica, ranking Top-K e sistemas RAG.

Matemática para IA - Parte 04
Nas aulas anteriores, construímos uma sequência importante: aprendemos a representar dados como vetores, medir sua magnitude e calcular o produto escalar. Agora chegamos a uma das aplicações mais úteis dessa matemática em inteligência artificial: comparar vetores pela direção em que apontam.
A similaridade de cosseno mede o alinhamento entre dois vetores reduzindo a influência de suas magnitudes.
Essa ideia aparece diretamente em embeddings, busca semântica, ranking vetorial e sistemas RAG.
1. Do produto escalar à similaridade de cosseno
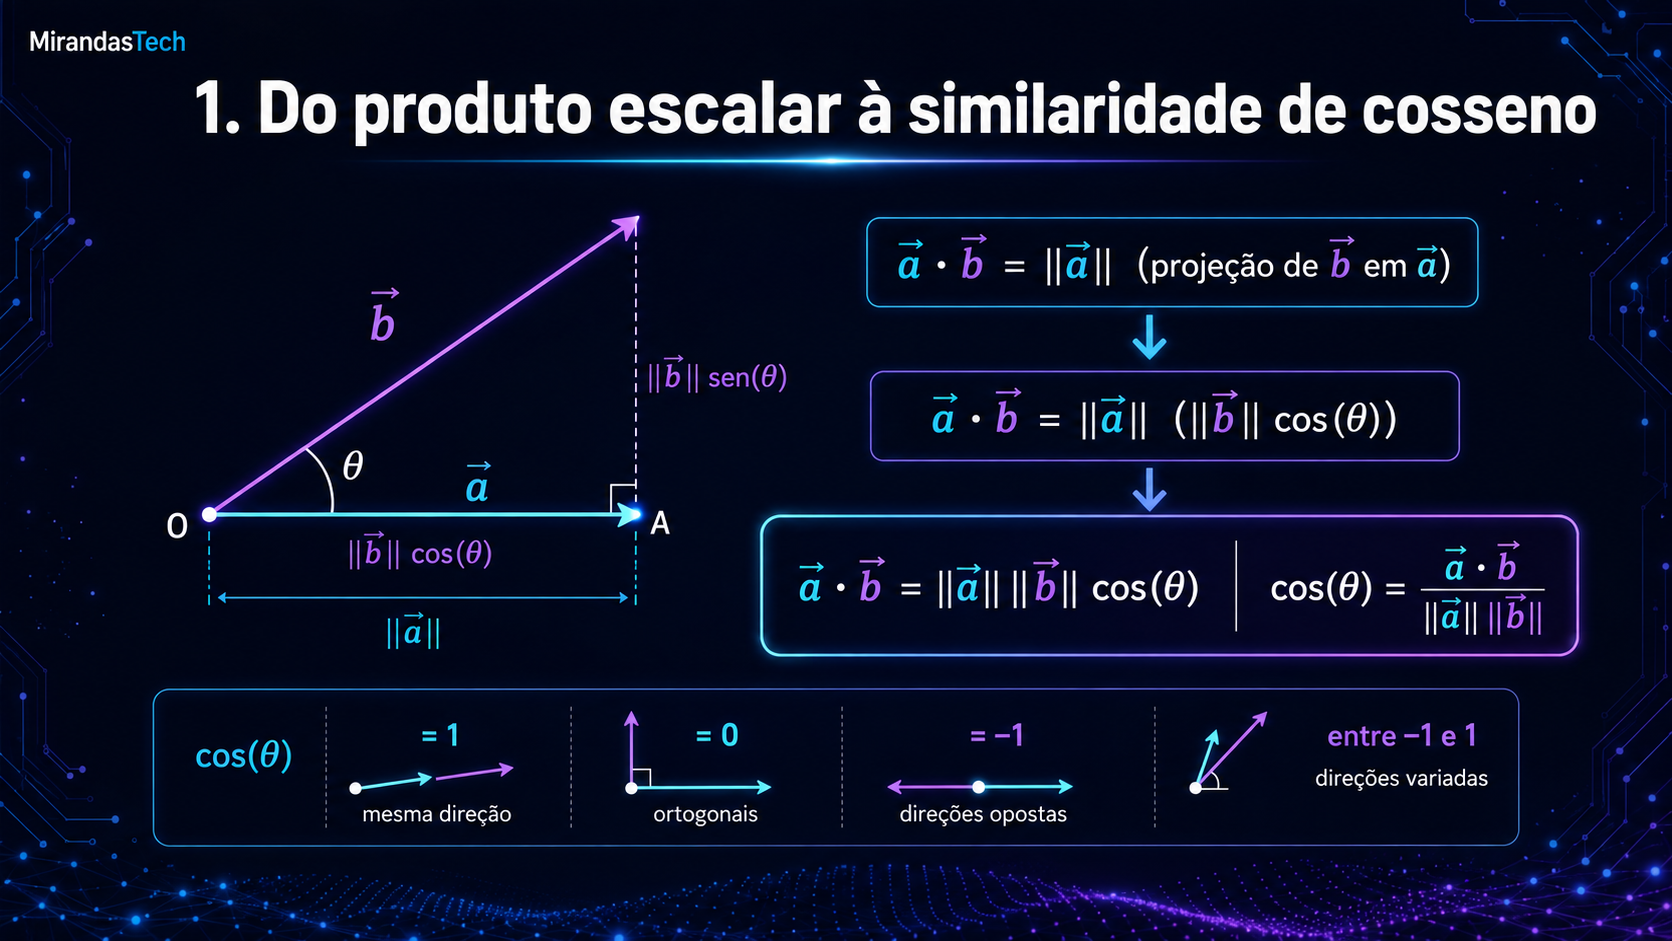
Na Aula 03 vimos a relação geométrica:
a · b = ||a|| ||b|| cos(θ)O produto escalar depende tanto do ângulo quanto do tamanho dos dois vetores. Mas, em muitos problemas de IA, queremos responder uma pergunta diferente:
Os vetores apontam para direções semelhantes?
Isolando o cosseno do ângulo:
cos(θ) = (a · b) / (||a|| ||b||)Essa expressão é a similaridade de cosseno.
2. Por que remover a influência da magnitude?
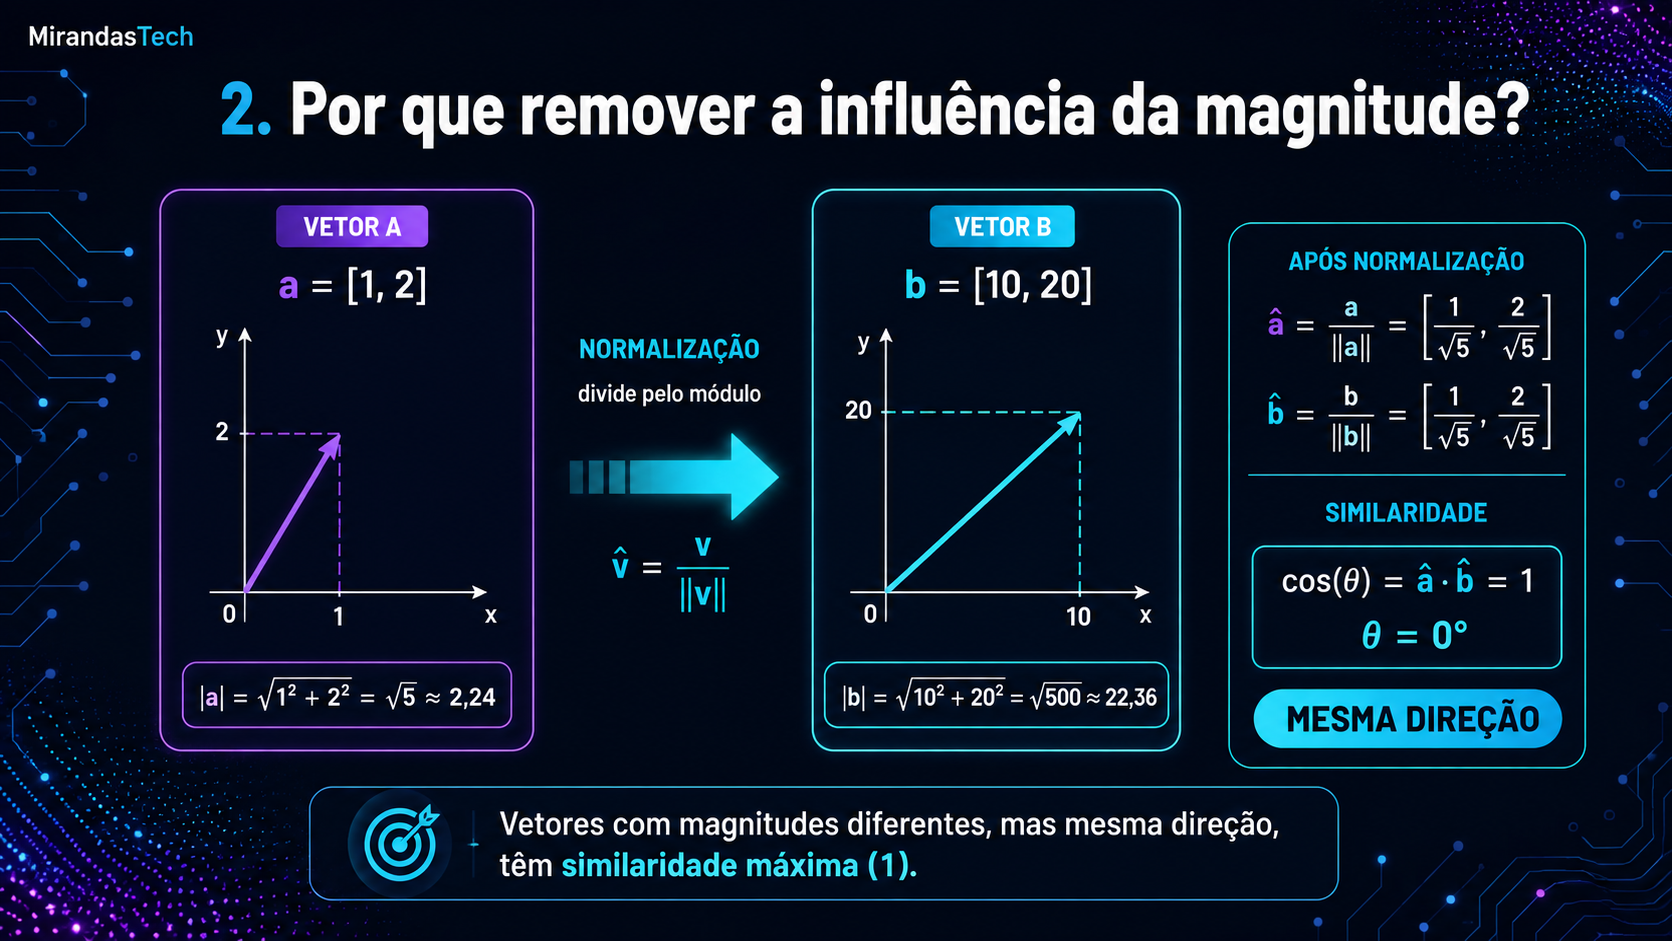
Considere:
a = [1, 2]
b = [10, 20]
O segundo vetor é dez vezes maior que o primeiro:
b = 10aAs magnitudes são muito diferentes, porém os dois apontam exatamente para a mesma direção. O ângulo entre eles é 0° e:
cos(0°) = 1Portanto:
similaridade(a,b) = 1Isso mostra a principal característica da métrica: ela consegue reconhecer alinhamento mesmo quando os tamanhos dos vetores são diferentes.
3. Como interpretar os valores?
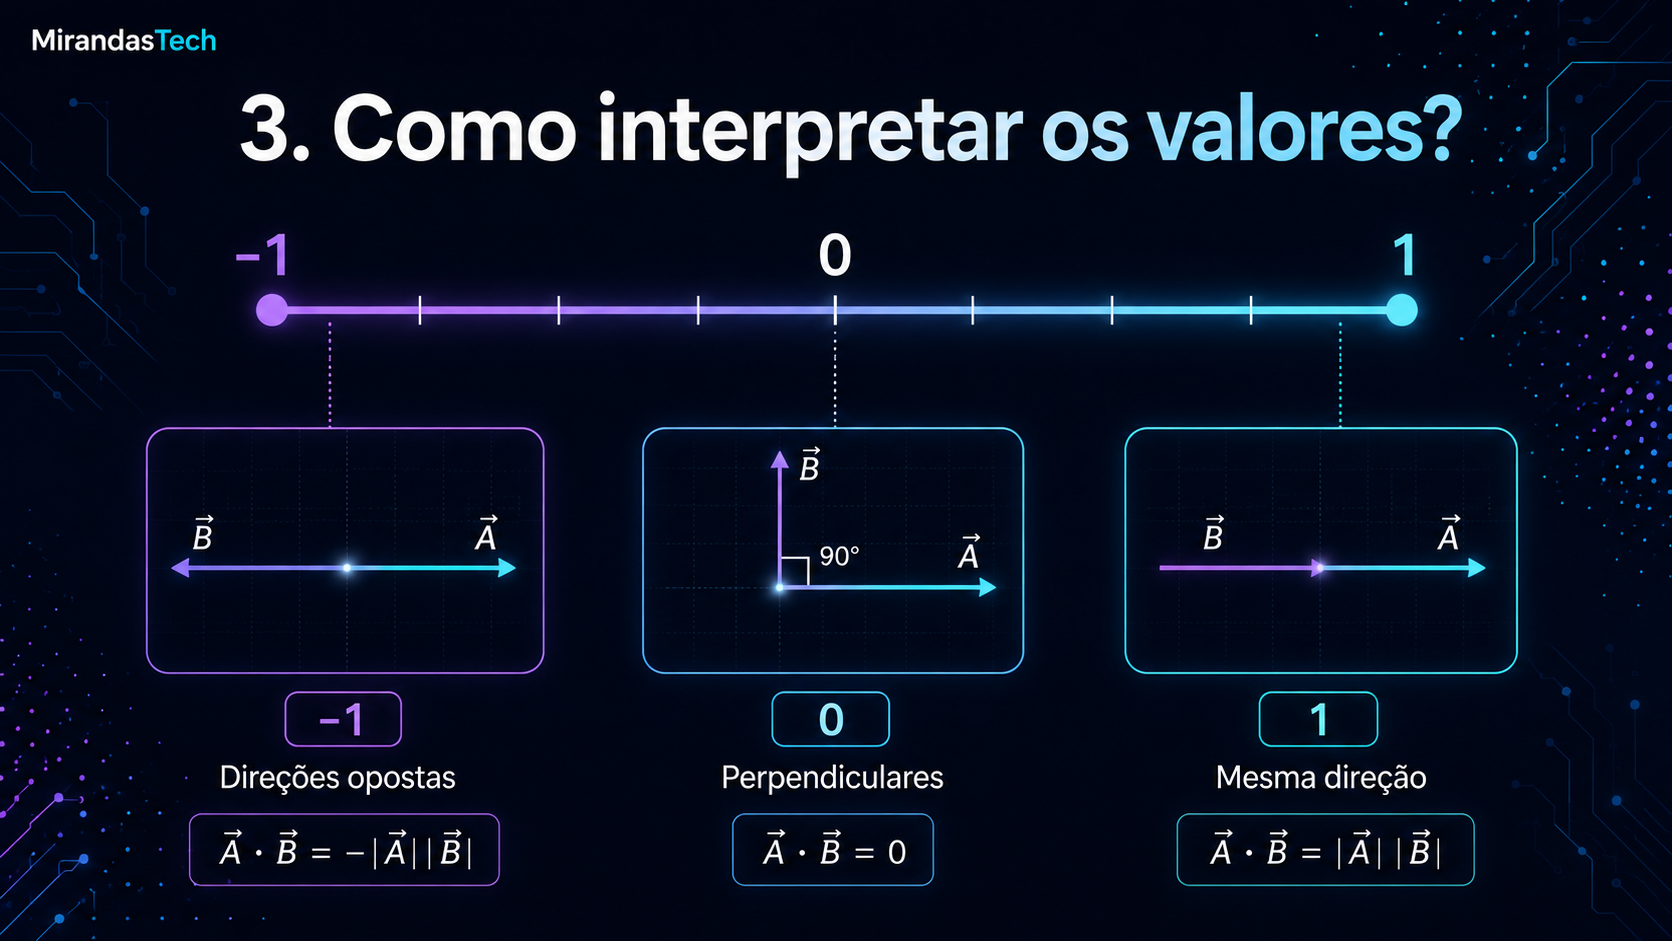
| Similaridade | Interpretação geométrica |
|---|---|
| 1 | mesma direção |
| próxima de 1 | direções muito semelhantes |
| 0 | vetores perpendiculares |
| negativa | direções opostas |
| -1 | direções exatamente opostas |
Em tarefas com embeddings, normalmente procuramos os vetores com maior score de similaridade.
4. Exemplo completo
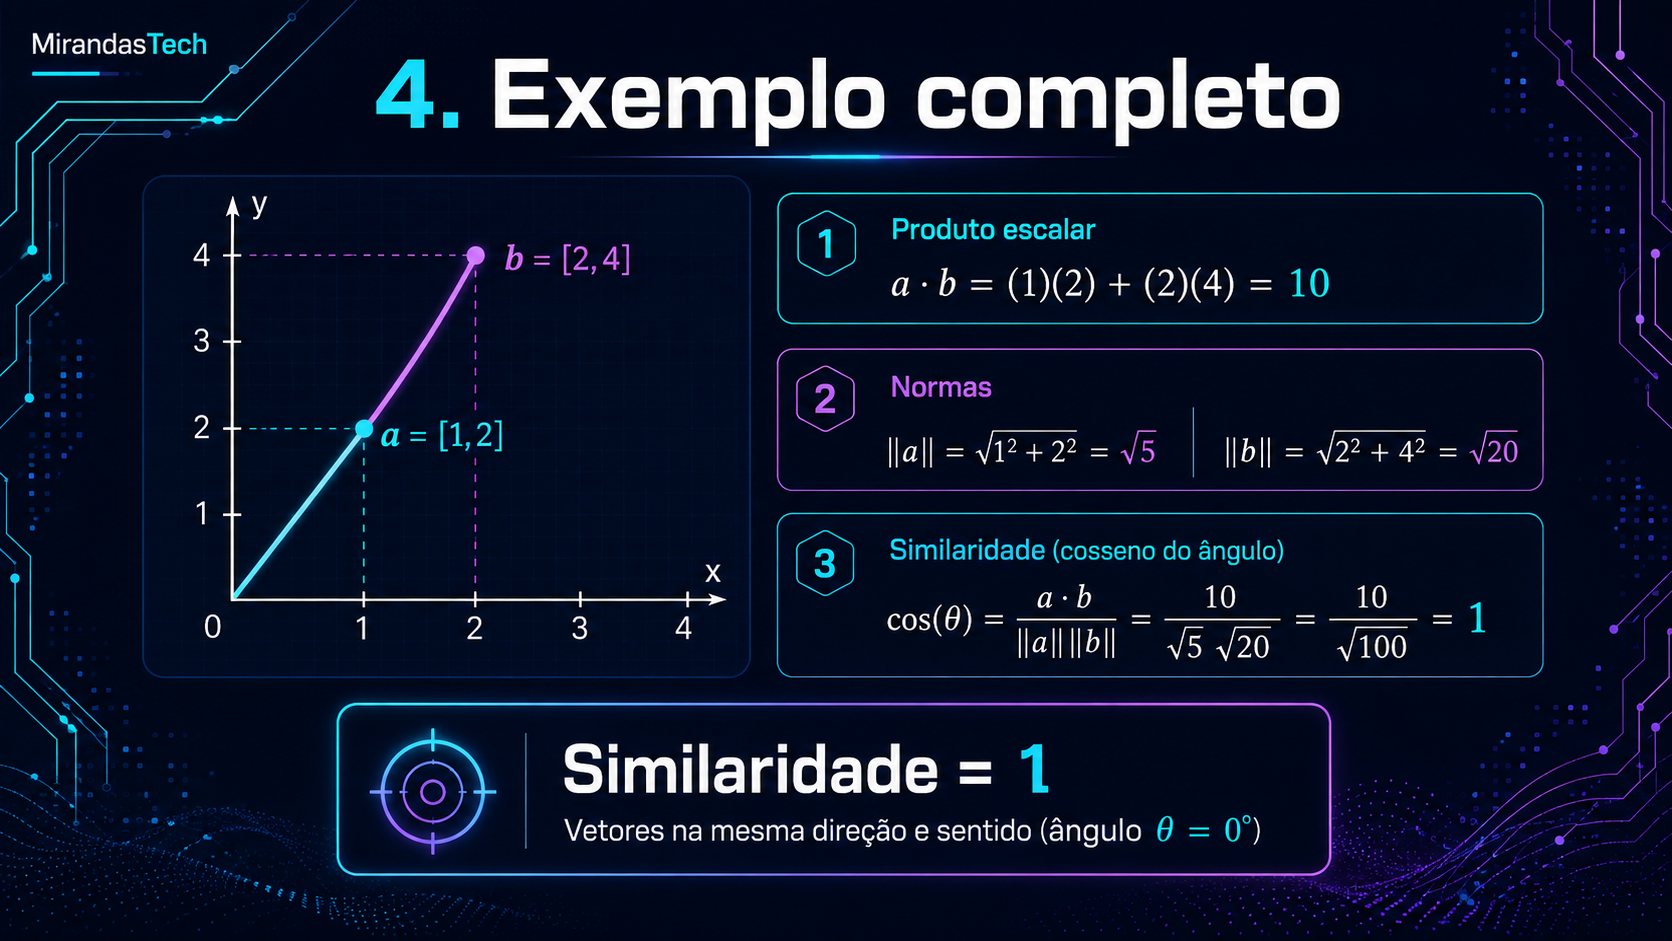
Considere:
a = [1, 2]
b = [2, 4]
Primeiro calculamos o produto escalar:
a · b = 1×2 + 2×4 = 10As normas são:
||a|| = √5
||b|| = √20
Então:
similaridade = 10 / (√5 × √20)
             = 10 / 10
             = 1
Os dois vetores possuem exatamente a mesma direção.
5. Vetores perpendiculares e opostos
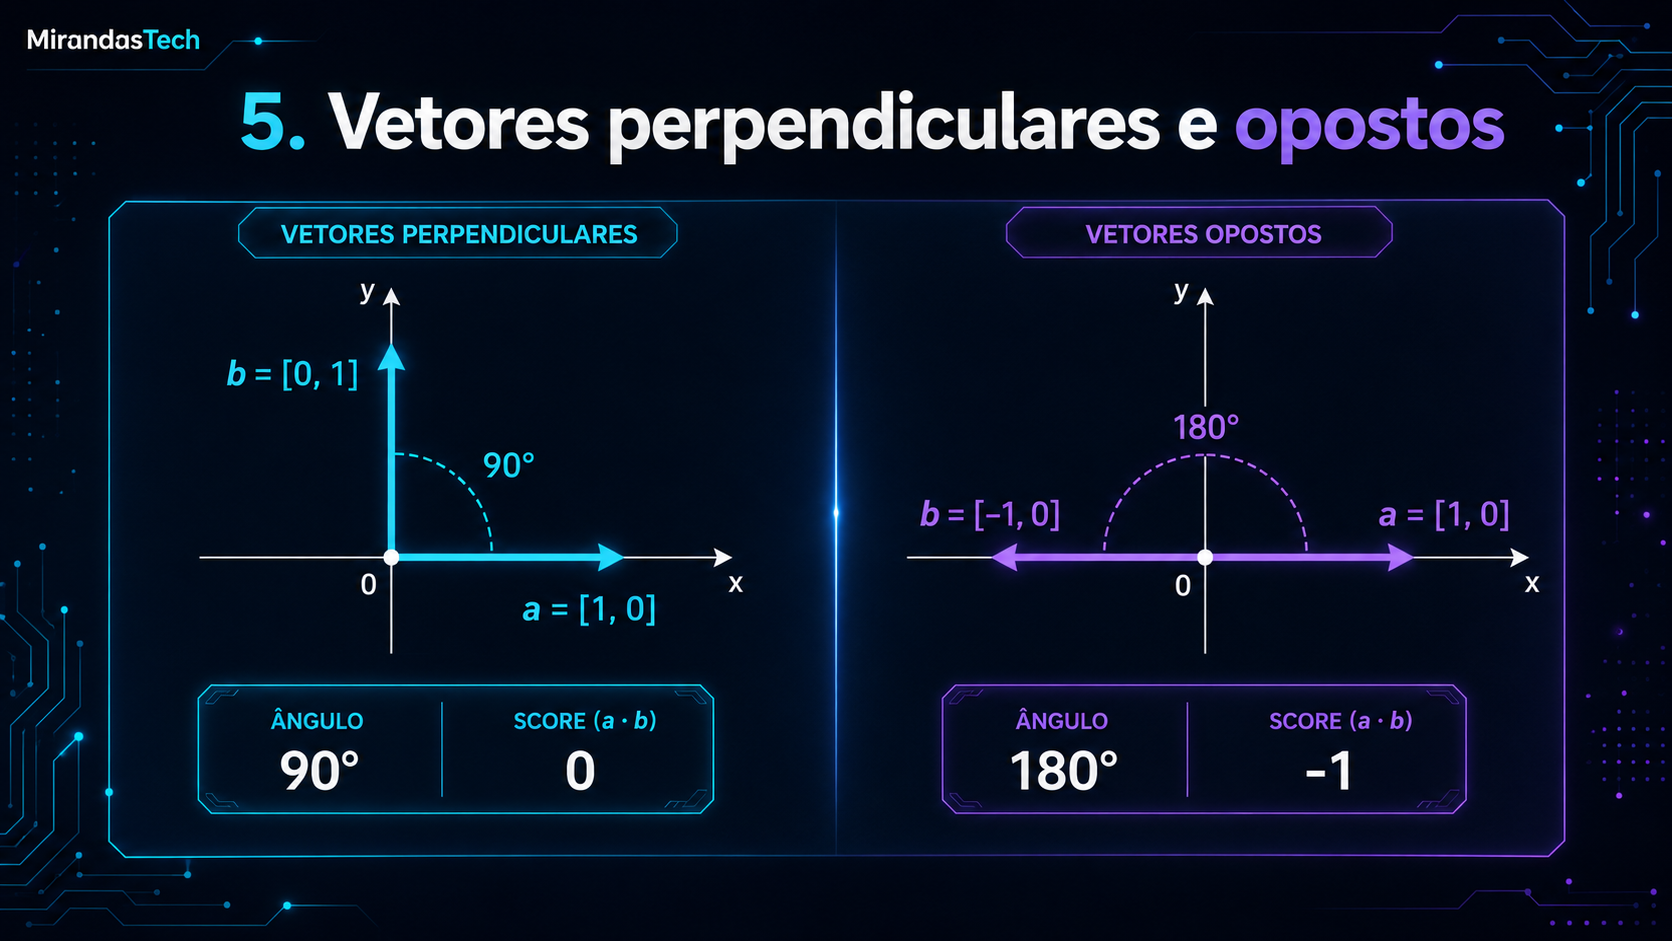
Para:
a = [1, 0]
b = [0, 1]
o produto escalar é zero, logo a similaridade de cosseno também é zero. Geometricamente, os vetores formam 90°.
Já para:
a = [1, 0]
b = [-1, 0]
o ângulo é 180° e a similaridade é:
-16. Implementando em NumPy
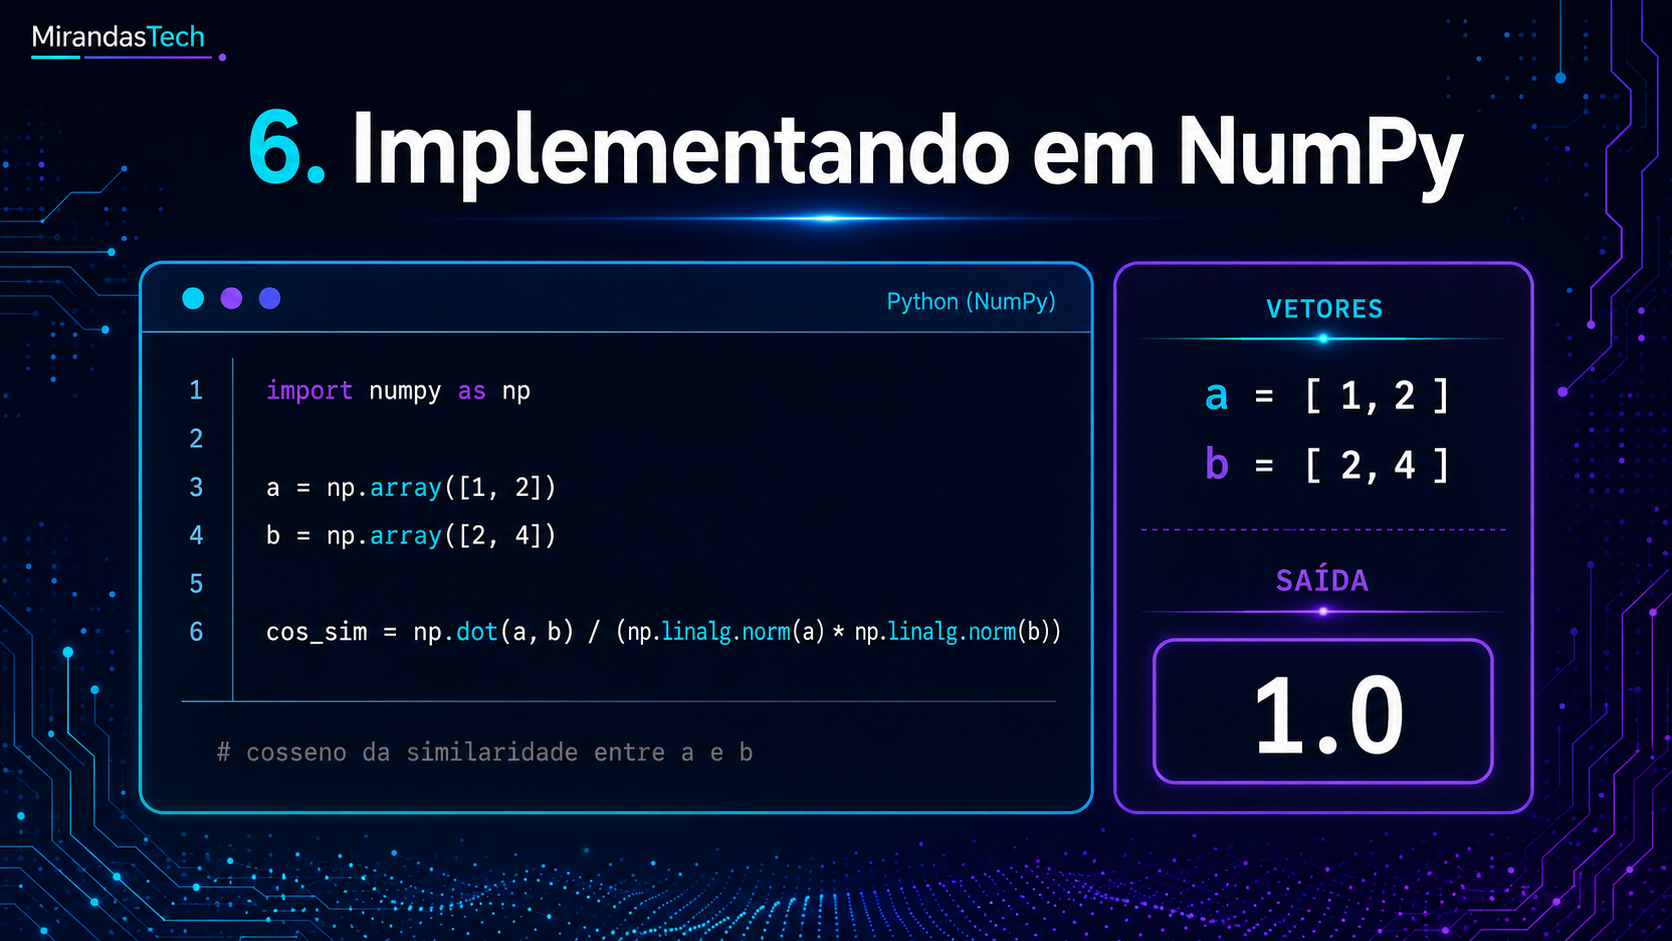
import numpy as np


def cosine_similarity(a, b):
    return np.dot(a, b) / (
        np.linalg.norm(a) * np.linalg.norm(b)
    )


a = np.array([1, 2])
b = np.array([2, 4])

print(cosine_similarity(a, b))
# 1.0
7. Vetores normalizados simplificam a conta
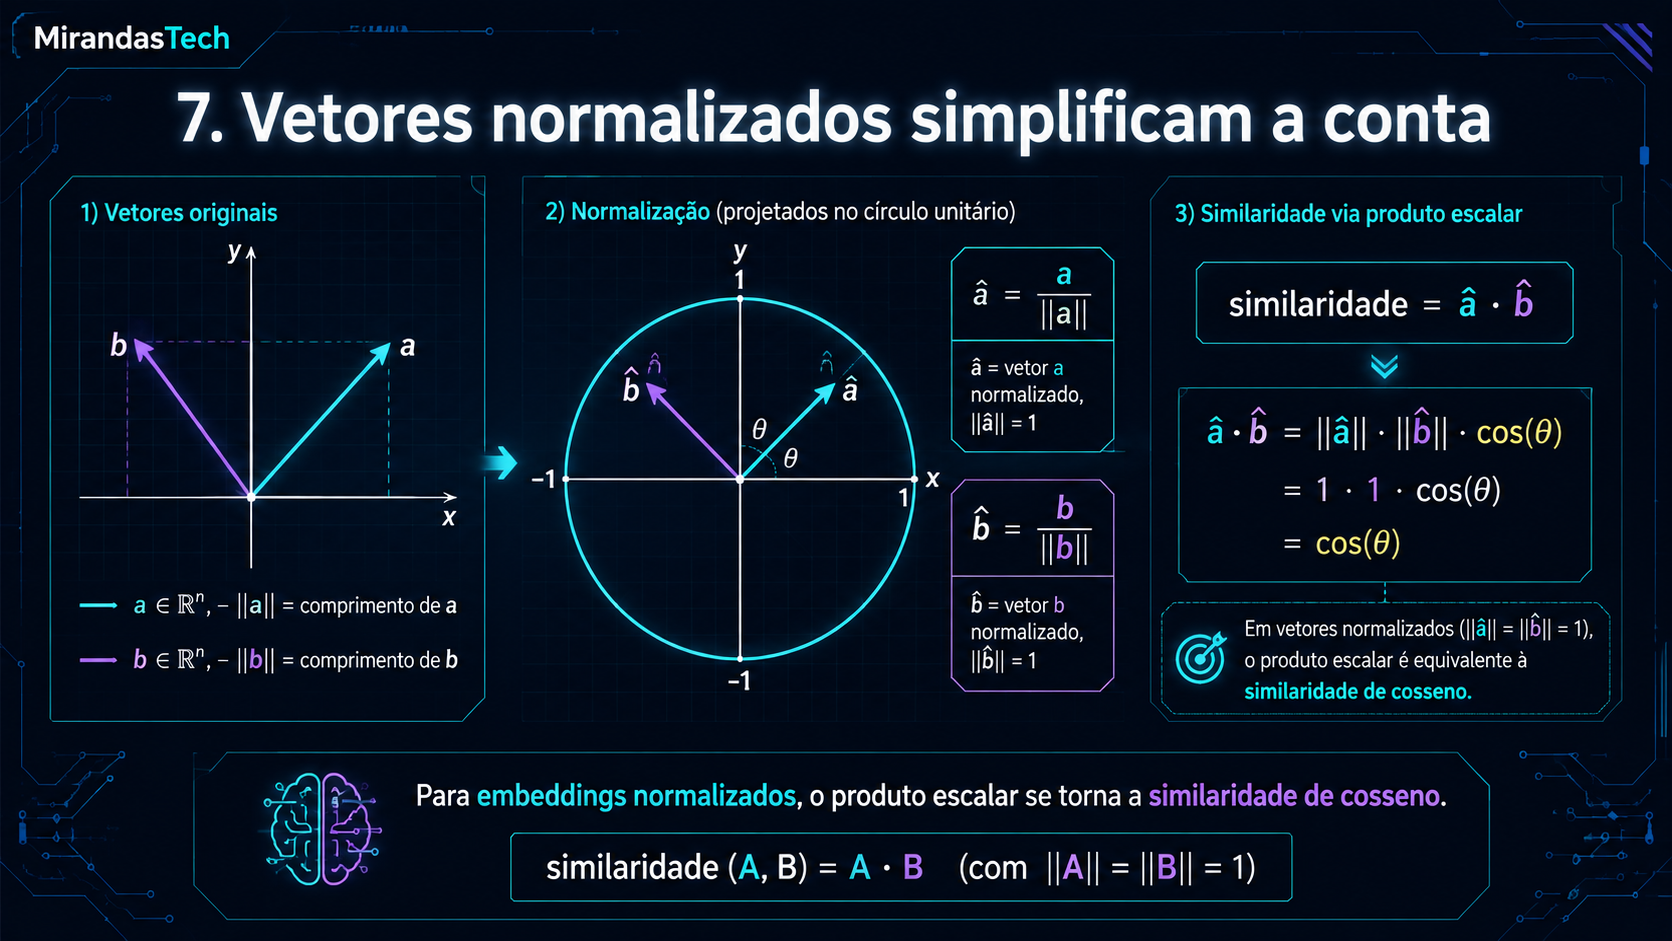
Quando normalizamos os vetores:
â = a / ||a||
b̂ = b / ||b||
suas normas passam a valer 1. Assim:
similaridade(a,b) = â · b̂Quando os embeddings já estão normalizados, o produto escalar equivale à similaridade de cosseno.
Essa relação é importante para compreender como sistemas de busca vetorial podem tornar comparações mais eficientes.
8. De palavras para embeddings
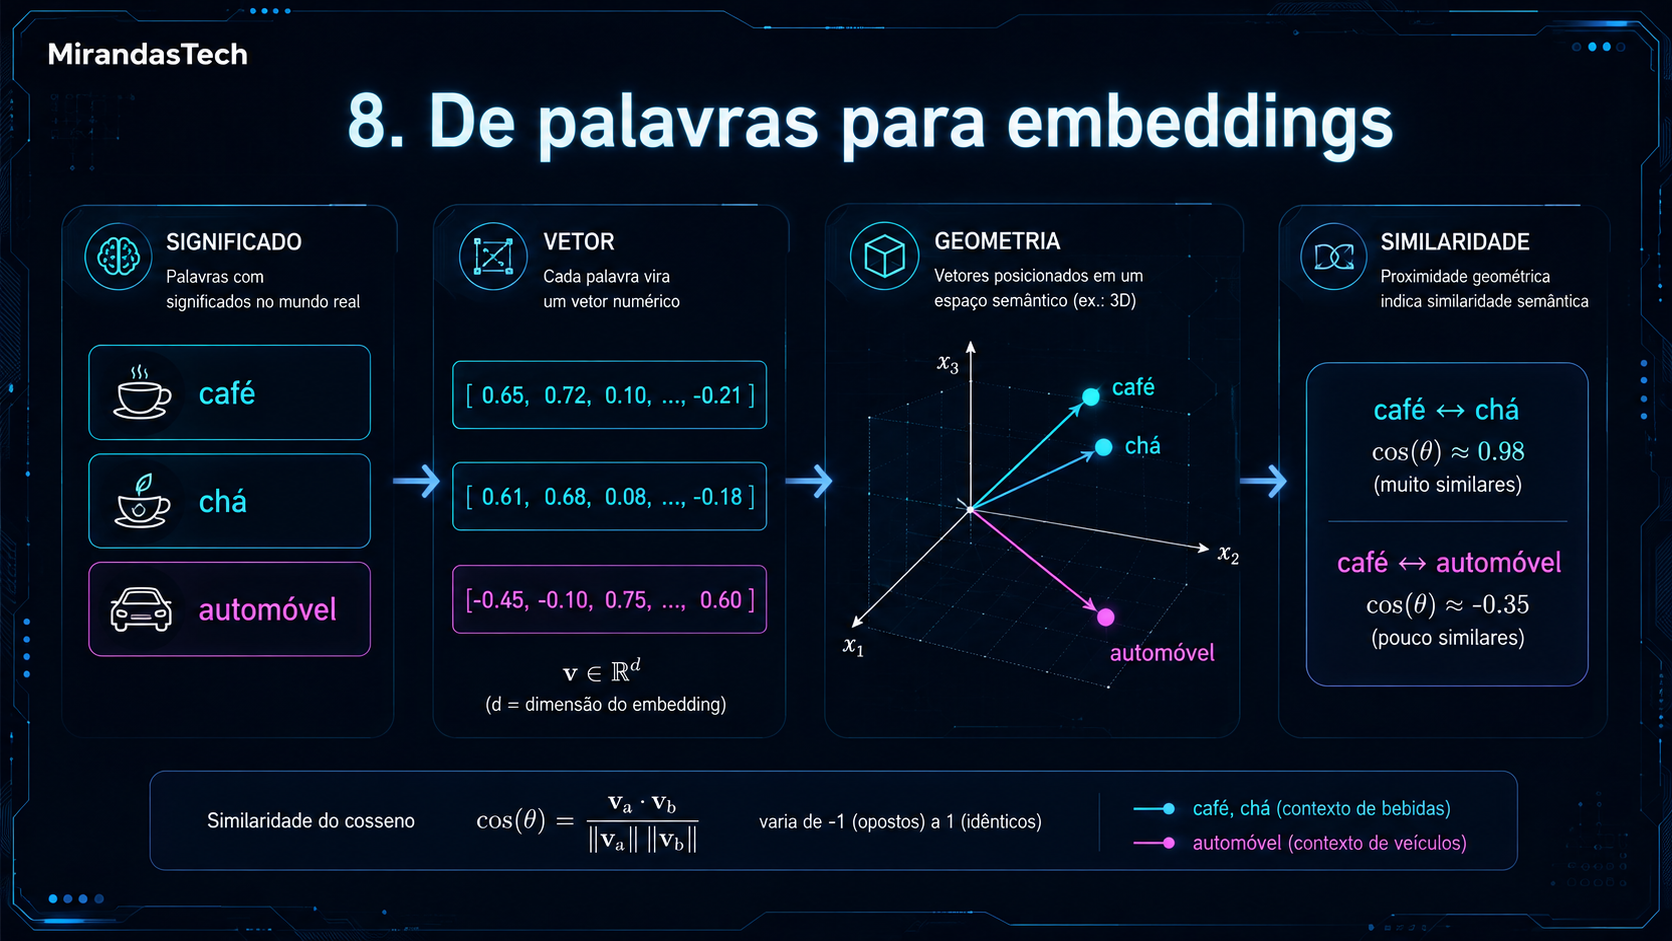
Imagine, apenas didaticamente:
café      = [ 0.72, 0.41,  0.88]
chá       = [ 0.69, 0.39,  0.84]
automóvel = [-0.42, 0.91, -0.35]
Se compararmos o embedding de “café” com os outros, é plausível que “chá” tenha maior alinhamento que “automóvel”.
A ideia central é:
significado
    ↓
vetor
    ↓
geometria
    ↓
similaridade
9. Significado virou geometria
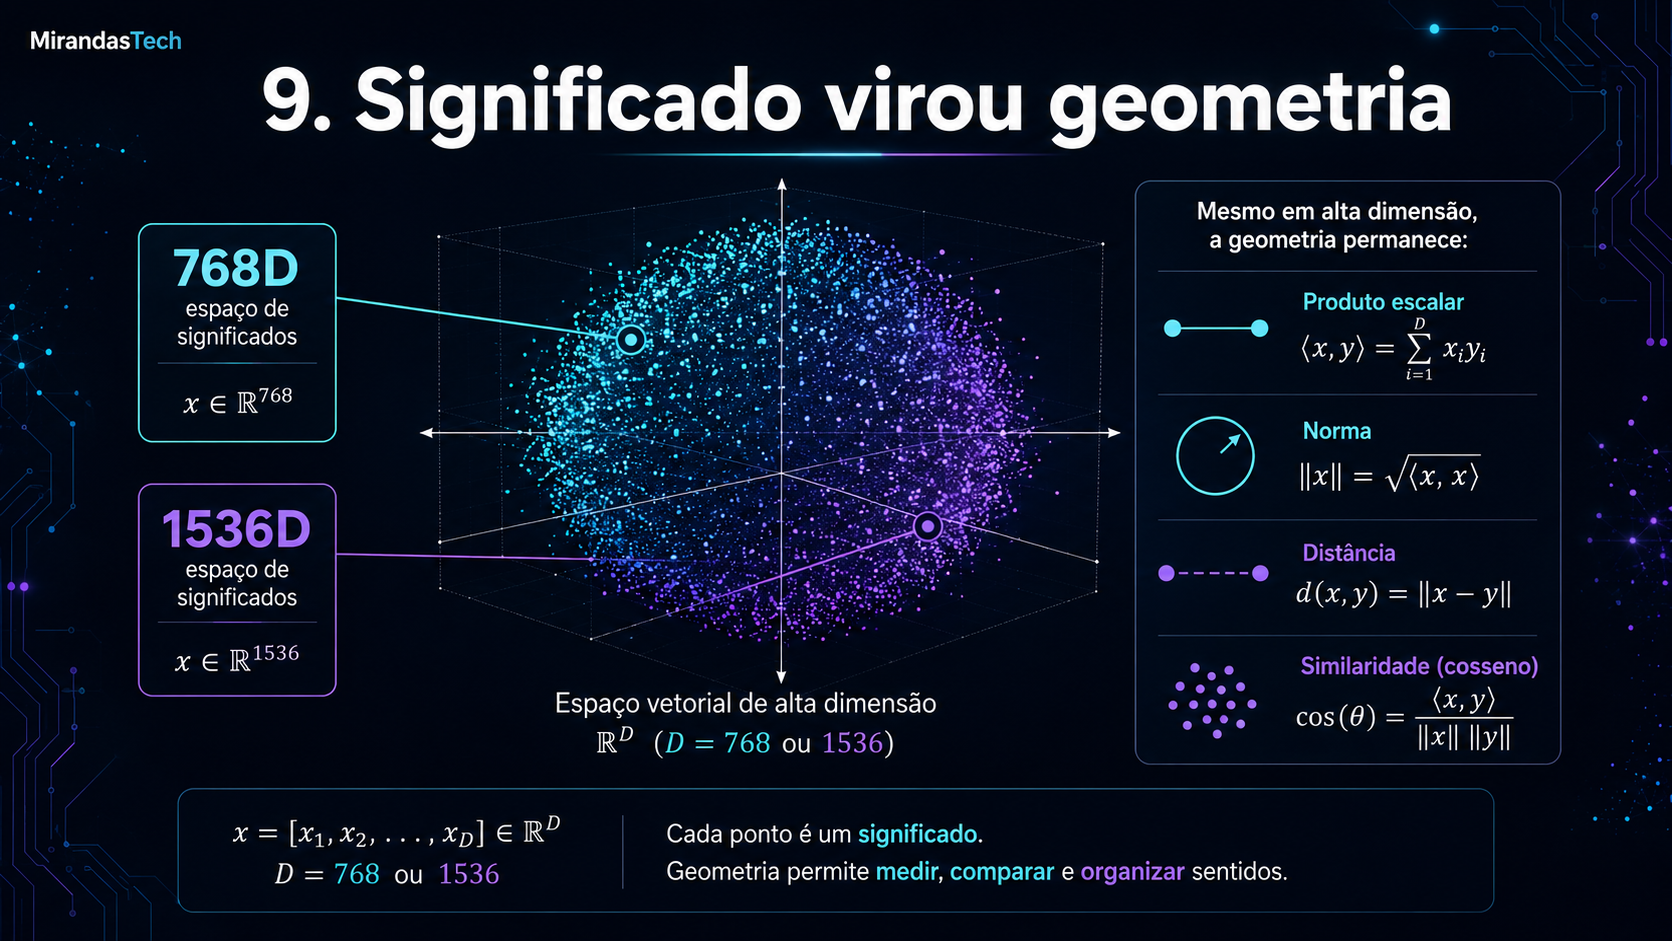
Embeddings reais podem possuir centenas ou milhares de dimensões. Não conseguimos visualizar um espaço de 768 ou 1536 dimensões, mas ainda conseguimos calcular:
- produto escalar;
- norma;
- distância;
- similaridade.
É por isso que podemos realizar geometria em espaços semânticos de alta dimensão.
10. Busca por palavra-chave versus busca semântica
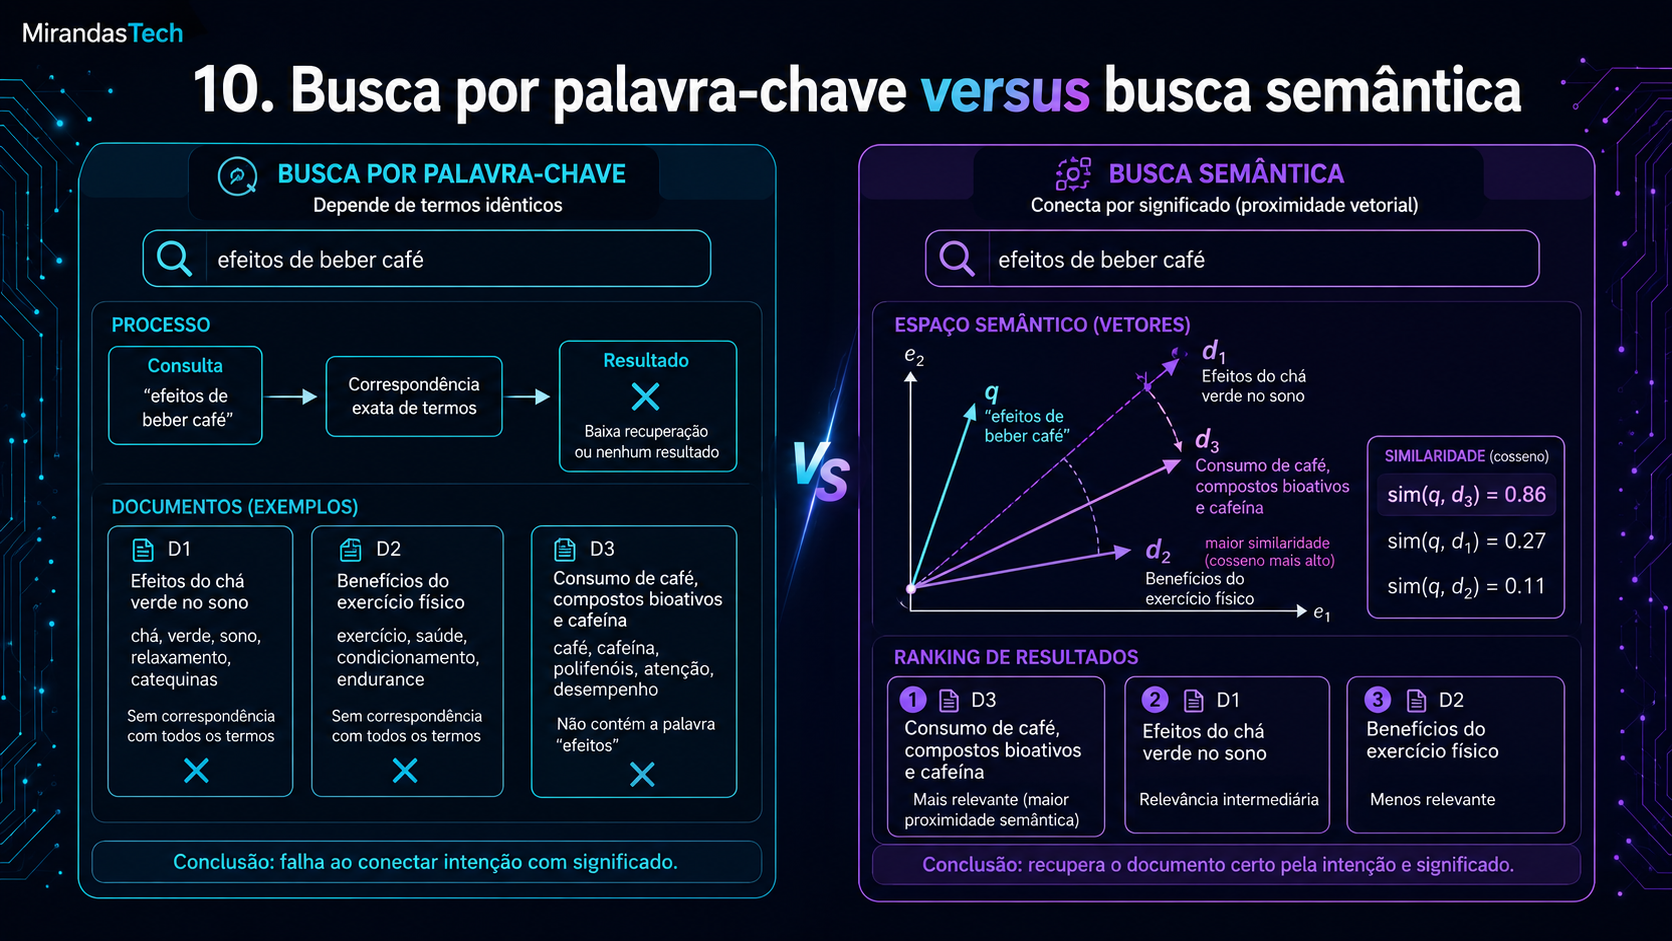
Considere um documento:
O consumo moderado de café contém compostos bioativos e cafeína.
E uma consulta:
Quais são os efeitos de beber café?
Uma busca puramente textual pode depender muito da coincidência de palavras. Uma busca semântica converte consulta e documentos em embeddings e compara suas representações, permitindo recuperar conteúdos relacionados mesmo quando a redação é diferente.
11. Ranking vetorial
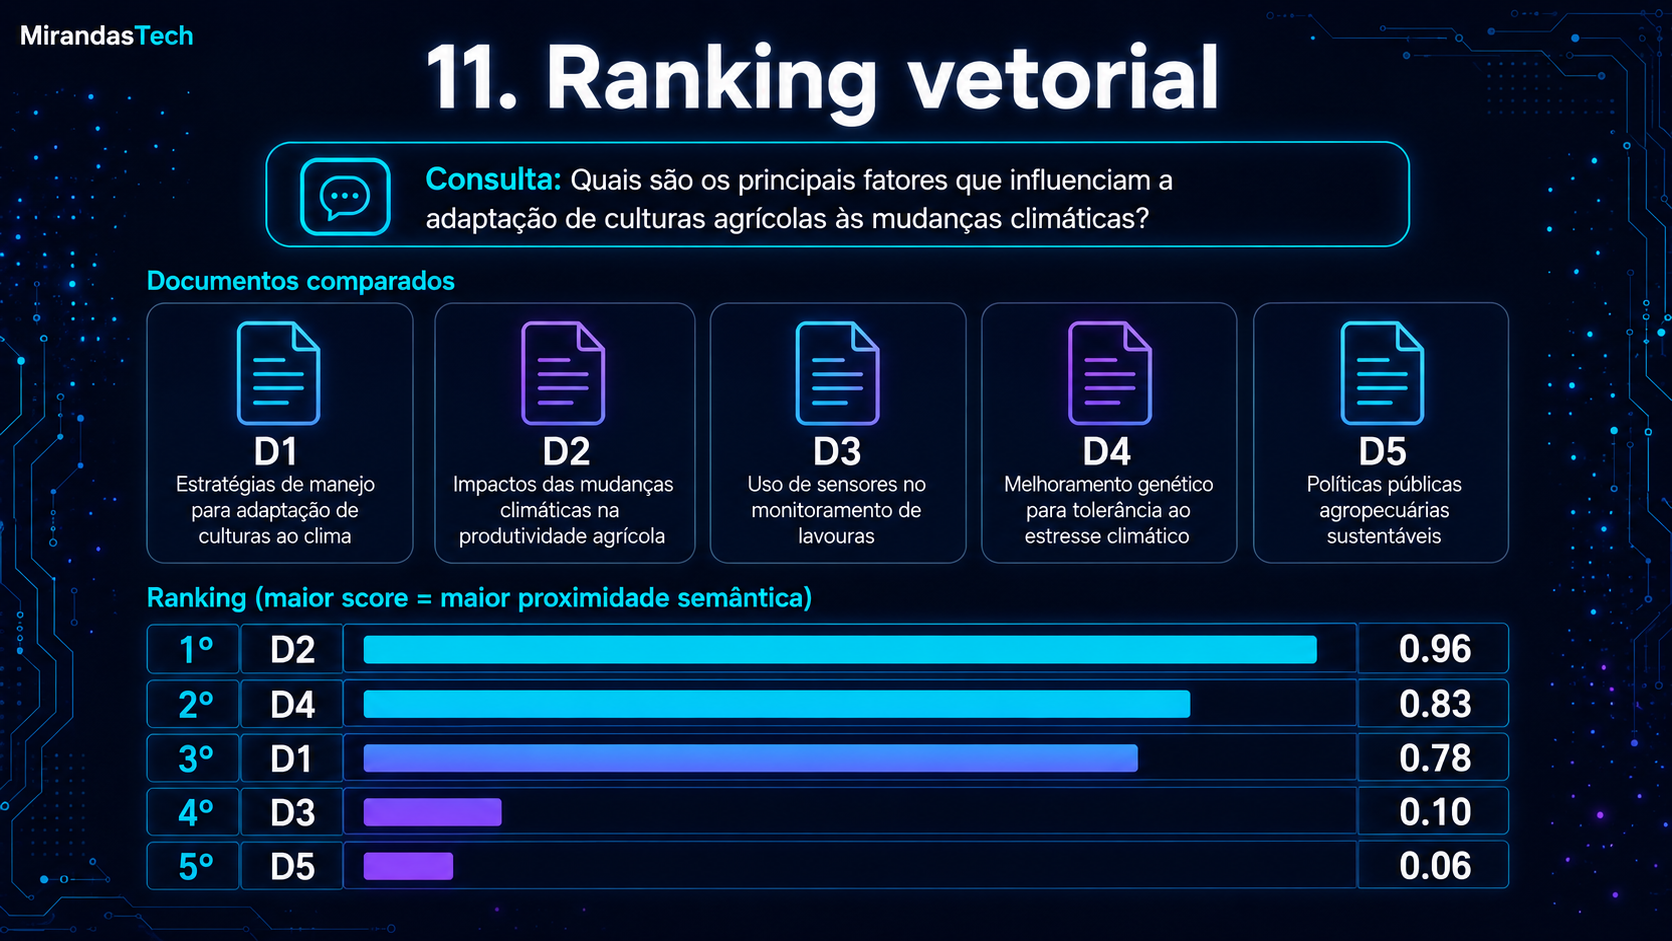
Imagine a coleção:
D1 — Cultivo de café no Brasil
D2 — Benefícios e composição do café
D3 — Manutenção de motores elétricos
D4 — Chá verde e cafeína
D5 — Legislação de trânsito
Consulta:
Qual a relação entre café e cafeína?
Depois da comparação vetorial, poderíamos obter um ranking ilustrativo:
1º D2 → 0.96
2º D4 → 0.83
3º D1 → 0.78
4º D3 → 0.10
5º D5 → 0.06
O sistema não está apenas procurando palavras: ele está ordenando documentos por proximidade semântica.
12. Top-K
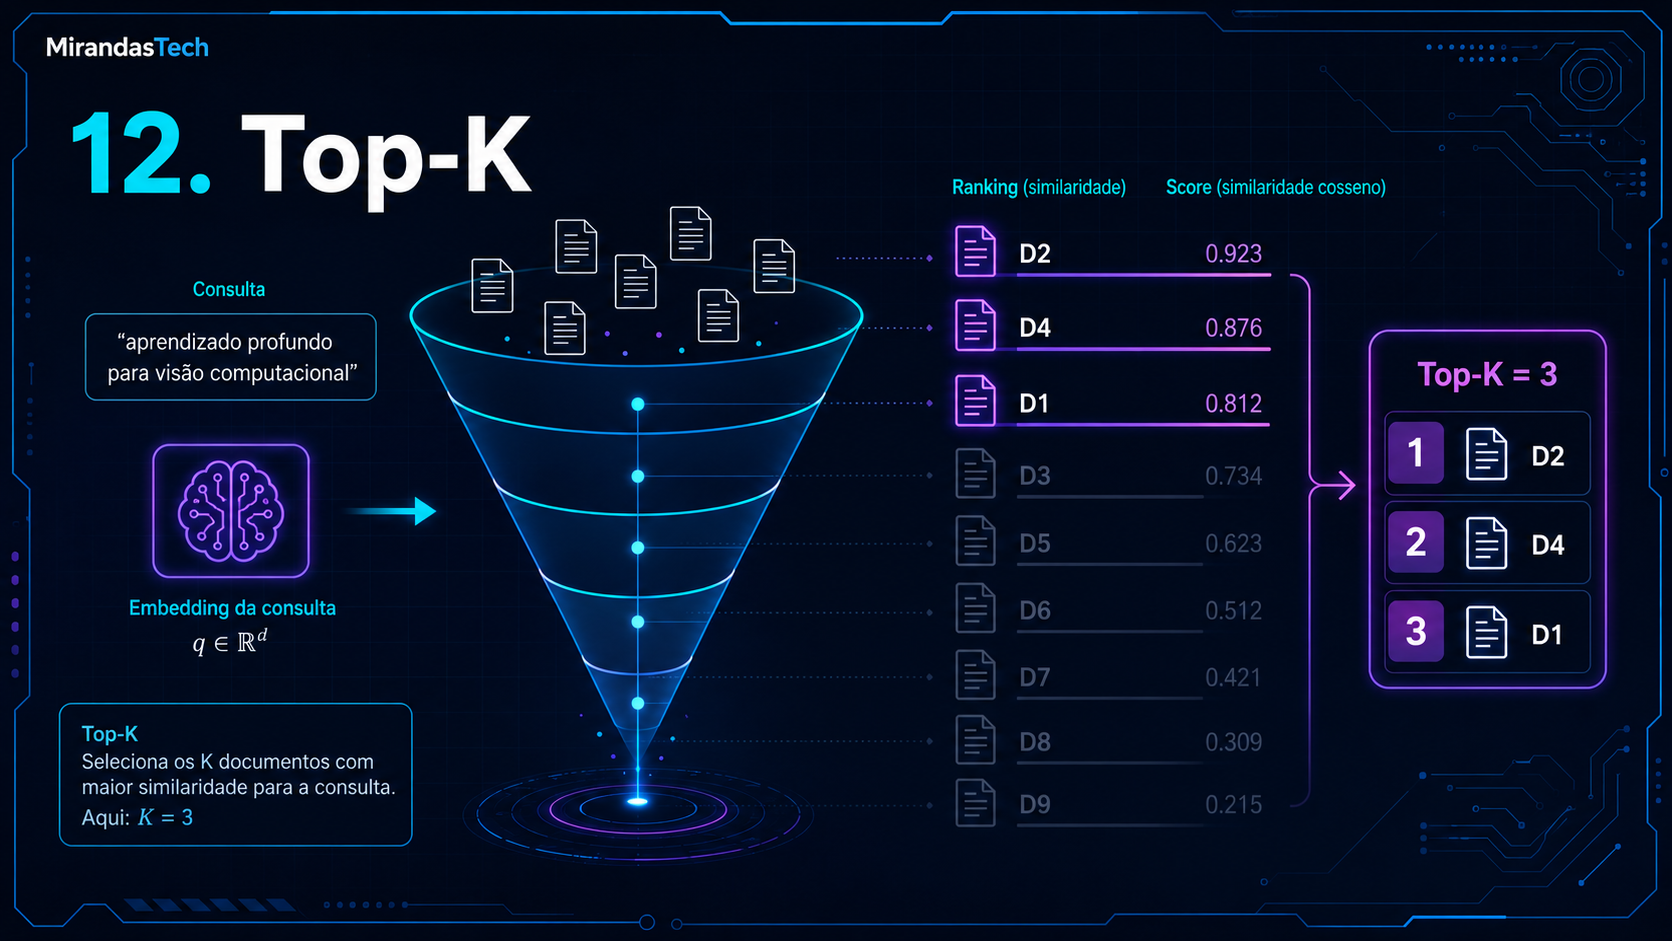
Em vez de recuperar todos os documentos, um sistema pode selecionar apenas os mais relevantes:
Top-K = 3

D2
D4
D1
Esse mecanismo será especialmente importante quando chegarmos a RAG.
13. Finalmente: RAG
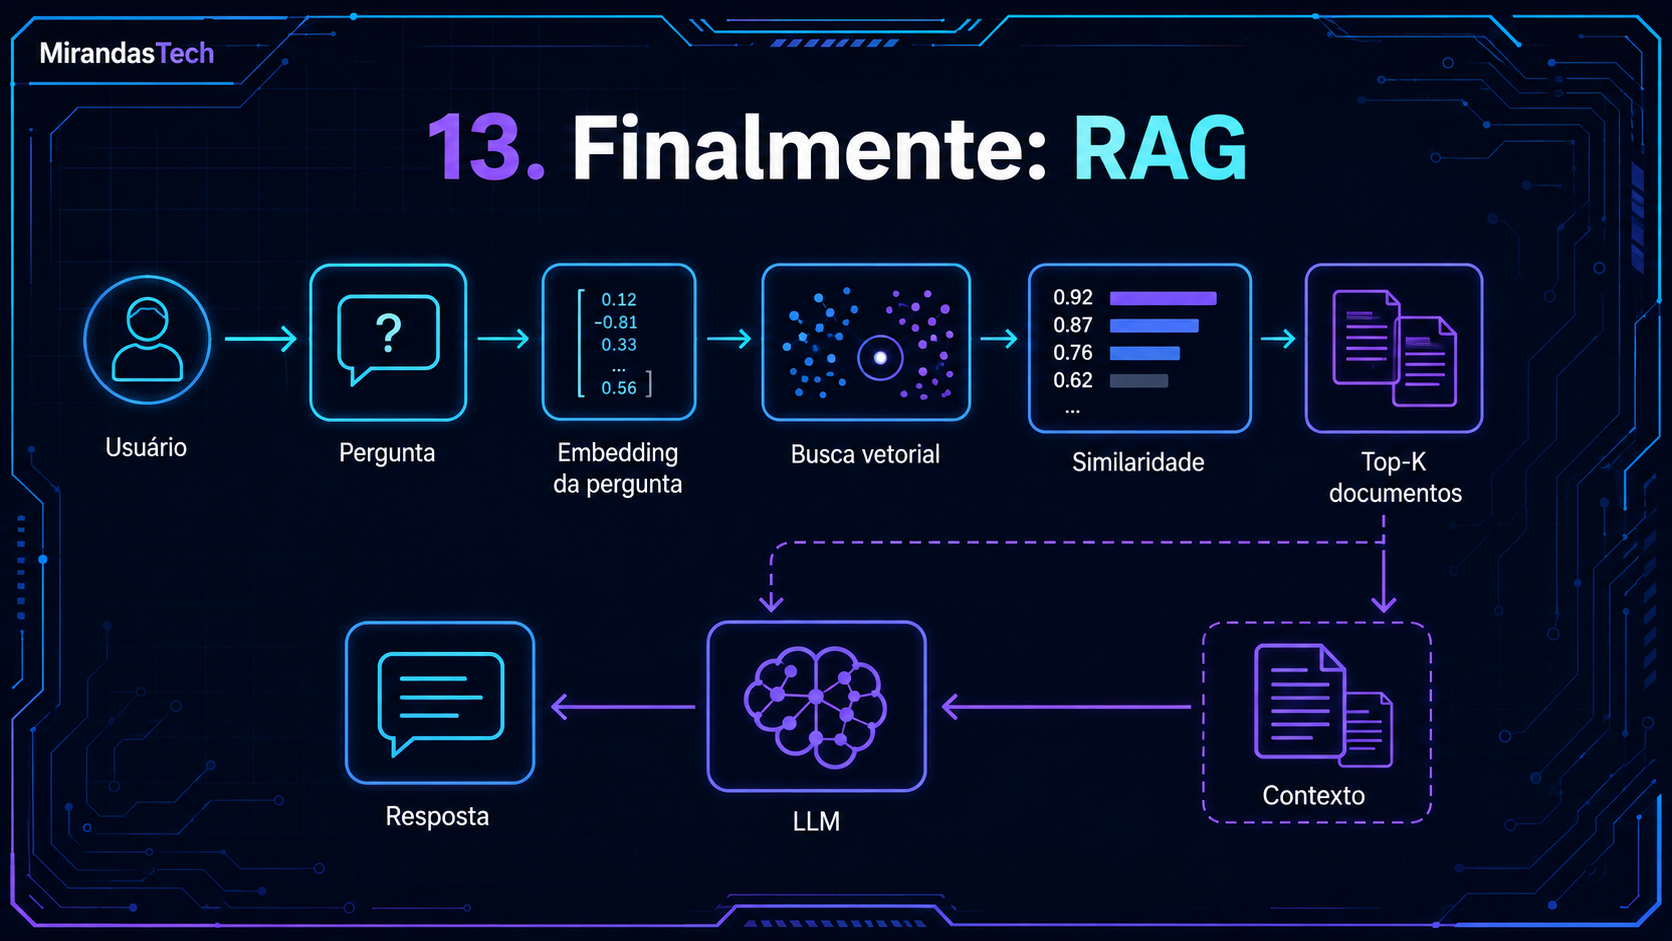
RAG significa Retrieval-Augmented Generation. O fluxo pode ser representado assim:
Usuário
   ↓
Pergunta
   ↓
Embedding da pergunta
   ↓
Busca vetorial
   ↓
Similaridade
   ↓
Top-K documentos
   ↓
Contexto
   ↓
LLM
   ↓
Resposta
O LLM não precisa depender somente do conhecimento internalizado no treinamento. O sistema pode primeiro recuperar informações externas relevantes e fornecê-las como contexto.
14. Um exemplo de RAG
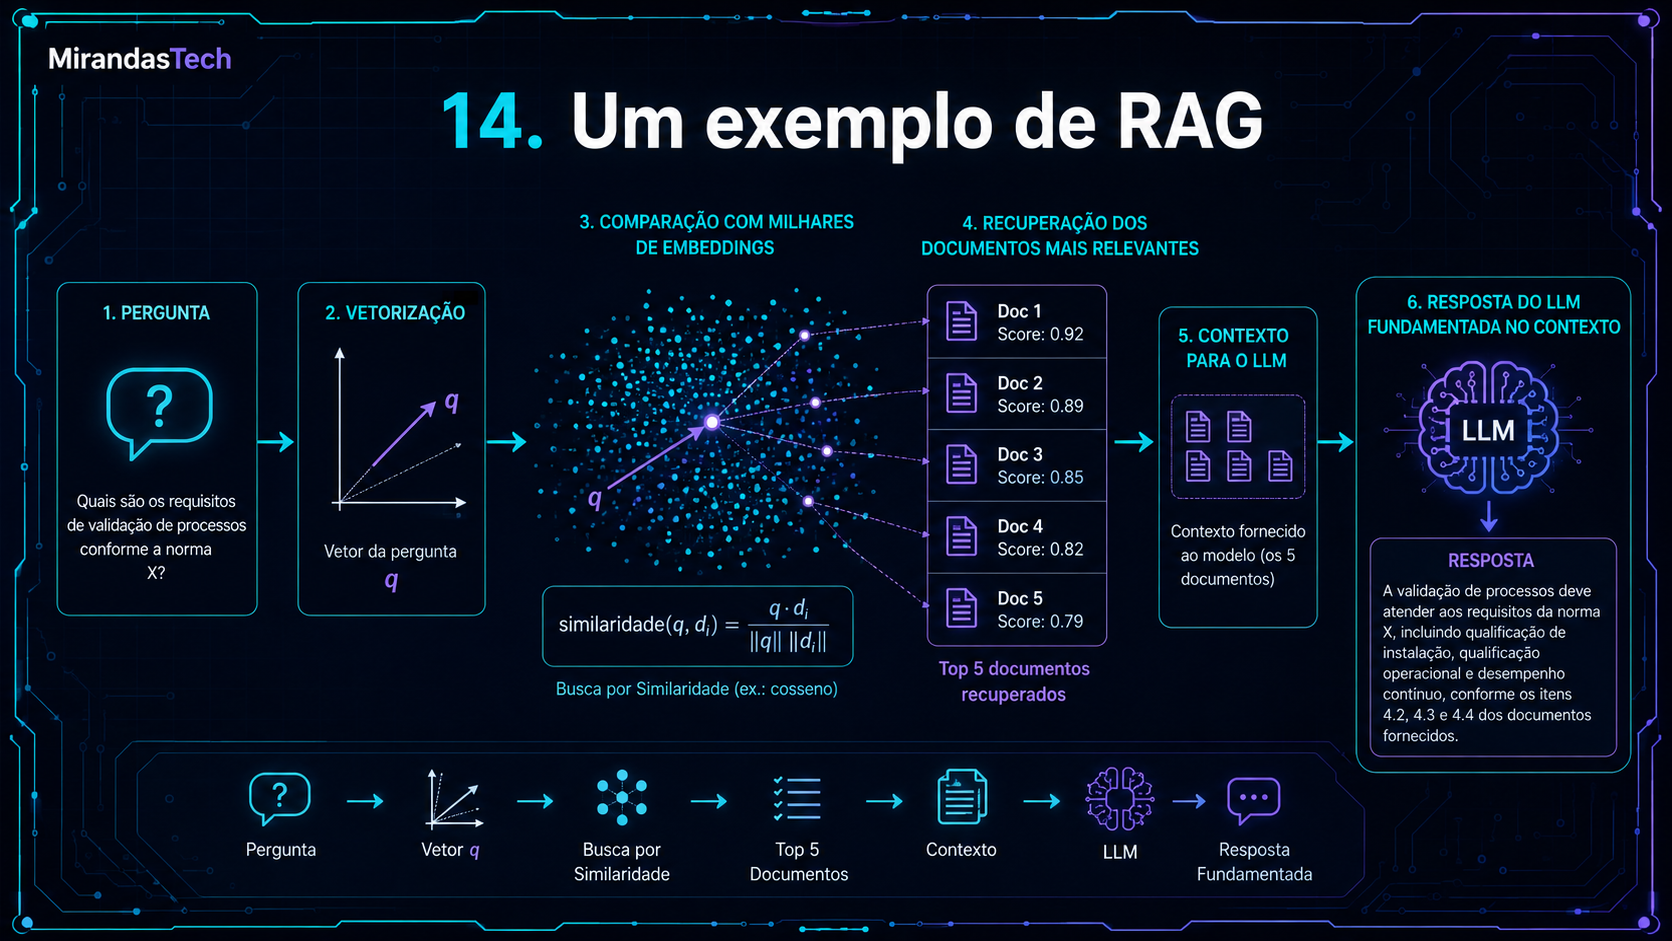
Usuário:
Quais normas regulam determinado produto?
A pergunta é transformada em um vetor q e comparada com milhares de embeddings de documentos.
O sistema recupera, por exemplo, os cinco documentos mais relevantes e entrega o conteúdo ao LLM. A resposta é então gerada a partir desse contexto recuperado.
15. Por que bancos vetoriais existem?
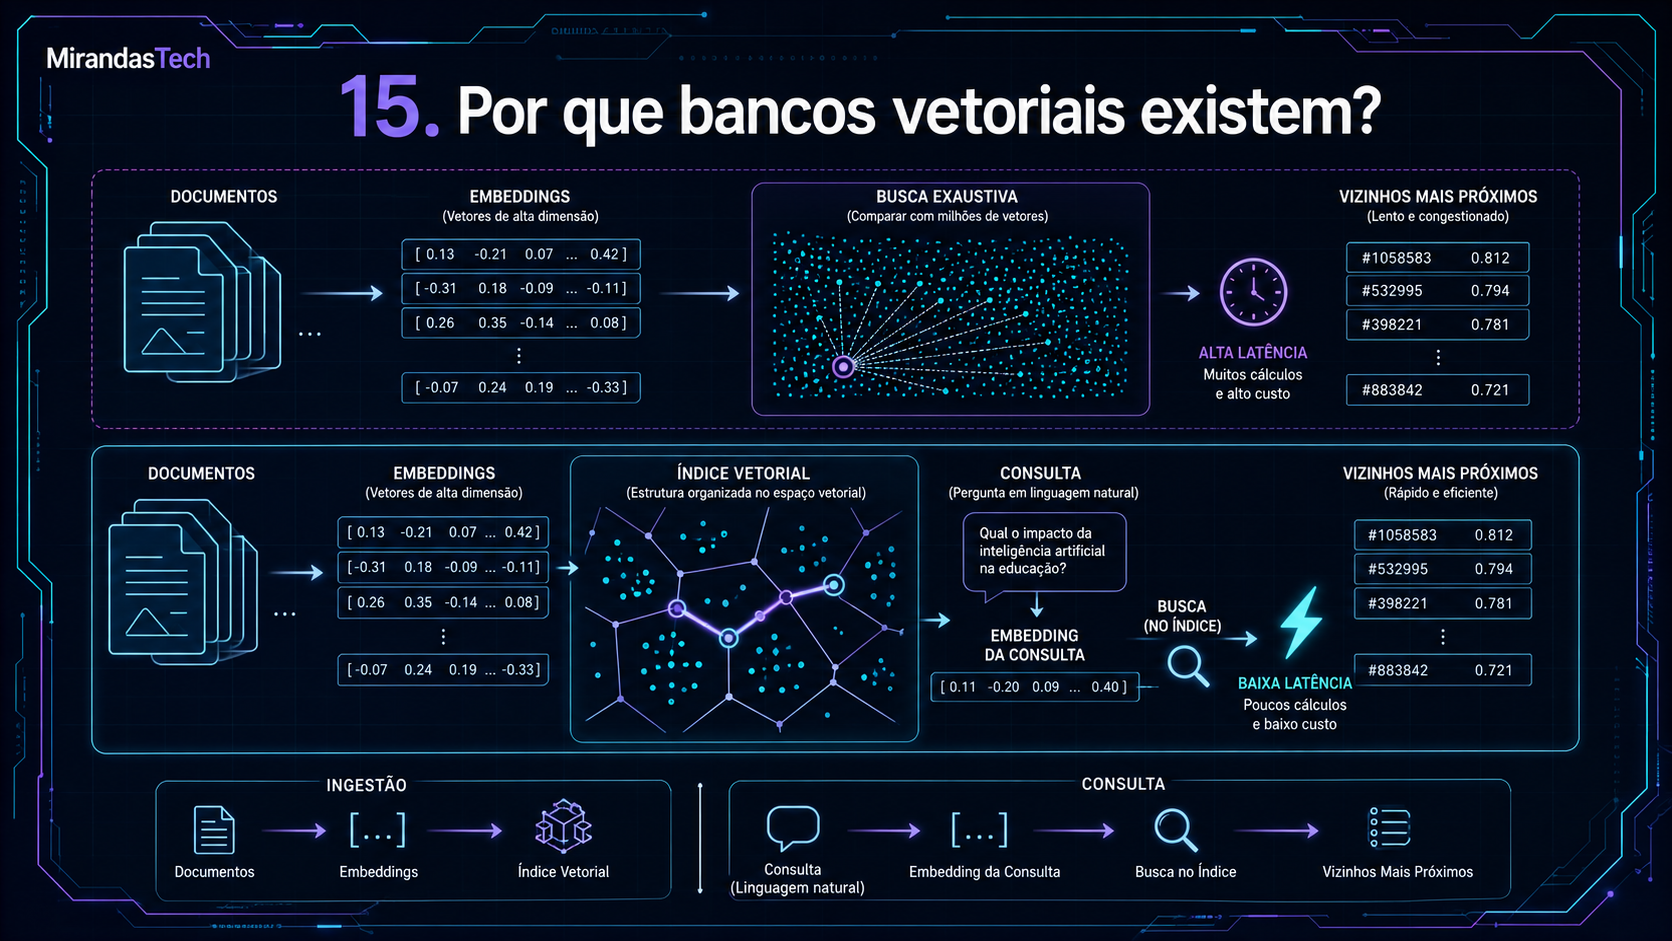
Com algumas dezenas de documentos, podemos comparar a consulta com todos os vetores. Mas imagine milhões ou centenas de milhões de embeddings.
É aí que entram bancos e índices vetoriais, projetados para encontrar rapidamente representações próximas.
documentos → embeddings → índice vetorial

consulta → embedding → busca → vizinhos mais próximos
16. Similaridade versus distância
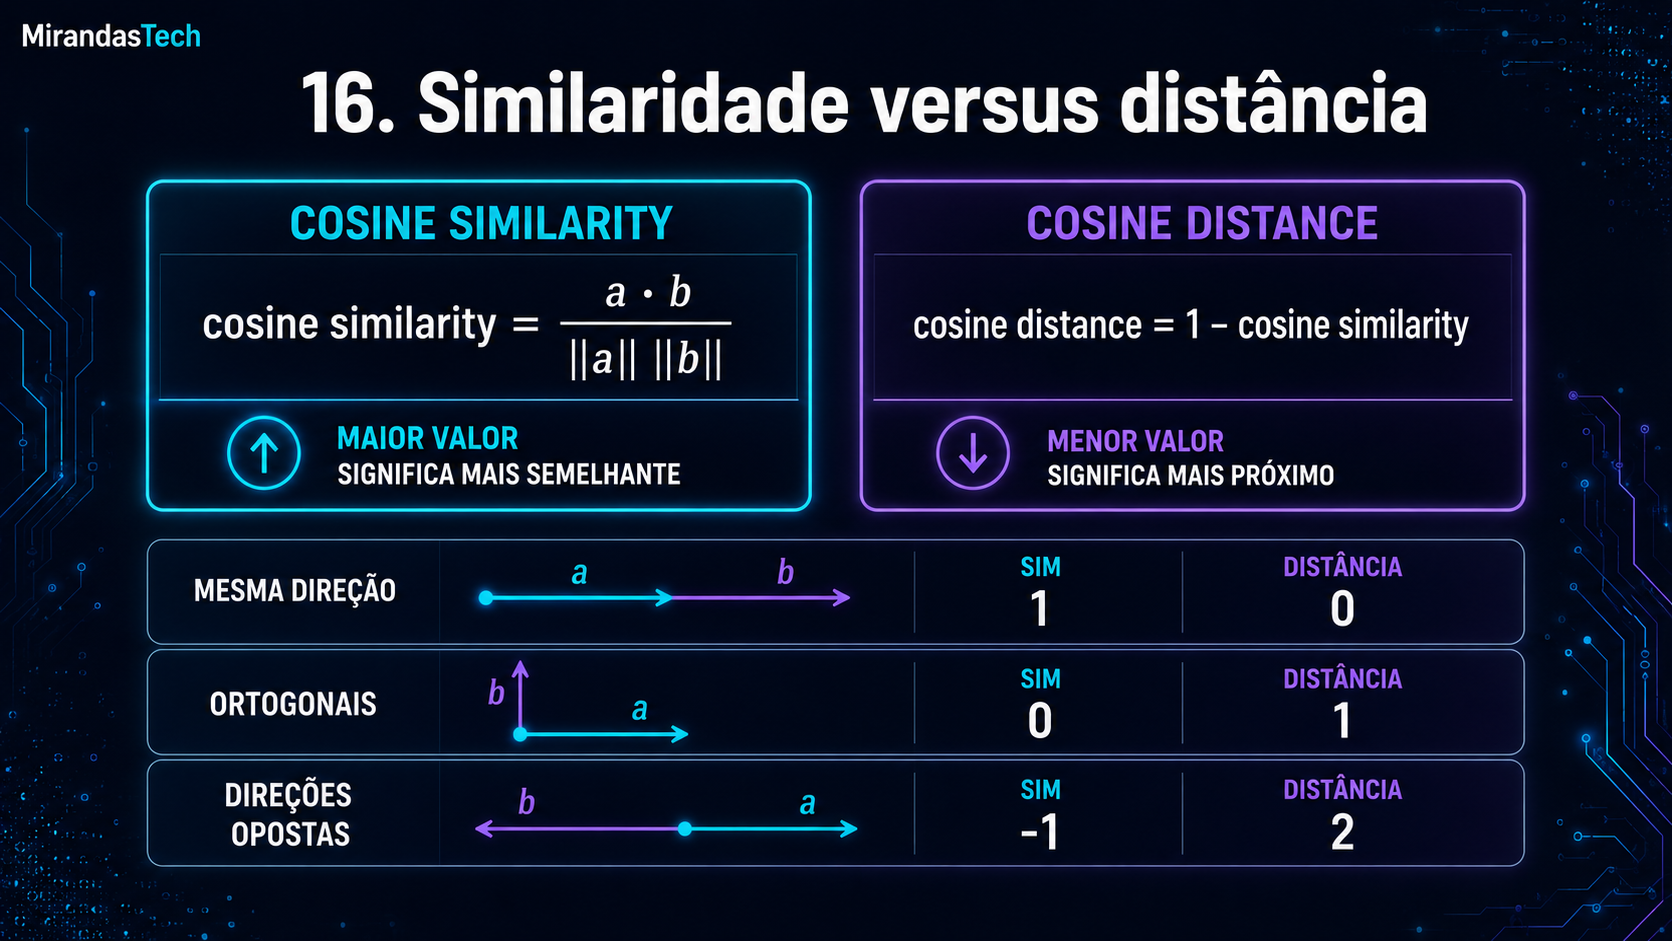
Algumas ferramentas trabalham com cosine similarity; outras utilizam cosine distance. Uma convenção comum é:
cosine distance = 1 - cosine similarityConsequentemente:
similaridade alta → distância baixaSempre verifique se a biblioteca está retornando similaridade ou distância.
17. Não existe um limiar universal
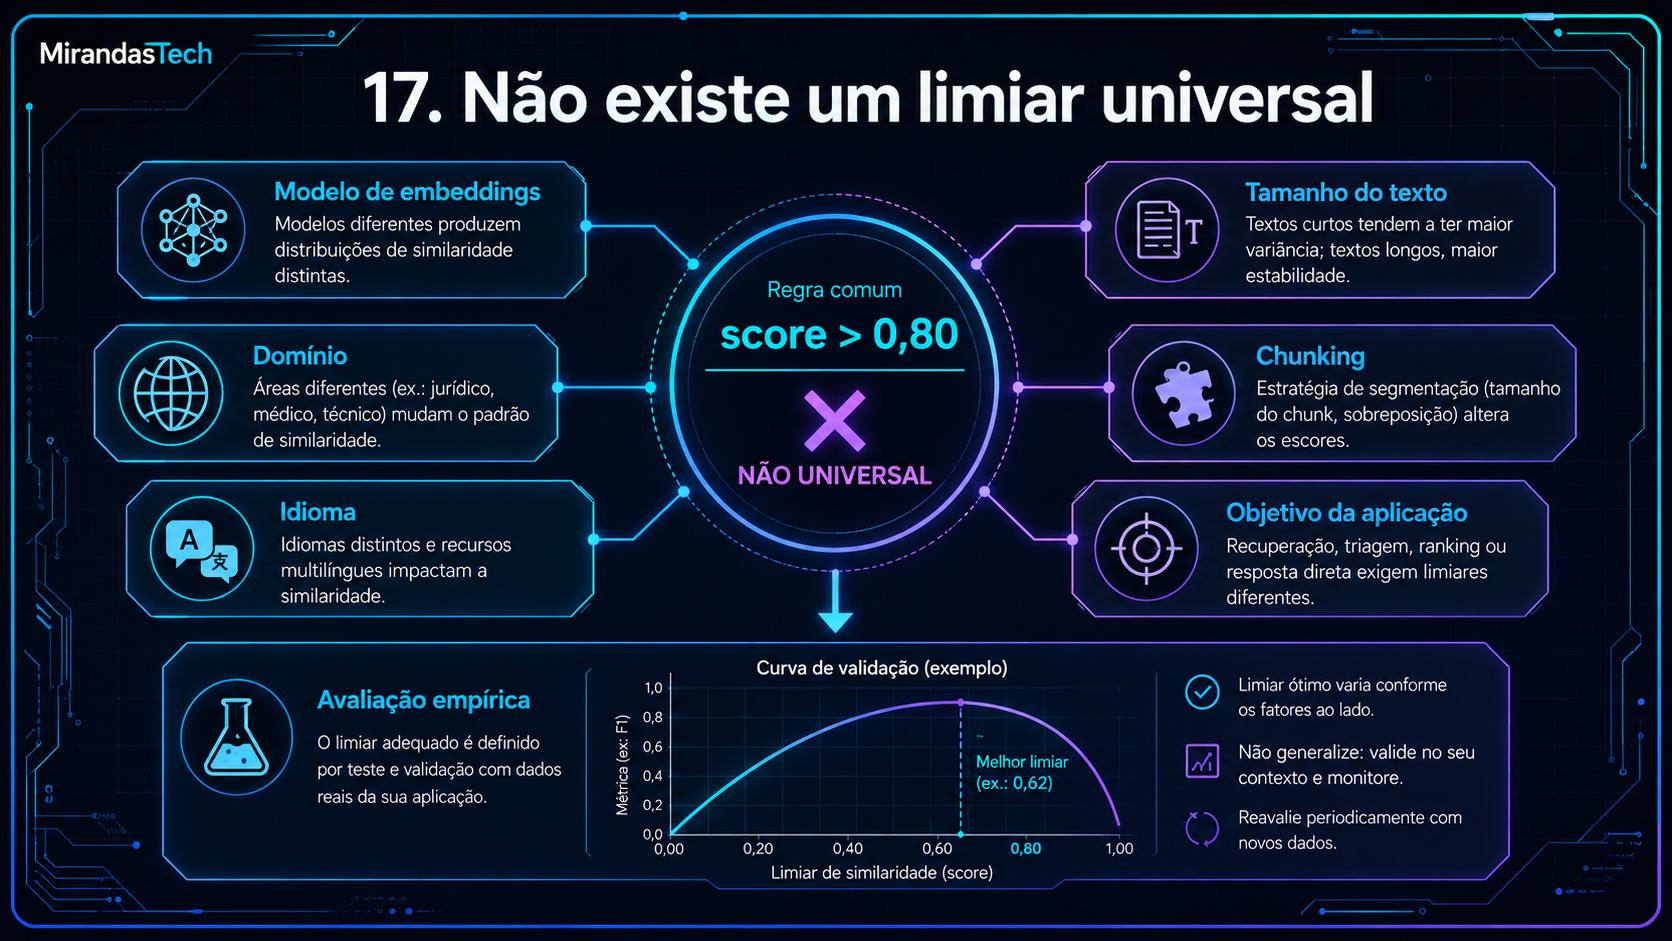
Uma regra como:
score > 0.80 = semanticamente equivalentenão é universalmente válida. O comportamento dos scores depende do modelo de embeddings, domínio, idioma, tamanho dos textos, estratégia de chunking e objetivo da aplicação.
Limiares precisam ser avaliados empiricamente.
18. Ranking muitas vezes importa mais que um score isolado
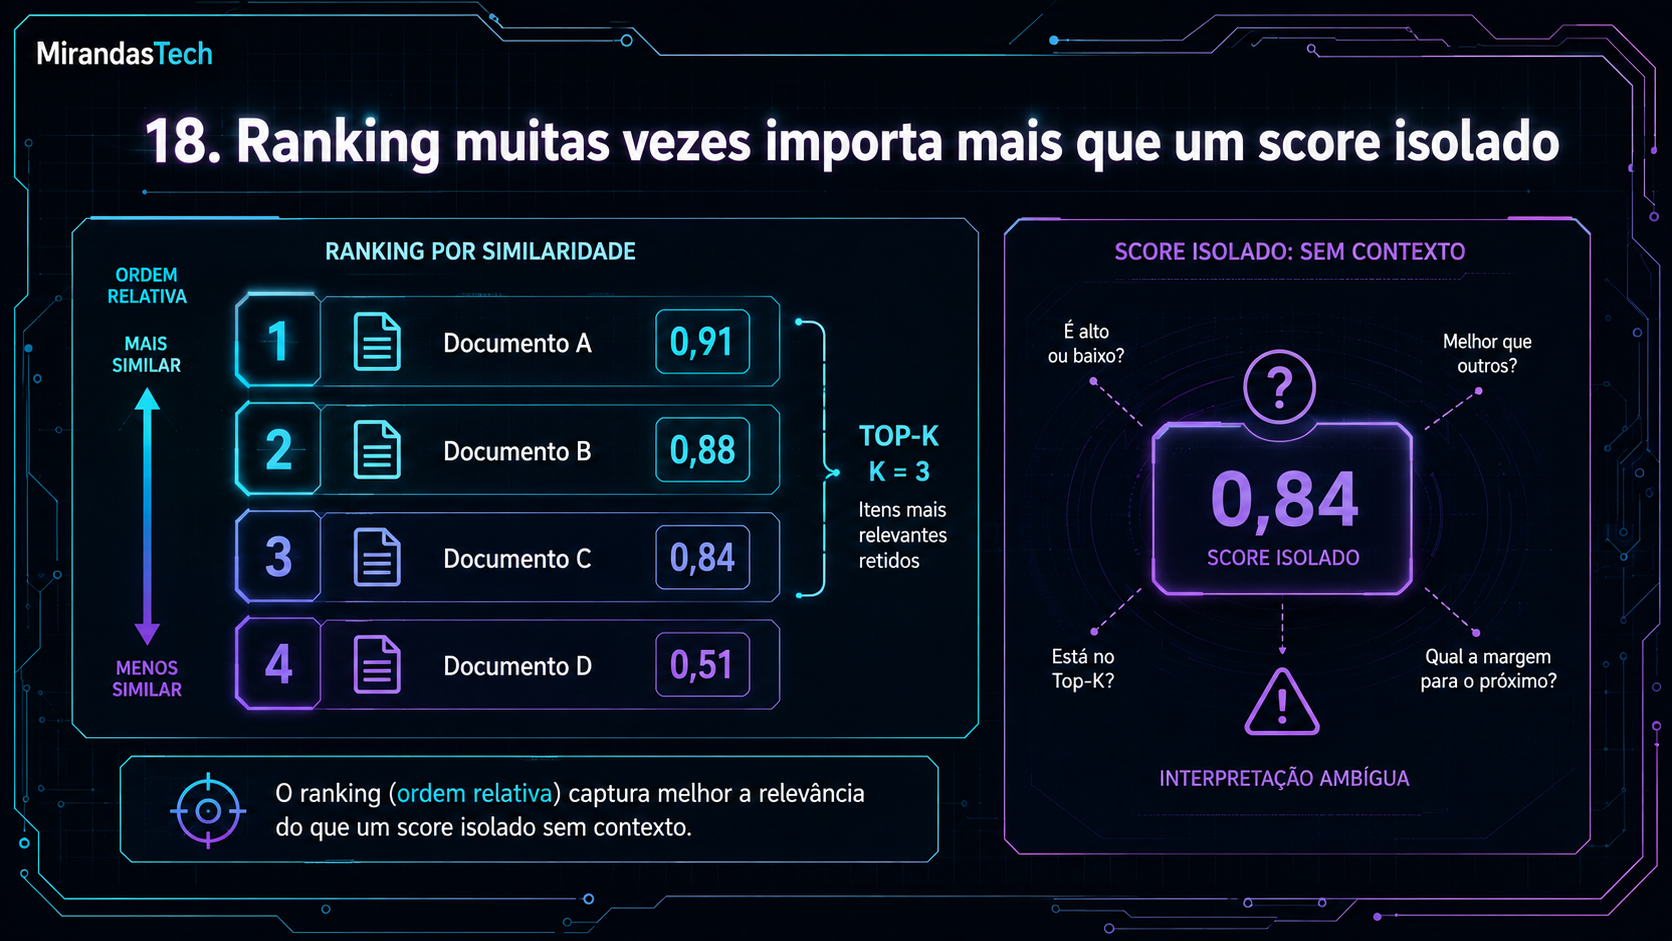
Em recuperação de informação, podemos estar mais interessados na ordenação:
Documento A → 0.91
Documento B → 0.88
Documento C → 0.84
Documento D → 0.51
do que em interpretar isoladamente se 0.84 é “alto” ou “baixo”.
19. Uma limitação importante
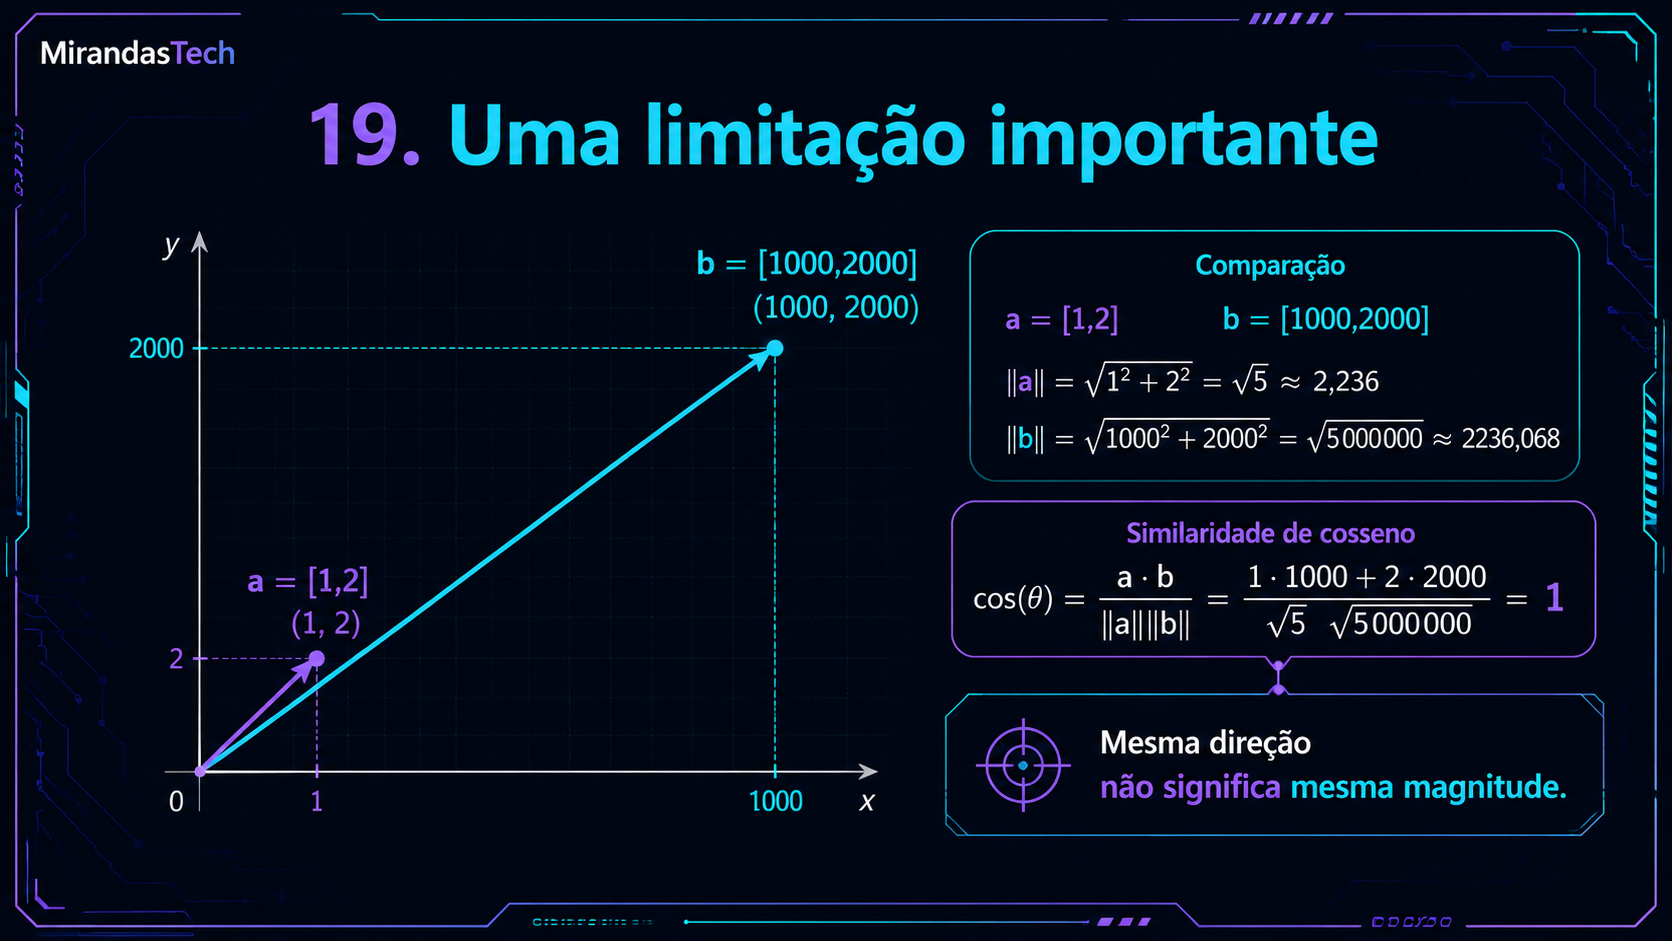
Considere:
a = [1, 2]
b = [1000, 2000]
A similaridade de cosseno é 1 porque a direção é idêntica. Isso não significa que os vetores sejam iguais em magnitude.
A similaridade de cosseno responde principalmente sobre alinhamento de direção, não sobre igualdade completa entre os vetores.
20. A métrica depende do problema
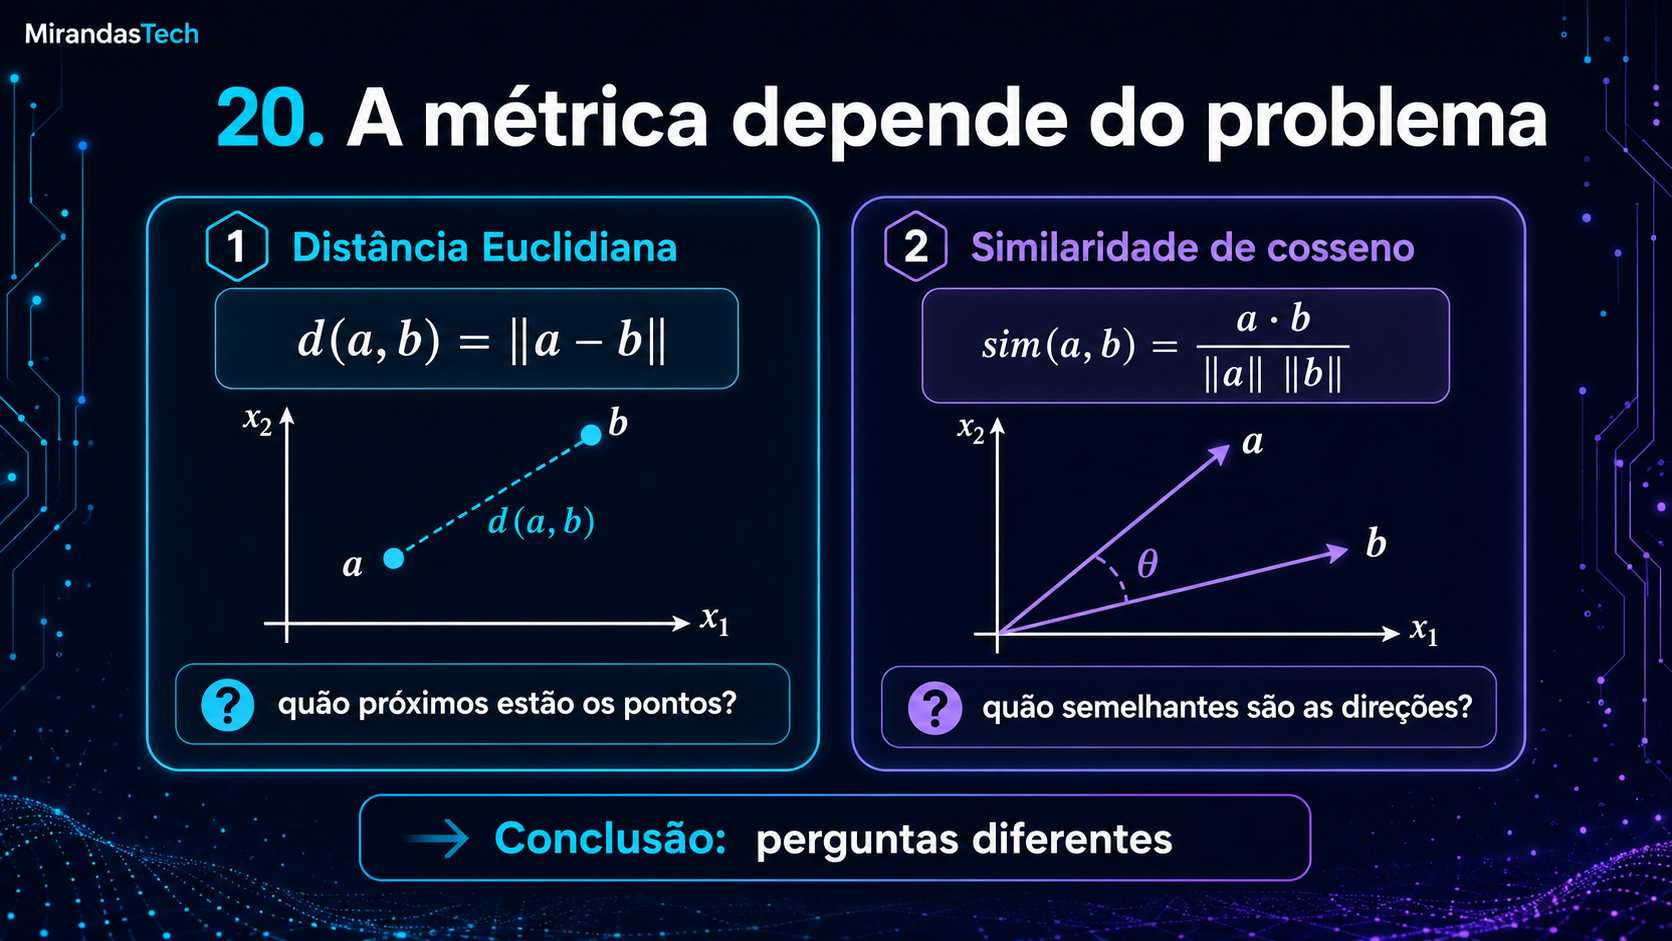
Distância Euclidiana:
d(a,b) = ||a - b||Pergunta: quão próximos os pontos estão?
Similaridade de cosseno:
sim(a,b) = (a · b) / (||a|| ||b||)Pergunta: quão semelhantes são suas direções?
Nenhuma das métricas é universalmente superior. Elas respondem a perguntas geométricas diferentes.
21. Mini busca vetorial em NumPy
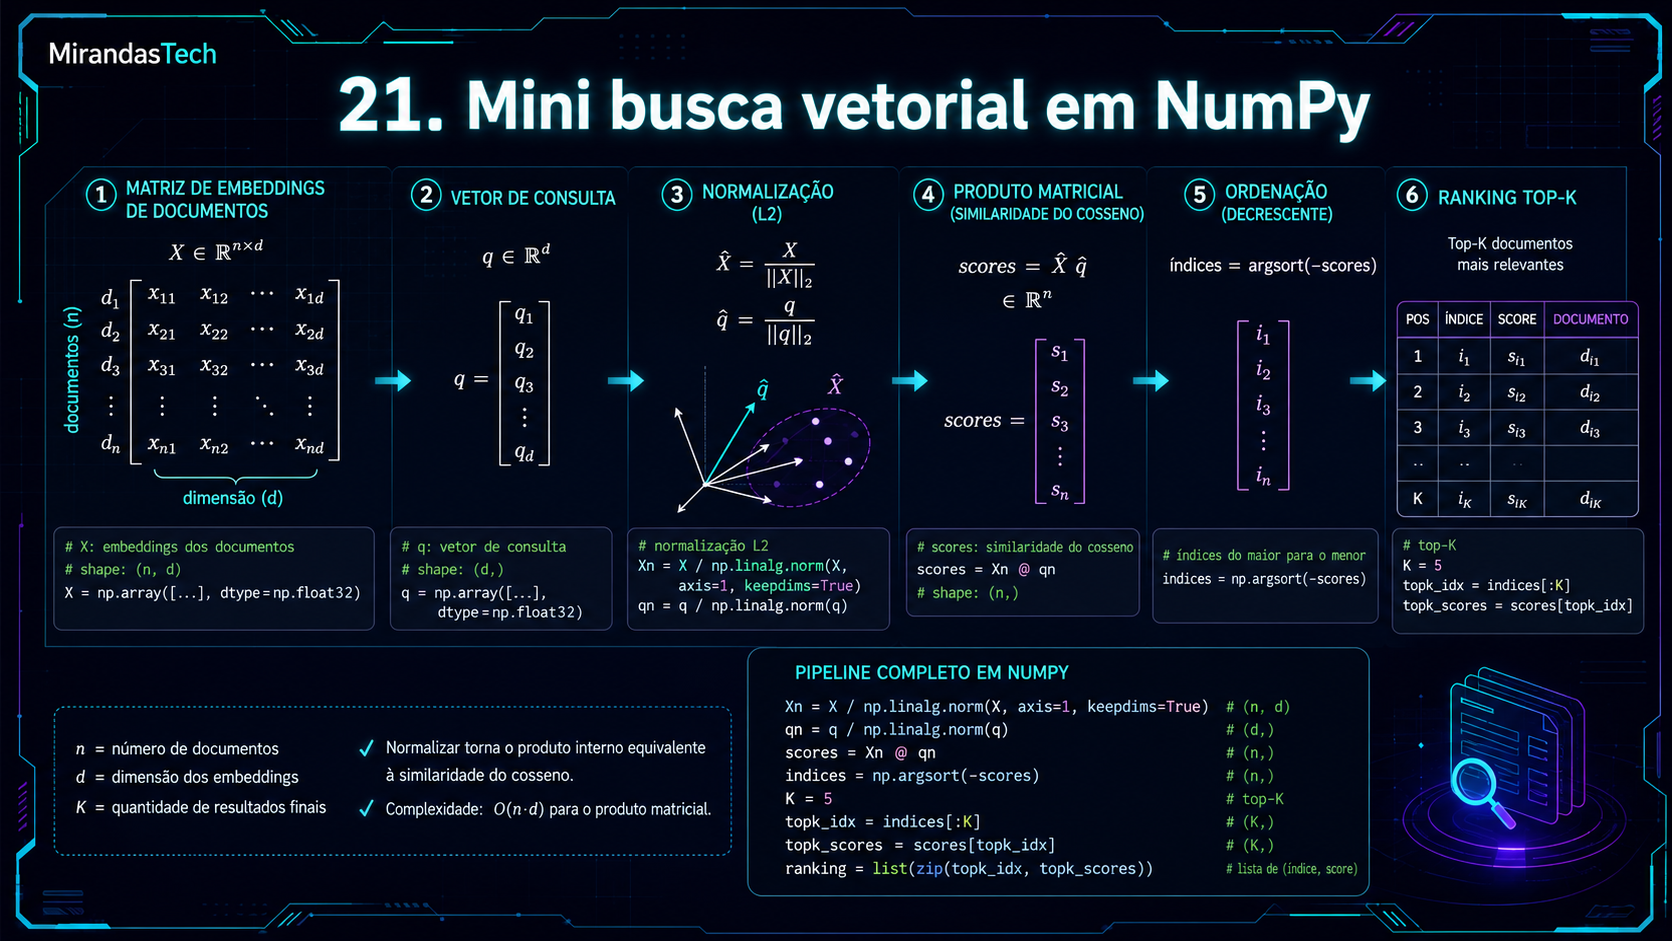
import numpy as np

query = np.array([0.8, 0.4, 0.2])

docs = {
    "café": np.array([0.79, 0.42, 0.18]),
    "chá": np.array([0.72, 0.46, 0.25]),
    "carro": np.array([-0.3, 0.8, -0.4])
}


def cosine_similarity(a, b):
    return np.dot(a, b) / (
        np.linalg.norm(a) * np.linalg.norm(b)
    )

resultados = []

for nome, vetor in docs.items():
    score = cosine_similarity(query, vetor)
    resultados.append((nome, score))

resultados.sort(key=lambda x: x[1], reverse=True)

for nome, score in resultados:
    print(nome, score)
Esse pequeno exemplo contém a essência matemática de uma busca vetorial: representar, comparar e ordenar.
22. O salto conceitual
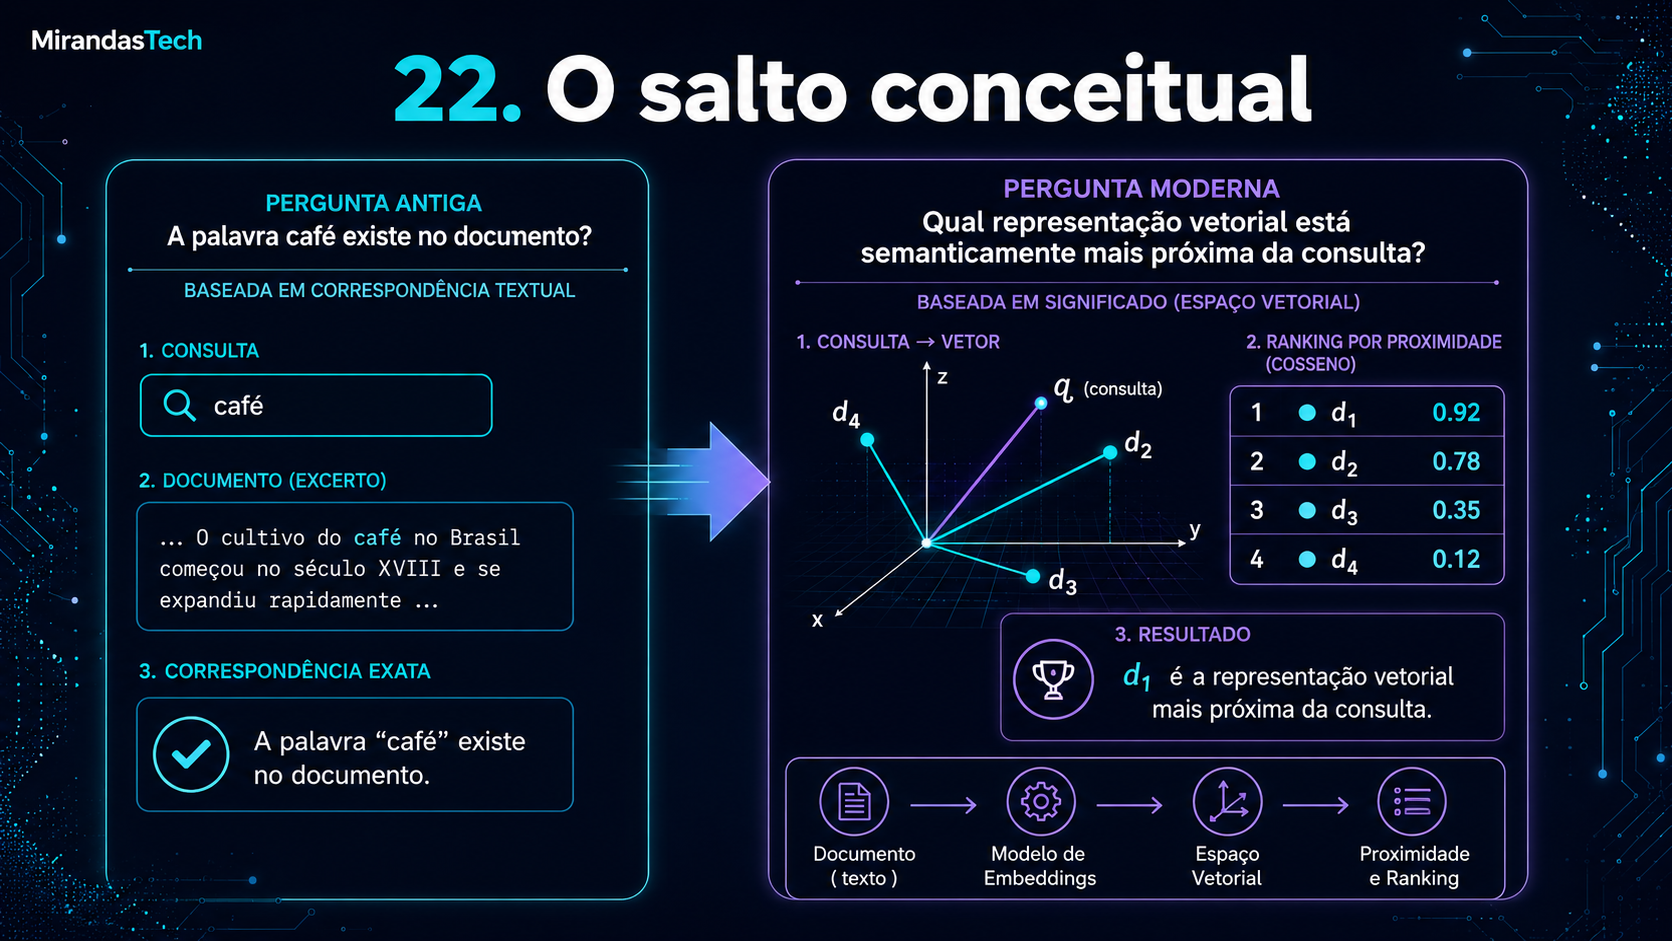
Em vez de perguntar apenas:
A palavra “café” existe no documento?
passamos a perguntar:
Qual representação vetorial está semanticamente mais próxima da consulta?
Essa mudança é uma das bases da recuperação semântica moderna.
23. Mapa mental da Aula 04
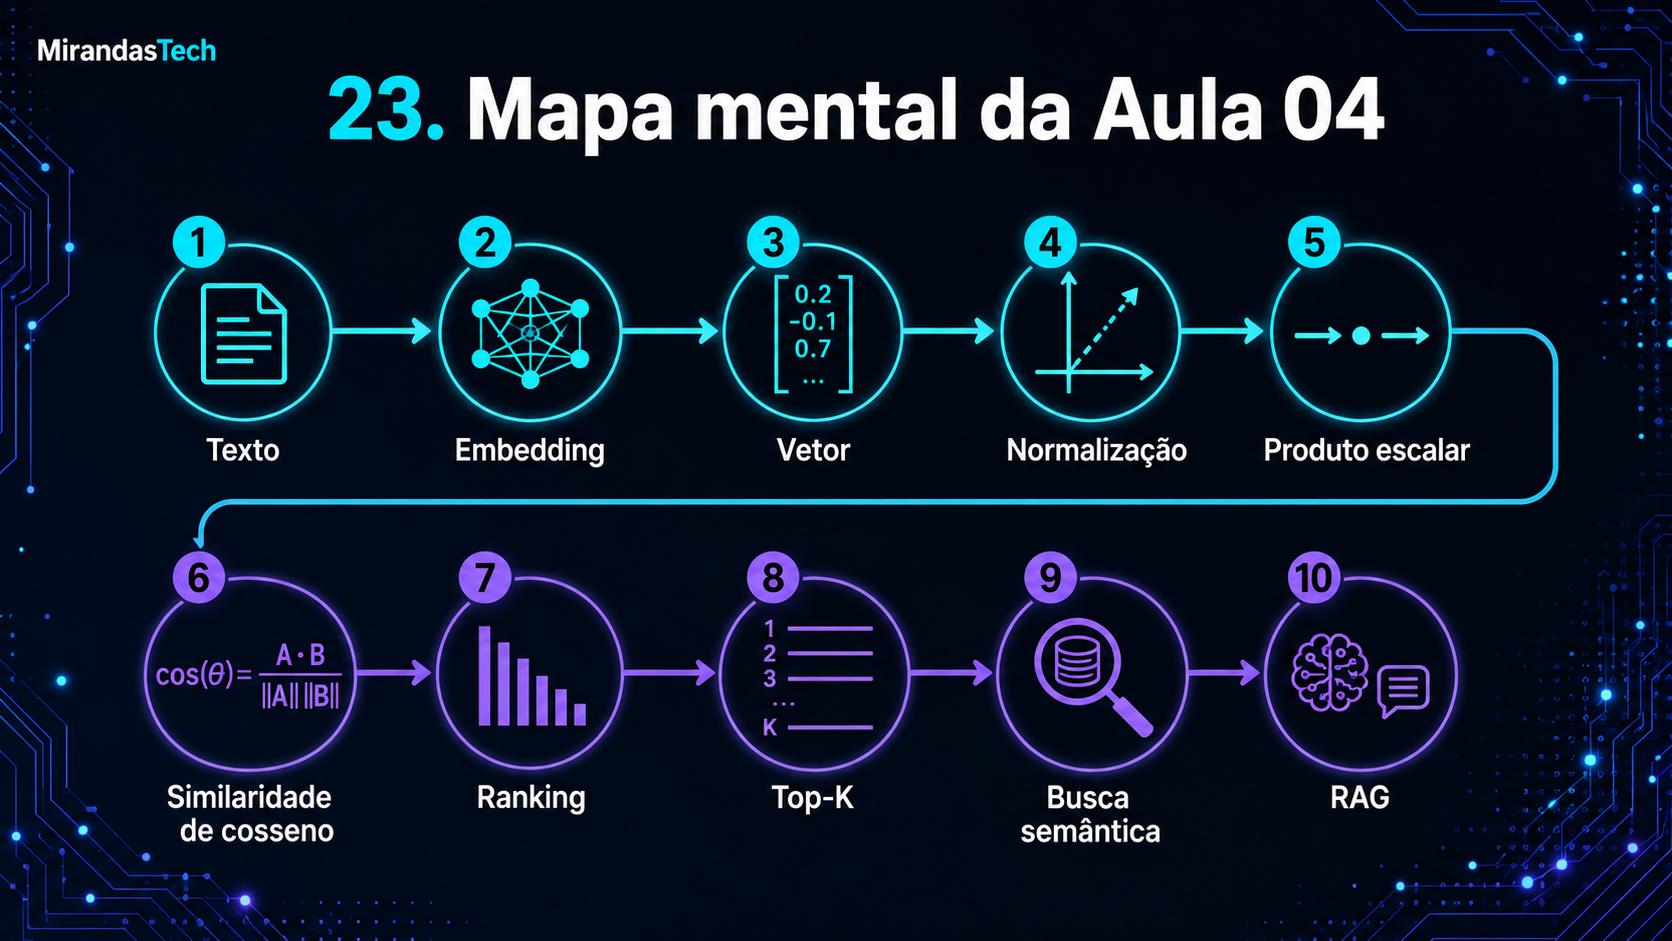
Texto
  ↓
Embedding
  ↓
Vetor
  ↓
Normalização
  ↓
Produto escalar
  ↓
Similaridade de cosseno
  ↓
Ranking
  ↓
Top-K
  ↓
Busca semântica
  ↓
RAG
24. Exercícios de fixação
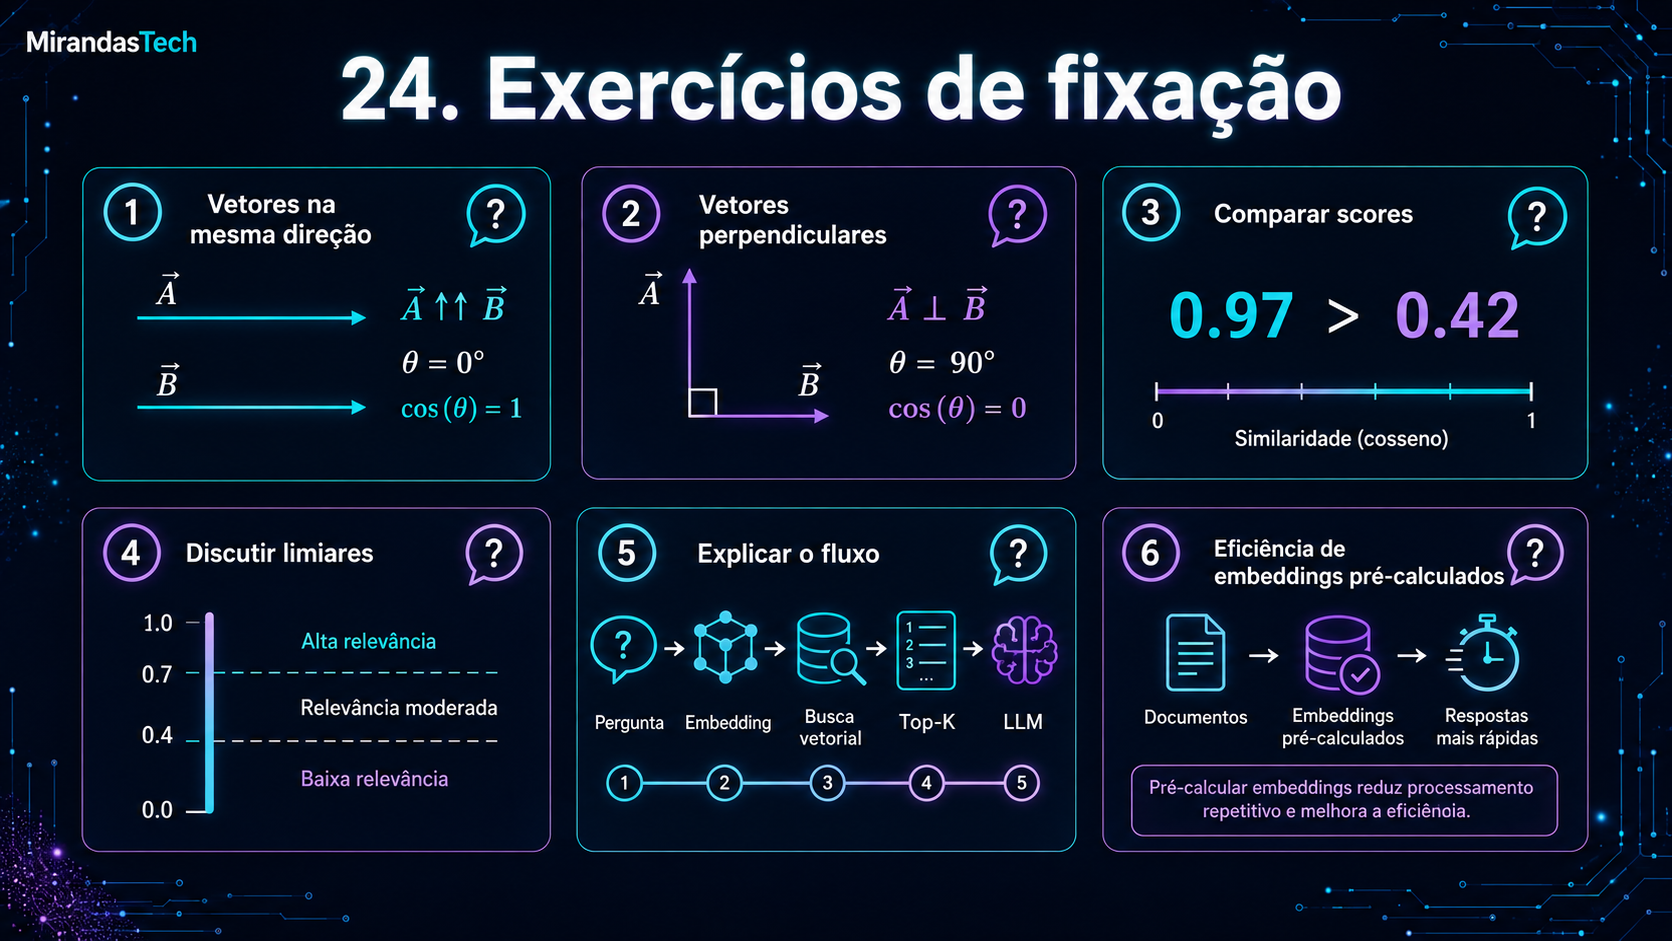
- Se
a=[1,2]eb=[2,4], qual deve ser aproximadamente a similaridade de cosseno? Explique. - Se
a=[1,0]eb=[0,7], qual é a similaridade e o que isso significa geometricamente? - Entre scores
0.97e0.42, qual representa maior alinhamento? - Por que não existe um limiar universal como
0.80para equivalência semântica? - Explique o fluxo
pergunta → embedding → busca vetorial → Top-K → LLM. - Por que pré-calcular embeddings de um milhão de documentos é mais eficiente do que pedir ao LLM para reler tudo em cada consulta?
25. O que vem depois?
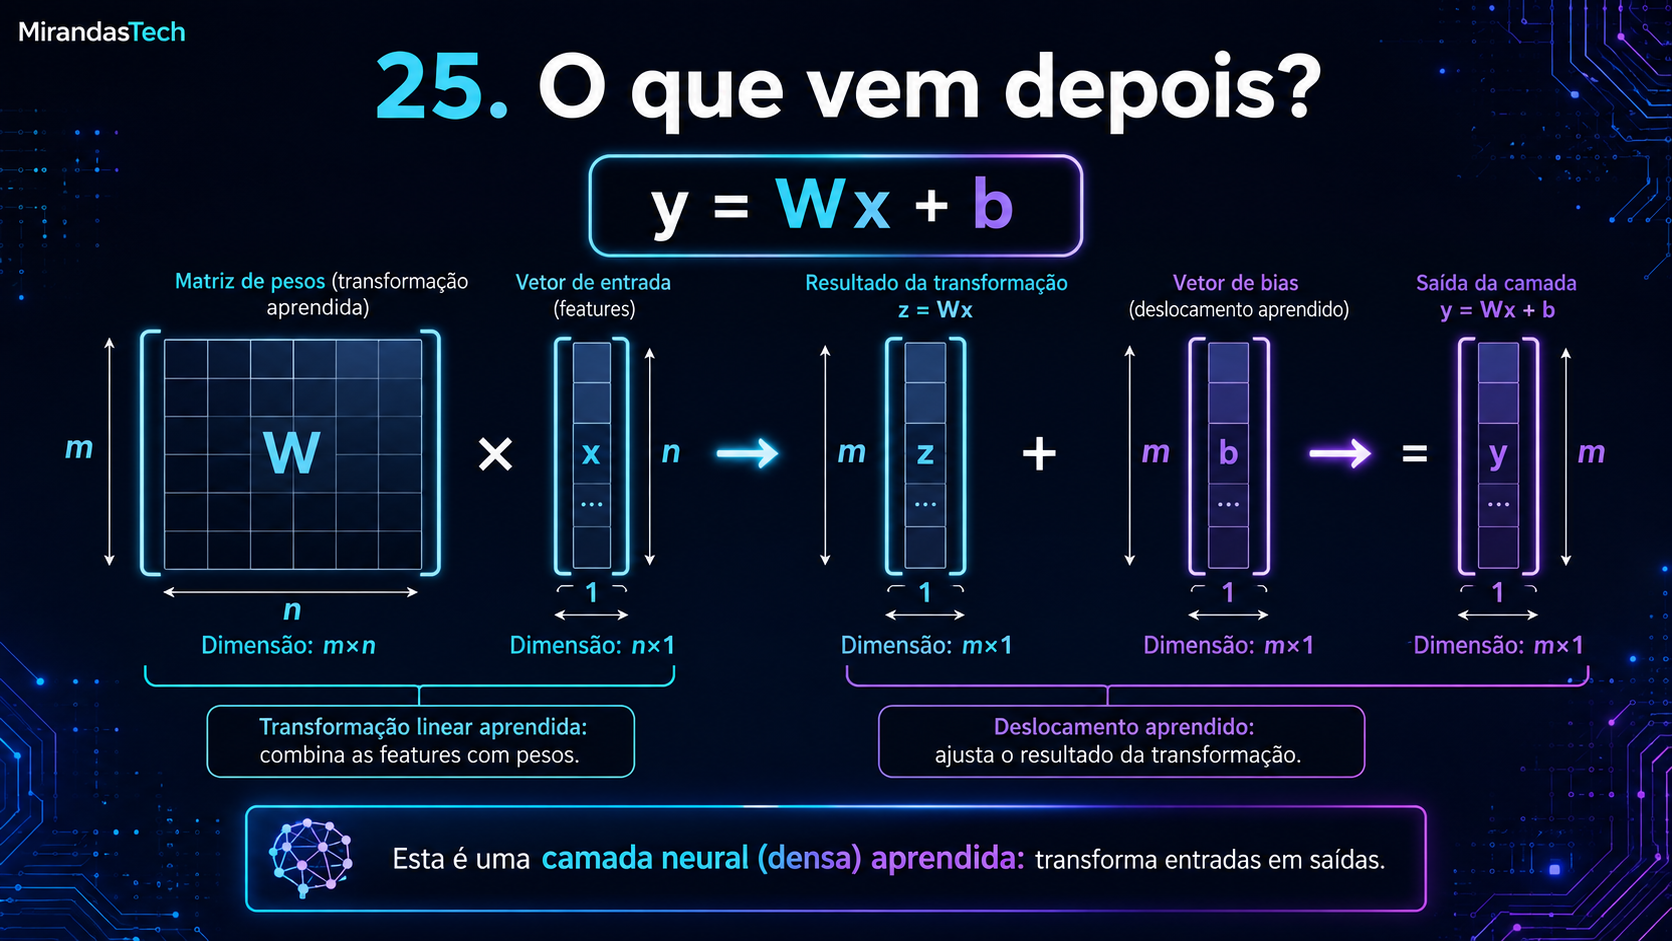
Na próxima aula voltaremos à expressão que apareceu logo no início da trilha:
y = Wx + bAgora teremos base suficiente para interpretá-la geometricamente. Vamos estudar matrizes como transformações, multiplicação matriz-vetor e como uma camada neural pode ser entendida como uma transformação aprendida.
Este artigo faz parte da série Fundamentos Matemáticos para Inteligência Artificial, do MirandasTech.