
Transformações geométricas: escala, rotação, reflexão e projeção
Enxergar matrizes como operações geométricas sobre o espaço e compreender como escala, rotação, reflexão e projeção formam a intuição necessária para redes neurais e Transformers.

Enxergar matrizes como operações geométricas sobre o espaço e compreender como escala, rotação, reflexão e projeção formam a intuição necessária para redes neurais e Transformers. Pré-requisito: Aula 05 — Matrizes como transformações.
Gire uma foto 90° no celular. O aplicativo não sabe o que é uma foto: para cada pixel, ele pega a coordenada, multiplica por uma matriz 2 × 2 e descobre para onde aquele pixel vai (Szeliski, 2022). Amplie a imagem: outra matriz. Espelhe a selfie: outra. Pegue um embedding de 768 dimensões e reduza a um gráfico em duas para visualizar: uma projeção, que também é uma matriz. Em todos esses casos a operação é a mesma que estudamos na aula anterior, y = Wx; o que muda são os números dentro de W, e cada escolha desses números tem um efeito geométrico com nome próprio.
No artigo anterior da série lemos $y = Wx + b$ como uma camada de rede neural e interpretamos W como uma transformação. Ficou uma pergunta em aberto: o que uma transformação matricial realmente pode fazer com um vetor e com o espaço? A resposta curta é que uma matriz pode aumentar, diminuir, rotacionar, refletir, projetar, deformar e combinar todos esses efeitos. A resposta longa é este artigo.
Ao final, você vai conseguir reconhecer, pela cara de uma matriz 2 × 2, se ela estica, gira, espelha ou achata o espaço; construir cada uma delas em NumPy e conferir o resultado; ler as colunas de W para saber para onde a base foi enviada; explicar por que a ordem em que se aplicam duas transformações importa; e entender por que uma pilha de matrizes sem não linearidade é só uma matriz, o motivo pelo qual redes neurais precisam de ReLU.
1. Uma matriz transforma o espaço inteiro
Considere um vetor qualquer do plano:
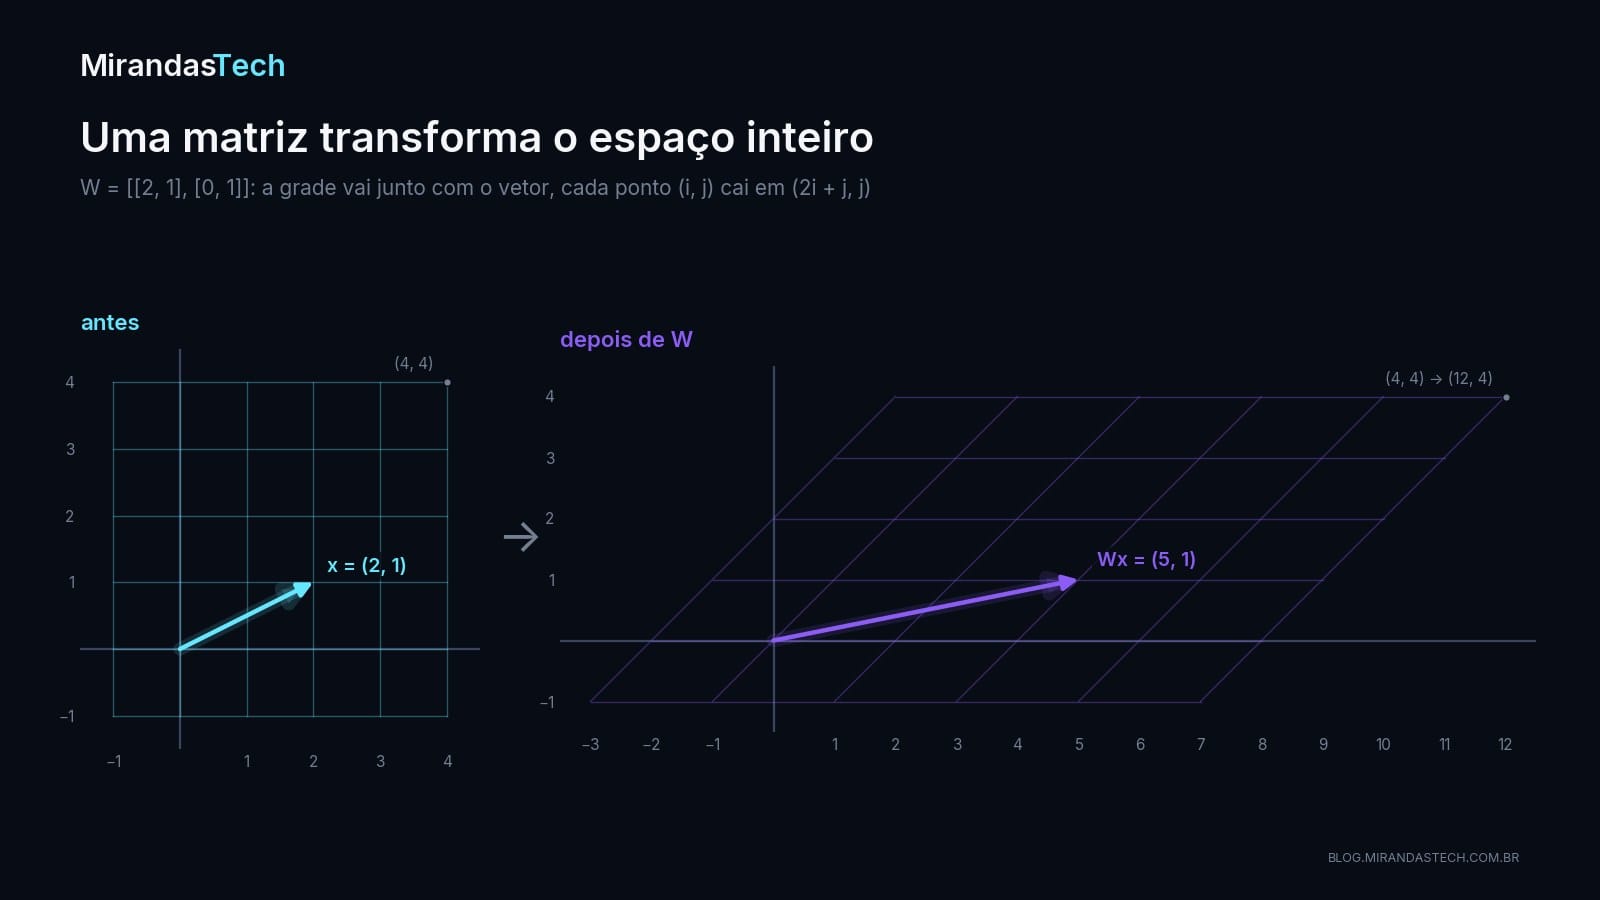
$$ x=\begin{bmatrix}2\\1\end{bmatrix} $$
Aplicamos uma matriz $W$ e obtemos:
$$ y=Wx $$
A matriz decide onde o vetor vai parar. Em termos gerais:
$$ \boxed{W:\mathbb{R}^{n}\rightarrow\mathbb{R}^{m}} $$
Ou seja, $W$ pode ser lida como uma função que recebe vetores de $n$ componentes e devolve vetores de $m$ componentes. Aqui, $n$ é o número de colunas de $W$ (quantas entradas) e $m$ é o número de linhas (quantas saídas), a mesma regra de dimensões da Aula 05.
O ponto que muda a intuição é este: a matriz não define uma regra para um vetor específico. Ela define uma transformação para todo o espaço. Se você desenhar uma grade quadriculada e aplicar $W$ a cada ponto dela, a grade inteira pode ficar esticada, comprimida, inclinada, girada ou refletida. A transformação de um vetor é consequência da transformação do espaço inteiro. É por isso que faz sentido perguntar “o que esta matriz faz”, e não apenas “o que esta matriz faz com este vetor”.
As próximas seções percorrem as respostas possíveis, da mais inofensiva (nada) até a que mistura vários efeitos.
2. Identidade e escala
A transformação mais simples é a que não faz nada. A matriz identidade:
$$ I=\begin{bmatrix}1&0\\0&1\end{bmatrix} $$
Para:
$$ x=\begin{bmatrix}3\\2\end{bmatrix} $$
teremos:
$$ Ix=\begin{bmatrix}3\\2\end{bmatrix} $$
Nada mudou. Por isso $I$ é a transformação identidade: é o “1” das matrizes, e vai servir de referência para todas as outras.
O primeiro passo além da identidade é mudar o tamanho. Considere:
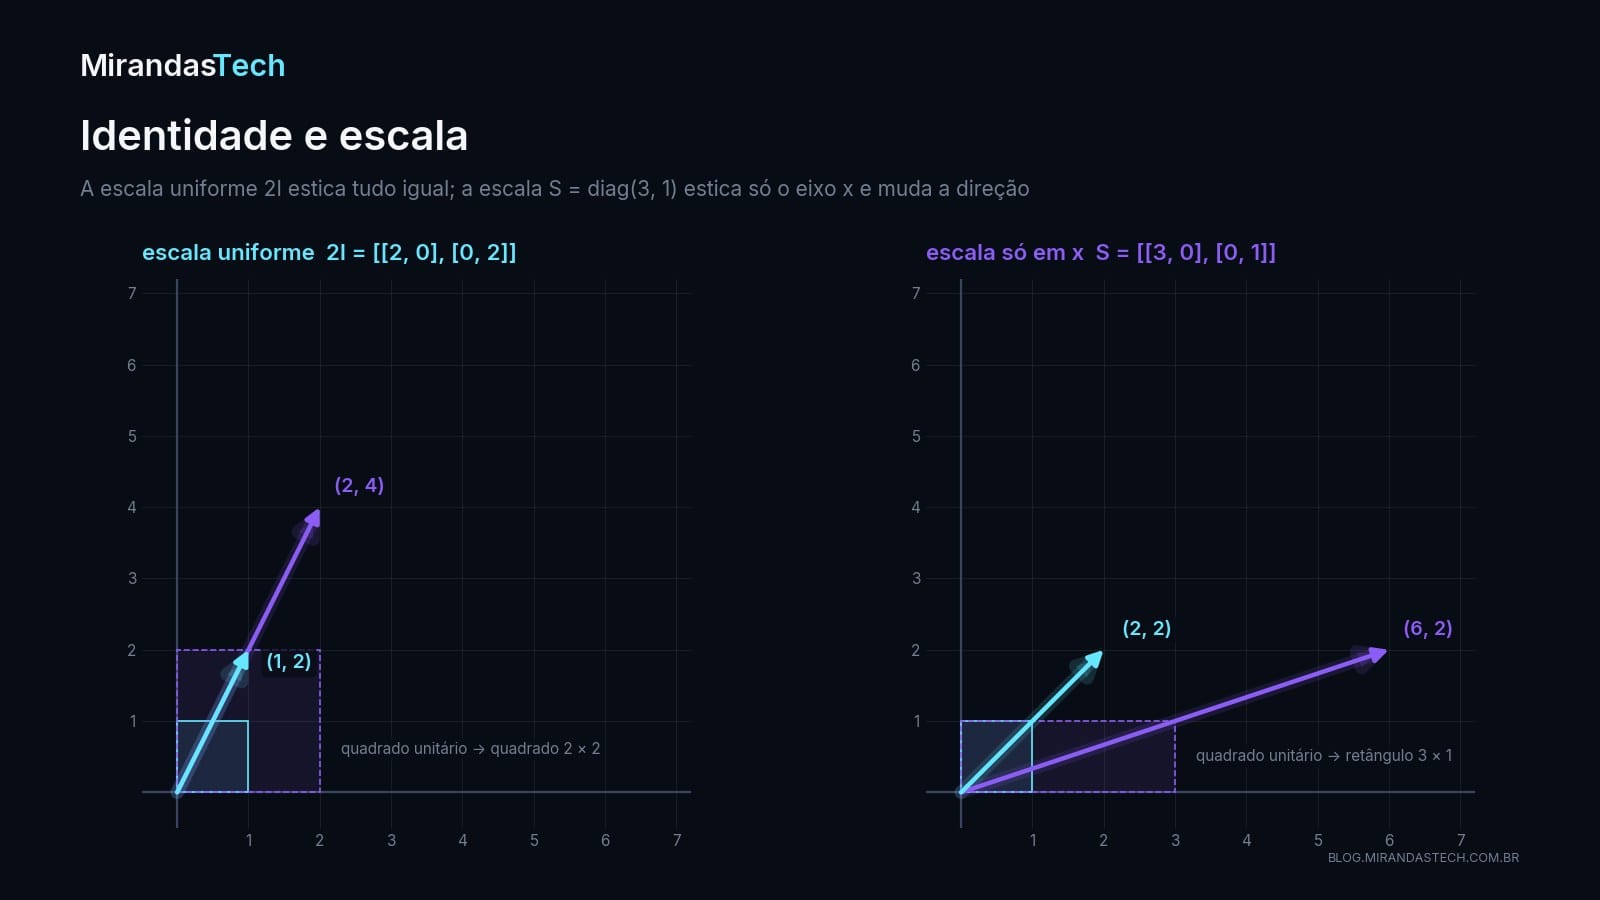
$$ W=\begin{bmatrix}2&0\\0&2\end{bmatrix} $$
Para:
$$ x=\begin{bmatrix}1\\2\end{bmatrix} $$
obtemos:
$$ Wx=\begin{bmatrix}2\\4\end{bmatrix} $$
O vetor ficou duas vezes maior, na mesma direção. Esse é o efeito de multiplicar a identidade por um escalar: o espaço inteiro é ampliado uniformemente.
Escala diferente em cada eixo
Os dois números da diagonal não precisam ser iguais. A matriz:
$$ W=\begin{bmatrix}3&0\\0&1\end{bmatrix} $$
faz o eixo $x$ ser multiplicado por 3 e preserva o eixo $y$. Para:
$$ x=\begin{bmatrix}2\\2\end{bmatrix} $$
o resultado é:
$$ Wx=\begin{bmatrix}6\\2\end{bmatrix} $$
Repare que agora a direção mudou: o vetor, que apontava a 45°, ficou mais deitado. A forma geral da matriz de escala 2D é:
$$ \boxed{S=\begin{bmatrix}s_x&0\\0&s_y\end{bmatrix}} $$
onde $s_x$ é o fator aplicado à componente horizontal e $s_y$ o fator aplicado à componente vertical. Fatores maiores que 1 esticam; entre 0 e 1 comprimem; iguais a 1 preservam o eixo. Guarde a forma: tudo fora da diagonal é zero. É o que distingue uma escala das transformações que vêm a seguir.
3. Rotação
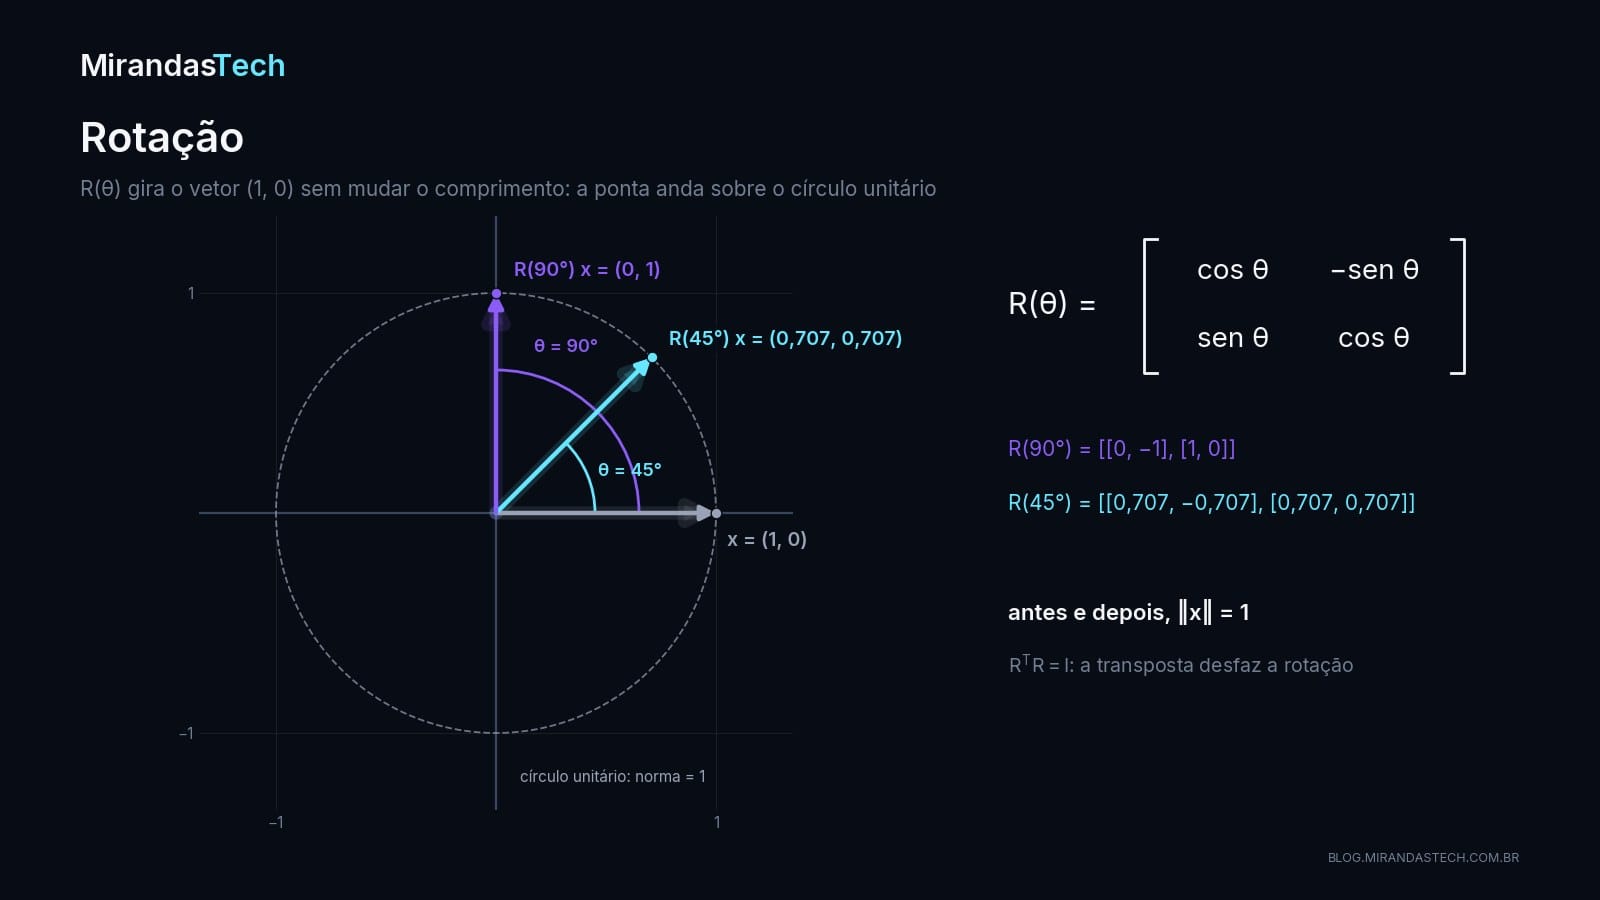
Uma rotação gira o espaço em torno da origem sem esticar nada. A matriz de rotação em 2D é:
$$ \boxed{R(\theta)=\begin{bmatrix}\cos\theta&-\sin\theta\\\sin\theta&\cos\theta\end{bmatrix}} $$
Aqui $\theta$ é o ângulo de giro, medido no sentido anti-horário a partir do eixo $x$; $\cos\theta$ e $\sin\theta$ são o cosseno e o seno desse ângulo. A primeira coluna, $(\cos\theta, \sin\theta)$, é para onde vai o vetor $(1, 0)$; a segunda, $(-\sin\theta, \cos\theta)$, é para onde vai o $(0, 1)$. A seção 7 vai mostrar por que ler as colunas assim funciona para qualquer matriz.
Rotação de 90°
Para $\theta=90^\circ$, temos $\cos\theta = 0$ e $\sin\theta = 1$:
$$ R=\begin{bmatrix}0&-1\\1&0\end{bmatrix} $$
Aplicando em:
$$ x=\begin{bmatrix}1\\0\end{bmatrix} $$
obtemos:
$$ Rx=\begin{bmatrix}0\\1\end{bmatrix} $$
O vetor foi girado 90° no sentido anti-horário. Uma rotação pura preserva comprimento e distância: antes e depois, a norma continua igual. É a propriedade que distingue uma rotação de uma escala, e a razão de a ponta do vetor caminhar sobre um círculo na figura.
Rotação de 45°
Para $\theta=45^\circ$, cosseno e seno valem $\sqrt{2}/2 \approx 0{,}707$:
$$ R=\begin{bmatrix}0.707&-0.707\\0.707&0.707\end{bmatrix} $$
Aplicando em $[1,0]^T$, obtemos aproximadamente:
$$ \begin{bmatrix}0.707\\0.707\end{bmatrix} $$
A direção mudou, mas a magnitude permaneceu aproximadamente 1 (o “aproximadamente” vem do arredondamento de 0,707; com o valor exato, é 1). Em NumPy, o ângulo entra em radianos:
import numpy as np

theta = np.radians(45)

R = np.array([
    [np.cos(theta), -np.sin(theta)],
    [np.sin(theta),  np.cos(theta)]
])

x = np.array([1.0, 0.0])
y = R @ x

print(y)
[0.70710678 0.70710678]
Vale conferir numericamente a promessa de que a rotação não muda o comprimento. Um vetor com norma conhecida, $(3, 4)$, tem norma 5 (é o triângulo 3-4-5 da Aula 02). Depois de girar 45°:
x = np.array([3.0, 4.0])

print("norma de x :", np.linalg.norm(x))
print("norma de Rx:", np.linalg.norm(R @ x))
print(R.T @ R)
norma de x : 5.0
norma de Rx: 5.0
[[1. 0.]
 [0. 1.]]
A norma continuou 5. A última linha mostra algo mais forte: $R^TR = I$, isto é, a transposta de uma rotação desfaz a rotação. Matrizes com essa propriedade se chamam ortogonais, e toda rotação é uma delas (Strang, 2016; Deisenroth, Faisal & Ong, 2020). É por isso que rotações preservam normas e produtos escalares: a geometria da Aula 03 sai intacta de uma rotação.
4. Reflexão
Uma matriz também pode espelhar o espaço. A reflexão em relação ao eixo horizontal é:
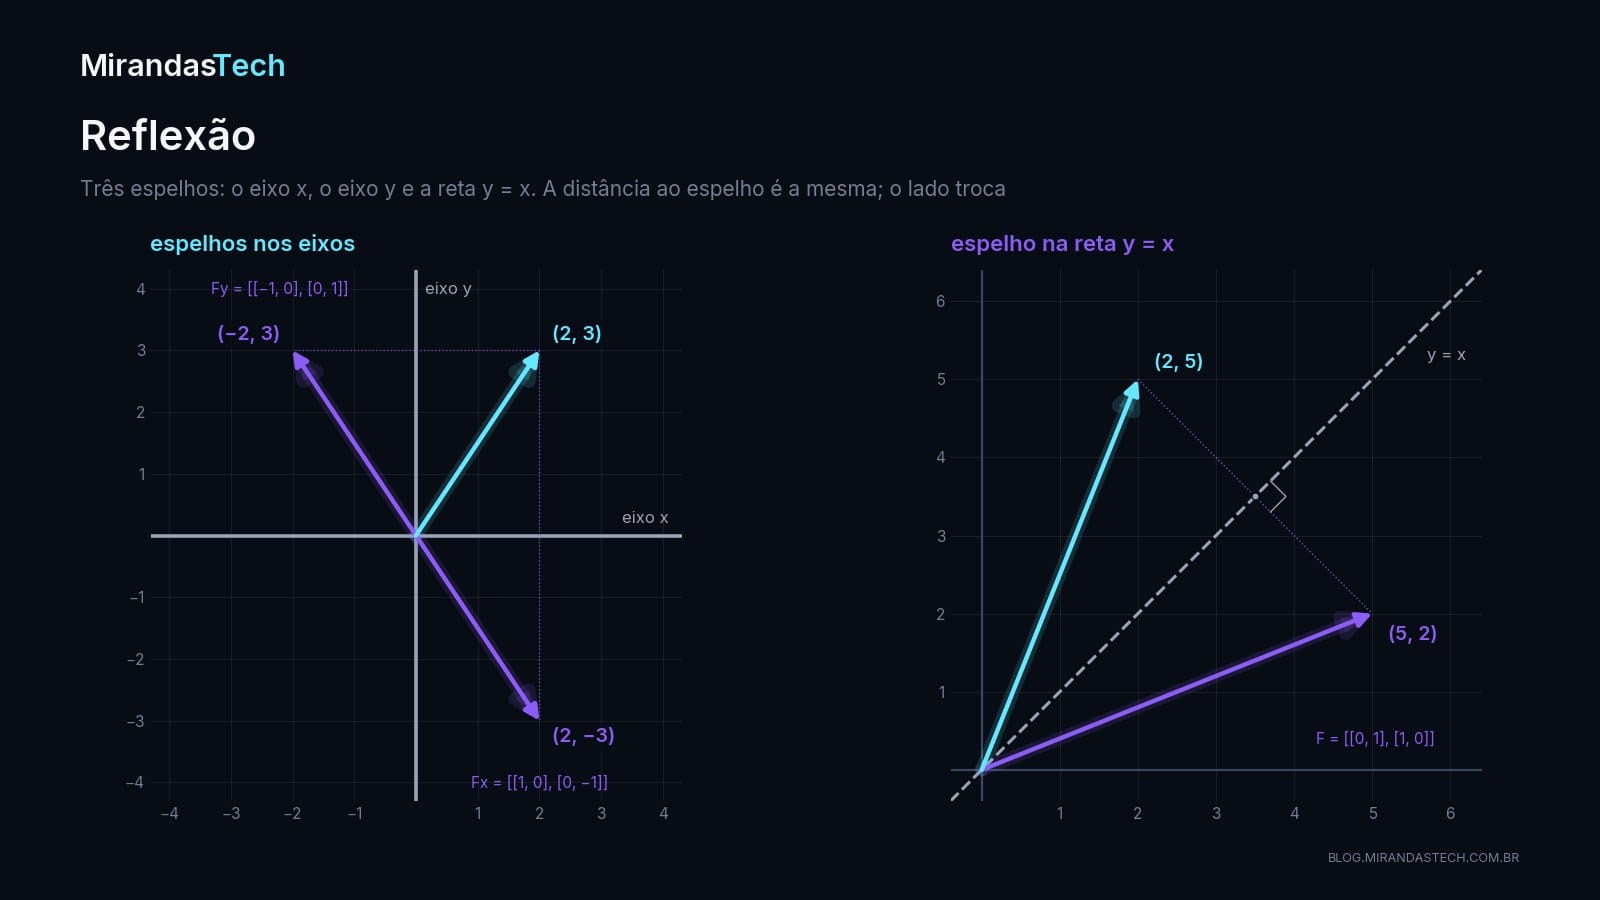
$$ W=\begin{bmatrix}1&0\\0&-1\end{bmatrix} $$
Para:
$$ x=\begin{bmatrix}2\\3\end{bmatrix} $$
obtemos:
$$ Wx=\begin{bmatrix}2\\-3\end{bmatrix} $$
A componente horizontal ficou, a vertical trocou de sinal: o vetor foi espelhado para baixo do eixo $x$. Compare com a matriz de escala da seção anterior: é uma escala com $s_y = -1$. Fatores negativos na diagonal espelham.
Reflexão no eixo y
$$ W=\begin{bmatrix}-1&0\\0&1\end{bmatrix} $$
transforma $[2,3]^T$ em $[-2,3]^T$. Agora foi a componente horizontal que trocou de sinal.
Reflexão na reta y = x
$$ W=\begin{bmatrix}0&1\\1&0\end{bmatrix} $$
transforma:
$$ \begin{bmatrix}2\\5\end{bmatrix} \rightarrow \begin{bmatrix}5\\2\end{bmatrix} $$
As componentes foram trocadas. Espelhar na diagonal é trocar $x$ por $y$. Um detalhe útil para conferir contas: aplicar o mesmo espelho duas vezes devolve o vetor original (em NumPy, W @ W @ x para a primeira reflexão devolve [2 3]). Assim como a rotação, a reflexão preserva comprimentos; a diferença é que ela inverte a orientação do plano, algo que a Aula 07 vai medir com o determinante.
5. Projeção
Até aqui, nenhuma transformação perdeu informação: dado o resultado, dá para recuperar o vetor original. A projeção é a primeira que joga algo fora. Considere:
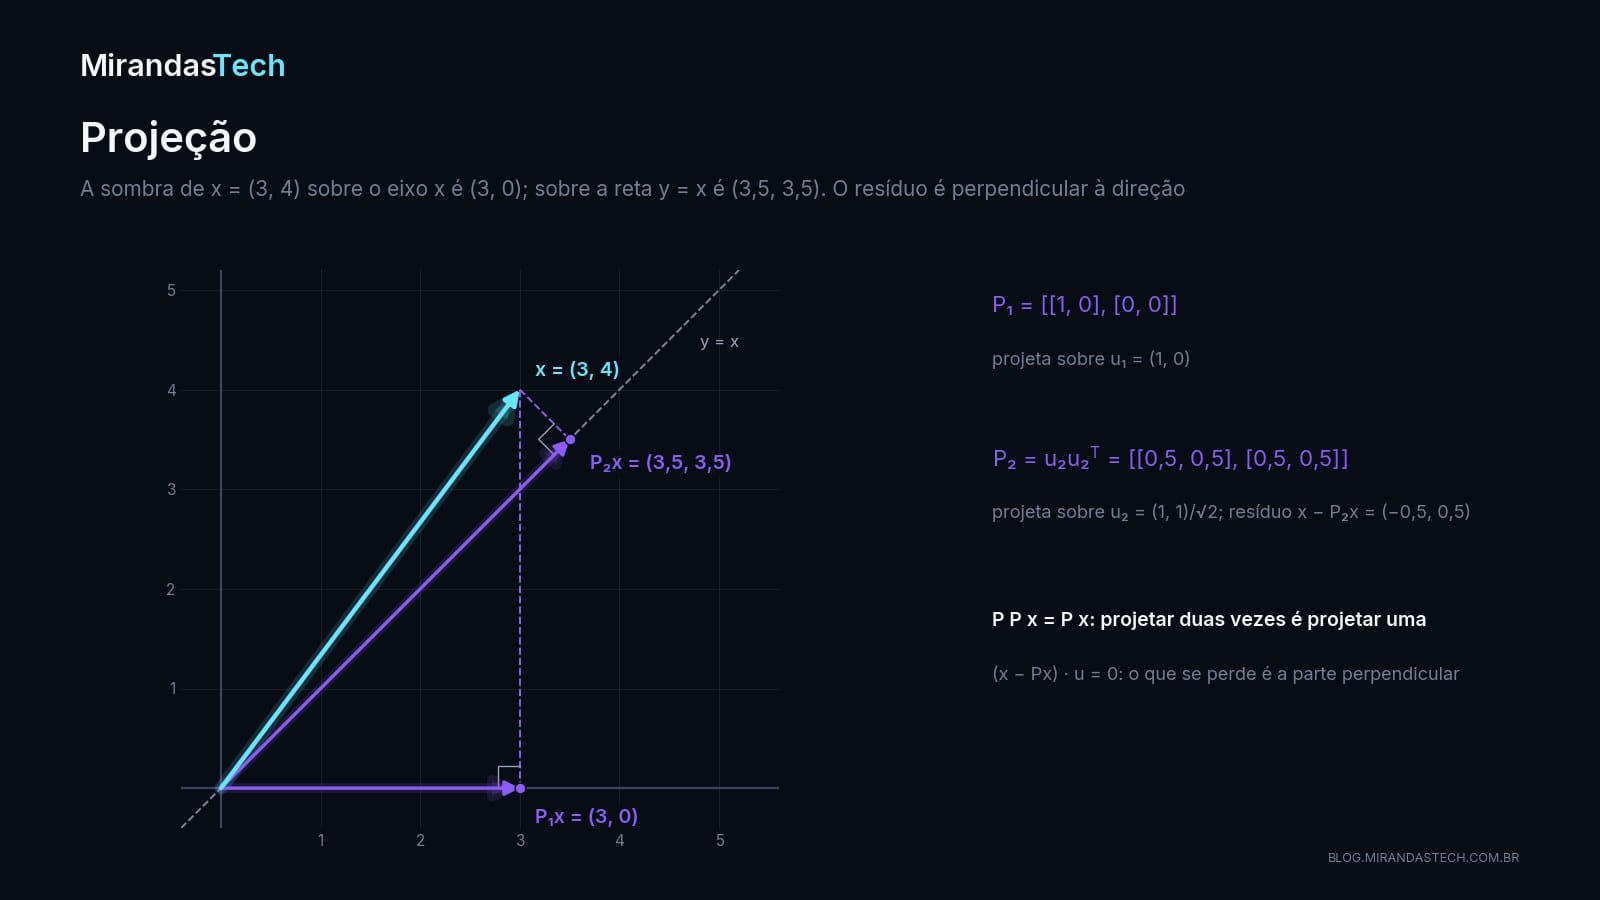
$$ x=\begin{bmatrix}3\\4\end{bmatrix} $$
Queremos projetá-lo sobre o eixo $x$. Usamos:
$$ P=\begin{bmatrix}1&0\\0&0\end{bmatrix} $$
Então:
$$ Px=\begin{bmatrix}3\\0\end{bmatrix} $$
A componente vertical foi descartada. Note que $(3, 0)$ é também o resultado de projetar $(3, 1)$, $(3, 7)$ ou $(3, -2)$: depois da projeção, não há como saber qual era o vetor original. Projetar significa responder, aproximadamente:
Quanto desse vetor existe em determinada direção ou subespaço?
Projeção sobre um vetor unitário
O eixo $x$ é só um caso particular. Para um vetor unitário $u$ qualquer (norma 1), a projeção de $x$ sobre a direção de $u$ é:
$$ \boxed{proj_u(x)=(x\cdot u)u} $$
O número $x\cdot u$ é o produto escalar da Aula 03: quanto $x$ se alinha com $u$. Multiplicá-lo por $u$ transforma esse número de volta em um vetor apontando na direção de $u$. Exemplo:
$$ x=\begin{bmatrix}3\\4\end{bmatrix},\quad u=\begin{bmatrix}1\\0\end{bmatrix} $$
Temos:
$$ x\cdot u=3 $$
Logo:
$$ proj_u(x)=3\begin{bmatrix}1\\0\end{bmatrix}=\begin{bmatrix}3\\0\end{bmatrix} $$
O mesmo $(3, 0)$ de antes, agora obtido pela fórmula geral.
Matriz de projeção
Como toda transformação linear, a projeção tem uma matriz. Quando $u$ é unitário:
$$ \boxed{P=uu^T} $$
O produto $uu^T$ (um vetor coluna vezes um vetor linha) é uma matriz 2 × 2, o chamado produto externo. Se:
$$ u=\begin{bmatrix}1\\0\end{bmatrix} $$
então:
$$ P=\begin{bmatrix}1&0\\0&0\end{bmatrix} $$
exatamente a matriz do início da seção. Para ver a fórmula trabalhando em uma direção que não é um eixo, projete $(3, 4)$ sobre a reta $y = x$, cujo vetor unitário é $u = (1, 1)/\sqrt{2}$:
import numpy as np

x = np.array([3.0, 4.0])
u = np.array([1.0, 1.0]) / np.sqrt(2)   # unitário na direção da reta y = x

P = np.outer(u, u)                       # P = u u^T
print("x·u      :", x @ u)
print("proj_u(x):", (x @ u) * u)
print("P =\n", P)
print("P x      :", P @ x)
print("P P x    :", P @ P @ x)
print("resíduo  :", x - P @ x, "  resíduo·u =", (x - P @ x) @ u)
x·u      : 4.949747468305832
proj_u(x): [3.5 3.5]
P =
 [[0.5 0.5]
 [0.5 0.5]]
P x      : [3.5 3.5]
P P x    : [3.5 3.5]
resíduo  : [-0.5  0.5]   resíduo·u = 1.2212453270876722e-15
Três coisas para ler nessa saída. Primeiro, $(x\cdot u)u$ e $Px$ dão o mesmo $(3{,}5, 3{,}5)$: fórmula e matriz são a mesma operação. Segundo, $PPx = Px$: projetar duas vezes é o mesmo que projetar uma; uma vez na reta, o vetor já não tem para onde cair. Terceiro, o resíduo $x - Px = (-0{,}5, 0{,}5)$ tem produto escalar zero com $u$ (o $10^{-15}$ é erro de ponto flutuante): o que a projeção descarta é exatamente a parte perpendicular à direção escolhida (Deisenroth, Faisal & Ong, 2020). É a “sombra” da figura, com a perpendicular tracejada.
Em Transformers, veremos matrizes que também recebem o nome de projeção:
$$ Q=XW_Q $$
$$ K=XW_K $$
$$ V=XW_V $$
As matrizes $W_Q$, $W_K$ e $W_V$ transformam a representação original $X$ em novos espaços. Não são necessariamente projeções geométricas simples como a projeção ortogonal estudada aqui, mas preservam a ideia central de mapear uma representação para outra. Voltaremos a elas na seção 11.
6. Cisalhamento e transformações gerais
Escala, rotação, reflexão e projeção são os casos “puros”. Uma matriz qualquer combina vários efeitos. Por exemplo:
$$ W=\begin{bmatrix}2&1\\0&1\end{bmatrix} $$
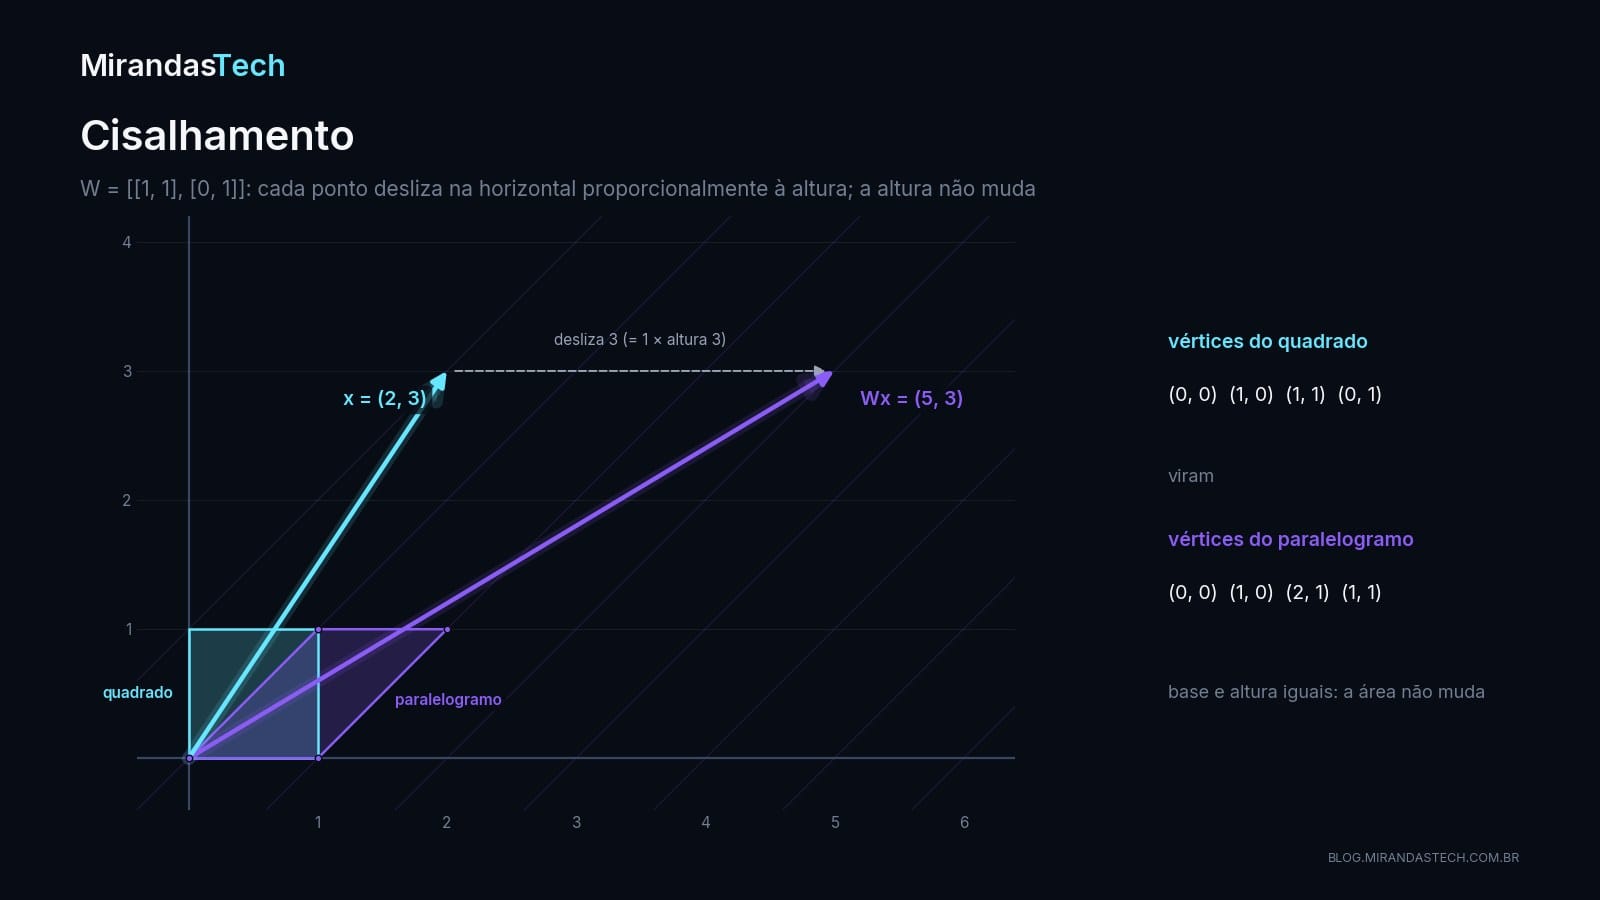
pode deformar o espaço de maneira mais geral: estica na horizontal e, ao mesmo tempo, inclina. Um caso com nome próprio é o cisalhamento (shear):
$$ W=\begin{bmatrix}1&1\\0&1\end{bmatrix} $$
Para:
$$ x=\begin{bmatrix}2\\3\end{bmatrix} $$
obtemos:
$$ Wx=\begin{bmatrix}5\\3\end{bmatrix} $$
A componente vertical, 3, ficou igual; a horizontal recebeu a vertical somada: $2 + 3 = 5$. Pontos mais altos deslizam mais para a direita; pontos no eixo $x$ não se movem. É o que acontece com um baralho quando se empurra o topo de lado: o quadrado unitário, de vértices $(0,0)$, $(1,0)$, $(1,1)$ e $(0,1)$, vira o paralelogramo $(0,0)$, $(1,0)$, $(2,1)$ e $(1,1)$. Compare com a matriz de escala: a diferença toda está no 1 fora da diagonal. É esse elemento que mistura uma componente na outra.
7. As colunas dizem para onde vai a base
Há uma forma de ler qualquer matriz, pura ou misturada, de uma vez só. No plano 2D temos os vetores da base:
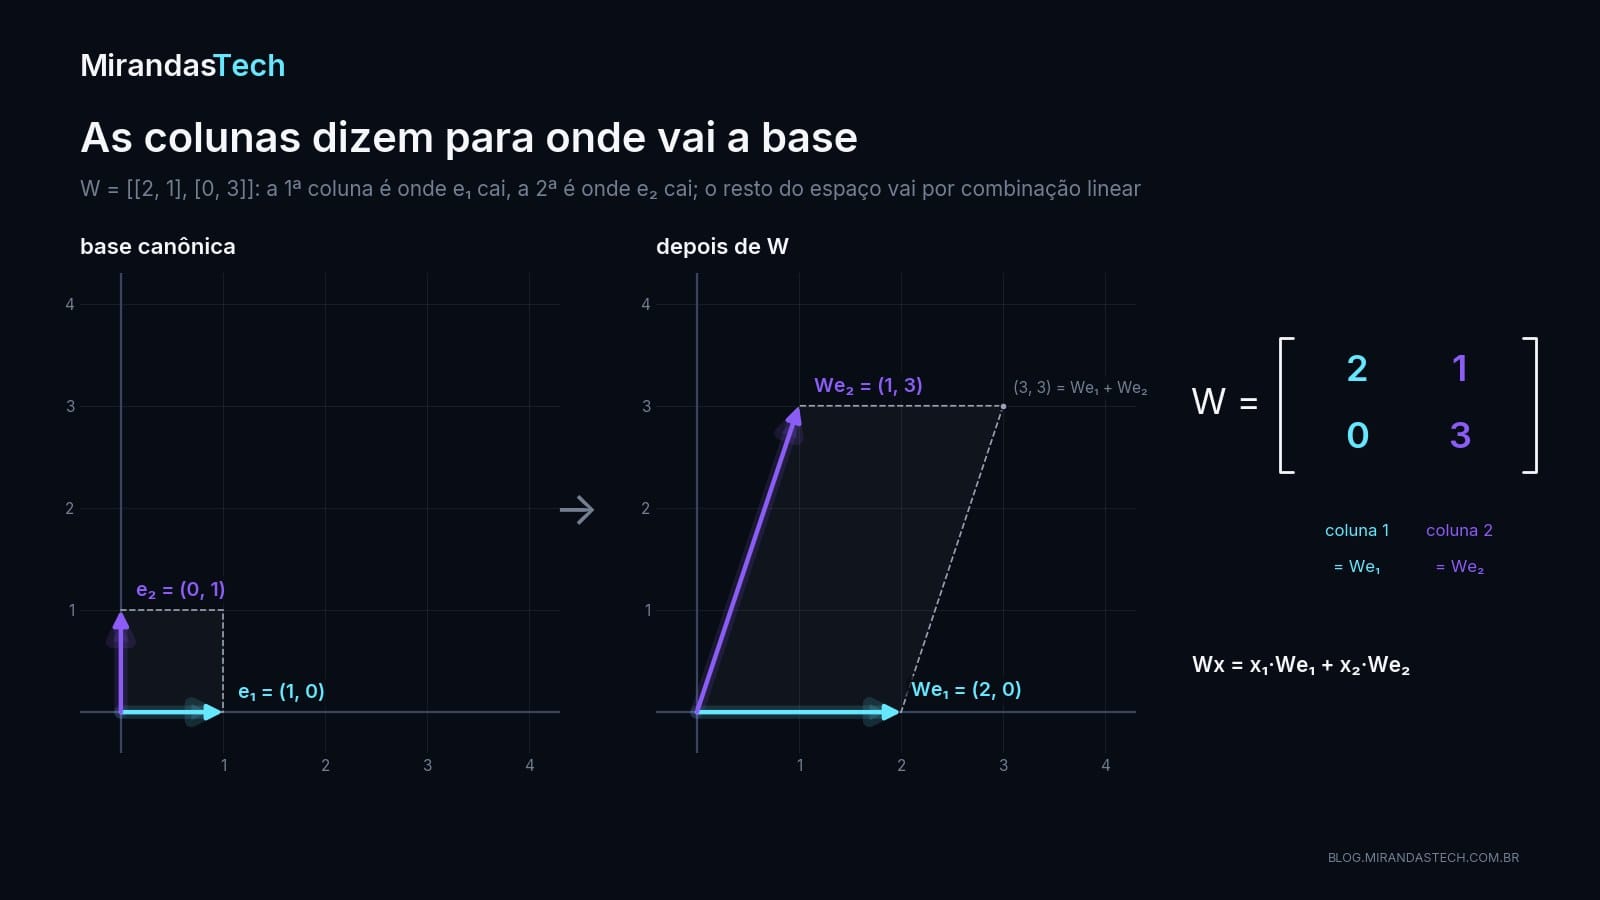
$$ e_1=\begin{bmatrix}1\\0\end{bmatrix},\quad e_2=\begin{bmatrix}0\\1\end{bmatrix} $$
Considere:
$$ W=\begin{bmatrix}2&1\\0&3\end{bmatrix} $$
Então:
$$ We_1=\begin{bmatrix}2\\0\end{bmatrix} $$
$$ We_2=\begin{bmatrix}1\\3\end{bmatrix} $$
As colunas de $W$ são exatamente os vetores $We_1$ e $We_2$. Não é coincidência: multiplicar por $e_1$ seleciona a primeira coluna, e multiplicar por $e_2$ seleciona a segunda. Portanto:
As colunas de uma matriz mostram para onde os vetores da base são enviados.
E como qualquer vetor pode ser escrito como combinação da base:
$$ x=ae_1+be_2 $$
a transformação de $x$ é a mesma combinação das colunas:
$$ Wx=aWe_1+bWe_2 $$
Aqui $a$ e $b$ são as componentes de $x$. Saber para onde vão $e_1$ e $e_2$ é saber para onde vai tudo. Em NumPy:
import numpy as np

W = np.array([[2, 1],
              [0, 3]])
e1 = np.array([1, 0])
e2 = np.array([0, 1])

print("W e1 =", W @ e1, " coluna 1 =", W[:, 0])
print("W e2 =", W @ e2, " coluna 2 =", W[:, 1])

x = 2 * e1 + 3 * e2
print("W x             =", W @ x)
print("2·W e1 + 3·W e2 =", 2 * (W @ e1) + 3 * (W @ e2))
W e1 = [2 0]  coluna 1 = [2 0]
W e2 = [1 3]  coluna 2 = [1 3]
W x             = [7 9]
2·W e1 + 3·W e2 = [7 9]
Com essa lente, releia as matrizes das seções anteriores. Na escala, as colunas são $(s_x, 0)$ e $(0, s_y)$: cada vetor da base fica na sua direção, só muda de tamanho. Na rotação, as colunas são $(\cos\theta, \sin\theta)$ e $(-\sin\theta, \cos\theta)$: os dois vetores da base giram juntos e continuam perpendiculares. Na projeção sobre o eixo $x$, a segunda coluna é $(0, 0)$: $e_2$ é enviado à origem, e é aí que a informação se perde. No cisalhamento, $e_1$ fica parado e $e_2$ vai para $(1, 1)$. Uma matriz é um catálogo de destinos da base.
8. Composição: a ordem importa
Transformações se encadeiam. Se aplicamos primeiro $A$ e depois $B$:
$$ x\xrightarrow{A}Ax\xrightarrow{B}B(Ax) $$
Então:
$$ \boxed{BAx} $$
A matriz que representa “primeiro $A$, depois $B$” é o produto $BA$, com $A$ à direita, encostada em $x$. Em geral:
$$ \boxed{AB\neq BA} $$
A ordem importa. Uma regra útil: em $ABCx$, leia da direita para a esquerda, primeiro $C$, depois $B$, depois $A$. É a ordem em que as transformações tocam o vetor.
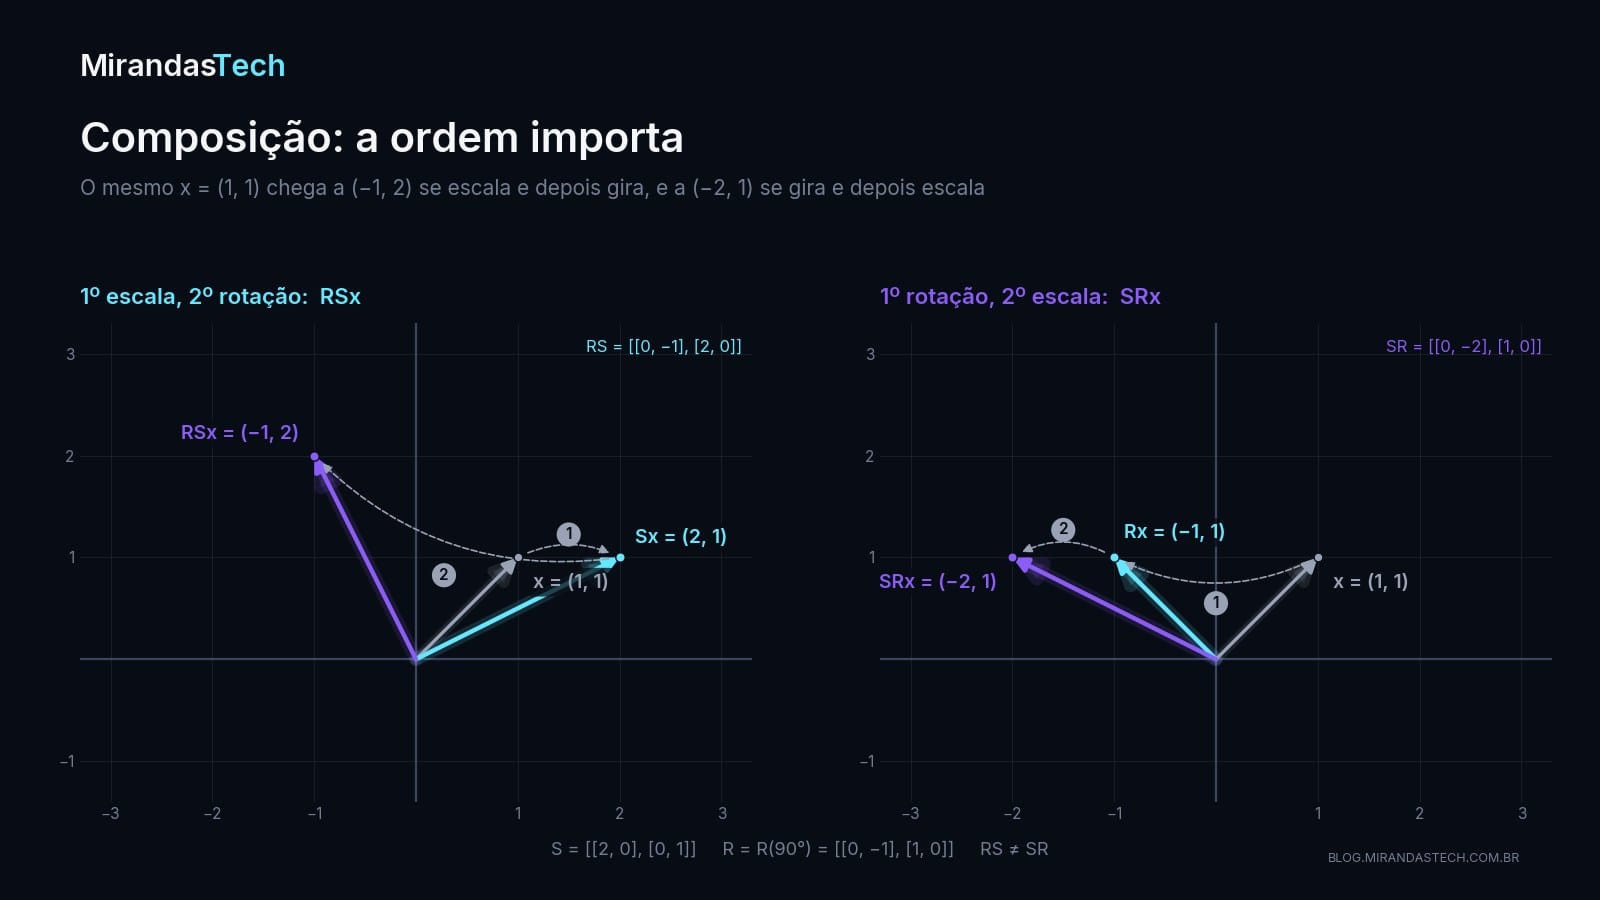
Para ver isso acontecer, combine uma escala e uma rotação de 90° sobre o vetor $(1, 1)$:
import numpy as np

x = np.array([1.0, 1.0])

S = np.array([
    [2.0, 0.0],
    [0.0, 1.0]
])

R = np.array([
    [0.0, -1.0],
    [1.0,  0.0]
])

print("Original:", x)
print("Escala:", S @ x)
print("Rotação:", R @ x)
print("Escala + rotação:", R @ S @ x)
print("Rotação + escala:", S @ R @ x)
Original: [1. 1.]
Escala: [2. 1.]
Rotação: [-1.  1.]
Escala + rotação: [-1.  2.]
Rotação + escala: [-2.  1.]
Escalar e depois girar leva $(1, 1)$ a $(-1, 2)$; girar e depois escalar leva a $(-2, 1)$. Os dois destinos são diferentes porque as matrizes compostas são diferentes:
$$ RS=\begin{bmatrix}0&-1\\2&0\end{bmatrix},\qquad SR=\begin{bmatrix}0&-2\\1&0\end{bmatrix} $$
Comparar $RSx$ com $SRx$ mostra na prática que, em geral:
$$ RS\neq SR $$
Repare que cada produto é, ele mesmo, uma única matriz 2 × 2. Duas transformações encadeadas continuam sendo uma transformação. Esse detalhe é o que a próxima seção explora.
9. Uma rede neural é uma cadeia de transformações
Uma rede com várias matrizes pode ser vista como uma sequência de mudanças de representação: a entrada passa pela transformação 1 e vira a representação 1; esta passa pela transformação 2 e vira a representação 2; e assim por diante. Cada seta dessa cadeia é uma das operações deste artigo, em mais dimensões.
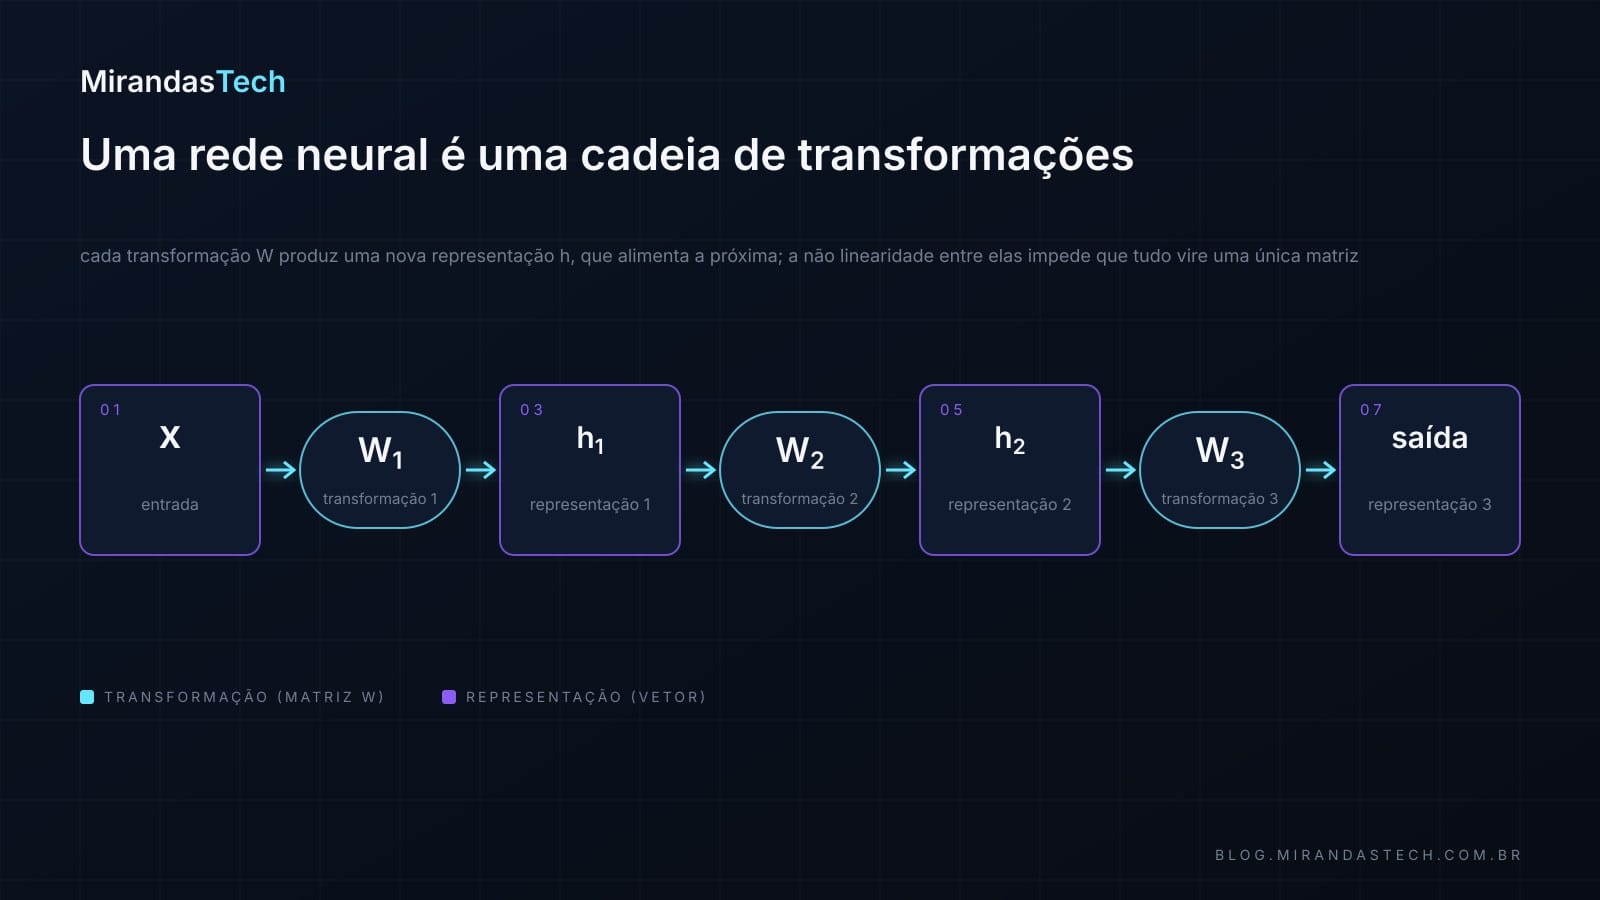
Mas há uma armadilha. Se tivermos apenas:
$$ W_3W_2W_1x $$
podemos combinar tudo em uma única transformação linear, exatamente como $RS$ virou uma só matriz na seção anterior. Em NumPy, com matrizes sintéticas de tamanhos 4 × 3, 5 × 4 e 2 × 5 sorteadas ao acaso:
import numpy as np

rng = np.random.default_rng(0)
W1 = rng.standard_normal((4, 3))
W2 = rng.standard_normal((5, 4))
W3 = rng.standard_normal((2, 5))
x  = rng.standard_normal(3)

W = W3 @ W2 @ W1
print(W.shape)
print(np.allclose(W3 @ (W2 @ (W1 @ x)), W @ x))
(2, 3)
True
Três camadas, três matrizes, e no fim uma única matriz 2 × 3 faz o mesmo serviço. Por isso redes neurais incluem não linearidades entre as matrizes, por exemplo:
$$ \boxed{y=W_2ReLU(W_1x)} $$
Aqui $ReLU(z) = \max(0, z)$, aplicada componente a componente, como na Aula 05. A não linearidade impede que todas as camadas sejam reduzidas a uma única matriz: não existe matriz que faça o que $W_2ReLU(W_1\,\cdot\,)$ faz.
Com esse ingrediente, uma forma útil de pensar em Deep Learning é:
As camadas aprendem transformações que reorganizam o espaço para tornar padrões mais fáceis de reconhecer ou separar.
Dados inicialmente misturados podem, após transformações sucessivas (esticar aqui, girar ali, achatar uma direção irrelevante), adquirir uma representação em que classes e estruturas se tornam mais separáveis (Goodfellow, Bengio & Courville, 2016). Cada operação deste artigo é uma peça desse repertório; o treinamento escolhe quais usar e em que ordem.
10. Mudança de dimensão: o mesmo princípio em 768 dimensões
Tudo até aqui foi em 2D para caber num desenho. Nada muda quando a matriz deixa de ser quadrada ou quando o espaço tem centenas de dimensões. Podemos ter:
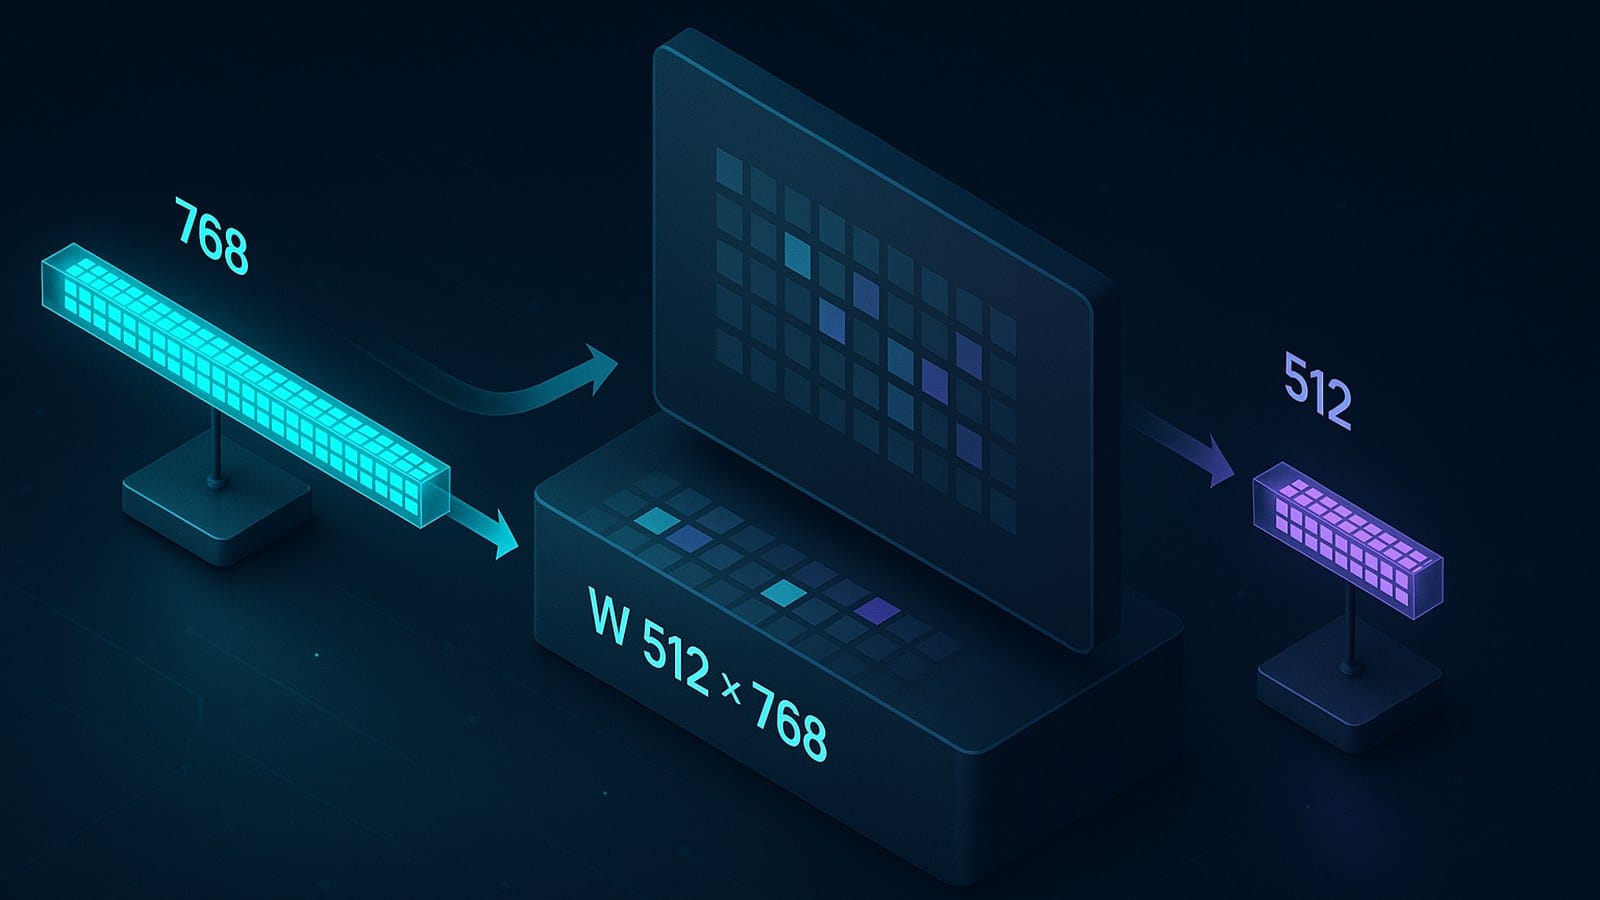
$$ W\in\mathbb{R}^{512\times768} $$
Então:
$$ x\in\mathbb{R}^{768}\rightarrow Wx\in\mathbb{R}^{512} $$
É a camada nn.Linear(768, 512) que abriu a Aula 05, agora vista pela geometria: 768 vetores de base entram, cada um é enviado para uma coluna de $W$ com 512 componentes, e o vetor de saída é a combinação dessas colunas. Também é possível expandir dimensões, com uma matriz que tem mais linhas que colunas. O mesmo princípio vale em 768, 4096 ou dezenas de milhares de dimensões, mesmo quando não conseguimos visualizar o espaço.
A projeção da seção 5 também escala. Quando você vê embeddings de 768 dimensões desenhados num gráfico 2D, o que está na tela são duas coordenadas por vetor, $x\cdot u_1$ e $x\cdot u_2$, com $u_1$ e $u_2$ unitários e perpendiculares; no PCA, são as duas direções em que os dados mais variam (Jolliffe & Cadima, 2016). É o $(x\cdot u)$ deste artigo aplicado duas vezes, e o que fica de fora do gráfico é, como no exemplo do $(3, 4)$, a parte perpendicular a essas direções.
11. Ligação com Transformers
Mais adiante na trilha veremos:
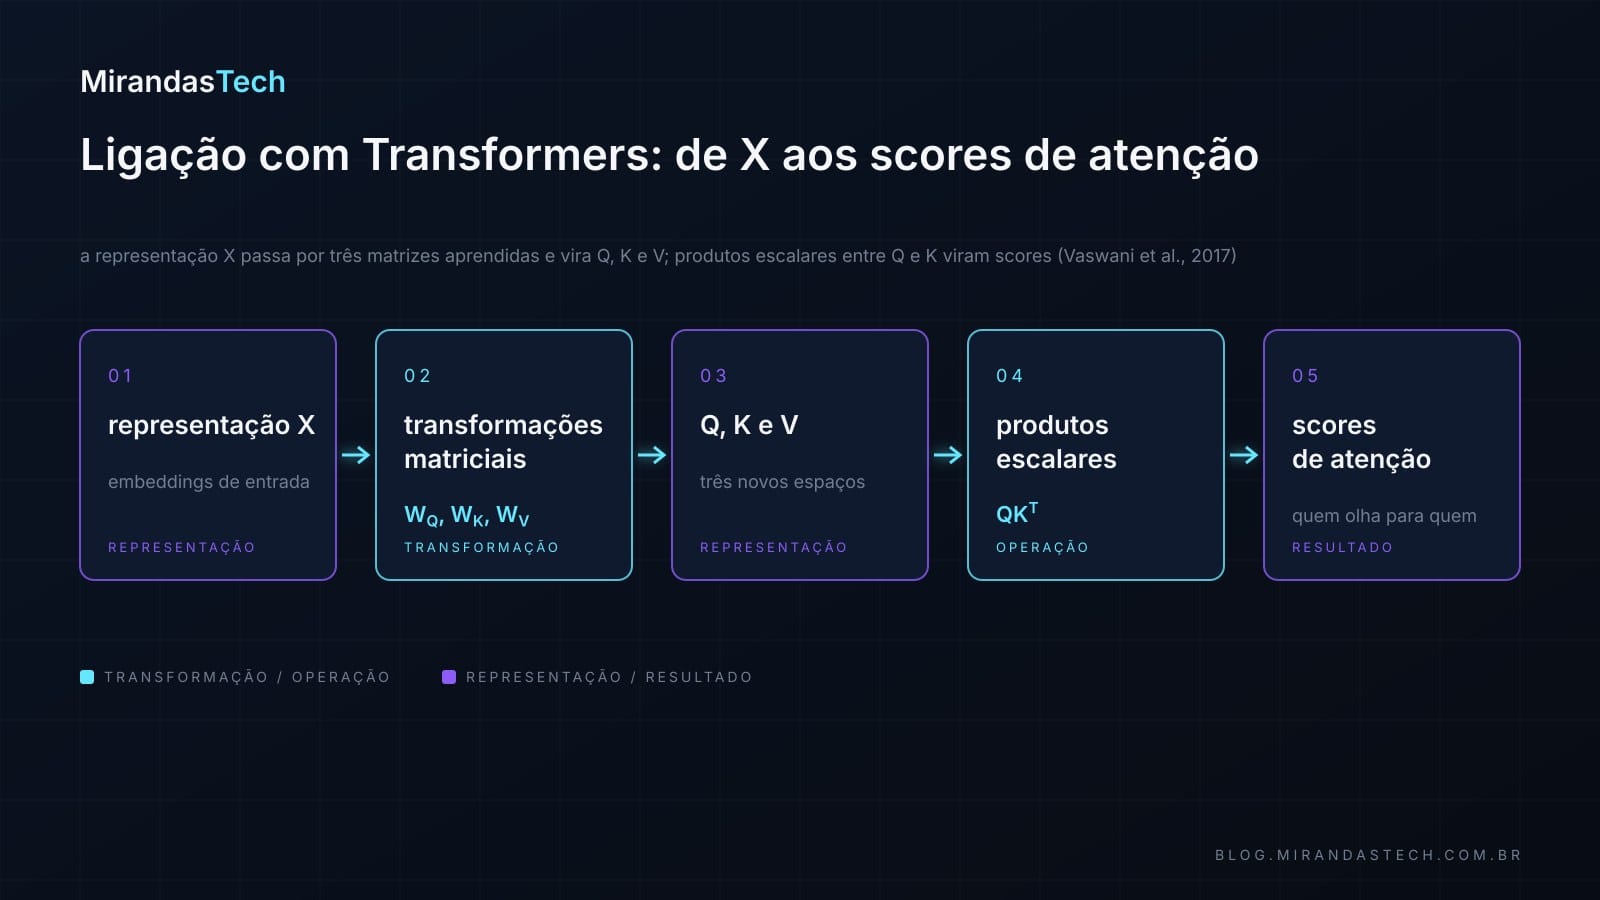
$$ XW_Q,\quad XW_K,\quad XW_V $$
seguido de:
$$ QK^T $$
A sequência conceitual é: a representação $X$ passa por transformações matriciais e vira $Q$, $K$ e $V$; produtos escalares entre linhas de $Q$ e de $K$ produzem os scores de atenção (Vaswani et al., 2017). Os conceitos das aulas anteriores se unem aqui: vetores (Aula 01 e 02), produto escalar (Aula 03), similaridade (Aula 04), matriz como transformação (Aula 05) e, agora, o que essa transformação faz com o espaço.
A rotação da seção 3 aparece de forma ainda mais literal. Nos Transformers que usam RoPE (Rotary Position Embedding), como a família LLaMA, as coordenadas de $Q$ e $K$ são agrupadas em pares e cada par é girado por uma matriz $R(\theta)$ como a desta aula, com um ângulo proporcional à posição do token na sequência (e uma velocidade de giro própria para cada par). Como a rotação preserva normas e o produto escalar entre dois vetores girados depende dos ângulos apenas pela diferença entre eles, o score $q\cdot k$ passa a carregar a distância relativa entre as posições (Su et al., 2024; Touvron et al., 2023). A matriz 2 × 2 de cosseno e seno que giramos à mão na seção 3 é, dentro de um LLM com RoPE, o que informa ao modelo a que distância cada palavra está das outras.
12. Exercícios
1. Escala.
$$ S=\begin{bmatrix}2&0\\0&3\end{bmatrix},\quad x=\begin{bmatrix}2\\1\end{bmatrix} $$
Calcule $Sx$ e explique geometricamente o que aconteceu.
2. Rotação.
$$ R=\begin{bmatrix}0&-1\\1&0\end{bmatrix},\quad x=\begin{bmatrix}1\\0\end{bmatrix} $$
Calcule $Rx$. Qual transformação ocorreu?
3. Reflexão.
$$ W=\begin{bmatrix}1&0\\0&-1\end{bmatrix},\quad x=\begin{bmatrix}3\\2\end{bmatrix} $$
Calcule $Wx$ e identifique a reflexão.
4. Projeção.
$$ P=\begin{bmatrix}1&0\\0&0\end{bmatrix},\quad x=\begin{bmatrix}5\\7\end{bmatrix} $$
Calcule $Px$. O que aconteceu com a componente vertical?
5. Base.
$$ W=\begin{bmatrix}3&2\\1&4\end{bmatrix} $$
Determine $We_1$ e $We_2$ sem realizar uma multiplicação completa.
6. Composição. Se:
$$ y=BAx $$
qual transformação acontece primeiro: $A$ ou $B$? Explique.
7. Questão principal. Explique com suas palavras a frase:
“Uma rede neural aprende a reorganizar o espaço das representações.”
Relacione sua resposta com transformações como $W_1x$, $W_2h$ e novas representações intermediárias.
O que guardar
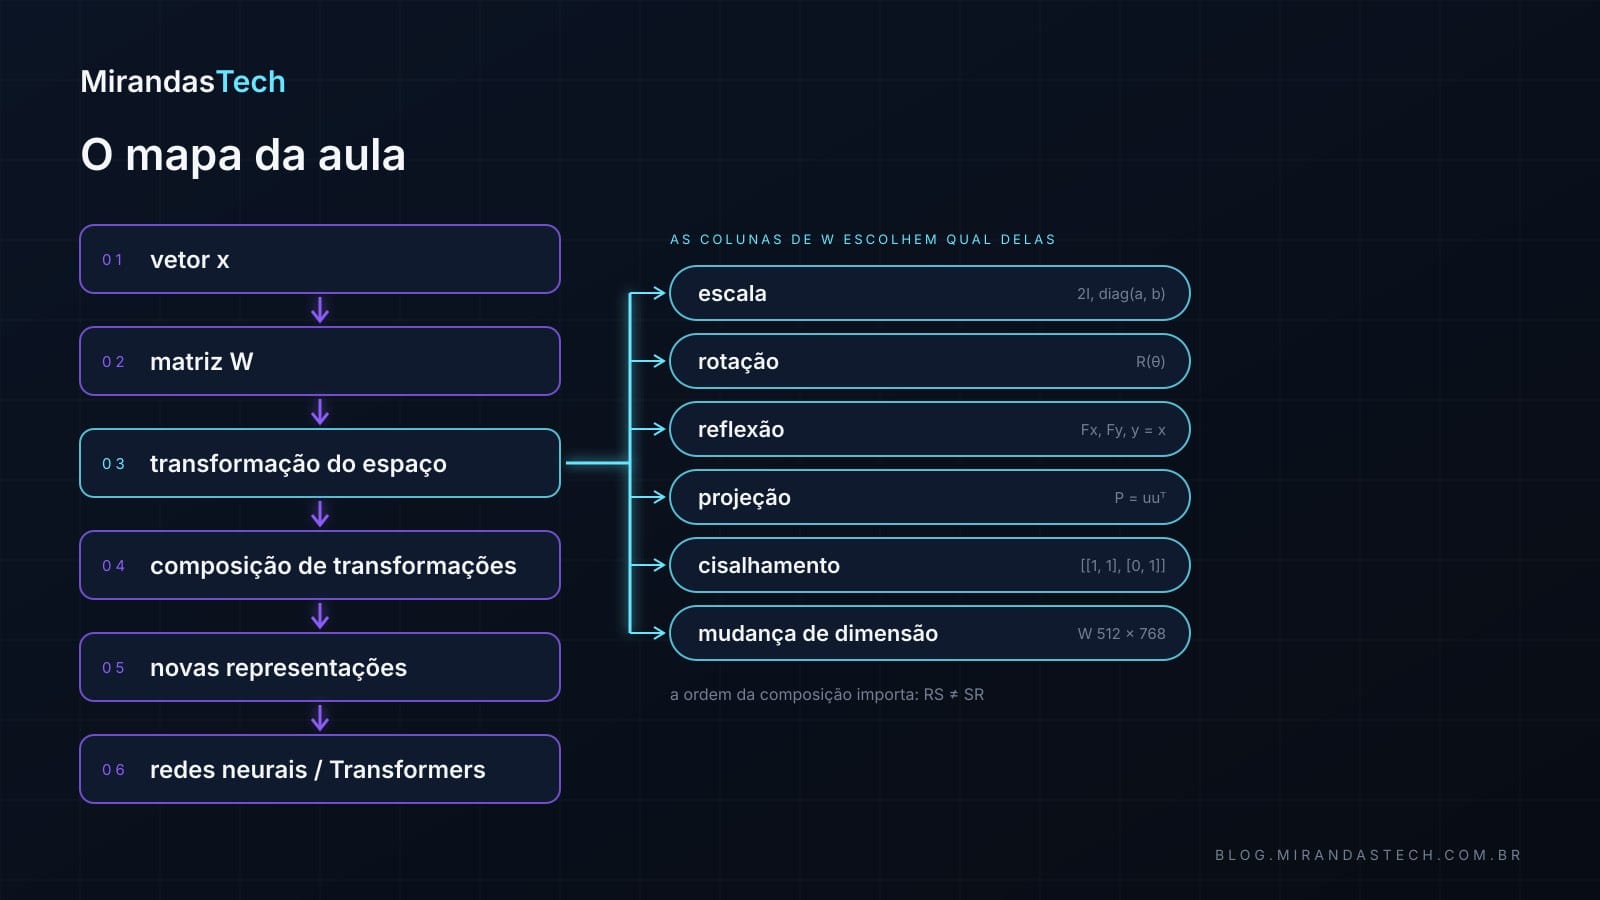
O mapa do artigo cabe em uma figura: um vetor encontra uma matriz; a matriz transforma o espaço por escala, rotação, reflexão, projeção, cisalhamento ou mudança de dimensão; transformações se compõem; a composição produz novas representações; redes neurais e Transformers são cadeias dessas representações.
Não pense em matriz apenas como uma tabela de números. Pense:
$$ \boxed{W=\text{uma regra para reorganizar o espaço}} $$
Ela pode alterar posição, direção, escala, dimensão e representação. E as colunas contam a regra inteira: para onde cada vetor da base foi enviado. Em IA, os valores de $W$ são aprendidos para produzir transformações úteis dos dados.
Na Aula 07, Determinante: área, volume, orientação e perda de informação, vamos estudar $\det(W)$ com interpretação geométrica: quanto uma transformação muda áreas e volumes, se ela inverte a orientação (como a reflexão fez), quais matrizes são invertíveis e por que $\det(W)=0$ indica colapso de dimensão e perda de informação, o que a projeção já nos mostrou de perto.
Referências
- Szeliski, Richard. Computer Vision: Algorithms and Applications. 2. ed. Texts in Computer Science, Springer, 2022. doi.org/10.1007/978-3-030-34372-9
- Strang, Gilbert. Introduction to Linear Algebra. 5. ed. Wellesley-Cambridge Press, 2016. math.mit.edu/~gs/linearalgebra/ila5
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. doi.org/10.1017/9781108679930
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. MIT Press, 2016. www.deeplearningbook.org
- Jolliffe, Ian T.; Cadima, Jorge. Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A, v. 374, n. 2065, 20150202, 2016. doi.org/10.1098/rsta.2015.0202
- Vaswani, Ashish; Shazeer, Noam; Parmar, Niki et al. Attention Is All You Need. arXiv (NeurIPS 2017), 2017. arxiv.org/abs/1706.03762
- Su, Jianlin; Ahmed, Murtadha; Lu, Yu et al. RoFormer: Enhanced transformer with Rotary Position Embedding. Neurocomputing, v. 568, 127063, 2024. doi.org/10.1016/j.neucom.2023.127063 (preprint: arxiv.org/abs/2104.09864, 2021)
- Touvron, Hugo; Lavril, Thibaut; Izacard, Gautier et al. LLaMA: Open and Efficient Foundation Language Models. arXiv, 2023. arxiv.org/abs/2302.13971

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/06-transformacoes-geometricas.md.



