
Determinante: área, volume, orientação e perda de informação
Compreender o determinante geometricamente e usá-lo para identificar mudança de área e volume, inversão de orientação e perda de dimensão.

Compreender o determinante geometricamente e usá-lo para identificar mudança de área e volume, inversão de orientação e perda de dimensão. Pré-requisito: Aula 06 — Transformações geométricas.
Olhe a sombra de uma caneca na mesa. Ela tem a largura da caneca, mas não tem a altura: a luz projetou um objeto de três dimensões num plano de duas, e nenhum cálculo feito só com a sombra vai devolver a altura que ficou para trás. Agora pense num aplicativo de mapas que amplia a tela 2 vezes na horizontal e 2 vezes na vertical. Cada quarteirão fica 4 vezes maior em área, não 2. São duas perguntas diferentes sobre uma transformação: quanto ela muda o tamanho das coisas, e se ela destrói alguma direção pelo caminho.
No artigo anterior da série vimos que uma matriz $W$ pode esticar, comprimir, girar, espelhar, projetar e deformar o espaço. Ficou uma pergunta em aberto: quanto essa transformação alterou o espaço? Para matrizes quadradas, um único número responde às duas perguntas da sombra e do mapa. Esse número é o determinante, $\det(W)$.
Ao final, você vai conseguir calcular o determinante de uma matriz 2 × 2 e dizer, só pelo valor, se ela expande ou comprime áreas, se inverte a orientação do espaço e se destrói informação; ligar $\det(A) = 0$ a colunas dependentes e à falta de inversa; conferir tudo em NumPy sem cair na armadilha do arredondamento; e reconhecer onde o determinante reaparece em IA, das gaussianas multivariadas aos normalizing flows.
1. O determinante não é apenas uma fórmula
Na aula anterior, a matriz era uma regra que leva cada vetor do plano a outro vetor:
$$ x \rightarrow Wx $$
Ela pode esticar, comprimir, rotacionar, refletir, projetar e deformar. O determinante é a resposta numérica a uma pergunta específica sobre essa regra:
Quanto essa transformação alterou o espaço?
Para matrizes quadradas (mesmo número de linhas e colunas, isto é, que levam o espaço nele mesmo), esse número existe e se escreve:
$$ \boxed{\det(W)} $$
A ideia central de todo o artigo cabe numa linha:
$$ \boxed{\begin{array}{c}|\det(W)|=\text{fator de mudança}\\\text{de área ou volume}\end{array}} $$
Aqui $|\cdot|$ é o valor absoluto. Além do tamanho, o determinante carrega mais duas informações: o sinal, que diz se a transformação espelhou o espaço, e o zero, que diz se alguma direção foi colapsada (Strang, 2016; Goodfellow, Bengio & Courville, 2016). As próximas seções constroem cada uma delas com exemplos que dá para conferir de cabeça.
2. Identidade e a fórmula ad − bc
O ponto de partida é a matriz que não faz nada:
$$ I=\begin{bmatrix}1&0\\0&1\end{bmatrix} $$
A identidade não altera o espaço, então um quadrado de área 1 continua com área 1. O determinante dela vale:
$$ \boxed{\det(I)=1} $$
Geometricamente: a transformação preservou a área. Esse 1 é a referência para tudo o que vem depois.
Para uma matriz 2 × 2 qualquer,
$$ A=\begin{bmatrix}a&b\\c&d\end{bmatrix} $$
o determinante é:
$$ \boxed{\det(A)=ad-bc} $$
onde $a$ e $d$ são as entradas da diagonal principal e $b$ e $c$ as da outra diagonal: multiplica-se a diagonal principal e subtrai-se o produto da secundária. Um exemplo:
$$ A=\begin{bmatrix}2&0\\0&3\end{bmatrix} $$
$$ \det(A)=2\cdot3-0\cdot0=6 $$
A conta é mecânica. O que interessa é o que esse 6 significa.
3. Determinante como mudança de área
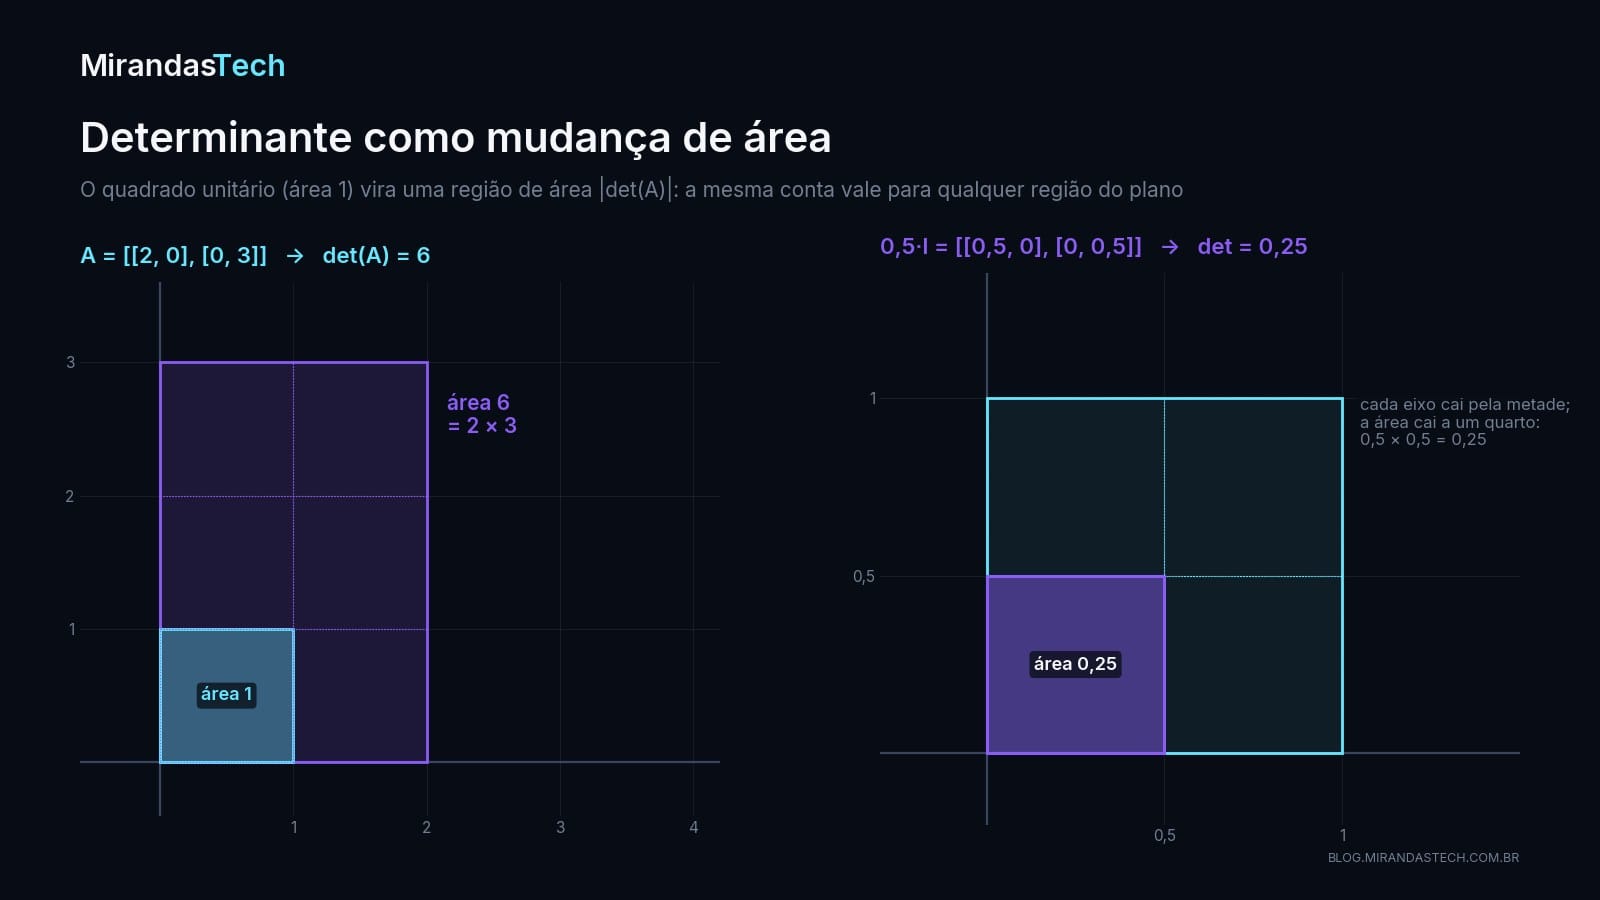
A matriz $A$ acima multiplica a componente horizontal por 2 e a vertical por 3. Um quadrado unitário, de área 1, vira um retângulo de largura 2 e altura 3:
$$ \text{área nova}=2\times3=6 $$
Portanto:
$$ \boxed{|\det(A)|=6} $$
E isso não vale só para o quadrado. Se uma região qualquer do plano tem área $S$, depois da transformação ela passa a ter área $S'$ dada por:
$$ \boxed{S'=|\det(A)|\,S} $$
O motivo é que qualquer região pode ser aproximada por quadradinhos, e uma transformação linear trata todos os quadradinhos do mesmo jeito: cada um tem a área multiplicada pelo mesmo fator (Deisenroth, Faisal & Ong, 2020).
Expandir ou comprimir
O valor absoluto do determinante diz o sentido da mudança. Se
$$ |\det(A)|>1 $$
a transformação expande área ou volume. Se
$$ 0<|\det(A)|<1 $$
ela comprime. Por exemplo:
$$ A=\begin{bmatrix}0{,}5&0\\0&0{,}5\end{bmatrix} $$
tem:
$$ \det(A)=0{,}25 $$
Cada eixo foi reduzido pela metade, mas a área foi reduzida a um quarto, como mostra o painel da direita na figura: quatro quadradinhos de lado 0,5 cabem no quadrado original.
Escalas em dimensões diferentes se multiplicam para determinar a mudança de volume.
4. Rotação preserva, reflexão inverte a orientação
Considere a rotação de 90° que vimos na Aula 06:
$$ R=\begin{bmatrix}0&-1\\1&0\end{bmatrix} $$
Pela fórmula, $\det(R)=0\cdot0-(-1)\cdot1$:
$$ \det(R)=1 $$
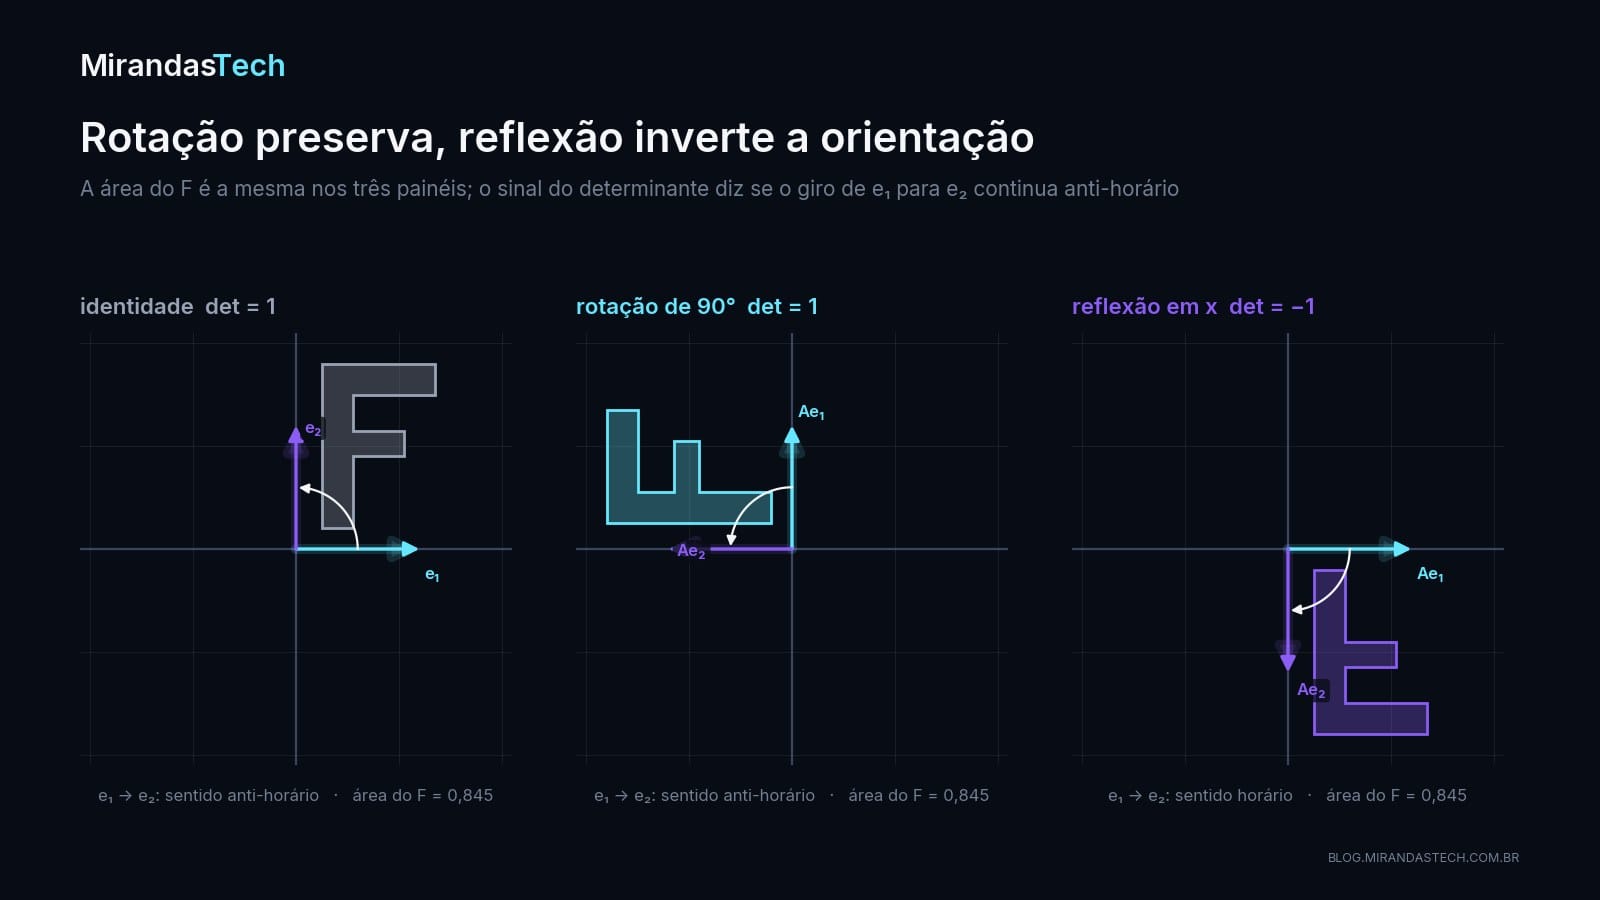
Faz sentido: uma rotação muda a direção dos vetores, mas preserva comprimentos, ângulos e áreas. Isso vale para qualquer ângulo. A matriz de rotação geral em 2D é:
$$ R(\theta)=\begin{bmatrix}\cos\theta&-\sin\theta\\\sin\theta&\cos\theta\end{bmatrix} $$
onde $\theta$ é o ângulo de giro no sentido anti-horário. Seu determinante é:
$$ \cos^2\theta+\sin^2\theta=1 $$
Logo:
$$ \boxed{\det(R)=1} $$
para qualquer rotação 2D.
Reflexão e determinante negativo
Agora a reflexão em relação ao eixo horizontal:
$$ A=\begin{bmatrix}1&0\\0&-1\end{bmatrix} $$
$$ \det(A)=-1 $$
A magnitude
$$ |\det(A)|=1 $$
mostra que a área foi preservada. O sinal negativo indica que a orientação do espaço foi invertida. Na figura, isso aparece de dois jeitos. O F espelhado não pode ser obtido do original por nenhuma rotação, por mais que você o gire no plano. E a ordem dos vetores da base mudou: no original, ir de $e_1 = (1, 0)$ para $e_2 = (0, 1)$ pelo menor caminho é girar no sentido anti-horário; depois da reflexão, o mesmo giro passa a ser horário. É o que acontece quando você olha a própria mão no espelho: a direita vira uma esquerda.
Ficam, então, duas leituras separadas do mesmo número:
$$ \boxed{|\det(A)|=\text{mudança de área/volume}} $$
$$ \boxed{\operatorname{sign}(\det(A))=\text{orientação}} $$
onde $\operatorname{sign}$ é a função sinal: $+1$ para positivo (orientação preservada), $-1$ para negativo (orientação invertida).
5. Determinante zero: o plano vira uma linha
Este é o caso mais importante do artigo. Considere:
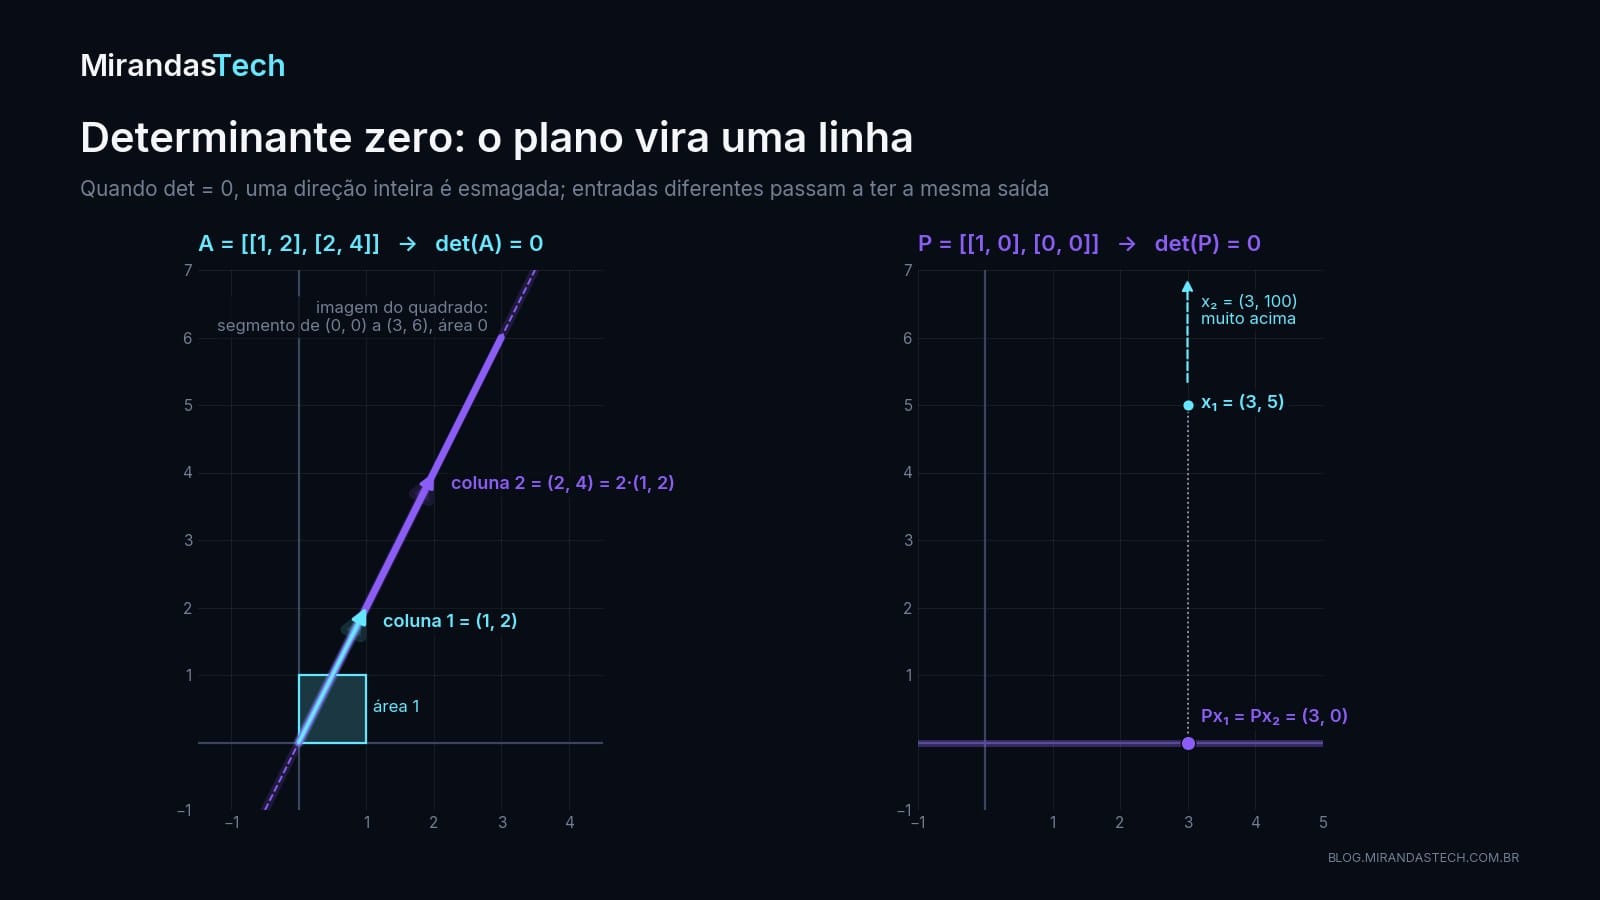
$$ A=\begin{bmatrix}1&2\\2&4\end{bmatrix} $$
$$ \det(A)=1\cdot4-2\cdot2=0 $$
Olhe as colunas:
$$ \begin{bmatrix}1\\2\end{bmatrix} \quad\text{e}\quad \begin{bmatrix}2\\4\end{bmatrix} $$
A segunda é o dobro da primeira:
$$ \begin{bmatrix}2\\4\end{bmatrix}=2\begin{bmatrix}1\\2\end{bmatrix} $$
As duas colunas apontam para a mesma direção. Como as colunas dizem para onde vão os vetores da base (Aula 06), o quadrado unitário vai parar inteiro sobre uma reta: em vez de formar uma região 2D, forma apenas um segmento, de $(0, 0)$ a $(3, 6)$, com área zero.
Quando o determinante é zero, pelo menos uma dimensão foi colapsada.
Projeção: o exemplo que já conhecemos
Na Aula 06 apareceu a projeção sobre o eixo horizontal:
$$ P=\begin{bmatrix}1&0\\0&0\end{bmatrix} $$
$$ \det(P)=0 $$
A transformação
$$ (x,y)\rightarrow(x,0) $$
elimina a componente vertical. Considere dois vetores bem diferentes:
$$ x_1=\begin{bmatrix}3\\5\end{bmatrix} \quad\text{e}\quad x_2=\begin{bmatrix}3\\100\end{bmatrix} $$
Então:
$$ Px_1=Px_2=\begin{bmatrix}3\\0\end{bmatrix} $$
Duas entradas diferentes produziram a mesma saída. A informação sobre a segunda componente foi perdida. É a sombra da caneca da abertura, em duas dimensões em vez de três.
6. Determinante e matriz inversa
Se $y = Ax$, a pergunta natural é se dá para recuperar $x$ a partir de $y$. Quando a transformação não perde informação, existe uma matriz inversa
$$ A^{-1} $$
que desfaz o que $A$ fez:
$$ A^{-1}Ax=x $$
Mas quando
$$ \det(A)=0 $$
a transformação destruiu informação e não pode ser completamente desfeita: se $Px_1 = Px_2$, nenhuma matriz consegue, olhando só para $(3, 0)$, saber se a entrada era $x_1$ ou $x_2$. Para matrizes quadradas, vale a equivalência (Strang, 2016; Deisenroth, Faisal & Ong, 2020):
$$ \boxed{A\text{ é invertível}\iff\det(A)\neq0} $$
O símbolo $\iff$ se lê "se e somente se": as duas afirmações são verdadeiras juntas ou falsas juntas.
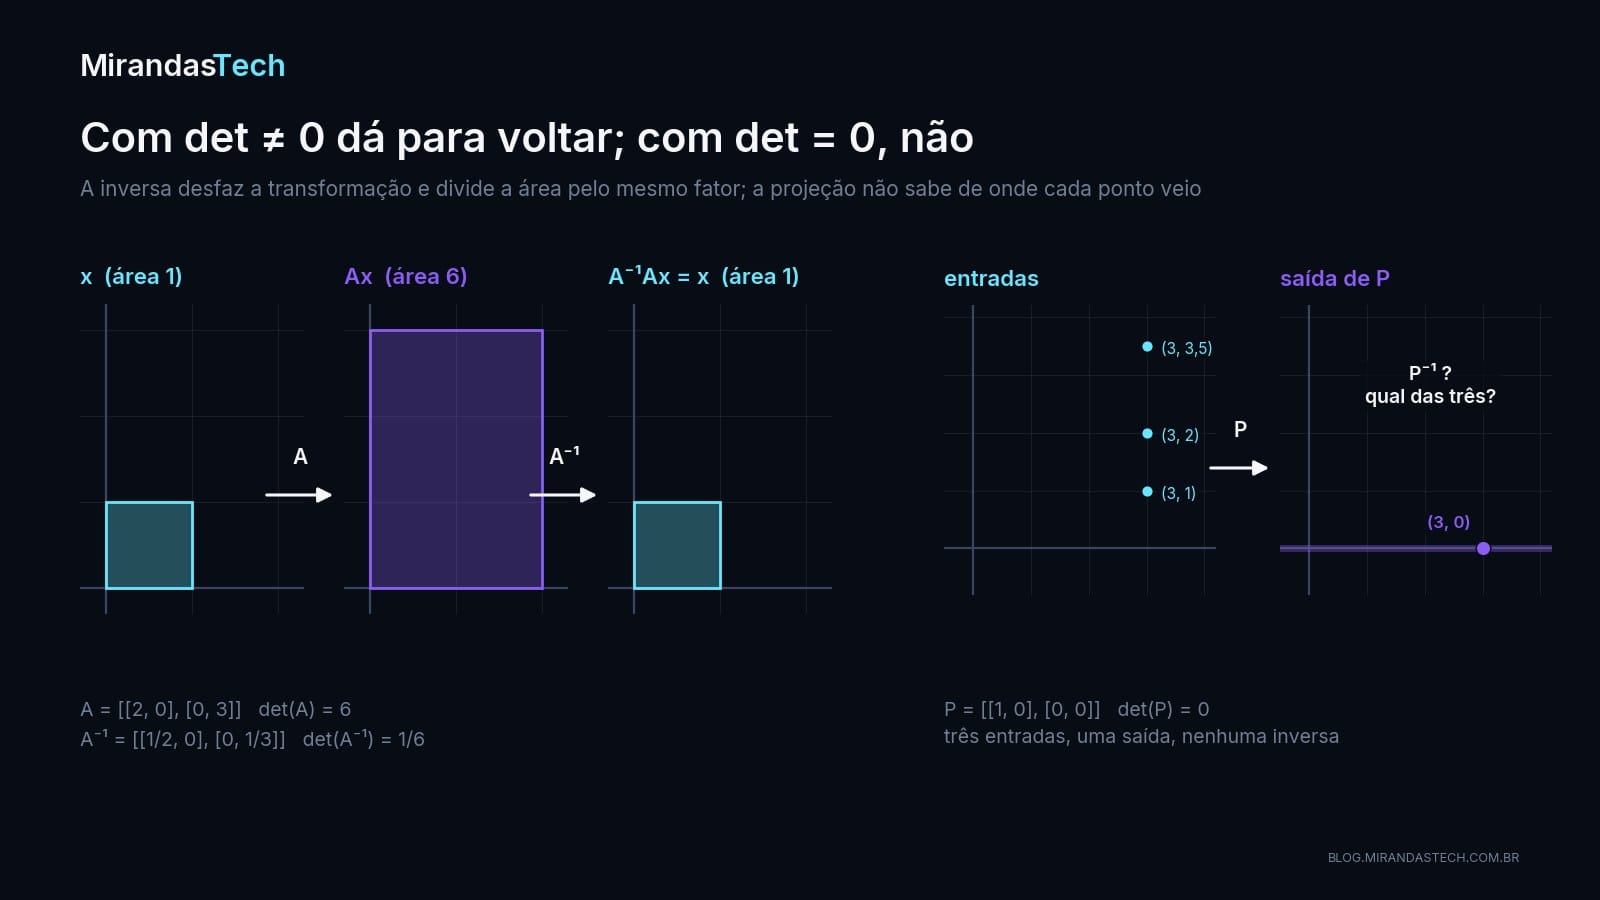
Um exemplo invertível
Para
$$ A=\begin{bmatrix}2&0\\0&3\end{bmatrix} $$
$$ \det(A)=6\neq0 $$
e a inversa existe:
$$ A^{-1}=\begin{bmatrix}1/2&0\\0&1/3\end{bmatrix} $$
A transformação pode ser desfeita: $A$ multiplica o eixo $x$ por 2 e o eixo $y$ por 3; $A^{-1}$ divide pelos mesmos fatores. A próxima aula da série é inteira sobre $A^{-1}$.
7. As colunas formam um paralelogramo
Chame de $a$ e $b$ as duas colunas de uma matriz 2 × 2:
$$ A=\begin{bmatrix}|&|\\a&b\\|&|\end{bmatrix} $$
As barras verticais indicam que $a$ e $b$ estão dispostas em coluna. Os dois vetores formam um paralelogramo, e a área dele é:
$$ \boxed{|\det(A)|} $$
Isso junta duas ideias. Na Aula 06, as colunas de uma matriz mostravam onde os vetores da base foram parar. O quadrado unitário é o paralelogramo formado por $e_1$ e $e_2$; depois da transformação, ele vira o paralelogramo formado por $a$ e $b$. Então:
O determinante mede a área formada pelos vetores da base transformada.
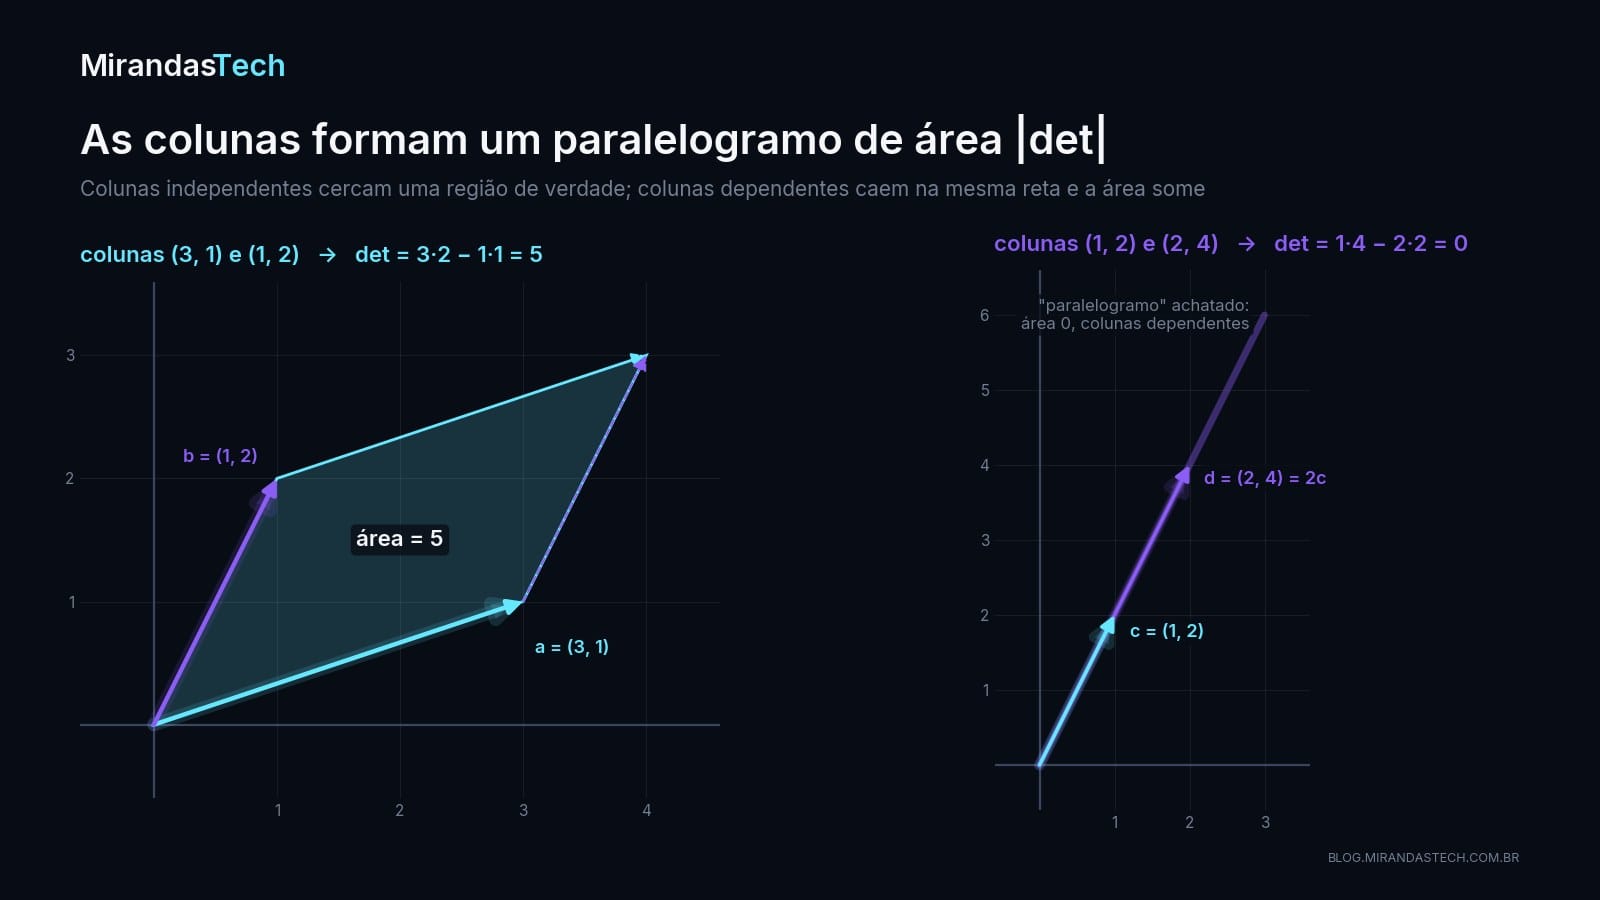
Na figura, as colunas $(3, 1)$ e $(1, 2)$ cercam um paralelogramo de área $3 \cdot 2 - 1 \cdot 1 = 5$.
Determinante e independência linear
O painel da direita mostra o outro lado da mesma moeda. Se
$$ \det(A)\neq0 $$
as colunas de uma matriz quadrada são linearmente independentes: nenhuma delas pode ser escrita como combinação das outras, e juntas elas cercam uma região de verdade. Se
$$ \det(A)=0 $$
elas são linearmente dependentes e o volume formado por elas é zero (Deisenroth, Faisal & Ong, 2020). É o caso de $(1, 2)$ e $(2, 4)$: uma é múltipla da outra, e o "paralelogramo" é só um segmento.
8. Três dimensões e além
Nada disso é exclusivo do plano. Para
$$ A\in\mathbb{R}^{3\times3} $$
(uma matriz 3 × 3 de números reais), $|\det(A)|$ mede o fator de alteração do volume. Exemplo:
$$ A=\begin{bmatrix}2&0&0\\0&2&0\\0&0&2\end{bmatrix} $$
Um cubo 1 × 1 × 1 vira um cubo 2 × 2 × 2:
$$ \det(A)=2^3=8 $$
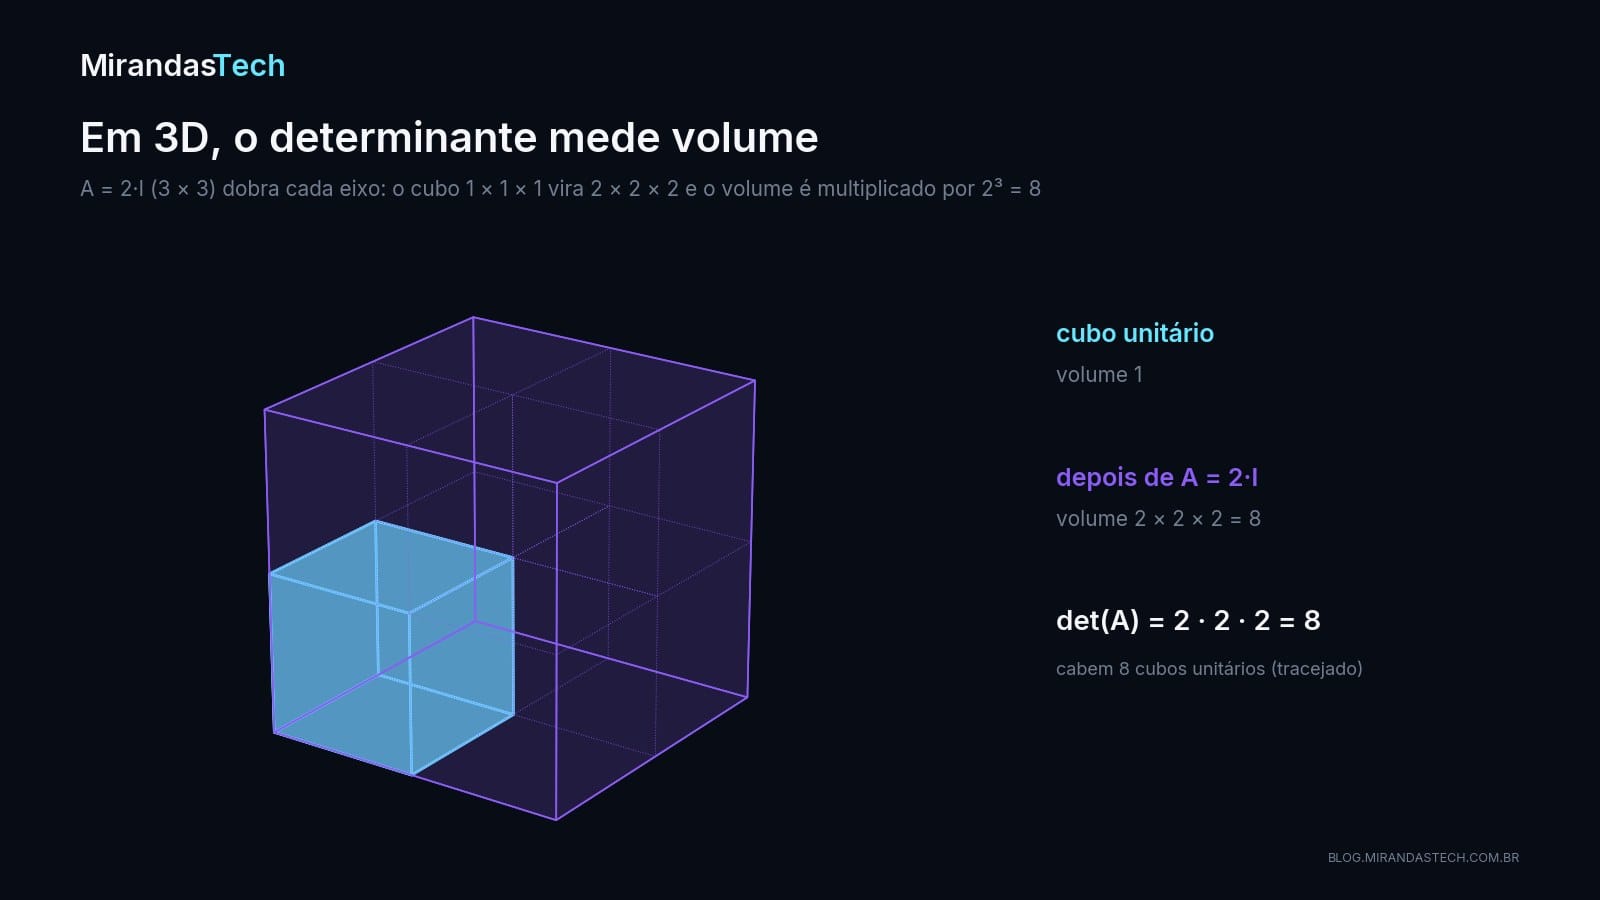
O volume foi multiplicado por oito, embora cada aresta só tenha dobrado. Em $n$ dimensões, o determinante mede o fator de escala do hipervolume, o análogo do volume num espaço com $n$ eixos (Deisenroth, Faisal & Ong, 2020). É assim que o conceito chega às matrizes 768 × 768 que agem sobre embeddings de 768 dimensões: ninguém desenha um hipercubo, mas a conta continua valendo.
9. Composição: os determinantes se multiplicam
Uma propriedade fundamental é:
$$ \boxed{\det(AB)=\det(A)\det(B)} $$
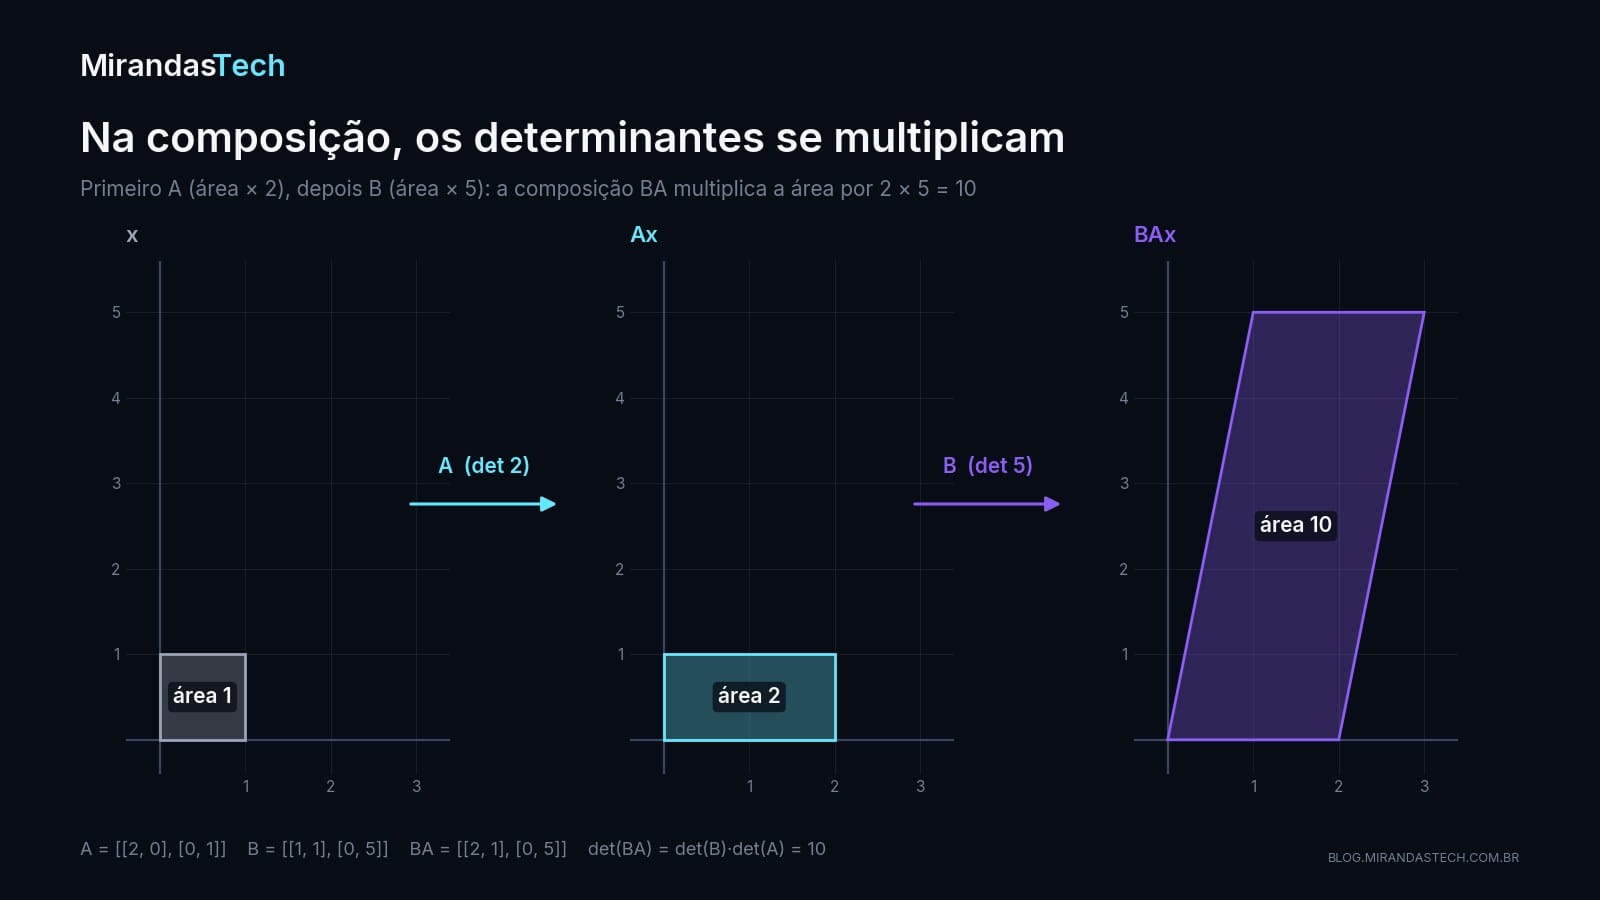
Aplicar uma transformação depois da outra é multiplicar as matrizes (Aula 06), e o efeito sobre a área é multiplicar os fatores. Se uma transformação multiplica áreas por 2 e outra por 3, a composição multiplica por 6. Exemplo:
$$ \det(A)=2,\quad\det(B)=5 $$
então:
$$ \det(BA)=10 $$
Na figura, $A = \begin{bmatrix}2&0\\0&1\end{bmatrix}$ e $B = \begin{bmatrix}1&1\\0&5\end{bmatrix}$, e $BA = \begin{bmatrix}2&1\\0&5\end{bmatrix}$, cujo determinante é $2 \cdot 5 - 1 \cdot 0 = 10$. Repare que, ao contrário do produto de matrizes, o produto de determinantes não depende da ordem: $\det(AB) = \det(BA)$, mesmo quando $AB \neq BA$.
Determinante da inversa
A regra do produto dá, de graça, o determinante da inversa. Como
$$ AA^{-1}=I $$
e $\det(I) = 1$, então:
$$ \det(A)\det(A^{-1})=1 $$
Logo:
$$ \boxed{\det(A^{-1})=\frac{1}{\det(A)}} $$
Se uma transformação multiplica áreas por 4, sua inversa precisa dividi-las por 4. E a fórmula mostra de outro ângulo por que $\det(A) = 0$ impede a inversa: não existe número que, multiplicado por zero, dê 1.
10. O que o determinante não vê
Para matrizes diagonais, a conta é a mais simples possível:
$$ D=\begin{bmatrix}d_1&0&0\\0&d_2&0\\0&0&d_3\end{bmatrix} $$
$$ \boxed{\det(D)=d_1d_2d_3} $$
O determinante é o produto dos fatores de escala de cada eixo, que é o que a seção 3 já sugeria. O mesmo vale para matrizes triangulares (zeros de um lado da diagonal): o determinante é o produto da diagonal (Deisenroth, Faisal & Ong, 2020). Essa regra vai reaparecer na seção 12, num lugar inesperado.
Já um cisalhamento como
$$ S=\begin{bmatrix}1&1\\0&1\end{bmatrix} $$
tem
$$ \det(S)=1 $$
O quadrado vira um paralelogramo sem alterar a área: a base continua 1 e a altura continua 1. A figura põe lado a lado três transformações com determinante 1 (uma rotação, esse cisalhamento e uma matriz que estica $x$ pelo dobro e achata $y$ pela metade) e o resultado é visualmente muito diferente.
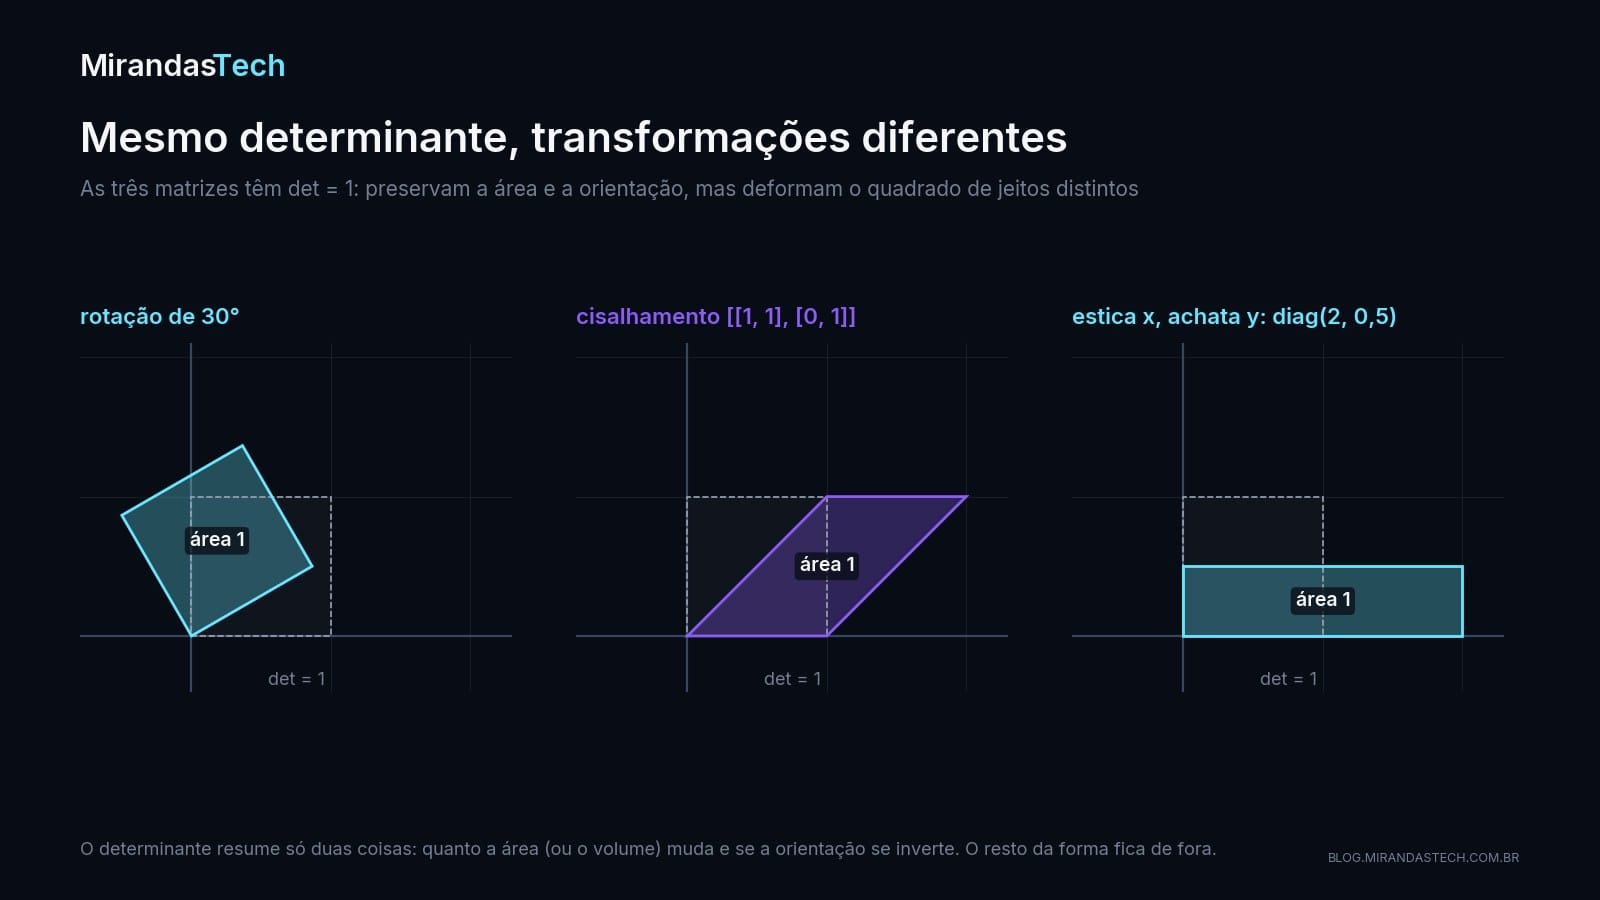
Isso mostra que o determinante não descreve toda a transformação. Ele resume especificamente mudança de volume e orientação. Para saber em que direções o espaço estica e em quais encolhe, vão ser precisos autovalores e a decomposição em valores singulares, assuntos de aulas futuras da série.
11. Na prática com NumPy
Em código, o determinante é uma chamada:
import numpy as np

A = np.array([
    [2.0, 0.0],
    [0.0, 3.0]
])

print(np.linalg.det(A))
6.0
Para a matriz singular da seção 5 (singular é o nome de uma matriz quadrada com determinante zero, sem inversa):
A = np.array([
    [1.0, 2.0],
    [2.0, 4.0]
])

print(np.linalg.det(A))

if np.isclose(np.linalg.det(A), 0):
    print("Matriz singular")
0.0
Matriz singular
Aqui o resultado saiu zero exato, mas não conte com isso. O NumPy calcula o determinante por uma fatoração (a decomposição LU, pela rotina getrf do LAPACK), com aritmética de ponto flutuante, e os arredondamentos podem deixar um resíduo minúsculo onde a matemática diz zero (NumPy, 2026). Por isso a aula recomenda comparar com np.isclose em vez de == 0. Antes de ir além, o mini laboratório da aula: tente prever os cinco resultados antes de rodar.
import numpy as np

matrizes = {
    "identidade": np.array([
        [1.0, 0.0],
        [0.0, 1.0]
    ]),
    "escala": np.array([
        [2.0, 0.0],
        [0.0, 3.0]
    ]),
    "rotacao_90": np.array([
        [0.0, -1.0],
        [1.0,  0.0]
    ]),
    "reflexao": np.array([
        [1.0,  0.0],
        [0.0, -1.0]
    ]),
    "projecao": np.array([
        [1.0, 0.0],
        [0.0, 0.0]
    ])
}

for nome, matriz in matrizes.items():
    print(nome, np.linalg.det(matriz))
identidade 1.0
escala 6.0
rotacao_90 1.0
reflexao -1.0
projecao 0.0
Identidade preserva (1), escala expande (6), rotação preserva área e orientação (1), reflexão preserva área e inverte a orientação (−1), projeção colapsa uma dimensão (0). As cinco leituras do artigo em cinco linhas.
Duas armadilhas numéricas
O exemplo abaixo não está na aula; foi executado com NumPy 2.2.3 para mostrar os dois lados do problema do ponto flutuante.
import numpy as np

M = np.array([[1.0, 2.0, 3.0],
              [4.0, 5.0, 6.0],
              [7.0, 8.0, 9.0]])
print(np.linalg.det(M))                # zero na matemática; não aqui
print(np.linalg.matrix_rank(M))        # 2: uma dimensão colapsou

A = 0.1 * np.eye(100)                  # só encolhe cada eixo para 10%
print(np.linalg.det(A))                # minúsculo...
print(np.isclose(np.linalg.det(A), 0)) # ...e o teste acusa "singular"
print(np.linalg.matrix_rank(A))        # 100: nenhuma dimensão perdida
print(np.linalg.cond(A))               # 1.0: a matriz mais bem-comportada possível
print(np.linalg.slogdet(A))            # sinal e log|det| sem underflow
6.66133814775094e-16
2
1.00000000000033e-100
True
100
1.0
SlogdetResult(sign=np.float64(1.0), logabsdet=np.float64(-230.25850929940424))
Na matriz $M$, a terceira linha é a segunda mais a diferença entre a segunda e a primeira, então $\det(M) = 0$; o NumPy devolve $6{,}7 \times 10^{-16}$, o resíduo de arredondamento que a aula anunciou. Na matriz $A = 0{,}1\,I$ de 100 × 100 acontece o contrário: o determinante é $0{,}1^{100} = 10^{-100}$, tão pequeno que np.isclose o confunde com zero, mas a matriz é perfeitamente invertível. Ela só encolhe cada um dos 100 eixos para 10%, e o volume despenca porque 100 fatores de 0,1 se multiplicam. O posto (matrix_rank, o número de direções que sobrevivem) é 100, e o número de condição (cond, que mede o quanto a matriz amplifica erros) é 1, o melhor valor possível.
A lição prática: o determinante responde bem à pergunta geométrica "quanto o volume mudou?", mas é um termômetro ruim para "esta matriz está perto de ser singular?", porque o valor dele depende da escala das entradas e da dimensão; a matriz $0{,}1\,I$ de 100 × 100 é justamente o exemplo que Moler (2004) usa para mostrar isso. Para essa segunda pergunta, use o posto ou o número de condição. E quando precisar do determinante de matrizes grandes, prefira np.linalg.slogdet, que devolve o sinal e o logaritmo de $|\det|$ separados e, por isso, é mais robusta contra underflow e overflow (NumPy, 2026): $\log|\det(A)| = 100 \cdot \log 0{,}1 \approx -230{,}26$, um número comum, onde o determinante em si seria $10^{-100}$.
12. Onde isso aparece em IA
Você provavelmente não vai calcular determinantes à mão ao treinar redes neurais. O conceito, porém, sustenta ideias que aparecem o tempo todo: dimensionalidade, perda de informação, invertibilidade, independência linear, mudança de volume e transformações. E há lugares onde ele aparece explicitamente.
Gaussianas multivariadas e covariância
A distribuição normal em $n$ dimensões, a que aparece em inicialização de pesos, em modelos generativos e em estatística multivariada, tem densidade (Deisenroth, Faisal & Ong, 2020):
$$ \begin{aligned}p(x)=\;&\frac{1}{\sqrt{(2\pi)^n\det(\Sigma)}}\\&\times\exp\!\left(-\tfrac{1}{2}(x-\mu)^T\Sigma^{-1}(x-\mu)\right)\end{aligned} $$
onde $\mu$ é o vetor de médias, $\Sigma$ é a matriz de covariância ($n \times n$) e $\Sigma^{-1}$ sua inversa. O $\det(\Sigma)$ no denominador é exatamente o fator de volume deste artigo: quanto mais espalhada a nuvem de dados, maior o volume que ela ocupa e mais a densidade precisa ser diluída para que a probabilidade total continue igual a 1. E se $\det(\Sigma) = 0$, a nuvem está achatada numa dimensão menor, a inversa não existe e a fórmula quebra; é o sinal, nos dados, de variáveis redundantes (uma é combinação linear das outras) ou constantes.
Normalizing flows e o log|det J|
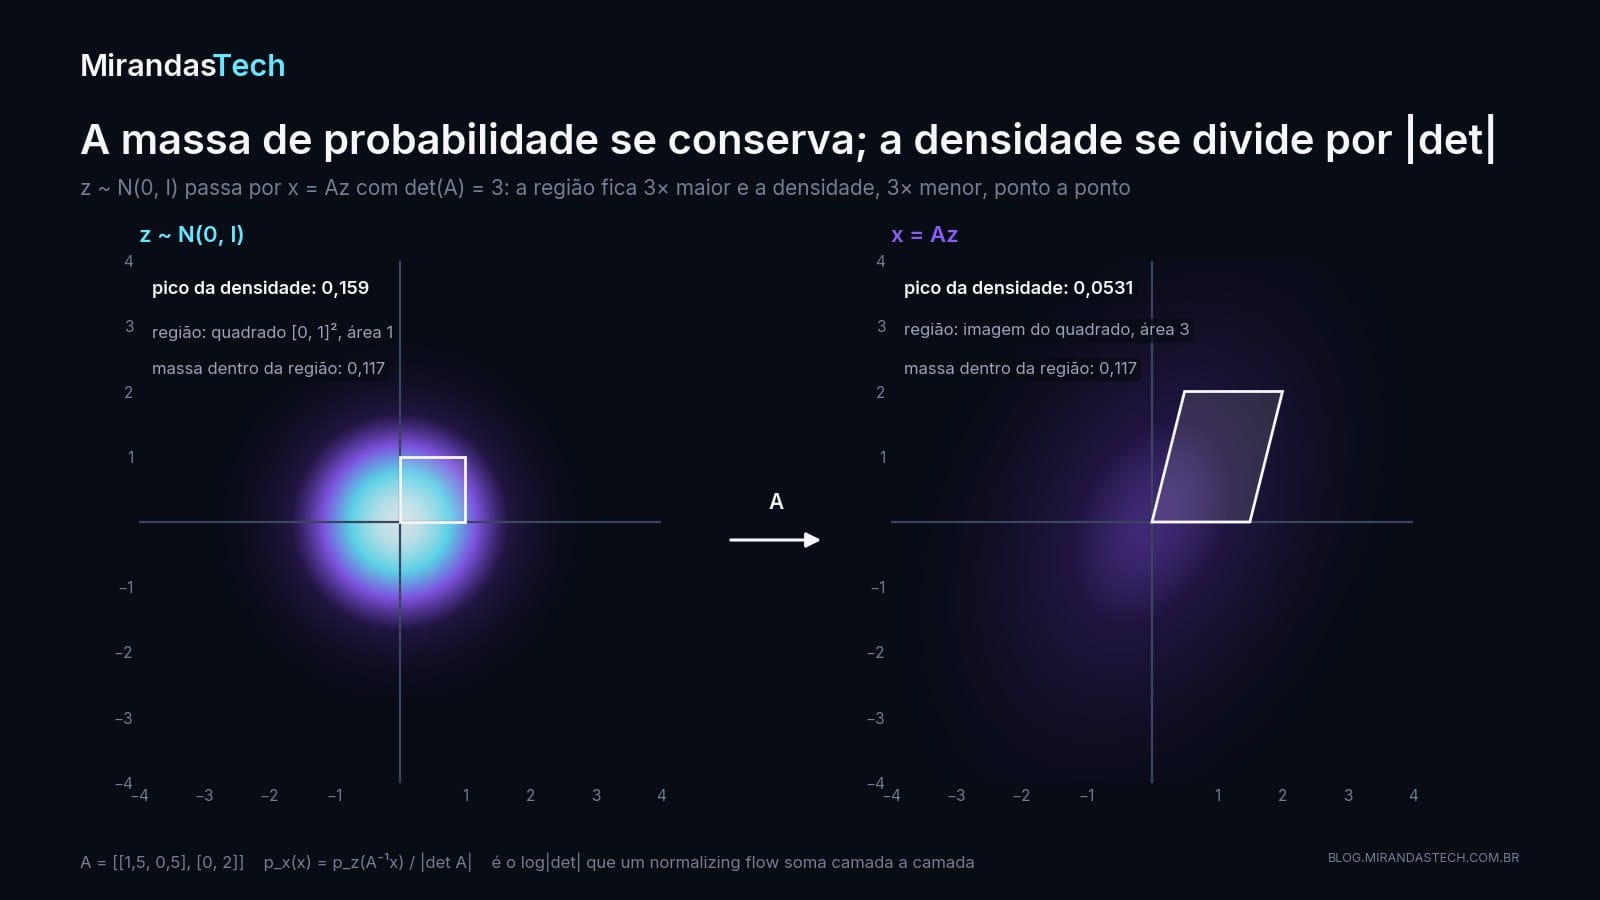
A figura mostra o caso linear de uma ideia central em modelos generativos. Se $z$ tem uma densidade conhecida $p_z$ e $x = Az$, então:
$$ p_x(x)=\frac{p_z(A^{-1}x)}{|\det(A)|} $$
A massa de probabilidade é conservada; como a região ficou $|\det(A)|$ vezes maior, a densidade precisa ficar $|\det(A)|$ vezes menor. Na figura, com $\det(A) = 3$, o pico cai de $1/(2\pi) \approx 0{,}159$ para $0{,}0531$, e a probabilidade dentro da região é 0,117 nos dois painéis.
Os normalizing flows generalizam isso: empilham transformações invertíveis e não lineares $f$ que levam uma gaussiana simples a uma distribuição complicada, como a de imagens. Para uma função não linear, o papel de $A$ é feito localmente pela matriz Jacobiana $J$, e a verossimilhança de cada exemplo $x = f(z)$ fica (Rezende & Mohamed, 2015; Papamakarios et al., 2021):
$$ \log p_x(x)=\log p_z(z)-\log\left|\det J_f(z)\right| $$
O termo $\log|\det(J)|$ é o custo de volume de cada camada, somado ao longo da pilha. Calcular um determinante genérico de $n \times n$ custa da ordem de $n^3$ operações, caro demais para dimensões de imagem (Rezende & Mohamed, 2015; Papamakarios et al., 2021), e aqui volta a regra da seção 10: arquiteturas como a Real NVP desenham cada camada para que o Jacobiano seja triangular, e aí o determinante é só o produto da diagonal (Dinh, Sohl-Dickstein & Bengio, 2017). A exigência de invertibilidade, por sua vez, é a da seção 6: cada camada precisa ter Jacobiano com determinante diferente de zero em todo ponto, condição necessária (mas, no caso não linear, não suficiente) para que ela seja invertível.
Preview: o Jacobiano
Mais adiante, na parte de cálculo da série, vão aparecer funções
$$ f:\mathbb{R}^n\rightarrow\mathbb{R}^n $$
cuja derivada pode ser representada por uma matriz Jacobiana $J$, a matriz das derivadas parciais de cada saída em relação a cada entrada. Então
$$ |\det(J)| $$
indica como pequenos volumes locais são expandidos ou comprimidos pela função, ponto a ponto, do mesmo jeito que $|\det(A)|$ faz para toda a transformação linear. É a fórmula de mudança de variáveis das integrais múltiplas, e uma ponte importante entre Álgebra Linear e Cálculo (Deisenroth, Faisal & Ong, 2020).
Perda de informação em IA
Se uma transformação quadrada $W$ tem
$$ \det(W)=0 $$
alguma informação foi colapsada: entradas diferentes podem gerar a mesma saída, como $x_1$ e $x_2$ na seção 5. Uma observação importante: a maioria das camadas de rede não é quadrada. Uma camada que leva 768 dimensões a 512 nem tem determinante, e perde informação por construção, porque não há como caber 768 direções independentes em 512. Para matrizes retangulares a pergunta certa é o posto, tema que a série retoma adiante.
Isso não significa que toda perda de dimensionalidade seja ruim. Em Machine Learning, muitas vezes queremos reduzir dimensionalidade de forma controlada, para remover redundância ou ruído; é o que fazem o PCA e a SVD, escolhendo quais direções descartar a partir da variância dos dados (Jolliffe & Cadima, 2016). A diferença importante é entre compressão planejada e perda acidental de informação.
13. Exercícios
1. Calcule:
$$ A=\begin{bmatrix}2&0\\0&4\end{bmatrix},\qquad\det(A)=? $$
Depois explique geometricamente o resultado.
2. Considere:
$$ A=\begin{bmatrix}1&0\\0&-1\end{bmatrix} $$
Calcule o determinante e explique por que ele é negativo.
3. Calcule o determinante de:
$$ A=\begin{bmatrix}1&2\\2&4\end{bmatrix} $$
Explique o resultado em termos de área, de dimensionalidade e de invertibilidade.
4. Uma transformação tem:
$$ \det(A)=0{,}2 $$
Se uma região original tem área 50, qual será sua área depois da transformação?
5. Se
$$ \det(A)=3,\qquad\det(B)=4 $$
quanto vale $\det(BA)$?
6. Uma matriz de rotação tem:
$$ \det(R)=1 $$
Explique geometricamente por que isso faz sentido.
7. Questão principal. Explique com suas palavras por que
$$ \boxed{\det(A)=0} $$
significa perda de informação. Relacione sua resposta com a ideia de transformar um plano inteiro em uma linha.
O que guardar
O mapa do artigo cabe numa figura: uma matriz transforma o espaço, o determinante resume essa transformação num número, e cada faixa de valores tem uma leitura.
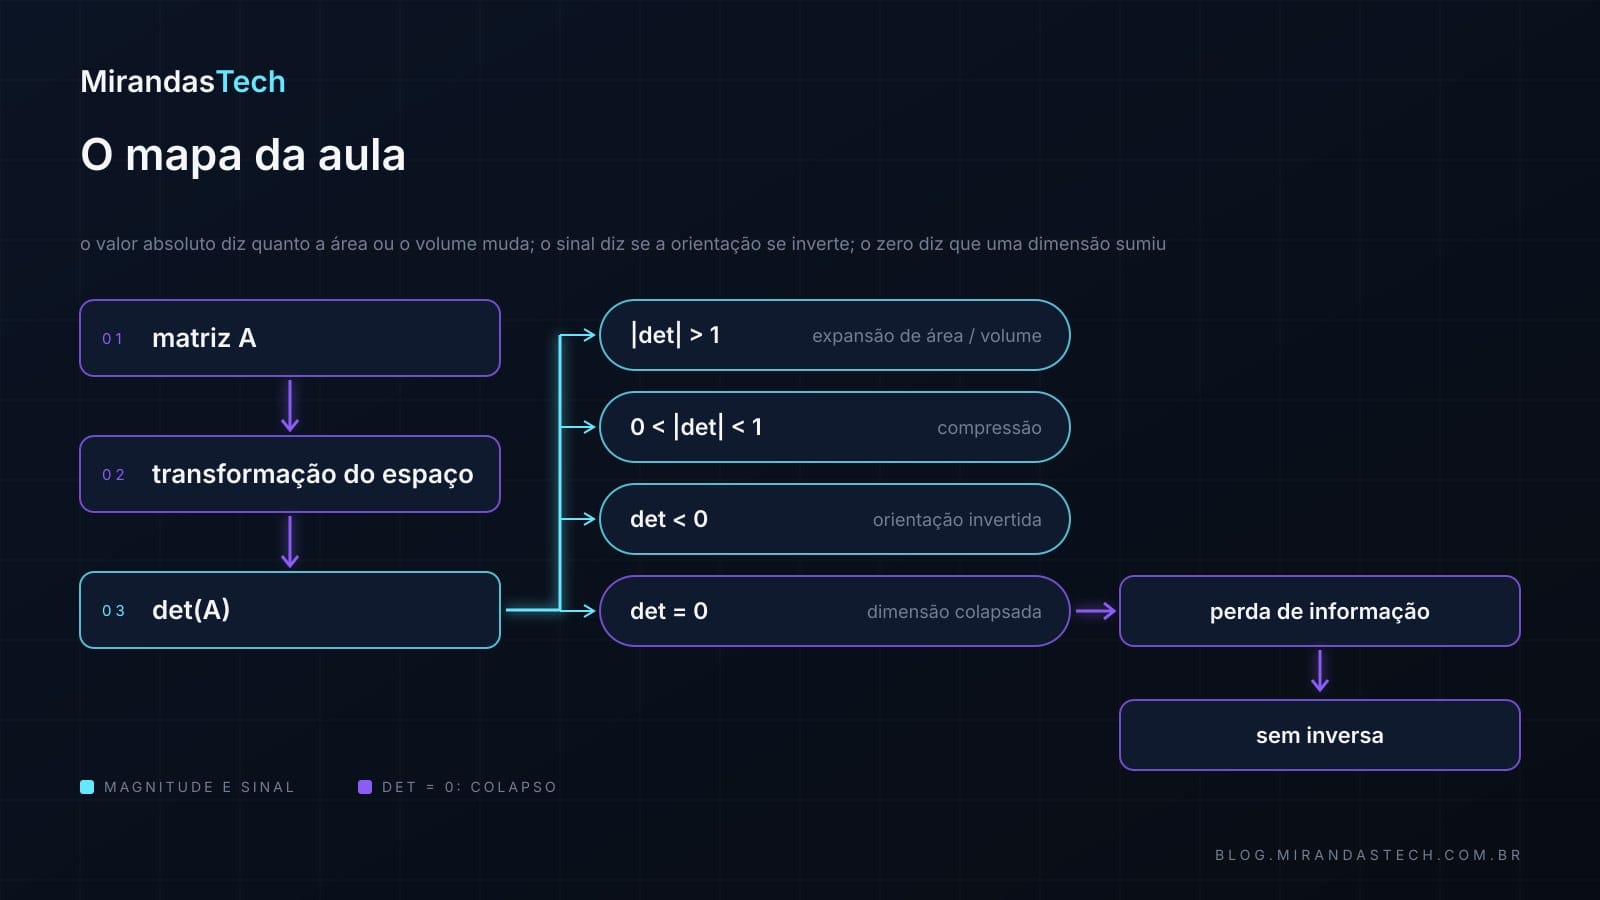
Quando olhar para $\det(A)$, não pense apenas em $ad-bc$. Pense:
$$ \boxed{\begin{array}{c}\det(A)=\text{como a transformação}\\\text{altera volume e orientação}\end{array}} $$
- $|\det(A)|>1$: expansão de volume.
- $0<|\det(A)|<1$: compressão.
- $\det(A)<0$: orientação invertida.
- $\det(A)=0$: alguma dimensão foi colapsada, informação foi perdida, a transformação não pode ser completamente desfeita e a matriz não tem inversa.
Com esta aula, a sequência da série fica assim:
- Aula 01 — vetores, matrizes e tensores.
- Aula 02 — norma e geometria vetorial.
- Aula 03 — produto escalar.
- Aula 04 — similaridade de cosseno.
- Aula 05 — $Wx+b$.
- Aula 06 — escala, rotação, reflexão e projeção.
- Aula 07 — $\det(W)$, mudança de volume e perda de informação.
Na Aula 08, Matriz inversa: desfazendo transformações, o assunto é $A^{-1}$: o que significa inverter uma transformação, por que $A^{-1}A=I$, como resolver sistemas lineares, quando uma matriz não tem inversa, a relação entre inversa, determinante e independência linear, e por que, em computação numérica, normalmente evitamos calcular a inversa explicitamente quando queremos resolver $Ax=b$.
Referências
- Strang, Gilbert. Introduction to Linear Algebra. 5. ed. Wellesley-Cambridge Press, 2016. math.mit.edu/~gs/linearalgebra/ila5
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning. MIT Press, 2016. www.deeplearningbook.org/contents/linear_algebra.html
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. doi.org/10.1017/9781108679930
- NumPy. numpy.linalg.det, numpy.linalg.slogdet e numpy.linalg.matrix_rank. Documentação oficial do NumPy, v2.5, 2026. Acesso em 25 set. 2026. numpy.org/doc/stable/reference/generated/numpy.linalg.det.html; numpy.org/doc/stable/reference/generated/numpy.linalg.slogdet.html; numpy.org/doc/stable/reference/generated/numpy.linalg.matrix_rank.html
- Moler, Cleve B. Numerical Computing with MATLAB. SIAM, 2004. doi.org/10.1137/1.9780898717952
- Rezende, Danilo Jimenez; Mohamed, Shakir. Variational Inference with Normalizing Flows. Proceedings of the 32nd International Conference on Machine Learning (ICML), PMLR v. 37, p. 1530–1538, 2015. proceedings.mlr.press/v37/rezende15.html (preprint: arxiv.org/abs/1505.05770)
- Papamakarios, George; Nalisnick, Eric; Rezende, Danilo Jimenez et al. Normalizing Flows for Probabilistic Modeling and Inference. Journal of Machine Learning Research, v. 22, n. 57, p. 1–64, 2021. jmlr.org/papers/v22/19-1028.html (preprint: arxiv.org/abs/1912.02762)
- Dinh, Laurent; Sohl-Dickstein, Jascha; Bengio, Samy. Density estimation using Real NVP. International Conference on Learning Representations (ICLR), 2017. arxiv.org/abs/1605.08803
- Jolliffe, Ian T.; Cadima, Jorge. Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A, v. 374, n. 2065, 20150202, 2016. doi.org/10.1098/rsta.2015.0202

Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/07-determinante-area-volume-orientacao-perda-informacao.md.



