Sistemas lineares, eliminação de Gauss e posto da matriz
Entender sistemas lineares como problemas matriciais, aprender eliminação de Gauss e compreender o posto (rank) como medida da quantidade de informação independente em uma matriz.
Entender sistemas lineares como problemas matriciais, aprender eliminação de Gauss e compreender o posto (rank) como medida da quantidade de informação independente em uma matriz. Pré-requisito: Aula 08 — Matriz inversa.
Imagine uma planilha de imóveis com duas colunas de área: uma em metros quadrados, outra em pés quadrados. Você ajusta uma regressão linear para prever o preço e recebe pesos estranhos para as duas colunas. Troca o método de cálculo (ou passa do R para o Python) e os pesos mudam completamente, mas as previsões continuam idênticas. Nenhuma das duas está errada. A planilha tem duas colunas, mas só uma informação: a segunda é a primeira multiplicada por 10,7639.
O nome matemático para "quantas informações independentes uma matriz carrega" é posto (em inglês, rank). Para chegar a ele, o caminho passa pela ferramenta clássica para resolver sistemas lineares: a eliminação de Gauss. No artigo anterior da série, $Ax=b$ foi resolvido com a inversa, quando ela existe. Aqui a pergunta é mais geral: e quando a matriz não é quadrada, ou é singular?
Ao final, você vai conseguir escalonar um sistema à mão e ler os pivôs; dizer, só comparando dois postos, se um sistema tem nenhuma, uma ou infinitas soluções; usar o teorema do posto e da nulidade para contar variáveis livres; entender por que o computador troca linhas durante a eliminação; e reconhecer o posto por trás da multicolinearidade, dos mínimos quadrados e do LoRA, o método de ajuste fino de modelos de linguagem.
1. O problema central: quando a inversa não basta
Na Aula 08, o sistema
$$ Ax=b $$
foi resolvido, quando $A$ é quadrada e invertível, por
$$ x=A^{-1}b $$
Em Machine Learning, porém, é comum a matriz não ser quadrada, ser singular ou ter muito mais equações do que incógnitas. Uma tabela com $1\,000\,000$ de observações e 50 variáveis dá uma matriz
$$ A\in\mathbb{R}^{1\,000\,000\times 50} $$
e uma matriz que não é quadrada não tem inversa. A própria fórmula $x=A^{-1}b$ só vale quando $A$ é quadrada e invertível, o que muitas vezes não acontece (Deisenroth, Faisal & Ong, 2020). O artigo anterior já mostrou que, mesmo quando a inversa existe, o código resolve o sistema com solve em vez de calculá-la. Agora entra a ferramenta mais geral, que funciona para qualquer formato de matriz e ainda diz por que um sistema não tem solução.
2. Sistema linear como matriz: os três destinos possíveis
Considere:
$$ \begin{cases} 2x+y=5\\ x+y=3 \end{cases} $$
Ele cabe na forma $Ax=b$ com
$$ A=\begin{bmatrix}2&1\\1&1\end{bmatrix},\quad x=\begin{bmatrix}x\\y\end{bmatrix},\quad b=\begin{bmatrix}5\\3\end{bmatrix} $$
Cada linha de $A$, junto com a entrada correspondente de $b$, é uma equação. Com duas incógnitas, cada equação é uma reta no plano, e a solução é o que as retas têm em comum. Isso pode ser um ponto, a reta inteira (quando as duas equações descrevem a mesma reta) ou nada (quando as retas são paralelas). Com três incógnitas, cada equação é um plano, e a interseção pode ser um plano, uma reta, um ponto ou o vazio (Deisenroth, Faisal & Ong, 2020).
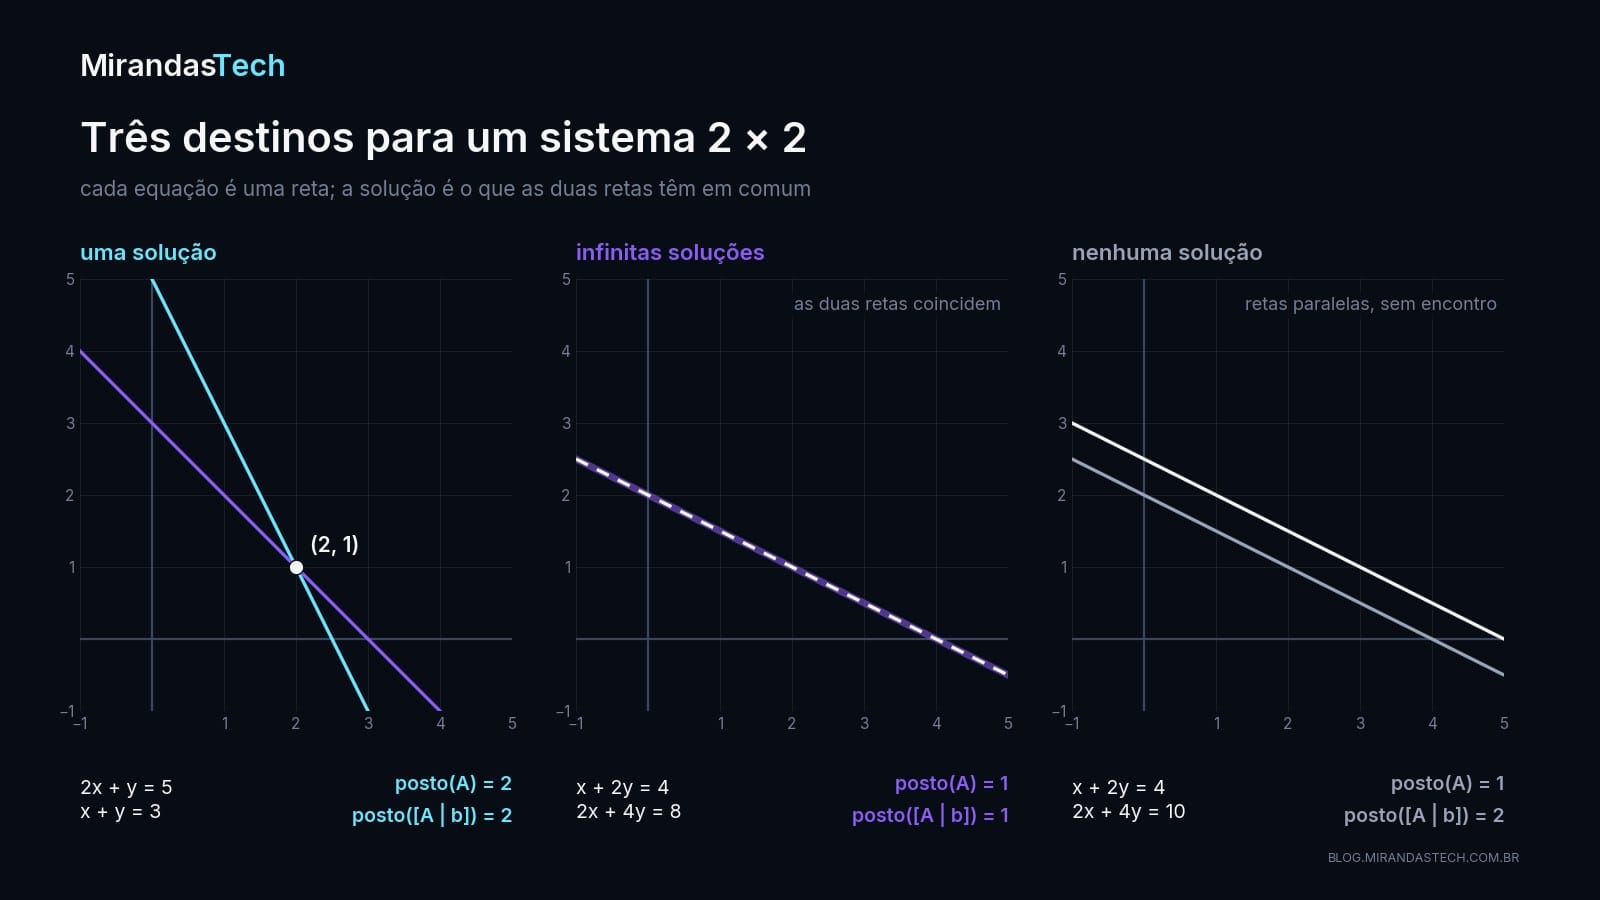
Por isso, um sistema linear real tem sempre um destes três destinos (Deisenroth, Faisal & Ong, 2020):
- uma solução única;
- infinitas soluções;
- nenhuma solução.
Nunca duas, nunca cinco. Se duas soluções diferentes existem, todos os pontos da reta que passa por elas também são soluções.
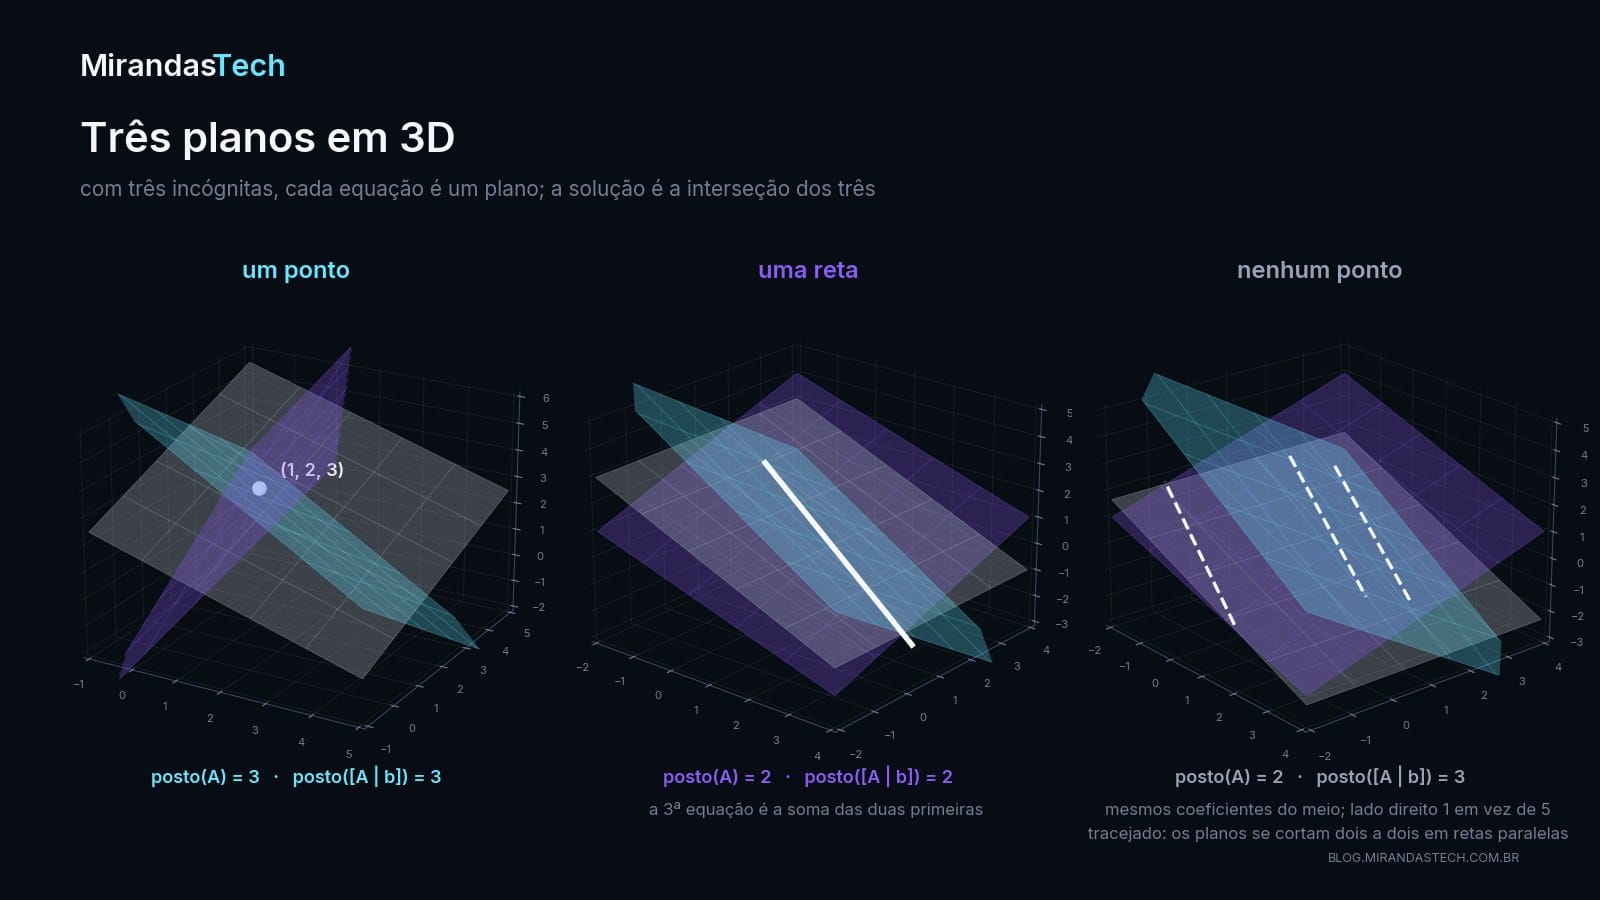
Com três incógnitas, a mesma tricotomia aparece em 3D. No primeiro painel da figura abaixo está o sistema que será escalonado na seção 5, com solução única $(1, 2, 3)$. No painel do meio da figura abaixo, a terceira equação é a soma das duas primeiras e não acrescenta nada: o sistema de Deisenroth, Faisal e Ong (2020, eq. 2.6), $x_1+x_2+x_3=3$, $x_1-x_2+2x_3=2$ e $2x_1+3x_3=5$, tem como solução uma reta inteira. Trocando o 5 por 1, os três planos passam a se cortar dois a dois em retas paralelas, e não sobra ponto comum aos três.
3. Matriz aumentada e operações elementares
Para resolver o sistema sem calcular inversa, junta-se $A$ e $b$ numa só tabela, a matriz aumentada $[A\,|\,b]$:
$$ \left[\begin{array}{cc|c} 2&1&5\\ 1&1&3 \end{array}\right] $$
Sobre ela valem três operações elementares de linha, que mudam a aparência do sistema sem mudar o conjunto de soluções (Deisenroth, Faisal & Ong, 2020):
- Trocar duas linhas: $L_1\leftrightarrow L_2$.
- Multiplicar uma linha por um escalar não nulo: $L_1\leftarrow cL_1$, com $c\neq0$.
- Somar a uma linha um múltiplo de outra: $L_2\leftarrow L_2+cL_1$.
Por que nenhuma delas muda as soluções? Trocar a ordem das equações obviamente não muda nada. Multiplicar uma equação por $c\neq0$ também não: $2x+y=5$ e $4x+2y=10$ são satisfeitas pelos mesmos pontos. E se $(x,y)$ satisfaz as duas equações, satisfaz também qualquer soma delas; como a operação pode ser desfeita (somando $-c$ vezes a mesma linha), nenhuma solução nova aparece e nenhuma se perde. O $c\neq0$ da segunda operação é essencial: multiplicar uma equação por zero apagaria a informação que ela carrega.
4. Eliminação de Gauss, passo a passo
Partindo de
$$ \left[\begin{array}{cc|c} 2&1&5\\ 1&1&3 \end{array}\right] $$
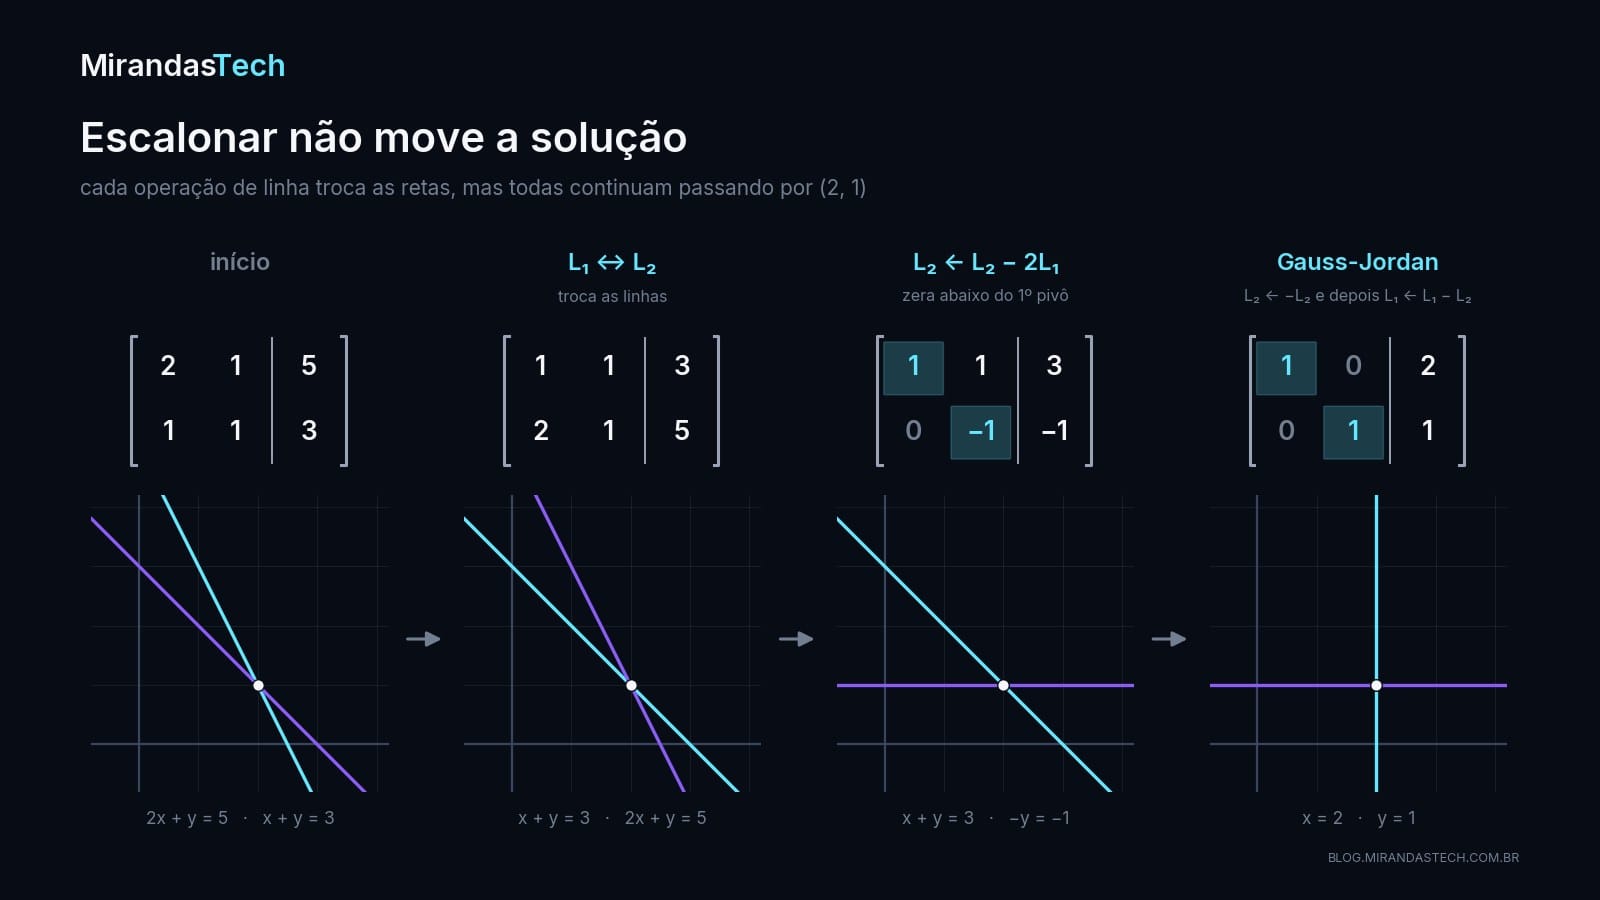
troque as linhas para deixar um 1 no canto, o que facilita as contas:
$$ \left[\begin{array}{cc|c} 1&1&3\\ 2&1&5 \end{array}\right] $$
Depois, zere o 2 abaixo do primeiro pivô com $L_2\leftarrow L_2-2L_1$:
$$ \left[\begin{array}{cc|c} 1&1&3\\ 0&-1&-1 \end{array}\right] $$
A segunda linha agora diz $-y=-1$, ou seja, $y=1$. Substituindo na primeira, $x+1=3$, e:
$$ \boxed{x=2,\;y=1} $$
Essa volta de baixo para cima chama-se substituição regressiva. A figura mostra o que cada passo fez com as retas: elas mudam, mas todas continuam passando por $(2, 1)$. É a seção 3 em imagem: as operações trocam o sistema por outro mais simples com exatamente as mesmas soluções.
5. Forma escalonada, pivôs e Gauss-Jordan
O objetivo da eliminação é chegar a uma matriz em forma escalonada, com o formato de uma escada:
$$ \begin{bmatrix} *&*&*\\ 0&*&*\\ 0&0&* \end{bmatrix} $$
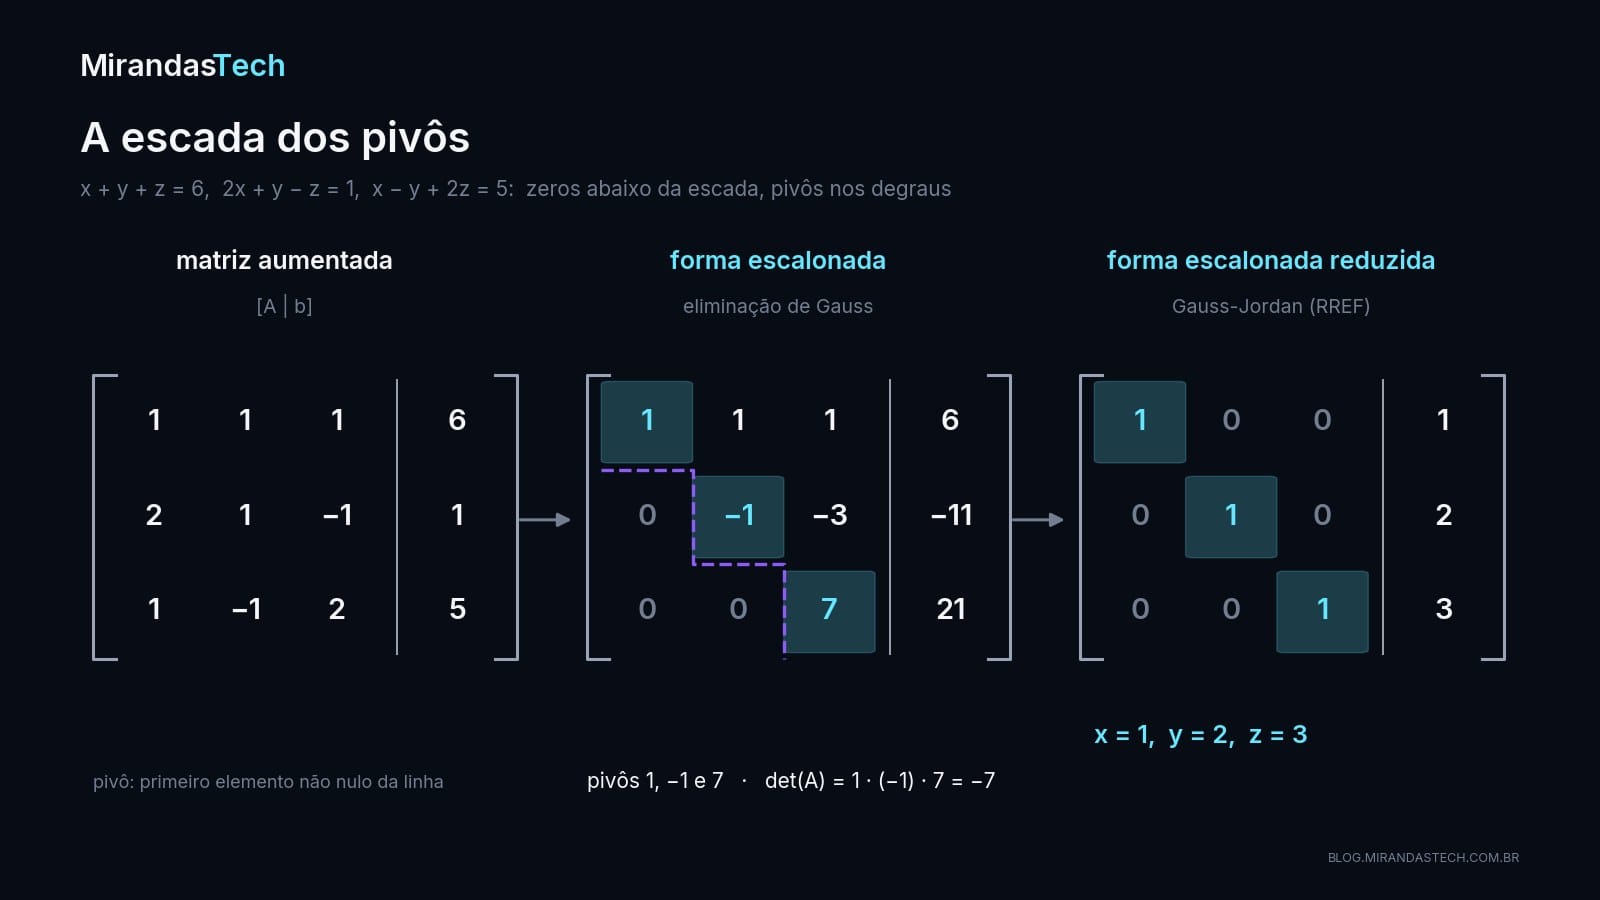
O primeiro elemento não nulo de cada linha é o pivô. Na forma escalonada, cada pivô fica estritamente à direita do pivô da linha de cima, e as linhas só de zeros ficam no fim; daí a "escada" (Deisenroth, Faisal & Ong, 2020). Se a eliminação continuar até cada pivô valer 1 e ser o único elemento não nulo da sua coluna, chega-se à forma escalonada reduzida (em inglês, RREF, de reduced row echelon form).
Um aviso de vocabulário: a aula do AI Lab chama de eliminação de Gauss o processo que para na forma escalonada e de Gauss-Jordan o que continua até a reduzida, uma divisão comum em livros-texto. Deisenroth, Faisal e Ong (2020) usam "eliminação de Gauss" para o algoritmo inteiro, até a forma reduzida. O conteúdo é o mesmo; muda só onde cada autor põe o nome.
Com três equações, o processo é o mesmo, só mais longo. O código abaixo escalona a matriz aumentada de
$$ \begin{cases} x+y+z=6\\ 2x+y-z=1\\ x-y+2z=5 \end{cases} $$
imprimindo cada operação, e depois faz a substituição regressiva:
import numpy as np

def escalonar(M, pivotear=False):
    """Eliminação de Gauss na matriz aumentada M = [A | b]; imprime cada passo."""
    M = M.astype(float).copy()
    linhas = M.shape[0]
    for k in range(linhas - 1):
        if pivotear:  # pivoteamento parcial: traz para cima o maior |valor| da coluna
            p = k + np.argmax(np.abs(M[k:, k]))
            if p != k:
                M[[k, p]] = M[[p, k]]
                print(f"L{k+1} <-> L{p+1}")
        for i in range(k + 1, linhas):
            fator = M[i, k] / M[k, k]
            if fator != 0:
                M[i] -= fator * M[k]
                print(f"L{i+1} <- L{i+1} - ({fator:g}) L{k+1}")
                print(M)
    return M

def substituir_de_tras_para_frente(U):
    n = U.shape[0]
    x = np.zeros(n)
    for i in range(n - 1, -1, -1):
        x[i] = (U[i, -1] - U[i, i+1:n] @ x[i+1:]) / U[i, i]
    return x

M = np.array([
    [1,  1,  1, 6],
    [2,  1, -1, 1],
    [1, -1,  2, 5],
])
U = escalonar(M)
print("pivôs:", np.diag(U)[:3])
print("x =", substituir_de_tras_para_frente(U))
Saída:
L2 <- L2 - (2) L1
[[  1.   1.   1.   6.]
 [  0.  -1.  -3. -11.]
 [  1.  -1.   2.   5.]]
L3 <- L3 - (1) L1
[[  1.   1.   1.   6.]
 [  0.  -1.  -3. -11.]
 [  0.  -2.   1.  -1.]]
L3 <- L3 - (2) L2
[[  1.   1.   1.   6.]
 [  0.  -1.  -3. -11.]
 [  0.   0.   7.  21.]]
pivôs: [ 1. -1.  7.]
x = [1. 2. 3.]
Três operações bastaram, e os pivôs são 1, −1 e 7. Uma ligação com a Aula 07: como não houve troca de linhas e a operação usada não altera o determinante, $\det(A)$ é o produto dos pivôs, $1\cdot(-1)\cdot7=-7$. Esse é justamente o jeito de calcular determinantes por eliminação, levando a matriz à forma triangular e multiplicando a diagonal (Deisenroth, Faisal & Ong, 2020).
6. Posto: quantas direções independentes existem?
Agora um caso em que a escada termina antes. Considere
$$ A=\begin{bmatrix}1&2\\2&4\end{bmatrix} $$
A segunda linha é o dobro da primeira. Aplicando $L_2\leftarrow L_2-2L_1$:
$$ \begin{bmatrix}1&2\\0&0\end{bmatrix} $$
Sobrou um único pivô. Esse número é o posto da matriz:
$$ \boxed{\mathrm{posto}(A)=\text{número de pivôs}} $$
O posto também é o número de colunas linearmente independentes de $A$, que é sempre igual ao número de linhas linearmente independentes (Deisenroth, Faisal & Ong, 2020). Aqui, $\mathrm{posto}(A)=1$: a segunda coluna, $(2, 4)$, é o dobro da primeira, $(1, 2)$.
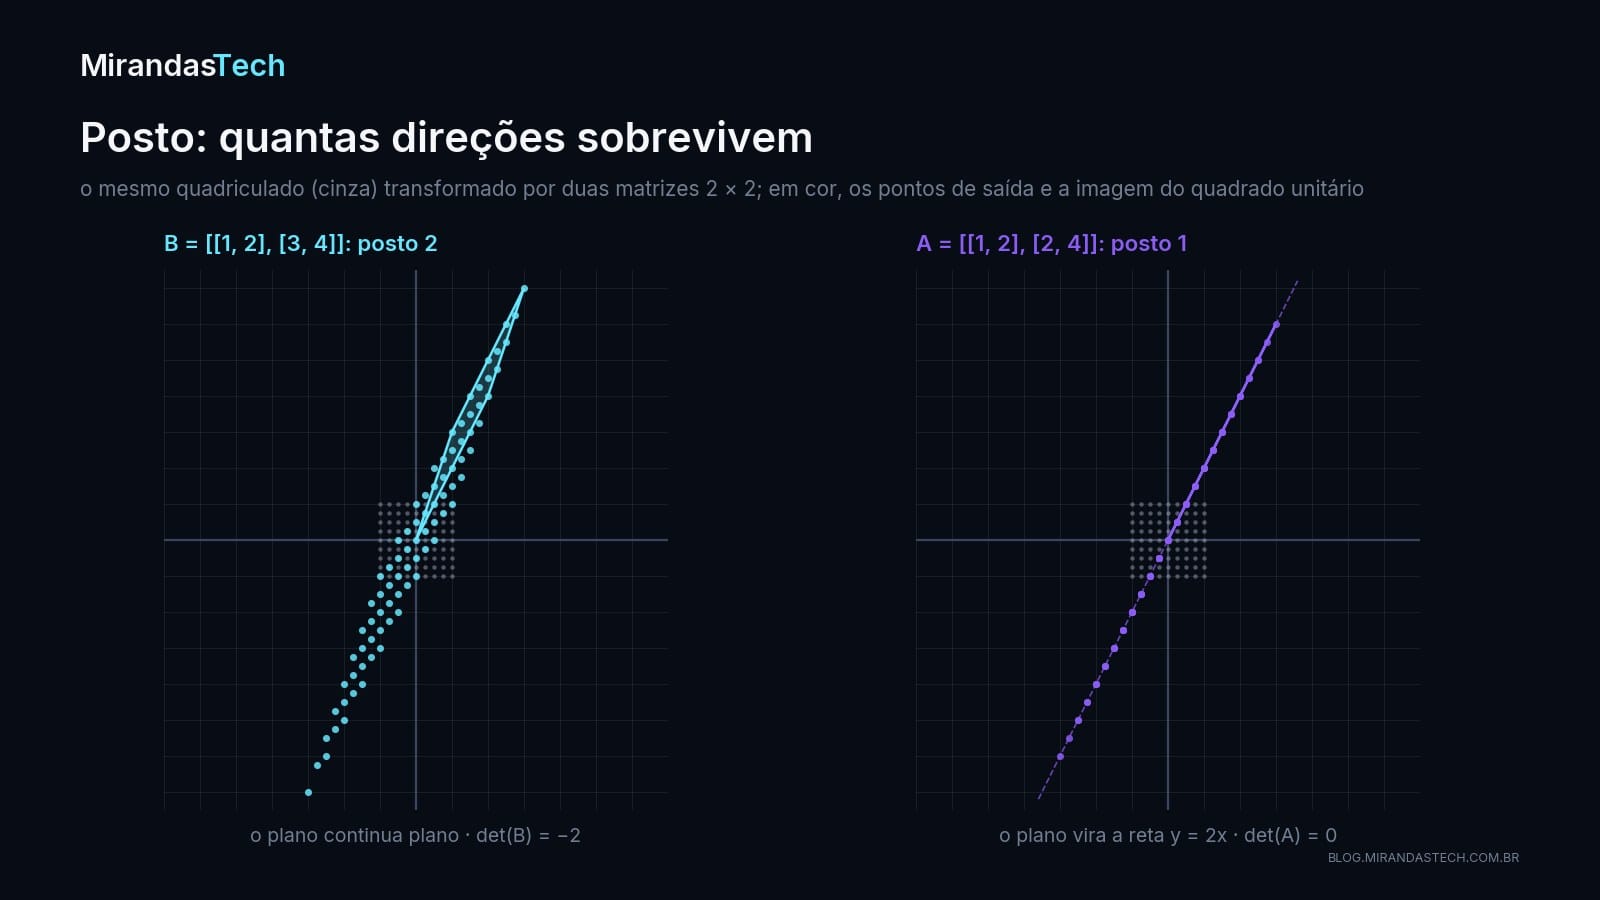
Geometricamente, o posto conta quantas dimensões sobrevivem à transformação. As colunas de $A$ geram um subespaço, a imagem de $A$, cuja dimensão é exatamente o posto (Deisenroth, Faisal & Ong, 2020). Na figura, a matriz $B$ tem posto 2 e leva o plano a um plano; a matriz $A$ tem posto 1 e esmaga o plano inteiro sobre a reta $y=2x$.
Posto completo e o elo com o determinante
Para uma matriz $m\times n$, o posto nunca passa do menor dos dois lados:
$$ \boxed{\mathrm{posto}(A)\le\min(m,n)} $$
Quando atinge esse máximo, a matriz tem posto completo (full rank); quando não atinge, tem posto deficiente (Deisenroth, Faisal & Ong, 2020). Uma matriz $5\times3$ com posto 3, por exemplo, tem posto completo nas colunas: as três colunas são independentes.
Para matrizes quadradas $n\times n$, o posto fecha o círculo com as duas aulas anteriores (Deisenroth, Faisal & Ong, 2020):
$$ \boxed{\begin{aligned}\det(A)\neq0&\iff\mathrm{posto}(A)=n\\&\iff A\text{ é invertível}\end{aligned}} $$
Se $\det(A)=0$, o posto é menor que $n$, alguma coluna depende das outras e não há inversa. É a mesma perda de informação da Aula 07, agora contada em número de dimensões. Não por acaso, a mesma matriz $[[1,2],[2,4]]$ apareceu no artigo anterior como exemplo de matriz sem inversa.
7. Existe solução? É única?
Depois do escalonamento, uma linha como esta pode aparecer:
$$ \left[\begin{array}{cc|c} 1&2&3\\ 0&0&5 \end{array}\right] $$
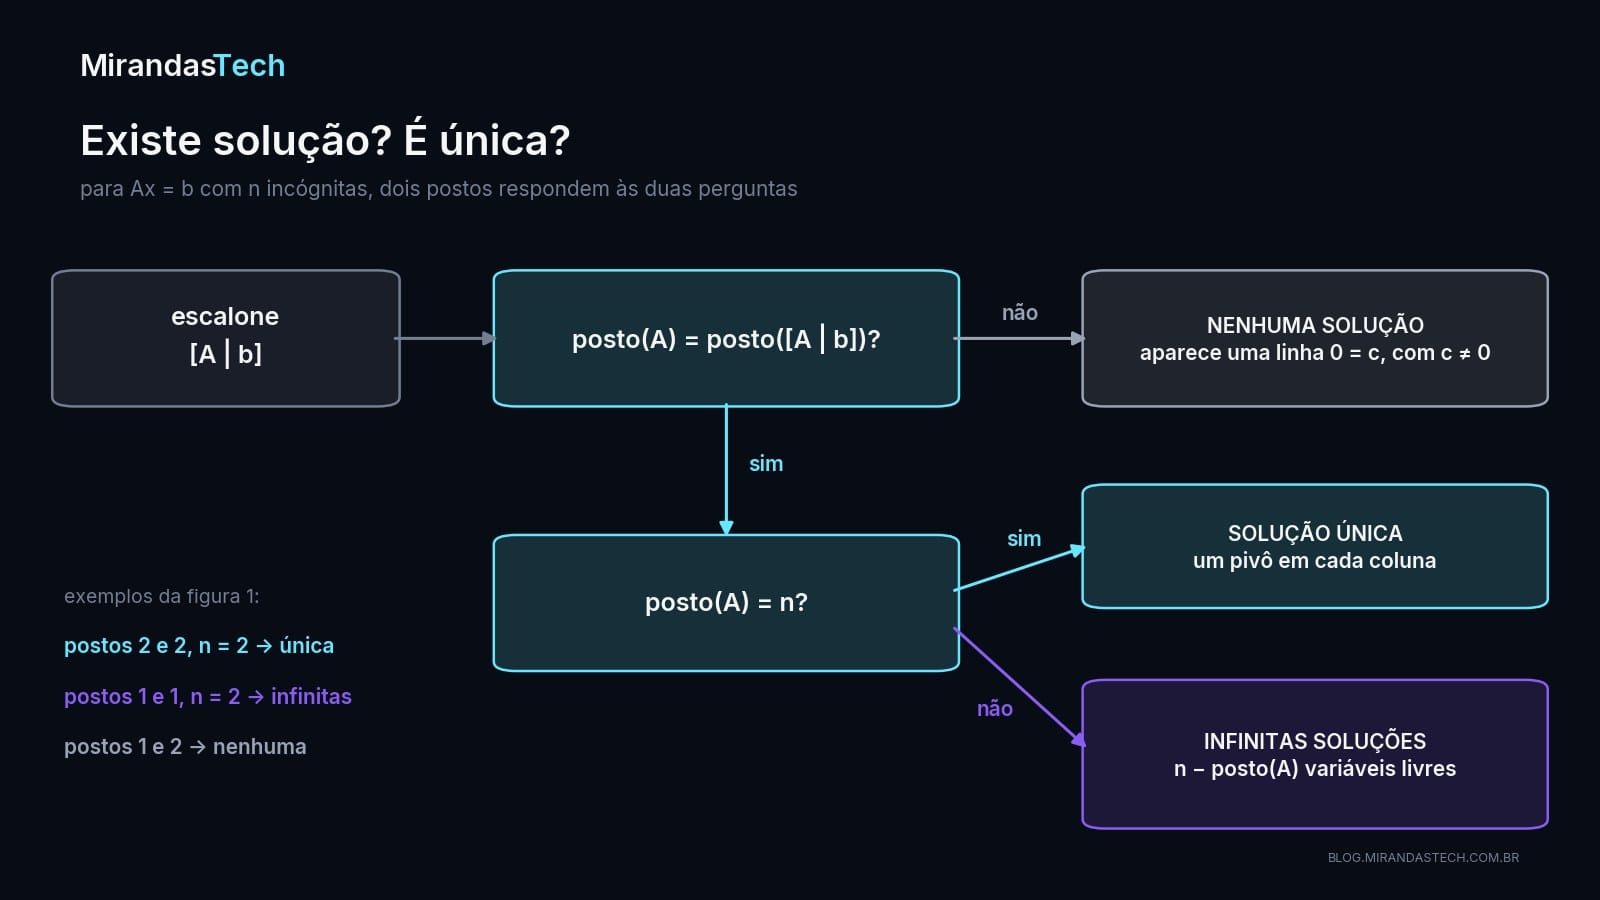
A segunda linha diz $0x+0y=5$, ou seja, $0=5$. Impossível: o sistema não tem solução. Em termos de posto, o que aconteceu é que a coluna $b$ criou um pivô que $A$ sozinha não tinha, e o posto da matriz aumentada ficou maior que o de $A$. Daí o critério geral: $Ax=b$ tem solução se e somente se (Deisenroth, Faisal & Ong, 2020)
$$ \boxed{\mathrm{posto}(A)=\mathrm{posto}([A\,|\,b])} $$
Havendo solução, a unicidade depende de sobrar ou não alguma coluna sem pivô. Com $n$ incógnitas:
- se $\mathrm{posto}(A)=\mathrm{posto}([A\,|\,b])=n$, há solução única;
- se $\mathrm{posto}(A)=\mathrm{posto}([A\,|\,b])\lt n$, há infinitas soluções;
- se $\mathrm{posto}(A)\lt\mathrm{posto}([A\,|\,b])$, nenhuma.
Variáveis pivô e variáveis livres
Depois do escalonamento, as colunas com pivô correspondem às variáveis pivô (ou básicas); as demais são variáveis livres (Deisenroth, Faisal & Ong, 2020). Na equação
$$ x+2y+3z=5 $$
o único pivô está na coluna de $x$, então
$$ x=5-2y-3z $$
e $y$ e $z$ são livres: cada escolha deles dá uma solução diferente. Por isso "infinitas soluções" vem sempre acompanhado de variáveis livres, e o número delas é $n-\mathrm{posto}(A)$. A conta abaixo aplica o critério aos três sistemas da figura 1:
import numpy as np

def classificar(A, b):
    n = A.shape[1]
    r = int(np.linalg.matrix_rank(A))
    r_aum = int(np.linalg.matrix_rank(np.column_stack([A, b])))
    if r < r_aum:
        tipo = "nenhuma solução"
    elif r == n:
        tipo = "solução única"
    else:
        tipo = f"infinitas soluções ({n - r} variável livre)"
    return r, r_aum, tipo

A1, b1 = np.array([[2., 1.], [1., 1.]]), np.array([5., 3.])
A2, b2 = np.array([[1., 2.], [2., 4.]]), np.array([4., 8.])
A3, b3 = np.array([[1., 2.], [2., 4.]]), np.array([4., 10.])

for nome, A, b in [("A1", A1, b1), ("A2", A2, b2), ("A3", A3, b3)]:
    print(nome, classificar(A, b))
A1 (2, 2, 'solução única')
A2 (1, 1, 'infinitas soluções (1 variável livre)')
A3 (1, 2, 'nenhuma solução')8. Núcleo e o teorema do posto e da nulidade
As soluções de $Ax=0$ formam o núcleo de $A$ (em inglês, null space ou kernel). Com
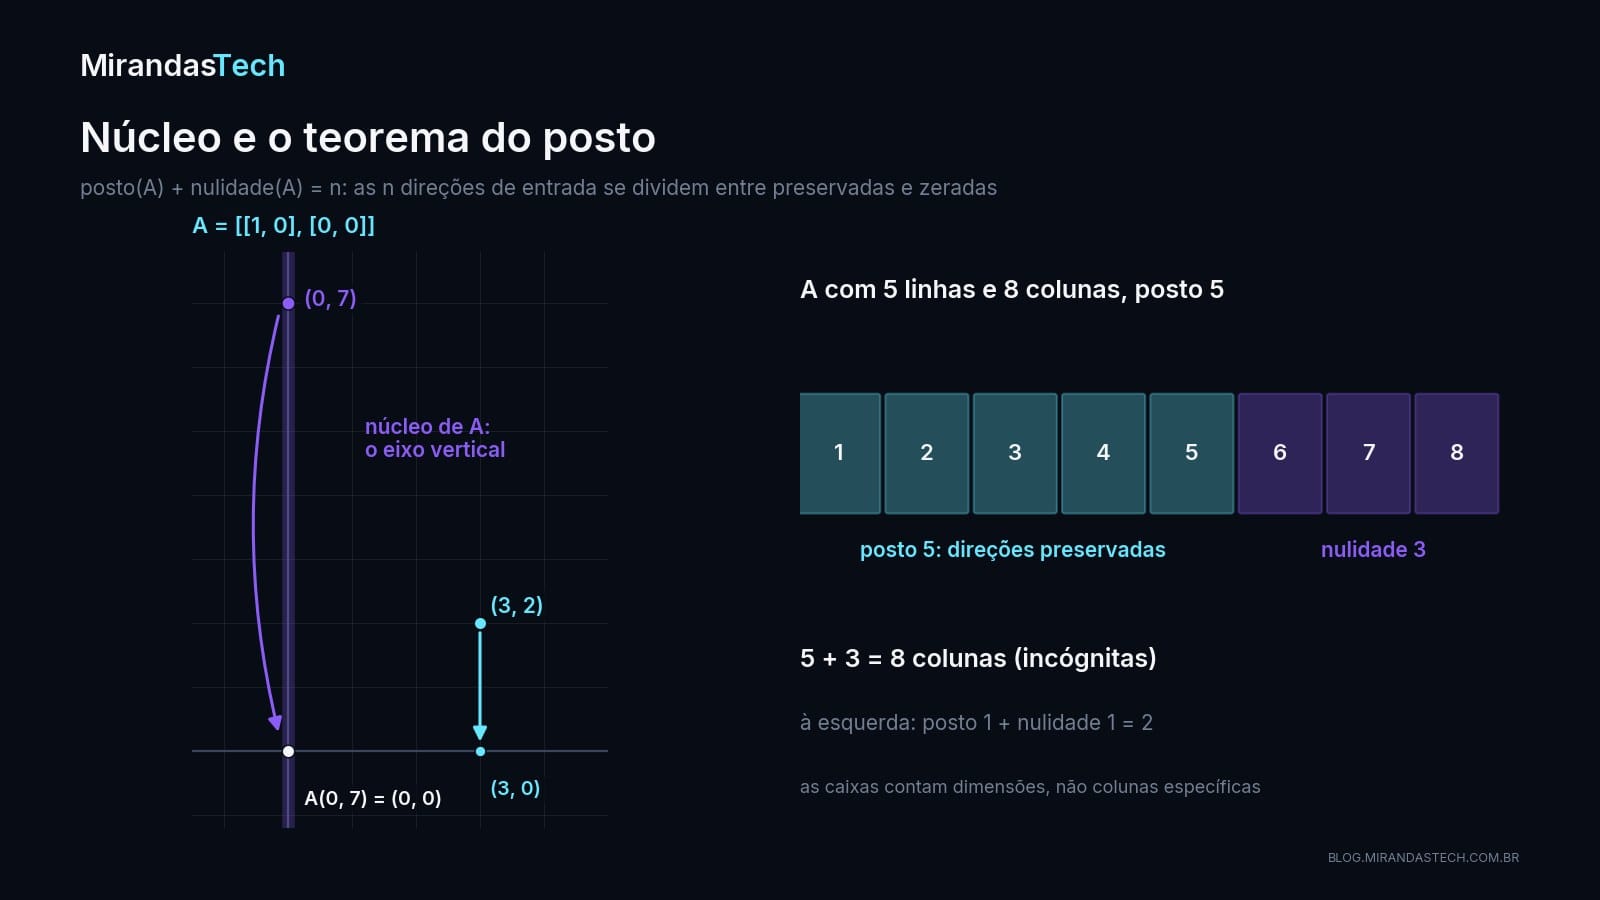
$$ A=\begin{bmatrix}1&0\\0&0\end{bmatrix} \quad\text{e}\quad x=\begin{bmatrix}0\\7\end{bmatrix}, \qquad Ax=\begin{bmatrix}0\\0\end{bmatrix} $$
Todo o eixo vertical vai parar na origem: essa direção foi completamente destruída pela transformação. A dimensão do núcleo chama-se nulidade, e ela se relaciona com o posto por um dos resultados mais úteis da álgebra linear. Se $A$ tem $n$ colunas:
$$ \boxed{\mathrm{posto}(A)+\mathrm{nulidade}(A)=n} $$
É o teorema do posto e da nulidade, também chamado de teorema fundamental das aplicações lineares (Deisenroth, Faisal & Ong, 2020). A leitura é direta: as $n$ direções de entrada se dividem entre as que a matriz preserva e as que ela manda para o zero. Para uma matriz $5\times8$ com posto 5,
$$ \mathrm{nulidade}(A)=8-5=3 $$
e o sistema $Ax=0$ tem um espaço de soluções de dimensão 3.
Essa conta também explica a estrutura das soluções. Deisenroth, Faisal e Ong (2020) descrevem a solução geral de $Ax=b$ em três passos: achar uma solução particular, achar todas as soluções de $Ax=0$ e somar as duas coisas. Se o núcleo tem dimensão positiva, dá para somar qualquer vetor dele a uma solução e obter outra, e por isso as soluções são infinitas.
9. Determinados, superdeterminados e subdeterminados
O formato de $A$, com $m$ equações e $n$ incógnitas, já diz bastante sobre o sistema. Um aviso de vocabulário: aqui, "determinado", "superdeterminado" e "subdeterminado" seguem o uso em inglês e comparam $m$ com $n$. No ensino médio brasileiro, "sistema possível e determinado" (SPD) significa solução única, e a classificação SPD, SPI e SI corresponde aos três destinos da seção 7, decididos pelos postos e não pelo formato.
- Determinado ($m=n$): mesmo número de equações e incógnitas. Se o posto for $n$, a solução é única.
- Superdeterminado ($m\gt n$): mais equações que incógnitas, como $A\in\mathbb{R}^{1000\times10}$. É o caso típico de Machine Learning, com mais exemplos do que parâmetros, e em geral não existe solução exata.
- Subdeterminado ($m\lt n$): menos equações que incógnitas, como $A\in\mathbb{R}^{3\times10}$. Como o posto é no máximo 3, sobram pelo menos 7 variáveis livres; se o sistema for consistente, as soluções são infinitas.
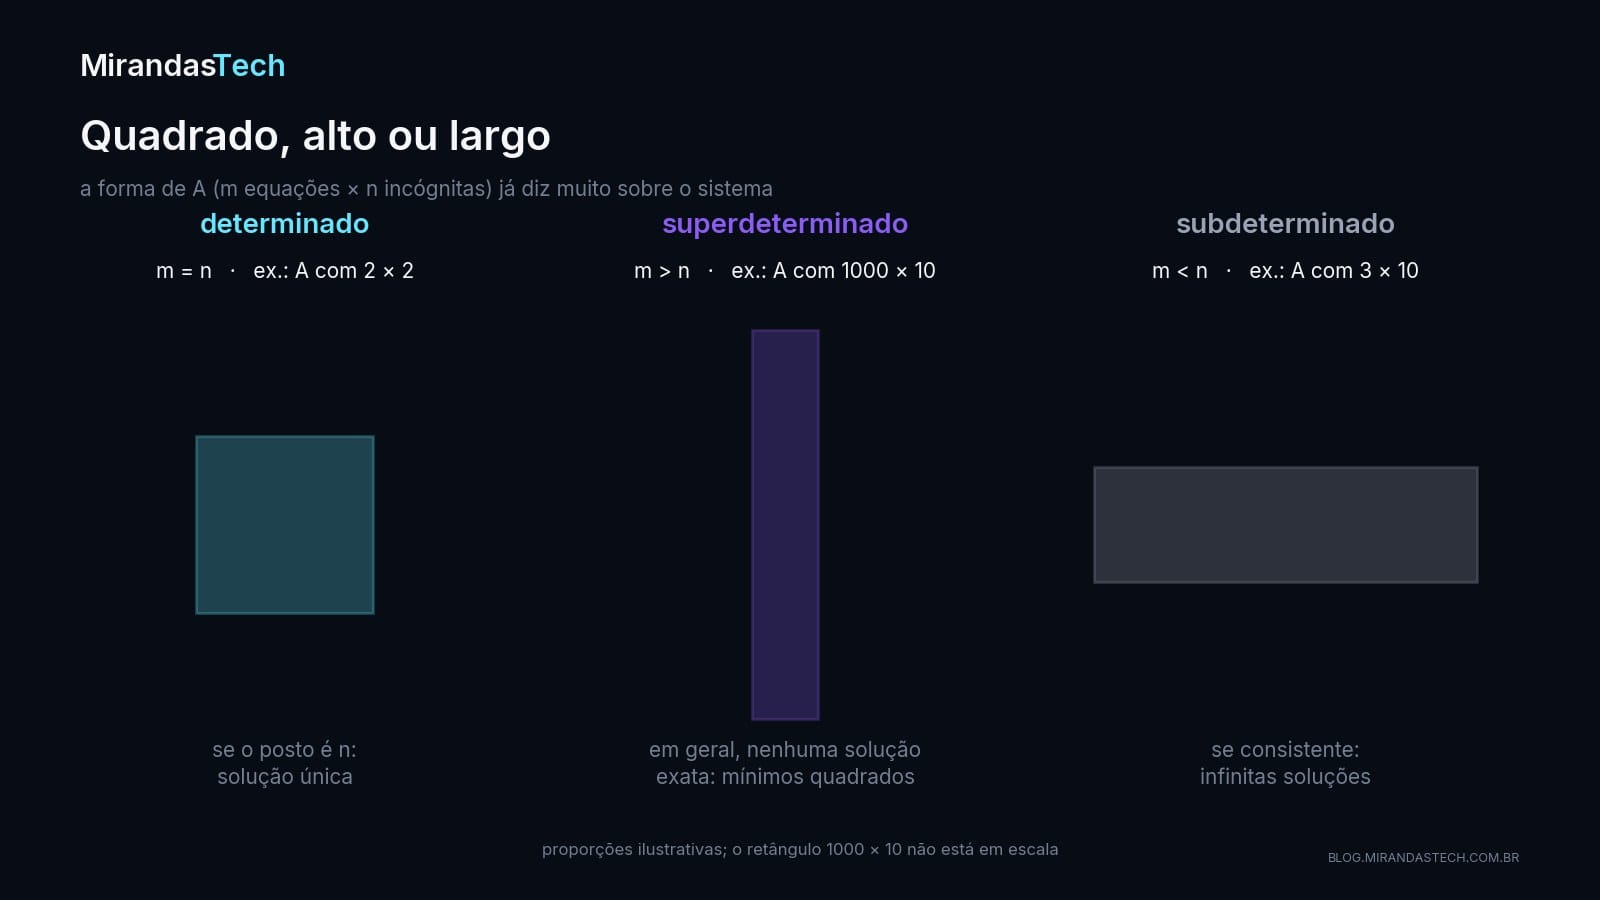
O caso subdeterminado sai direto do teorema da seção 8: com 10 colunas e posto no máximo 3, a nulidade é pelo menos 7.
10. Mínimos quadrados: quando não há solução exata
No caso superdeterminado, em regressão, o sistema é
$$ Xw=y $$
com milhares de observações e poucos pesos. Em geral não existe $w$ que satisfaça todas as equações ao mesmo tempo, porque o ruído dos dados coloca $y$ fora da imagem de $X$. Então se troca a pergunta "qual $w$ resolve?" por "qual $w$ erra menos?":
$$ \boxed{\min_w\|Xw-y\|^2} $$
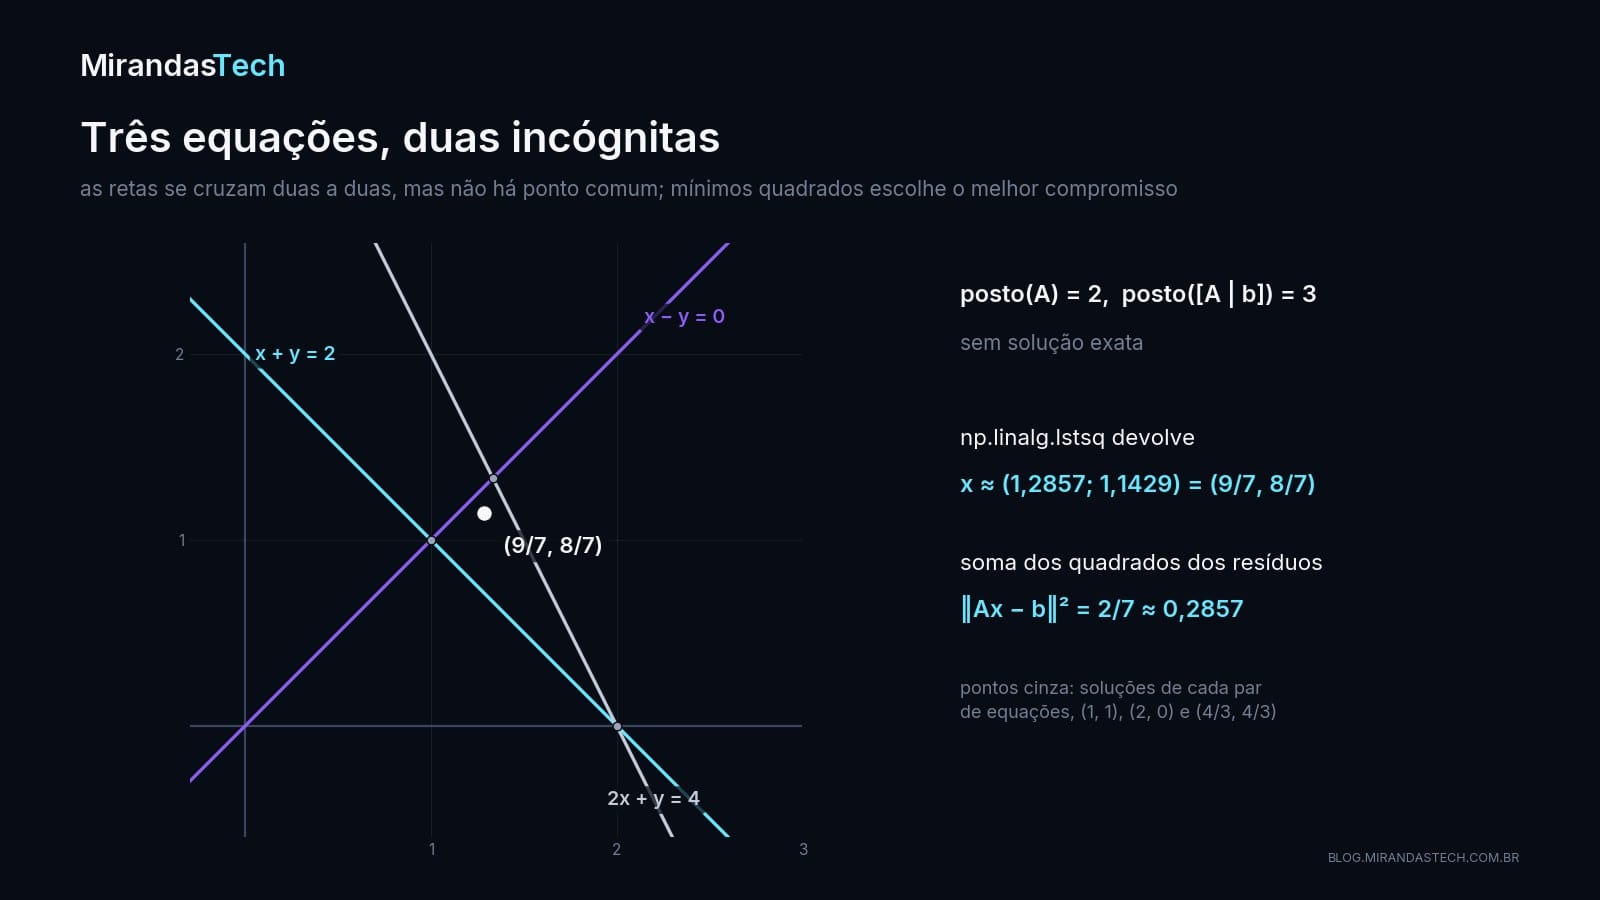
Esse é o problema de mínimos quadrados. Deisenroth, Faisal e Ong (2020) apontam a regressão linear justamente como a saída quando o sistema não tem solução. A mesma ideia em miniatura: três equações, duas incógnitas, nenhum ponto comum.
import numpy as np

# três equações, duas incógnitas: x + y = 2,  x - y = 0,  2x + y = 4
A = np.array([[1., 1.], [1., -1.], [2., 1.]])
b = np.array([2., 0., 4.])

print("posto de A:", np.linalg.matrix_rank(A))
print("posto de [A|b]:", np.linalg.matrix_rank(np.column_stack([A, b])))

x, residuos, posto, s = np.linalg.lstsq(A, b, rcond=None)
print("x de mínimos quadrados:", np.round(x, 4))
print("soma dos quadrados dos resíduos:", np.round(residuos, 4))
print("A @ x:", np.round(A @ x, 4))
posto de A: 2
posto de [A|b]: 3
x de mínimos quadrados: [1.2857 1.1429]
soma dos quadrados dos resíduos: [0.2857]
A @ x: [2.4286 0.1429 3.7143]O posto denuncia a inconsistência: 2 para $A$ e 3 para $[A\,|\,b]$, o critério da seção 7. A função np.linalg.lstsq devolve o $x$ que minimiza $\|Ax-b\|^2$; a soma dos quadrados dos resíduos, $2/7\approx0{,}2857$, é o menor erro possível. A documentação do NumPy descreve exatamente isso: lstsq aceita sistemas sub, bem ou superdeterminados e, havendo mais de um minimizador, devolve o de menor norma (NumPy, 2026).
Este artigo não refaz a regressão: as equações normais, a projeção ortogonal e o ajuste com dados reais estão no post Regressão linear e mínimos quadrados. O que interessa aqui é o papel do posto, que aparece na próxima seção.
11. Multicolinearidade: o posto escondido na planilha
Voltemos à planilha da abertura. A fórmula fechada da regressão, $w=(X^\top X)^{-1}X^\top y$, exige que $X^\top X$ seja invertível, e isso acontece exatamente quando $X$ tem posto completo nas colunas, isto é, quando as colunas de $X$ são linearmente independentes (Deisenroth, Faisal & Ong, 2020). Com uma coluna em metros quadrados e outra em pés quadrados, essa condição quebra. Cinco imóveis sintéticos:
import numpy as np

m2 = np.array([50., 70., 85., 100., 120.])
pes2 = m2 * 10.7639                # a mesma área, em pés quadrados
X = np.column_stack([m2, pes2])    # 5 imóveis, 2 colunas
y = np.array([160., 215., 262., 305., 362.])  # preço em milhares de reais

print("posto de X:", np.linalg.matrix_rank(X))
print("número de condição de X^T X: %.1e" % np.linalg.cond(X.T @ X))

w_min, *_ = np.linalg.lstsq(X, y, rcond=None)
print("w de menor norma:", np.round(w_min, 4))

# somar um vetor do núcleo de X não muda nenhuma previsão
nucleo = np.array([10.7639, -1.0])
print("X @ nucleo:", np.round(X @ nucleo, 10))
w_outro = w_min + 2.0 * nucleo
print("outro w:", np.round(w_outro, 4))
print("mesmas previsões?", np.allclose(X @ w_min, X @ w_outro))
posto de X: 1
número de condição de X^T X: 5.3e+16
w de menor norma: [0.0262 0.2815]
X @ nucleo: [0. 0. 0. 0. 0.]
outro w: [21.554 -1.7185]
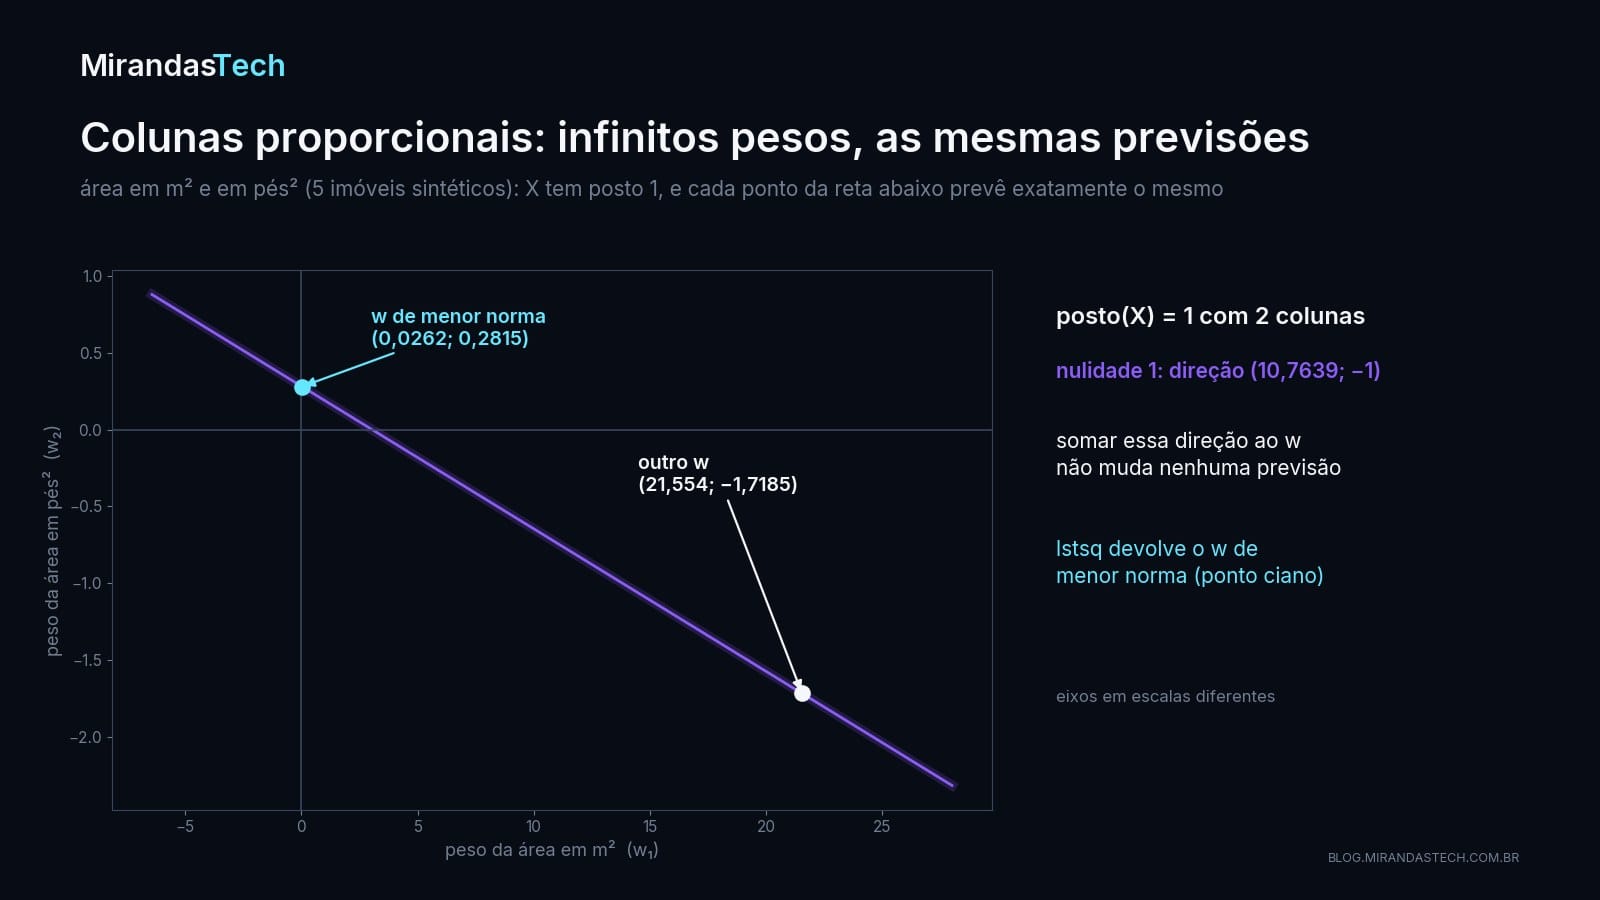
mesmas previsões? TrueDuas colunas, posto 1. Pelo teorema da seção 8, a nulidade é 1: existe uma direção, $(10{,}7639;\,-1)$, que $X$ manda para o zero. Somar qualquer múltiplo dela aos pesos não muda nenhuma previsão. Por isso há infinitos $w$ igualmente bons, e cada biblioteca devolve o que o seu algoritmo escolher. O lstsq escolhe o de menor norma. O número de condição de $X^\top X$, da ordem de $10^{16}$, é o sinal numérico de que essa matriz é, na prática, singular (o valor exato pode variar com a biblioteca de álgebra linear instalada).
Em dados reais, a dependência raramente é exata: duas colunas quase proporcionais deixam $X$ com posto completo no papel, mas com $X^\top X$ quase singular, o problema de condicionamento do artigo anterior. A regularização é uma das saídas. Na regressão ridge, somar $\lambda I$ a $X^\top X$ torna a matriz simétrica e estritamente positiva definida, e portanto invertível, o que faz a solução voltar a ser única (Deisenroth, Faisal & Ong, 2020). O assunto está desenvolvido no post Ridge, Lasso e Elastic Net.
12. Estabilidade numérica e pivoteamento
Na teoria, qualquer pivô diferente de zero serve. No computador, não. Dividir por um pivô minúsculo produz um multiplicador gigante, e os arredondamentos que seriam desprezíveis passam a engolir os números originais. Moler (2004) mostra isso num sistema 3 × 3 com aritmética de cinco dígitos e resume: a matriz não estava perto de ser singular, a dificuldade veio de escolher um pivô pequeno. Com números de 64 bits, um exemplo 2 × 2 basta:
import numpy as np

def gauss_2x2(A, b, pivotear):
    A, b = A.astype(float).copy(), b.astype(float).copy()
    if pivotear and abs(A[1, 0]) > abs(A[0, 0]):   # troca as linhas
        A[[0, 1]], b[[0, 1]] = A[[1, 0]], b[[1, 0]]
    fator = A[1, 0] / A[0, 0]
    A[1] -= fator * A[0]
    b[1] -= fator * b[0]
    y = b[1] / A[1, 1]
    x = (b[0] - A[0, 1] * y) / A[0, 0]
    return np.array([x, y])

A = np.array([[1e-20, 1.0],
              [1.0,   1.0]])
b = np.array([1.0, 2.0])

print("sem pivoteamento:", gauss_2x2(A, b, pivotear=False))
print("com pivoteamento:", gauss_2x2(A, b, pivotear=True))
print("np.linalg.solve: ", np.linalg.solve(A, b))
print("número de condição de A: %.1f" % np.linalg.cond(A))
sem pivoteamento: [0. 1.]
com pivoteamento: [1. 1.]
np.linalg.solve: [1. 1.]
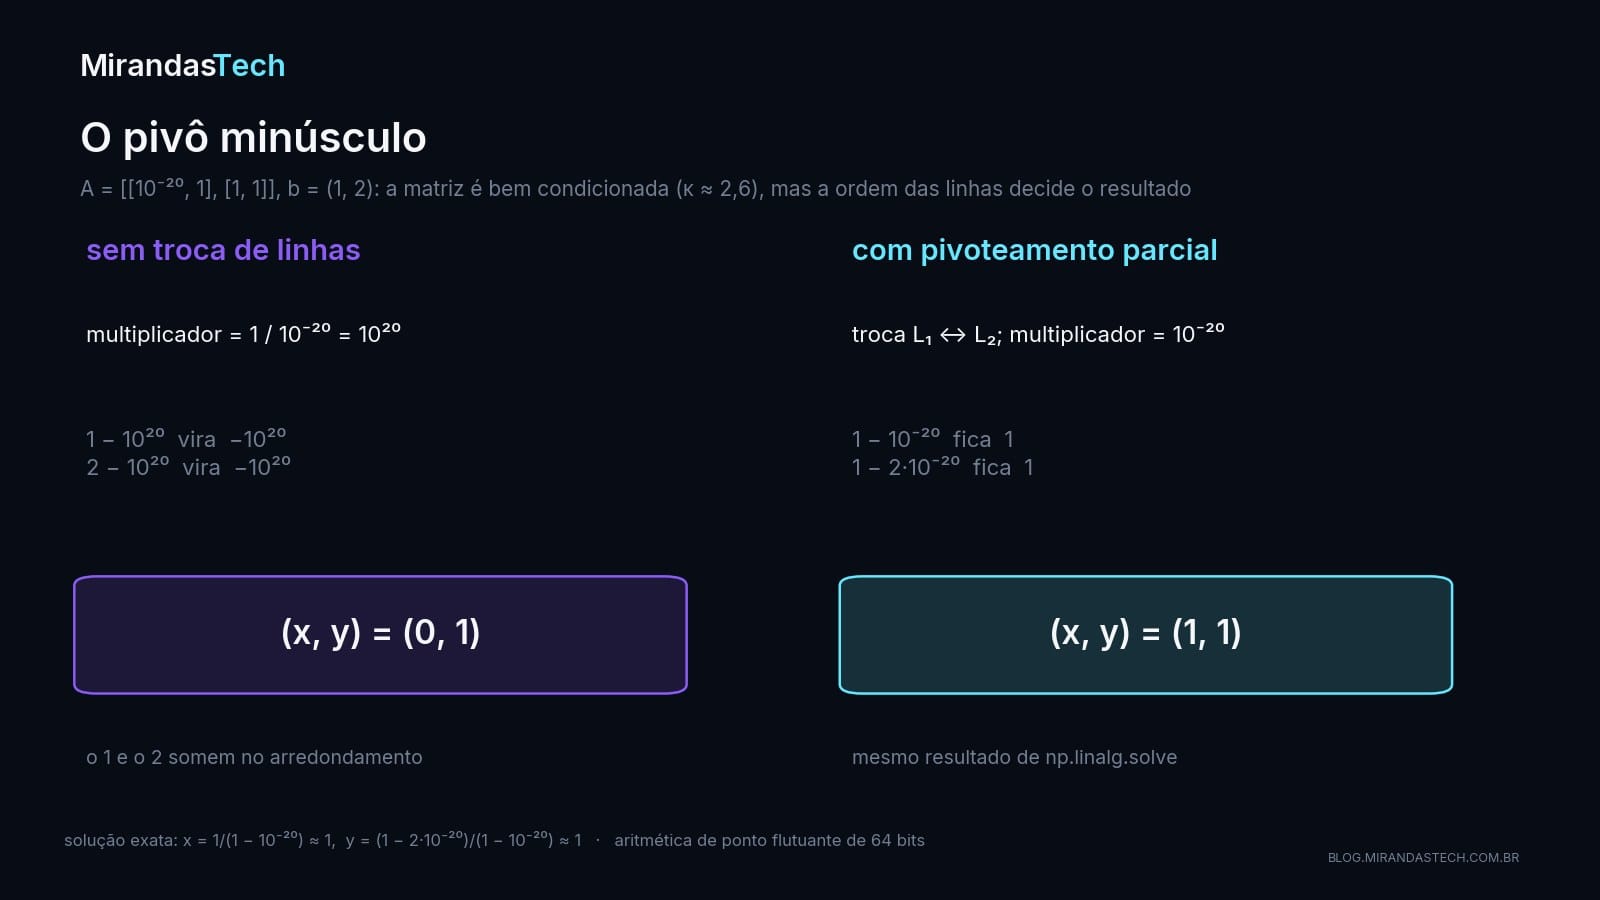
número de condição de A: 2.6A matriz é bem comportada: o número de condição é 2,6, longe do território perigoso da Aula 08. Mesmo assim, sem troca de linhas o resultado é $(0, 1)$, quando a resposta certa é praticamente $(1, 1)$. O multiplicador $1/10^{-20}=10^{20}$ faz $1-10^{20}$ e $2-10^{20}$ virarem o mesmo número em ponto flutuante, e a informação da segunda equação desaparece.
A correção é o pivoteamento parcial: a cada passo, escolher como pivô o elemento de maior valor absoluto na parte ainda não reduzida da coluna e trazer a linha dele para cima. Assim os multiplicadores ficam com valor absoluto no máximo 1, e Moler (2004) afirma que, nessa condição, a solução calculada é comprovadamente satisfatória. É o que o np.linalg.solve faz por baixo: a documentação informa que ele usa a rotina _gesv do LAPACK (NumPy, 2026), e a documentação do LAPACK descreve essa rotina como uma decomposição LU com pivoteamento parcial e troca de linhas (LAPACK, 2026).
Há ainda uma questão de escala. Deisenroth, Faisal e Ong (2020) observam que a eliminação de Gauss resolve com tranquilidade sistemas de milhares de variáveis, mas fica impraticável com milhões, porque o número de operações cresce com o cubo do número de equações. Nesses casos, usam-se métodos iterativos.
Posto numérico
O mesmo cuidado vale para o posto. Em ponto flutuante, uma coluna que é combinação exata das outras raramente produz um zero exato. Por isso o np.linalg.matrix_rank não escalona: ele calcula os valores singulares da matriz e conta quantos ficam acima de uma tolerância, por padrão o maior valor singular vezes o maior entre o número de linhas e o de colunas vezes o épsilon da máquina (NumPy, 2026). O posto calculado depende dessa tolerância:
import numpy as np

quase = np.array([[1., 2.],
                  [2., 4. + 1e-10]])

print("posto (tolerância padrão):", np.linalg.matrix_rank(quase))
print("posto com tol=1e-6:      ", np.linalg.matrix_rank(quase, tol=1e-6))
print("valores singulares:", np.linalg.svd(quase, compute_uv=False))
posto (tolerância padrão): 2
posto com tol=1e-6: 1
valores singulares: [5.00000000e+00 2.00000895e-11]Para a tolerância padrão, a matriz tem posto 2; com uma tolerância mais frouxa, posto 1. Qual resposta é a certa depende de quanto ruído os dados carregam. A documentação do NumPy discute exatamente esse ponto, inclusive tolerâncias alternativas (NumPy, 2026).
13. Posto em IA: embeddings, pesos e LoRA
A interpretação mais útil do posto para quem trabalha com IA é esta:
O posto mede quantas direções independentes de informação uma transformação consegue preservar ou representar.
A camada $y=Wx+b$
Na camada linear da Aula 05, se
$$ W\in\mathbb{R}^{100\times100},\qquad\mathrm{posto}(W)=10 $$
a saída tem 100 posições, mas $Wx$ vive num subespaço de no máximo 10 dimensões, a imagem de $W$. A dimensão aparente é 100; a dimensionalidade efetiva da transformação é 10. Do mesmo modo, um embedding com 768 dimensões não garante que os dados usem todas essas direções com a mesma importância: o número de coordenadas é um limite superior para o posto, não uma medida dele.
LoRA: o nome vem do posto
O exemplo mais direto está no ajuste fino de modelos de linguagem. Hu et al. (2022) observam que as matrizes de pesos das camadas densas costumam ter posto completo, mas levantam a hipótese de que a atualização dessas matrizes durante a adaptação a uma tarefa tenha um "posto intrínseco" baixo. A proposta, chamada LoRA (Low-Rank Adaptation), congela a matriz pré-treinada $W_0\in\mathbb{R}^{d\times k}$ e escreve a atualização como um produto:
$$ \begin{aligned}&W_0+\Delta W=W_0+BA\\[4pt]&B\in\mathbb{R}^{d\times r},\quad A\in\mathbb{R}^{r\times k}\\[4pt]&r\ll\min(d,k)\end{aligned} $$
Só $B$ e $A$ são treinadas (Hu et al., 2022). Como $\Delta W=BA$ passa por uma dimensão interna $r$, seu posto é no máximo $r$, por mais que a matriz tenha milhares de linhas e colunas. É a origem matemática do nome:
import numpy as np

rng = np.random.default_rng(0)
d, k, r = 1024, 1024, 8

B = rng.normal(size=(d, r))
A = rng.normal(size=(r, k))
delta_W = B @ A                      # 1024 x 1024, mas feita de 8 direções

print("forma de delta_W:", delta_W.shape)
print("posto de delta_W:", np.linalg.matrix_rank(delta_W))

for d, k in [(1024, 1024), (4096, 4096)]:
    cheio = d * k
    lora = r * (d + k)
    print(f"{d}x{k}: matriz cheia {cheio:,} parâmetros; B e A com r={r}: {lora:,} ({cheio // lora}x menos)")
forma de delta_W: (1024, 1024)
posto de delta_W: 8
1024x1024: matriz cheia 1,048,576 parâmetros; B e A com r=8: 16,384 (64x menos)
4096x4096: matriz cheia 16,777,216 parâmetros; B e A com r=8: 65,536 (256x menos)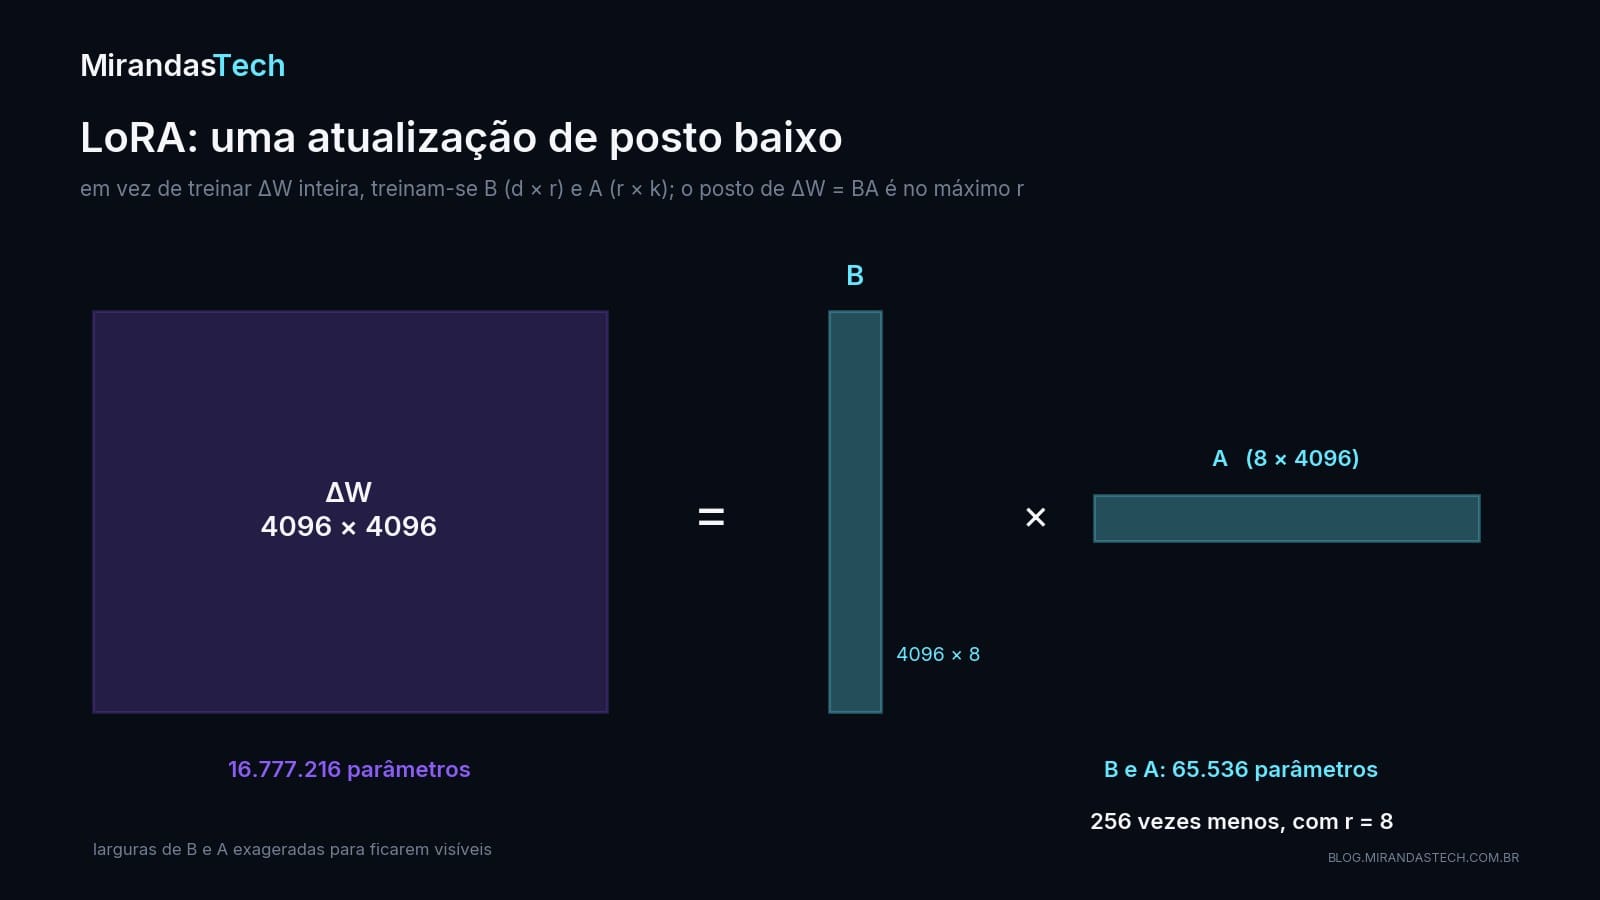
O ganho em escala real é grande. Comparado ao ajuste fino completo do GPT-3 175B com Adam, o LoRA reduz o número de parâmetros treináveis em 10 000 vezes e o uso de memória de GPU em 3 vezes, com qualidade igual ou melhor que o ajuste fino completo em RoBERTa, DeBERTa, GPT-2 e GPT-3, segundo os autores (Hu et al., 2022). A conta deste artigo é mais modesta, uma única matriz, mas mostra de onde vem a economia: a atualização é guardada pelas suas $r$ direções independentes.
Caminho para PCA e SVD
O passo seguinte é descobrir, a partir dos dados, quais direções importam. Se dados com 500 características estiverem aproximadamente concentrados num subespaço de 20 dimensões, técnicas como a PCA podem identificar essas direções principais. A ferramenta por trás disso é a decomposição em valores singulares,
$$ \boxed{A=U\Sigma V^\top} $$
que revela o posto (o matrix_rank da seção 12 já conta valores singulares), as direções importantes, quanta informação cada uma carrega e quanto dá para comprimir. SVD e PCA têm aulas próprias mais adiante na série.
14. Na prática com NumPy
Os comandos essenciais da aula, com as saídas reais.
Resolver um sistema quadrado
import numpy as np

A = np.array([
    [2.0, 1.0],
    [1.0, 1.0]
])
b = np.array([5.0, 3.0])

x = np.linalg.solve(A, b)
print(x)
[2. 1.]O solve exige matriz quadrada de posto completo; se não for o caso, a própria documentação manda usar lstsq (NumPy, 2026).
Calcular o posto
import numpy as np
A = np.array([[1.0, 2.0], [2.0, 4.0]])
print(np.linalg.matrix_rank(A))1Mínimos quadrados
Com o $A$ (3 × 2) e o $b$ da seção 10:
x, residuals, rank, s = np.linalg.lstsq(A, b, rcond=None)A função devolve a solução, a soma dos quadrados dos resíduos, o posto de $A$ e seus valores singulares; a saída completa está na seção 10. Atenção: se $A$ não tiver posto completo nas colunas, como a matriz $[[1,2],[2,4]]$ do bloco anterior, residuals volta vazio (NumPy, 2026).
Mini laboratório: posto e determinante
Antes de executar, tente prever os resultados e relacionar determinante e posto para matrizes quadradas.
import numpy as np

A = np.array([
    [1., 2.],
    [2., 4.]
])

B = np.array([
    [1., 2.],
    [3., 4.]
])

print("Rank A:", np.linalg.matrix_rank(A))
print("Rank B:", np.linalg.matrix_rank(B))
print("Det A:", np.linalg.det(A))
print("Det B:", np.linalg.det(B))
Rank A: 1
Rank B: 2
Det A: 0.0
Det B: -2.0000000000000004A matriz $A$, de posto 1, tem determinante zero; $B$, de posto completo, tem determinante $-2$. O $-2{,}0000000000000004$ é arredondamento de ponto flutuante, e não um erro de conta.
15. Exercícios
1. Resolva por eliminação:
$$ \begin{cases} x+y=5\\ 2x+y=8 \end{cases} $$
2. Para $A=\begin{bmatrix}1&2\\2&4\end{bmatrix}$, qual é $\mathrm{posto}(A)$? Explique sem software.
3. Para
$$ A=\begin{bmatrix}1&0&2\\0&1&3\\0&0&0\end{bmatrix} $$
quantos pivôs existem e qual é o posto?
4. Uma matriz $7\times4$ pode ter posto máximo igual a quanto?
5. Uma matriz $1000\times10$ representando 1000 equações e 10 incógnitas é determinada, superdeterminada ou subdeterminada?
6. O sistema representado por
$$ \left[\begin{array}{cc|c}1&2&4\\0&0&3\end{array}\right] $$
possui solução?
7. Se $A\in\mathbb{R}^{5\times8}$ e $\mathrm{posto}(A)=5$, qual é a nulidade?
8. Explique o que significa dizer que duas colunas são linearmente dependentes.
9. Se $W\in\mathbb{R}^{1000\times1000}$ e $\mathrm{posto}(W)=20$, qual é a interpretação sobre a dimensionalidade efetiva da transformação?
10. Explique a diferença entre dimensão da matriz e posto. Exemplo: $A\in\mathbb{R}^{100\times100}$ com $\mathrm{posto}(A)=5$. O que isso significa geometricamente e em termos de informação?
O que guardar
O mapa da aula cabe numa linha que termina num número:
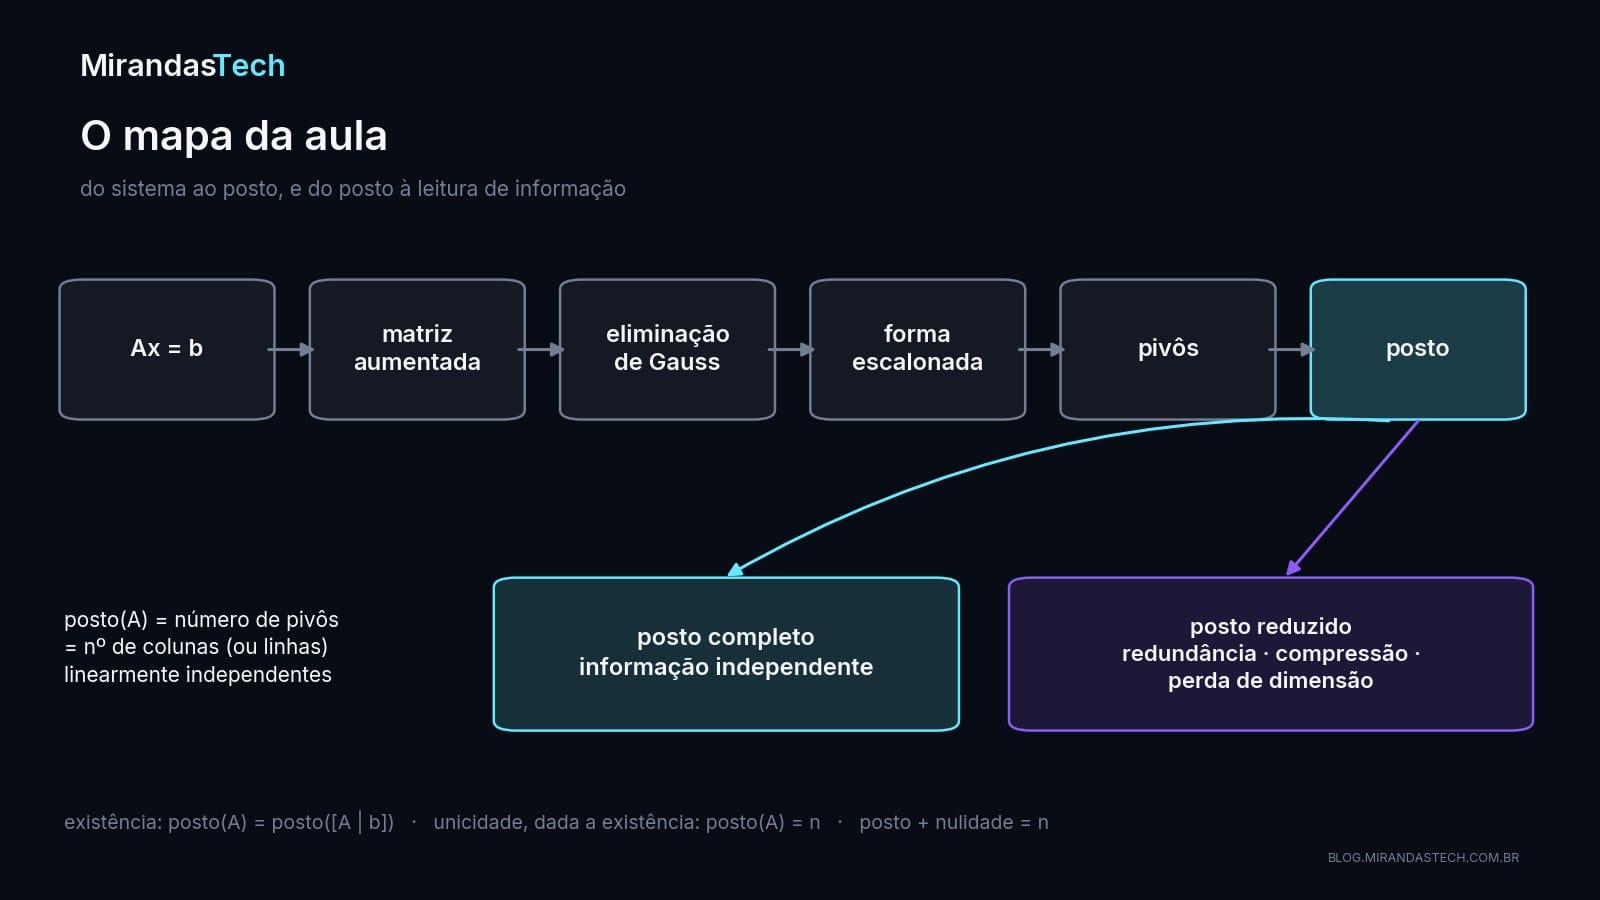
Ao olhar para $Ax=b$, pense: estou procurando uma entrada que, transformada por $A$, produza $b$. A eliminação de Gauss reorganiza o sistema para revelar sua estrutura, os pivôs mostram as direções independentes, e:
$$ \boxed{\begin{aligned}\mathrm{posto}(A)=\;&\text{quantidade de dimensões}\\&\text{independentes preservadas}\\&\text{pela matriz}\end{aligned}} $$
- Operações elementares de linha não mudam as soluções; escalonar é trocar o sistema por outro mais fácil de ler.
- Posto = número de pivôs = colunas independentes = linhas independentes.
- Existe solução se $\mathrm{posto}(A)=\mathrm{posto}([A\,|\,b])$; ela é única se, além disso, o posto é $n$.
- $\mathrm{posto}(A)+\mathrm{nulidade}(A)=n$: o que a matriz não preserva, ela apaga.
- No computador, troque linhas (pivoteamento parcial) e trate o posto como numérico, dependente de uma tolerância.
- Colunas dependentes em $X$ tornam os pesos da regressão não únicos; uma atualização de posto baixo é a ideia do LoRA.
Com esta aula, a sequência da série fica assim:
- Aula 01 — vetores, matrizes e tensores.
- Aula 02 — norma e geometria vetorial.
- Aula 03 — produto escalar.
- Aula 04 — similaridade de cosseno.
- Aula 05 — matrizes como transformações, $Wx+b$.
- Aula 06 — escala, rotação, reflexão e projeção.
- Aula 07 — determinante, volume e perda de informação.
- Aula 08 — matriz inversa, solve e condicionamento.
- Aula 09 — sistemas lineares, eliminação de Gauss e posto.
Na Aula 10, Independência linear, span, base e dimensão, o assunto é o que ficou implícito aqui: o que exatamente significa um conjunto de vetores ser independente, o que é o espaço gerado por eles, base, dimensão, mudança de base e a relação entre base e posto. É o caminho para autovalores, autovetores, PCA e SVD.
Referências
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. §2.1, §2.3, §2.6.2, Teorema 2.24, §4.1 (Teorema 4.3) e §9.2; numeração de seções, equações e teoremas conferida no PDF público (draft de 15/01/2024). doi.org/10.1017/9781108679930
- Moler, Cleve B. Numerical Computing with MATLAB. SIAM, 2004. Cap. 2, Linear Equations, §2.6. doi.org/10.1137/1.9780898717952
- Hu, Edward J.; Shen, Yelong; Wallis, Phillip; Allen-Zhu, Zeyuan; Li, Yuanzhi; Wang, Shean; Wang, Lu; Chen, Weizhu. LoRA: Low-Rank Adaptation of Large Language Models. International Conference on Learning Representations (ICLR), 2022. arxiv.org/abs/2106.09685
- LAPACK. DGESV: solução de sistemas lineares A·X = B. Documentação de referência (explore-html), netlib. Acesso em 9 out. 2026. netlib.org/lapack/explore-html/d8/da6/group__gesv_ga831ce6a40e7fd16295752d18aed2d541.html
- NumPy. numpy.linalg.solve, numpy.linalg.matrix_rank e numpy.linalg.lstsq. Documentação oficial do NumPy. Acesso em 9 out. 2026. numpy.org/doc/stable/reference/generated/numpy.linalg.solve.html; numpy.org/doc/stable/reference/generated/numpy.linalg.matrix_rank.html; numpy.org/doc/stable/reference/generated/numpy.linalg.lstsq.html
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/09-sistemas-lineares-gauss-posto.md.