Independência linear, span, base e dimensão
Entender quando vetores carregam informação nova, como conjuntos de vetores geram espaços e por que base e dimensão são conceitos centrais para representações em IA.
Entender quando vetores carregam informação nova, como conjuntos de vetores geram espaços e por que base e dimensão são conceitos centrais para representações em IA. Pré-requisito: Aula 09 — Sistemas lineares, eliminação de Gauss e posto.
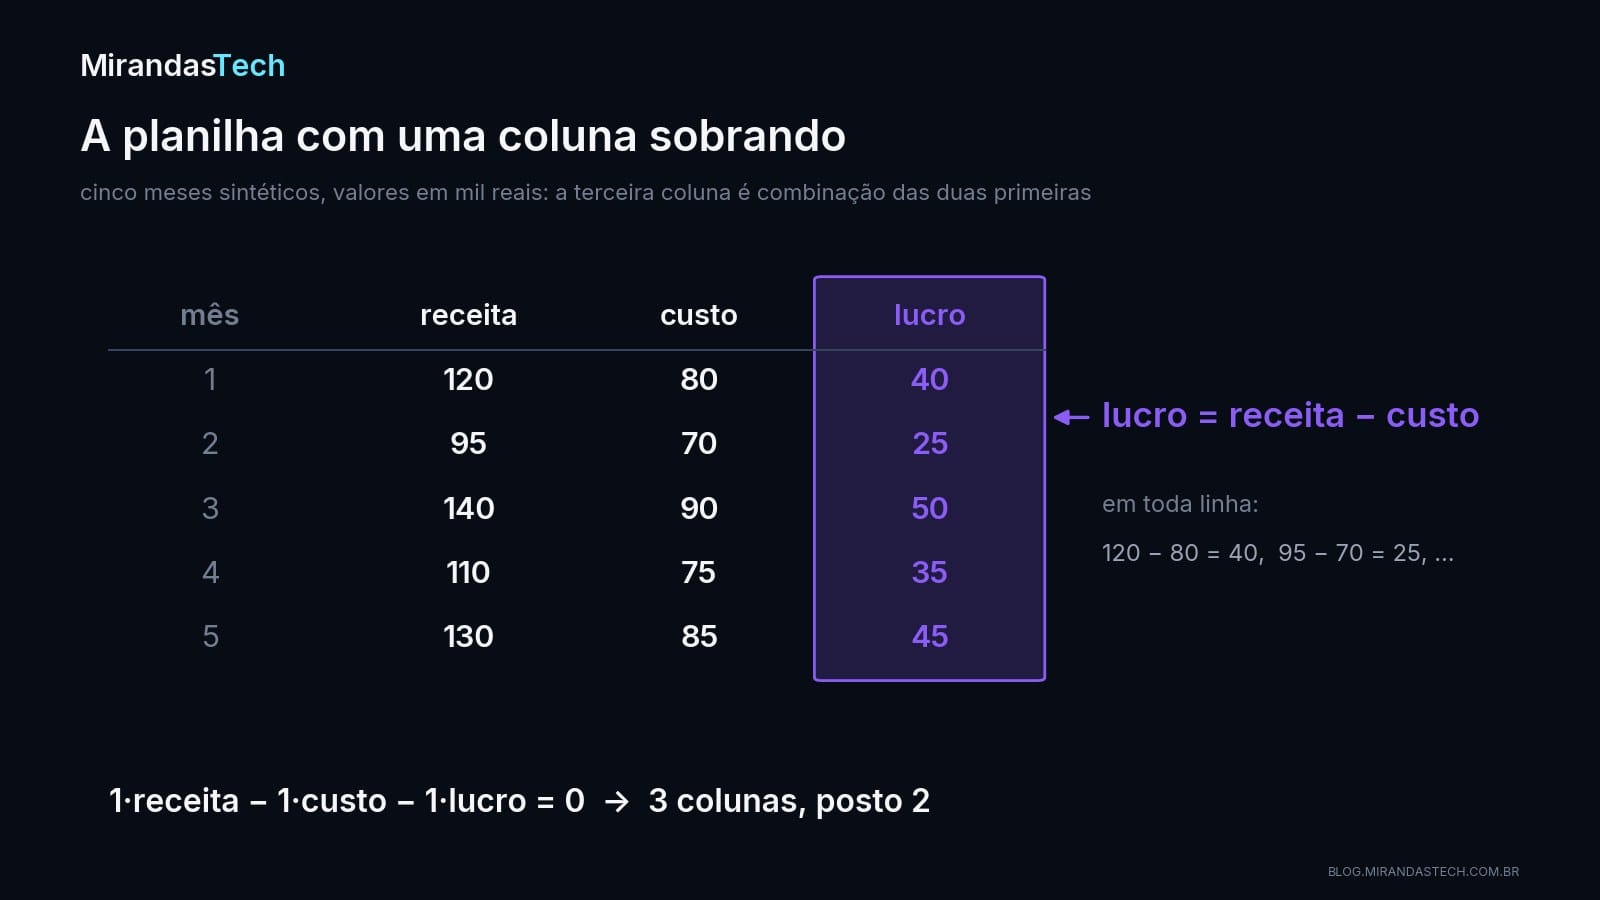
Uma planilha de vendas tem três colunas: receita, custo e lucro. À primeira vista, são três informações por mês. Só que o lucro é a receita menos o custo. Quem conhece as duas primeiras colunas reconstrói a terceira sem olhar para ela. A planilha tem três colunas, mas só duas informações independentes.
Um modelo treinado com essa planilha recebe uma coluna que não acrescenta nada, e o artigo anterior da série mostrou o preço disso na hora de estimar pesos. A mesma pergunta vale para qualquer coleção de vetores, das três colunas de uma planilha às centenas de números de um embedding: quantas direções realmente novas existem aqui?
A álgebra linear responde com quatro ideias encadeadas: combinação linear, span (o espaço gerado), independência linear e base. A quinta, a dimensão, é o número que sai delas. Ao final, você vai conseguir dizer se um conjunto de vetores é independente, à mão e com uma linha de NumPy; descrever o espaço que ele gera; escrever o mesmo vetor em bases diferentes; e separar a dimensão aparente de uma representação da dimensão que os dados de fato ocupam.
1. A pergunta central
Considere três vetores do plano:
$$ v_1=\begin{bmatrix}1\\0\end{bmatrix},\quad v_2=\begin{bmatrix}0\\1\end{bmatrix},\quad v_3=\begin{bmatrix}1\\1\end{bmatrix} $$
O terceiro parece novo, mas
$$ v_3=v_1+v_2 $$
Ele é só a soma dos outros dois. Não acrescenta uma direção independente: tudo o que se constrói com $v_3$ já se constrói com $v_1$ e $v_2$. Essa ideia de redundância é o ponto de partida de tudo o que vem a seguir, e é a mesma da planilha: o lucro está para receita e custo como $v_3$ está para $v_1$ e $v_2$.
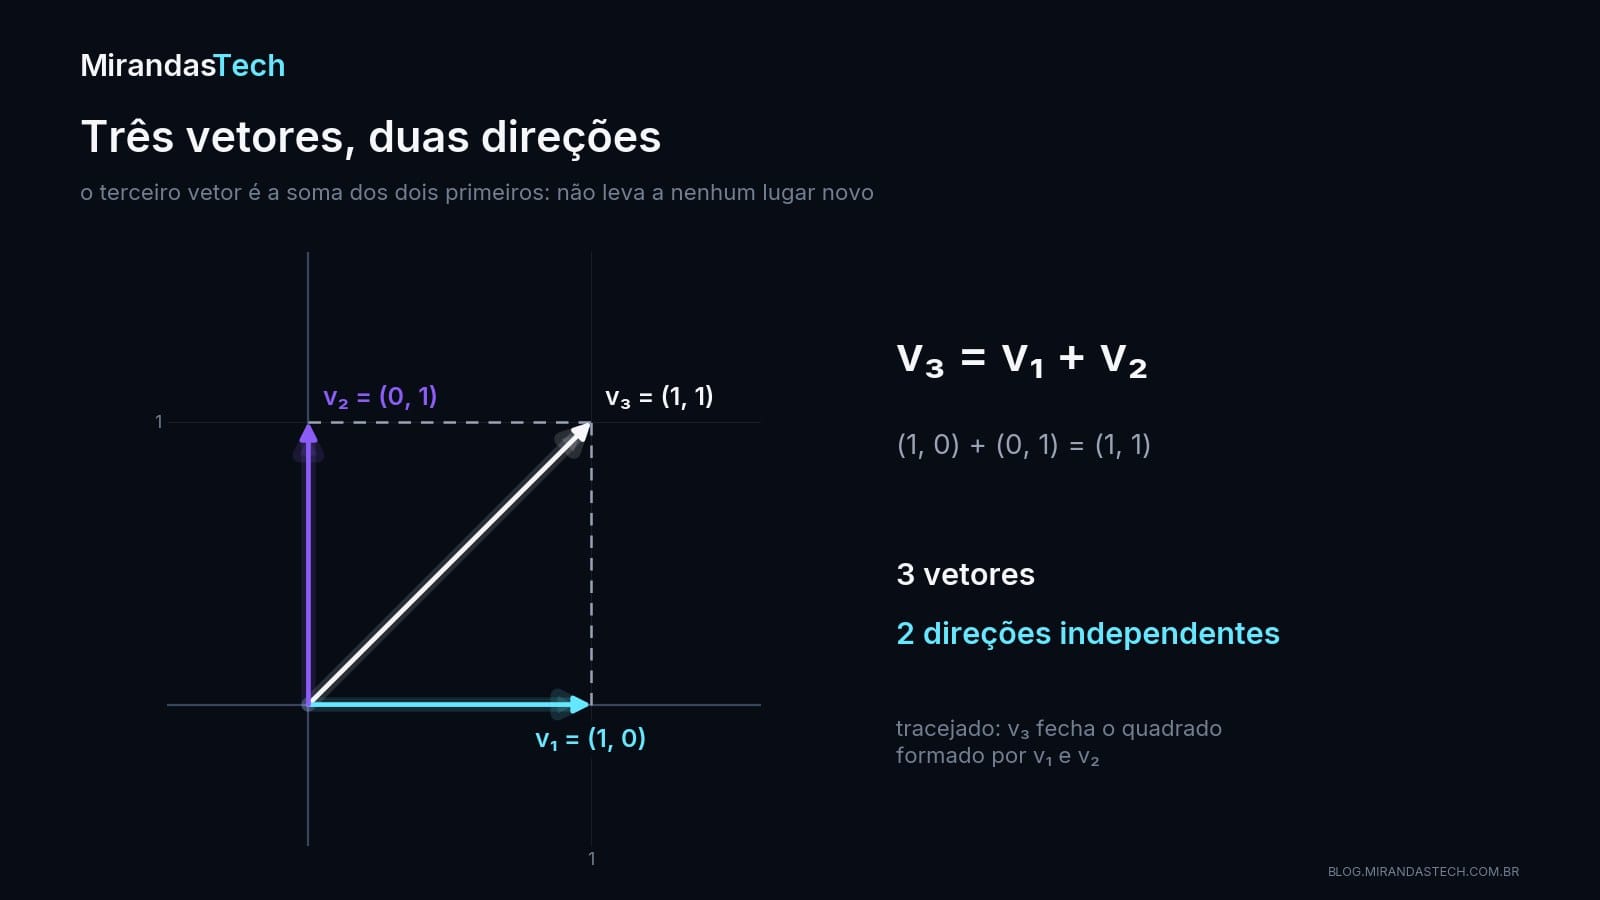
Em álgebra linear, uma pergunta fundamental é: quantas direções realmente novas existem em um conjunto de vetores?
2. Combinação linear: misturar vetores com pesos
A operação que permite "construir" um vetor a partir de outros é a combinação linear: escolher quanto de cada vetor usar e somar tudo.
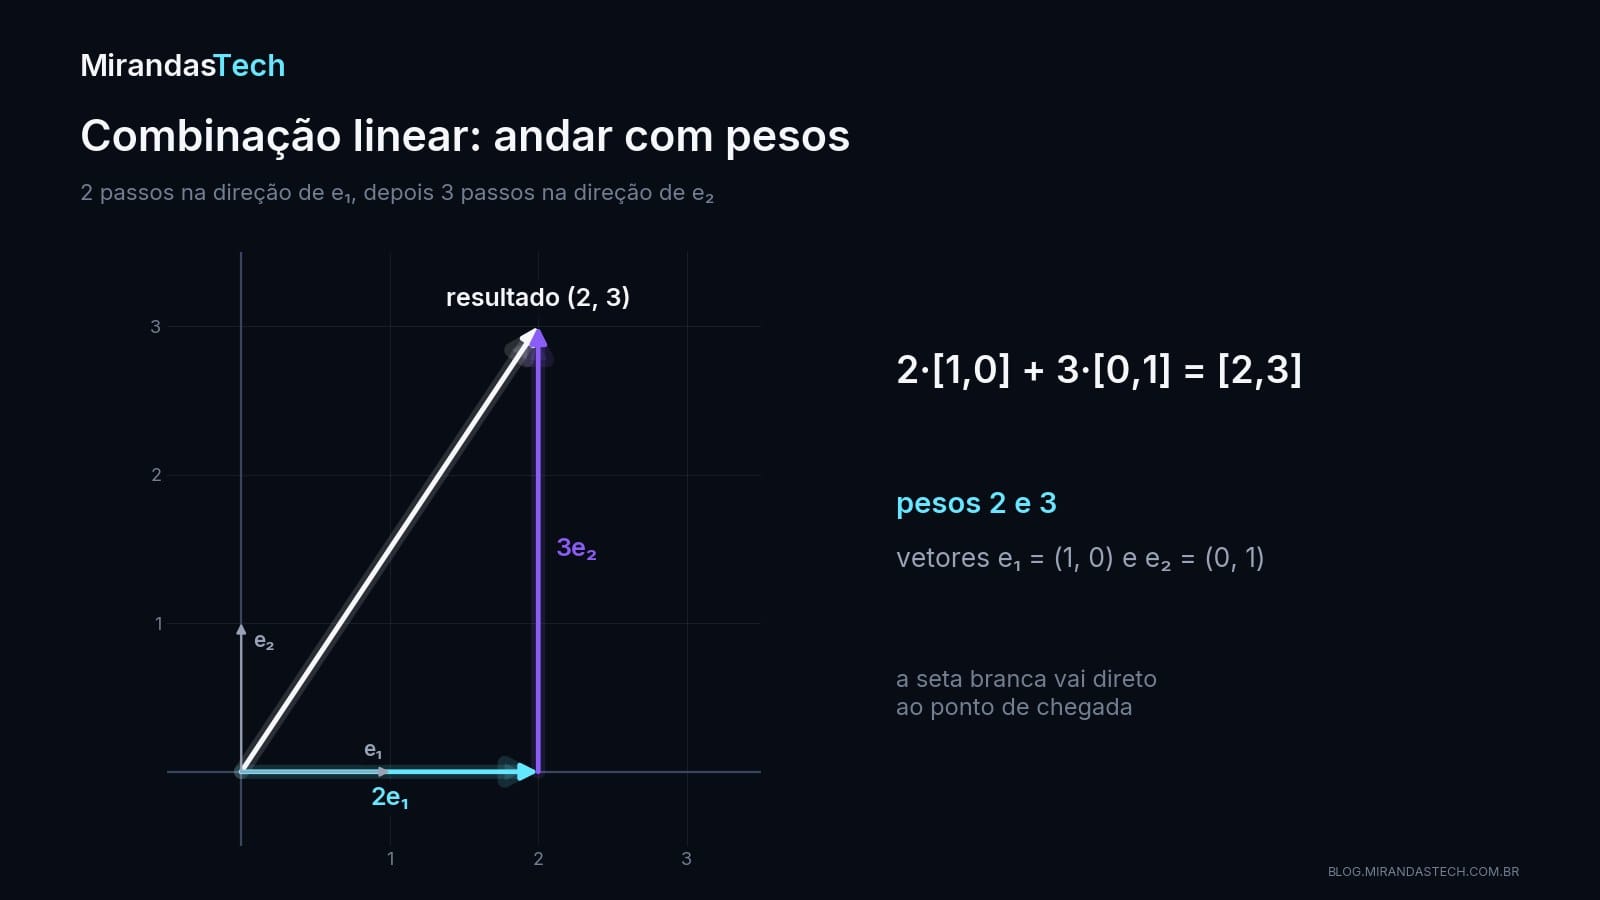
Formalmente, uma combinação linear de vetores $v_1,\ldots,v_k$ é qualquer vetor da forma
$$ a_1v_1+a_2v_2+\cdots+a_kv_k $$
em que:
- $v_1,\ldots,v_k$ são os vetores que se quer misturar, todos do mesmo tamanho;
- $a_1,\ldots,a_k$ são escalares, números reais que funcionam como pesos: quanto de cada vetor entra na mistura (podem ser negativos ou zero);
- $k$ é a quantidade de vetores.
Um exemplo:
$$ 2\begin{bmatrix}1\\0\end{bmatrix}+3\begin{bmatrix}0\\1\end{bmatrix} =\begin{bmatrix}2\\3\end{bmatrix} $$
Isso significa que os vetores canônicos $[1,0]^T$ e $[0,1]^T$ (chamados de $e_1$ e $e_2$; voltam na seção 6) conseguem construir qualquer vetor do plano: para chegar a $[x,y]^T$, basta usar os pesos $x$ e $y$. O $^T$ (transposta) só indica que o vetor, escrito deitado para caber na linha, é uma coluna.
Essa operação já apareceu na série sem esse nome. O produto de uma matriz por um vetor, $Ax$, é exatamente uma combinação linear das colunas de $A$, com os pesos guardados em $x$ (Deisenroth, Faisal & Ong, 2020). É por isso que, na camada linear $y=Wx+b$ do artigo sobre matrizes como transformações, a parte $Wx$ só consegue produzir misturas das colunas de $W$; o viés $b$ apenas desloca esse conjunto inteiro.
3. Span: tudo o que dá para construir
Se a combinação linear é uma receita, o span é o cardápio inteiro. O span (ou espaço gerado) de um conjunto de vetores é o conjunto de todas as combinações lineares possíveis deles (Deisenroth, Faisal & Ong, 2020):
$$ \begin{aligned}\operatorname{span}(v_1,\ldots,v_k)=\{\,&a_1v_1+\cdots+a_kv_k \;:\\ &a_1,\ldots,a_k\in\mathbb{R}\,\}\end{aligned} $$
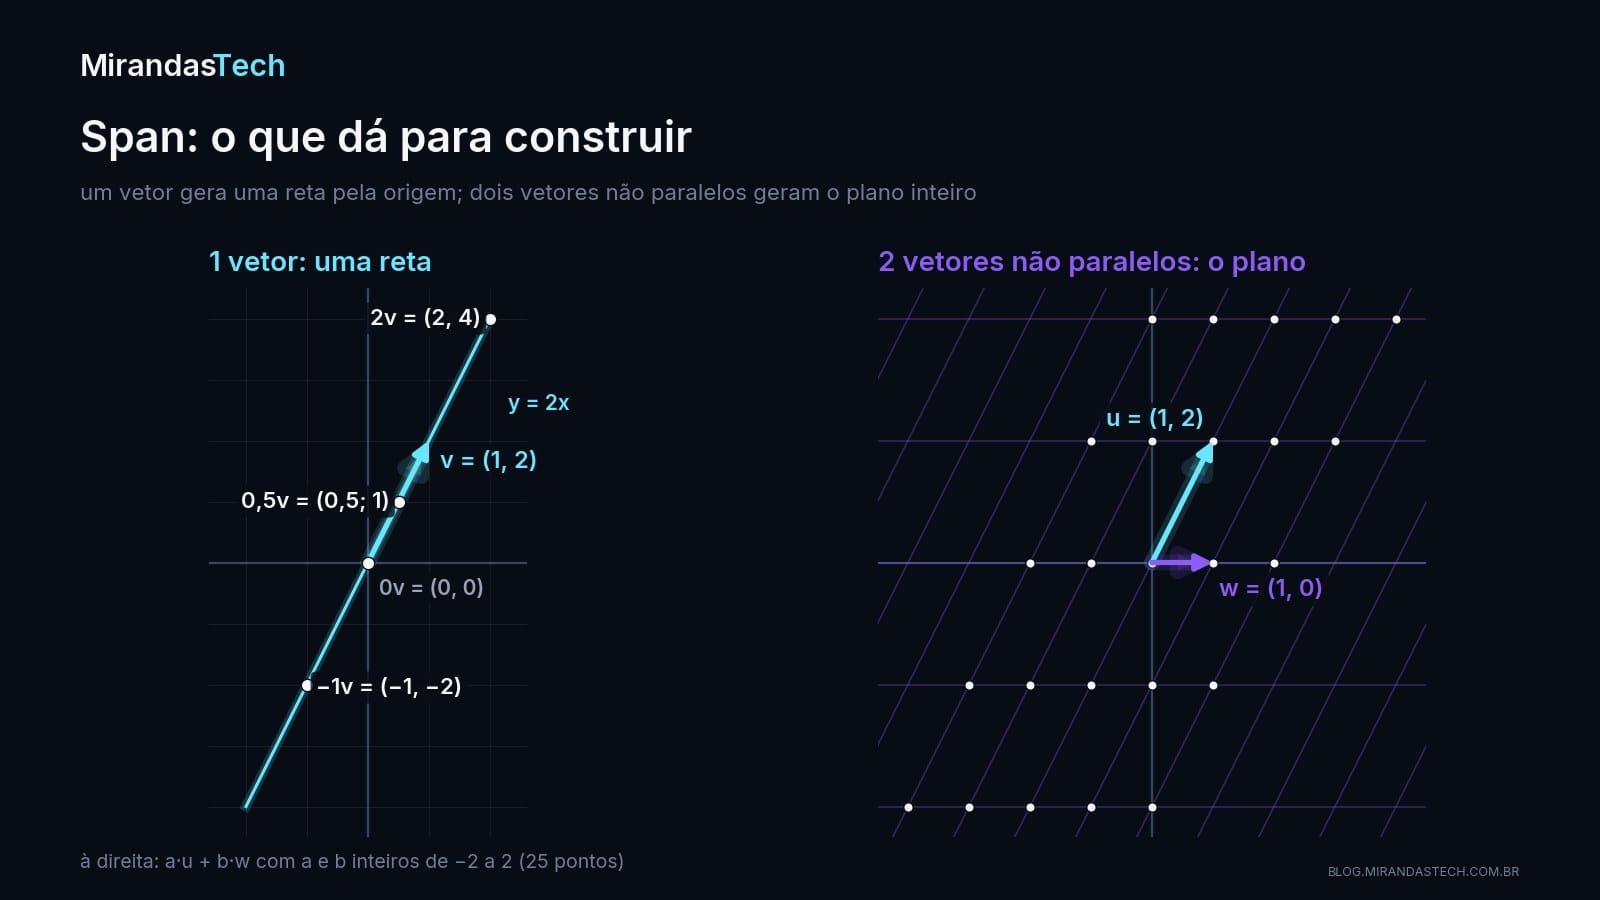
Lendo a notação: as chaves $\{\ \}$ delimitam um conjunto; os dois-pontos se leem "tal que"; $\mathbb{R}$ é o conjunto dos números reais. Em palavras: o span é tudo o que se obtém escolhendo pesos reais quaisquer para os vetores dados e somando.
Com um único vetor,
$$ v=\begin{bmatrix}1\\2\end{bmatrix} $$
o span é uma reta que passa pela origem:
$$ \{av:a\in\mathbb{R}\} $$
Cada $a$ estica, encolhe ou inverte $v$, e todos os resultados caem sobre a reta $y=2x$. Ela passa pela origem porque $a=0$ é permitido: o vetor zero pertence a qualquer span.
Com dois vetores não paralelos no plano, o span é todo o $\mathbb{R}^2$. Já dois vetores paralelos, como $[1,2]^T$ e $[2,4]^T$, continuam gerando só a reta $y=2x$: o segundo não abriu nenhuma direção nova. É a redundância da seção 1 de novo, e ela tem nome.
4. Dependência e independência linear
Dependência é o nome preciso da redundância: um conjunto é dependente quando seus vetores conseguem se anular uns aos outros com pesos que não são todos zero.
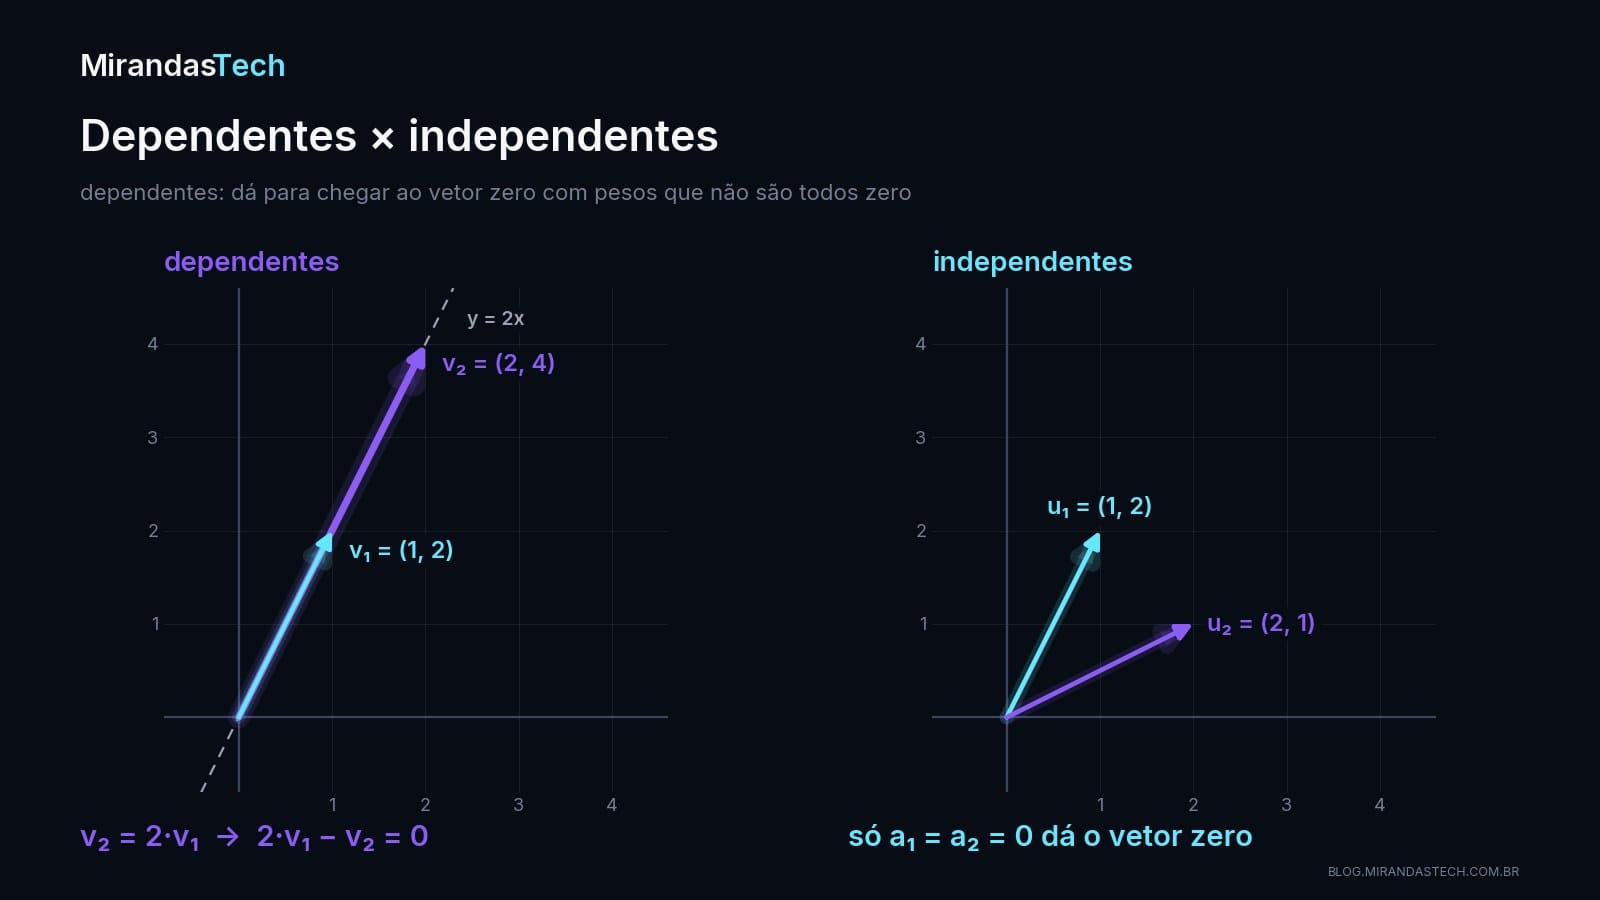
Formalmente, os vetores $v_1,\ldots,v_k$ são linearmente dependentes se existe uma combinação não trivial que produz zero:
$$ a_1v_1+\cdots+a_kv_k=0 $$
com pelo menos um coeficiente diferente de zero. O $0$ do lado direito é o vetor zero, com todas as entradas nulas. "Não trivial" é justamente a exigência de que nem todos os $a_i$ sejam zero, porque com todos os pesos zerados qualquer conjunto produz o vetor zero (Deisenroth, Faisal & Ong, 2020).
Exemplo:
$$ v_1=\begin{bmatrix}1\\2\end{bmatrix},\quad v_2=\begin{bmatrix}2\\4\end{bmatrix} $$
Como
$$ v_2=2v_1 $$
podemos escrever
$$ 2v_1-v_2=0 $$
com pesos $a_1=2$ e $a_2=-1$, nenhum deles zero. Logo, os vetores são dependentes. Os três vetores da seção 1 também são: $v_1+v_2-v_3=0$.
Independência linear
Um conjunto é linearmente independente quando a única maneira de obter o vetor zero é
$$ a_1=a_2=\cdots=a_k=0 $$
ou seja, quando a única combinação que zera é a trivial. A intuição:
- independente: cada vetor acrescenta uma direção nova;
- dependente: pelo menos um vetor é redundante, porque pode ser escrito como combinação dos outros.
Essa interpretação se conecta diretamente ao posto (rank) do artigo anterior, que conta quantas colunas independentes uma matriz tem. A próxima seção transforma essa ligação num teste.
5. Testando independência com uma matriz
Para decidir se $v_1,\ldots,v_k$ são independentes, coloque-os como colunas de uma matriz:
$$ A=\begin{bmatrix}|&|& &|\\v_1&v_2&\cdots&v_k\\|&|&&|\end{bmatrix} $$
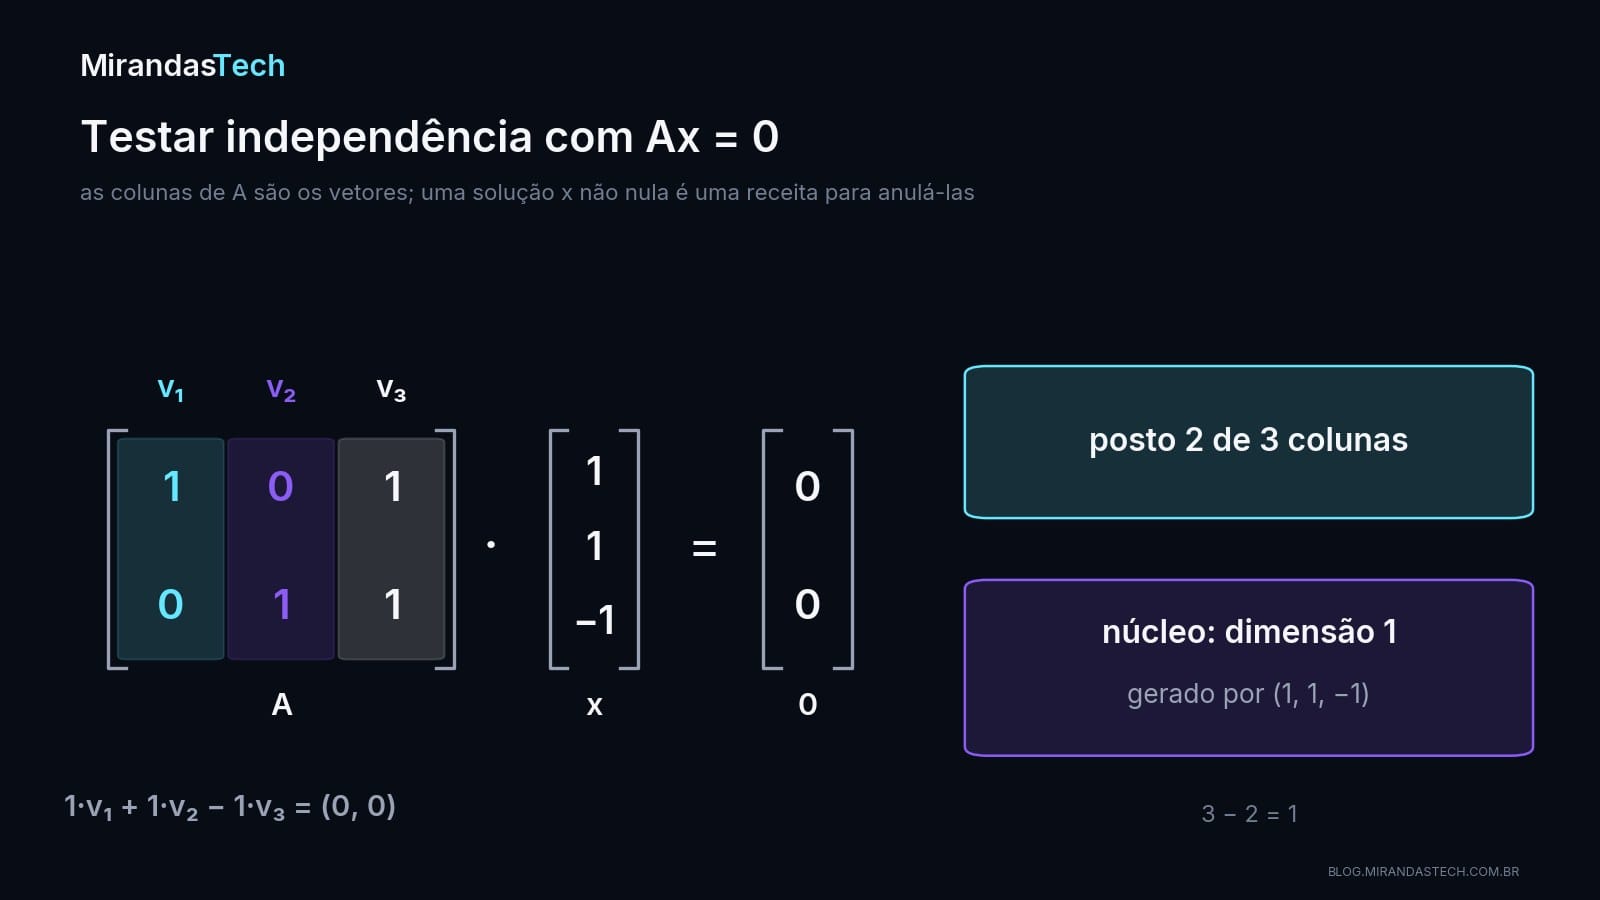
As barras verticais indicam que cada $v_i$ ocupa uma coluna inteira. Resolver
$$ Ax=0 $$
responde se existe uma combinação não trivial das colunas que produz zero. O motivo é a observação da seção 2: com $x=[x_1,\ldots,x_k]^T$, o produto $Ax$ é $x_1v_1+\cdots+x_kv_k$, e as entradas de $x$ fazem o papel dos pesos $a_i$.
O conjunto das soluções de $Ax=0$ é o núcleo de $A$ (em inglês, null space). Se o núcleo contém apenas $x=0$, as colunas são independentes. Pelo teorema do posto e da nulidade, apresentado no artigo sobre sistemas lineares e posto, isso equivale a dizer que o posto de $A$ é igual a $k$, o número de vetores. Na prática, o teste vira uma linha de código.
A matriz da aula tem como colunas exatamente os três vetores da seção 1:
import numpy as np

A = np.array([
    [1., 0., 1.],
    [0., 1., 1.]
])

print("rank:", np.linalg.matrix_rank(A))
rank: 2A matriz possui três colunas, mas posto 2. Logo, uma das colunas é redundante. O teste completo, aplicado também aos pares das seções 3 e 4, e a combinação que anula as colunas:
import numpy as np

def testar(*vetores):
    """Põe os vetores como colunas de A: são independentes se e só se posto(A) = número de vetores."""
    A = np.column_stack(vetores).astype(float)
    posto = np.linalg.matrix_rank(A)
    veredito = "independentes" if posto == A.shape[1] else "dependentes"
    print(f"{len(vetores)} vetores, posto {posto}: {veredito}")

testar([1, 2], [2, 4])
testar([1, 2], [2, 1])
testar([1, 0], [0, 1], [1, 1])

# A combinação não trivial que zera as colunas de A = [v1 v2 v3]
A = np.array([[1., 0., 1.],
              [0., 1., 1.]])
x = np.array([1., 1., -1.])
print("A @ x =", A @ x)
2 vetores, posto 1: dependentes
2 vetores, posto 2: independentes
3 vetores, posto 2: dependentes
A @ x = [0. 0.]Três vetores em $\mathbb{R}^2$ nunca podem ser independentes: o posto de uma matriz $2\times3$ é no máximo 2. O vetor $x=(1,1,-1)$ é a relação $v_1+v_2-v_3=0$ escrita como solução de $Ax=0$. O matrix_rank trabalha em ponto flutuante e decide o posto com uma tolerância (NumPy, 2026); o artigo anterior explica por que esse "posto numérico" pede cuidado com dados reais.
6. Base: gerar tudo, sem sobra
Juntando as duas ideias anteriores: uma base de um espaço precisa satisfazer duas propriedades (Deisenroth, Faisal & Ong, 2020):
- gerar todo o espaço (o span dela é o espaço inteiro);
- ser linearmente independente (nenhum vetor sobrando).
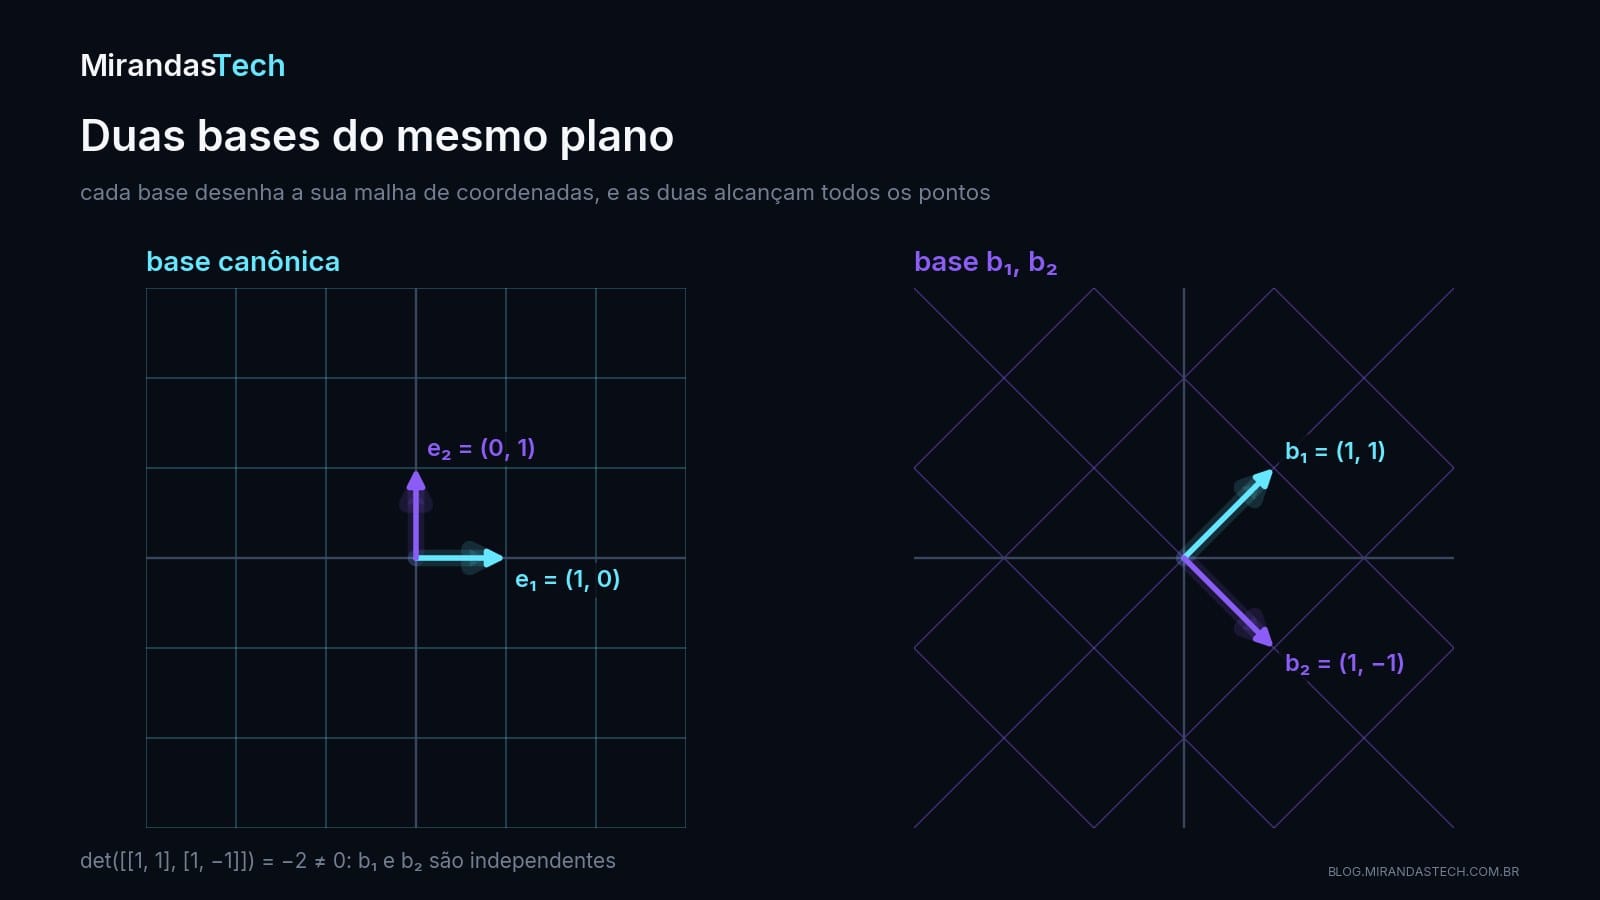
A primeira condição garante que nada fica de fora; a segunda, que nada é desperdiçado. Para $\mathbb{R}^2$, a base canônica é
$$ e_1=\begin{bmatrix}1\\0\end{bmatrix},\quad e_2=\begin{bmatrix}0\\1\end{bmatrix} $$
Mas ela não é a única base. Também podemos usar
$$ b_1=\begin{bmatrix}1\\1\end{bmatrix},\quad b_2=\begin{bmatrix}1\\-1\end{bmatrix} $$
Eles são independentes, porque um não é múltiplo do outro, e geram o plano inteiro, porque são dois vetores não paralelos em $\mathbb{R}^2$. Os três vetores da seção 1 geram o plano, mas não formam uma base: falham na segunda condição.
7. Coordenadas dependem da base
Ter mais de uma base tem uma consequência que costuma surpreender: o mesmo vetor ganha números diferentes, conforme a base usada para descrevê-lo.
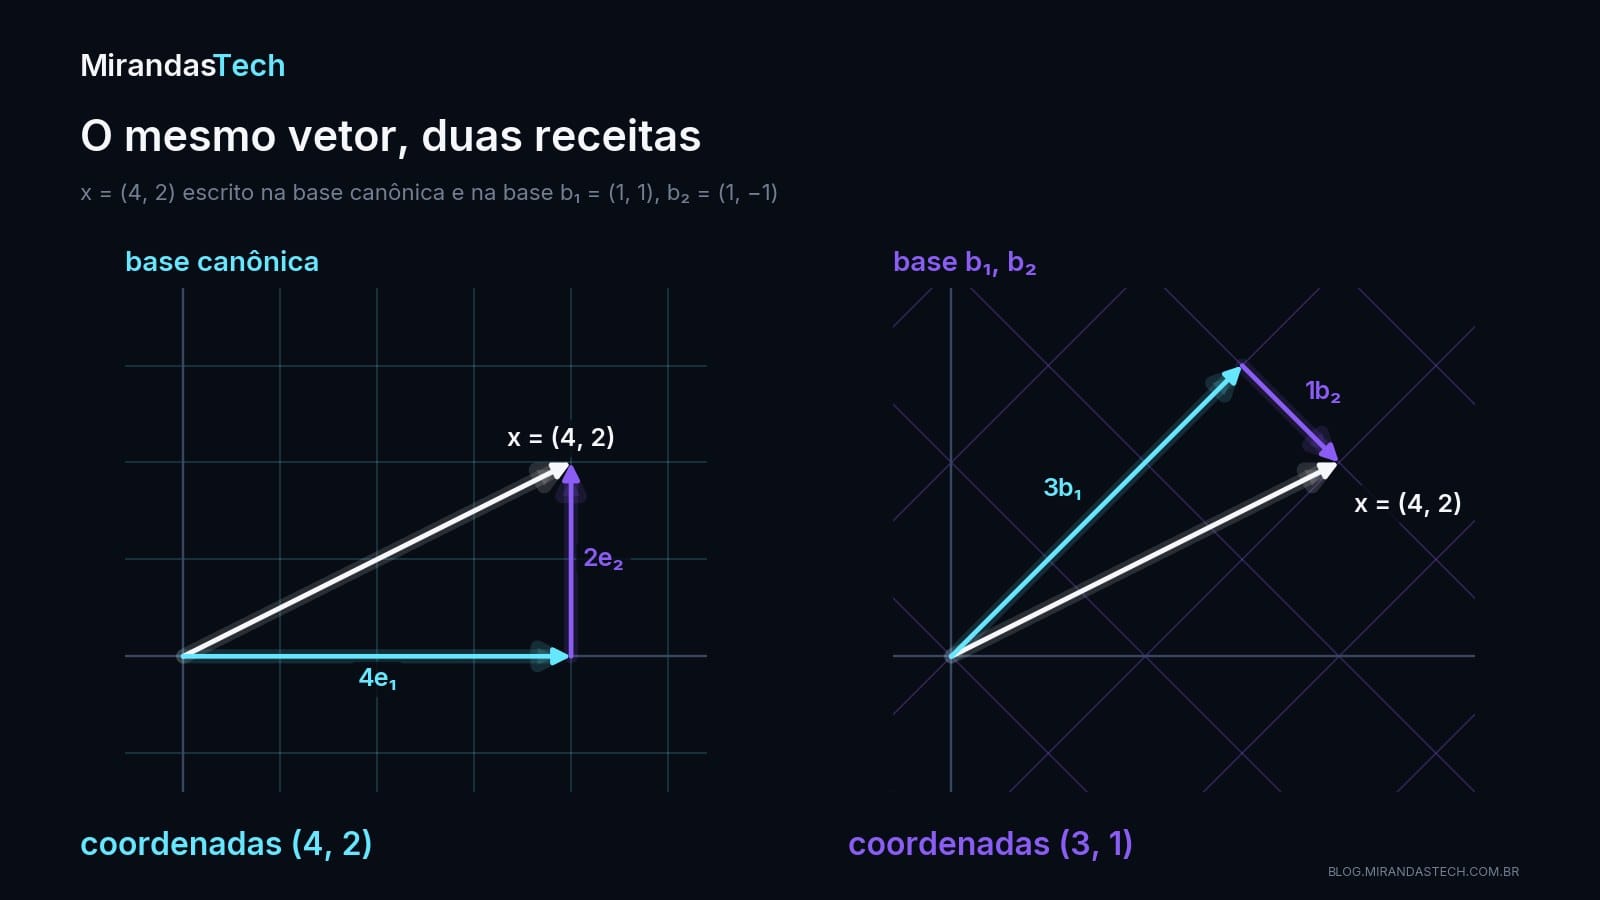
O vetor
$$ x=\begin{bmatrix}4\\2\end{bmatrix} $$
tem coordenadas $(4,2)$ na base canônica, porque $x=4e_1+2e_2$. Na base $b_1=[1,1]^T$, $b_2=[1,-1]^T$, procuramos os pesos $\alpha$ e $\beta$ tais que
$$ x=\alpha b_1+\beta b_2 $$
Aqui $\alpha$ (alfa) e $\beta$ (beta) são as coordenadas procuradas: quanto de $b_1$ e quanto de $b_2$ é preciso somar para chegar a $x$. Comparando entrada por entrada,
$$ \alpha+\beta=4,\qquad \alpha-\beta=2 $$
Somando as duas equações, $2\alpha=6$. O resultado é
$$ \alpha=3,\qquad \beta=1 $$
Confira: $3[1,1]^T+1[1,-1]^T=[4,2]^T$. O mesmo objeto pode ter representações numéricas diferentes em bases diferentes.
Em forma de matriz, pondo $b_1$ e $b_2$ como colunas de $B$ e as coordenadas em $c=[\alpha,\beta]^T$, a equação é $Bc=x$, um sistema linear. Como $B$ é quadrada e suas colunas são independentes, ela é invertível, e $c=B^{-1}x$. O artigo sobre matriz inversa explica por que, no código, se usa solve em vez de calcular a inversa:
import numpy as np

B = np.array([
    [1.,  1.],
    [1., -1.]
])

x = np.array([4., 2.])
coords = np.linalg.solve(B, x)
print(coords)  # [3. 1.]
[3. 1.]Lido ao contrário, $x=Bc$ diz que a matriz $B$ converte as coordenadas na base $b_1,b_2$ em coordenadas na base canônica (Deisenroth, Faisal & Ong, 2020). É a forma mais simples de mudança de base, assunto da seção 10.
8. Dimensão: o número que não depende da base
Bases diferentes, coordenadas diferentes; mas uma coisa não muda. A dimensão de um espaço é o número de vetores em qualquer base desse espaço:
$$ \dim(\mathbb{R}^2)=2,\qquad \dim(\mathbb{R}^3)=3 $$
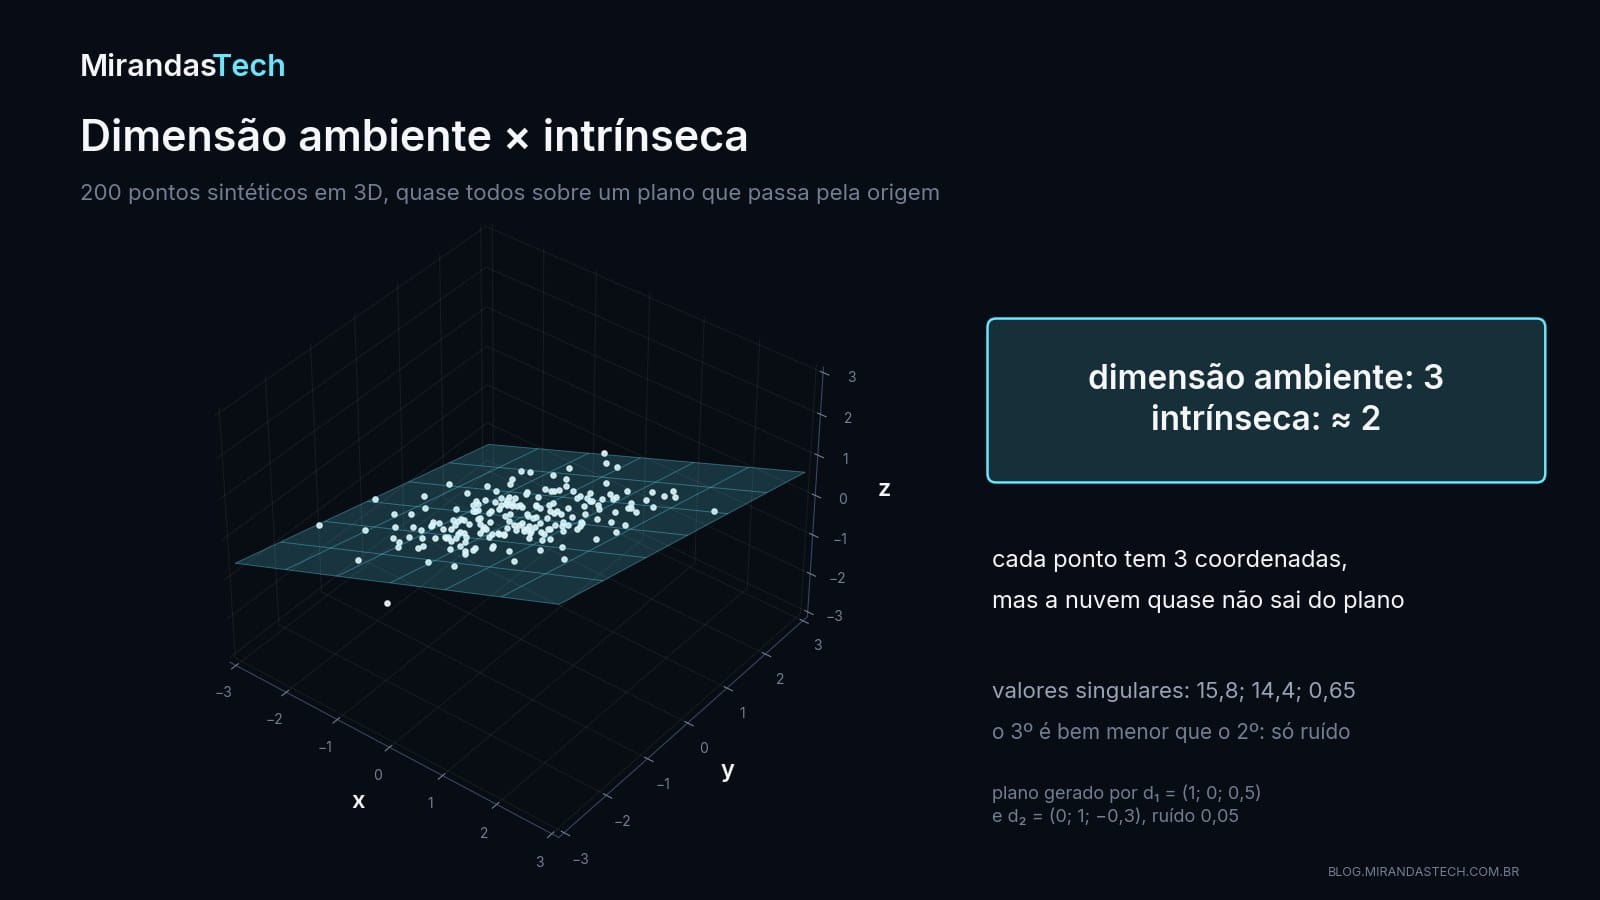
O símbolo $\dim$ se lê "dimensão de". A definição só faz sentido porque todas as bases de um mesmo espaço têm a mesma quantidade de vetores (Deisenroth, Faisal & Ong, 2020): $e_1,e_2$ e $b_1,b_2$ são bases diferentes de $\mathbb{R}^2$, e as duas têm dois vetores. A dimensão do span de um conjunto conta as direções realmente novas: os três vetores da seção 1 geram um espaço de dimensão 2, e o posto da matriz que os tem como colunas é 2 justamente por isso.
Se um conjunto de dados vive em $\mathbb{R}^{1000}$, mas todos os pontos estão próximos de um plano, sua dimensionalidade ambiente é 1000, enquanto sua dimensionalidade intrínseca pode ser muito menor. Um exemplo sintético: 500 pontos em $\mathbb{R}^{1000}$ montados como combinações de apenas duas direções, com e sem um pouco de ruído.
import numpy as np

rng = np.random.default_rng(0)           # dados sintéticos, semente fixa
n, D = 500, 1000                          # 500 pontos em R^1000

direcoes = rng.standard_normal((2, D))    # duas direções de R^1000
coords = rng.standard_normal((n, 2))      # cada ponto = a*d1 + b*d2
X_plano = coords @ direcoes               # todos exatamente num plano pela origem
X = X_plano + 0.01 * rng.standard_normal((n, D))  # um pouco de ruído

print("formato:", X.shape)
print("posto sem ruído:", np.linalg.matrix_rank(X_plano))
print("posto com ruído:", np.linalg.matrix_rank(X))

s = np.linalg.svd(X, compute_uv=False)    # "força" de cada direção, em ordem decrescente
print("6 maiores valores singulares:", ", ".join(f"{v:.1f}" for v in s[:6]))
print(f"menor valor singular: {s[-1]:.2f}")
formato: (500, 1000)
posto sem ruído: 2
posto com ruído: 500
6 maiores valores singulares: 719.5, 670.0, 0.5, 0.5, 0.5, 0.5
menor valor singular: 0.09Sem ruído, cada ponto é uma combinação de duas direções, e o posto da matriz de dados é 2. Com ruído, o posto vira 500, o máximo possível para uma matriz $500\times1000$: tecnicamente, nenhuma linha é combinação exata das outras. A estrutura, porém, continua visível. Os valores singulares, que a série vai estudar com a SVD, medem quanto os dados se estendem, a partir da origem, em cada uma das direções que a SVD encontra; com dados centrados, o quadrado de cada um dividido pelo número de pontos é a variância naquela direção (Deisenroth, Faisal & Ong, 2020). Os dois primeiros passam de 600; os outros 498 ficam todos entre 0,09 e 0,53, mais de mil vezes menores. O posto diz 500; a geometria diz 2.
9. Ligação com embeddings e features redundantes
Um embedding pode ter 768 componentes, o tamanho das representações do BERT-base (Devlin et al., 2019), ou 1536, o tamanho padrão do text-embedding-3-small da OpenAI (OpenAI, 2026). Isso indica a dimensão do espaço de representação; como a Aula 09 adiantou, não garante que os dados usem todas as direções com a mesma importância. Há evidência medida disso: nas representações contextuais de palavras do BERT, do ELMo e do GPT-2, os vetores ocupam um cone estreito em vez de se espalharem por todas as direções (Ethayarajh, 2019). Os vetores que alimentam a busca semântica e o RAG vivem em espaços como $\mathbb{R}^{768}$ ou $\mathbb{R}^{1536}$, e nada impede que, como os pontos da seção anterior, ocupem muito menos direções do que o espaço oferece.
A versão mais concreta do problema está numa tabela de features. Voltando à planilha da abertura, com números sintéticos:
import numpy as np

# Planilha sintética: 5 meses, valores em milhares de reais
receita = np.array([120., 95., 140., 110., 130.])
custo   = np.array([ 80., 70.,  90.,  75.,  85.])
lucro   = receita - custo

X = np.column_stack([receita, custo, lucro])
print("colunas:", X.shape[1], "| posto:", np.linalg.matrix_rank(X))

c = np.array([1., -1., -1.])   # receita - custo - lucro
print("X @ c =", X @ c)
colunas: 3 | posto: 2
X @ c = [0. 0. 0. 0. 0.]Três colunas, posto 2, e uma combinação não trivial, $c=(1,-1,-1)$, que zera todas as linhas: as colunas são linearmente dependentes. Diferentemente das colunas de metros e pés quadrados da Aula 09, aqui nenhuma coluna é múltipla de outra: olhando os pares, tudo parece independente. A redundância só aparece com as três juntas, e é por isso que o teste usa o conjunto inteiro. Numa regressão linear, isso é a multicolinearidade exata, que deixa os pesos sem solução única. O artigo anterior mostra o efeito, e o post Ridge, Lasso e Elastic Net, uma das saídas.
Perguntas que aparecerão mais adiante na série:
- existem direções redundantes?
- podemos encontrar uma base melhor?
- podemos representar os dados com menos dimensões?
Essas perguntas conduzem diretamente à PCA (análise de componentes principais) e à SVD (decomposição em valores singulares).
10. Mudança de base e IA
Uma matriz pode transformar coordenadas de uma base para outra, como a matriz $B$ da seção 7. Em IA, as redes profundas compõem várias transformações para aprender representações que tornam mais fácil extrair a informação útil para a tarefa (Bengio, Courville & Vincent, 2013). Uma forma mental útil:
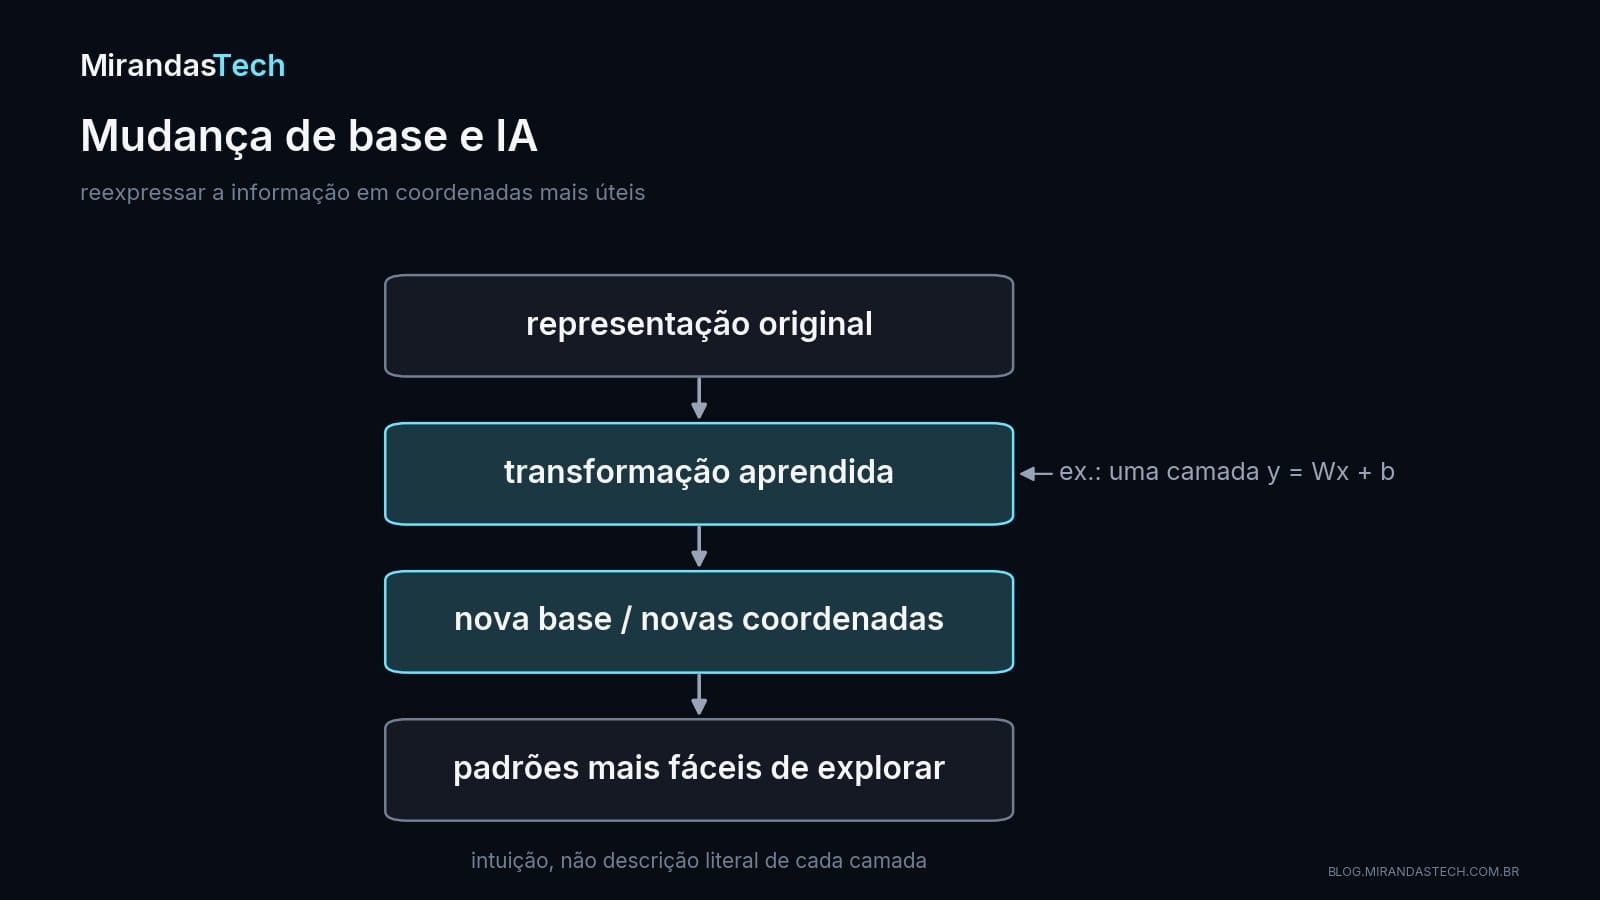
Não significa que toda camada neural execute literalmente uma mudança de base clássica: uma camada pode mudar a dimensão, perder posto ou aplicar uma não linearidade depois da parte linear. Mas a intuição de reexpressar informação em coordenadas mais úteis é poderosa. A seção 7 mostrou a versão exata dessa ideia: o vetor $x$ não mudou, só os números que o descrevem.
A PCA é o exemplo clássico de mudança de base escolhida pelos dados: ela centraliza os dados (subtrai a média) e troca a base canônica por uma base ortonormal ordenada pela variância dos dados, e descartar as últimas direções reduz a dimensão perdendo só a variância que elas carregavam, pouca quando os dados têm estrutura como os da seção 8 (Deisenroth, Faisal & Ong, 2020). Esse é o assunto das aulas sobre autovetores, SVD e PCA, mais adiante na série.
11. Na prática com NumPy
Os dois comandos da aula resolvem as duas perguntas centrais:
- Estes vetores são independentes? Ponha-os como colunas e compare
np.linalg.matrix_rank(A)com o número de colunas (seção 5). - Quais são as coordenadas de $x$ nesta base? Ponha a base como colunas de $B$ e use
np.linalg.solve(B, x)(seção 7).
O mini laboratório abaixo junta os dois: antes de calcular coordenadas, confere se o conjunto é mesmo uma base. Antes de executar, tente prever as três saídas.
import numpy as np

def coordenadas(base, x):
    """Coordenadas de x na base dada (vetores da base como colunas de B)."""
    B = np.column_stack(base).astype(float)
    n = B.shape[0]
    if B.shape[1] != n or np.linalg.matrix_rank(B) < n:
        raise ValueError(f"não é base de R^{n}: {B.shape[1]} vetores, posto {np.linalg.matrix_rank(B)}")
    c = np.linalg.solve(B, x)
    assert np.allclose(B @ c, x)   # B @ c reconstrói o mesmo vetor
    return c

x = np.array([4., 2.])
print("base canônica:", coordenadas([[1, 0], [0, 1]], x))
print("base b1, b2:  ", coordenadas([[1, 1], [1, -1]], x))
try:
    coordenadas([[1, 2], [2, 4]], x)
except ValueError as erro:
    print("[1,2] e [2,4]:", erro)
base canônica: [4. 2.]
base b1, b2: [3. 1.]
[1,2] e [2,4]: não é base de R^2: 2 vetores, posto 1Na base canônica, as coordenadas são as próprias entradas do vetor; na base $b_1,b_2$, são $(3,1)$, como na seção 7. O par $[1,2]^T$, $[2,4]^T$ é recusado: com posto 1, ele gera só uma reta, e um vetor fora dela, como $(4,2)$, não tem coordenadas nesse conjunto.
12. Erros comuns
- Confundir número de vetores com dimensão do espaço gerado. Três vetores em $\mathbb{R}^2$ geram no máximo o plano, de dimensão 2 (seção 8).
- Achar que qualquer conjunto que gera o espaço é uma base. Ele também precisa ser independente; $v_1,v_2,v_3$ da seção 1 geram o plano e não são base (seção 6).
- Pensar que coordenadas são o vetor em si. Coordenadas dependem da base escolhida: $(4,2)$ e $(3,1)$ descrevem o mesmo vetor (seção 7).
- Confundir dimensão ambiente com dimensionalidade efetiva dos dados. 1000 coordenadas por ponto não significam 1000 direções ocupadas (seção 8).
13. Exercícios
1. Os vetores $[1,2]^T$ e $[3,6]^T$ são independentes? Por quê?
2. Qual é o span de um único vetor não nulo em $\mathbb{R}^3$?
3. Verifique se $[1,0]^T$ e $[1,1]^T$ formam uma base de $\mathbb{R}^2$.
4. Expresse $[5,1]^T$ na base $b_1=[1,1]^T$, $b_2=[1,-1]^T$.
5. Uma matriz tem 100 colunas e posto 7. O que isso sugere sobre independência entre as colunas?
6. Explique a diferença entre "o vetor" e "as coordenadas do vetor em uma base".
O que guardar
As ideias desta aula formam uma cadeia, e cada elo responde a uma pergunta:
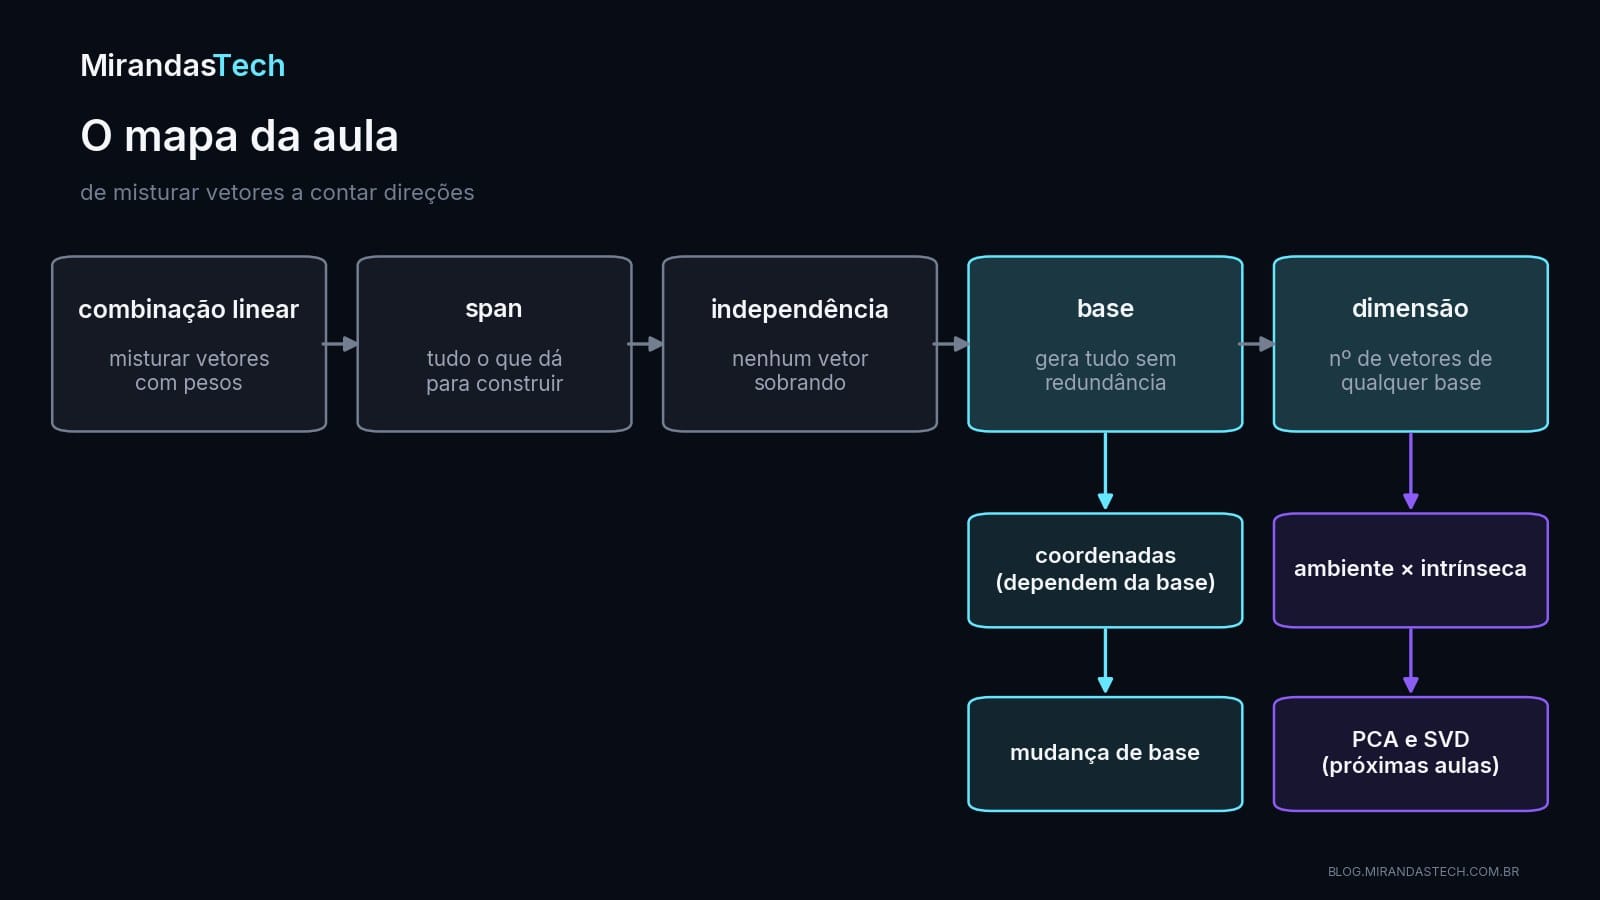
- Uma combinação linear mistura vetores com pesos; $Ax$ é uma combinação linear das colunas de $A$.
- O span é tudo o que as combinações alcançam: uma reta, um plano, o espaço inteiro.
- Vetores são independentes se só a combinação com todos os pesos zero dá o vetor zero; no computador, se o posto da matriz de colunas é igual ao número de vetores.
- Base = gera o espaço + é independente. Dimensão = número de vetores de qualquer base.
- Coordenadas são relativas à base; o vetor não muda quando a base muda.
- Muitas coordenadas não significam muitas direções ocupadas: dimensão ambiente e intrínseca são coisas diferentes.
Com esta aula, a sequência da série fica assim:
- Aula 01 — vetores, matrizes e tensores.
- Aula 02 — norma e geometria vetorial.
- Aula 03 — produto escalar.
- Aula 04 — similaridade de cosseno.
- Aula 05 — matrizes como transformações, $Wx+b$.
- Aula 06 — escala, rotação, reflexão e projeção.
- Aula 07 — determinante, volume e perda de informação.
- Aula 08 — matriz inversa, solve e condicionamento.
- Aula 09 — sistemas lineares, eliminação de Gauss e posto.
- Aula 10 — independência linear, span, base e dimensão.
Na Aula 11, Os quatro subespaços fundamentais, o posto e a dimensão se encontram: espaço coluna, espaço linha, núcleo e núcleo à esquerda, os quatro espaços que toda matriz carrega, cada um com sua base e sua dimensão.
Referências
- Deisenroth, Marc Peter; Faisal, A. Aldo; Ong, Cheng Soon. Mathematics for Machine Learning. Cambridge University Press, 2020. §2.2.4, §2.5 (Definições 2.11 e 2.12), §2.6.1 (Definições 2.13 e 2.14), §2.7.1 (Definição 2.18), §2.7.2 (Teorema 2.20) e cap. 10 (§10.2.2, §10.3.1 e §10.4); numeração de seções, definições e equações conferida no PDF público (draft de 15/01/2024). doi.org/10.1017/9781108679930
- Devlin, Jacob; Chang, Ming-Wei; Lee, Kenton; Toutanova, Kristina. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of NAACL-HLT 2019, v. 1, p. 4171–4186, 2019. doi.org/10.18653/v1/N19-1423
- Ethayarajh, Kawin. How Contextual are Contextualized Word Representations? Comparing the Geometry of BERT, ELMo, and GPT-2 Embeddings. Proceedings of EMNLP-IJCNLP 2019, p. 55–65, 2019. doi.org/10.18653/v1/D19-1006
- Bengio, Yoshua; Courville, Aaron; Vincent, Pascal. Representation Learning: A Review and New Perspectives. IEEE Transactions on Pattern Analysis and Machine Intelligence, v. 35, n. 8, p. 1798–1828, 2013. doi.org/10.1109/TPAMI.2013.50
- NumPy. numpy.linalg.matrix_rank. Documentação oficial do NumPy. Acesso em 16 out. 2026. numpy.org/doc/stable/reference/generated/numpy.linalg.matrix_rank.html
- OpenAI. Vector embeddings. Documentação oficial da API da OpenAI (guia de embeddings). Acesso em 16 out. 2026. developers.openai.com/api/docs/guides/embeddings
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 01-math/aulas/10-independencia-linear-span-base-dimensao.md.