Regressão logística: probabilidade, log-loss e limiar de decisão
Transformar um preditor linear em probabilidade, treiná-lo pela log-loss e separar a probabilidade estimada da decisão tomada com ela.
Transformar um preditor linear em probabilidade, treiná-lo pela log-loss e separar a probabilidade estimada da decisão tomada com ela. Pré-requisitos: Aula 05 — Ridge, Lasso e Elastic Net, Aula 03 — Pré-processamento, pipelines e data leakage e a linguagem de eventos de probabilidade para IA.
Um sistema antifraude estima risco de 18% para uma transação e de 73% para outra. Nenhum dos dois números é uma decisão. Bloquear, mandar para revisão ou aprovar depende de quanto custa cada tipo de erro e de quantos casos a equipe consegue revisar por dia. Uma fraude que passa pode custar cinco vezes mais que uma revisão desnecessária, e aí 18% já pode ser risco demais. Para tomar essa decisão com critério, é preciso saber de onde vem o 18%, o que ele promete e o que ele não promete.
Nos artigos anteriores da série, o alvo era contínuo: a regressão linear previa um número, e a regularização controlava a complexidade desse modelo. Agora o alvo é binário: fraude ou não fraude, falha ou operação normal, inadimplência ou pagamento. A regressão logística mantém o preditor linear e o liga a uma probabilidade pela função sigmoide. Ao final, você vai conseguir passar de logit para odds e para probabilidade, ler um coeficiente como razão de odds, derivar a log-loss e o gradiente $X^T(p-y)/n$, calcular a perda sem estourar o ponto flutuante e escolher um limiar pelo custo dos erros sem tocar no teste. Esta aula fecha o bloco de modelos lineares da série.
1. Por que não usar regressão linear num alvo 0 ou 1
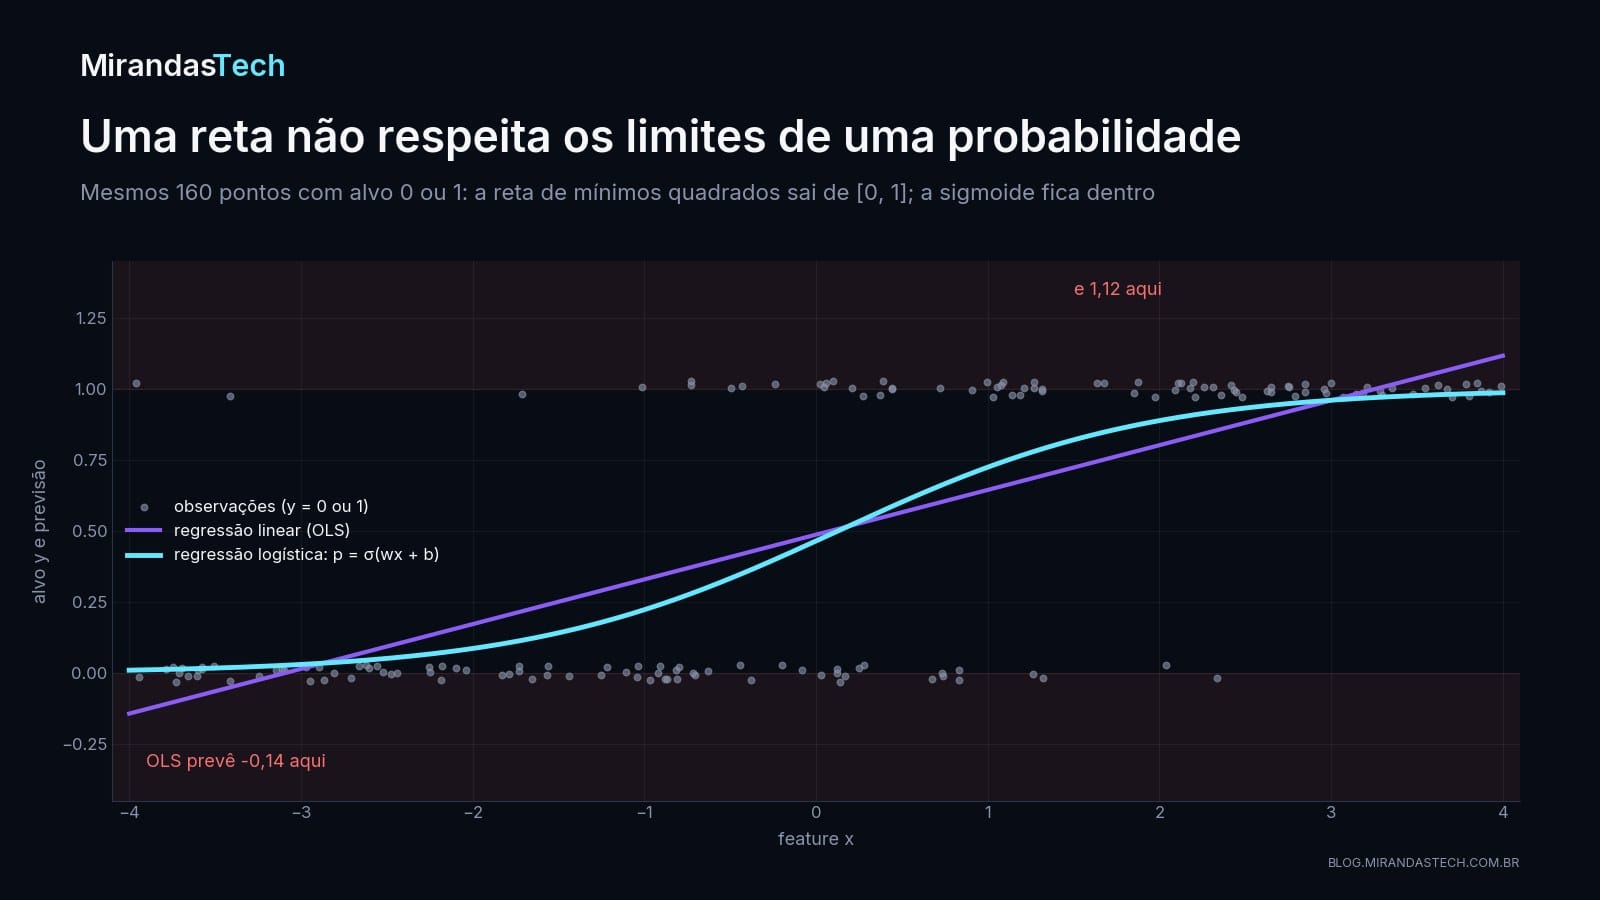
Nada impede ajustar mínimos quadrados a um alvo que vale 0 ou 1. O problema aparece nas pontas: a reta não respeita os limites de uma probabilidade e pode prever $-0{,}14$ ou $1{,}12$, como na figura abaixo. Há também um problema de estrutura. Num alvo Bernoulli, a variância depende da média:
$$ \operatorname{Var}(Y\mid X=x)=p(x)\,[1-p(x)]. $$
Aqui, $p(x)=P(Y=1\mid X=x)$ é a probabilidade do evento para quem tem features $x$. A variância é máxima em $p=0{,}5$ e cai a zero nas pontas, enquanto a regressão linear clássica supõe variância constante.
A regressão logística resolve isso em duas etapas. Primeiro, modela uma quantidade sem limites, as log-odds, como função linear das features. Depois, transforma essa quantidade numa probabilidade válida. A cadeia completa vai das features até a ação:
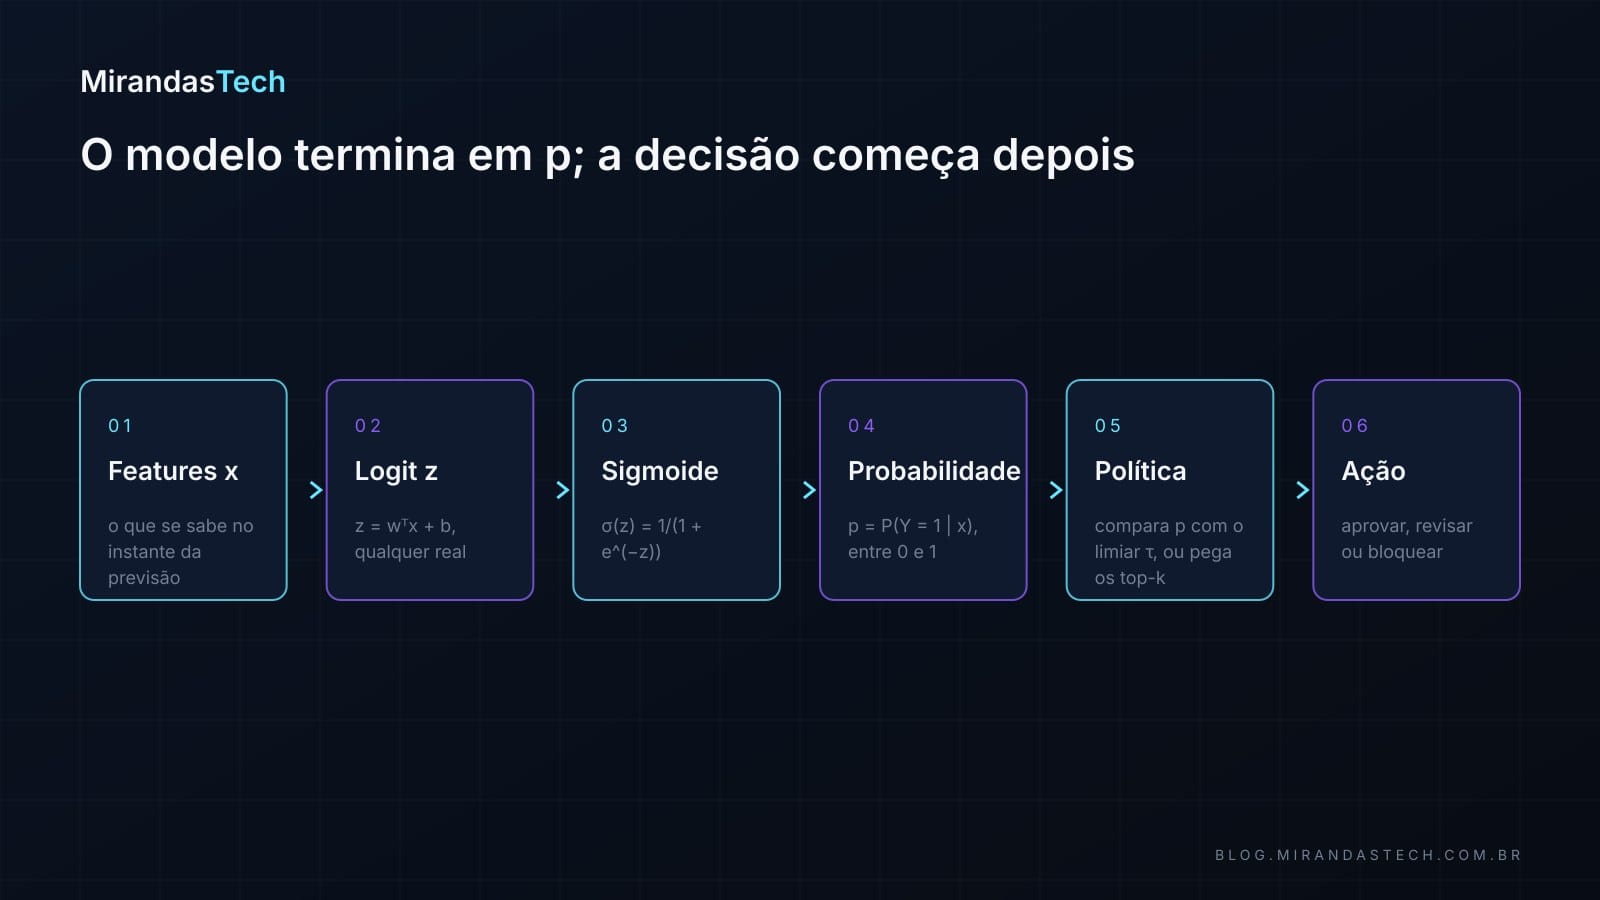
Essa separação permite usar o mesmo modelo com limiares diferentes: um para revisão manual, outro para bloqueio automático, outro para ordenar uma fila. Se o modelo devolvesse direto a classe, essa flexibilidade se perderia.
2. Do preditor linear à sigmoide
Para uma observação $x\in\mathbb{R}^d$, calculamos o logit:
$$ z=w^Tx+b, $$
onde $w$ contém os $d$ coeficientes, $b$ é o intercepto e $w^Tx$ é o produto escalar entre pesos e features. Como $z$ pode ser qualquer número real, aplicamos a função sigmoide:
$$ p=P(Y=1\mid X=x)=\sigma(z)=\frac{1}{1+e^{-z}}. $$
Propriedades que vamos usar o tempo todo:
- $\sigma(0)=0{,}5$: logit zero significa odds iguais;
- quando $z\to+\infty$, $\sigma(z)\to1$; quando $z\to-\infty$, $\sigma(z)\to0$;
- simetria: $\sigma(-z)=1-\sigma(z)$;
- derivada: $\sigma'(z)=\sigma(z)\,[1-\sigma(z)]$, que vale no máximo $0{,}25$, em $z=0$.
Alguns valores: $\sigma(-4)\approx0{,}018$ (evento pouco provável), $\sigma(-1)\approx0{,}269$, $\sigma(0)=0{,}500$, $\sigma(1)\approx0{,}731$ e $\sigma(4)\approx0{,}982$ (evento muito provável).
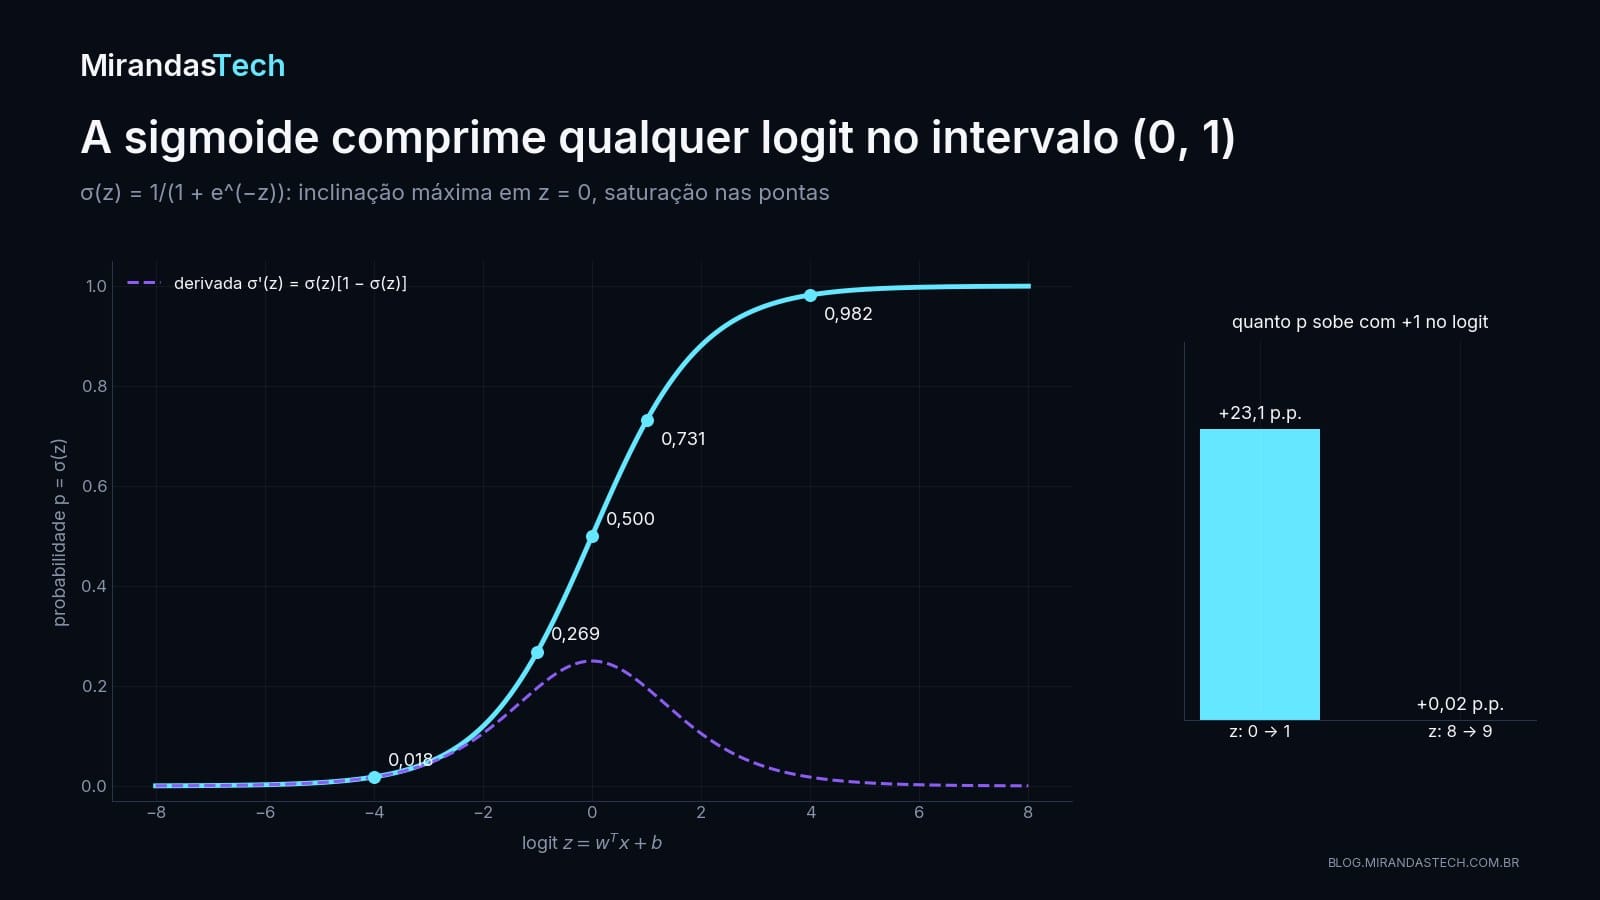
A sigmoide satura nas pontas. Por isso, o efeito de uma feature sobre $p$ depende do ponto em que a observação já está: perto de $z=0$, uma unidade a mais no logit muda muito a probabilidade; perto de $z=8$, quase não muda. É uma diferença importante em relação à regressão linear, em que o efeito de uma unidade a mais é sempre o mesmo.
3. Odds e log-odds
As odds de um evento são a razão entre a probabilidade de ocorrer e a de não ocorrer:
$$ \operatorname{odds}(p)=\frac{p}{1-p}. $$
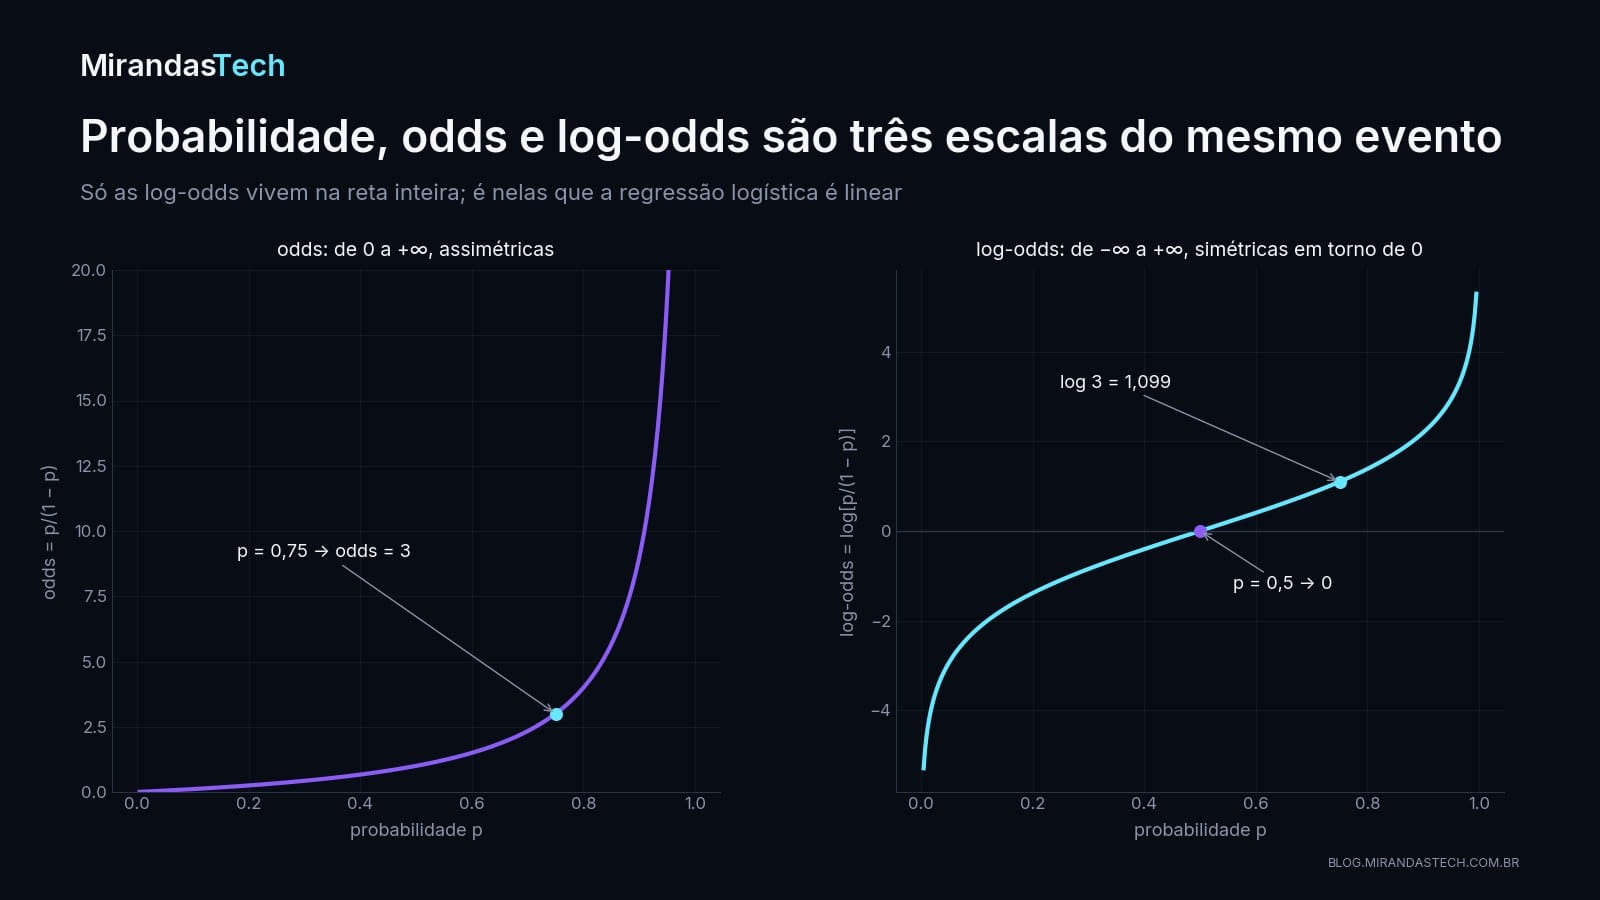
Se $p=0{,}75$, as odds são $0{,}75/0{,}25=3$: em repetições do mesmo cenário, esperamos três ocorrências para cada não ocorrência. Probabilidade e odds não são a mesma coisa. Partindo da sigmoide e isolando $z$:
$$ \begin{gathered} p=\frac{1}{1+e^{-z}} \;\Longrightarrow\; \frac{p}{1-p}=e^{z}\\ \Longrightarrow\; \log\frac{p}{1-p}=z. \end{gathered} $$
O logit é, literalmente, o logaritmo das odds. A hipótese estrutural da regressão logística, portanto, é
$$ \log\frac{p(x)}{1-p(x)}=w^Tx+b. $$
O modelo não afirma que a probabilidade é linear nas features. Afirma que as log-odds são.
4. Como ler um coeficiente
Mantidas as outras features fixas, aumentar $x_j$ em uma unidade soma $w_j$ às log-odds. Exponenciando os dois lados:
$$ \frac{\operatorname{odds}(x_j+1)}{\operatorname{odds}(x_j)}=e^{w_j}. $$
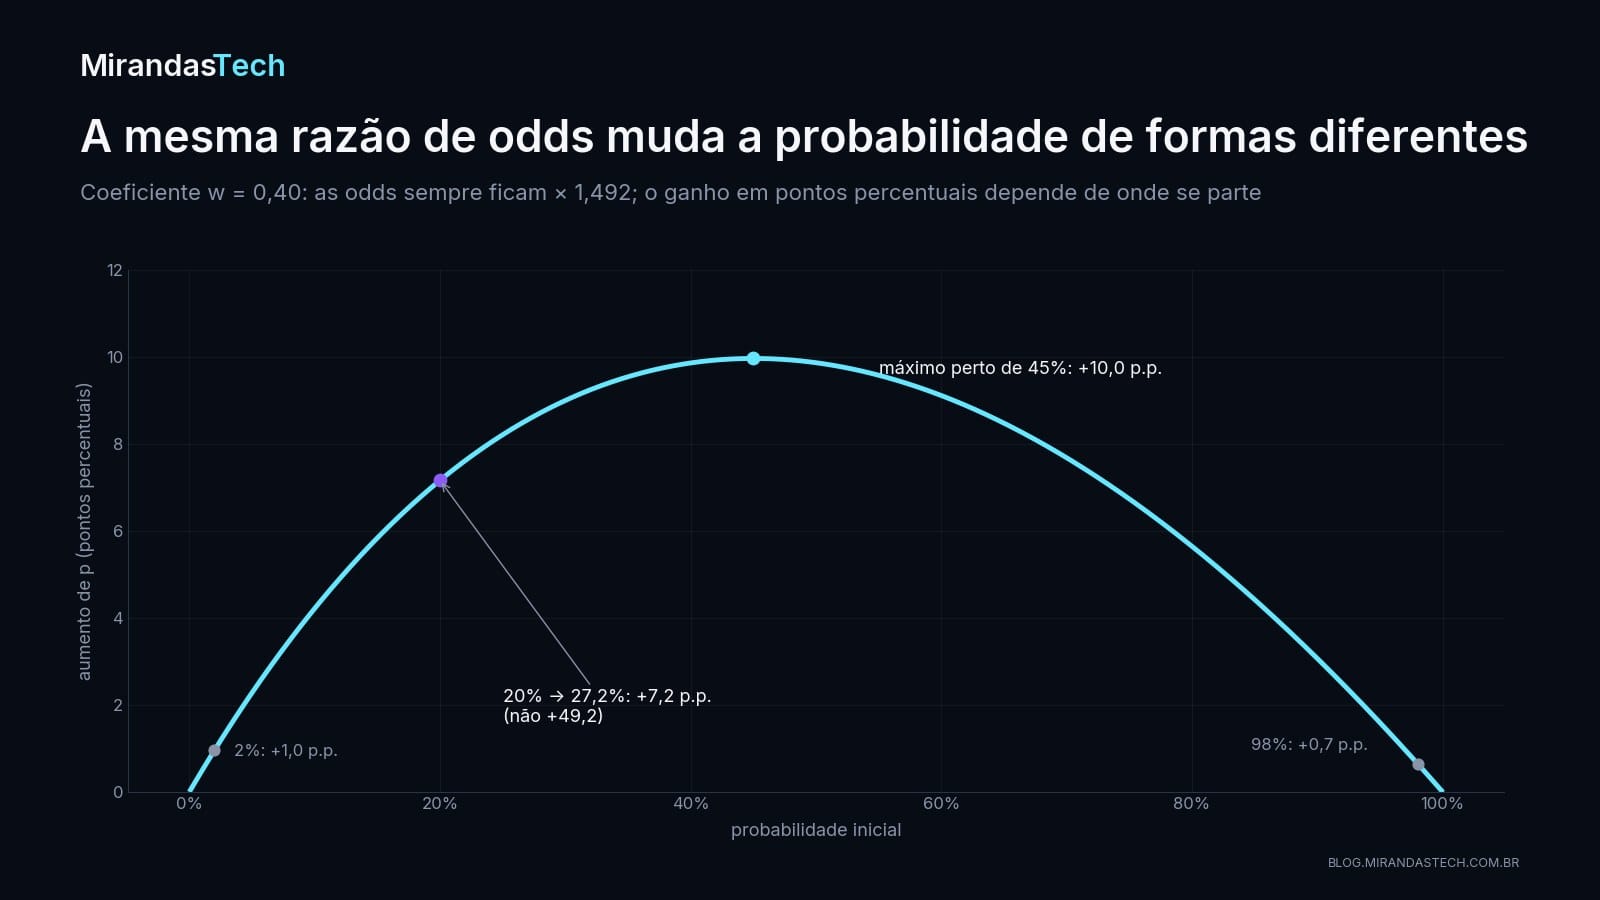
Assim, $e^{w_j}$ é uma razão de odds condicional, sob o modelo. Se $w_j=0{,}40$, então $e^{0{,}40}\approx1{,}492$: cada unidade a mais em $x_j$ multiplica as odds por cerca de 1,492. São 49,2% a mais nas odds, não na probabilidade. Partindo de $p=20\%$, as odds são $0{,}25$; multiplicadas por 1,492, viram $0{,}373$, e a nova probabilidade é
$$ p'=\frac{0{,}373}{1+0{,}373}\approx0{,}272. $$
O aumento foi de 7,2 pontos percentuais, não de 49,2. Partindo de outro ponto, o mesmo coeficiente produz outro aumento:
No laboratório da aula, as features entram padronizadas, então uma unidade passa a ser um desvio-padrão do treino. A feature frequencia recebeu coeficiente 1,462, e um desvio-padrão a mais multiplica as odds por 4,31. A feature valor_centavos recebeu −1,008, e um desvio-padrão a mais multiplica as odds por 0,365. Padronizar facilita comparar magnitudes, mas muda a unidade da leitura. Codificação, interações e correlação também mexem nos coeficientes: no mesmo laboratório, sinal_redundante tem correlação 0,958 com frequencia e ficou com o menor coeficiente (0,182). Com duas features quase iguais, separar o efeito de cada uma fica difícil, e o coeficiente de uma só deve ser lido junto com o da outra. E, como nos modelos anteriores da série, uma associação condicional não identifica causa.
5. Da Bernoulli à log-loss
Cox (1958) tratou de testes e estimativas para sequências de 0 e 1 em que a chance de cada 1 depende de variáveis explicativas, revisando trabalhos anteriores sobre o tema. Na forma que usamos hoje, o modelo cabe em uma linha. Para cada observação,
$$ \begin{gathered} Y_i\mid X_i=x_i\sim\operatorname{Bernoulli}(p_i),\\ p_i=\sigma(w^Tx_i+b). \end{gathered} $$
A probabilidade de observar $y_i\in\{0,1\}$ se escreve numa fórmula só:
$$ P(Y_i=y_i\mid x_i)=p_i^{\,y_i}(1-p_i)^{1-y_i}. $$
Se $y_i=1$, sobra $p_i$; se $y_i=0$, sobra $1-p_i$. Supondo observações condicionalmente independentes, a verossimilhança é o produto
$$ L(w,b)=\prod_{i=1}^{n}p_i^{\,y_i}(1-p_i)^{1-y_i}. $$
Um produto de muitas probabilidades pequenas some no ponto flutuante (underflow). Tomando o logaritmo, o produto vira soma:
$$ \begin{aligned} \log L(w,b)=\sum_{i=1}^{n}\big[\,&y_i\log p_i\\ &+(1-y_i)\log(1-p_i)\big]. \end{aligned} $$
Maximizar a log-verossimilhança é o mesmo que minimizar sua média com sinal trocado, a binary cross-entropy (BCE), também chamada de log-loss:
$$ \begin{aligned} J(w,b)=-\frac{1}{n}\sum_{i=1}^{n}\big[\,&y_i\log p_i\\ &+(1-y_i)\log(1-p_i)\big]. \end{aligned} $$
Cada observação paga $-\log$ da probabilidade que o modelo deu ao que de fato aconteceu.
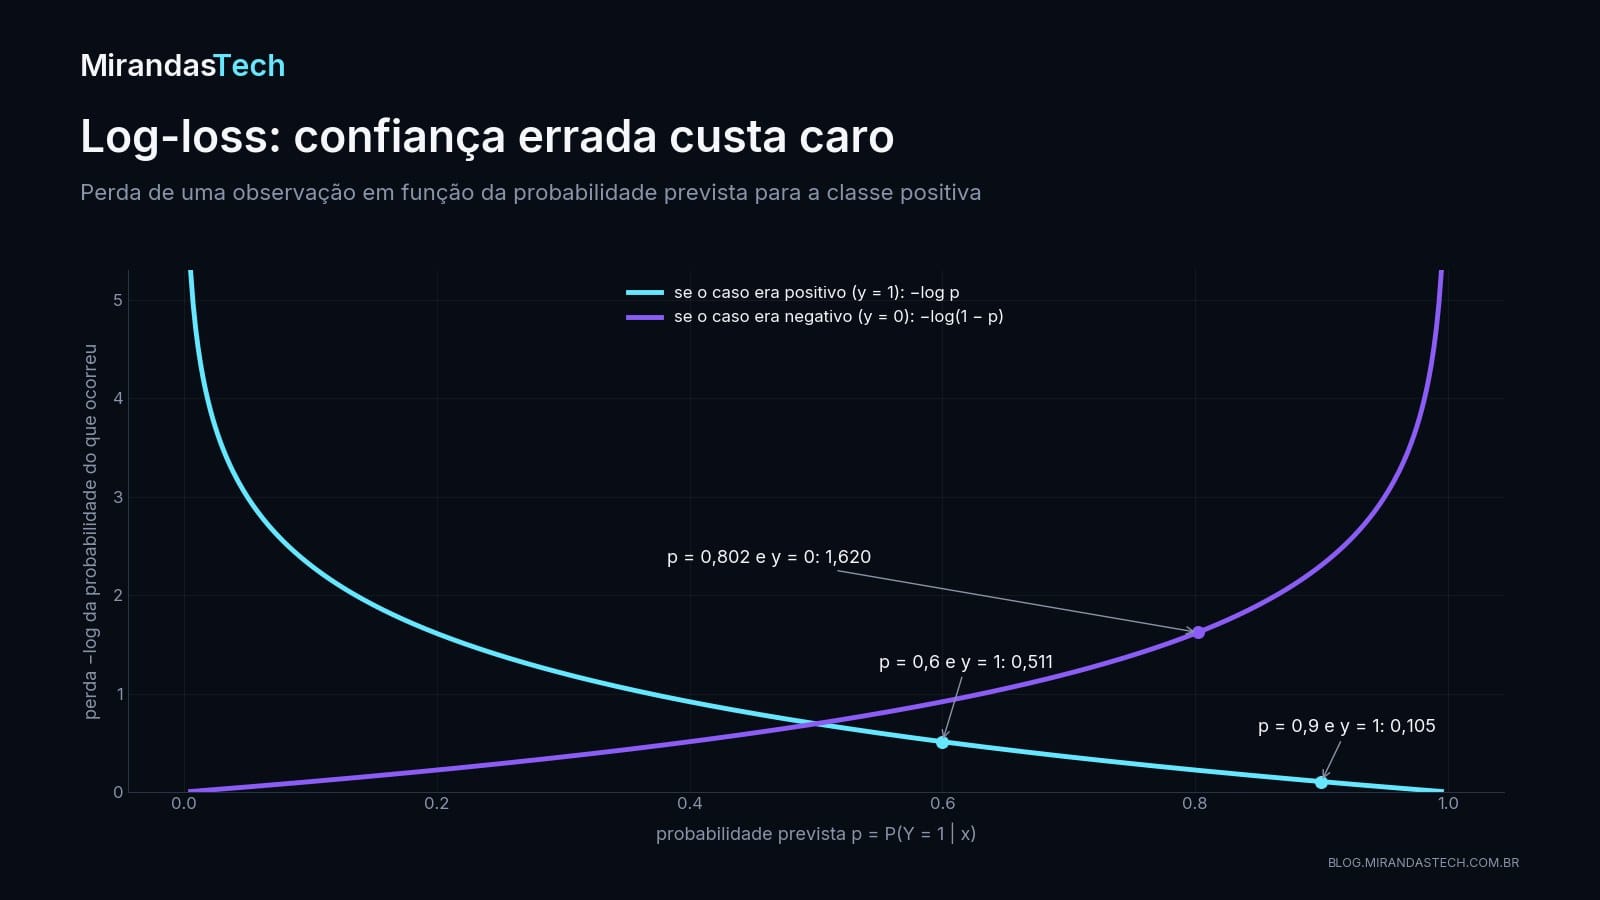
Duas observações positivas com $p=0{,}9$ e $p=0{,}6$ pagam $0{,}105$ e $0{,}511$: a segunda deu menos probabilidade ao que ocorreu. Uma observação negativa com $p\approx0{,}802$ paga $1{,}620$. A log-loss, portanto, não premia só o lado certo do limiar. Ela incentiva o modelo a representar a incerteza com honestidade.
6. Estabilidade numérica
A fórmula da seção anterior é correta e frágil. Para um logit muito negativo, $e^{-z}$ transborda; para um logit muito positivo, $p$ arredonda para exatamente 1 e $\log(1-p)$ vira $-\infty$. A saída é escrever a perda direto no logit. Como $\log\sigma(z)=-\log(1+e^{-z})$ e $\log[1-\sigma(z)]=-\log(1+e^{z})$, a perda de uma observação fica
$$ \ell(z,y)=\log\!\left(1+e^{z}\right)-y\,z. $$
O termo $\log(1+e^{z})$ é a função softplus. Em NumPy, np.logaddexp(0, z) calcula esse valor sem formar $e^{z}$ gigante:
perda = np.mean(np.logaddexp(0.0, logits) - y * logits)
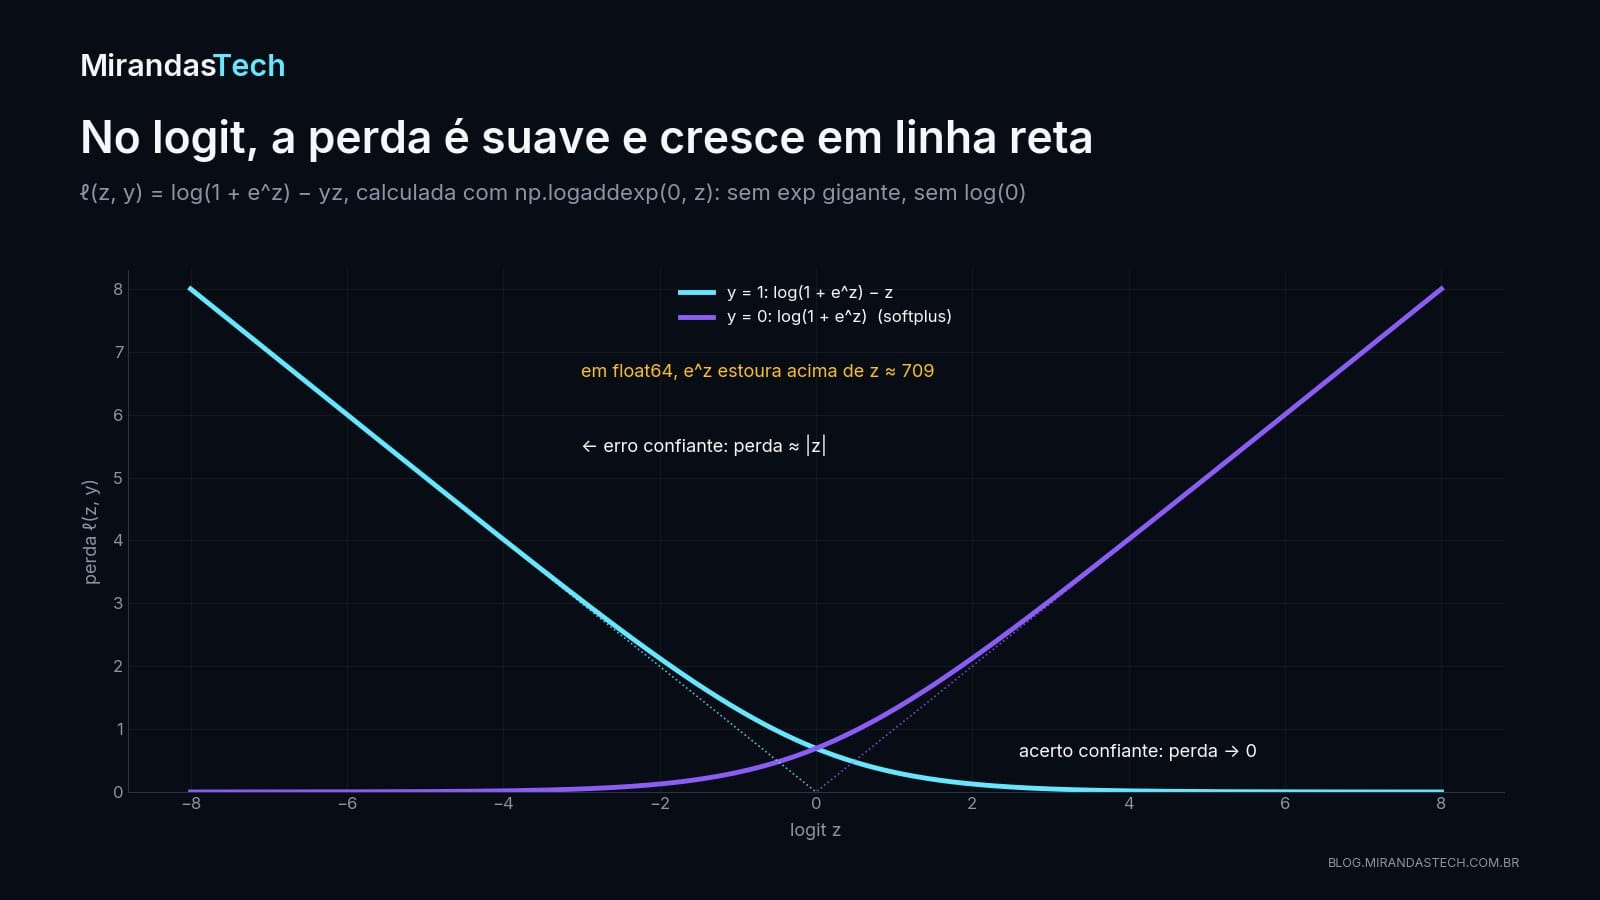
A seção 11 mostra a diferença em código: com logits de ±1.000, a conta ingênua devolve perda infinita, e a estável devolve um número finito. Recortar probabilidades (por exemplo, para o intervalo $[10^{-15},\,1-10^{-15}]$) serve para calcular uma métrica, mas não substitui a formulação estável durante a otimização.
7. O gradiente $p-y$
Derivando a perda de uma observação em relação ao logit:
$$ \frac{\partial\ell}{\partial z}=\sigma(z)-y=p-y. $$
Pela regra da cadeia, a derivada da BCE em relação a $p$ vale $(p-y)/[p(1-p)]$, e $\partial p/\partial z=p(1-p)$: os fatores se cancelam. Como $z=Xw+b$, para o conjunto inteiro,
$$ \begin{gathered} \nabla_w J=\frac{1}{n}X^T(p-y),\\ \frac{\partial J}{\partial b}=\frac{1}{n}\sum_{i=1}^{n}(p_i-y_i). \end{gathered} $$
O vetor $p-y$ é o erro probabilístico com sinal: positivo quando o modelo superestimou o evento, negativo quando subestimou. O gradiente propaga esse erro para cada feature, ponderado pelo valor dela.
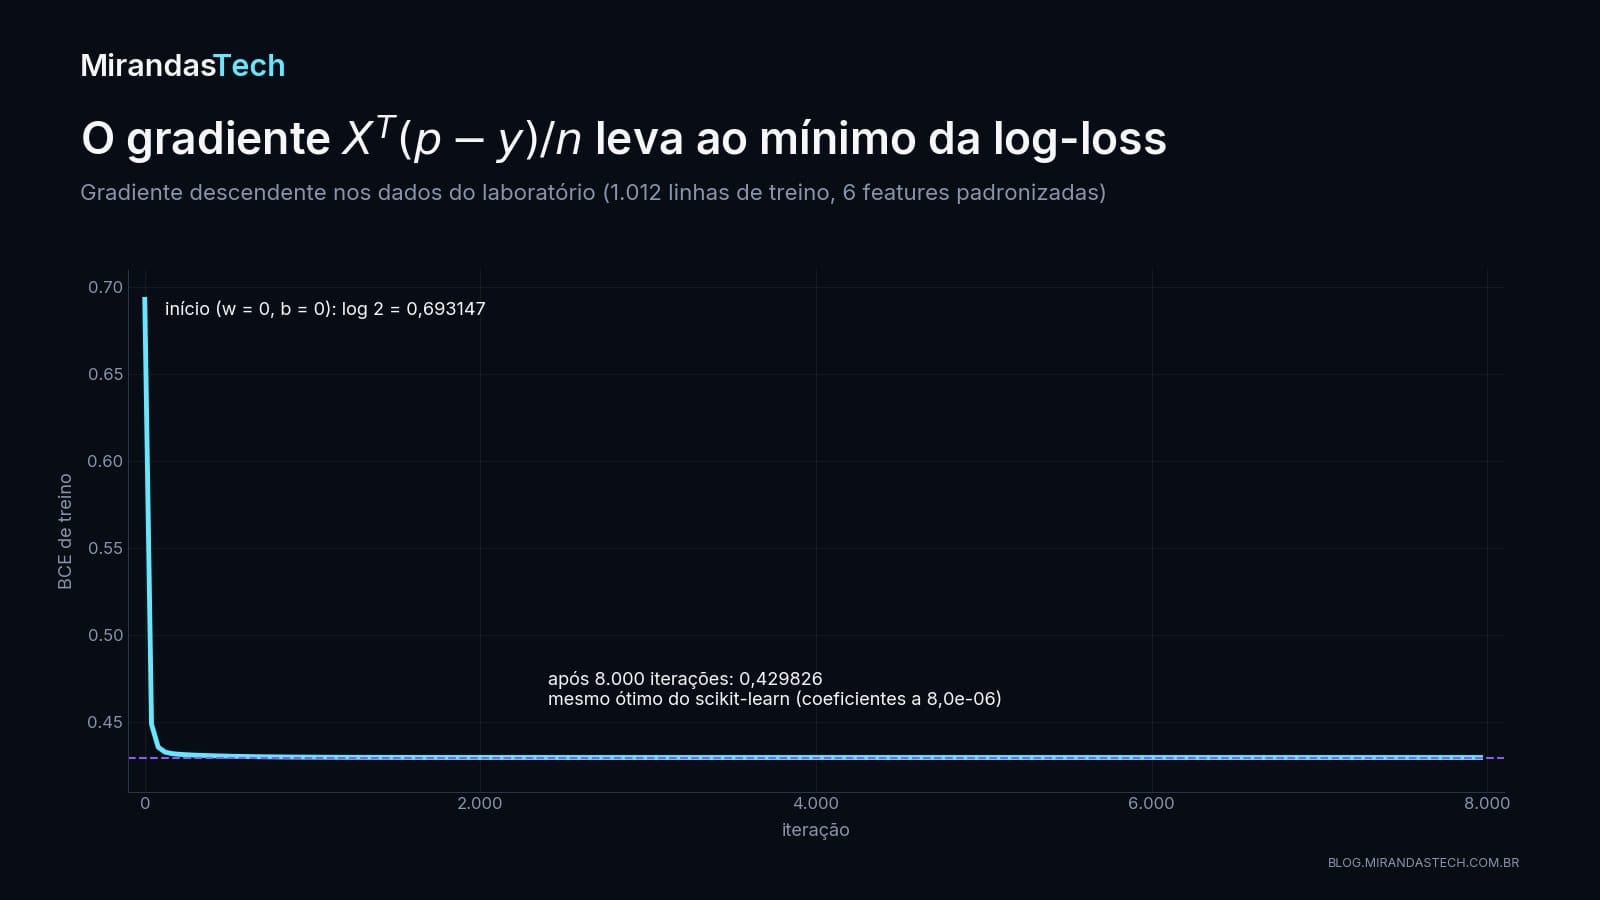
Duas consequências práticas. A primeira: a BCE logística é convexa em $w$ e $b$, então não há mínimos locais ruins, e métodos numéricos chegam ao ótimo global quando ele existe. A segunda sai da derivada em $b$. No ótimo sem penalidade (e também com penalidade só em $w$, como no solver lbfgs, que não penaliza o intercepto), ela é zero, ou seja, $\frac{1}{n}\sum_i p_i=\frac{1}{n}\sum_i y_i$: a probabilidade média prevista no treino reproduz exatamente a prevalência do treino. A documentação do scikit-learn chama isso de balance property (scikit-learn developers, 2026c); a tabela de solvers indica que só o liblinear penaliza o intercepto (scikit-learn developers, 2026a). O bloco de código da seção 12 confere as duas coisas.
A mesma estrutura, erro $p-y$ propagado para os pesos, reaparece em redes neurais com sigmoide ou softmax na saída. É por isso que vale entender bem este caso pequeno.
8. Regularização e separação perfeita
Convexa não quer dizer que o ótimo sempre exista. Se uma reta (ou um hiperplano) separa perfeitamente as classes no treino, multiplicar $w$ por um número maior mantém todos os sinais corretos e empurra as probabilidades para 0 e 1. A log-loss continua caindo sem nunca chegar a um mínimo finito, e os coeficientes crescem sem limite. Albert e Anderson (1984) classificaram os padrões possíveis dos dados em separação completa, separação quase completa e sobreposição, e mostraram que a existência da estimativa de máxima verossimilhança depende desse padrão.
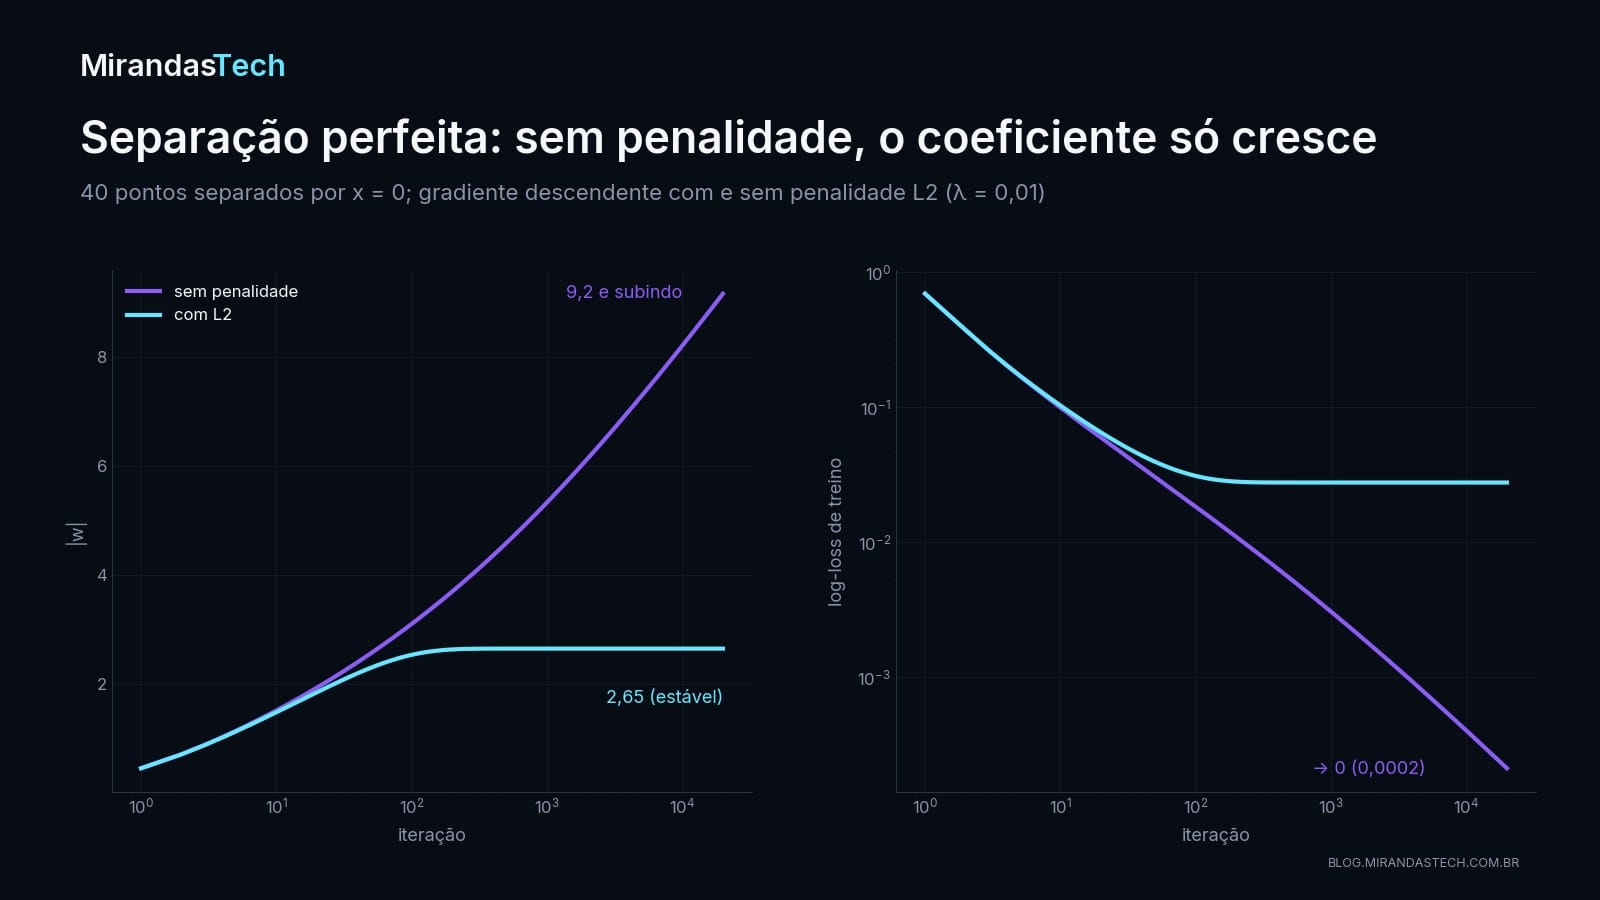
O que a aula de regularização ensinou continua valendo. Com penalidade $L_2$:
$$ J_{L_2}(w,b)=J(w,b)+\frac{\lambda}{2}\|w\|_2^2. $$
O intercepto normalmente fica fora da penalidade. A regularização limita os coeficientes, ajuda com features colineares e garante uma solução finita no caso separável.
No scikit-learn, a LogisticRegression regulariza por padrão, e a força vem do parâmetro C, que é o inverso da força: C maior significa penalidade mais fraca, e C=np.inf desliga a penalidade (scikit-learn developers, 2026a). Sem pesos por amostra nem por classe, a função que a biblioteca minimiza no caso $L_2$ é a log-loss média mais $\frac{1}{nC}\cdot\frac{1}{2}\|w\|_2^2$. Comparando com a fórmula acima, $\lambda=1/(nC)$. Com C=1 e 1.012 linhas de treino, como no laboratório, $\lambda\approx0{,}001$. Como $\lambda$ depende de $n$, o mesmo C regulariza menos quando o modelo é reajustado com mais linhas. No reajuste final, com 1.350 linhas, $\lambda\approx0{,}0007$. A partir da versão 1.8, o tipo de penalidade se escolhe por l1_ratio, e o parâmetro penalty está marcado para sair na 1.10. Registre a versão junto com o valor de C.
Duas regras que vêm das aulas anteriores. Se as features têm escalas diferentes, o StandardScaler fica dentro do pipeline, para aprender médias e desvios só no treino de cada etapa (o porquê está na aula sobre pipelines e vazamento). E C é escolhido por validação no desenvolvimento, nunca pelo teste.
9. Probabilidade não é decisão
A regra binária usual é
$$ \widehat y= \begin{cases} 1, & p\geq\tau,\\ 0, & p\lt\tau, \end{cases} $$
onde $\tau$ é o limiar. O valor 0,5 é só uma convenção. É o corte que o predict do scikit-learn usa (com desigualdade estrita), e a própria documentação avisa que essa regra fixa não é a ideal na maioria dos casos de uso (scikit-learn developers, 2026b). Ela costuma ser inadequada quando custos, prevalência ou capacidade de revisão são assimétricos. Considere os custos do exemplo da abertura:
- verdadeiro positivo e verdadeiro negativo: custo 0;
- falso positivo, uma revisão desnecessária: custo $c_{FP}=1$;
- falso negativo, uma fraude que passou: custo $c_{FN}=5$.
Num conjunto de validação, o custo médio de um limiar é
$$ \widehat C(\tau)=\frac{c_{FP}\,FP(\tau)+c_{FN}\,FN(\tau)}{n_{val}}, $$
onde $FP(\tau)$ e $FN(\tau)$ contam os falsos positivos e falsos negativos com aquele limiar. Há também uma conta de referência. Se $p$ for uma probabilidade calibrada, marcar o caso como positivo custa, em média, $(1-p)\,c_{FP}$, e deixar passar custa $p\,c_{FN}$. Vale marcar quando $p\,c_{FN}\geq(1-p)\,c_{FP}$, isto é, quando
$$ p\;\geq\;\frac{c_{FP}}{c_{FP}+c_{FN}}=\frac{1}{1+5}=\frac{1}{6}\approx0{,}167. $$
Um falso negativo cinco vezes mais caro empurra o limiar para baixo: aceitamos mais alarmes para deixar passar menos fraudes. Na prática, as probabilidades não são perfeitamente calibradas, e por isso o limiar é escolhido pelo custo medido na validação:
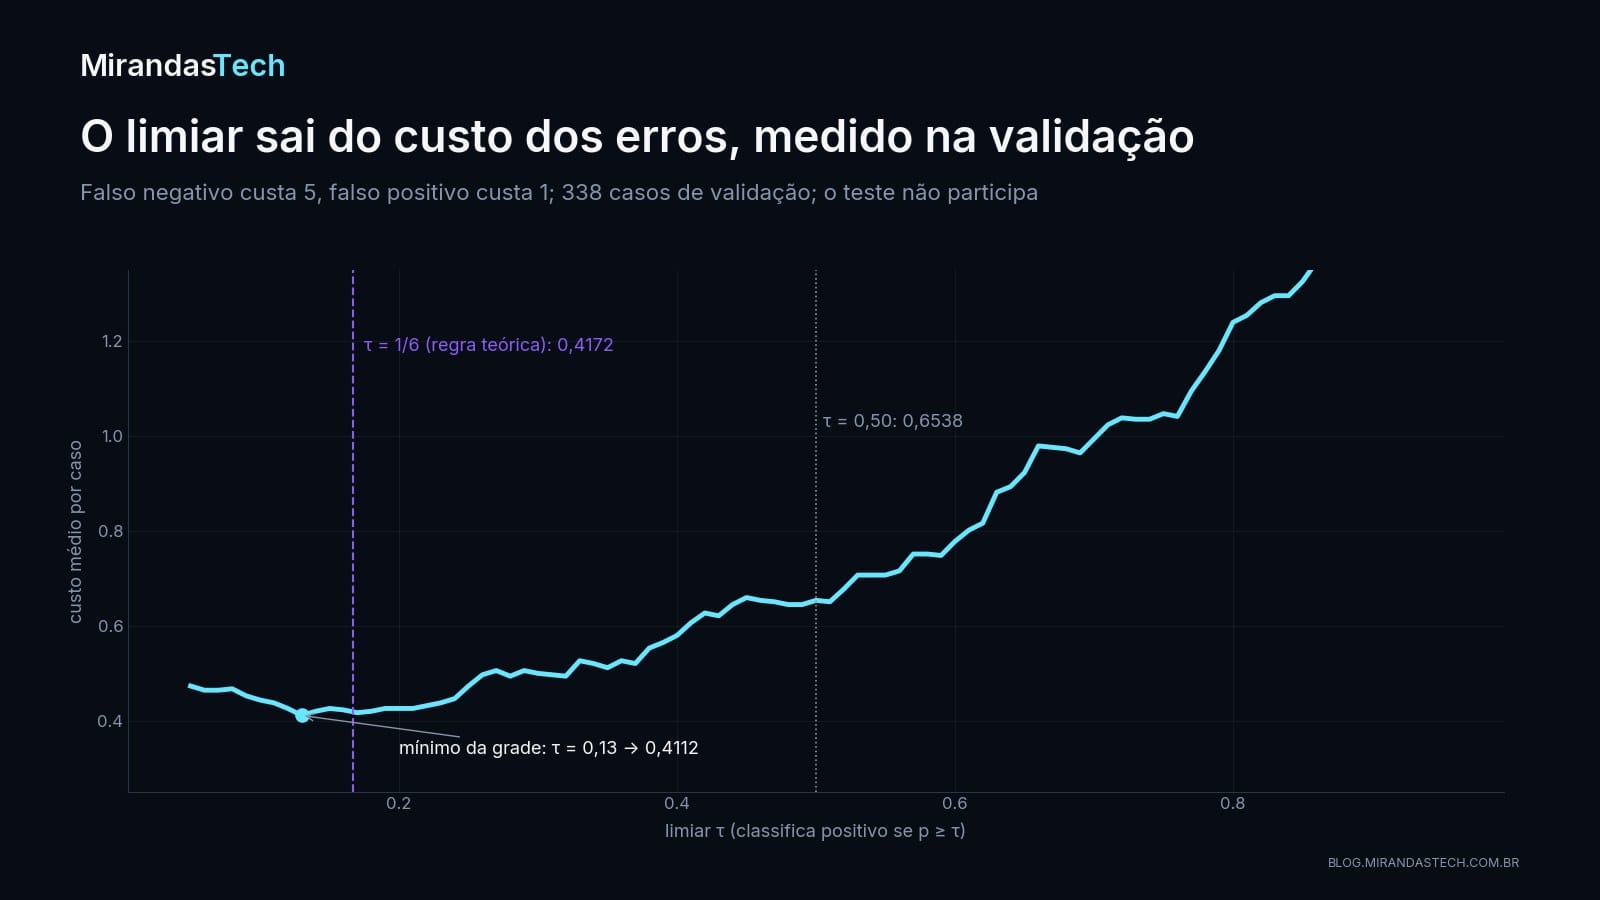
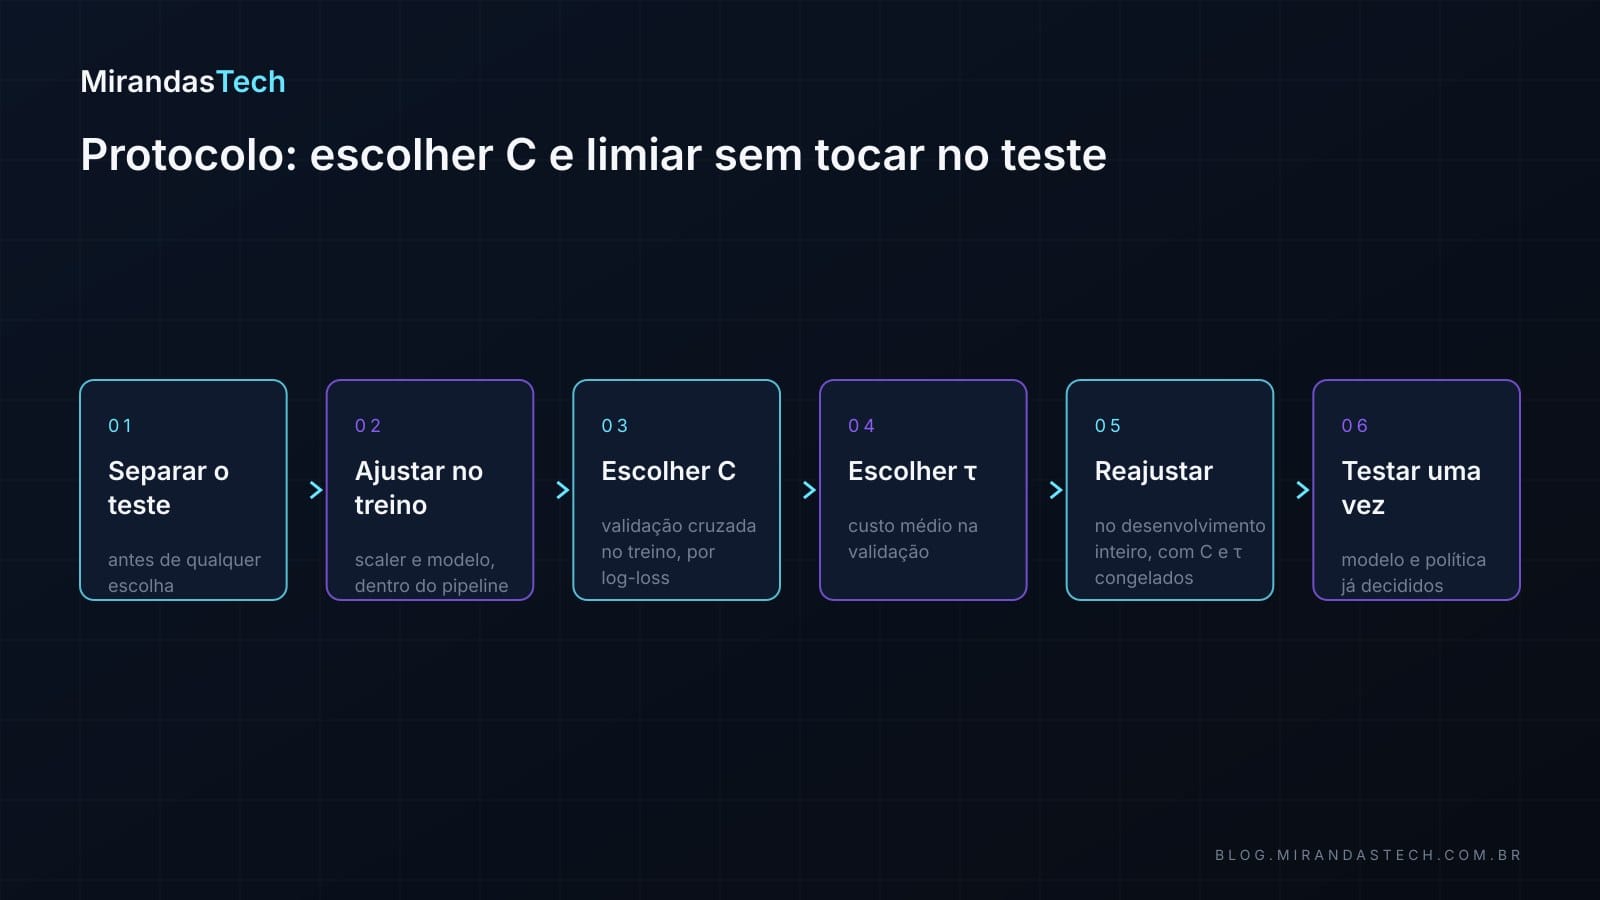
A diferença entre 0,13 e 1/6 é pequena perto da distância para 0,5, e um mínimo de grade medido em 338 casos carrega ruído. O ponto não é decorar 0,13: é que o limiar sai de uma matriz de custos definida antes de olhar os resultados e é escolhido na validação. Depois, a política é congelada e só então o teste é usado. Se a equipe só consegue revisar $k$ casos por dia, a política certa pode ser outra: revisar os $k$ maiores riscos, em vez de um limiar fixo. Para automatizar a busca do limiar com validação cruzada interna, o scikit-learn oferece o TunedThresholdClassifierCV (scikit-learn developers, 2026b).
10. Calibração: o que significa prever 0,7?
Um modelo é calibrado quando, entre os casos aos quais atribui probabilidade perto de 0,7, cerca de 70% são de fato positivos (scikit-learn developers, 2026c). Essa garantia vale para condições comparáveis às do treino. Calibração é diferente de ordenação. Imagine um modelo que dá 0,6 a todos os positivos e 0,4 a todos os negativos. Ele ordena perfeitamente, mas, se todo caso com 0,6 for positivo, prever 60% subestima uma frequência observada de 100%.
A log-loss avalia a distribuição probabilística inteira e pune confiança errada. O Brier score mede o erro quadrático das probabilidades:
$$ \operatorname{Brier}=\frac{1}{n}\sum_{i=1}^{n}(p_i-y_i)^2. $$
Nenhum dos dois mede só calibração: um Brier menor pode vir de um modelo mais discriminativo e pior calibrado (scikit-learn developers, 2026c). Para olhar a calibração, a ferramenta é o diagrama de confiabilidade: agrupa as previsões em faixas e compara a probabilidade média prevista com a frequência observada em cada faixa.
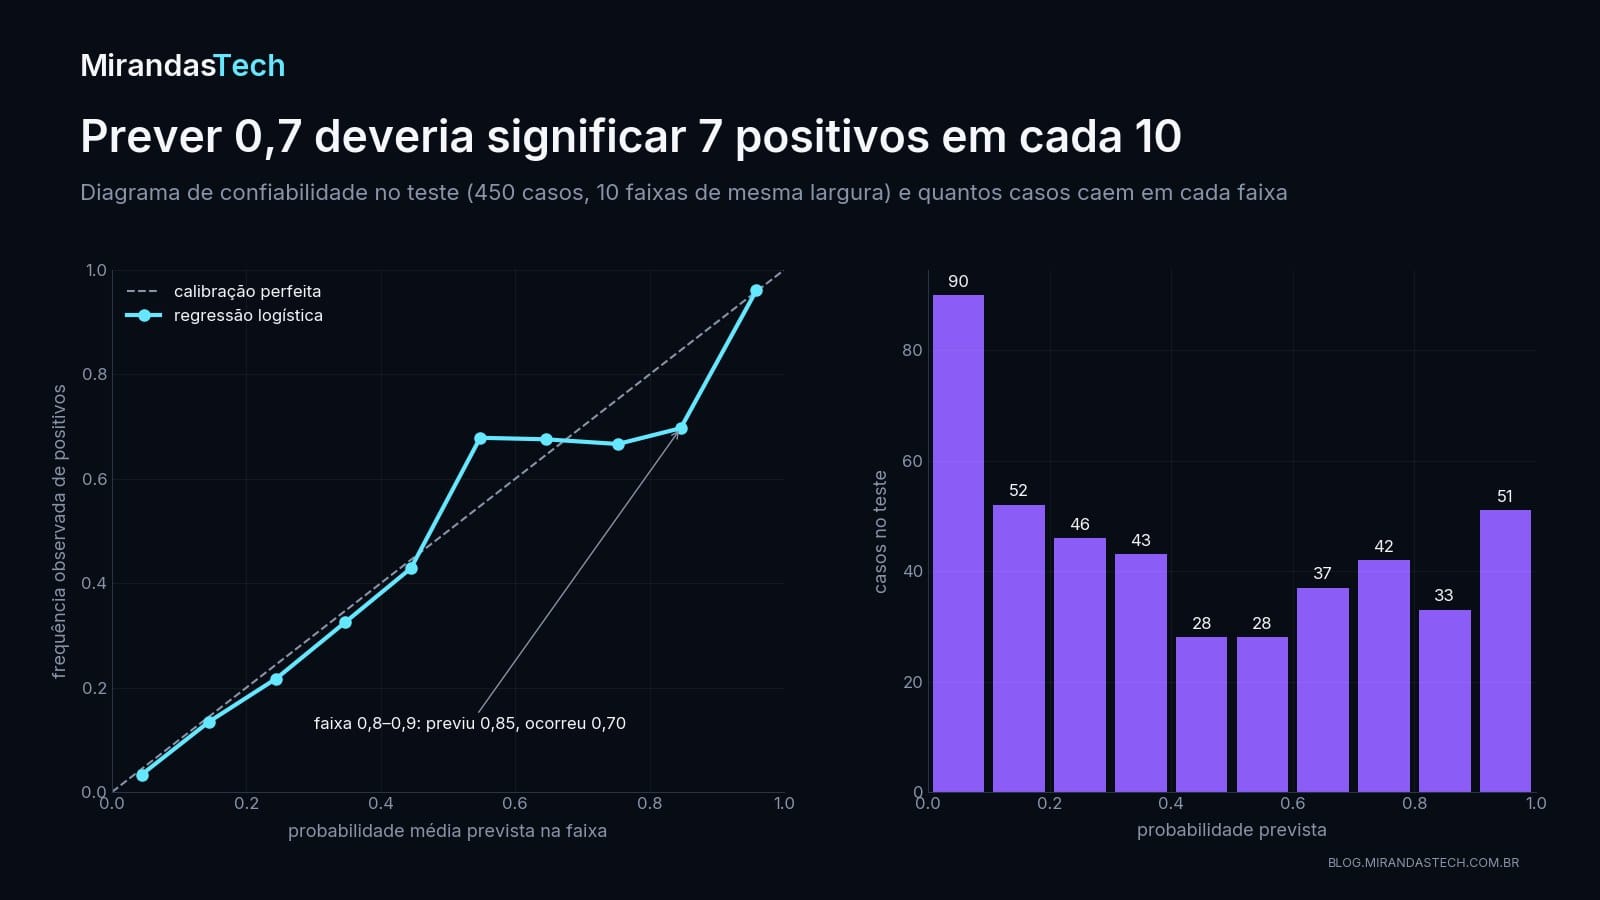
Faixas com poucas observações dão estimativas ruidosas, e o número e o tipo de faixas mudam o desenho. No laboratório, os rótulos são sorteados de um modelo logístico exato, então a especificação está certa; mesmo assim, com 28 a 42 casos por faixa no meio, a curva oscila em torno da diagonal. O diagnóstico de um único teste não substitui monitoramento depois da implantação.
A regressão logística tende a sair razoavelmente calibrada quando bem especificada. A documentação do scikit-learn atribui isso ao uso da ligação canônica (o logit) para a log-loss (scikit-learn developers, 2026c). Mas calibração não é garantida. Relações não lineares mal modeladas, regularização forte e, principalmente, mudança de prevalência podem degradá-la. Se o modelo foi treinado com 42% de positivos e opera num lugar onde há 5%, as probabilidades a posteriori que ele devolve deixam de valer para a nova população. Saerens, Latinne e Decaestecker (2002) propuseram um procedimento para reajustar as saídas às novas probabilidades a priori sem retreinar o modelo. O diagnóstico e os métodos de calibração ficam para a aula 15 da série.
11. Exemplo resolvido, passo a passo
Considere $w=1{,}2$, $x=2$ e $b=-1$.
- Logit: $z=1{,}2\cdot2-1=1{,}4$.
- Probabilidade: $p=\sigma(1{,}4)=1/(1+e^{-1{,}4})\approx0{,}8022$.
- Odds: $p/(1-p)\approx0{,}8022/0{,}1978\approx4{,}055$, que é também $e^{1{,}4}$.
- Perda se $y=1$: $-\log(0{,}8022)\approx0{,}2204$.
- Perda se $y=0$: $-\log(1-0{,}8022)\approx1{,}6204$.
- Decisão: com $\tau=0{,}5$, a classe é positiva; com $\tau=0{,}85$, é negativa. A probabilidade não mudou; só a política.
Em código, junto com a razão de odds da seção 4 e o teste de estabilidade da seção 6:
import numpy as np

def sigmoide(z):
    return 1 / (1 + np.exp(-z))

# Exemplo resolvido: w = 1,2, x = 2, b = -1
z = 1.2 * 2 - 1
p = sigmoide(z)
print(f"logit z = {z:.1f} | p = {p:.4f} | odds = {p / (1 - p):.3f} | e^z = {np.exp(z):.3f}")
print(f"perda se y=1: {-np.log(p):.4f} | perda se y=0: {-np.log(1 - p):.4f}")

# Razão de odds: w_j = 0,40 partindo de p = 20%
odds = 0.20 / 0.80 * np.exp(0.40)
print(f"e^0,40 = {np.exp(0.40):.3f} | nova odds = {odds:.3f} | nova p = {odds / (1 + odds):.3f}")

# Logits extremos: a conta ingênua quebra, a estável não
logits = np.array([-1000.0, 0.0, 1000.0])
y = np.array([1.0, 1.0, 0.0])          # dois erros confiantes e um caso neutro
with np.errstate(over="ignore", divide="ignore", invalid="ignore"):
    p_ing = sigmoide(logits)
    bce_ing = -np.mean(y * np.log(p_ing) + (1 - y) * np.log(1 - p_ing))
bce_est = np.mean(np.logaddexp(0.0, logits) - y * logits)
print("p ingênua:", p_ing, "| BCE ingênua:", bce_ing)
print(f"BCE estável: {bce_est:.4f}")
Saída real, com Python 3.13 e NumPy 2.2:
logit z = 1.4 | p = 0.8022 | odds = 4.055 | e^z = 4.055
perda se y=1: 0.2204 | perda se y=0: 1.6204
e^0,40 = 1.492 | nova odds = 0.373 | nova p = 0.272
p ingênua: [0.  0.5 1. ] | BCE ingênua: inf
BCE estável: 666.8977
A conta ingênua arredonda $\sigma(-1000)$ para 0 e $\sigma(1000)$ para 1, e $\log 0$ leva a perda a infinito: nenhum gradiente útil sai daí. A versão com logaddexp devolve 666,9, que é a média de 1.000, $\log 2$ e 1.000. É um valor grande, como deve ser para dois erros confiantes, mas finito.
12. Na prática: o laboratório em dois blocos
O notebook da aula gera 1.800 transações sintéticas com probabilidade conhecida. São seis features, uma delas quase cópia de outra (correlação 0,958), com unidades que diferem em até quatro ordens de grandeza. O rótulo é sorteado de uma Bernoulli: mesmo com o modelo certo, há incerteza irredutível. O primeiro bloco separa o teste, implementa a regressão logística do zero e confere o gradiente, o ótimo e a balance property:
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

SEED = 20260908
rng = np.random.default_rng(SEED)

# Dados sintéticos do laboratório: 6 features, uma quase cópia de outra, escalas muito diferentes
n = 1_800
u = rng.normal(size=(n, 5))
X_base = np.column_stack([u[:, 0], u[:, 1], u[:, 2], u[:, 3],
                          0.82 * u[:, 0] + 0.25 * rng.normal(size=n), u[:, 4]])
X = X_base * np.array([1.0, 100.0, 0.01, 5.0, 1.0, 20.0])
beta = np.array([1.15, -0.85, 0.75, 0.55, 0.35, -0.60])
p_real = 1 / (1 + np.exp(-(-0.55 + X_base @ beta)))
y = rng.binomial(1, p_real)               # o rótulo é sorteado: há ruído mesmo com o modelo certo

# Teste separado antes de qualquer escolha; desenvolvimento = treino + validação
X_dev, X_test, y_dev, y_test = train_test_split(X, y, test_size=0.25, stratify=y, random_state=SEED)
X_tr, X_val, y_tr, y_val = train_test_split(X_dev, y_dev, test_size=0.25, stratify=y_dev, random_state=SEED + 1)
print("treino/validação/teste:", len(X_tr), len(X_val), len(X_test), f"| prevalência {y.mean():.3f}")

def sigmoide_estavel(z):
    out = np.empty_like(z, dtype=float)
    pos = z >= 0
    out[pos] = 1 / (1 + np.exp(-z[pos]))
    ez = np.exp(z[~pos])
    out[~pos] = ez / (1 + ez)
    return out

def perda_e_gradiente(w, b, Z, y):
    z = Z @ w + b
    erro = sigmoide_estavel(z) - y                     # p - y
    perda = np.mean(np.logaddexp(0.0, z) - y * z)
    return perda, Z.T @ erro / len(y), erro.mean()

Z_tr = StandardScaler().fit(X_tr).transform(X_tr)      # scaler aprende só no treino

# 1) Gradiente analítico x diferenças finitas
w0 = rng.normal(0, 0.2, 6); h = 1e-5
_, g_w, _ = perda_e_gradiente(w0, -0.1, Z_tr[:250], y_tr[:250])
g_num = [(perda_e_gradiente(w0 + h * e, -0.1, Z_tr[:250], y_tr[:250])[0]
          - perda_e_gradiente(w0 - h * e, -0.1, Z_tr[:250], y_tr[:250])[0]) / (2 * h) for e in np.eye(6)]
print(f"maior diferença analítico x numérico: {np.max(np.abs(g_w - g_num)):.1e}")

# 2) Gradiente descendente sem penalidade
w, b = np.zeros(6), 0.0
for passo in range(8_000):
    perda, g_w, g_b = perda_e_gradiente(w, b, Z_tr, y_tr)
    w -= 0.25 * g_w
    b -= 0.25 * g_b
perda, g_w, g_b = perda_e_gradiente(w, b, Z_tr, y_tr)
print(f"BCE inicial {np.log(2):.6f} -> final {perda:.6f} | norma do gradiente {np.sqrt(g_w @ g_w + g_b**2):.1e}")

# 3) Mesmo ótimo que o scikit-learn com penalidade desprezível (C enorme)
sk = LogisticRegression(C=1e8, max_iter=10_000, tol=1e-12).fit(Z_tr, y_tr)
print(f"maior diferença de coeficientes para o scikit-learn: {np.max(np.abs(w - sk.coef_[0])):.1e}")

# 4) No ótimo, dJ/db = média(p - y) = 0: a probabilidade média reproduz a prevalência do treino
p_tr = sigmoide_estavel(Z_tr @ w + b)
print(f"média de p no treino {p_tr.mean():.6f} | prevalência no treino {y_tr.mean():.6f}")
Saída real (Python 3.13, NumPy 2.2, scikit-learn 1.9):
treino/validação/teste: 1012 338 450 | prevalência 0.422
maior diferença analítico x numérico: 9.2e-12
BCE inicial 0.693147 -> final 0.429826 | norma do gradiente 6.3e-08
maior diferença de coeficientes para o scikit-learn: 8.0e-06
média de p no treino 0.421937 | prevalência no treino 0.421937
O gradiente analítico e as diferenças finitas diferem em menos de $10^{-11}$. O gradiente descendente sai de $\log 2$, a perda de quem prevê 0,5 para todos, e chega ao mesmo ótimo do scikit-learn, com coeficientes a $8\times10^{-6}$ de distância. No ótimo, a probabilidade média do treino é idêntica à prevalência do treino, como a derivada em $b$ prometia.
O segundo bloco continua do primeiro e faz o protocolo completo: escolhe C por validação cruzada no treino, escolhe o limiar pelo custo na validação, reajusta no desenvolvimento e olha o teste uma vez.
from sklearn.metrics import brier_score_loss, log_loss, roc_auc_score
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline

def modelo(C):
    return make_pipeline(StandardScaler(), LogisticRegression(C=C, max_iter=3_000))

# 1) C escolhido por validação cruzada só no treino (log-loss média em 5 folds)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)
grade = np.logspace(-2, 2, 9)
ll_cv = [-cross_val_score(modelo(C), X_tr, y_tr, scoring="neg_log_loss", cv=cv).mean() for C in grade]
C_best = grade[int(np.argmin(ll_cv))]
print("log-loss CV:", " ".join(f"{v:.4f}" for v in ll_cv), f"-> C = {C_best:g}")

# 2) Limiar escolhido por custo na validação: falso positivo custa 1, falso negativo custa 5
def custo(y, p, t):
    pred = p >= t
    return (1 * np.sum(pred & (y == 0)) + 5 * np.sum(~pred & (y == 1))) / len(y)

p_val = modelo(C_best).fit(X_tr, y_tr).predict_proba(X_val)[:, 1]
limiares = np.round(np.linspace(0.05, 0.95, 91), 2)
custos = [custo(y_val, p_val, t) for t in limiares]
t_best = limiares[int(np.argmin(custos))]
print(f"validação | custo(0.50) = {custo(y_val, p_val, 0.5):.4f} | custo(1/6) = {custo(y_val, p_val, 1/6):.4f}"
      f" | mínimo da grade: custo({t_best:.2f}) = {min(custos):.4f}")

# 3) Modelo e política congelados; reajuste no desenvolvimento e UMA avaliação no teste
final = modelo(C_best).fit(X_dev, y_dev)
assert list(final[-1].classes_) == [0, 1]        # a coluna 1 de predict_proba é o evento y=1
p_test = final.predict_proba(X_test)[:, 1]
base = np.full(len(y_test), y_dev.mean())
print(f"teste     | log-loss {log_loss(y_test, p_test):.4f} (prevalência constante: {log_loss(y_test, base):.4f})"
      f" | Brier {brier_score_loss(y_test, p_test):.4f} | AUC {roc_auc_score(y_test, p_test):.4f}")
print(f"teste     | custo(0.50) = {custo(y_test, p_test, 0.5):.4f} | custo(1/6) = {custo(y_test, p_test, 1/6):.4f}"
      f" | política congelada: custo({t_best:.2f}) = {custo(y_test, p_test, t_best):.4f}")
Saída real:
log-loss CV: 0.4818 0.4498 0.4390 0.4367 0.4366 0.4367 0.4368 0.4368 0.4368 -> C = 1
validação | custo(0.50) = 0.6538 | custo(1/6) = 0.4172 | mínimo da grade: custo(0.13) = 0.4112
teste     | log-loss 0.4466 (prevalência constante: 0.6810) | Brier 0.1467 | AUC 0.8667
teste     | custo(0.50) = 0.6156 | custo(1/6) = 0.3911 | política congelada: custo(0.13) = 0.3822
Algumas leituras:
- A log-loss de validação cruzada é quase plana de
C= 0,3 a 100, e o mínimo da grade ficou emC= 1. Com 1.012 linhas e seis features, a penalidade pouco importa para este modelo. - No teste, o modelo bate com folga a referência que prevê sempre a prevalência: log-loss de 0,4466 contra 0,6810. Comparar com essa referência é o mínimo para saber se as probabilidades carregam informação.
- A política congelada (τ = 0,13) custou 0,3822 por caso no teste, contra 0,6156 com τ = 0,5. No notebook, que imprime a matriz de confusão completa, dá para ver a troca: os falsos negativos caem de 46 para 4, e os falsos positivos sobem de 47 para 152. É exatamente o que os custos pediam.
- O
assertsobreclasses_não é enfeite. Opredict_probadevolve as colunas na ordem dos rótulos emclasses_(scikit-learn developers, 2026a). Se o evento de interesse estiver codificado de outro jeito, a "coluna 1" pode ser o evento errado.
13. Armadilhas comuns
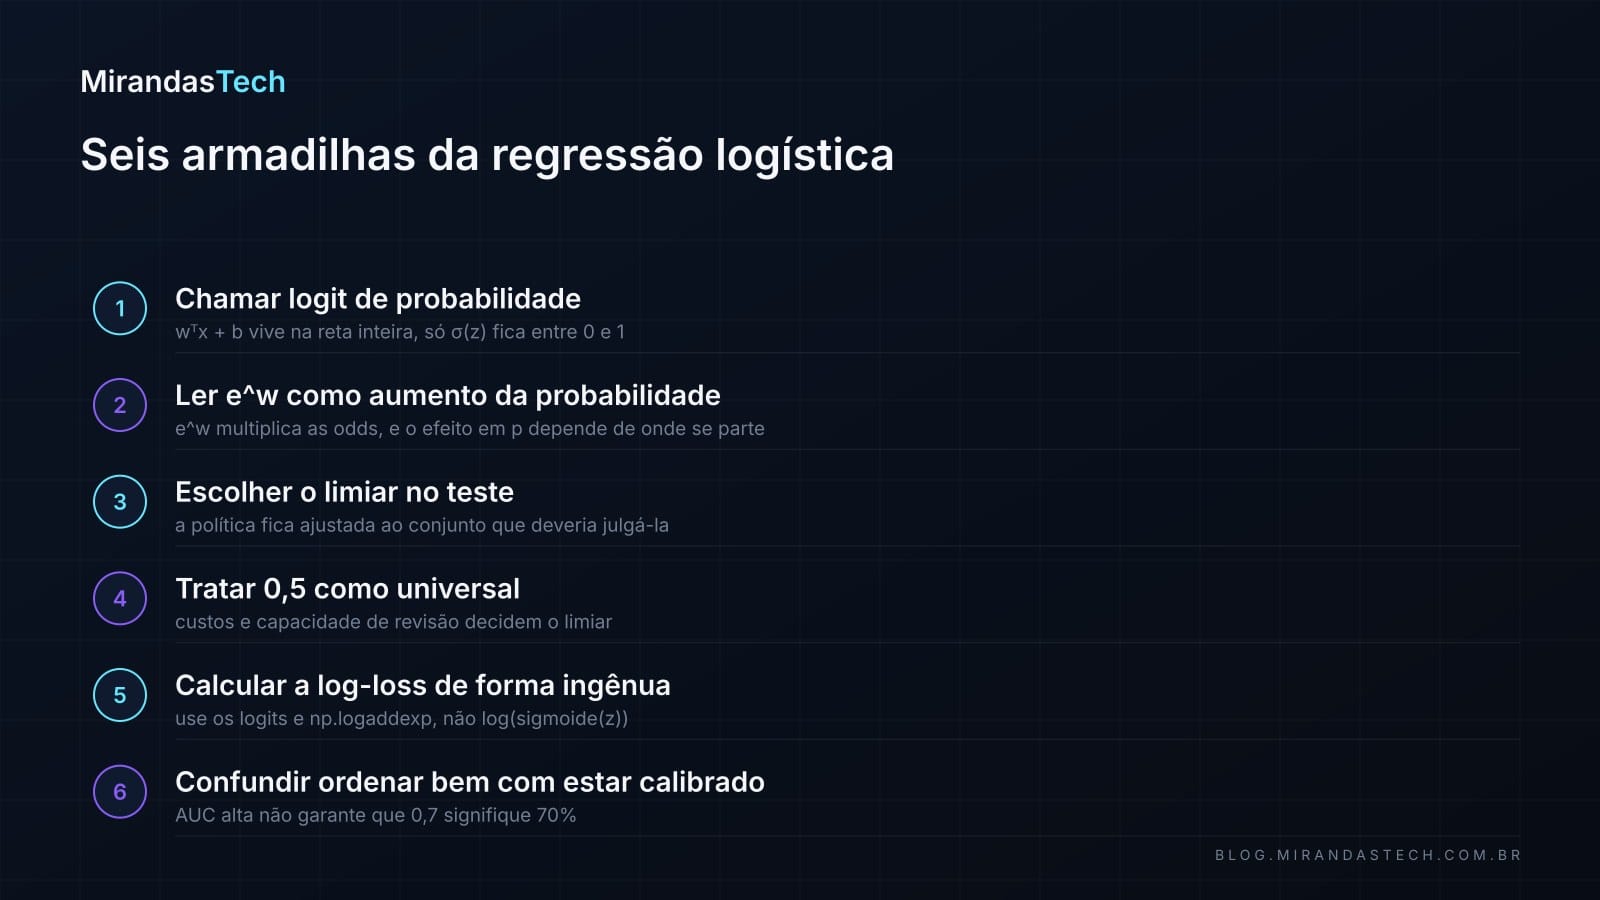
- Chamar logit de probabilidade. $w^Tx+b$ não fica preso a $[0,1]$.
- Usar regressão linear e recortar as saídas. Isso não produz o modelo Bernoulli nem a perda correta.
- Escolher o limiar no teste. A política fica ajustada ao conjunto que deveria julgá-la.
- Tratar 0,5 como universal. Custos e capacidade operacional decidem o limiar.
- Ler $e^{w_j}$ como aumento percentual da probabilidade. Ele multiplica odds.
- Esquecer qual é a classe positiva. Inverter 0 e 1 inverte a interpretação dos coeficientes e das colunas do
predict_proba. - Calcular a BCE de forma instável. Use os logits e
logaddexp, ou funções confiáveis da biblioteca. - Ignorar a separação perfeita. Sem penalidade, os coeficientes podem divergir.
- Padronizar antes do split. O scaler aprende só no treino de cada etapa.
- Tratar ordenação como calibração. AUC alta não garante que 0,7 signifique 70%.
- Confiar nas probabilidades depois de mudar a prevalência. Monitore o contexto de implantação.
- Tirar causalidade dos coeficientes. O modelo é associativo, condicionado às variáveis observadas.
14. Checklist prático
- Defini claramente qual evento é $y=1$?
- Declarei a unidade de análise e o instante da previsão?
- Separei o teste antes de ajustar modelo, regularização ou limiar?
- Todo o pré-processamento está dentro da fronteira de treino?
- A sigmoide e a log-loss estão numericamente estáveis?
- Escolhi
Csó no desenvolvimento? - Defini custos ou objetivo operacional antes de escolher o limiar?
- Comparei as probabilidades com uma referência que prevê a prevalência?
- Reportei ao menos a log-loss e uma medida de decisão coerente com os custos?
- Inspecionei a confiabilidade e os casos confiantes e errados?
- Registrei seed, versões, coeficientes e política de decisão?
- Evitei afirmações causais sem sustentação?
15. Onde isso aparece em IA aplicada
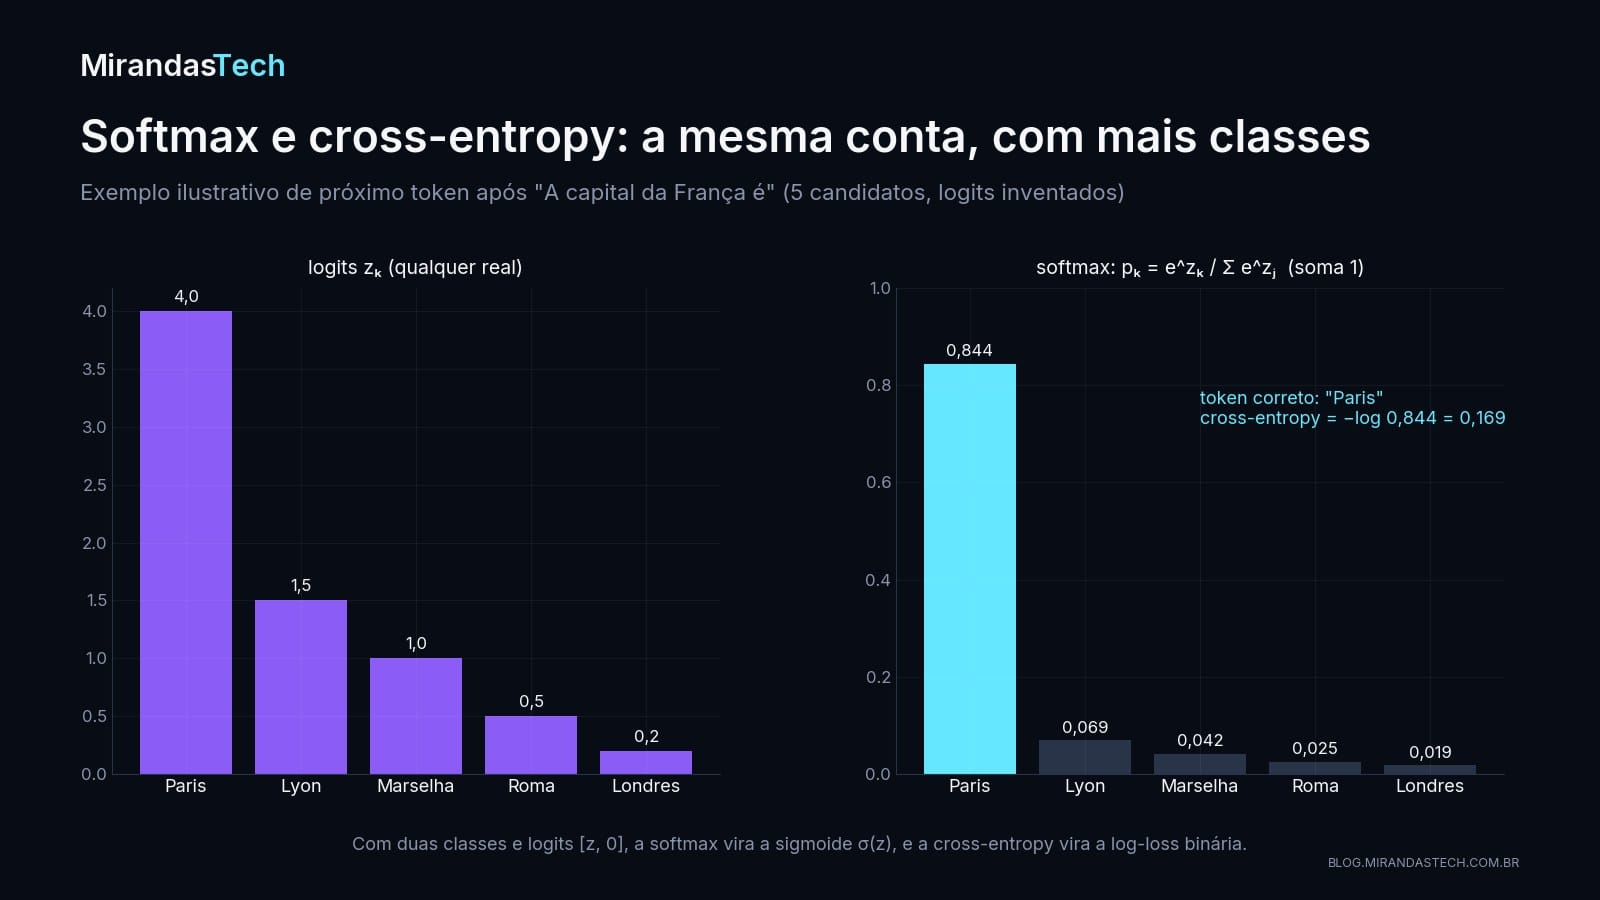
Com mais de duas classes, a sigmoide vira a softmax. Para $K$ classes com logits $z_1,\dots,z_K$,
$$ p_k=\frac{e^{z_k}}{\sum_{j=1}^{K}e^{z_j}}, \qquad \ell=-\log p_{y}, $$
onde $p_y$ é a probabilidade dada à classe correta. Com duas classes e logits $(z,0)$, a softmax devolve $e^{z}/(e^{z}+1)=\sigma(z)$, e a perda vira a log-loss binária deste artigo. O gradiente em relação aos logits continua com a mesma forma: probabilidade prevista menos o indicador da classe correta.
A mesma conta é a perda de treino de modelos de linguagem autorregressivos. No estudo sobre leis de escala, Kaplan et al. (2020) treinam Transformers otimizando a log-verossimilhança autorregressiva, isto é, a cross-entropy média sobre um contexto de 1.024 tokens, e usam essa mesma perda como principal medida de desempenho. O GPT-4 foi pré-treinado na mesma tarefa, prever o próximo token de um documento (OpenAI, 2023), embora o relatório não detalhe a perda. A cada posição, o modelo produz um logit para cada token do vocabulário, a softmax os transforma em probabilidades, e a perda é $-\log$ da probabilidade do token que de fato veio.
A segunda ponte é a calibração, e ela importa mais do que parece quando um sistema usa a confiança do modelo para decidir. Guo et al. (2017) mostraram que redes neurais modernas, ao contrário das de uma década antes, saem mal calibradas, e que, na maioria dos conjuntos de dados testados, o temperature scaling foi surpreendentemente eficaz para corrigir isso. A técnica aplica a softmax a $z/T$, com um único parâmetro $T$ aprendido minimizando a log-loss num conjunto separado; como $T$ não muda qual logit é o maior, a acurácia fica igual (scikit-learn developers, 2026c). Em modelos de linguagem, Kadavath et al. (2022) encontraram modelos grandes bem calibrados em questões de múltipla escolha e verdadeiro ou falso apresentadas no formato certo. O relatório técnico do GPT-4 descreve o modelo pré-treinado como altamente calibrado num subconjunto do MMLU e mostra que o pós-treinamento reduziu essa calibração (OpenAI, 2023). Ou seja, a probabilidade que sai de um modelo grande também precisa ser verificada, não presumida.
A terceira ponte é a separação entre estimativa e política. Um classificador de risco num fluxo de triagem assistida por IA, um filtro de segurança ou um agente que decide se pede confirmação antes de agir usam a mesma arquitetura desta aula: um modelo que devolve uma probabilidade e uma política, com custos explícitos, que decide o que fazer com ela. Trocar a política é barato e auditável. Embutir o limiar no modelo esconde a decisão.
Próximo passo
A próxima aula da série troca a fronteira global por decisões locais com o KNN, os K vizinhos mais próximos. Em vez de aprender um único hiperplano, o modelo decide olhando os exemplos parecidos, e isso torna explícitos o papel da escala, da métrica de distância e da dimensionalidade.
Referências
- Cox, D. R. The Regression Analysis of Binary Sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), p. 215–232, 1958. doi.org/10.1111/j.2517-6161.1958.tb00292.x
- Albert, A.; Anderson, J. A. On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), p. 1–10, 1984. doi.org/10.1093/biomet/71.1.1
- scikit-learn developers. Logistic regression (User Guide, seção 1.1.11) e classe LogisticRegression. Documentação oficial do scikit-learn 1.9 (acesso em 9 out. 2026), 2026a. scikit-learn.org/stable/modules/linear_model.html#logistic-regression
- scikit-learn developers. Tuning the decision threshold for class prediction (User Guide, seção 3.3). Documentação oficial do scikit-learn 1.9 (acesso em 9 out. 2026), 2026b. scikit-learn.org/stable/modules/classification_threshold.html
- scikit-learn developers. Probability calibration (User Guide, seção 1.16). Documentação oficial do scikit-learn 1.9 (acesso em 9 out. 2026), 2026c. scikit-learn.org/stable/modules/calibration.html
- Saerens, Marco; Latinne, Patrice; Decaestecker, Christine. Adjusting the Outputs of a Classifier to New a Priori Probabilities: A Simple Procedure. Neural Computation, 14(1), p. 21–41, 2002. doi.org/10.1162/089976602753284446
- Guo, Chuan; Pleiss, Geoff; Sun, Yu et al. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning (ICML 2017), PMLR 70, p. 1321–1330. arXiv:1706.04599, 2017. arxiv.org/abs/1706.04599
- Kadavath, Saurav; Conerly, Tom; Askell, Amanda et al. Language Models (Mostly) Know What They Know. Preprint arXiv:2207.05221, 2022. arxiv.org/abs/2207.05221
- Kaplan, Jared; McCandlish, Sam; Henighan, Tom et al. Scaling Laws for Neural Language Models. Preprint arXiv:2001.08361, 2020. arxiv.org/abs/2001.08361
- OpenAI. GPT-4 Technical Report. Relatório técnico, arXiv:2303.08774, 2023. arxiv.org/abs/2303.08774
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/06-regressao-logistica-classificacao-probabilistica.md.