KNN: distâncias, escala e a maldição da dimensionalidade
Classificar um caso novo pelos exemplos mais parecidos, com uma distância que faça sentido, escolher k sem tocar no teste e reconhecer quando a alta dimensão dilui a noção de proximidade.
Classificar um caso novo pelos exemplos mais parecidos, com uma distância que faça sentido, escolher k sem tocar no teste e reconhecer quando a alta dimensão dilui a noção de proximidade. Pré-requisitos: vetores, normas e distância, Aula 02 — features, target, split e baseline e Aula 03 — Pré-processamento, pipelines e data leakage.
Um chamado chega à central de suporte. O cliente espera há 30 minutos, e o texto se parece muito com o dos casos urgentes da semana anterior: similaridade 0,90 numa escala de 0 a 1. Para decidir a prioridade, a equipe quer uma regra simples: procurar os chamados antigos mais parecidos e ver como eles foram classificados. Dois candidatos aparecem. O chamado A tem o mesmo texto, mas o cliente esperou 40 minutos. O chamado B tem um texto muito diferente (similaridade 0,10) e esperou 32 minutos.
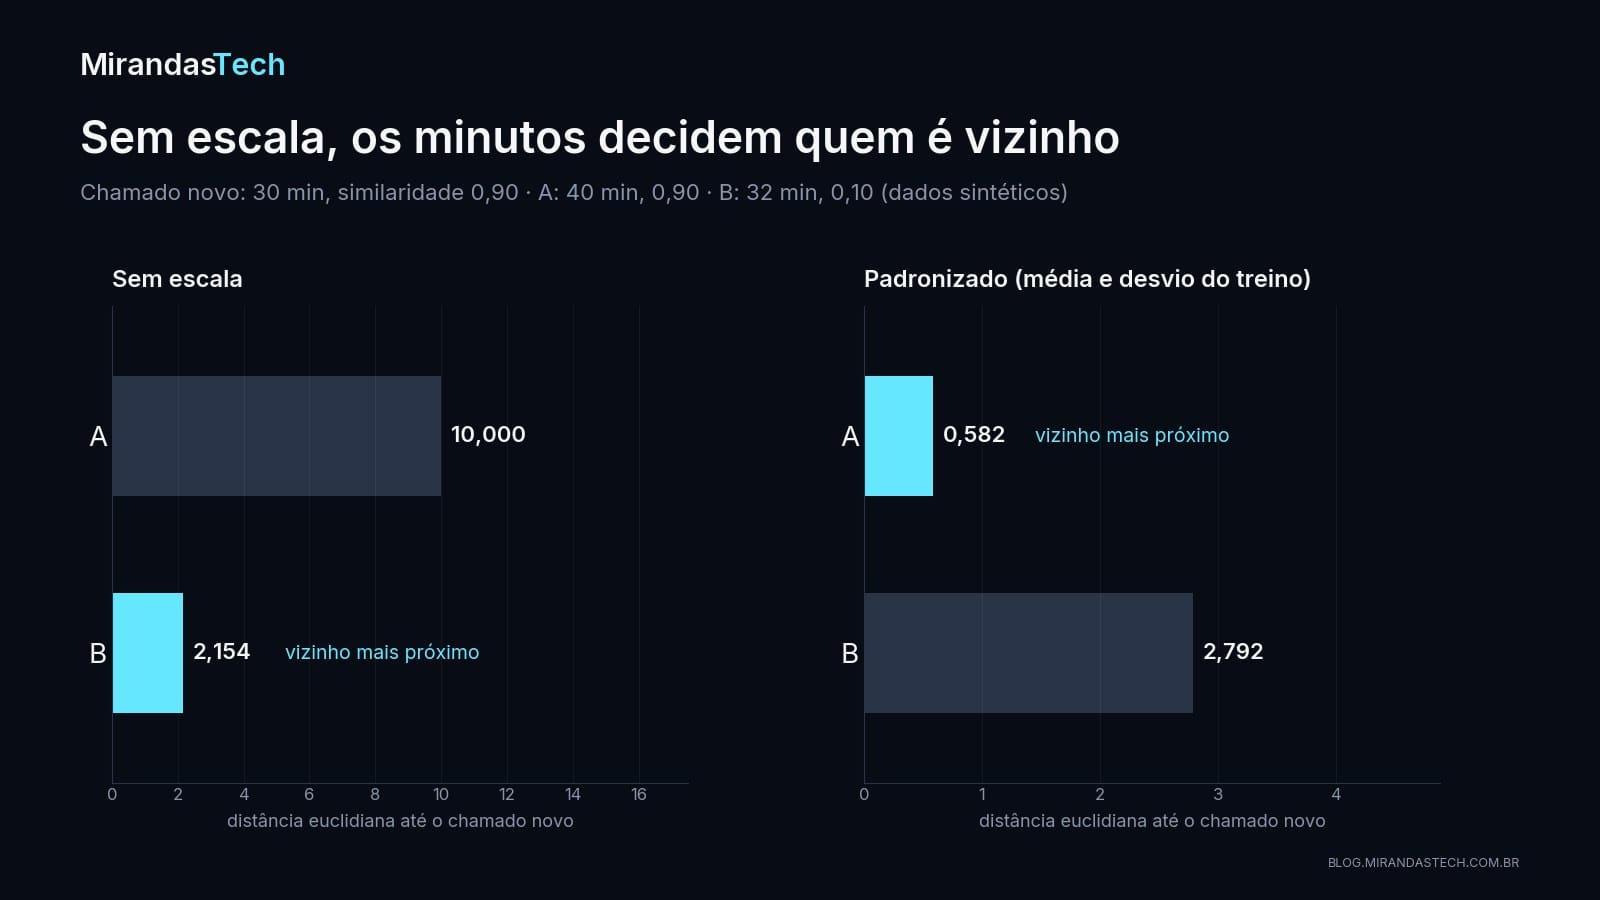
Qual dos dois é mais parecido? Pela distância euclidiana nas unidades originais, é o B: 2,15 contra 10. Dez minutos de espera pesam mais que a diferença inteira entre dois textos, porque o algoritmo não conhece unidades nem significado, só números. Depois de padronizar as duas colunas, a resposta se inverte: A fica a 0,58 da consulta, e B, a 2,79. Quem decidiu quem era vizinho de quem não foi o modelo. Foi a escala.
Essa regra tem nome: K-Nearest Neighbors (KNN), os k vizinhos mais próximos. No artigo anterior da série, a regressão logística resumia o conjunto de treino numa única combinação linear das features, uma fronteira global. O KNN faz quase o oposto: guarda os exemplos e, para cada caso novo, consulta os mais parecidos. A simplicidade esconde decisões que mudam o resultado. O que conta como parecido? Quantos vizinhos ouvir? O que acontece quando entram centenas de colunas irrelevantes? Ao final, você vai conseguir calcular uma predição à mão, escolher uma métrica coerente com a representação, padronizar dentro de um pipeline sem vazamento, escolher k sem tocar no teste e reconhecer quando a alta dimensão apaga a diferença entre perto e longe. As mesmas perguntas reaparecem na busca vetorial que alimenta os sistemas de RAG.
1. Decisões locais
Imagine um mapa em que cada exemplo de treino é um ponto colorido pela sua classe. Para classificar uma consulta, o KNN mede a distância dela a cada exemplo conhecido, separa os k menores valores, junta os rótulos desses vizinhos e devolve a classe mais votada. Em regressão, o último passo vira uma média.
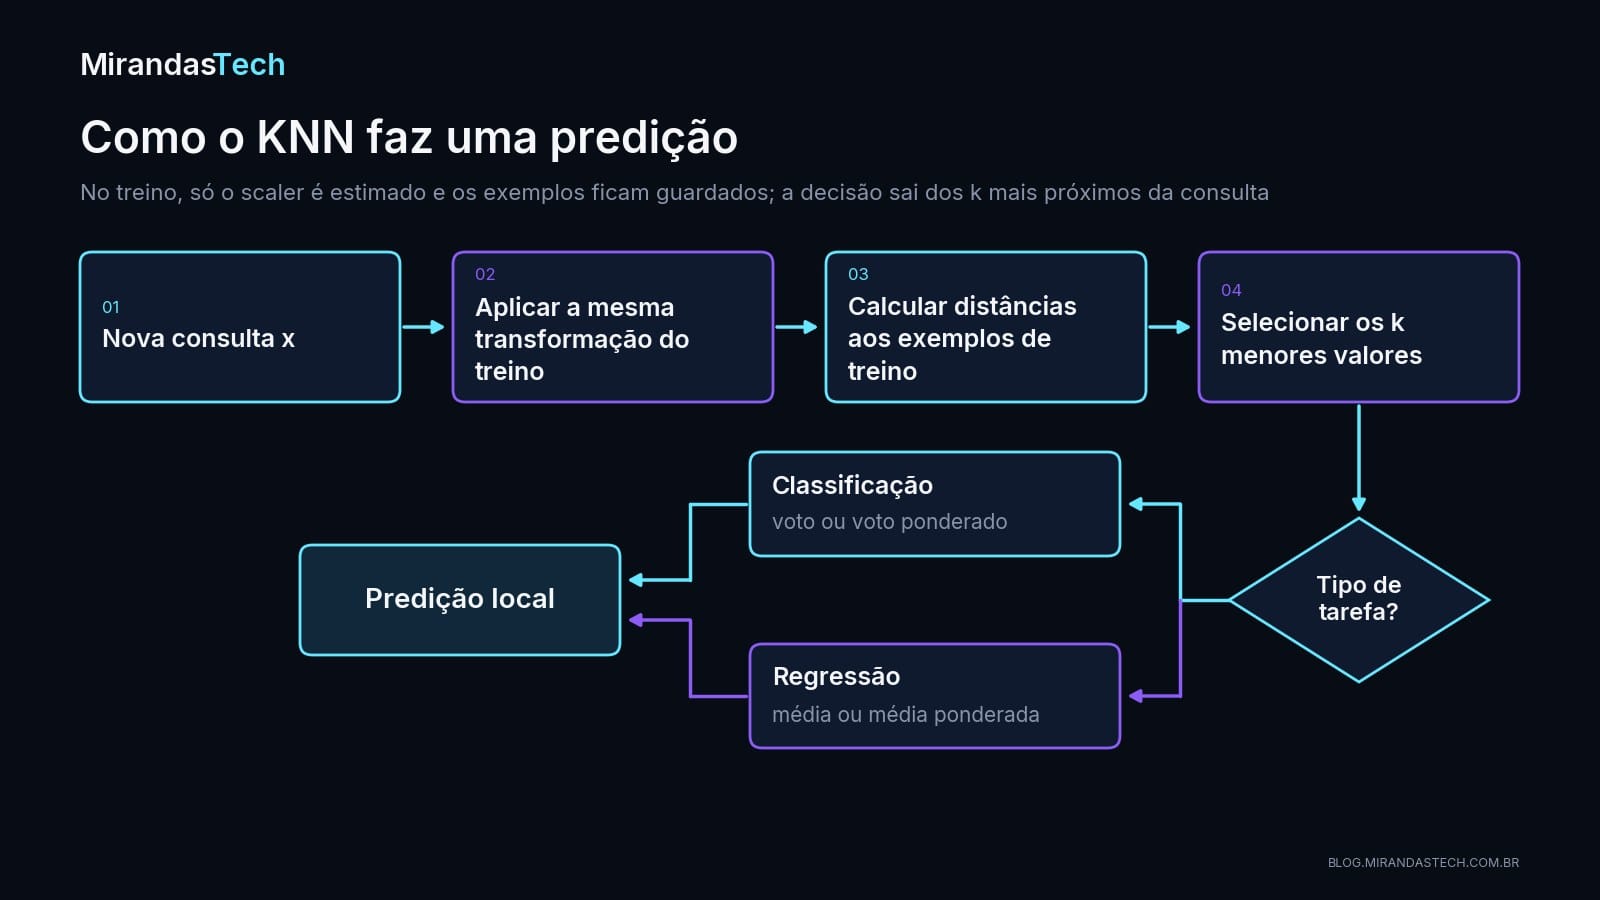
O "treino" clássico é barato: o modelo apenas armazena os exemplos, às vezes numa estrutura de índice. O custo aparece na inferência, quando é preciso encontrar os vizinhos de cada consulta. Por isso o KNN é chamado de método baseado em instâncias (scikit-learn developers, 2026a), ou de aprendizado preguiçoso (lazy learning).
O KNN também é não paramétrico (scikit-learn developers, 2026a): sua flexibilidade não fica presa a um vetor pequeno de parâmetros. Isso não quer dizer "sem hiperparâmetros". O resultado depende de k, da métrica, dos pesos, da transformação das features e da estratégia de busca.
A regra é antiga e tem uma garantia teórica conhecida. Cover e Hart (1967) mostraram que, no limite de amostras infinitas e para distribuições suficientemente suaves, a regra do vizinho mais próximo (k = 1) erra no máximo o dobro do erro de Bayes, o menor erro que qualquer regra pode atingir naquele problema. A garantia é assintótica: com amostra finita e features mal escolhidas, nada disso está assegurado.
2. Formalização e um exemplo resolvido
Os dados de treino são pares de features e alvo:
$$ \mathcal{D}=\{(\mathbf{x}_i,y_i)\}_{i=1}^{n}, $$
em que $n$ é o número de exemplos, $\mathbf{x}_i\in\mathbb{R}^{d}$ contém as $d$ features do exemplo $i$ e $y_i$ é o seu alvo. Para uma consulta $\mathbf{x}$, chamamos de $\mathcal{N}_k(\mathbf{x})$ o conjunto dos índices dos $k$ exemplos com menor distância até ela.
Em classificação com votos uniformes, a frequência local da classe $c$ é
$$ \widehat{P}(Y=c\mid\mathbf{x})= \frac{1}{k}\sum_{i\in\mathcal{N}_k(\mathbf{x})}\mathbb{1}(y_i=c), $$
onde $\mathbb{1}(\cdot)$ vale 1 quando a condição entre parênteses é verdadeira e 0 caso contrário. A soma conta quantos dos $k$ vizinhos são da classe $c$, e a divisão por $k$ transforma a contagem em proporção. A classe prevista é a que tem a maior proporção:
$$ \widehat{y}=\arg\max_c\,\widehat{P}(Y=c\mid\mathbf{x}). $$
Essa saída é uma proporção de votos e não deve ser lida automaticamente como probabilidade calibrada. Com amostra pequena, sobreposição entre classes ou um $k$ mal escolhido, ela fica discreta demais ou confiante demais. Com $k=25$, por exemplo, só existem 26 valores possíveis: $0, 1/25, 2/25, \dots, 1$.
Em regressão, a regra de agregação vira a média dos alvos dos vizinhos:
$$ \widehat{y}=\frac{1}{k}\sum_{i\in\mathcal{N}_k(\mathbf{x})}y_i. $$
A geometria é a mesma. Só muda o que se faz com os vizinhos depois de encontrá-los.
Um exemplo pequeno deixa tudo concreto. A consulta é $q=(1,1)$, e há cinco pontos de treino, já em ordem de distância euclidiana até $q$:
- A = (1, 2), classe 0: $\sqrt{0^2+1^2}=1$;
- D = (2, 2), classe 0: $\sqrt{1^2+1^2}=\sqrt{2}$;
- B = (3, 1), classe 1: $\sqrt{2^2+0^2}=2$;
- E = (7, 7), classe 1: $\sqrt{6^2+6^2}=\sqrt{72}$;
- C = (8, 8), classe 1: $\sqrt{7^2+7^2}=\sqrt{98}$.
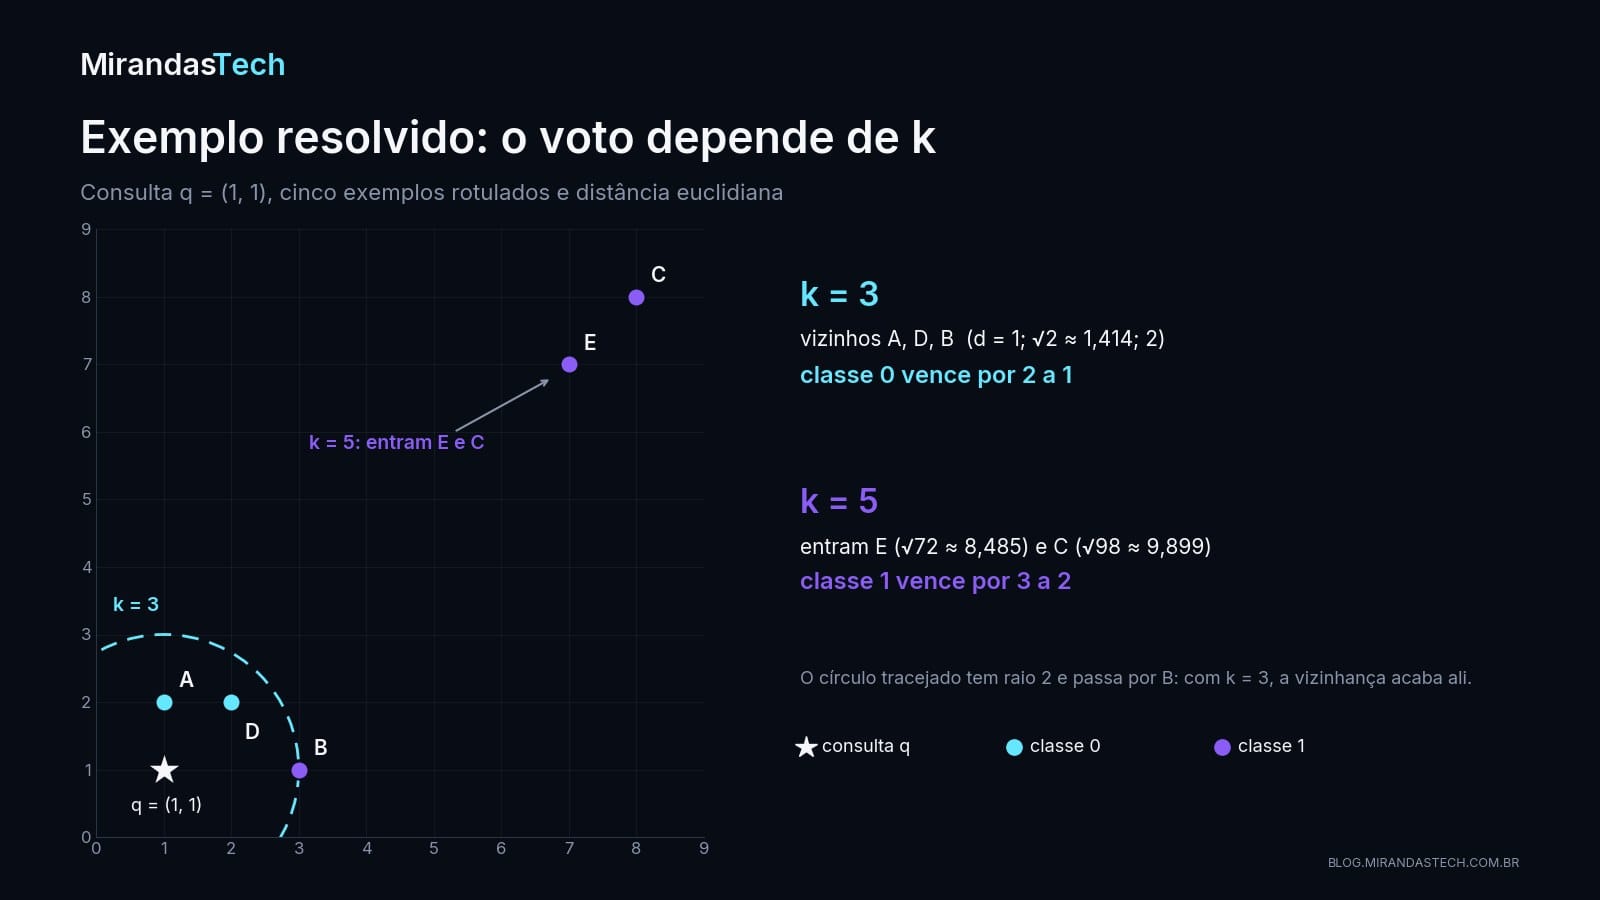
Com $k=3$, os vizinhos são A, D e B. A classe 0 recebe dois votos, a classe 1 recebe um, e a frequência local estimada é $(2/3,\ 1/3)$. Logo, $\widehat y=0$. Com $k=5$, os cinco pontos votam, e a classe 1 vence por três a dois. O algoritmo não descobriu uma verdade diferente: nós mudamos a escala espacial da pergunta. O código confere as contas:
import numpy as np

def knn_votos(X, y, q, k):
    d = np.sqrt(((X - q) ** 2).sum(axis=1))      # distância euclidiana até a consulta
    viz = np.argsort(d, kind="stable")[:k]       # os k menores, desempate pela ordem
    return d, viz, np.bincount(y[viz], minlength=2) / k

# Exemplo resolvido: consulta q = (1, 1) e cinco pontos
nomes = np.array(list("ADBEC"))
X = np.array([[1, 2], [2, 2], [3, 1], [7, 7], [8, 8]], dtype=float)
y = np.array([0, 0, 1, 1, 1])
q = np.array([1.0, 1.0])
for k in (3, 5):
    d, viz, freq = knn_votos(X, y, q, k)
    print(f"k={k}: vizinhos {''.join(nomes[viz])} | frequências {freq.round(3)} | classe {freq.argmax()}")
print("distâncias:", "  ".join(f"{n}={v:.3f}" for n, v in zip(nomes, d)))
Saída real:
k=3: vizinhos ADB | frequências [0.667 0.333] | classe 0
k=5: vizinhos ADBEC | frequências [0.4 0.6] | classe 1
distâncias: A=1.000  D=1.414  B=2.000  E=8.485  C=9.899
O mesmo efeito aparece num caso ainda menor. Para a consulta $(0,0)$ e os pontos (1, 0) da classe 0, (0, 2) da classe 1 e (2, 2) da classe 1, as distâncias são 1, 2 e $\sqrt 8$. Com $k=1$, só o primeiro vota, e a saída é 0. Com $k=3$, a classe 1 vence por dois a um. O $k$ define o tamanho da região que responde pela decisão.
3. A métrica define a vizinhança
A distância euclidiana é a escolha mais comum, mas não é a única. Ela pertence à família de Minkowski:
$$ d_p(\mathbf{x},\mathbf{z})= \left(\sum_{j=1}^{d}|x_j-z_j|^p\right)^{1/p}, $$
em que $\mathbf{x}$ e $\mathbf{z}$ são os dois pontos comparados, $j$ percorre as features, $d$ é o número de features (a dimensionalidade) e $p\ge1$ controla a geometria. Com $p=1$, a fórmula vira a distância de Manhattan; com $p=2$, a euclidiana.
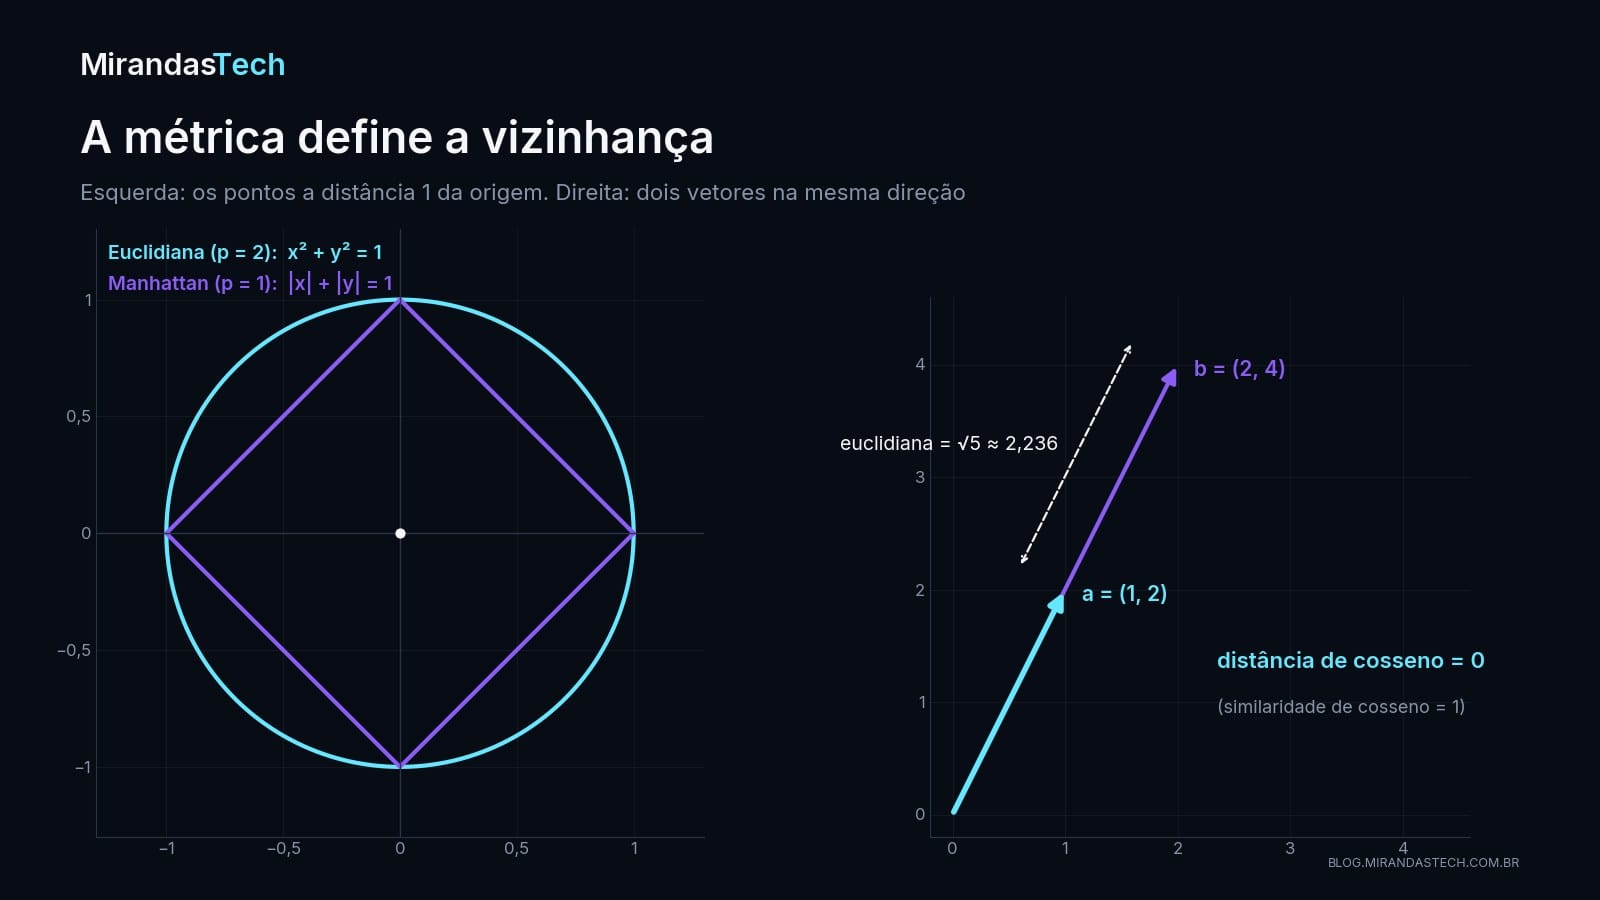
Quatro métricas aparecem o tempo todo:
- Euclidiana ($p=2$): a linha reta entre os pontos. Funciona bem com features contínuas padronizadas, mas é sensível à escala e a valores extremos.
- Manhattan ($p=1$): a soma das diferenças eixo a eixo. Faz sentido quando desvios em cada feature se acumulam, e continua exigindo escala coerente.
- Cosseno: mede a diferença de direção entre dois vetores, como na similaridade de cosseno usada com embeddings. É comum com vetores esparsos e embeddings. Ignora a magnitude, e o vetor zero precisa de tratamento à parte, porque não tem direção.
- Hamming: a proporção de posições diferentes. Serve para atributos binários comparáveis; a forma de codificar categorias muda o que ela mede.
Escolher a métrica não é procurar a que dá o melhor número. A distância precisa expressar a noção de similaridade que importa no problema. Para texto, o cosseno pode ser adequado. Para latitude e longitude, a geometria esférica importa. Para categorias nominais, codificar azul=1, verde=2, vermelho=3 cria distâncias que não existem: vermelho passa a ficar "duas vezes mais longe" de azul do que verde.
4. Escala: quem manda na distância
Numa soma de quadrados, a coluna com os maiores números domina. Se uma feature está em milhares e outra vai de 0 a 1, a segunda quase não muda a distância euclidiana, por mais relevante que seja. A correção usual é a padronização, aplicada a cada coluna $j$:
$$ z_j=\frac{x_j-\mu_j}{\sigma_j}, $$
em que $x_j$ é o valor original, $\mu_j$ é a média da coluna e $\sigma_j$ é o seu desvio-padrão. Depois da transformação, todas as colunas têm média 0 e desvio 1 no conjunto em que $\mu_j$ e $\sigma_j$ foram estimados.
O detalhe que decide se a avaliação é honesta: $\mu_j$ e $\sigma_j$ devem ser estimados apenas no treino. Em validação cruzada, isso significa colocar o StandardScaler dentro do Pipeline, para que ele seja reajustado em cada fold. Quem ajusta o scaler na base inteira e só depois roda a validação cruzada deixa a média e o desvio dos folds de validação entrarem no treino. É o vazamento discutido em pré-processamento, pipelines e data leakage.
O exemplo da abertura, com dados sintéticos: 500 chamados de treino com tempo de espera uniforme entre 0 e 60 minutos e similaridade uniforme entre 0 e 1.
import numpy as np
from sklearn.preprocessing import StandardScaler

# Dados sintéticos: 500 chamados de treino com tempo de espera (0 a 60 min)
# e similaridade textual com casos urgentes (0 a 1)
rng = np.random.default_rng(20260908)
treino = np.c_[rng.uniform(0, 60, 500), rng.uniform(0, 1, 500)]

consulta = np.array([[30.0, 0.90]])   # chamado novo
A = np.array([[40.0, 0.90]])          # mesmo texto, 10 minutos de diferença
B = np.array([[32.0, 0.10]])          # 2 minutos de diferença, texto muito diferente

def dist(u, v):
    return float(np.linalg.norm(u - v))

print(f"sem escala:  d(consulta, A) = {dist(consulta, A):.3f} | d(consulta, B) = {dist(consulta, B):.3f}")

esc = StandardScaler().fit(treino)    # média e desvio estimados só no treino
print("desvios do treino:", esc.scale_.round(3))
c, a, b = esc.transform(consulta), esc.transform(A), esc.transform(B)
print(f"padronizado: d(consulta, A) = {dist(c, a):.3f} | d(consulta, B) = {dist(c, b):.3f}")
Saída real:
sem escala:  d(consulta, A) = 10.000 | d(consulta, B) = 2.154
desvios do treino: [17.19   0.287]
padronizado: d(consulta, A) = 0.582 | d(consulta, B) = 2.792
Sem escala, a distância até A é exatamente 10, porque só o tempo difere. Até B, é 2,154: na soma dos quadrados, os 2 minutos contribuem com 4, e a diferença de 0,80 na similaridade, com apenas 0,64. No treino, o desvio do tempo é 17,19 minutos, e o da similaridade, 0,287. Divididas por esses valores, as diferenças viram "quantos desvios", e o texto volta a pesar.
Trocar a unidade à mão não é uma solução geral. Dividir uma renda em reais por 1.000 só troca uma unidade arbitrária por outra, e pode continuar privilegiando uma coluna. A transformação precisa de justificativa e precisa ser estimada só no treino. Padronizar também não torna uma feature relevante: uma coluna de ruído padronizada continua sendo ruído, e passa a contribuir para a distância com o mesmo peso das demais. A seção 6 mostra o tamanho desse estrago.
5. Escolhendo k: localidade contra suavização
O $k$ controla a complexidade efetiva do modelo (Hastie, Tibshirani e Friedman, 2009). É o mesmo compromisso entre viés e variância que a regularização controlava nos modelos lineares, só que agora medido em quantos vizinhos opinam:
- $k=1$: fronteira muito local, e treino frequentemente perfeito, porque cada ponto é o próprio vizinho. O risco é a variância alta: um único rótulo ruidoso cria uma ilha na fronteira.
- $k$ intermediário: combina a evidência de uma região. O valor bom depende da densidade dos dados.
- $k$ muito grande: fronteira suave, que tende à prevalência global. O risco é o viés alto e o apagamento de grupos minoritários locais.
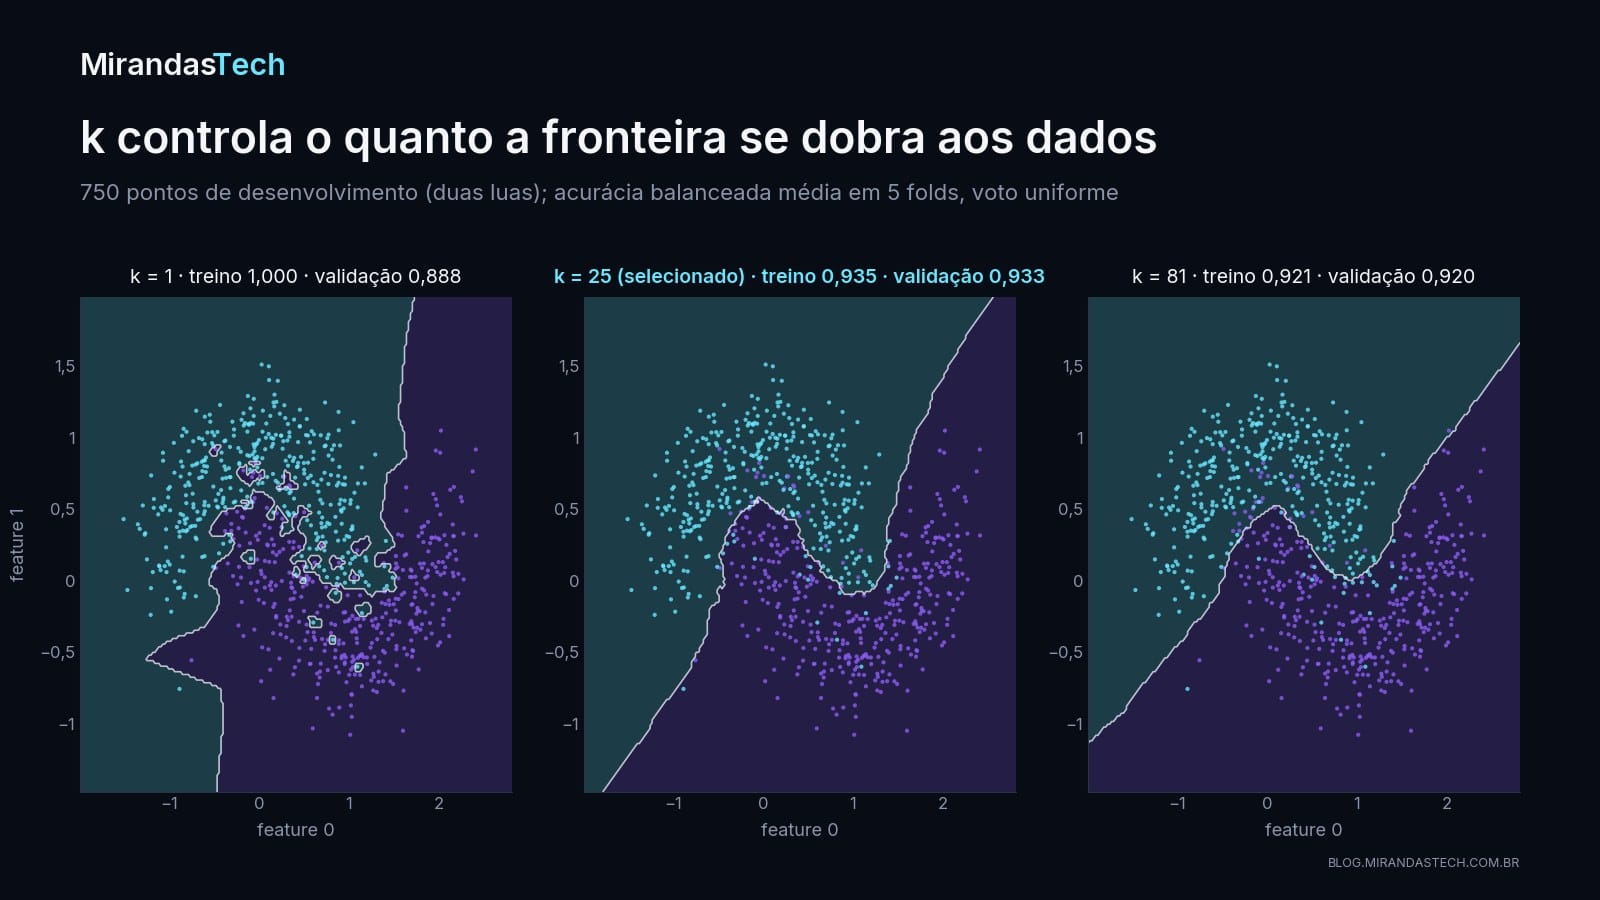
Não existe $k$ universal. No laboratório da seção 9, medida pela acurácia balanceada (a média do recall de cada classe, que dá o mesmo peso às duas; scikit-learn developers, 2026b), a validação cruzada sobe de 0,888 com $k=1$ para 0,933 com $k=25$, enquanto a nota de treino cai de 1,000 para 0,935: o modelo decora menos e generaliza mais. O caminho é escolher uma grade plausível e compará-la por validação cruzada nos dados de desenvolvimento. Em classificação binária com voto uniforme, um $k$ ímpar elimina o empate de votos; em problemas multiclasse, não. Distâncias idênticas na borda da vizinhança são outro empate, o de quem entra como vizinho, e o scikit-learn o resolve pela ordem dos dados (scikit-learn developers, 2026a).
Votos por distância
No voto uniforme, o vizinho colado na consulta e o mais afastado dos $k$ pesam o mesmo. A alternativa é dar a cada vizinho um peso que diminui com a distância:
$$ w_i=\frac{1}{d(\mathbf{x},\mathbf{x}_i)+\varepsilon}, $$
em que $d(\mathbf{x},\mathbf{x}_i)$ é a distância da consulta ao vizinho $i$ e $\varepsilon>0$ é uma constante pequena que evita divisão por zero. Cada classe acumula os pesos dos seus vizinhos, e vence a de maior soma.
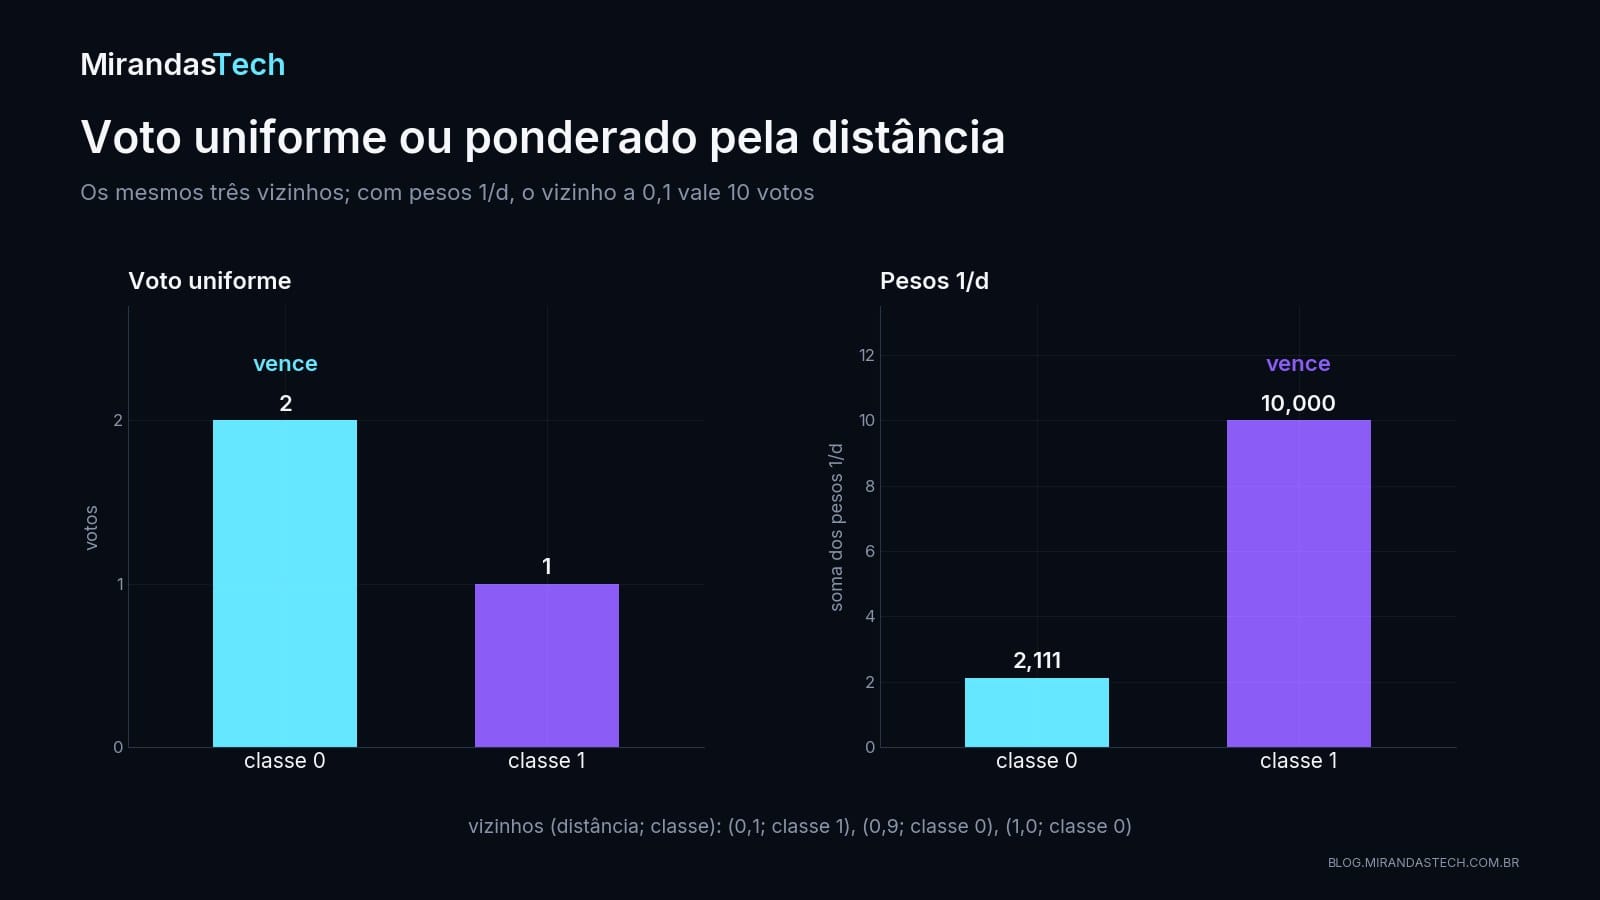
Um caso com três vizinhos mostra a diferença. As distâncias e classes são (0,1; classe 1), (0,9; classe 0) e (1,0; classe 0):
import numpy as np

# Voto uniforme x voto por 1/d: três vizinhos com (distância, classe)
dist = np.array([0.1, 0.9, 1.0])
cls = np.array([1, 0, 0])
w = 1 / dist
print("uniforme -> classe 0:", (cls == 0).sum(), "| classe 1:", (cls == 1).sum())
print(f"pesos 1/d -> classe 0: {w[cls == 0].sum():.3f} | classe 1: {w[cls == 1].sum():.3f}")

# O mesmo caso no scikit-learn, em uma dimensão (consulta em 0)
from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier(n_neighbors=3, weights="distance").fit(dist.reshape(-1, 1), cls)
print("predict_proba com weights='distance':", knn.predict_proba([[0.0]]).round(3))
print("consulta em 0,1 (distância zero a um ponto):", knn.predict_proba([[0.1]]).round(3))
Saída real:
uniforme -> classe 0: 2 | classe 1: 1
pesos 1/d -> classe 0: 2.111 | classe 1: 10.000
predict_proba com weights='distance': [[0.174 0.826]]
consulta em 0,1 (distância zero a um ponto): [[0. 1.]]
No voto uniforme, a classe 0 vence por dois a um. Com peso $1/d$, a classe 1 recebe 10, e a classe 0, $1/0{,}9+1/1\approx2{,}111$. A classe 1 vence. O scikit-learn faz a mesma conta com weights="distance", sem o $\varepsilon$: as proporções são $2{,}111/12{,}111\approx0{,}174$ e $10/12{,}111\approx0{,}826$. Quando a consulta coincide com um ponto de treino, a implementação dá peso 1 aos pontos a distância zero e peso 0 aos demais, como diz um comentário da função _get_weights no código-fonte (scikit-learn developers, 2026c) e como mostra a última linha da saída acima. É por isso que, no laboratório, toda configuração com voto por distância tem nota de treino 1,000: cada exemplo de treino encontra a si mesmo.
O ganho de localidade tem um preço. Um vizinho muito próximo passa a decidir sozinho, inclusive quando é uma duplicata com rótulo errado. Por isso o tipo de peso (weights) é um hiperparâmetro a validar como qualquer outro.
Empates, duplicatas e reprodutibilidade
- Documente a regra de desempate.
- Investigue pontos duplicados com rótulos conflitantes.
- Preserve a ordem dos dados quando a implementação a usa para desempatar distâncias idênticas, como faz o scikit-learn (scikit-learn developers, 2026a).
- Registre transformações, métrica, $k$, pesos e versão da biblioteca.
6. A maldição da dimensionalidade
Em duas ou três dimensões, perto e longe são fáceis de distinguir. Cada dimensão independente que entra acrescenta variação à distância. O espaço cresce rapidamente, os dados ficam esparsos, e uma quantidade fixa de exemplos cobre uma fração cada vez menor dele (Hastie, Tibshirani e Friedman, 2009). Um sinal operacional desse efeito é o contraste relativo de uma consulta:
$$ C=\frac{d_{\max}-d_{\min}}{d_{\min}}, $$
em que $d_{\min}$ e $d_{\max}$ são a menor e a maior distância da consulta aos pontos de referência. Se $C$ é grande, o vizinho mais próximo se destaca com folga. Se $C$ cai, o mais próximo e o mais distante ficam parecidos, e "vizinho mais próximo" perde o sentido. Beyer et al. (1999) mostraram que, sob um conjunto amplo de condições, a distância ao ponto mais próximo se aproxima da distância ao mais distante à medida que a dimensão cresce.
A simulação a seguir mede $C$ para 200 consultas, cada uma comparada a 1.000 pontos gaussianos, em 2, 10, 50 e 200 dimensões:
import numpy as np

# 200 consultas, cada uma comparada a 1.000 pontos gaussianos padrão
rng = np.random.default_rng(20260908 + 1)
print("  d   contraste C (mediana)   d_min / média (mediana)")
for d in [2, 10, 50, 200]:
    ref = rng.normal(size=(1_000, d))
    consultas = rng.normal(size=(200, d))
    C, razao = [], []
    for q in consultas:
        ds = np.linalg.norm(ref - q, axis=1)
        C.append((ds.max() - ds.min()) / ds.min())
        razao.append(ds.min() / ds.mean())
    print(f"{d:>3}   {np.median(C):>18.3f}   {np.median(razao):>22.3f}")
Saída real:
  d   contraste C (mediana)   d_min / média (mediana)
  2               88.163                    0.035
 10                3.098                    0.414
 50                0.768                    0.730
200                0.317                    0.864
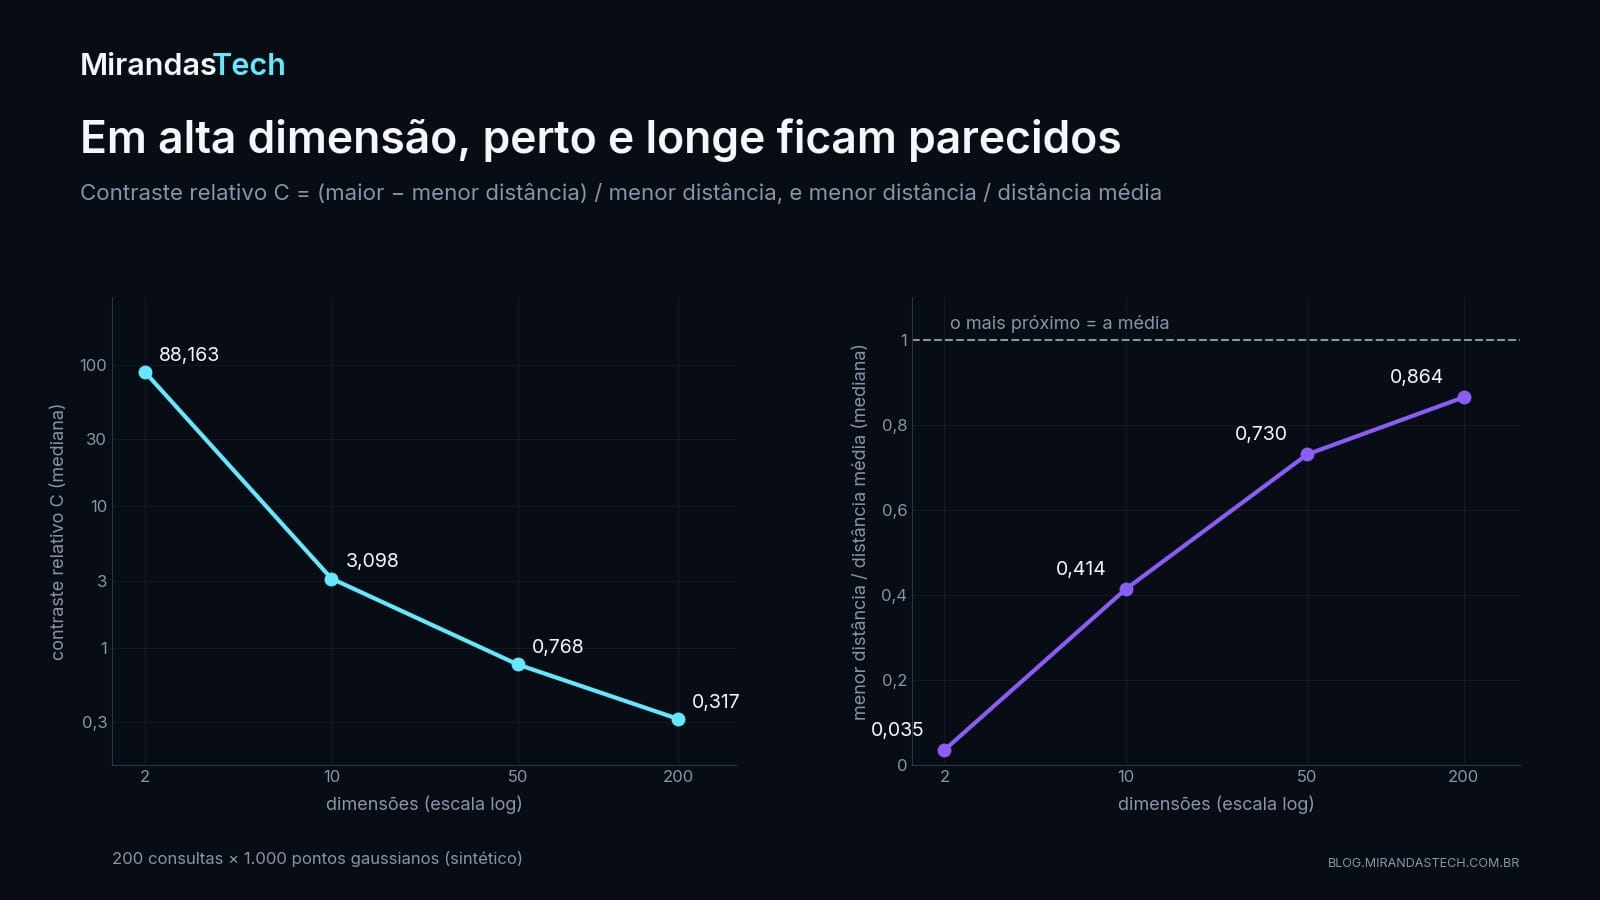
Em duas dimensões, o ponto mais distante está, na mediana, 88 vezes mais longe que o mais próximo, e o mais próximo está a 3,5% da distância média. Em 200 dimensões, o contraste cai para 0,32: o mais distante fica só 32% mais longe que o mais próximo, e o mais próximo está a 86% da distância média.
Isso não quer dizer que toda tarefa em alta dimensão seja impossível, e os próprios Beyer et al. (1999) apontam cargas de alta dimensão em que o efeito não aparece. Dados reais podem ocupar uma estrutura de dimensão intrínseca menor (scikit-learn developers, 2026a), e boas representações podem aproximar os itens que importam. A conclusão prática é outra: proximidade precisa ser medida e validada, não presumida.
Features irrelevantes
Suponha duas features informativas e 200 colunas gaussianas independentes do alvo. Depois da padronização, cada coluna de ruído contribui para a distância com variância comparável à das úteis, e a soma dessas contribuições encobre a geometria das duas primeiras.
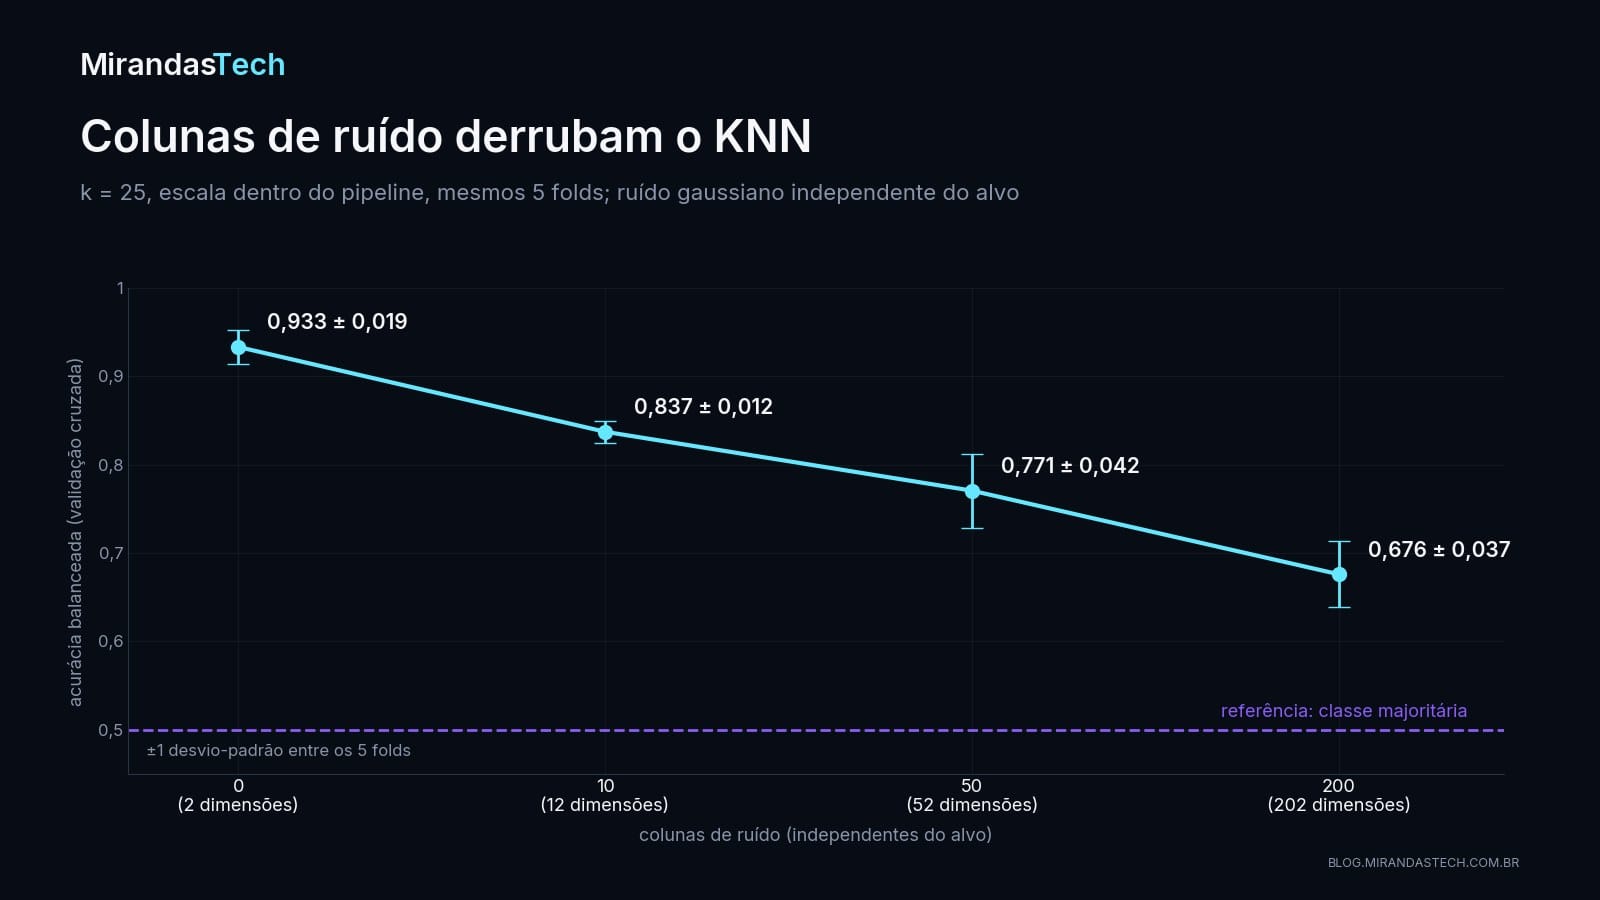
O laboratório faz exatamente esse teste, com o mesmo $k$, a mesma escala e os mesmos folds. A acurácia balanceada cai de 0,933 sem ruído para 0,837 com 10 colunas, 0,771 com 50 e 0,676 com 200. Aumentar $k$ não basta. Um $k$ maior suaviza o voto e recupera um pouco, mas não a geometria que o ruído encobriu: numa rodada extra, com os mesmos folds e a mesma semente, 200 colunas de ruído com $k=151$ chegam a 0,728 (contra 0,676 com $k=25$), e 50 colunas com $k=301$ chegam a 0,833 (contra 0,771). Nada disso se aproxima de 0,933. É preciso rever a representação, a relevância das features, a métrica e a quantidade de dados, e validar qualquer mudança sem tocar no teste.
É aqui que o KNN se liga ao resto da série. Seleção e engenharia de atributos procuram representações mais informativas. Redução de dimensionalidade, que vem mais adiante, pode remover redundância. Embeddings aprendidos tentam colocar objetos semanticamente parecidos perto uns dos outros. E a busca vetorial em RAG é, em essência, uma forma escalável de recuperar por vizinhança. Uma regra vale para todas: a redução de dimensionalidade também é ajustada dentro do protocolo de validação, nunca antes da divisão dos dados.
7. Custo computacional e implantação
Para $n$ exemplos e $d$ features, a busca exata por força bruta calcula cerca de $n\times d$ contribuições por consulta, e o armazenamento também é da ordem de $n\times d$. Em lotes grandes, isso pode estourar o orçamento de latência e de memória.
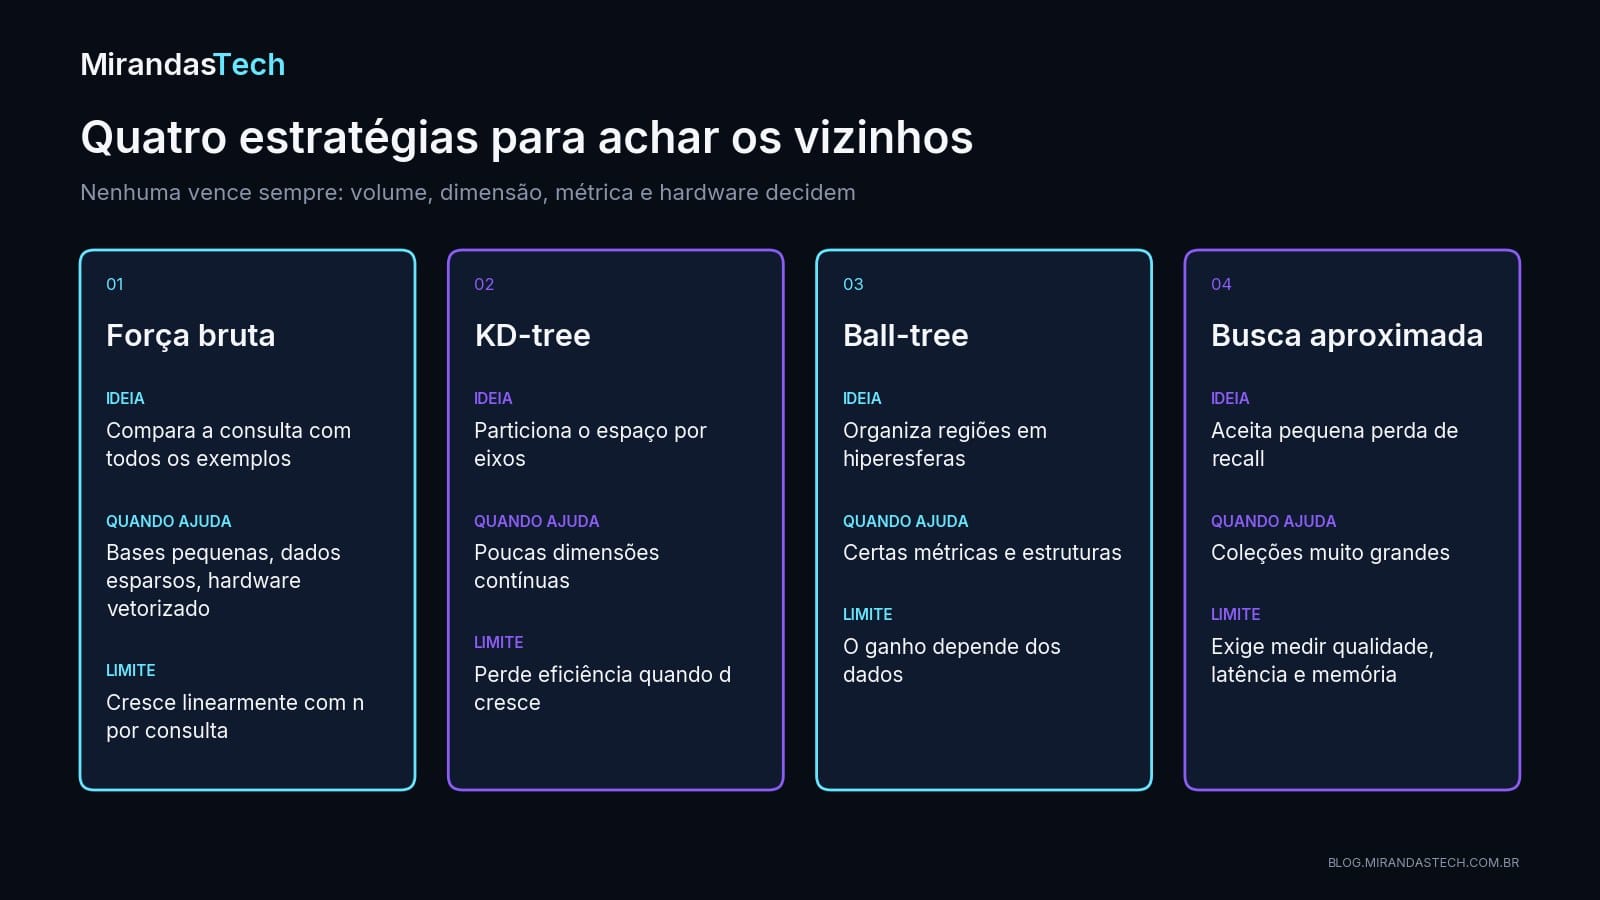
- Força bruta: compara a consulta com todos os exemplos. Serve para bases pequenas, dados esparsos e hardware vetorizado. O custo por consulta cresce linearmente com $n$.
- KD-tree: particiona o espaço eixo a eixo. Ajuda com poucas dimensões contínuas e perde eficiência quando $d$ cresce; a documentação do scikit-learn fala em menos de 20 dimensões (scikit-learn developers, 2026a).
- Ball-tree: organiza regiões em hiperesferas. Ajuda com certas métricas e estruturas geométricas; o ganho depende dos dados.
- Busca aproximada: aceita perder alguns vizinhos verdadeiros (uma pequena perda de recall) em troca de velocidade (Malkov e Yashunin, 2020). Serve para coleções muito grandes e exige medir qualidade, latência e memória.
No scikit-learn, algorithm="auto" escolhe entre as estratégias disponíveis a partir dos dados e dos parâmetros; com mais de 15 dimensões, por exemplo, vai para força bruta (scikit-learn developers, 2026a). É uma heurística da biblioteca, não uma garantia de desempenho. Faça benchmark com o volume, a métrica e o hardware reais.
8. Protocolo metodológico
Tudo o que foi dito até aqui cabe num protocolo que não deixa o teste influenciar nenhuma escolha:
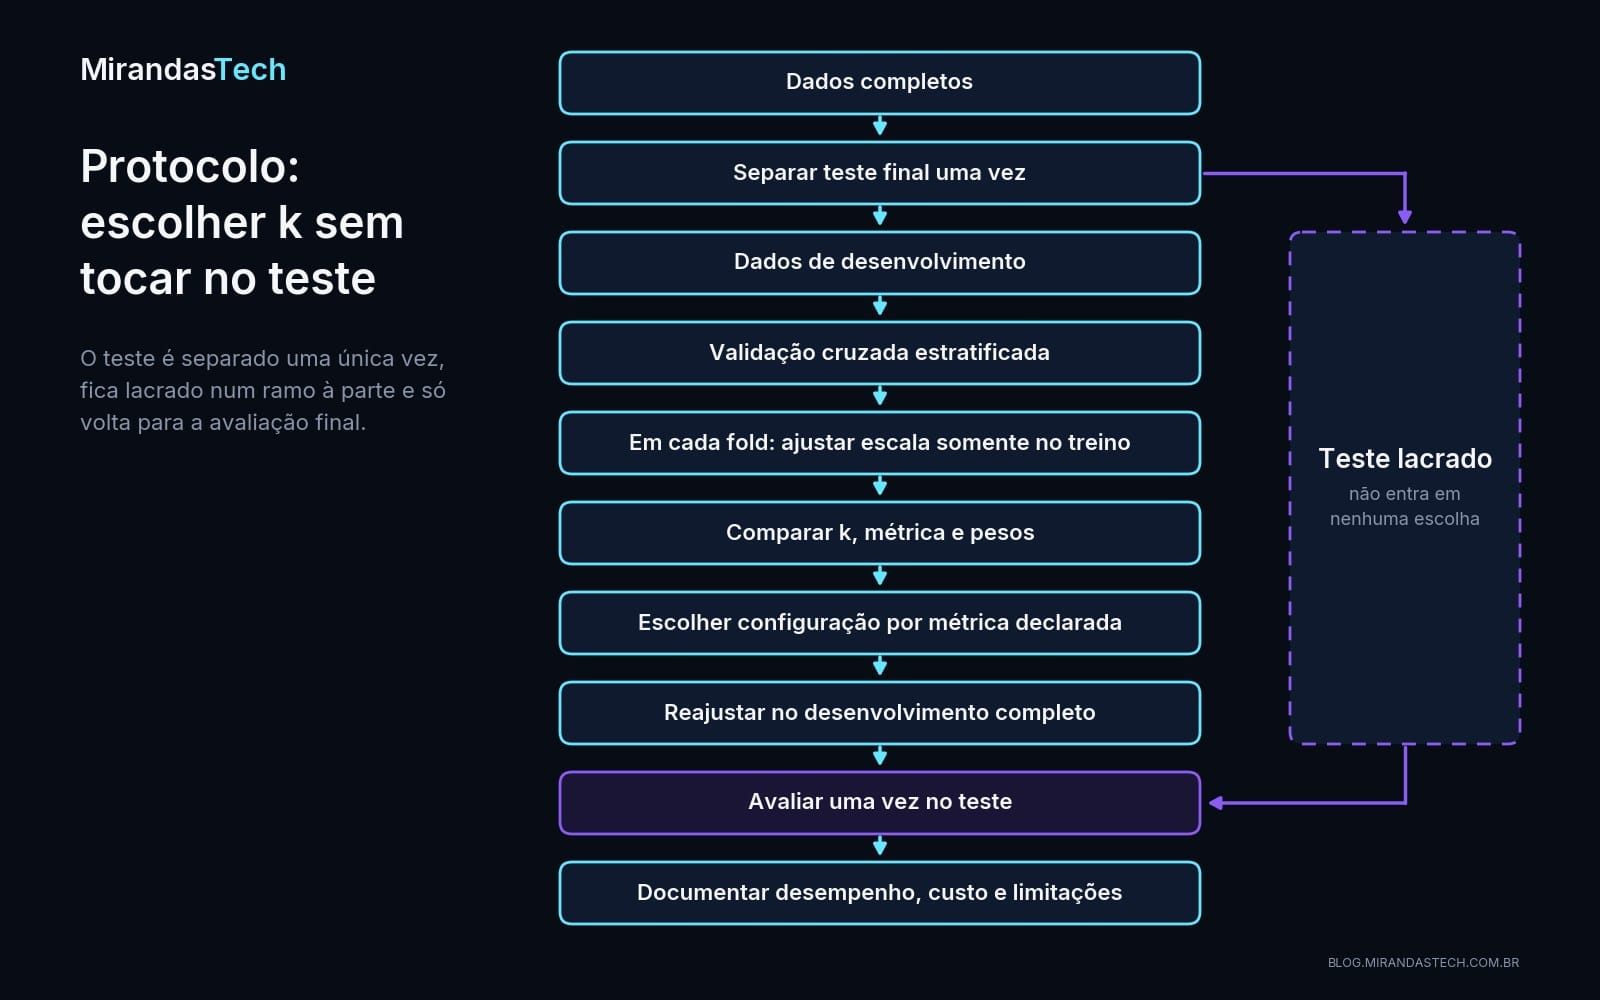
- Defina a unidade de análise e elimine duplicação entre partições.
- Separe o teste antes de explorar hiperparâmetros.
- Encapsule imputação, codificação e escala num pipeline.
- Escolha uma métrica de avaliação coerente com os custos e as classes.
- Compare $k$, pesos e, se houver justificativa, a distância, sempre nos mesmos folds.
- Olhe a média e a dispersão entre folds, não só o maior número.
- Selecione a configuração sem consultar o teste.
- Reajuste no desenvolvimento completo e abra o teste uma vez.
- Meça também memória, tempo de consulta e comportamento em subgrupos.
- Registre o protocolo para reprodução.
9. Na prática: o laboratório em dois blocos
O laboratório da aula usa dados sintéticos de make_moons: 1.000 pontos em duas classes que formam arcos intercalados, uma fronteira curva que favorece um método local. A primeira feature é multiplicada por 1.000, como se uma coluna estivesse em milímetros e a outra em metros. Vinte e cinco por cento dos dados vão para o teste antes de qualquer outra coisa. O primeiro bloco escolhe $k$ e pesos por validação cruzada estratificada de 5 folds, com o StandardScaler dentro do Pipeline, e compara com o KNN sem escala.
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import GridSearchCV, StratifiedKFold, cross_val_score, train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

SEED = 20260908
X_base, y = make_moons(n_samples=1_000, noise=0.24, random_state=SEED)
idx_dev, idx_test = train_test_split(np.arange(len(y)), test_size=0.25, stratify=y, random_state=SEED)
X = X_base.copy()
X[:, 0] *= 1_000.0                    # a primeira feature numa unidade mil vezes maior
X_dev, X_test, y_dev, y_test = X[idx_dev], X[idx_test], y[idx_dev], y[idx_test]

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)
k_values = [1, 3, 5, 9, 15, 25, 41]
pipe = Pipeline([("scale", StandardScaler()), ("knn", KNeighborsClassifier())])
grid = GridSearchCV(pipe, {"knn__n_neighbors": k_values, "knn__weights": ["uniform", "distance"]},
                    scoring="balanced_accuracy", cv=cv, return_train_score=True)
grid.fit(X_dev, y_dev)                # o teste não entra aqui

r = grid.cv_results_
print(" k  treino  validação (voto uniforme, acurácia balanceada)")
for i, p in enumerate(r["params"]):
    if p["knn__weights"] == "uniform":
        print(f"{p['knn__n_neighbors']:>2}  {r['mean_train_score'][i]:.3f}   "
              f"{r['mean_test_score'][i]:.3f} ± {r['std_test_score'][i]:.3f}")
print("melhor:", grid.best_params_, f"| CV = {grid.best_score_:.4f}")

sem_escala = max(cross_val_score(KNeighborsClassifier(n_neighbors=k), X_dev, y_dev,
                                 scoring="balanced_accuracy", cv=cv).mean() for k in k_values)
print(f"melhor CV sem escala: {sem_escala:.4f} | ganho do pipeline: {grid.best_score_ - sem_escala:.4f}")
Saída real:
 k  treino  validação (voto uniforme, acurácia balanceada)
 1  1.000   0.888 ± 0.020
 3  0.949   0.920 ± 0.015
 5  0.944   0.919 ± 0.018
 9  0.938   0.923 ± 0.021
15  0.938   0.932 ± 0.018
25  0.935   0.933 ± 0.019
41  0.933   0.931 ± 0.016
melhor: {'knn__n_neighbors': 25, 'knn__weights': 'uniform'} | CV = 0.9333
melhor CV sem escala: 0.7187 | ganho do pipeline: 0.2147
A grade escolheu $k=25$ com voto uniforme, com acurácia balanceada de 0,9333 na validação cruzada. Sem escala, o melhor resultado da mesma grade é 0,7187: a coluna multiplicada por 1.000 decide sozinha quem é vizinho. O pipeline ganha 0,2147, e o ganho vem só de medir a distância numa unidade coerente.
O segundo bloco continua o primeiro. Abre o teste uma vez, audita os vizinhos de uma predição e repete a ablação de ruído da seção 6.
from sklearn.dummy import DummyClassifier
from sklearn.metrics import balanced_accuracy_score

# Só agora o teste é aberto, uma vez
modelo = grid.best_estimator_         # já reajustado no desenvolvimento inteiro (refit)
teste = balanced_accuracy_score(y_test, modelo.predict(X_test))
dummy = DummyClassifier(strategy="most_frequent").fit(X_dev, y_dev)
print(f"teste: KNN = {teste:.3f} | classe majoritária = {balanced_accuracy_score(y_test, dummy.predict(X_test)):.3f}")

# Auditoria: quem votou na primeira consulta do teste?
dist, ids = modelo["knn"].kneighbors(modelo["scale"].transform(X_test[[0]]))
print(f"vizinhos: distâncias de {dist[0].min():.3f} a {dist[0].max():.3f} | rótulos {set(y_dev[ids[0]].tolist())}"
      f" | predict_proba {modelo.predict_proba(X_test[[0]])[0].round(3)}")

# Ablação: colunas de ruído gaussiano, independentes do rótulo
ruido = np.random.default_rng(SEED).normal(size=(len(y), 200))
for n in [0, 10, 50, 200]:
    Xr = np.c_[X_base, ruido[:, :n]]
    m = Pipeline([("scale", StandardScaler()), ("knn", KNeighborsClassifier(n_neighbors=25))])
    s = cross_val_score(m, Xr[idx_dev], y_dev, scoring="balanced_accuracy", cv=cv)
    print(f"{n:>3} colunas de ruído ({Xr.shape[1]:>3} dimensões): CV = {s.mean():.3f} ± {s.std():.3f}")
Saída real:
teste: KNN = 0.960 | classe majoritária = 0.500
vizinhos: distâncias de 0.134 a 0.296 | rótulos {1} | predict_proba [0. 1.]
  0 colunas de ruído (  2 dimensões): CV = 0.933 ± 0.019
 10 colunas de ruído ( 12 dimensões): CV = 0.837 ± 0.012
 50 colunas de ruído ( 52 dimensões): CV = 0.771 ± 0.042
200 colunas de ruído (202 dimensões): CV = 0.676 ± 0.037
Algumas leituras:
- No teste, o KNN chegou a 0,960 de acurácia balanceada, contra 0,500 da referência que prevê sempre a classe majoritária. Como o teste não participou de nenhuma escolha, esse número estima o desempenho em vez de premiar a seleção.
- A auditoria mostra os 25 vizinhos da primeira consulta do teste, a distâncias padronizadas entre 0,134 e 0,296, todos da classe 1. O
predict_probadevolve 1,0 para essa classe. É a proporção de votos da seção 2, não uma certeza calibrada. - A ablação reproduz a queda de 0,933 para 0,676 com 200 colunas de ruído.
Os números acima vêm da execução com Python 3.13.3, NumPy 2.2.3 e scikit-learn 1.9.0, e coincidem com os do notebook completo. O notebook declara como versões mínimas Python 3.10, NumPy 1.24, pandas 1.5, Matplotlib 3.7 e scikit-learn 1.3, usa a semente 20260908 e não precisa de rede nem de credenciais.
10. Quando o KNN é uma boa escolha
O KNN é especialmente útil como baseline quando o conjunto cabe em memória, há uma noção defensável de distância, a dimensão efetiva é moderada, a fronteira pode ser irregular e mostrar exemplos parecidos ajuda a explicar uma decisão.
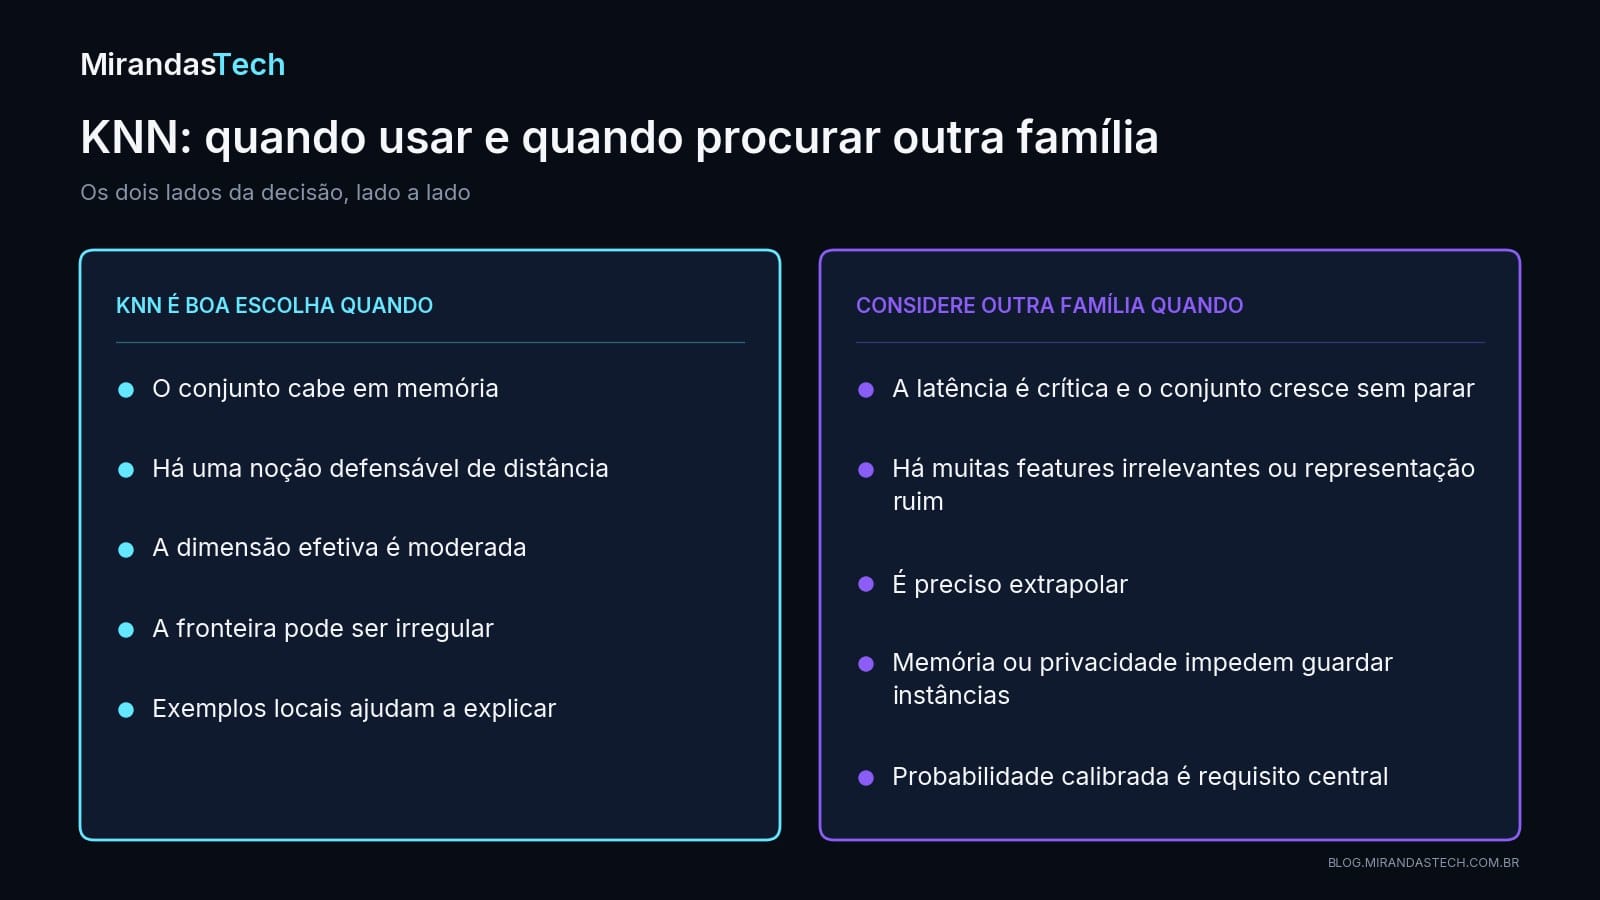
Vale considerar outra família quando a latência de consulta é crítica e o conjunto cresce sem parar, quando há muitas features irrelevantes ou a representação é ruim, quando é preciso extrapolar além das regiões observadas, quando memória ou privacidade impedem guardar as instâncias, ou quando probabilidades calibradas são requisito central.
O KNN não extrapola como um modelo funcional. Longe dos dados, ele continua devolvendo os rótulos dos pontos "menos distantes", mesmo que todos estejam remotos. Monitorar a distância ao vizinho mais próximo ajuda a detectar consultas fora do suporte dos dados.
E quando o KNN e outro modelo, como a regressão logística, empatam no teste? A métrica preditiva sozinha não decide. Entram na conta a memória, a latência por consulta e por lote, a facilidade de atualizar a base, a explicabilidade necessária, o comportamento fora do suporte, a privacidade e a estabilidade em subgrupos.
11. Armadilhas comuns
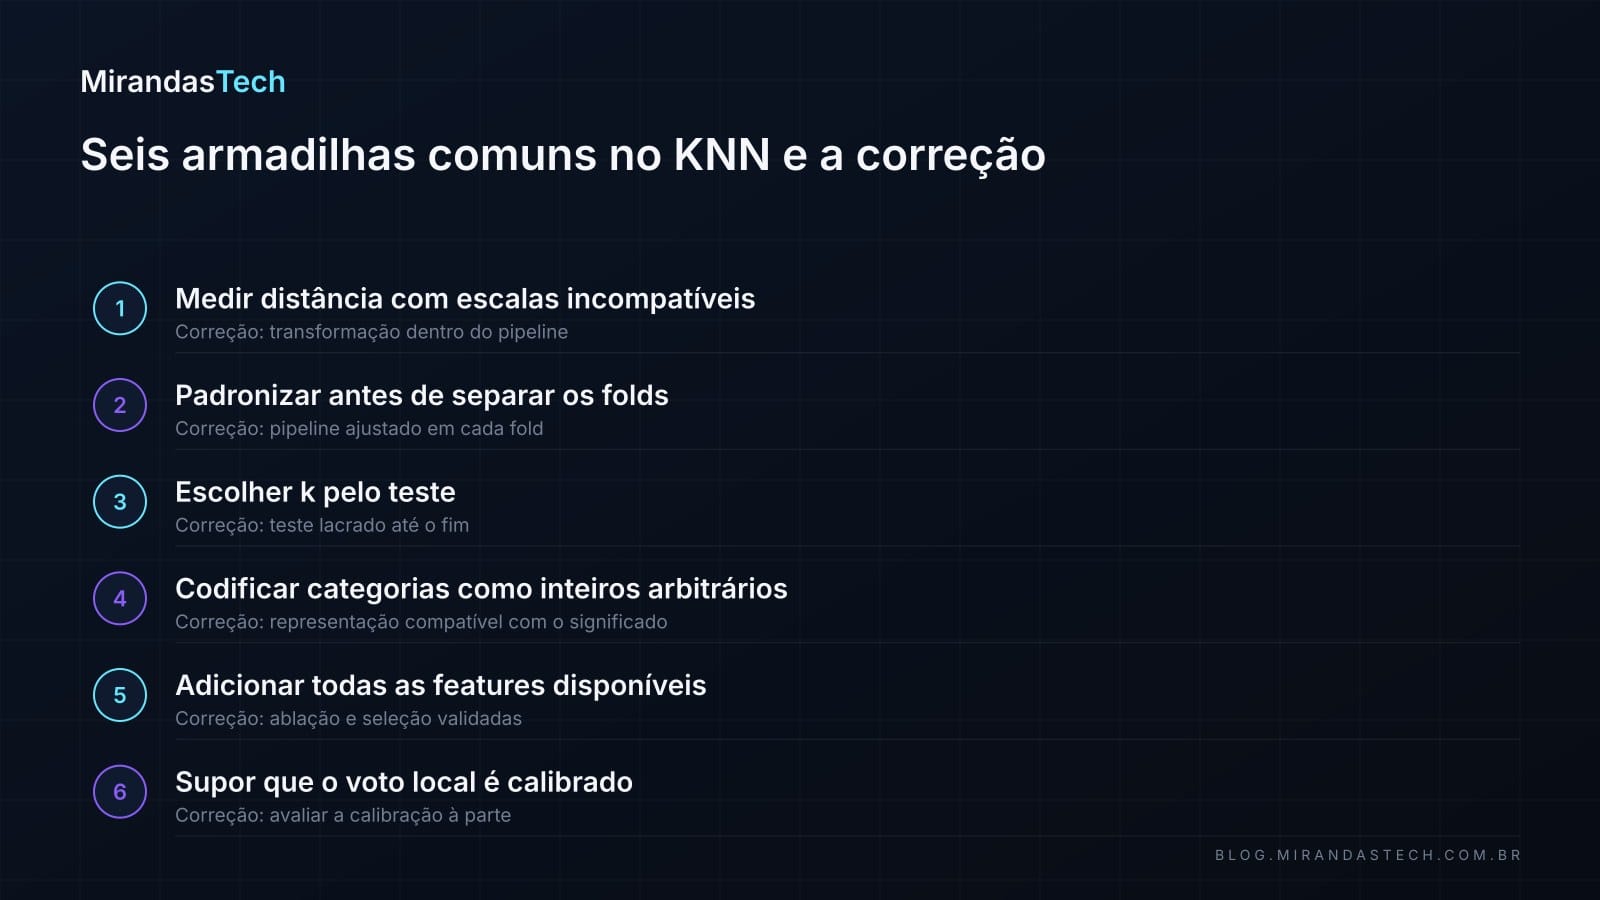
- Medir distância com escalas incompatíveis. A unidade dominante define os vizinhos. Ajuste a transformação dentro do pipeline.
- Padronizar antes dos folds. Média e variância vazam da validação para o treino. O pipeline resolve, fold a fold.
- Escolher $k$ pelo teste. A estimativa final fica otimista. O teste fica lacrado até o fim.
- Usar inteiros arbitrários para categorias. Cria ordem e distância fictícias. Use uma representação compatível com o significado.
- Adicionar todas as features disponíveis. O ruído dilui a proximidade. Faça ablação e seleção validadas.
- Supor que o voto local é calibrado. Decisões de risco ficam mal dimensionadas. Avalie a calibração à parte.
- Ignorar duplicatas conflitantes. Empates instáveis e diagnóstico difícil. Audite a origem e os rótulos.
- Avaliar só a qualidade. Memória e latência surpreendem em produção. Meça os requisitos operacionais.
- Ler vizinhança como causalidade. Parecido não é causa. Separe associação preditiva de efeito causal.
12. Checklist prático
- A unidade de análise está explícita?
- A distância tem interpretação no domínio?
- As features categóricas foram representadas sem ordem artificial?
- Imputação e escala estão dentro do pipeline?
- O teste foi isolado antes da seleção?
- $k$, pesos e métrica foram comparados nos mesmos folds?
- Há uma baseline simples e uma métrica adequada às classes?
- Foram testadas features irrelevantes ou ablações?
- As distâncias dos vizinhos foram inspecionadas?
- Duplicatas, empates e consultas fora do suporte foram tratados?
- Memória e latência foram medidas no cenário real?
- Semente, versões e decisões estão registradas?
13. Onde isso aparece em IA aplicada: busca vetorial e RAG
Quando um assistente com RAG responde sobre a documentação de uma empresa, a primeira etapa é um KNN sem voto. A pergunta vira um vetor (um embedding), o sistema procura os $k$ trechos cujos vetores estão mais perto dele e entrega esses trechos ao modelo de linguagem como contexto. No trabalho que deu nome à técnica, Lewis et al. (2020) combinam um gerador pré-treinado com um índice vetorial denso da Wikipédia, consultado por um recuperador neural. A pergunta central deste artigo, o que significa "perto", continua valendo.
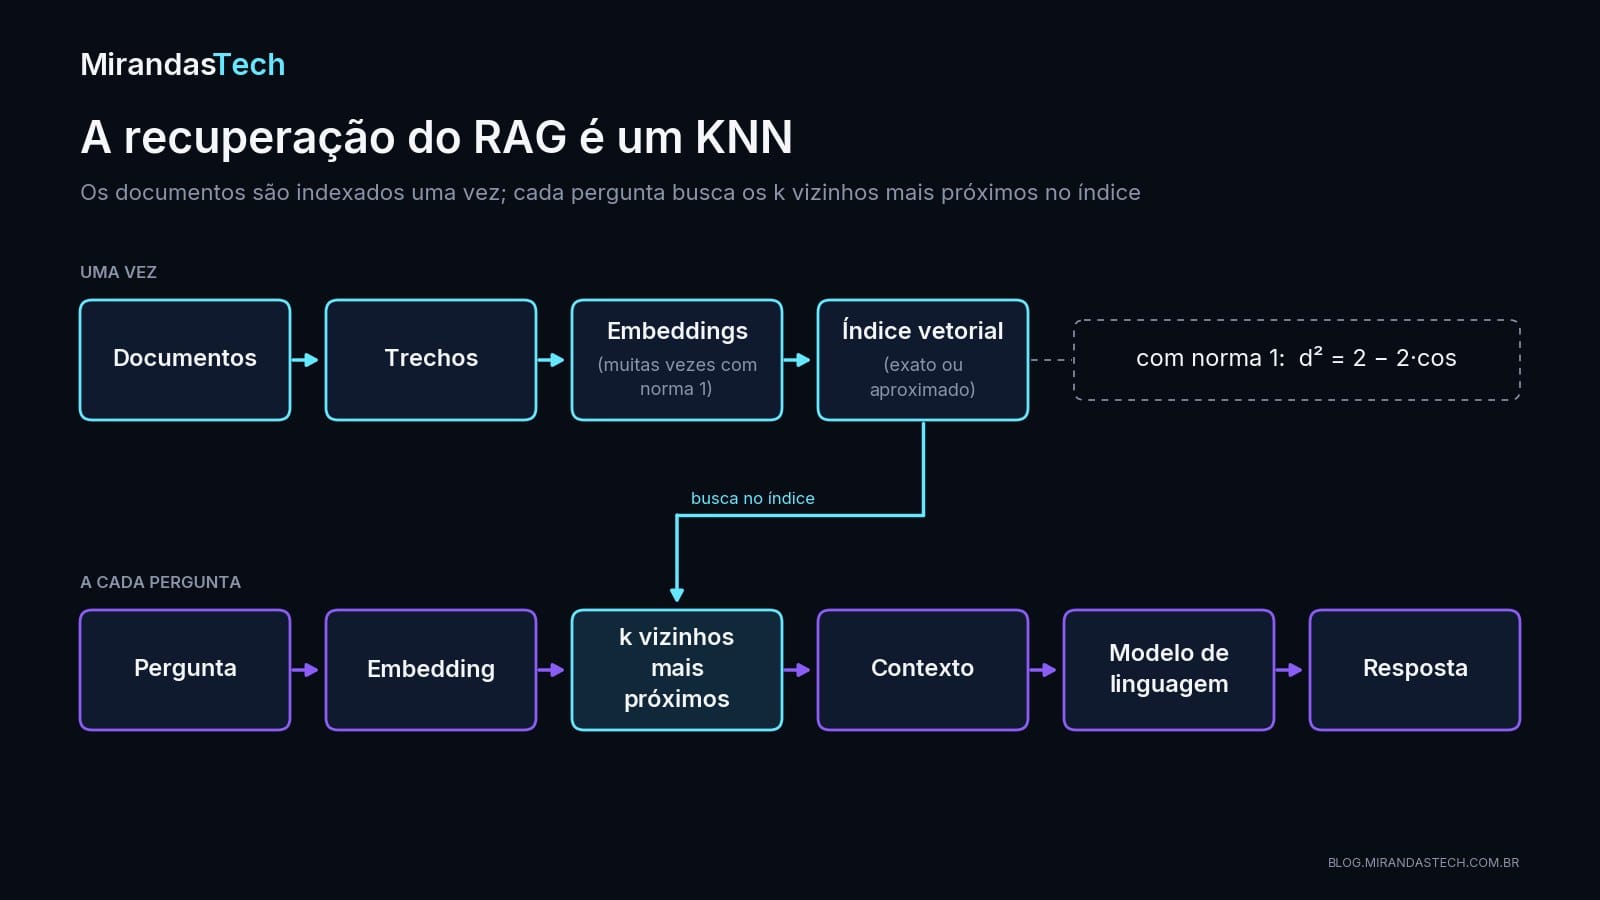
Em embeddings, a noção de perto costuma ser a similaridade de cosseno ou o produto interno; no RAG original, a busca é por produto interno máximo (Lewis et al., 2020). Quando os vetores têm norma 1, cosseno, produto interno e distância euclidiana passam a contar a mesma história. Expandindo o quadrado da distância,
$$ \begin{aligned} \|\mathbf{a}-\mathbf{b}\|^2&=\|\mathbf{a}\|^2+\|\mathbf{b}\|^2-2\,\mathbf{a}\cdot\mathbf{b}\\ &=2-2\cos(\mathbf{a},\mathbf{b}), \end{aligned} $$
em que $\mathbf{a}$ e $\mathbf{b}$ são os dois vetores, $\|\cdot\|$ é a norma euclidiana, $\mathbf{a}\cdot\mathbf{b}$ é o produto escalar e $\cos(\mathbf{a},\mathbf{b})=\mathbf{a}\cdot\mathbf{b}/(\|\mathbf{a}\|\,\|\mathbf{b}\|)$. A última igualdade usa $\|\mathbf{a}\|=\|\mathbf{b}\|=1$. Como a distância cresce quando o cosseno cai, ordenar por uma ou pela outra dá os mesmos vizinhos. O bloco abaixo confere isso com 1.000 vetores aleatórios de 384 dimensões, normalizados. São vetores sintéticos, não embeddings de um modelo real.
import numpy as np

# Vetores de norma 1: distância euclidiana e cosseno ordenam igual
rng = np.random.default_rng(7)
docs = rng.normal(size=(1_000, 384))
docs /= np.linalg.norm(docs, axis=1, keepdims=True)
q = rng.normal(size=384)
q /= np.linalg.norm(q)

cos = docs @ q
d2 = ((docs - q) ** 2).sum(axis=1)
print("máx |d² - (2 - 2·cos)|:", f"{np.abs(d2 - (2 - 2 * cos)).max():.1e}")
print("top-5 por cosseno:   ", np.argsort(-cos)[:5])
print("top-5 por euclidiana:", np.argsort(d2)[:5])
Saída real:
máx |d² - (2 - 2·cos)|: 1.3e-15
top-5 por cosseno:    [486 705 370 367 298]
top-5 por euclidiana: [486 705 370 367 298]
A diferença entre $d^2$ e $2-2\cos$ é da ordem do erro de arredondamento, e os cinco primeiros vizinhos são os mesmos. Sem normalizar, as duas ordens podem divergir, porque a distância euclidiana também enxerga a magnitude dos vetores.
A segunda ponte é o custo. Uma base de documentos pode ter milhões de trechos, e a força bruta da seção 7 passa a custar caro a cada pergunta. Os sistemas de busca vetorial usam então índices de vizinhos mais próximos aproximados, que aceitam perder alguns vizinhos verdadeiros em troca de latência. O HNSW, de Malkov e Yashunin (2020), organiza os vetores num grafo hierárquico de "mundo pequeno" navegável. O FAISS, biblioteca aberta cuja busca em GPU Johnson, Douze e Jégou (2021) descrevem, chega a bilhões de vetores. O próprio RAG original consulta um índice FAISS com aproximação HNSW (Lewis et al., 2020). É a linha "busca aproximada" da seção 7, e a regra é a mesma: o recall da recuperação precisa ser medido, não presumido.
A terceira ponte é a dimensionalidade. Embeddings têm muitas dimensões, e a busca vetorial é usada justamente nesses espaços. Isso não contradiz a seção 6. Beyer et al. (1999) mostram que a concentração de distâncias vale sob condições bem mais amplas que dimensões independentes, mas também apontam cargas de alta dimensão em que ela não aparece; o ruído do laboratório é o caso em que ela aparece com força. Uma representação aprendida tenta concentrar o sinal e aproximar o que é semanticamente parecido. Se conseguiu, é uma pergunta empírica: um conjunto de perguntas com o trecho certo conhecido mostra se ele aparece entre os $k$ recuperados. Na minha leitura, o conselho da seção 10 se transfere quase sem mudança: se nem o trecho mais próximo está perto da pergunta, a base talvez não cubra o assunto, e o sistema deveria dizer isso em vez de responder com o trecho "menos distante".
Próximo passo
O KNN decide por vizinhança, sem aprender uma distribuição explícita. A próxima aula da série faz outra simplificação poderosa com o Naive Bayes: modelar probabilidades condicionais sob uma hipótese de independência entre as features. A comparação mostra dois caminhos distintos para classificar, a evidência local e o modelo probabilístico.
Referências
- Cover, T.; Hart, P. Nearest Neighbor Pattern Classification. IEEE Transactions on Information Theory, 13(1), p. 21–27, 1967. doi.org/10.1109/tit.1967.1053964
- scikit-learn developers. Nearest Neighbors (User Guide, seção 1.6). Documentação oficial do scikit-learn 1.9 (acesso em 16 out. 2026), 2026a. scikit-learn.org/stable/modules/neighbors.html
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2ª ed. Springer (Springer Series in Statistics), 2009. doi.org/10.1007/978-0-387-84858-7
- scikit-learn developers. Metrics and scoring: quantifying the quality of predictions (User Guide, seção 3.4; 3.4.4.4 Balanced accuracy score). Documentação oficial do scikit-learn 1.9 (acesso em 16 out. 2026), 2026b. scikit-learn.org/stable/modules/model_evaluation.html#balanced-accuracy-score
- scikit-learn developers. sklearn/neighbors/_base.py, função _get_weights (código-fonte, versão 1.9.0). Repositório oficial do scikit-learn no GitHub, tag 1.9.0 (acesso em 16 out. 2026), 2026c. github.com/scikit-learn/scikit-learn/blob/1.9.0/sklearn/neighbors/_base.py#L96-L98
- Beyer, Kevin; Goldstein, Jonathan; Ramakrishnan, Raghu et al. When Is “Nearest Neighbor” Meaningful?. Database Theory — ICDT’99, Lecture Notes in Computer Science, v. 1540, p. 217–235, 1999. doi.org/10.1007/3-540-49257-7_15
- Lewis, Patrick; Perez, Ethan; Piktus, Aleksandra et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems 33 (NeurIPS 2020), p. 9459–9474. arXiv:2005.11401, 2020. arxiv.org/abs/2005.11401
- Malkov, Yu. A.; Yashunin, D. A. Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4), p. 824–836. arXiv:1603.09320, 2020. doi.org/10.1109/tpami.2018.2889473
- Johnson, Jeff; Douze, Matthijs; Jégou, Hervé. Billion-Scale Similarity Search with GPUs. IEEE Transactions on Big Data, 7(3), p. 535–547. arXiv:1702.08734, 2021. doi.org/10.1109/tbdata.2019.2921572
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 03-machine-learning/aulas/07-knn-distancias-dimensionalidade.md.