Variáveis aleatórias: PMF, PDF, CDF e a densidade que passa de 1
Representar resultados numéricos incertos como variáveis aleatórias e calcular probabilidades somando massas, integrando densidades e subtraindo valores da CDF.
Representar resultados numéricos incertos como variáveis aleatórias e calcular probabilidades somando massas, integrando densidades e subtraindo valores da CDF. Pré-requisitos: Aula 01 (eventos e axiomas), Aula 03 (probabilidade condicional) e Aula 04 (Teorema de Bayes). Tempo sugerido: 90 a 120 minutos de estudo, mais 45 a 60 minutos de laboratório.
Uma API atende uma aplicação de IA, e o monitoramento registra duas coisas a cada janela de três verificações: quantas delas geraram alerta e quanto tempo a requisição levou para responder. Pergunte qual é a chance de dois alertas e existe um número para isso. Pergunte qual é a chance de a próxima resposta levar exatamente 0,81 s e, num modelo contínuo, a resposta é zero, embora uma latência que o painel mostra como 0,81 s possa ter acabado de acontecer.
As duas quantidades são incertas, mas não se descrevem do mesmo jeito. A contagem de alertas tem valores separados, e cada um recebe uma probabilidade. A latência varia num contínuo, e a probabilidade mora em intervalos, não em pontos. Misturar os dois casos produz erros conhecidos de quem trabalha com modelos: ler a altura de uma densidade como se fosse uma chance, estranhar uma densidade maior que 1, tratar scores brutos de um classificador como probabilidades.
Na Aula 04, o Teorema de Bayes atualizou crenças sobre hipóteses. Agora o foco passa para o que pode ser observado: quantos alertas virão, qual será a latência, que probabilidade um classificador dá a cada classe. Ao final, você vai saber definir uma variável aleatória e separá-la do valor observado, reconhecer variáveis discretas, contínuas e mistas, validar e usar uma PMF, ler uma PDF sem confundir altura com probabilidade, calcular intervalos e quantis pela CDF e conferir tudo isso em Python, de forma reproduzível.
1. Dois tipos de incerteza
Para descrever a API, duas quantidades bastam numa janela de três verificações:
- $X$: número de verificações que geram alerta, com valores possíveis $0,1,2,3$;
- $T$: tempo de resposta, qualquer valor real não negativo, como 0,81 s ou 1,237 s.
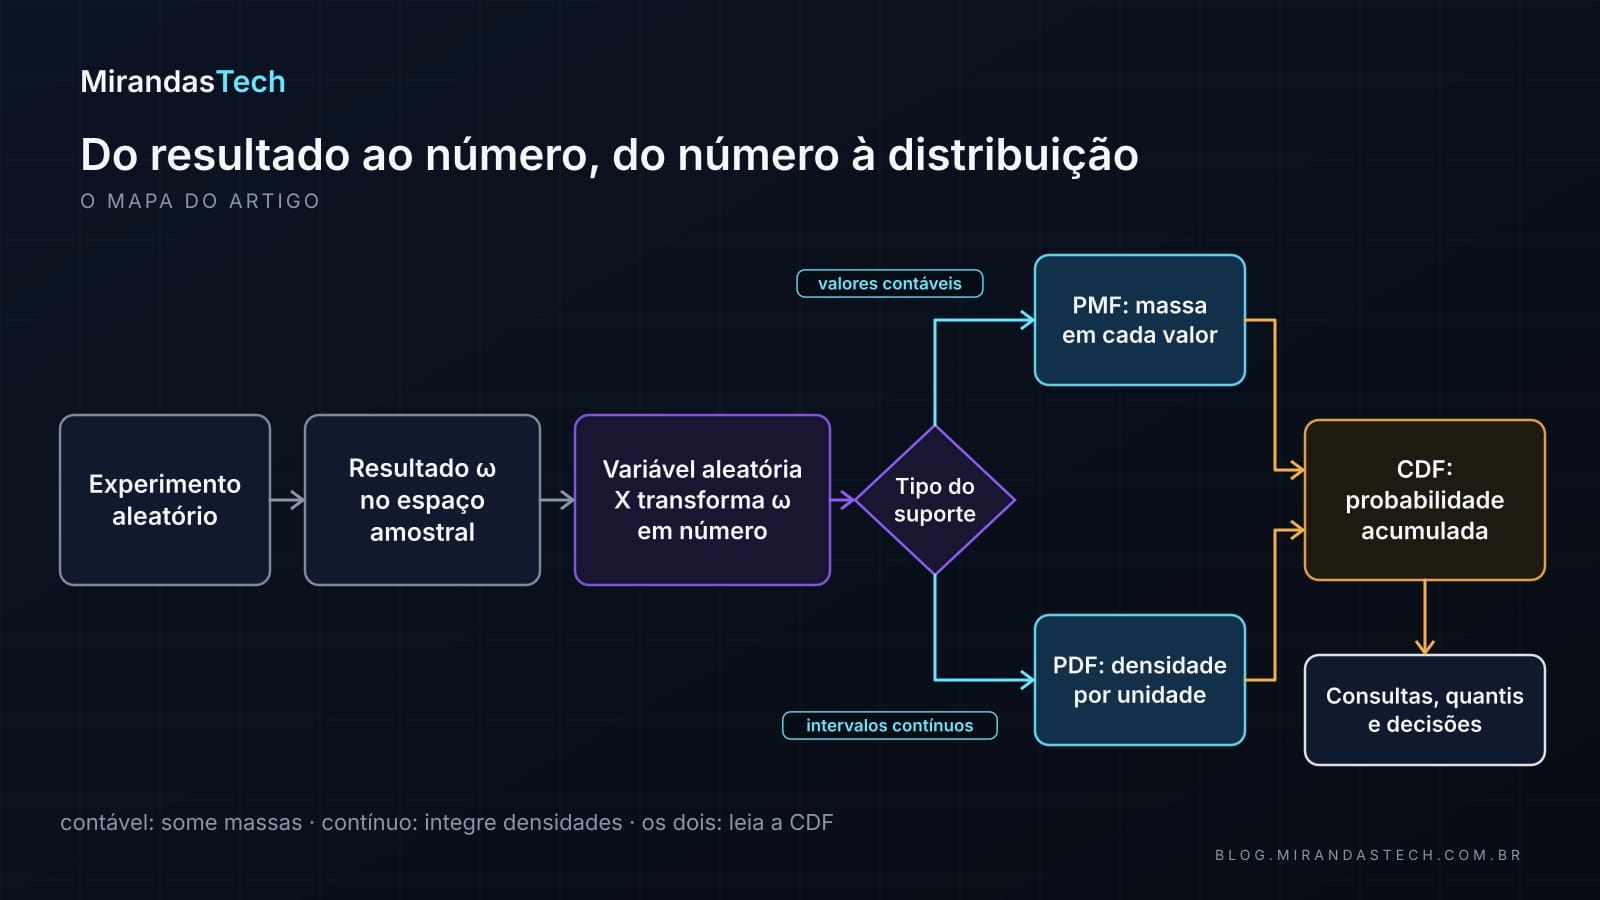
As duas são incertas, mas exigem representações diferentes. Para $X$, faz sentido atribuir uma probabilidade a cada valor. Para $T$, um ponto isolado tem probabilidade zero no modelo contínuo; as probabilidades pertencem a intervalos. A CDF, a função distribuição acumulada, oferece uma linguagem comum aos dois casos, e é para ela que o resto do texto converge.
2. Variável aleatória: de resultados a números
Um experimento aleatório é um processo cujo resultado não se conhece antes da observação, e o espaço amostral $\Omega$ é o conjunto de resultados elementares possíveis, como na Aula 01. Uma variável aleatória real associa um número real a cada resultado (Orloff & Bloom, 2022, Class 4). Formalmente, é uma função
$$X:\Omega\rightarrow\mathbb{R}.$$
Ela não “escolhe” uma fórmula ao acaso. A regra $X(\omega)$ é fixa; o que varia é o resultado $\omega$ do experimento. Numa definição rigorosa, $X$ também precisa ser mensurável, condição que garante que eventos como $\{X\leq x\}$ tenham probabilidade definida (Durrett, 2019, §1.2).
Para ver a mecânica num caso menor, deixe a API de lado por um momento. No lançamento de duas moedas, com $C$ para cara e $K$ para coroa,
$$\Omega=\{CC,CK,KC,KK\}.$$
Defina $X$ como o número de caras. A regra leva cada resultado a um número:
- $X(CC)=2$;
- $X(CK)=1$ e $X(KC)=1$;
- $X(KK)=0$.
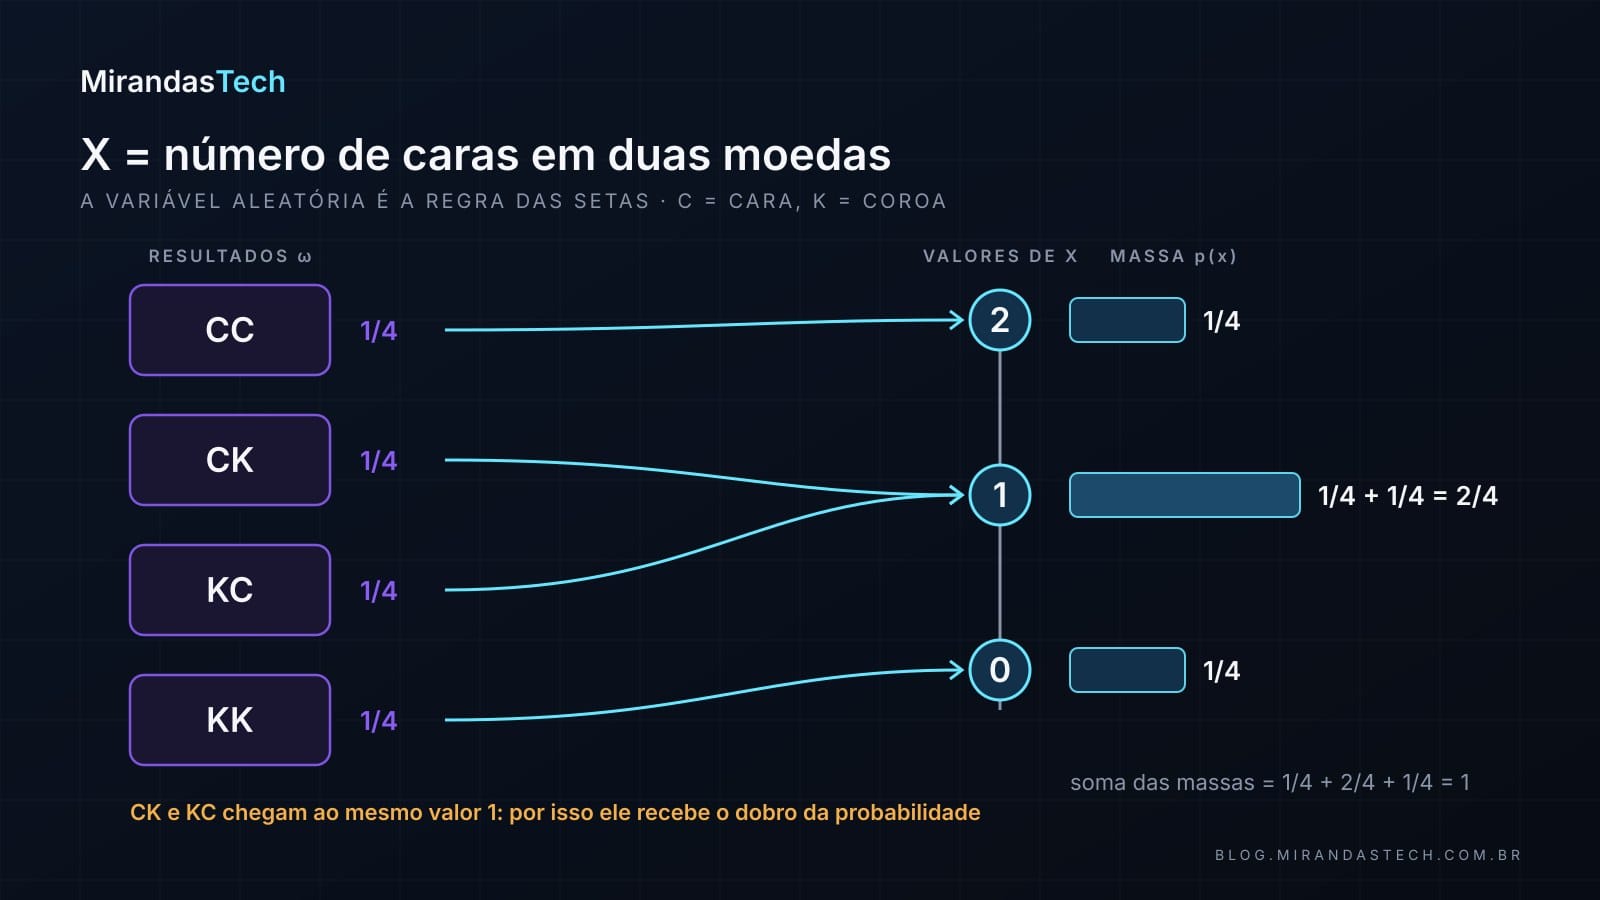
Resultados diferentes podem produzir o mesmo valor. A distribuição de $X$ reúne as probabilidades de todos os resultados que chegam a cada número.
3. Discreta, contínua ou mista?
A classificação depende dos valores que a variável pode assumir e de como a probabilidade se distribui entre eles. O suporte é o conjunto de valores aos quais a distribuição atribui massa ou densidade positiva. Há três casos:
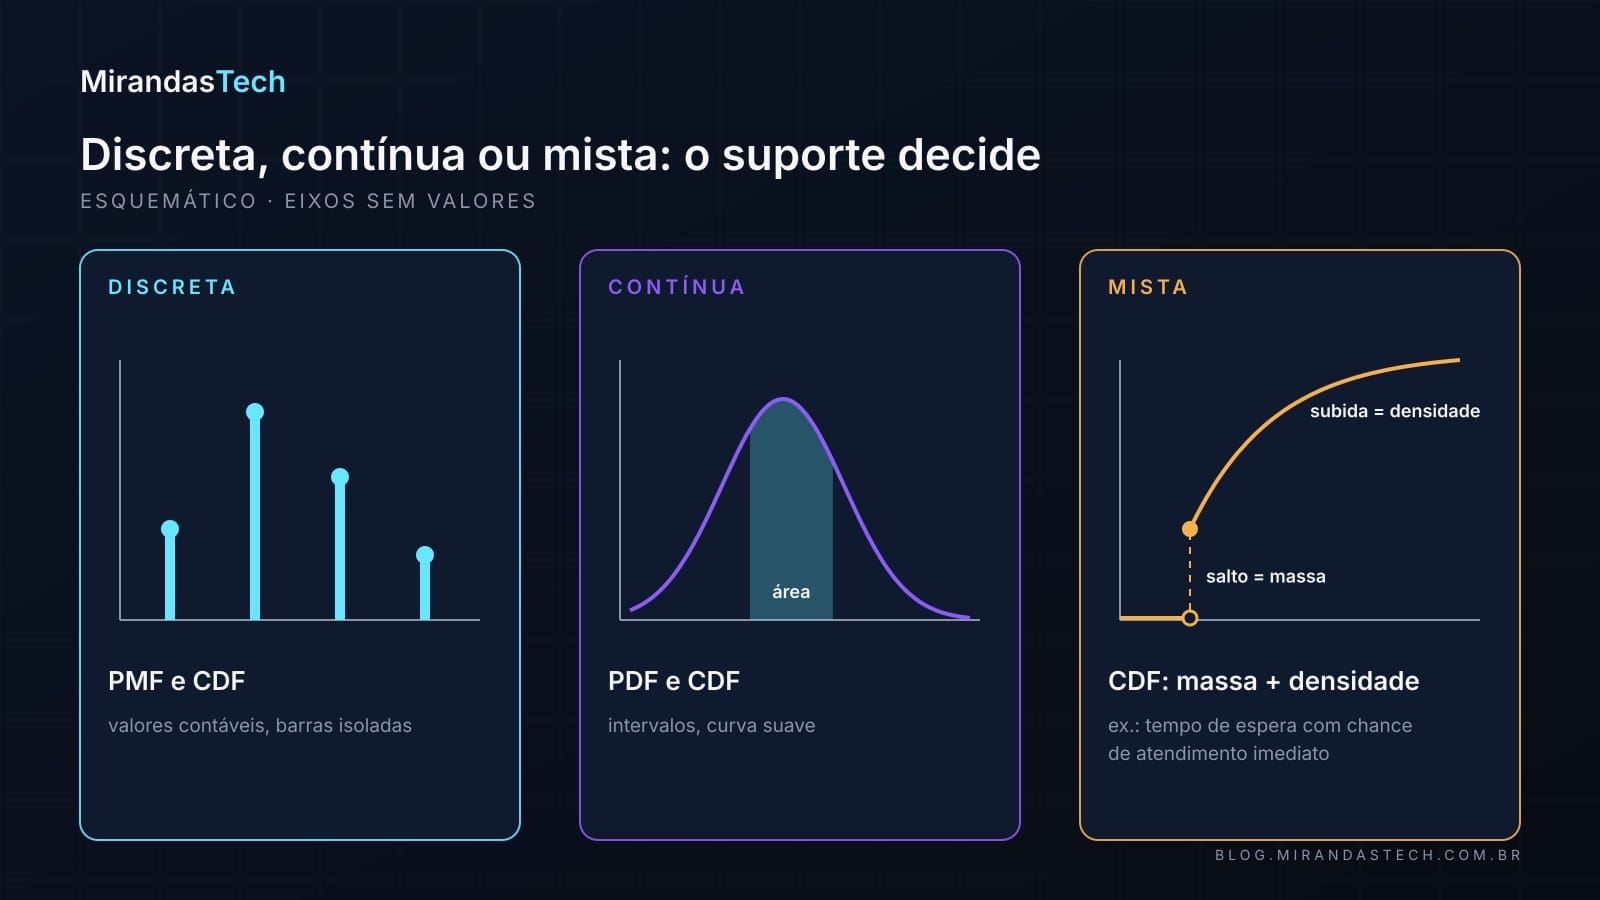
- Discreta. Suporte finito ou contável. Ferramentas: PMF e CDF. Em IA: classe prevista, número de tokens, contagem de erros.
- Contínua. Suporte em intervalos de números reais. Ferramentas: PDF e CDF. Em IA: latência, temperatura, ruído de sensor.
- Mista. Pontos com massa mais um trecho contínuo. Ferramenta: a CDF, combinando massa e densidade. Em IA: tempo de espera com chance de atendimento imediato.
Uma quantidade medida com casas decimais não é automaticamente contínua. Um sensor digital registra valores discretizados, embora um modelo contínuo possa ser uma aproximação útil. O modelo é uma escolha, e ela deve respeitar o fenômeno e a precisão necessária.
4. PMF: probabilidade em valores discretos
Para uma variável discreta $X$, a função massa de probabilidade (PMF, de probability mass function) dá a probabilidade de cada valor:
$$p_X(x)=P(X=x).$$
Uma PMF válida satisfaz duas condições, não negatividade e normalização (Murphy, 2022, §2.2.1):
$$p_X(x)\geq 0 \quad\text{e}\quad \sum_x p_X(x)=1.$$
Para qualquer conjunto $A$ de valores, a probabilidade é a soma das massas dentro dele:
$$P(X\in A)=\sum_{x\in A}p_X(x).$$
No exemplo das duas moedas, se elas forem justas e independentes, os quatro resultados elementares têm probabilidade $1/4$ cada, e basta contá-los, como na Aula 02. A PMF do número de caras fica:
- $p_X(0)=1/4$;
- $p_X(1)=2/4$;
- $p_X(2)=1/4$.
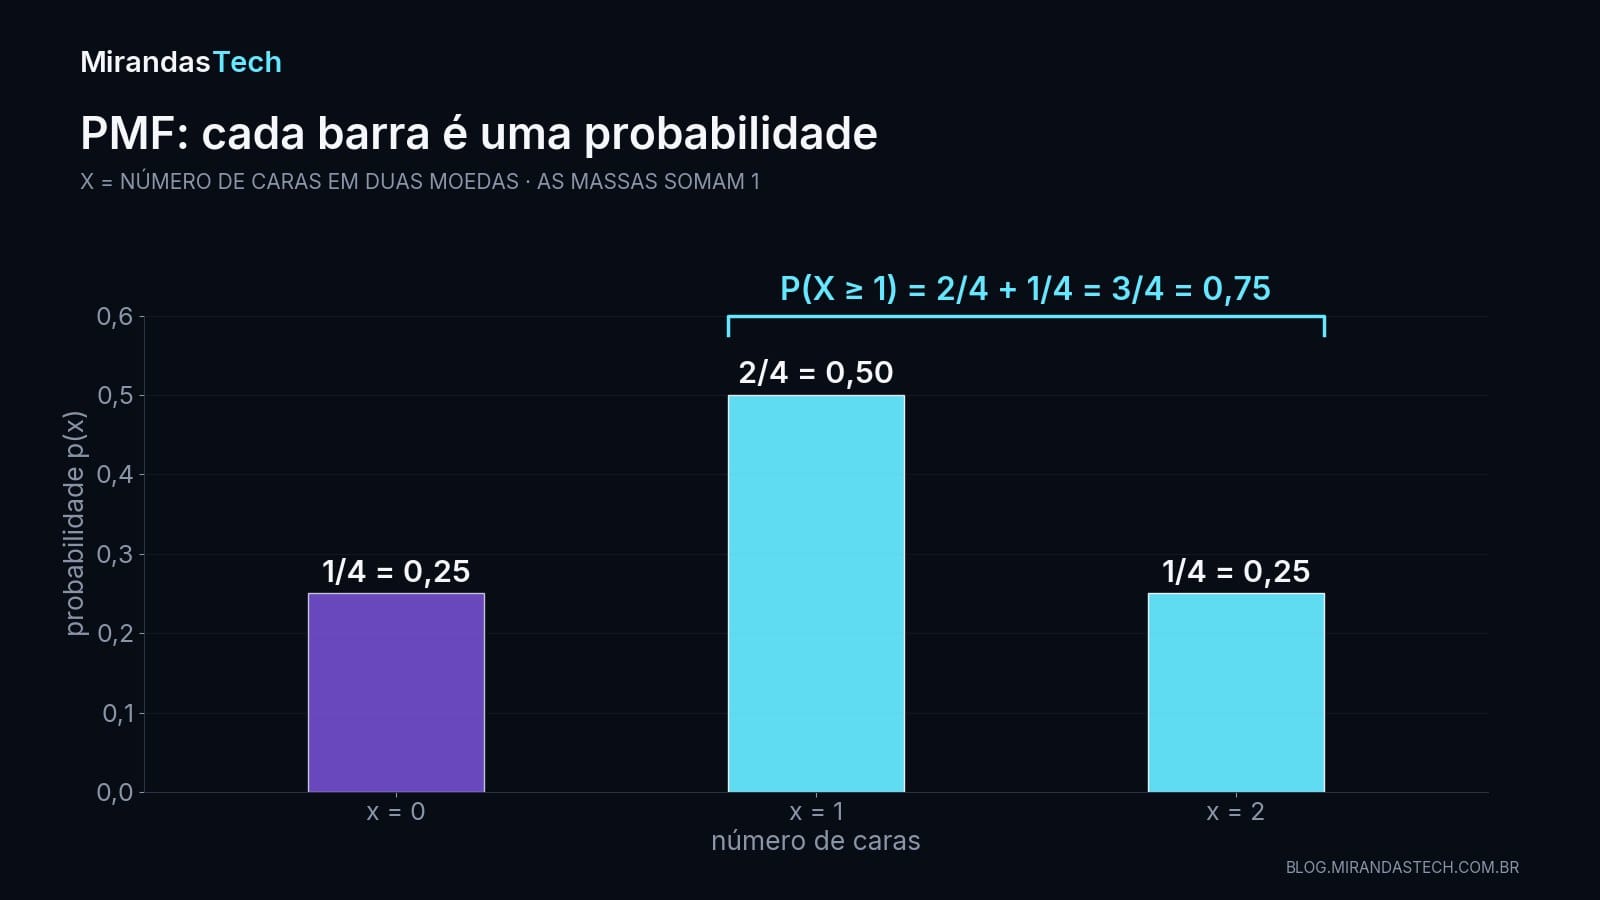
Para calcular a chance de sair ao menos uma cara, três passos. Primeiro, valide a PMF: $1/4+2/4+1/4=1$. Depois, traduza o evento: “ao menos uma cara” é $X\geq1$. Por fim, some as massas:
$$\begin{aligned}P(X\geq1)&=p_X(1)+p_X(2)\\&=\frac{2}{4}+\frac{1}{4}=\frac{3}{4}.\end{aligned}$$
As barras de uma PMF representam probabilidades, e sua soma é 1. Isso contrasta com uma PDF, em que a área, e não a soma das alturas, é normalizada.
5. PDF: densidade em variáveis contínuas
Uma variável contínua pode ser descrita por uma função densidade de probabilidade (PDF, de probability density function) $f_X$ tal que
$$f_X(x)\geq0 \quad\text{e}\quad \int_{-\infty}^{\infty}f_X(x)\,dx=1.$$
A probabilidade de um intervalo é a área sob a curva nesse intervalo (Orloff & Bloom, 2022, Class 5):
$$P(a\leq X\leq b)=\int_a^b f_X(x)\,dx.$$
Voltando à API: suponha, só para fins didáticos, que a latência $T$ seja uniforme entre 0 e 4 segundos.
$$f_T(t)=\begin{cases}1/4, & 0\leq t\leq4,\\0, & \text{caso contrário.}\end{cases}$$
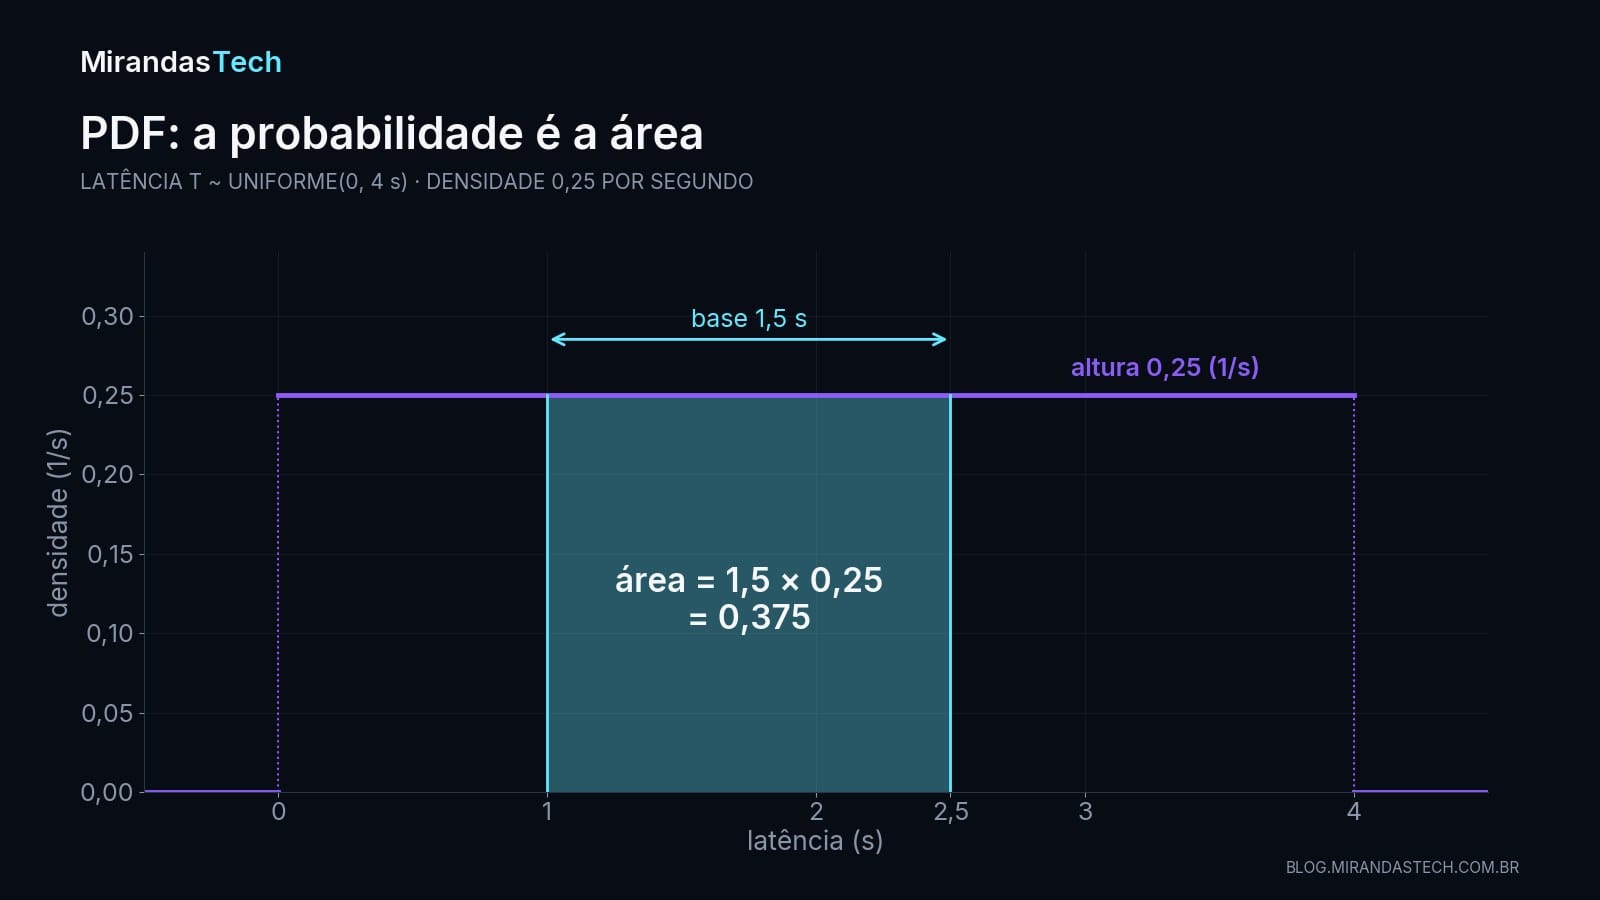
A chance de a latência ficar entre 1 e 2,5 segundos é a área do retângulo de base 1,5 e altura $1/4$:
$$\begin{aligned}P(1\leq T\leq2{,}5)&=\int_1^{2{,}5}\frac14\,dt\\&=\frac{2{,}5-1}{4}=0{,}375.\end{aligned}$$
Probabilidade zero não é impossível
Um ponto tem largura zero. Portanto, num modelo contínuo,
$$P(X=x)=\int_x^x f_X(t)\,dt=0.$$
Ainda assim, algum valor será observado: a latência exata, com infinitas casas, que o painel arredondou para 0,81 s tinha probabilidade zero e aconteceu. Já o valor exibido representa o intervalo de 0,805 a 0,815 s, e esse intervalo tem probabilidade positiva: $0{,}01/4=0{,}0025$ na latência uniforme. Probabilidade zero e impossibilidade não são sinônimos em espaços contínuos (Orloff & Bloom, 2022, Class 5). Cada ponto isolado tem massa zero, enquanto um intervalo reúne infinitos pontos e pode ter área positiva.
Uma densidade pode ser maior que 1
Se $U$ é uniforme em $[0;\,0{,}5]$, então $f_U(u)=2$ nesse intervalo. Isso é válido porque a área total é $2\times0{,}5=1$. A altura da PDF tem unidade de “probabilidade por unidade de $x$”; ela não é uma probabilidade isolada, e nada a impede de passar de 1 (Orloff & Bloom, 2022, Class 5; Murphy, 2022, §2.6.2).
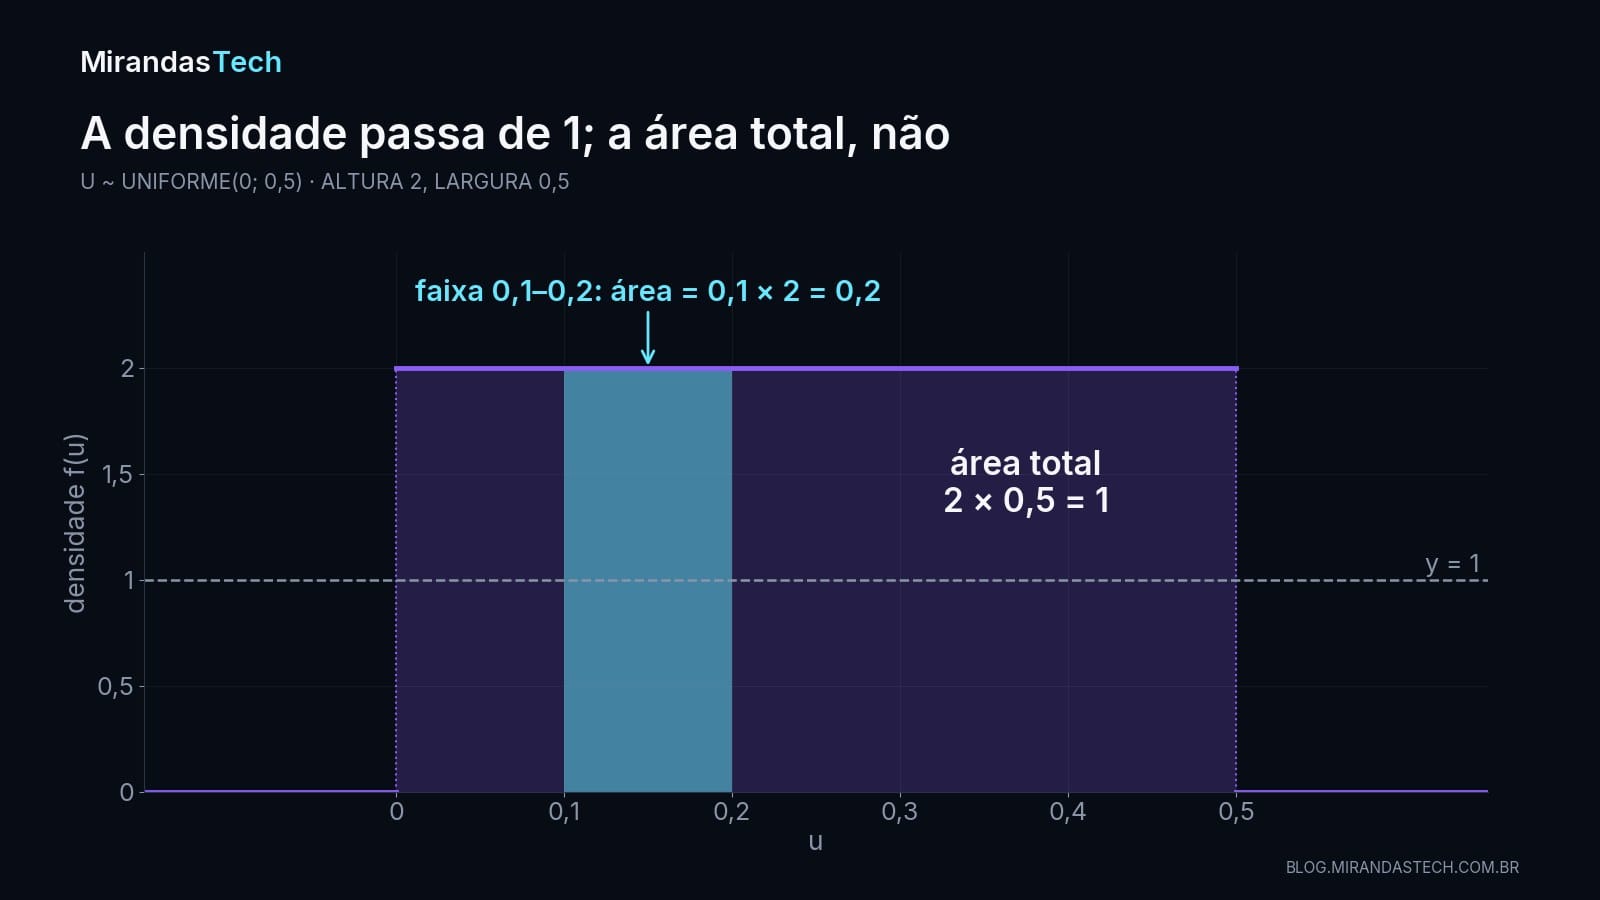
As probabilidades continuam pequenas onde devem ser: a faixa entre 0,1 e 0,2, por exemplo, tem área $0{,}1\times2=0{,}2$. O que precisa valer 1 é a área total, nunca a altura.
6. CDF: a linguagem comum
A função distribuição acumulada (CDF, de cumulative distribution function) é
$$F_X(x)=P(X\leq x).$$
Ela existe para variáveis discretas, contínuas e mistas. Toda CDF (Durrett, 2019, Teorema 1.2.1):
- é não decrescente;
- é contínua à direita;
- tende a 0 quando $x\to-\infty$;
- tende a 1 quando $x\to+\infty$.
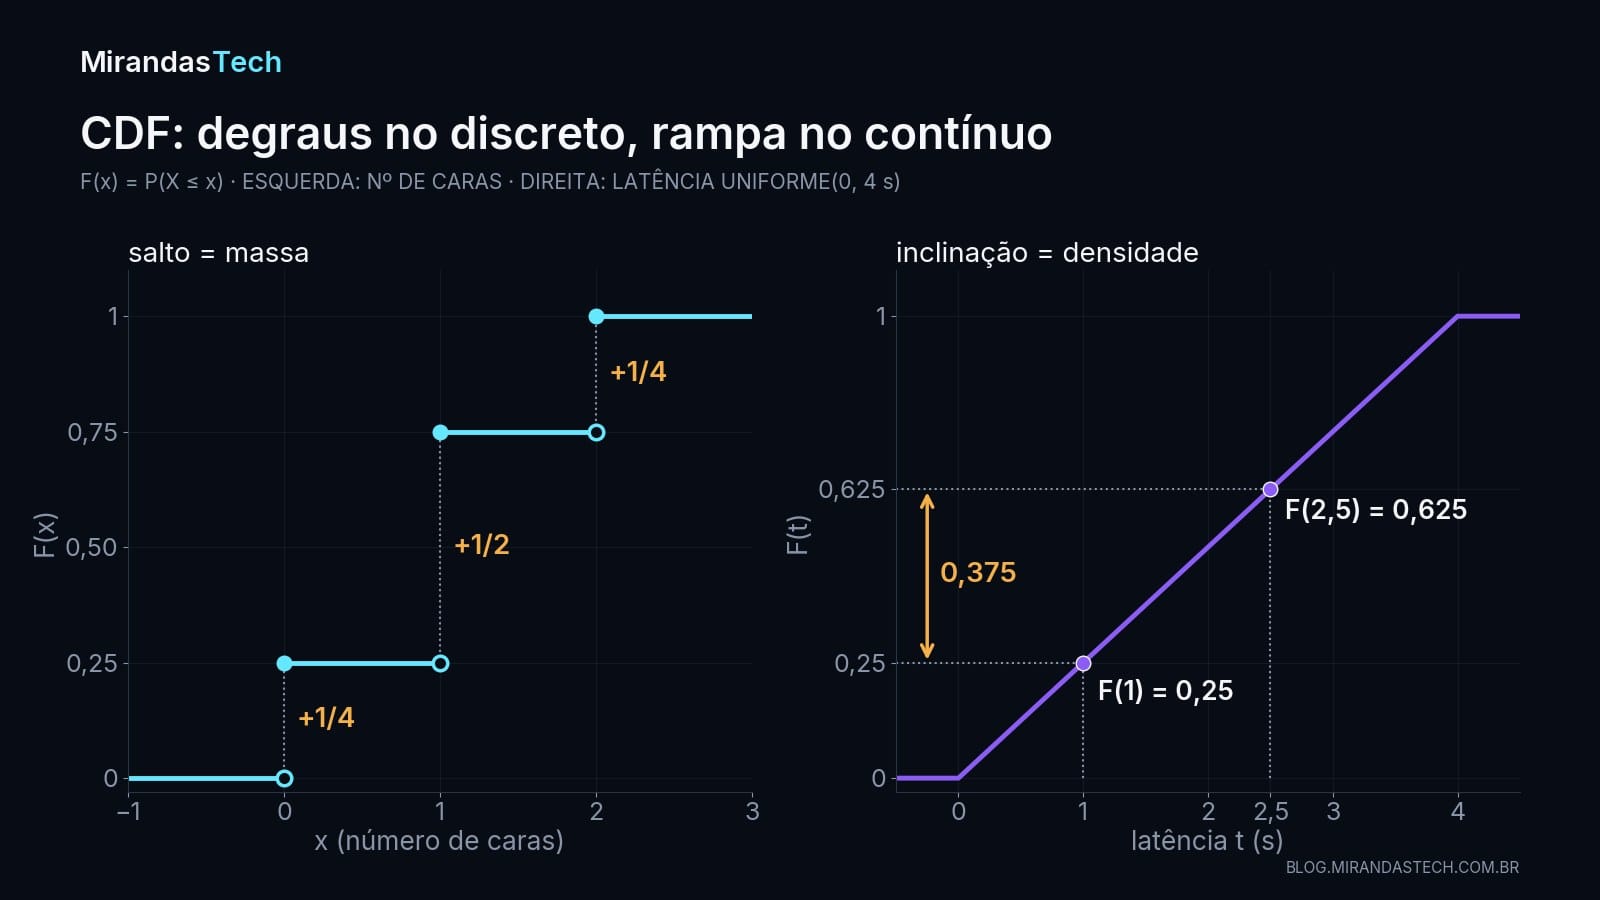
Para $a\lt b$, a identidade que respeita os extremos (Murphy, 2022, §2.2.2) é
$$P(a\lt X\leq b)=F_X(b)-F_X(a).$$
Numa variável contínua, pontos isolados têm probabilidade zero, então trocar $\lt$ por $\leq$ nos extremos não muda o resultado. Numa variável discreta, pode mudar.
A CDF da contagem de caras
Acumulando a PMF da seção 4:
$$F_X(x)=\begin{cases}0, & x\lt0,\\1/4, & 0\leq x\lt1,\\3/4, & 1\leq x\lt2,\\1, & x\geq2.\end{cases}$$
Observe os saltos. A massa em $x$ é o tamanho do salto,
$$P(X=x)=F_X(x)-F_X(x^-),$$
em que $F_X(x^-)$ é o limite da CDF pela esquerda (Durrett, 2019, Teorema 1.2.1). Em $x=1$, por exemplo, a CDF pula de $1/4$ para $3/4$, e o salto de $2/4$ é exatamente $p_X(1)$.
A CDF da latência uniforme
Para $T\sim\operatorname{Uniforme}(0,4)$:
$$F_T(t)=\begin{cases}0, & t\lt0,\\t/4, & 0\leq t\leq4,\\1, & t\gt4.\end{cases}$$
Assim, a mesma pergunta da seção 5 sai por subtração, sem integral:
$$\begin{aligned}P(1\lt T\leq2{,}5)&=F_T(2{,}5)-F_T(1)\\&=0{,}625-0{,}25\\&=0{,}375.\end{aligned}$$
Quando a CDF é diferenciável, recuperamos a densidade derivando (Orloff & Bloom, 2022, Class 5; Murphy, 2022, §2.2.2):
$$f_X(x)=\frac{d}{dx}F_X(x).$$
Na uniforme, a derivada de $t/4$ é $1/4$, a altura da PDF. Saltos da CDF revelam massas; inclinações revelam densidades.
7. PMF, PDF e CDF lado a lado
As três funções respondem às mesmas seis perguntas de formas diferentes: para que variável servem, o que o valor da função significa, como se normalizam, qual é a probabilidade de um ponto, como se calcula um intervalo e qual é a unidade do eixo vertical.
- PMF, para variável discreta. O valor da função é a probabilidade no ponto; a normalização é $\sum_x p(x)=1$; a probabilidade pontual é $P(X=x)=p(x)$; um intervalo é uma soma de massas; o eixo vertical está em probabilidade.
- PDF, para variável contínua. O valor da função é a densidade no ponto; a normalização é $\int f(x)\,dx=1$; a probabilidade pontual é $P(X=x)=0$; um intervalo é uma integral da densidade; o eixo vertical está em probabilidade por unidade de $x$.
- CDF, para qualquer variável real. O valor da função é a probabilidade acumulada até o ponto; a normalização aparece nos limites 0 e 1; a probabilidade pontual é o tamanho do salto, se houver; um intervalo é uma diferença entre valores da CDF; o eixo vertical está em probabilidade.
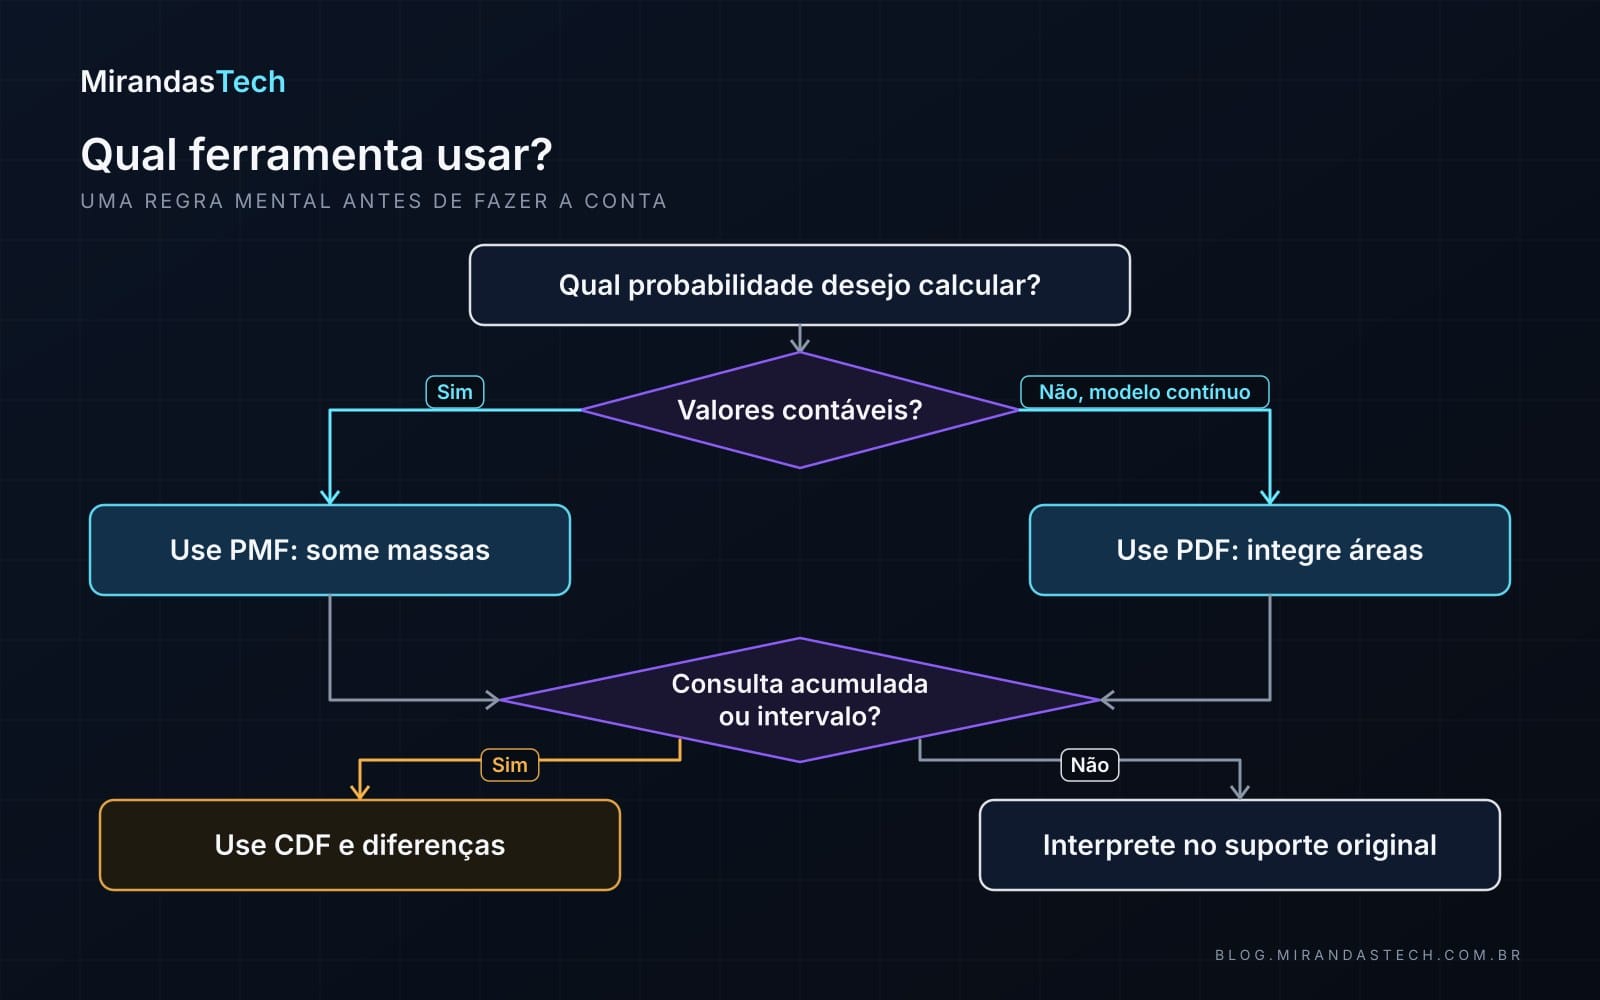
A regra prática do fluxograma: se os valores são contáveis, some massas na PMF; se o modelo é contínuo, integre áreas na PDF; se a consulta é acumulada ou de intervalo, use a CDF e diferenças; caso contrário, interprete o resultado no suporte original.
8. Quantis e amostragem pela CDF
A CDF também responde à pergunta inversa: dado um nível de probabilidade, qual é o limiar? Quando a CDF é invertível, a resposta é a inversa dela, que o NIST chama de percent point function (NIST/SEMATECH, 2020; Murphy, 2022, §2.2.2). Em geral, o quantil de nível $q\in(0,1)$ pode ser definido (Hyndman & Fan, 1996) por
$$Q(q)=\inf\{x:F_X(x)\geq q\}.$$
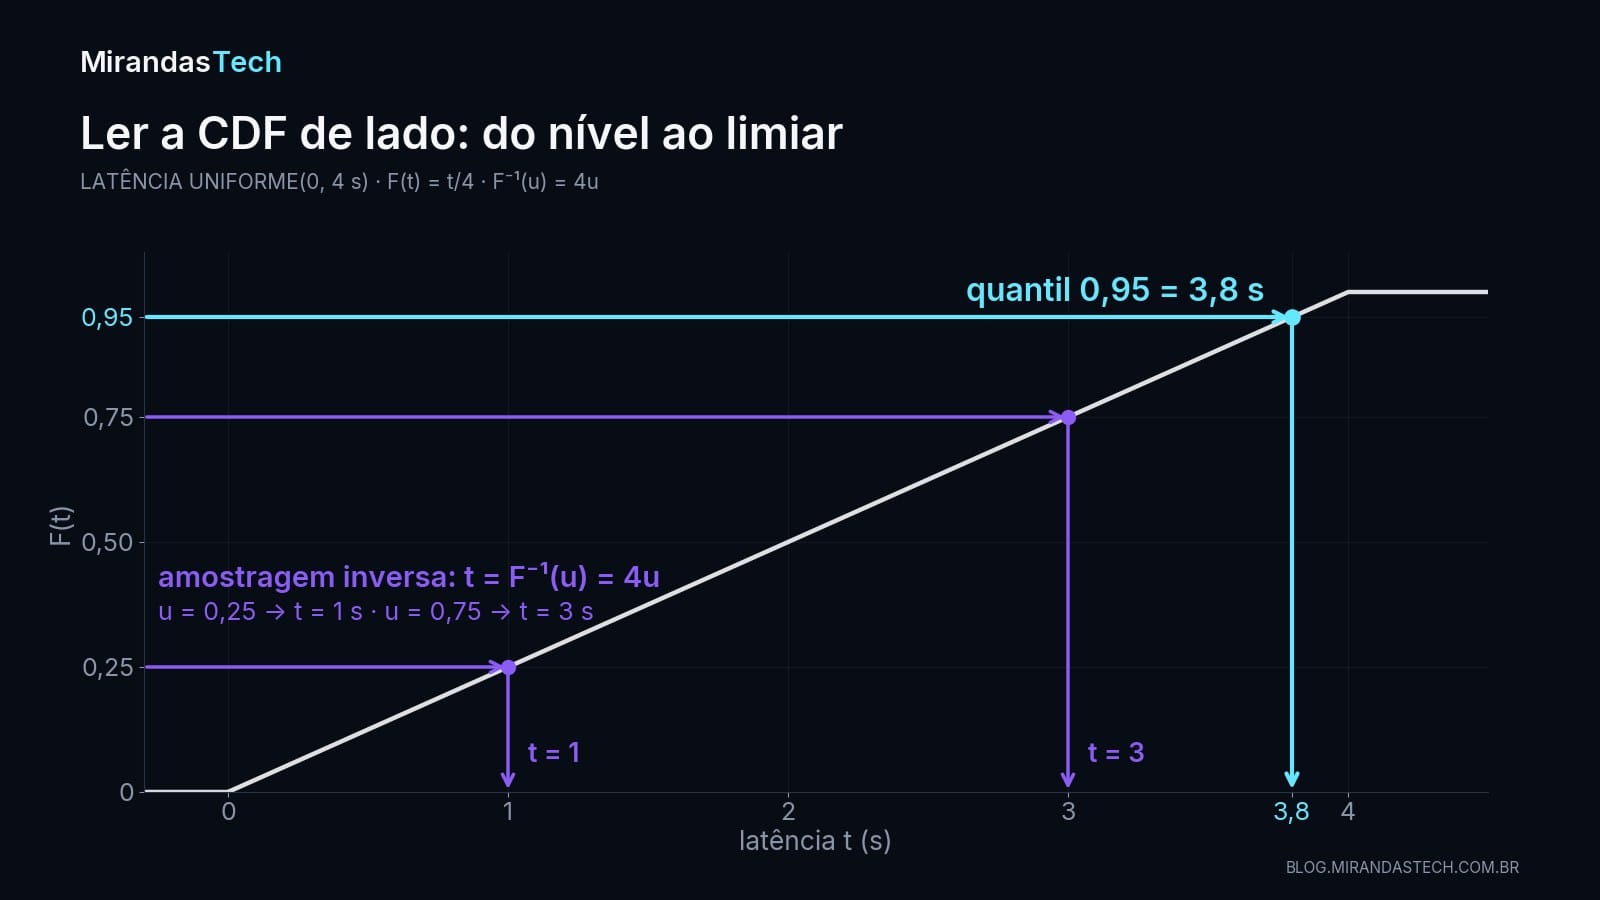
Por exemplo, o quantil 0,95 da latência é um limiar abaixo do qual se encontra pelo menos 95% da distribuição. Percentis altos de latência servem de indicadores e metas de nível de serviço e mostram a cauda que a média esconde (Jones et al., 2016). Na latência uniforme, $F_T(t)=t/4$, e o quantil 0,95 é $0{,}95\cdot4=3{,}8$ s. O ínfimo na definição resolve os casos em que a CDF não é invertível, como as CDFs em degraus: na contagem de caras, $Q(0{,}5)=1$, porque $F_X(0)=1/4$ ainda não alcança 0,5 e $F_X(1)=3/4$ já passa.
A CDF também permite amostrar algumas distribuições. Se $U\sim\operatorname{Uniforme}(0,1)$ e $F$ é contínua e invertível, então
$$X=F^{-1}(U)$$
tem CDF $F$ (Devroye, 1986, Teorema 2.1). Para a latência uniforme em $[0,4]$, $F^{-1}(u)=4u$: basta sortear $u$ entre 0 e 1 e multiplicar por 4. O laboratório demonstra o princípio só com a uniforme, sem depender das fórmulas de distribuições que aparecem nas aulas seguintes.
9. Distribuição teórica, amostra e estimativa
Três objetos andam juntos e não devem ser confundidos:
- Distribuição teórica: o modelo que atribui probabilidades ou densidades.
- Amostra: os valores efetivamente observados.
- Estimativa empírica: um resumo calculado a partir da amostra, como frequências, histograma ou CDF empírica.
A CDF empírica de uma amostra $x_1,\ldots,x_n$ é
$$\widehat F_n(x)=\frac1n\sum_{i=1}^n\mathbf{1}(x_i\leq x),$$
em que $\mathbf{1}(\cdot)$ vale 1 quando a condição é verdadeira e 0 caso contrário. Ela conta a fração de observações até cada limiar e é uma função em degraus, mesmo quando o modelo teórico é contínuo (Murphy, 2022, §2.7.6).
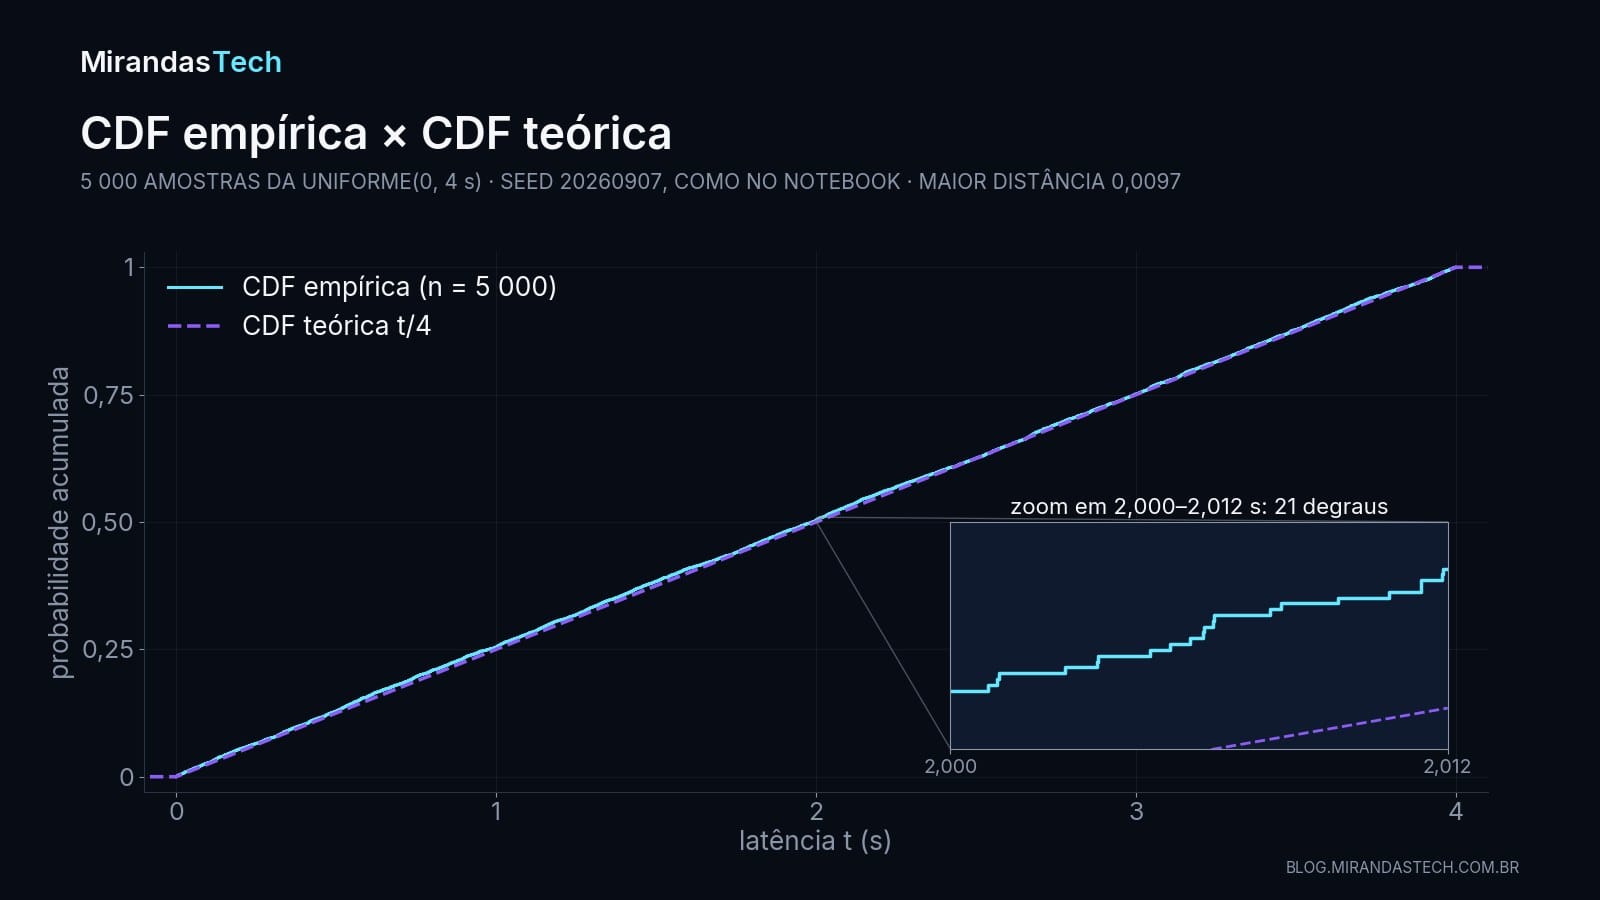
Histogramas dependem da largura e da posição dos intervalos. Com density=True, as alturas são normalizadas para que a área total das barras seja 1: cada altura passa a estimar a densidade naquele intervalo; a probabilidade estimada da barra é altura × largura (NumPy, 2026). Uma amostra não é a distribuição, e um histograma é só uma estimativa dela.
10. Onde isso aparece em IA
Massa, densidade e acumulada não ficam no livro-texto. Quatro lugares em que elas aparecem em sistemas de IA:
Classificação e geração de tokens
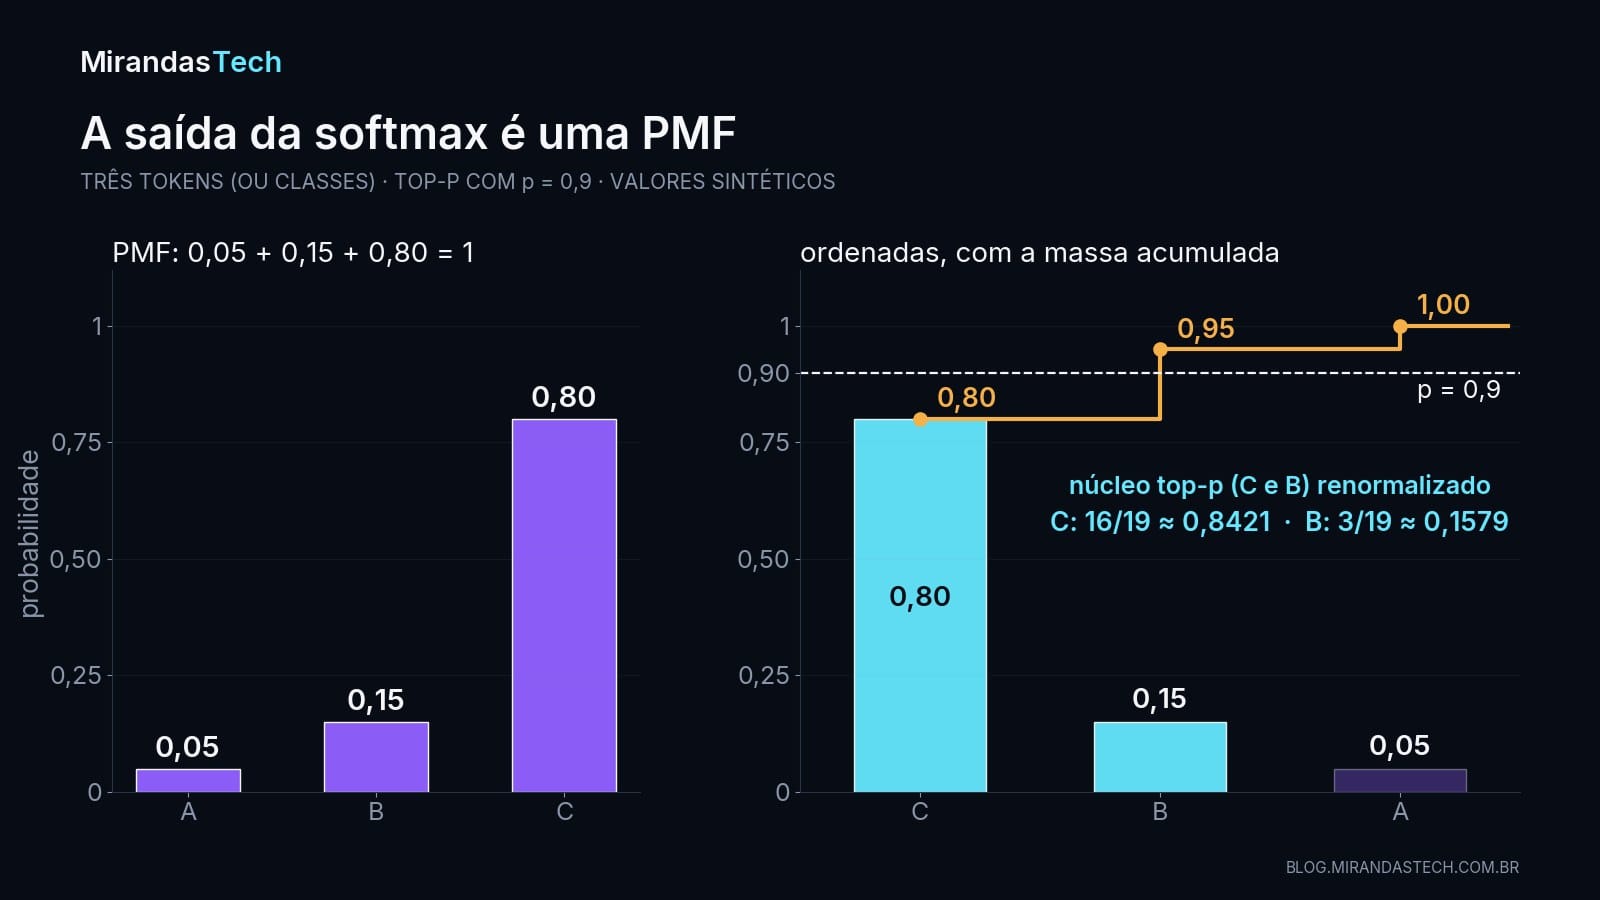
Depois da normalização, a saída de um classificador multiclasse ou de um modelo de linguagem define uma PMF sobre um conjunto discreto de classes ou de tokens:
$$\sum_{k=1}^K P(Y=k\mid\mathbf{x})=1.$$
Cada valor é uma massa. Amostrar um token significa selecionar um resultado segundo essa distribuição. A normalização costuma ser feita pela softmax (Murphy, 2022, §2.5.2), que exponencia os scores brutos $z_k$ do modelo e divide pela soma, a mesma ideia de “pontuar e normalizar” vista na Aula 04:
$$P(Y=k\mid\mathbf{x})=\frac{e^{z_k}}{\sum_{j=1}^K e^{z_j}}.$$
Antes dessa transformação, os scores em geral não satisfazem os axiomas (podem ser negativos e não somam 1) e não são probabilidades. Depois dela, valem as regras da PMF, inclusive a soma acumulada. A amostragem por núcleo, ou top-p, proposta por Holtzman et al. (2020, §3.1), usa exatamente essa soma: ordena os tokens por probabilidade, guarda o menor conjunto cuja massa acumulada atinge $p$, renormaliza e sorteia só entre eles. Com massas sintéticas $(0{,}05;\,0{,}15;\,0{,}80)$ e $p=0{,}9$, a ordem é 0,80 e 0,15, a massa acumulada chega a 0,95 no segundo token, e os dois sobreviventes passam a valer $0{,}80/0{,}95\approx0{,}8421$ e $0{,}15/0{,}95\approx0{,}1579$.
Regressão probabilística
Um modelo pode produzir não apenas um número, mas uma densidade condicional $f_{Y\mid\mathbf{x}}(y)$ (Murphy, 2022, §2.6.3). Intervalos preditivos dependem de áreas ou de quantis, e não da altura isolada da densidade. Um modelo que diz “a densidade em 120 ms é alta” ainda não disse qual é a chance de a latência ficar abaixo de 150 ms; essa resposta é uma área, ou o valor da CDF em 150 ms.
Modelos generativos e likelihood
No caso discreto, a verossimilhança usa massas; no contínuo, usa valores de densidade (Murphy, 2022, §4.2). A densidade num ponto pode participar de comparações de modelos mesmo sem ser a probabilidade daquele ponto. Uma consequência da seção 5: como a densidade pode passar de 1, o logaritmo dela pode ser positivo. Na uniforme em $[0;\,0{,}5]$, $\log f_U(u)=\log2\approx0{,}6931$. Uma log-verossimilhança positiva num modelo contínuo não é erro de código. Produtos de muitos termos podem causar instabilidade numérica, e o tratamento por logaritmos, já visto em Bayes, continua importante.
Decisões por limiar
Se uma ação é tomada quando $X\gt c$, então
$$P(X\gt c)=1-F_X(c).$$
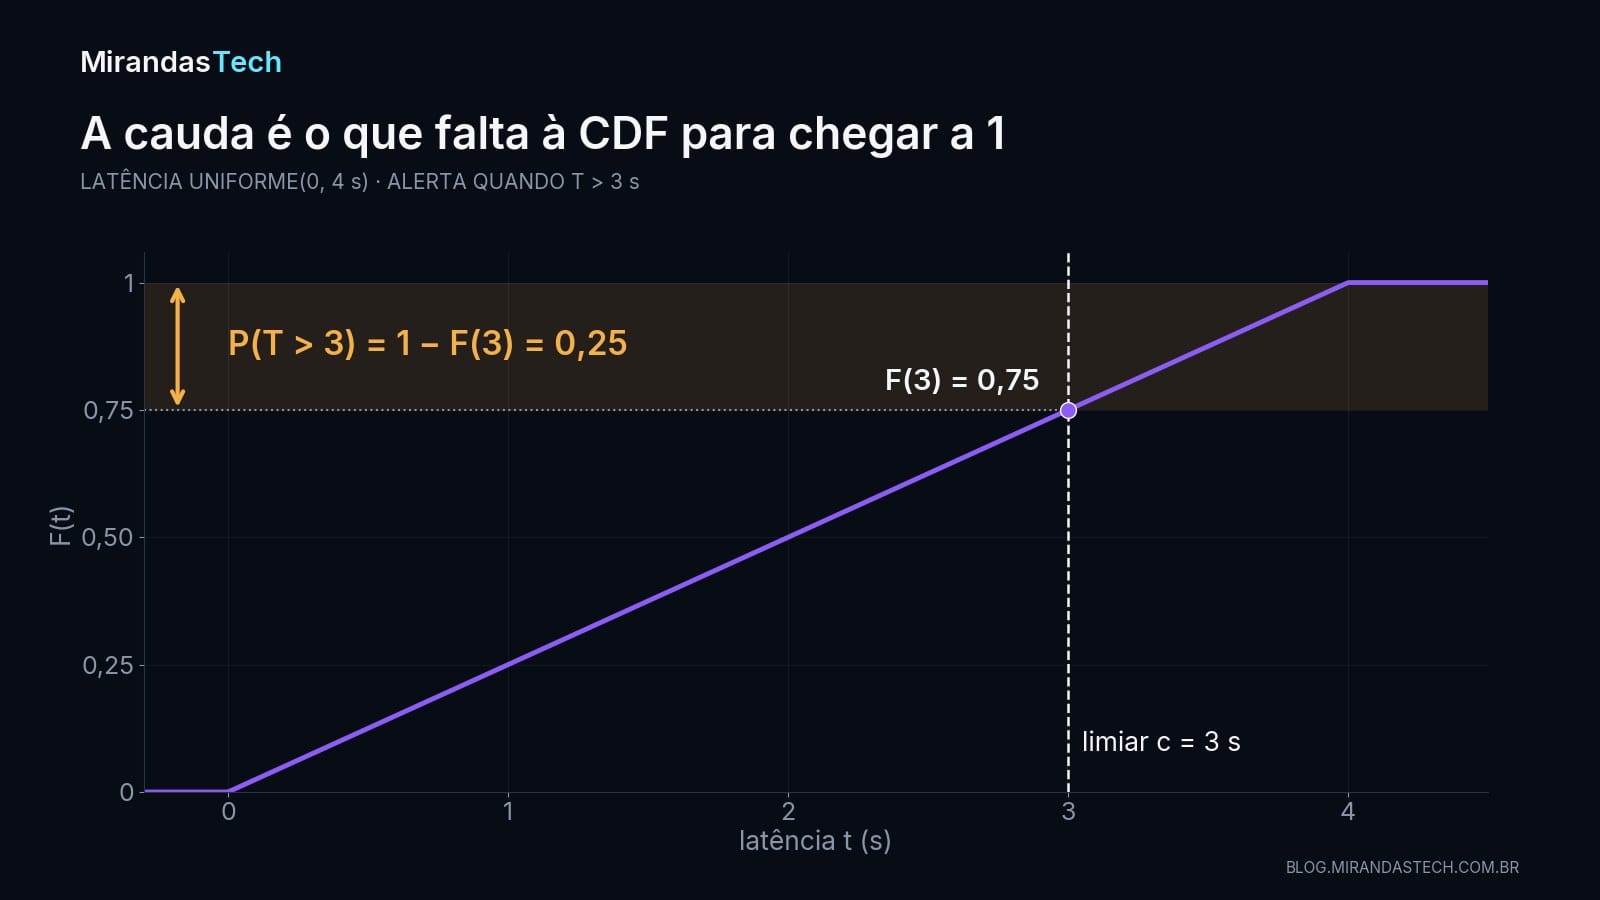
Essa é a função de sobrevivência, $S(c)=P(X\gt c)$, como o e-Handbook do NIST a chama (NIST/SEMATECH, 2020). Ela é usada sobretudo em confiabilidade e aparece em alertas de latência (Jones et al., 2016), como em toda decisão por limiar. Na latência uniforme, um alerta disparado acima de 3 s tem probabilidade $1-F_T(3)=1-3/4=0{,}25$ por requisição. A escolha do limiar é uma decisão; a distribuição quantifica a incerteza associada a ela.
11. Na prática em Python
O laboratório da aula, que abre no Google Colab, constrói e valida a PMF das duas moedas, compara probabilidades exatas com frequências simuladas, desenha a CDF em degraus, a PDF e a CDF da latência uniforme, demonstra a densidade maior que 1, a CDF empírica e a amostragem por transformação inversa, e confere tudo com testes automáticos. Os dois trechos abaixo condensam o essencial. O primeiro fica no caso discreto, só com NumPy:
import numpy as np

# PMF do número de caras em duas moedas justas
x = np.array([0, 1, 2])
pmf = np.array([0.25, 0.50, 0.25])
assert np.all(pmf >= 0) and np.isclose(pmf.sum(), 1.0)  # PMF válida

print("P(X >= 1)        =", pmf[x >= 1].sum())          # some as massas

cdf = np.cumsum(pmf)                                     # F(0), F(1), F(2)
print("CDF              =", cdf)
print("saltos da CDF    =", np.diff(cdf, prepend=0))     # devolvem as massas
print("P(0 < X <= 2)    =", cdf[2] - cdf[0])             # F(2) - F(0)

# simulação: teste de coerência, não prova
rng = np.random.default_rng(20260907)
n = 200_000
amostra = rng.integers(0, 2, size=(n, 2)).sum(axis=1)   # 1 = cara
print("frequências sim. =", np.bincount(amostra, minlength=3) / n)
Saída:
P(X >= 1)        = 0.75
CDF              = [0.25 0.75 1.  ]
saltos da CDF    = [0.25 0.5  0.25]
P(0 < X <= 2)    = 0.75
frequências sim. = [0.250385 0.50037  0.249245]
A PMF passa na validação, $P(X\geq1)=0{,}75$, a soma cumulativa dá a CDF $(0{,}25;\,0{,}75;\,1)$, e as diferenças entre degraus devolvem as massas. A subtração $F(2)-F(0)$ dá 0,75, o mesmo valor de $P(X\geq1)$, porque o extremo aberto remove só a massa de $X=0$. As frequências simuladas ficam a menos de 0,001 das massas exatas, dentro da tolerância de 0,004 que o notebook declara; com a mesma seed, são os mesmos valores que o notebook imprime. Uma simulação não prova a PMF, mas funciona como teste de coerência.
O segundo trecho usa scipy.stats (SciPy, 2026) para o caso contínuo: a latência uniforme, a cauda acima de 3 s, o quantil 0,95, a densidade maior que 1 e a amostragem inversa.
import numpy as np
from scipy import stats

T = stats.uniform(loc=0, scale=4)          # latência uniforme em [0, 4] s
print(f"f_T(2)              = {T.pdf(2.0):.3f} por segundo")
print(f"P(1 < T <= 2,5)     = {T.cdf(2.5) - T.cdf(1.0):.3f}")
print(f"P(T > 3) = 1 - F(3) = {1 - T.cdf(3.0):.3f}")
print(f"quantil 0,95        = {T.ppf(0.95):.3f} s")

U = stats.uniform(loc=0, scale=0.5)        # densidade maior que 1
print(f"f_U(0,25)           = {U.pdf(0.25):.1f}")
print(f"P(0,1 < U <= 0,2)   = {U.cdf(0.2) - U.cdf(0.1):.1f}")
print(f"log f_U(0,25)       = {np.log(U.pdf(0.25)):.4f}")

# amostragem por transformação inversa: F^{-1}(u) = 4u
rng = np.random.default_rng(20260907)
t = 4 * rng.random(100_000)
print(f"F_emp(1) = {np.mean(t <= 1):.4f}   F_emp(3) = {np.mean(t <= 3):.4f}")
Saída:
f_T(2)              = 0.250 por segundo
P(1 < T <= 2,5)     = 0.375
P(T > 3) = 1 - F(3) = 0.250
quantil 0,95        = 3.800 s
f_U(0,25)           = 2.0
P(0,1 < U <= 0,2)   = 0.2
log f_U(0,25)       = 0.6931
F_emp(1) = 0.2481   F_emp(3) = 0.7510
A densidade da latência é 0,25 por segundo, a área entre 1 e 2,5 s é 0,375, a cauda acima de 3 s é 0,25 e o quantil 0,95 é 3,8 s, os valores das seções 5, 6, 8 e 10. Na uniforme curta, a densidade é 2, a faixa entre 0,1 e 0,2 tem probabilidade 0,2, e o log da densidade é positivo. Na amostragem inversa, as frações empíricas 0,2481 e 0,7510 ficam a menos de 0,002 de $F(1)=0{,}25$ e $F(3)=0{,}75$. O notebook imprime 0,249270 e 0,750650 nesse passo porque, lá, o mesmo gerador já foi usado antes pela simulação das moedas e pela CDF empírica; os dois resultados cabem na tolerância de 0,005 do notebook. As saídas são reais, obtidas com Python 3.13.3, NumPy 2.2.3 e SciPy 1.14.1, e os dados são sintéticos.
12. Roteiro e erros comuns
Para modelar uma variável nova, um roteiro em nove passos:
- Defina o experimento e o que será observado.
- Escreva a variável como regra numérica, incluindo a unidade.
- Identifique o suporte possível, não apenas os valores vistos na amostra.
- Escolha uma representação discreta, contínua ou mista coerente.
- Verifique não negatividade e normalização.
- Traduza a pergunta para um evento, como $X\in A$ ou $X\leq x$.
- Some massas, integre densidades ou subtraia valores da CDF.
- Compare o resultado teórico com simulação ou dados, quando possível.
- Registre hipóteses, unidades, seed e tamanho da amostra.
E os erros que mais aparecem:
- Tratar $f(x)$ como $P(X=x)$. Em modelos contínuos, probabilidades são áreas.
- Exigir que a PDF seja menor que 1. Somente a área total precisa ser 1.
- Somar alturas de uma PDF. Use integração; a soma depende da malha escolhida.
- Ignorar extremos em variáveis discretas. $P(a\lt X\leq b)=F(b)-F(a)$, o que não é necessariamente $P(a\leq X\leq b)$.
- Confundir variável com valor observado. $X$ é o objeto aleatório; $x$ é uma realização.
- Normalizar pelo número de valores. Uma PMF precisa somar 1, mas não precisa ser uniforme.
- Usar o histograma como verdade. Ele é uma estimativa sensível aos intervalos.
- Ignorar suporte e unidades. Densidade positiva fora da região possível indica modelo ou código incorreto.
- Interpretar probabilidade zero como impossibilidade. Essa equivalência falha em espaços contínuos.
- Usar scores brutos como probabilidades. Os valores precisam satisfazer os axiomas depois de uma transformação apropriada, como a softmax.
13. Exercícios
- PMF válida. Uma variável $Z$ assume $-1$, $0$ e $1$ com massas $0{,}2$, $0{,}5$ e $0{,}4$. Essa é uma PMF válida? Se não, qual axioma falha?
- Consulta discreta. Para a PMF do número de caras em duas moedas justas, calcule $P(0\lt X\leq2)$ diretamente e pela CDF.
- PDF constante. $Y$ tem densidade constante $c$ em $[2,5]$ e zero fora desse intervalo. Encontre $c$, calcule $P(3\leq Y\leq4{,}5)$ e calcule $P(Y=4)$.
- CDF e extremos. Uma variável discreta tem $F(0)=0{,}10$, $F(1)=0{,}35$ e $F(2)=0{,}80$. Calcule $P(0\lt X\leq2)$ e a massa em $X=2$, sabendo que $F(2^-)=0{,}35$.
- Densidade ou probabilidade? Um modelo contínuo informa $f(1{,}2)=1{,}7$. É correto dizer que existe 170% de chance de $X=1{,}2$? Explique.
- Aplicação em IA. Um classificador retorna massas $(0{,}05;\,0{,}15;\,0{,}80)$ para três classes. Já um modelo de latência retorna uma PDF. Qual objeto usar para calcular (a) a chance da terceira classe, (b) a chance de latência entre 100 e 200 ms e (c) a chance de latência até 200 ms?
Respostas comentadas
- Não. As massas são não negativas, mas somam $0{,}2+0{,}5+0{,}4=1{,}1$, o que viola a normalização.
- O evento contém $X=1$ e $X=2$, logo $P=1/2+1/4=3/4$. Pela CDF, $F(2)-F(0)=1-1/4=3/4$. A subtração remove a massa de $X=0$, coerentemente com o extremo aberto.
- A área total é $3c=1$, então $c=1/3$. O intervalo tem largura $1{,}5$, portanto a probabilidade é $1{,}5/3=0{,}5$. Como $Y$ é contínua, $P(Y=4)=0$.
- $P(0\lt X\leq2)=F(2)-F(0)=0{,}80-0{,}10=0{,}70$. A massa em 2 é o salto: $F(2)-F(2^-)=0{,}80-0{,}35=0{,}45$.
- Não. O valor $1{,}7$ é densidade por unidade de $X$, não probabilidade. Num modelo contínuo, $P(X=1{,}2)=0$; a probabilidade de um intervalo ao redor de 1,2 é a área da densidade nesse intervalo.
- (a) Use diretamente a PMF: $0{,}80$. (b) Integre a PDF entre 100 e 200 ms, ou subtraia os valores da CDF. (c) Use a CDF em 200 ms. É indispensável manter a unidade coerente com a da PDF.
Para ir além dos exercícios, o notebook traz um desafio curto: trocar o intervalo da uniforme para $[2,5]$ sem mudar a seed e prever, antes de rodar, a altura da PDF, $P(3\leq Y\leq4{,}5)$ e a CDF em 2, 3 e 5. As respostas esperadas, $1/3$, $0{,}5$ e $(0;\,1/3;\,1)$, são conferidas por assert na própria célula.
O que guardar
Uma variável aleatória é uma função que transforma resultados em números. A PMF atribui massas a valores discretos, e essas massas somam 1. A PDF atribui densidade a valores contínuos: as probabilidades são áreas, e a densidade pode passar de 1. A CDF acumula $P(X\leq x)$, serve para qualquer variável real e calcula intervalos por diferenças; seus saltos revelam massas pontuais, e sua derivada revela a densidade, onde ela existe. Quantis são a CDF lida ao contrário, e a mesma leitura permite amostrar. Uma amostra não é a distribuição, e um histograma é apenas uma estimativa dela. Esses conceitos sustentam a classificação probabilística, a regressão, a amostragem em modelos generativos e as decisões por limiar.
Na Aula 06, Esperança, variância e covariância, as distribuições construídas aqui passam a ser resumidas em números: centro, dispersão e variação conjunta. Aqui aprendemos a representar a incerteza; lá, a extrair números que a resumem sem perder de vista suas limitações.
Referências
- Devroye, Luc. Non-Uniform Random Variate Generation. New York: Springer-Verlag. Cap. II, §2.1, Teorema 2.1 (edição web do autor: luc.devroye.org/rnbookindex.html), 1986. doi.org/10.1007/978-1-4613-8643-8
- Durrett, Rick. Probability: Theory and Examples. 5. ed. Cambridge University Press. §1.2 e Teorema 1.2.1, 2019. doi.org/10.1017/9781108591034
- Holtzman, Ari; Buys, Jan; Du, Li et al. The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR 2020), 2020. arxiv.org/abs/1904.09751
- Hyndman, Rob J.; Fan, Yanan. Sample Quantiles in Statistical Packages. The American Statistician, 50(4), 361–365, 1996. doi:10.1080/00031305.1996.10473566
- Jones, Chris; Wilkes, John; Murphy, Niall et al. Service Level Objectives. In: Site Reliability Engineering (Google; O’Reilly Media), cap. 4, ed. Betsy Beyer. Versão online oficial em sre.google, 2016. sre.google/sre-book/service-level-objectives/
- Murphy, Kevin P. Probabilistic Machine Learning: An Introduction. Cambridge, MA: MIT Press. Versão aberta do autor (online de 18/04/2025): §2.2.1–2.2.2, §2.5.1–2.5.2, §2.6.2–2.6.3, §2.7.6 e §4.2, 2022. probml.github.io/pml-book/book1.html
- NIST/SEMATECH. e-Handbook of Statistical Methods (NIST Handbook 151), §1.3.6.2 Related Distributions. National Institute of Standards and Technology, 2020. doi.org/10.18434/m32189
- NumPy. numpy.histogram. Documentação oficial (NumPy v2.5, acesso em 16 out. 2026), 2026. numpy.org · numpy.histogram
- Orloff, Jeremy; Bloom, Jonathan. Discrete Random Variables (Class 4a Reading). MIT OpenCourseWare, 18.05 Introduction to Probability and Statistics, primavera de 2022 (§2.2 a §2.8), 2022. ocw.mit.edu · 18.05 Class 4a (PDF)
- Orloff, Jeremy; Bloom, Jonathan. Continuous Random Variables (Class 5b Reading). MIT OpenCourseWare, 18.05 Introduction to Probability and Statistics, primavera de 2022 (§4 a §4.4), 2022. ocw.mit.edu · 18.05 Class 5b (PDF)
- SciPy. scipy.stats.uniform. Documentação oficial (SciPy v1.18.0, acesso em 16 out. 2026), 2026. docs.scipy.org · scipy.stats.uniform
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 02-statistics/aulas/05-variaveis-aleatorias-pmf-pdf-cdf.md.