Teorema de Bayes: por que 95% de acerto vira 16%
Atualizar probabilidades de hipóteses diante de evidências, combinando prevalência, qualidade da evidência e normalização sem inverter condicionais indevidamente.
Atualizar probabilidades de hipóteses diante de evidências, combinando prevalência, qualidade da evidência e normalização sem inverter condicionais indevidamente. Pré-requisito: a Aula 03 (probabilidade condicional e independência). Tempo sugerido: 3 a 4 horas, com o laboratório e os exercícios.
Um detector de falhas raras foi validado com cuidado: quando a falha existe, ele dispara o alerta em 95% dos casos; quando não existe, fica em silêncio em 95% dos casos. Ele acaba de alertar sobre um item. Qual é a chance de a falha ser real? A resposta que vem primeiro à cabeça é 95%. Se só 1% dos itens tem a falha, a resposta certa é cerca de 16%.
Nenhum número do detector está errado. O que a resposta apressada esquece é que a falha é rara: entre milhares de itens sem falha, 5% de alarmes falsos somam mais alertas do que todos os alertas verdadeiros. O Teorema de Bayes é a conta que junta essas duas coisas, a qualidade da evidência e o quão comum era a hipótese antes dela. A mesma conta aparece quando você avalia um classificador numa classe rara, quando pergunta se o score 0,9 de um modelo significa mesmo 90%, quando um filtro de spam combina pistas ou quando um LLM é usado como juiz de outro.
Na Aula 03 vimos que $P(A\mid B)$ e $P(B\mid A)$ dividem a mesma interseção por totais diferentes, e montamos a regra do produto e a lei da probabilidade total. Aqui essas peças se juntam para inverter a direção da pergunta. Ao final, você vai saber derivar o teorema, nomear prior, likelihood, evidence e posterior, resolver o problema por fórmula, por tabela e por frequências naturais, atualizar em odds com razões de verossimilhança, normalizar várias hipóteses, separar a hipótese mais provável da melhor decisão e testar a sensibilidade da conclusão ao prior e à taxa de falso positivo.
1. 95% não significa 95%
O sistema é didático e sintético. Chame de $H$ a hipótese “o item tem a falha” e de $+$ o alerta positivo:
- 1% dos itens tem a falha: $P(H)=0{,}01$;
- quando há falha, o sistema alerta em 95% dos casos: $P(+\mid H)=0{,}95$;
- quando não há falha, o sistema alerta em 5% dos casos: $P(+\mid H^c)=0{,}05$.
A pergunta é $P(H\mid +)$. A resposta apressada troca essa probabilidade por $P(+\mid H)$, que é outra pergunta. Escritas em palavras, a diferença fica clara:
- $P(+\mid H)$: entre os itens com falha, quantos alertam?
- $P(H\mid +)$: entre os itens que alertaram, quantos têm falha?
O Teorema de Bayes conecta as duas direções sem esquecer que a falha é rara. Antes da fórmula, porém, vale fazer a conta do jeito mais seguro.
2. Primeiro, em frequências naturais
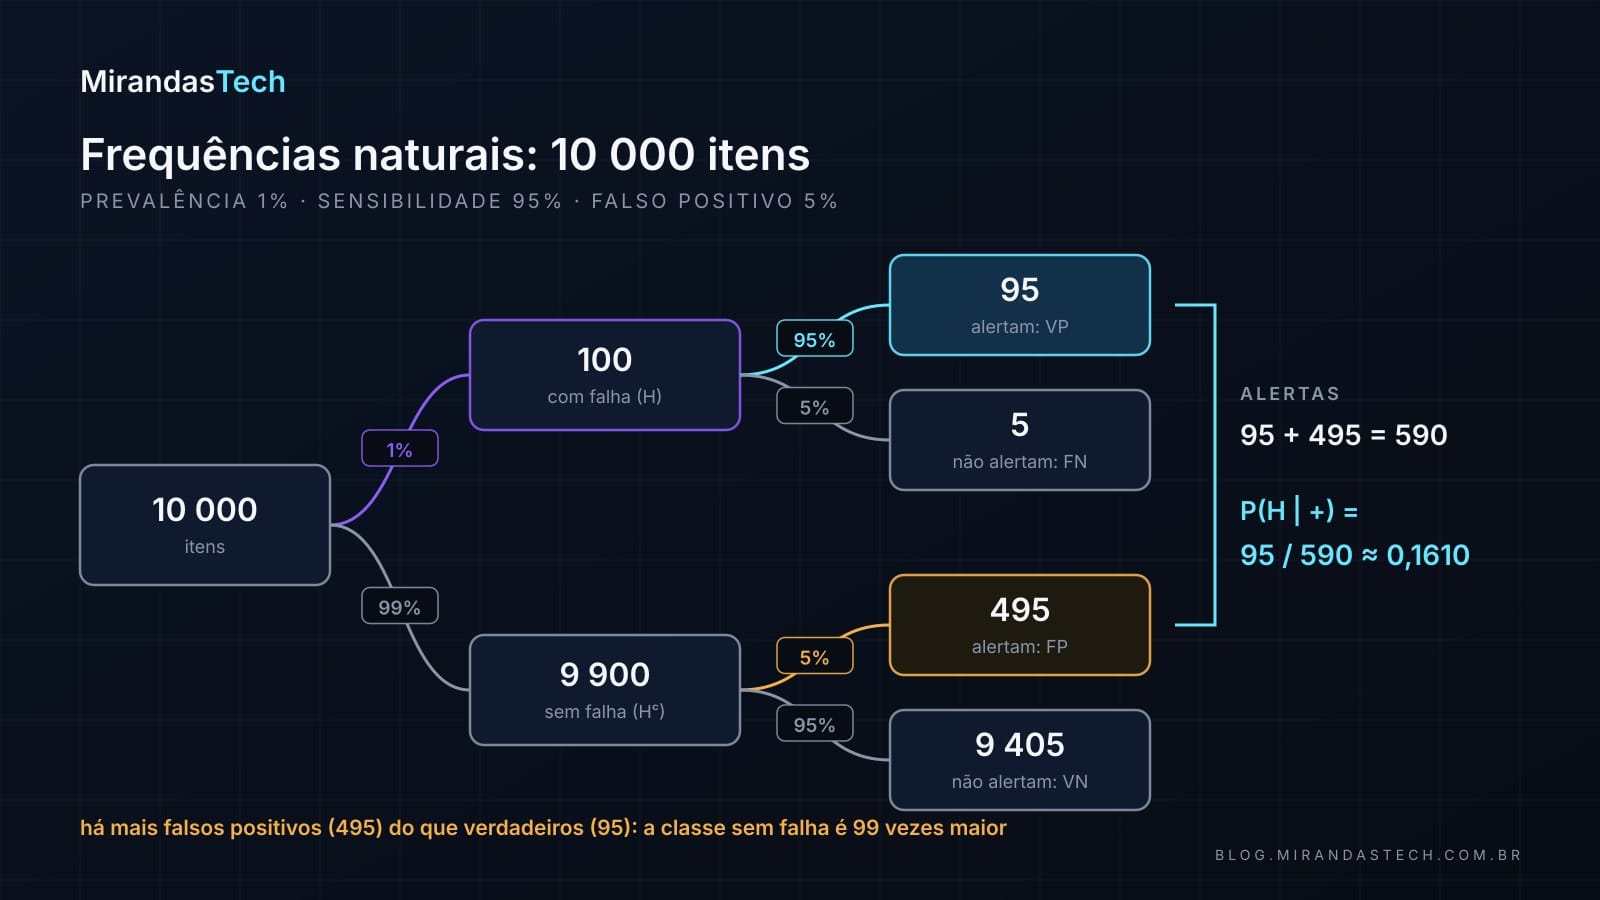
Imagine 10 000 itens exatamente com essas proporções. Com falha são $10\,000\cdot0{,}01=100$, e o sistema alerta em 95% deles: 95 alertas verdadeiros. Sem falha são $10\,000-100=9\,900$, e o sistema alerta falsamente em 5% deles: $9\,900\cdot0{,}05=495$ alertas falsos.
As quatro contagens, em lista:
- Com falha ($H$): 95 alertam, 5 não alertam, 100 no total.
- Sem falha ($H^c$): 495 alertam, 9 405 não alertam, 9 900 no total.
- Total: 590 alertas, 9 410 sem alerta, 10 000 itens.
Entre os 590 alertas, só 95 correspondem à falha:
$$P(H\mid +)=\frac{95}{590}\approx0{,}1610.$$
O posterior é de cerca de 16,10%, e não 95%. O alerta multiplicou por cerca de 16 a probabilidade da falha, que passou de 1% para 16,10%, e por isso é informativo. Mas a população sem falha é tão grande que produz mais alertas falsos do que a população com falha produz alertas verdadeiros.
Esse formato de contagens não é só um truque didático. Gigerenzer e Hoffrage (1995) mostraram que algoritmos bayesianos ficam computacionalmente mais simples quando a informação chega em frequências do que em probabilidades, e que, nesse formato, participantes sem treino estatístico resolveram por raciocínio bayesiano até metade das inferências. Na prática, as frequências naturais são uma verificação barata contra o erro de direção: elas obrigam a escrever o denominador.
3. As quatro peças e de onde vem a fórmula
Considere uma hipótese $H$ e um dado, ou evidência, $D$. O teorema tem quatro peças, e cada uma responde a uma pergunta diferente:
- Prior, $P(H)$: quão plausível era $H$ antes de observar $D$?
- Likelihood, $P(D\mid H)$: quão compatível é $D$ com $H$?
- Evidence, ou probabilidade marginal, $P(D)$: quão provável é observar $D$, considerando todas as hipóteses?
- Posterior, $P(H\mid D)$: quão plausível fica $H$ depois de observar $D$?
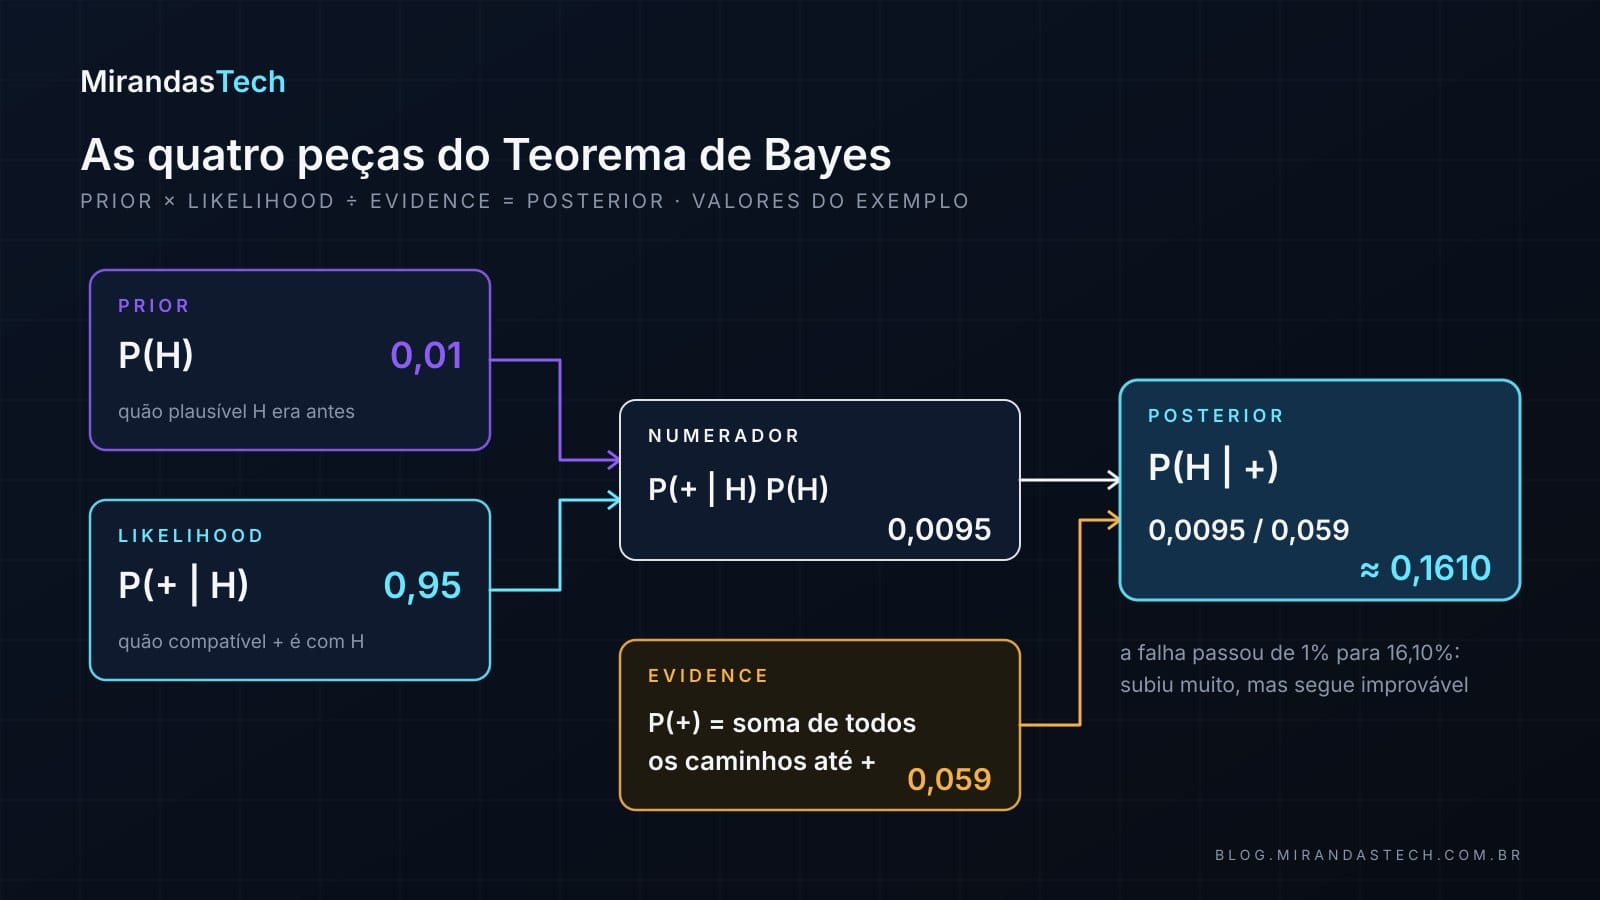
Em português, likelihood costuma ser traduzida como verossimilhança. Um cuidado conceitual: $P(D\mid H)$ é uma probabilidade sobre possíveis dados quando $H$ está fixada. Vista como função de $H$ para um dado já observado, a likelihood não precisa somar 1 sobre as hipóteses. Bertsekas e Tsitsiklis (2008, §1.4) chamam $P(H)$ de probabilidade a priori e $P(H\mid D)$ de probabilidade a posteriori, e descrevem o uso típico do teorema: há várias “causas” possíveis para um “efeito”; observamos o efeito e queremos inferir a causa.
A fórmula sai da regra do produto da Aula 03, escrita nas duas ordens. Por um lado,
$$P(H\cap D)=P(D\mid H)\,P(H).$$
Por outro,
$$P(H\cap D)=P(H\mid D)\,P(D).$$
Os lados esquerdos são a mesma interseção. Igualando os direitos e dividindo por $P(D)$, desde que $P(D)>0$:
$$\boxed{P(H\mid D)=\frac{P(D\mid H)\,P(H)}{P(D)}}$$
Bayes não cria informação. Ele reorganiza probabilidades condicionais e normaliza o resultado.
4. O denominador vem da probabilidade total
No caso binário, $H$ e $H^c$ formam uma partição: todo item tem ou não tem a falha. Pela lei da probabilidade total,
$$\begin{aligned}P(D)&=P(D\mid H)P(H)\\&\quad+P(D\mid H^c)P(H^c).\end{aligned}$$
Substituindo no teorema:
$$\begin{aligned}&P(H\mid D)=\\&\frac{P(D\mid H)P(H)}{P(D\mid H)P(H)+P(D\mid H^c)P(H^c)}.\end{aligned}$$
Para o alerta, o numerador é $0{,}95\cdot0{,}01=0{,}0095$ e o segundo termo do denominador é $0{,}05\cdot0{,}99=0{,}0495$:
$$\begin{aligned}P(H\mid +)&=\frac{0{,}0095}{0{,}0095+0{,}0495}\\&=\frac{0{,}0095}{0{,}059}\approx0{,}1610.\end{aligned}$$
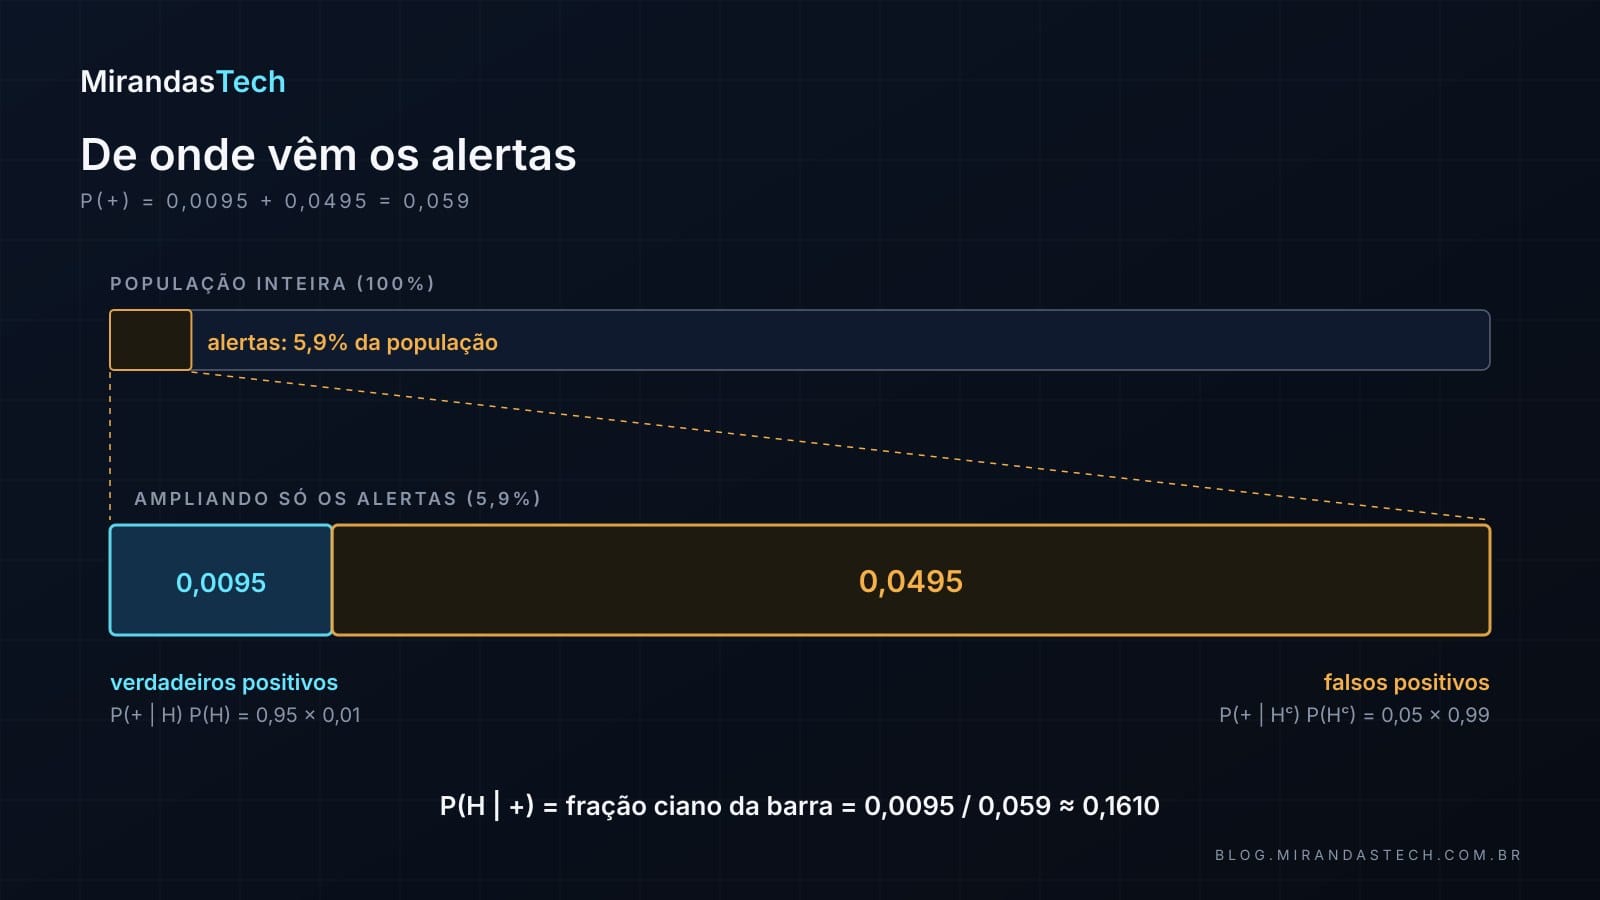
O denominador $0{,}059$ é a probabilidade marginal de um alerta: 0,95% da população gera verdadeiros positivos e 4,95% gera falsos positivos. O posterior é simplesmente a fatia verdadeira dentro de todos os alertas. Bertsekas e Tsitsiklis (2008, Ex. 1.16) fazem a mesma conta com um radar que acusa aeronaves: com $P(A)=0{,}05$, $P(B\mid A)=0{,}99$ e $P(B\mid A^c)=0{,}1$, a probabilidade de haver uma aeronave dado o alarme é cerca de 0,3426.
Essa forma também resolve o que a Aula 03 calculou direto na tabela de mensagens. Com $P(S)=0{,}20$, $P(L\mid S)=0{,}75$ e $P(L\mid S^c)=80/800=0{,}10$, o teorema devolve $P(S\mid L)=0{,}15/(0{,}15+0{,}08)\approx0{,}6522$, o mesmo valor obtido contando as 230 mensagens com link. Bayes é útil justamente quando a tabela não está disponível, mas as taxas por classe e a prevalência estão.
5. Sensibilidade, especificidade e precisão
As taxas do detector têm nomes próprios. No exemplo:
- Sensibilidade, $P(+\mid H)=0{,}95$;
- taxa de falso negativo, $P(-\mid H)=0{,}05$;
- especificidade, $P(-\mid H^c)=0{,}95$;
- taxa de falso positivo, $P(+\mid H^c)=0{,}05$;
- valor preditivo positivo (a precisão do vocabulário de ML), $P(H\mid +)\approx0{,}1610$.
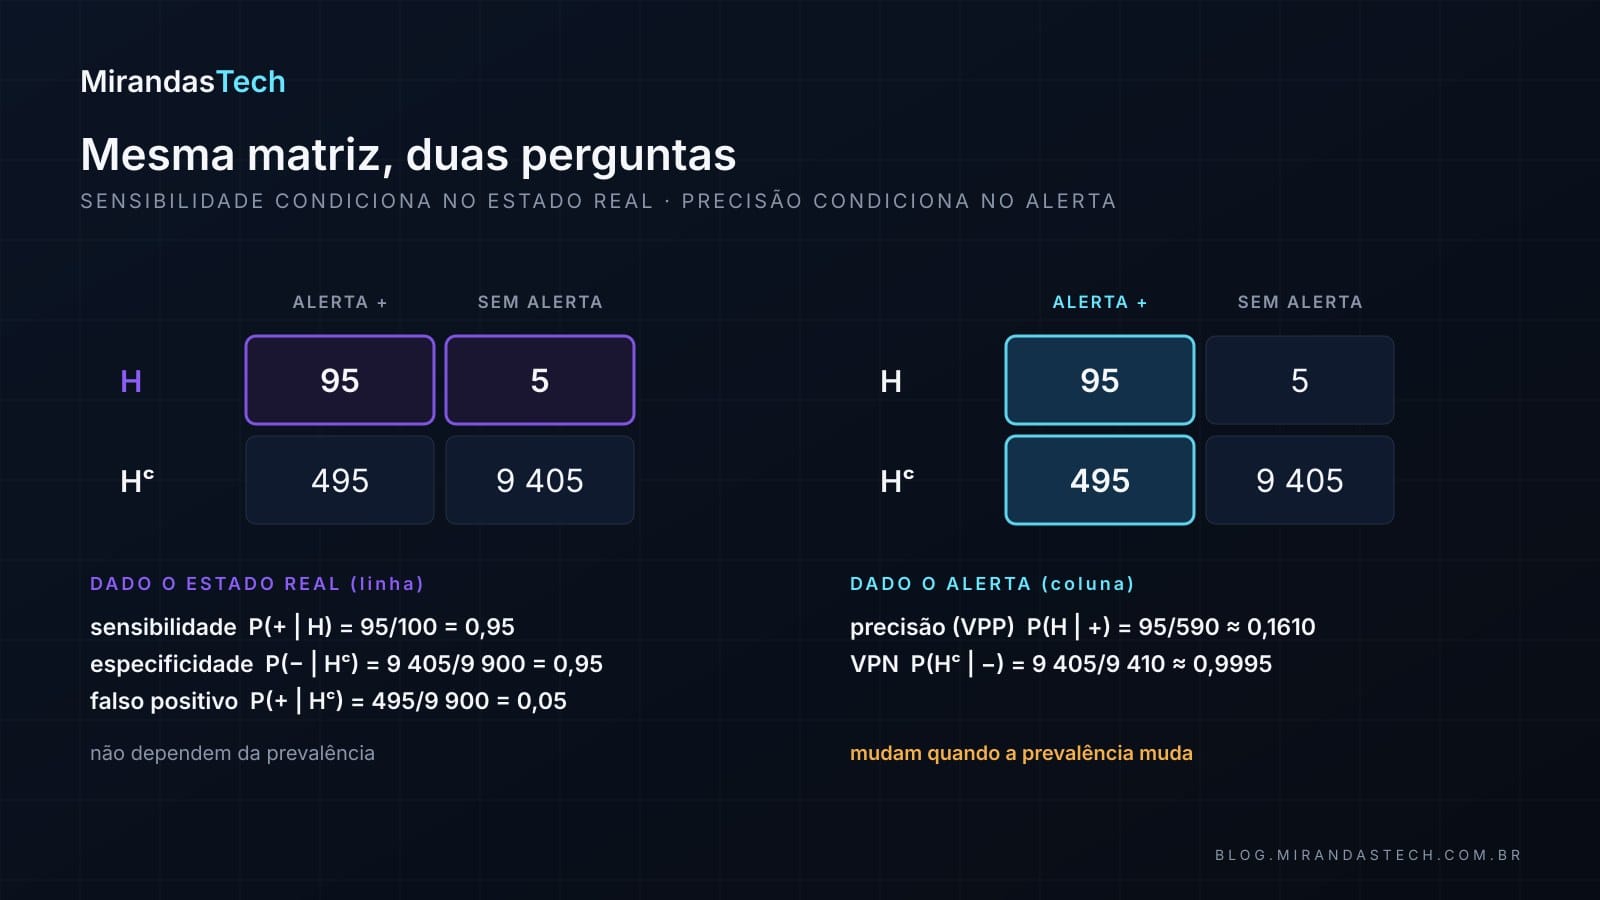
Sensibilidade e especificidade condicionam no estado real: dividem por totais de linha. O valor preditivo condiciona no resultado observado: divide por um total de coluna, e esse total depende de quantos itens de cada linha existem, isto é, da prevalência $P(H)$. É por isso que um detector com 95% de acerto (sensibilidade e especificidade de 95%, portanto 95% dos itens classificados corretamente em qualquer prevalência) pode ter precisão de 16% num contexto e de 95% em outro, como as seções 12 e 13 mostram.
Este é um exemplo matemático, não orientação clínica ou operacional. Em aplicações reais, as taxas precisam ser estimadas na população relevante, com incerteza, desenho de estudo e custos de erro apropriados.
6. Negligência da taxa-base
Taxa-base é a frequência anterior da hipótese no contexto relevante, aqui a prevalência da falha. Negligenciá-la é avaliar a evidência sem ponderar quão comum era cada hipótese. No exemplo, duas forças puxam em sentidos opostos:
- o alerta é 19 vezes mais provável com falha do que sem falha, porque $0{,}95/0{,}05=19$;
- mas itens sem falha são 99 vezes mais comuns que itens com falha.
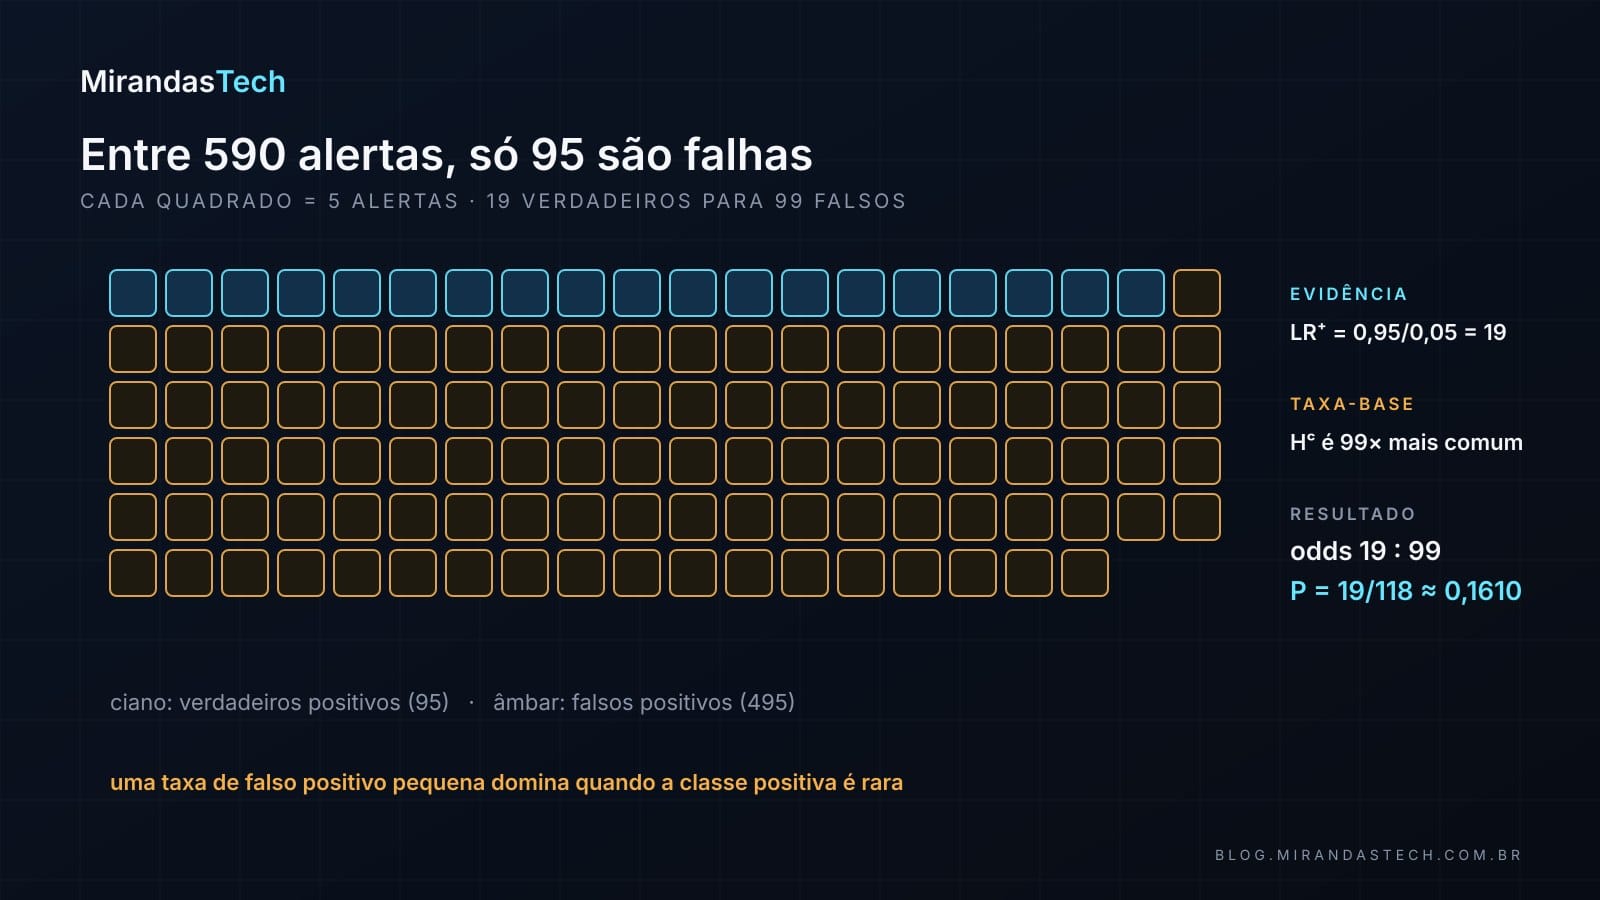
A evidência vence por 19, a taxa-base vence por 99, e o resultado é 19 alertas verdadeiros para 99 falsos. Uma taxa de falso positivo aparentemente pequena domina quando a classe positiva é muito rara. A leitura do MIT 18.05 resume o fenômeno numa frase: 95% de todos os testes estarem corretos não implica que 95% dos testes positivos estejam corretos (Orloff & Bloom, 2022). Bertsekas e Tsitsiklis (2008, Ex. 1.18) trazem o “quebra-cabeça do falso positivo” com um teste correto 95% do tempo e prevalência de 0,1%: o posterior fica em 0,0187, menos de 2%.
Antes de interpretar um alerta, três perguntas evitam o erro:
- Qual é a prevalência no grupo em que o sistema está operando?
- Como sensibilidade e falso positivo foram medidos nesse grupo?
- O fluxo de produção mudou desde a validação?
7. Odds e razão de verossimilhança
A seção anterior já raciocinou em “19 contra 1” e “99 contra 1”. Isso tem nome: odds, a razão entre a chance de $H$ e a chance do contrário:
$$O(H)=\frac{P(H)}{1-P(H)},$$
e, para voltar das odds à probabilidade,
$$P(H)=\frac{O(H)}{1+O(H)}.$$
A razão de verossimilhança positiva compara a chance de observar $+$ sob as duas hipóteses:
$$LR^+=\frac{P(+\mid H)}{P(+\mid H^c)}.$$
Dividindo o Teorema de Bayes escrito para $H$ pelo mesmo teorema escrito para $H^c$, o denominador $P(+)$ se cancela, e sobra a forma mais curta do teorema:
$$\boxed{O(H\mid +)=O(H)\cdot LR^+}$$
Em palavras: odds posteriores são odds anteriores vezes a força da evidência. No exemplo, $O(H)=0{,}01/0{,}99\approx0{,}010101$ e $LR^+=19$, então $O(H\mid +)\approx0{,}191919$. Convertendo de volta:
$$P(H\mid +)=\frac{0{,}191919}{1{,}191919}\approx0{,}1610.$$
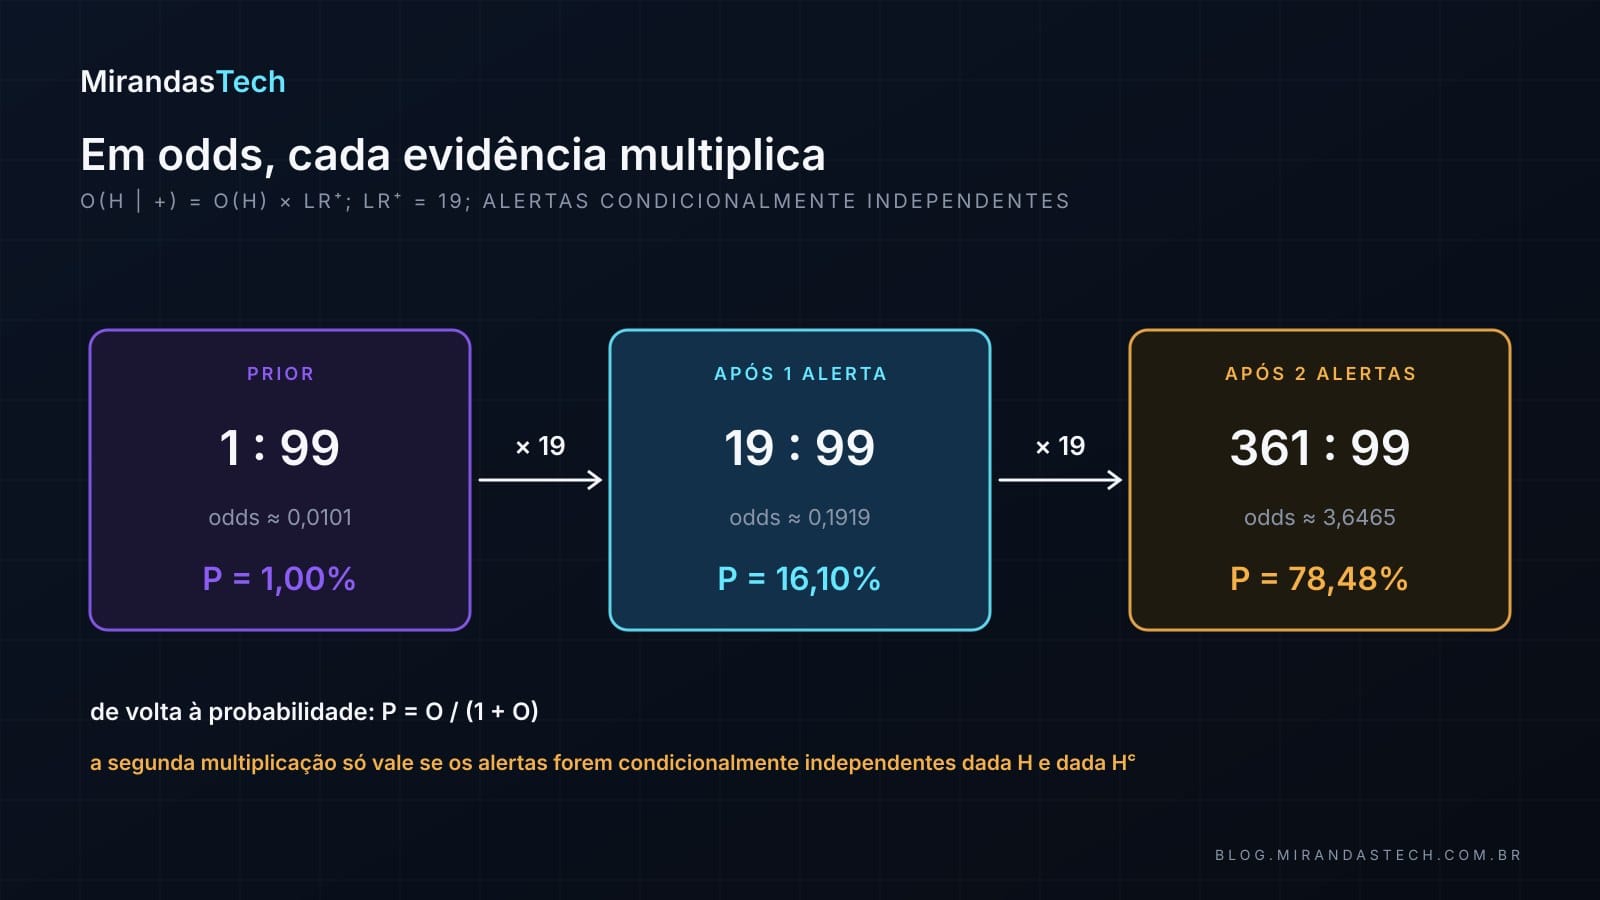
A vantagem das odds aparece quando há mais de uma evidência: a atualização vira uma sequência de multiplicações.
8. Atualização sequencial e o risco da dupla contagem
Depois da primeira evidência, o posterior pode virar o prior da próxima atualização. Para evidências $D_1,\ldots,D_n$ condicionalmente independentes dada cada hipótese,
$$O(H\mid D_1,\ldots,D_n)=O(H)\prod_{i=1}^{n}\frac{P(D_i\mid H)}{P(D_i\mid H^c)}.$$
Se dois alertas positivos têm $LR^+=19$ cada e satisfazem essa hipótese:
$$O_{\text{post}}=\frac{0{,}01}{0{,}99}\cdot19^2=\frac{361}{99}\approx3{,}6465,$$ $$P_{\text{post}}=\frac{3{,}6465}{1+3{,}6465}\approx0{,}7848.$$
Dois alertas independentes levam a falha de 1% para cerca de 78,48%. A palavra que sustenta essa conta é “independentes”, e ela é exatamente a independência condicional da Aula 03: dado o estado real do item, um alerta não pode trazer informação sobre o outro.
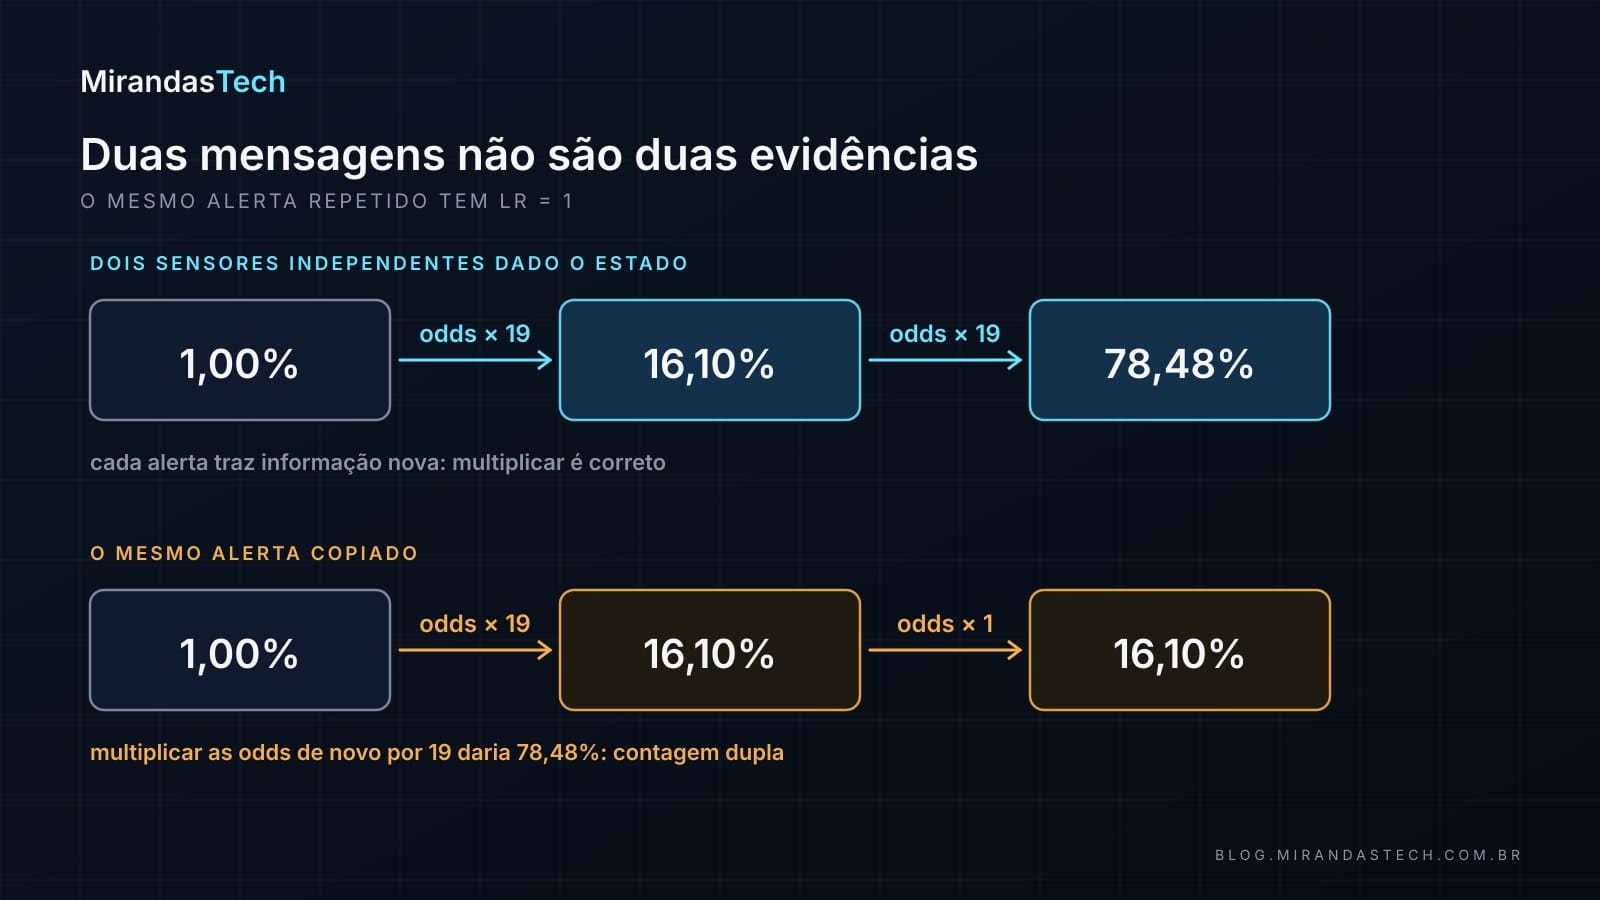
Se os dois alertas usam o mesmo sensor, os mesmos dados ou falham pelo mesmo motivo, multiplicar dois LRs como se fossem independentes superestima a evidência. No caso extremo, o segundo alerta é uma cópia do primeiro: dado o primeiro, ele aparece com probabilidade 1 com ou sem falha, sua razão de verossimilhança é 1 e o posterior correto continua em 16,10%. “Duas mensagens” não significam “duas evidências”. Clemen e Winkler (1985) mostraram, na combinação de fontes de informação, que dependência positiva entre as fontes pode reduzir seriamente a precisão e o valor da informação combinada, e que o valor incremental de cada fonte nova pode cair muito depressa.
9. Várias hipóteses: pontuar e normalizar
Nada no teorema exige só duas hipóteses. Se $H_1,\ldots,H_k$ formam uma partição,
$$P(H_i\mid D)=\frac{P(D\mid H_i)P(H_i)}{\sum_{j=1}^{k}P(D\mid H_j)P(H_j)}.$$
O cálculo tem três etapas: a pontuação não normalizada $s_i=P(D\mid H_i)P(H_i)$; a evidence $Z=\sum_j s_j$; e o posterior $P(H_i\mid D)=s_i/Z$. Os posteriors resultantes são não negativos e somam 1. Bertsekas e Tsitsiklis (2008, Fig. 1.14) ilustram o mesmo esquema com três causas possíveis para uma sombra num raio X.
Um exemplo resolvido: três componentes podem ter originado um alerta de produção. Os priors e as likelihoods são:
- Sensor: prior 0,50, likelihood 0,10, score 0,050;
- Rede: prior 0,30, likelihood 0,40, score 0,120;
- Aplicação: prior 0,20, likelihood 0,70, score 0,140.
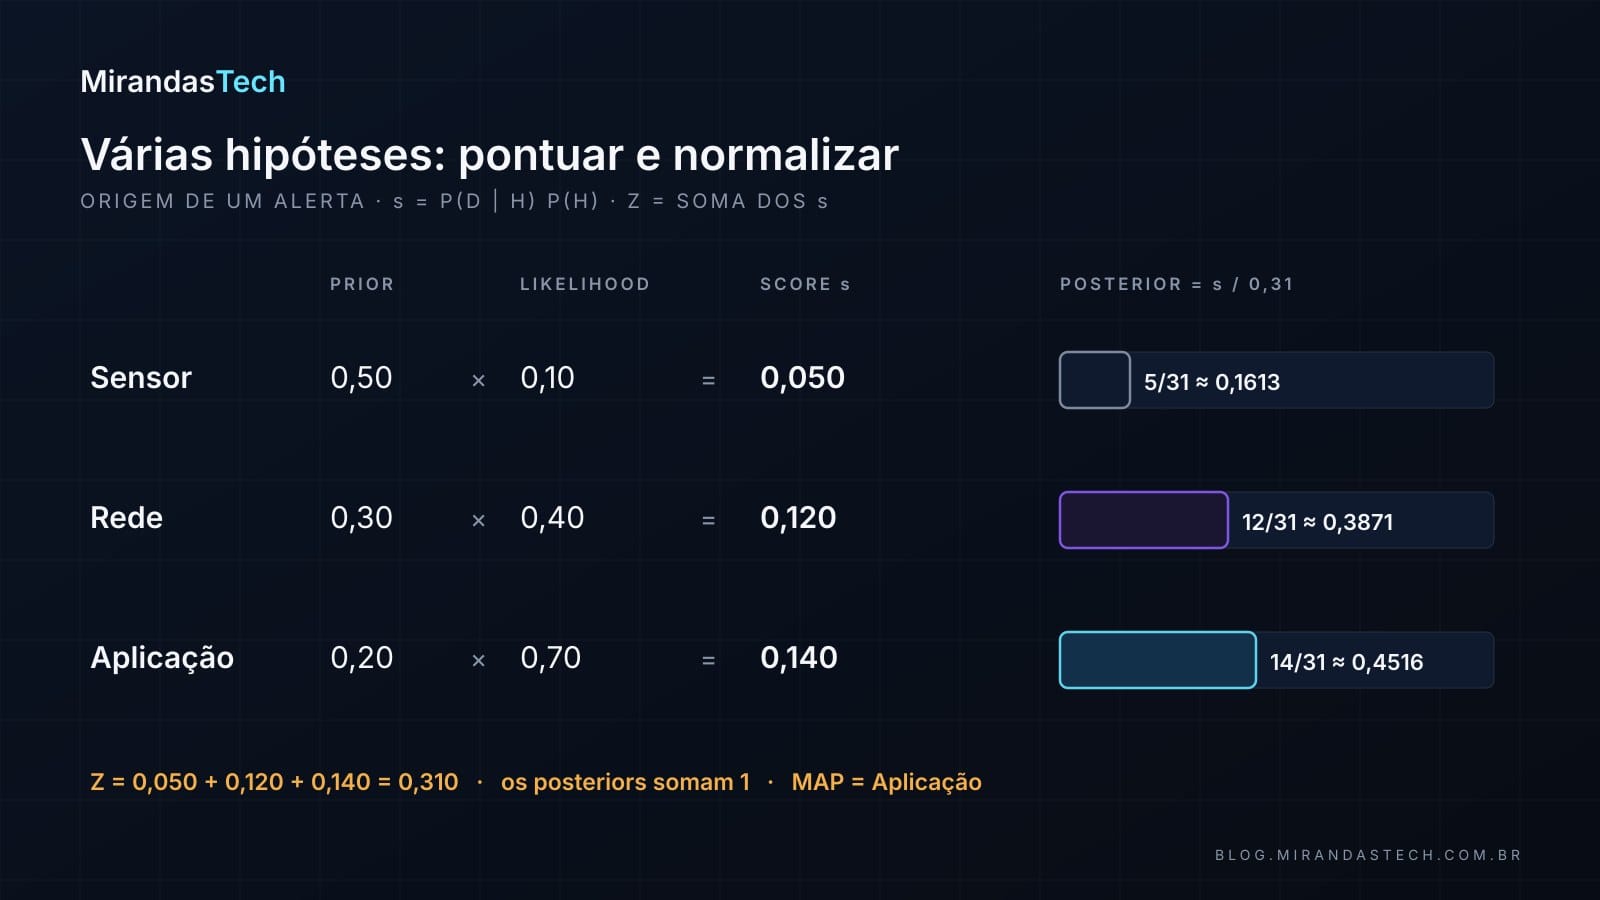
A evidence é $Z=0{,}050+0{,}120+0{,}140=0{,}310$. Logo,
$$P(\text{Sensor}\mid D)=\frac{0{,}050}{0{,}310}\approx0{,}1613,$$ $$P(\text{Rede}\mid D)=\frac{0{,}120}{0{,}310}\approx0{,}3871,$$ $$P(\text{Aplicação}\mid D)=\frac{0{,}140}{0{,}310}\approx0{,}4516.$$
O sensor tinha o maior prior e terminou com o menor posterior: a evidência é pouco compatível com ele. Quem trabalha com redes neurais vai reconhecer o padrão “pontuar e dividir pela soma”: ele lembra a etapa final de uma softmax, que divide cada score exponenciado pela soma de todos. Aqui, porém, cada score tem significado probabilístico explícito.
10. MAP: a hipótese mais provável não é a melhor decisão
A estimativa de máximo a posteriori escolhe a hipótese de maior posterior:
$$\begin{aligned}\hat h_{\text{MAP}}&=\arg\max_h P(h\mid D)\\&=\arg\max_h P(D\mid h)\,P(h).\end{aligned}$$
A segunda igualdade vale porque $P(D)$ é o mesmo para todas as hipóteses comparadas: para escolher o MAP, nem é preciso normalizar. No exemplo anterior, “Aplicação” é a hipótese MAP, com posterior de cerca de 45,16%.
Escolher a classe de maior posterior minimiza a taxa de erro de classificação, isto é, a perda 0-1, em que todo erro custa o mesmo (Domingos & Pazzani, 1997). Quando os erros custam diferente, a melhor ação pode ser outra. Um exemplo didático: suponha que deixar passar uma falha de rede custe 5 e deixar passar qualquer outra custe 1, e que só dê para investigar uma causa primeiro. O custo esperado de não investigar a causa $j$ é $P(j\mid D)\cdot c_j$: cerca de 0,16 para o sensor, 1,94 para a rede e 0,45 para a aplicação.
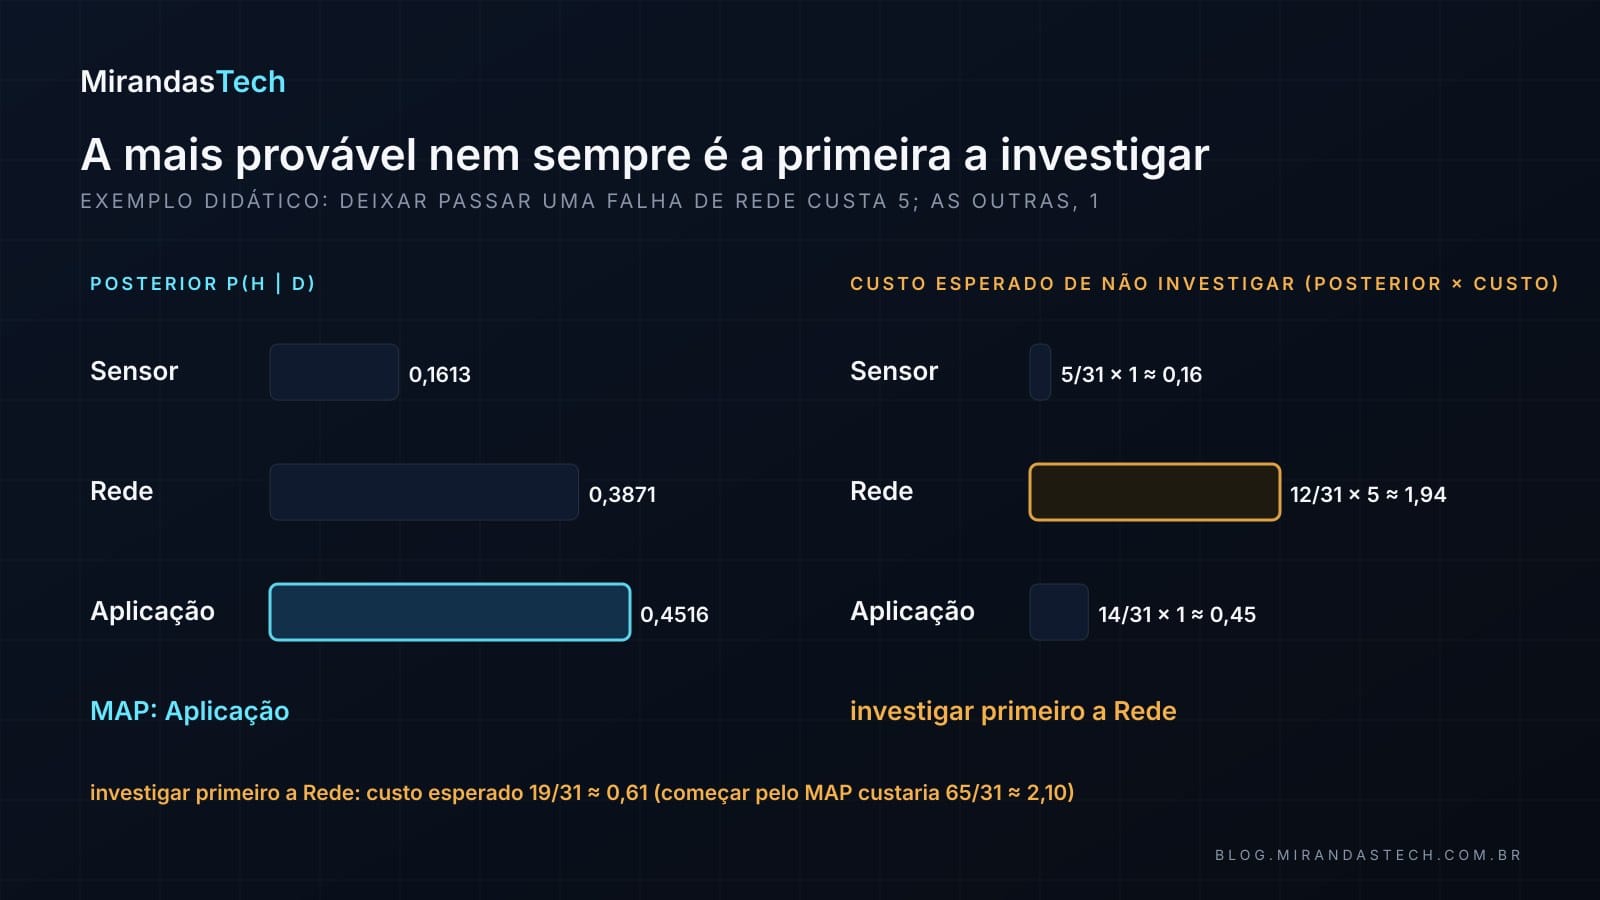
Investigar primeiro a rede deixa de fora o sensor e a aplicação, com custo esperado $5/31+14/31=19/31\approx0{,}61$. Investigar primeiro a aplicação, a hipótese MAP, deixa de fora o sensor e a rede, e custa $5/31+60/31=65/31\approx2{,}10$. A hipótese mais provável e a ação de menor custo não coincidem. Probabilidade e utilidade são peças diferentes da decisão, e um sistema que só devolve o MAP esconde a primeira peça de quem precisa combiná-la com a segunda.
11. Naive Bayes e o domínio logarítmico
A Aula 03 apresentou o Naive Bayes como uma hipótese de independência condicional. Aqui ele aparece como o que é: o Teorema de Bayes aplicado a uma classe $Y$ e atributos $X_1,\ldots,X_d$, com a likelihood fatorada.
$$P(Y\mid X_1,\ldots,X_d)\propto P(Y)\prod_{j=1}^{d}P(X_j\mid Y).$$
O símbolo $\propto$ diz “proporcional a”: falta dividir pela evidence, a soma dos scores de todas as classes, exatamente como na seção 9. Um exemplo simplificado com uma mensagem que contém as palavras “promoção” e “link”:
- Spam: prior 0,20; $P(\text{promoção}\mid\text{spam})=0{,}70$; $P(\text{link}\mid\text{spam})=0{,}75$; score $0{,}20\cdot0{,}70\cdot0{,}75=0{,}105$.
- Legítima: prior 0,80; $P(\text{promoção}\mid\text{leg.})=0{,}05$; $P(\text{link}\mid\text{leg.})=0{,}10$; score $0{,}80\cdot0{,}05\cdot0{,}10=0{,}004$.
$$\begin{aligned}&P(\text{spam}\mid\text{evidências})\\&=\frac{0{,}105}{0{,}105+0{,}004}\approx0{,}9633.\end{aligned}$$
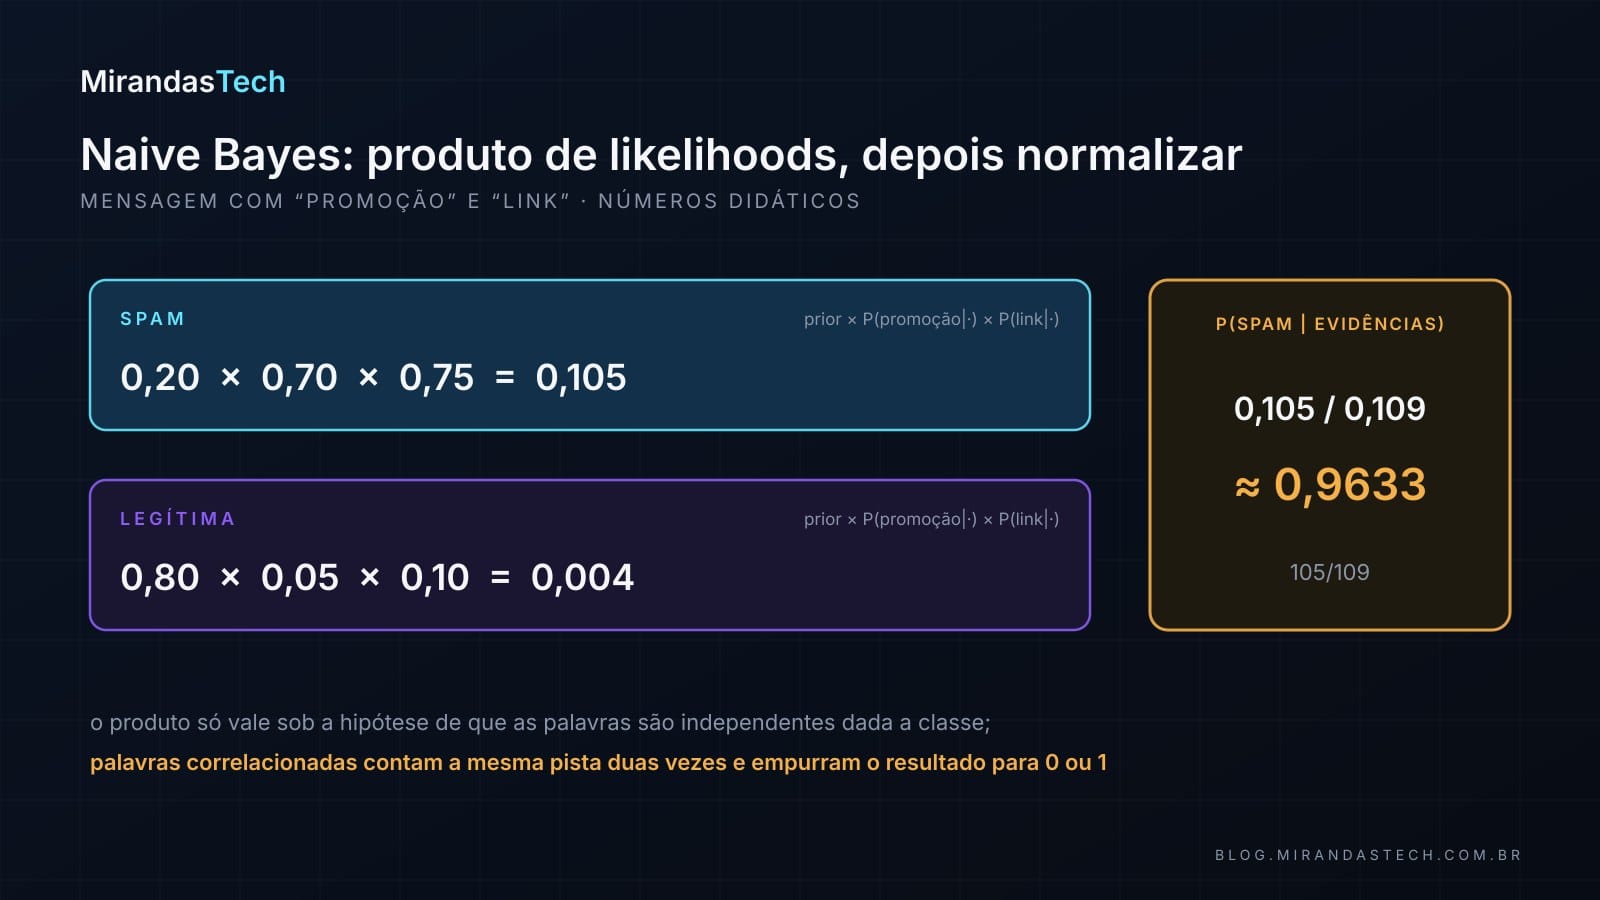
Esse número só vale dentro do modelo e das probabilidades fornecidas. Palavras correlacionadas violam a fatoração, que então conta a mesma pista mais de uma vez: é a dupla contagem da seção 8 dentro de um classificador. O efeito prático é conhecido. Niculescu-Mizil e Caruana (2005) observaram que modelos como o Naive Bayes, que fazem hipóteses de independência irrealistas, empurram as probabilidades previstas para 0 e 1. O outro lado, com Domingos e Pazzani e a documentação do scikit-learn, ficou na Aula 03: a classe escolhida pode continuar certa mesmo quando a probabilidade está exagerada. Ordenar bem e estimar bem a probabilidade são propriedades diferentes.
Há ainda um problema numérico. Multiplicar centenas de probabilidades pequenas pode produzir números menores do que o ponto flutuante consegue representar, e o produto vira zero (underflow). A saída é somar logaritmos:
$$\log s_y=\log P(y)+\sum_{j=1}^{d}\log P(x_j\mid y).$$
O maior score logarítmico identifica o mesmo MAP, porque o logaritmo é estritamente crescente. Para obter probabilidades normalizadas de forma estável, subtrai-se o maior log-score antes de exponenciar, o truque conhecido como log-sum-exp. A seção 15 mostra os dois comportamentos em código. Teoria da informação e log-loss voltam nas Aulas 21 e 22 desta série.
12. O prior e a análise de sensibilidade
O prior não é um palpite descartável. Ele pode vir de frequência histórica numa população comparável, de conhecimento de domínio formalizado, de um estudo anterior ou de uma distribuição deliberadamente ampla para análise de sensibilidade. Em todos os casos, precisa registrar população e período de referência, processo de coleta, justificativa, versão e alternativas plausíveis.
Dois valores exigem cuidado especial. Se $P(H)=0$, o numerador é zero e $P(H\mid D)=0$ para qualquer evidência; se $P(H)=1$, o posterior permanece 1. Valores dogmáticos impedem o modelo de aprender. Reserve-os a impossibilidades ou certezas realmente estruturais, não à confiança subjetiva.
Uma conclusão robusta não deveria depender silenciosamente de uma única escolha frágil. Mantendo sensibilidade 0,95 e falso positivo 0,05, o mesmo alerta produz estes posteriors conforme o prior:
- prior de 0,1%: posterior de 1,87%;
- prior de 1%: posterior de 16,10%;
- prior de 5%: posterior de 50,00%;
- prior de 10%: posterior de 67,86%;
- prior de 50%: posterior de 95,00%.
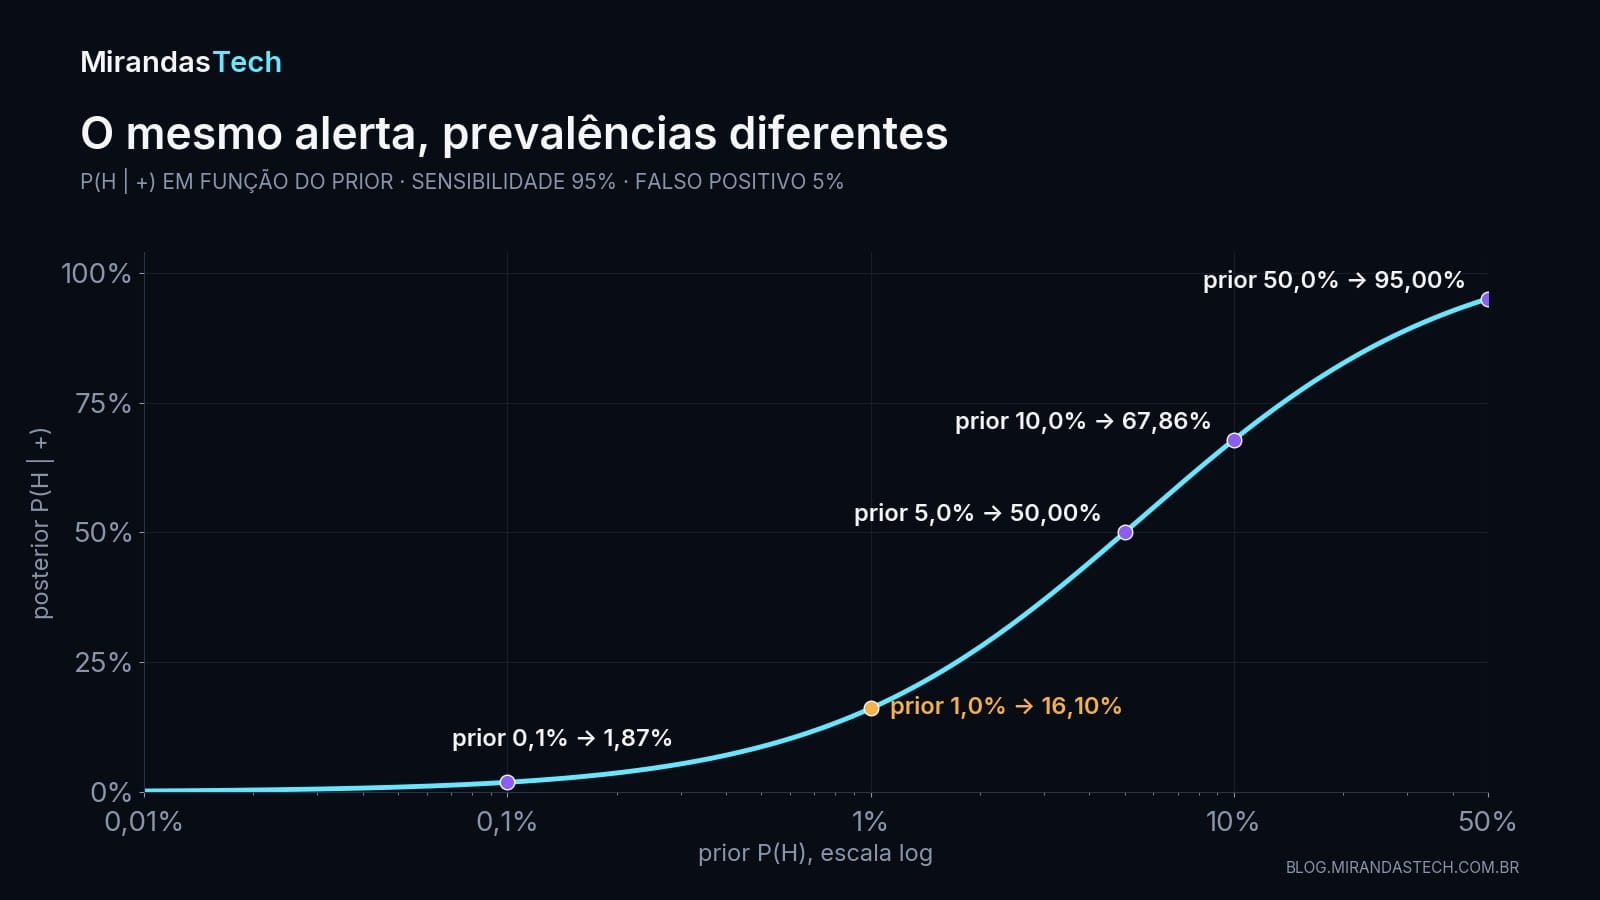
Com prior de 5%, o alerta empata: posterior de exatamente 50%. Com prior de 50%, o posterior é 95%, o número que a resposta apressada usava; essa resposta só estaria certa se metade dos itens tivesse a falha. O falso positivo pesa tanto quanto o prior. O mapa abaixo, gerado no notebook da aula, varia os dois ao mesmo tempo.
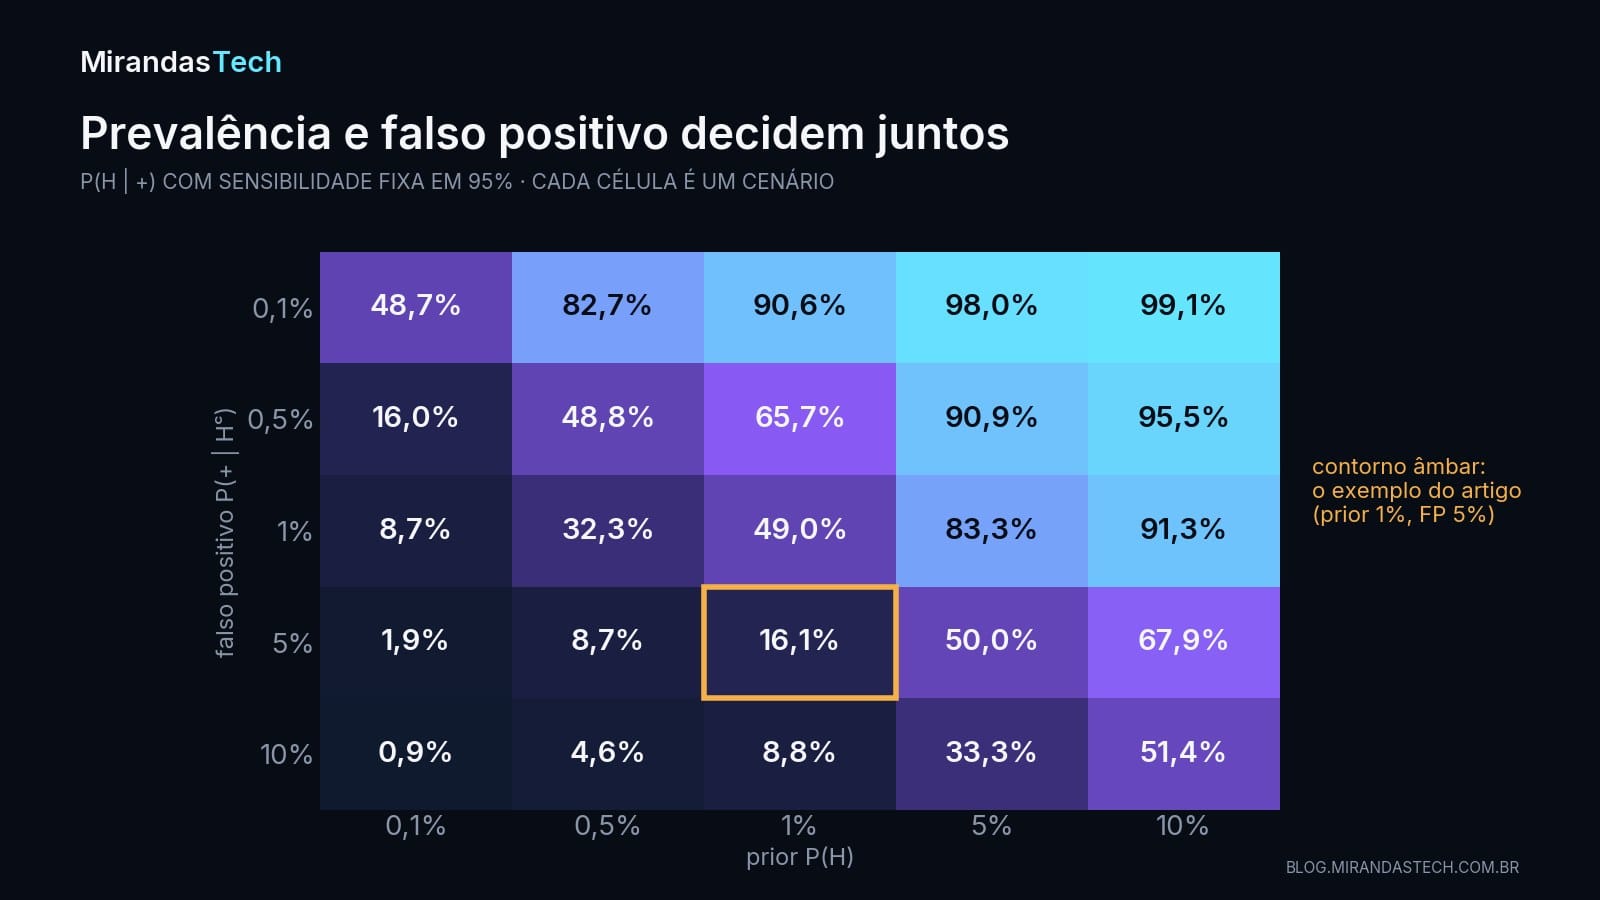
Quando o evento é raro, reduzir a taxa de falso positivo pode valer mais do que aumentar a sensibilidade. Um ajuste do prior escolhido depois de ver o resultado, até obter a conclusão desejada, compromete a análise; a alternativa honesta é registrar a escolha antes ou apresentar a sensibilidade de forma transparente, como neste mapa.
13. Bayes não corrige um modelo mal especificado
Bayes garante coerência dadas as entradas e as hipóteses. Não garante que elas correspondam ao mundo. O resultado pode falhar se o prior não representa a população atual; se a likelihood veio de uma amostra enviesada; se sensibilidade e falso positivo mudaram em produção; se evidências correlacionadas foram tratadas como independentes; se classes relevantes foram omitidas do denominador; se o dado foi selecionado depois de observar o resultado; ou se o score do sistema não está calibrado.
O primeiro caso é comum em aprendizado de máquina: o modelo é treinado com uma proporção de classes e usado em outra. Saerens, Latinne e Decaestecker (2002) descrevem exatamente essa situação: quando o conjunto de treino não reflete as probabilidades a priori reais das classes, as estimativas de posterior do classificador deixam de valer para os dados reais, e as saídas podem ser reajustadas para as novas priors sem retreinar o modelo. Se só a prevalência mudou e as likelihoods por classe continuam as mesmas, o ajuste é a forma em odds da seção 7 aplicada duas vezes (dedução direta, não uma fórmula do paper):
$$O_{\text{prod}}(H\mid D)=O_{\text{treino}}(H\mid D)\cdot\frac{O_{\text{prod}}(H)}{O_{\text{treino}}(H)}.$$
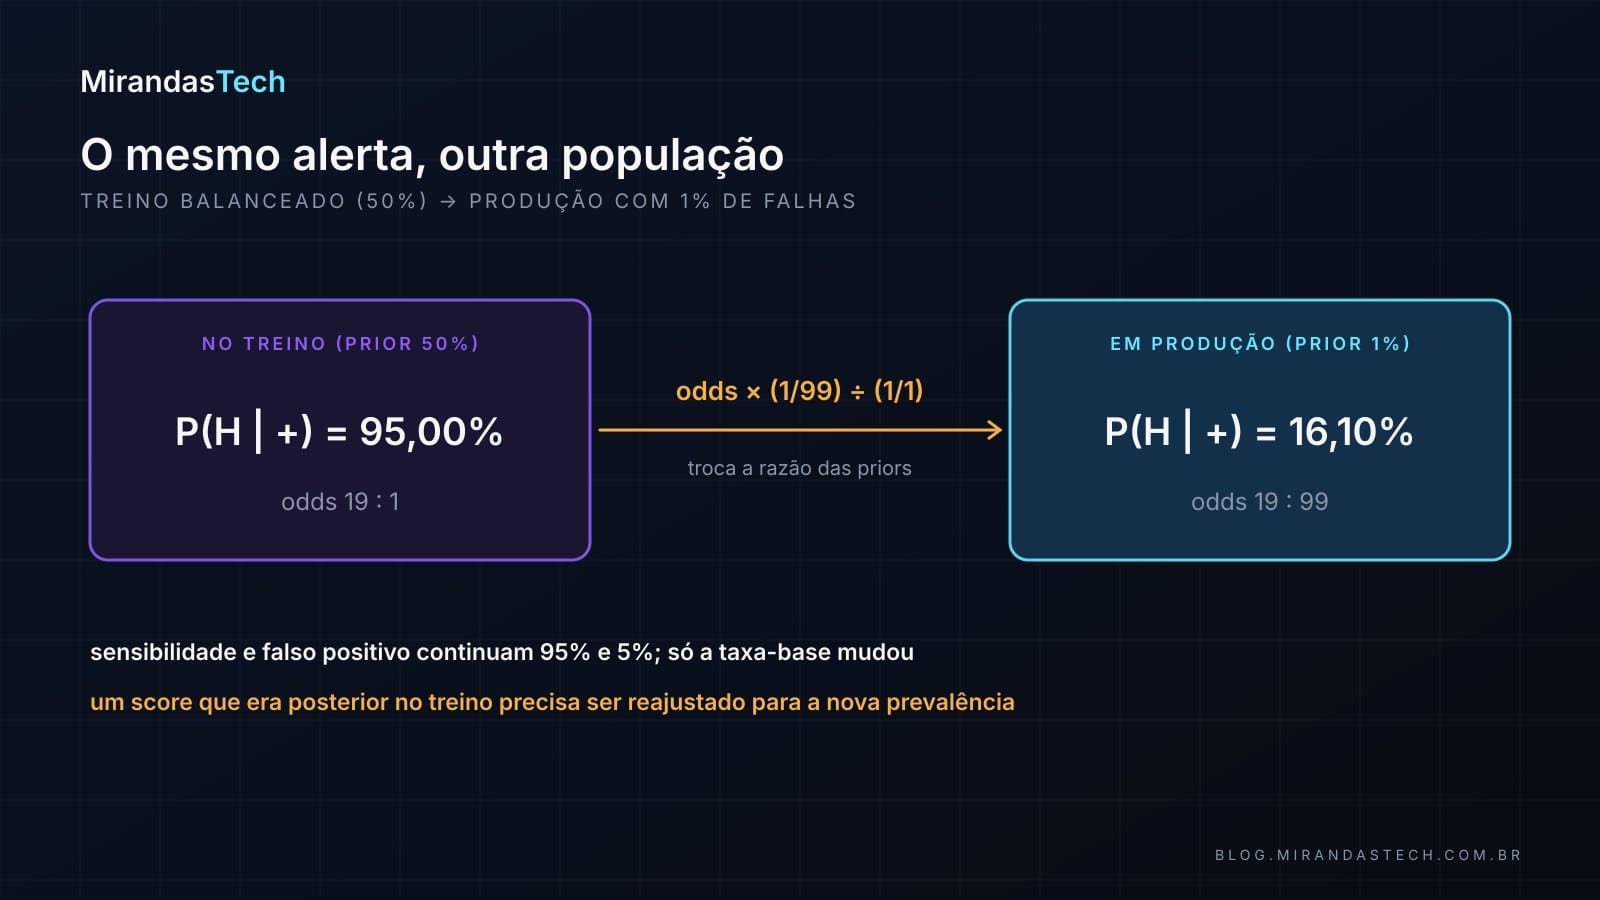
No exemplo do alerta: num conjunto de validação balanceado, com metade dos itens com falha, o posterior após um alerta é 95% (odds 19 para 1). Em produção, com 1% de falhas, as odds anteriores passam de 1 para 1/99, e as posteriores, de 19 para 19/99, ou seja, 16,10%. É a mesma linha 50% e 1% da análise de sensibilidade, agora lida como deriva de prevalência entre treino e uso. Saerens et al. (2002) propõem ainda um procedimento iterativo, uma instância do algoritmo EM, para estimar as novas priors quando elas não são conhecidas.
14. Onde Bayes aparece em IA
Quase toda avaliação de sistema de IA tem um Teorema de Bayes escondido. Cinco lugares concretos:
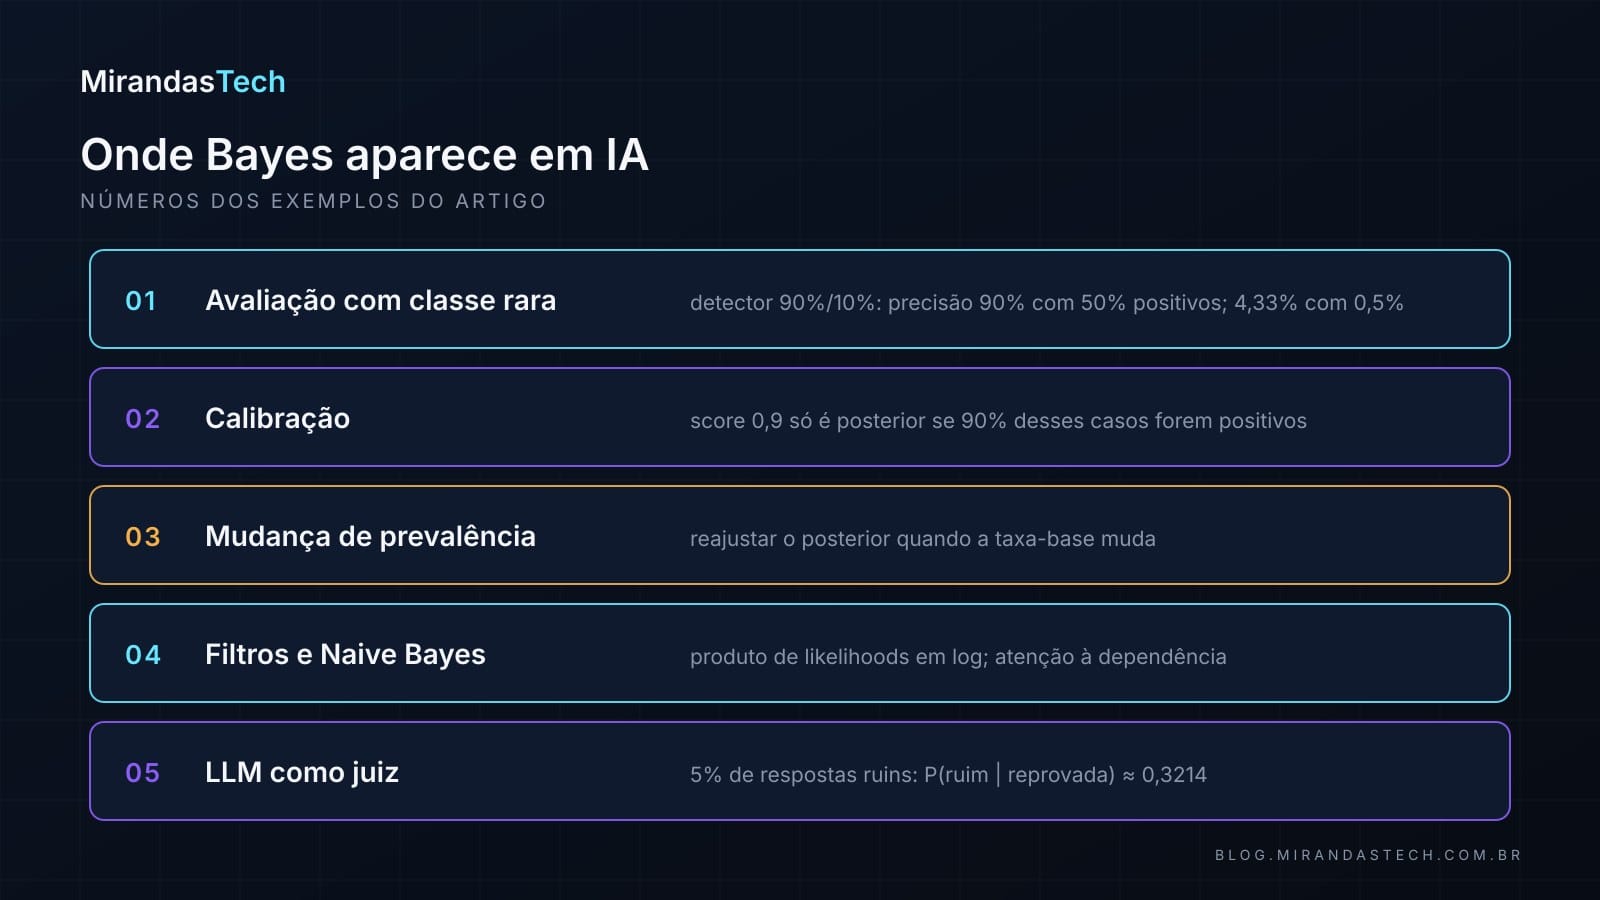
- Avaliação com classe rara. Precisão é $P(H\mid +)$ e recall é a sensibilidade $P(+\mid H)$. Um detector com sensibilidade de 90% e falso positivo de 10% tem precisão de 90% num conjunto de teste com metade de positivos e de apenas 4,33% numa população com 0,5% de positivos, sem que nada no detector tenha mudado. Saito e Rehmsmeier (2015) mostraram que, em dados fortemente desbalanceados, o gráfico ROC, construído com sensibilidade e especificidade, pode levar a conclusões enganosas sobre a confiabilidade do classificador, enquanto a curva precisão-recall avalia diretamente a fração de verdadeiros positivos entre as previsões positivas. Fraude, intrusão, defeito e doença rara são todos problemas dessa forma.
- Calibração. Um score só pode ser lido como posterior se for calibrado: entre os casos com score 0,9, cerca de 90% devem ser positivos. Guo et al. (2017) definem calibração como estimativas de probabilidade que representam a probabilidade real de acerto, mostram que redes neurais modernas, ao contrário das de uma década antes, são mal calibradas, e encontram no temperature scaling, uma variante de um parâmetro do Platt scaling, uma correção surpreendentemente eficaz na maioria dos conjuntos de dados. Niculescu-Mizil e Caruana (2005) comparam como diferentes algoritmos distorcem as probabilidades e como Platt scaling e regressão isotônica corrigem essas distorções. Ranking e calibração são propriedades diferentes: um modelo pode ordenar muito bem e ainda assim errar o tamanho das probabilidades.
- Mudança de prevalência. É a seção 13: o posterior estimado no treino precisa ser reajustado quando a proporção de classes muda em produção (Saerens et al., 2002).
- Filtros de spam e Naive Bayes. É a seção 11: o posterior de uma mensagem é prior vezes o produto das likelihoods das palavras, normalizado, calculado em logaritmo. A hipótese de independência condicional, discutida na Aula 03, é o que torna o produto possível e também o que o deixa confiante demais.
- LLM como juiz. Usar um modelo de linguagem forte para avaliar respostas de outro é uma forma escalável de aproximar preferências humanas: Zheng et al. (2023) mostraram que juízes como o GPT-4 alcançam mais de 80% de concordância com preferências humanas, o mesmo nível de concordância entre humanos, e também documentaram vieses de posição, de verbosidade e de autofavorecimento. Do ponto de vista de Bayes, um juiz é um teste diagnóstico com sensibilidade e falso positivo próprios, e as mesmas perguntas valem.
Um exemplo sintético para o último item. Suponha que 5% das respostas de um assistente sejam ruins, que o juiz reprove 90% das ruins (sensibilidade) e 10% das boas (falso positivo). A probabilidade de uma resposta reprovada ser de fato ruim é
$$\begin{aligned}&P(\text{ruim}\mid\text{reprovada})\\&=\frac{0{,}90\cdot0{,}05}{0{,}90\cdot0{,}05+0{,}10\cdot0{,}95}\\&=\frac{0{,}045}{0{,}14}\approx0{,}3214.\end{aligned}$$
Cerca de duas em cada três reprovações seriam alarmes falsos. E a taxa de reprovação observada, 14%, quase triplica a proporção real de respostas ruins. Como a taxa observada é $q=\text{sens}\cdot\pi+\text{fp}\cdot(1-\pi)$, pela probabilidade total, dá para resolver para a prevalência real $\pi$:
$$\pi=\frac{q-\text{fp}}{\text{sens}-\text{fp}}=\frac{0{,}14-0{,}10}{0{,}90-0{,}10}=0{,}05.$$
Essa correção é antiga na epidemiologia: Rogan e Gladen (1978) mostraram que a frequência de testes positivos é uma má estimativa da prevalência e deram os ajustes necessários. Ela só funciona se a sensibilidade e o falso positivo do juiz tiverem sido medidos numa amostra rotulada por humanos, representativa do que está sendo avaliado, e se $\text{sens}>\text{fp}$. Com $q$ estimado numa amostra, a conta pode sair de $[0,1]$, por exemplo quando $q\lt\text{fp}$; nesse caso, trunca-se o resultado no intervalo. E vale o aviso da seção 8: dois juízes do mesmo modelo, com o mesmo prompt, sobre a mesma resposta, não são duas evidências independentes.
15. Na prática em Python
O laboratório da aula, que abre no Google Colab, implementa Bayes binário com validações, reconstrói a tabela de 10 000 itens, simula o mecanismo, atualiza odds sequencialmente, normaliza várias hipóteses e desenha os mapas de sensibilidade. O primeiro trecho abaixo resolve o exemplo pelos quatro caminhos do artigo: fórmula, contagem, odds e várias hipóteses. A função recusa entradas impossíveis em vez de devolver um número sem sentido.
def bayes_binario(prior, sensibilidade, taxa_falso_positivo):
    valores = (prior, sensibilidade, taxa_falso_positivo)
    if not all(0 <= x <= 1 for x in valores):
        raise ValueError("Todas as probabilidades devem estar em [0, 1].")
    evidencia = sensibilidade * prior + taxa_falso_positivo * (1 - prior)
    if evidencia == 0:
        raise ZeroDivisionError("A evidência observada tem probabilidade zero.")
    return sensibilidade * prior / evidencia

# 1) fórmula
posterior = bayes_binario(0.01, 0.95, 0.05)
print(f"P(H|+) pela fórmula      = {posterior:.4f}")

# 2) frequências naturais em 10 000 itens
n_h = 10_000 * 1 // 100              # 100 itens com falha
vp = n_h * 95 // 100                 # 95 verdadeiros positivos
fp = (10_000 - n_h) * 5 // 100       # 495 falsos positivos
print(f"P(H|+) por contagem      = {vp}/{vp + fp} = {vp / (vp + fp):.4f}")

# 3) odds: dois alertas condicionalmente independentes
odds = 0.01 / 0.99
for i in (1, 2):
    odds *= 0.95 / 0.05              # LR+ = 19
    print(f"após {i} alerta(s): odds = {odds:.4f}, P = {odds / (1 + odds):.4f}")

# 4) três hipóteses: normalizar os scores
priors = {"Sensor": 0.50, "Rede": 0.30, "Aplicação": 0.20}
likes = {"Sensor": 0.10, "Rede": 0.40, "Aplicação": 0.70}
scores = {h: priors[h] * likes[h] for h in priors}
Z = sum(scores.values())
for h, s in scores.items():
    print(f"{h:10} score = {s:.3f}  posterior = {s / Z:.4f}")
print("MAP:", max(scores, key=scores.get))

assert abs(posterior - 95 / 590) < 1e-12 and (vp, fp) == (95, 495)
Saída:
P(H|+) pela fórmula      = 0.1610
P(H|+) por contagem      = 95/590 = 0.1610
após 1 alerta(s): odds = 0.1919, P = 0.1610
após 2 alerta(s): odds = 3.6465, P = 0.7848
Sensor     score = 0.050  posterior = 0.1613
Rede       score = 0.120  posterior = 0.3871
Aplicação  score = 0.140  posterior = 0.4516
MAP: Aplicação
Os quatro caminhos concordam: 0,1610 pela fórmula e pela contagem, 0,1610 após um alerta e 0,7848 após dois em odds, e os posteriors das três hipóteses da seção 9. O segundo trecho faz duas coisas. Primeiro simula o mecanismo com seed fixa, sorteando o estado real antes do alerta, como o notebook faz. Depois mostra o underflow da seção 11 com 400 atributos e o resolve em logaritmo.
import numpy as np

# Simulação do mecanismo: primeiro o estado real, depois o alerta
rng = np.random.default_rng(42)
n = 500_000
h = rng.random(n) < 0.01                        # tem a falha?
alerta = rng.random(n) < np.where(h, 0.95, 0.05)
print(f"P(H|+) simulado = {(h & alerta).sum() / alerta.sum():.4f}  (teórico 0.1610)")

# 400 atributos: P(x_j|spam) = 0,0100 e P(x_j|legítima) = 0,0099
prior = np.array([0.20, 0.80])
lik = np.array([0.0100, 0.0099])
print("produtos diretos:", prior * lik ** 400)  # underflow: os dois viram 0.0
log_s = np.log(prior) + 400 * np.log(lik)       # some logaritmos
post = np.exp(log_s - log_s.max())              # log-sum-exp: subtrai o máximo
post /= post.sum()
print("log-scores:", np.round(log_s, 2), " posteriors:", np.round(post, 4))
Saída:
P(H|+) simulado = 0.1633  (teórico 0.1610)
produtos diretos: [0. 0.]
log-scores: [-1843.68 -1846.31]  posteriors: [0.933 0.067]
A estimativa simulada, 0,1633, fica a 0,0023 do valor teórico, dentro da tolerância de 0,005 que o notebook declara antes de rodar; é o mesmo valor que o notebook imprime com a seed 42. No segundo bloco, os dois produtos diretos viram 0,0, e o posterior se perde. Em logaritmo, os scores são −1843,68 e −1846,31, e a normalização com o máximo subtraído recupera o posterior de 0,933 para spam. A seed fixa reproduz esta simulação na versão usada (Python 3.13.3, NumPy 2.2.3), mas não é evidência sobre fenômeno nenhum: os dados são sintéticos.
16. Erros comuns
- Falácia da probabilidade inversa. Confundir $P(D\mid H)$ com $P(H\mid D)$. Escreva as duas em palavras e identifique o denominador.
- Ignorar a taxa-base. Usar só a sensibilidade ou a likelihood descarta a prevalência da hipótese.
- Esquecer hipóteses alternativas. O denominador precisa contar todas as rotas relevantes até a evidência; uma classe omitida distorce a normalização.
- Contar a mesma evidência duas vezes. Relatórios derivados da mesma fonte podem ser redundantes. Multiplicar LRs em sequência requer a fatoração condicional declarada.
- Interpretar o posterior como frequência universal. Ele vale para o modelo, o prior, a evidência e a população especificados. Mudar o contexto muda a resposta.
- Confundir MAP com certeza. A hipótese MAP é só a mais provável entre as consideradas. Pode ter posterior baixo e pode não determinar a melhor ação.
- Escolher o prior depois de ver o resultado. Registre a escolha antes ou apresente a análise de sensibilidade.
Antes de aceitar uma atualização bayesiana, confira: as hipóteses são mutuamente exclusivas e cobrem os casos relevantes; prior, likelihood, evidence e posterior estão escritos em palavras; o prior está justificado para a população relevante; as alternativas estão no denominador; a dependência entre evidências foi verificada; não há probabilidades exatamente 0 ou 1 sem justificativa estrutural; a análise de sensibilidade foi feita; a hipótese mais provável foi separada da ação de menor custo; e dados, período, versões e limitações estão documentados.
17. Exercícios
- Um evento tem prior de 2%, sensibilidade de 90% e taxa de falso positivo de 10%. Calcule $P(H\mid +)$.
- Resolva o exercício anterior com frequências naturais numa população de 10 000 itens.
- No exemplo principal, calcule $P(H\mid -)$.
- Uma hipótese tem prior 0,20. Uma evidência tem $LR=4$. Calcule as odds anteriores, as odds posteriores e a probabilidade posterior.
- Três hipóteses têm priors $(0{,}5;\,0{,}3;\,0{,}2)$ e likelihoods $(0{,}1;\,0{,}4;\,0{,}7)$. Reproduza os posteriors da seção 9.
- Por que dois alertas do mesmo modelo sobre a mesma entrada não devem ser multiplicados automaticamente como evidências independentes?
- Num Naive Bayes com duas classes, os scores não normalizados são 0,03 e 0,07. Quais são os posteriors e a classe MAP?
- Se o prior de uma hipótese for exatamente zero, o que acontece com o posterior pela fórmula usual? Qual é o risco prático?
- Um classificador tem ótimo ranking, mas seus scores de 0,9 correspondem empiricamente a apenas 60% de positivos. O score deve ser tratado como posterior calibrado? Explique.
- Cite duas mudanças de produção que podem invalidar priors ou likelihoods estimados no passado.
Respostas comentadas
- $P(H\mid +)=\dfrac{0{,}90\cdot0{,}02}{0{,}90\cdot0{,}02+0{,}10\cdot0{,}98}\approx0{,}1552$, cerca de 15,52%.
- Há 200 casos de $H$, com 180 positivos; entre 9 800 casos de $H^c$, há 980 falsos positivos. Portanto, $180/(180+980)=180/1\,160\approx15{,}52\%$.
- $P(H\mid -)=\dfrac{0{,}05\cdot0{,}01}{0{,}05\cdot0{,}01+0{,}95\cdot0{,}99}\approx0{,}000531$, ou 0,0531%. Na tabela: 5 de 9 410 itens sem alerta.
- Odds anteriores: $0{,}20/0{,}80=0{,}25$. Odds posteriores: $0{,}25\cdot4=1$. Probabilidade posterior: $1/(1+1)=0{,}50$.
- Scores $(0{,}05;\,0{,}12;\,0{,}14)$, soma 0,31; posteriors aproximados $(0{,}1613;\,0{,}3871;\,0{,}4516)$.
- Eles podem ser perfeitamente correlacionados ou compartilhar erros e dados. Multiplicar como independentes contaria duas vezes a mesma informação.
- A soma é 0,10; os posteriors são 0,30 e 0,70. A segunda classe é MAP.
- O numerador permanece zero, então o posterior é zero. Um prior dogmático impede que qualquer evidência ordinária recupere a hipótese.
- Não. Ranking e calibração são propriedades diferentes; a frequência observada indica que 0,9 não representa 90% naquele contexto.
- Exemplos: mudança de prevalência, novo perfil de usuários, sensor substituído, alteração de limiar, mudança na coleta ou concept drift.
Desafio de transferência
Escolha um alerta realista de sensor, agente, classificador ou juiz automático e documente por escrito: a hipótese $H$ e a evidência $D$; o prior e sua origem; $P(D\mid H)$ e sua origem; as hipóteses alternativas; a evidence $P(D)$ e o posterior; se as evidências podem ser dependentes; os cenários da análise de sensibilidade; a ação e os custos dos erros; e o que o posterior não prova.
O que guardar
O Teorema de Bayes sai da regra do produto escrita nas duas ordens: $P(H\mid D)=P(D\mid H)P(H)/P(D)$. O denominador é a probabilidade total, a soma de todos os caminhos até a evidência. Sensibilidade e especificidade condicionam no estado real; precisão e posterior condicionam no resultado e dependem da prevalência. Frequências naturais deixam o denominador visível. Em odds, o teorema vira uma multiplicação pela razão de verossimilhança, e várias evidências viram um produto, desde que sejam condicionalmente independentes; caso contrário, há dupla contagem. Com várias hipóteses, pontua-se e normaliza-se. O MAP é a hipótese mais provável, não necessariamente a melhor ação. E a coerência de Bayes vale para as entradas e hipóteses declaradas: prior desatualizado, falso positivo que mudou em produção e score sem calibração quebram a conclusão sem quebrar a conta.
Na Aula 05, Variáveis aleatórias, PMF, PDF e CDF, resultados numéricos passam a ser representados por variáveis aleatórias, e você aprende a distinguir massa, densidade e probabilidade acumulada. É a linguagem que permite escrever priors e likelihoods como distribuições inteiras, e não só como números soltos.
Referências
- Bertsekas, Dimitri P.; Tsitsiklis, John N. Introduction to Probability. 2. ed. Athena Scientific, 2008. Cap. 1, §1.4 “Total Probability Theorem and Bayes’ Rule” (Fig. 1.14 e exemplos 1.16 a 1.18). Capítulo 1 aberto pela editora: athenasc.com/Prob-2nd-Ch1.pdf
- Orloff, Jeremy; Bloom, Jonathan. Conditional Probability, Independence and Bayes’ Theorem (Class 3 Reading). MIT OpenCourseWare, 18.05 Introduction to Probability and Statistics, primavera de 2022. §7 e §7.1 “The Base Rate Fallacy”. ocw.mit.edu/…/mit18_05_s22_class03-prep.pdf
- Gigerenzer, Gerd; Hoffrage, Ulrich. How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704, 1995. doi.org/10.1037/0033-295x.102.4.684
- Clemen, Robert T.; Winkler, Robert L. Limits for the Precision and Value of Information from Dependent Sources. Operations Research, 33(2), 427–442, 1985. doi.org/10.1287/opre.33.2.427
- Domingos, Pedro; Pazzani, Michael. On the Optimality of the Simple Bayesian Classifier under Zero-One Loss. Machine Learning, 29(2–3), 103–130, 1997. doi.org/10.1023/a:1007413511361
- Niculescu-Mizil, Alexandru; Caruana, Rich. Predicting good probabilities with supervised learning. Proceedings of the 22nd International Conference on Machine Learning (ICML ’05), 625–632, 2005. doi.org/10.1145/1102351.1102430
- Guo, Chuan; Pleiss, Geoff; Sun, Yu; Weinberger, Kilian Q. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning, PMLR 70, 1321–1330, 2017. proceedings.mlr.press/v70/guo17a.html (versão aberta: arXiv:1706.04599)
- Saito, Takaya; Rehmsmeier, Marc. The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLOS ONE, 10(3), e0118432, 2015. doi.org/10.1371/journal.pone.0118432
- Saerens, Marco; Latinne, Patrice; Decaestecker, Christine. Adjusting the Outputs of a Classifier to New a Priori Probabilities: A Simple Procedure. Neural Computation, 14(1), 21–41, 2002. doi.org/10.1162/089976602753284446
- Rogan, Walter J.; Gladen, Beth. Estimating prevalence from the results of a screening test. American Journal of Epidemiology, 107(1), 71–76, 1978. doi.org/10.1093/oxfordjournals.aje.a112510
- Zheng, Lianmin; Chiang, Wei-Lin; Sheng, Ying et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems 36 (NeurIPS 2023), Datasets and Benchmarks Track, 2023. proceedings.neurips.cc/…/91f18a12…-Abstract-Datasets_and_Benchmarks.html (versão aberta: arXiv:2306.05685)
- scikit-learn. 1.9. Naive Bayes. User Guide, acesso em 9 out. 2026. scikit-learn.org/stable/modules/naive_bayes.html
- NumPy. Random Generator (
default_rng,Generator.random). Documentação oficial, acesso em 9 out. 2026. numpy.org/doc/stable/reference/random/generator.html
Esta aula faz parte do AI Lab, o laboratório aberto de estudo da MirandasTech. Código, notebooks e exercícios: 02-statistics/aulas/04-bayes.md.