
Como uma IA escolhe uma ferramenta? A semântica escondida nos MCP Tools
Como descrições, schemas e contexto influenciam a escolha de ferramentas por agentes de IA — e o que estudos recentes revelam sobre MCP Tools, recuperação semântica e custo de raciocínio.

Série MCP — Parte 2
O Model Context Protocol (MCP) padroniza a forma pela qual aplicações baseadas em modelos de linguagem descobrem e invocam ferramentas externas. Entretanto, o protocolo não determina o algoritmo cognitivo utilizado pelo modelo para decidir qual ferramenta utilizar, quando utilizá-la ou quais argumentos fornecer. Para tomar essa decisão, o modelo recebe uma representação da ferramenta composta, entre outros elementos, por nome, descrição em linguagem natural e schemas de entrada e saída.
Consequentemente, a qualidade semântica dessa representação passa a interferir diretamente no comportamento do agente. Um estudo empírico de 2026 analisou 856 ferramentas distribuídas em 103 servidores MCP e constatou que 97,1% das descrições apresentavam ao menos um problema de qualidade. Em uma avaliação posterior baseada no MCP-Universe, descrições enriquecidas elevaram a taxa mediana de sucesso em 5,85 pontos percentuais, mas também aumentaram em 67,46% o número mediano de etapas executadas. Esses resultados mostram que a descrição de uma ferramenta funciona simultaneamente como documentação, especificação e instrução para o modelo (HASAN et al., 2026).
A descrição textual de uma MCP Tool não é mera documentação. Ela participa do caminho de decisão do agente.
1. O problema escondido atrás de uma simples Tool
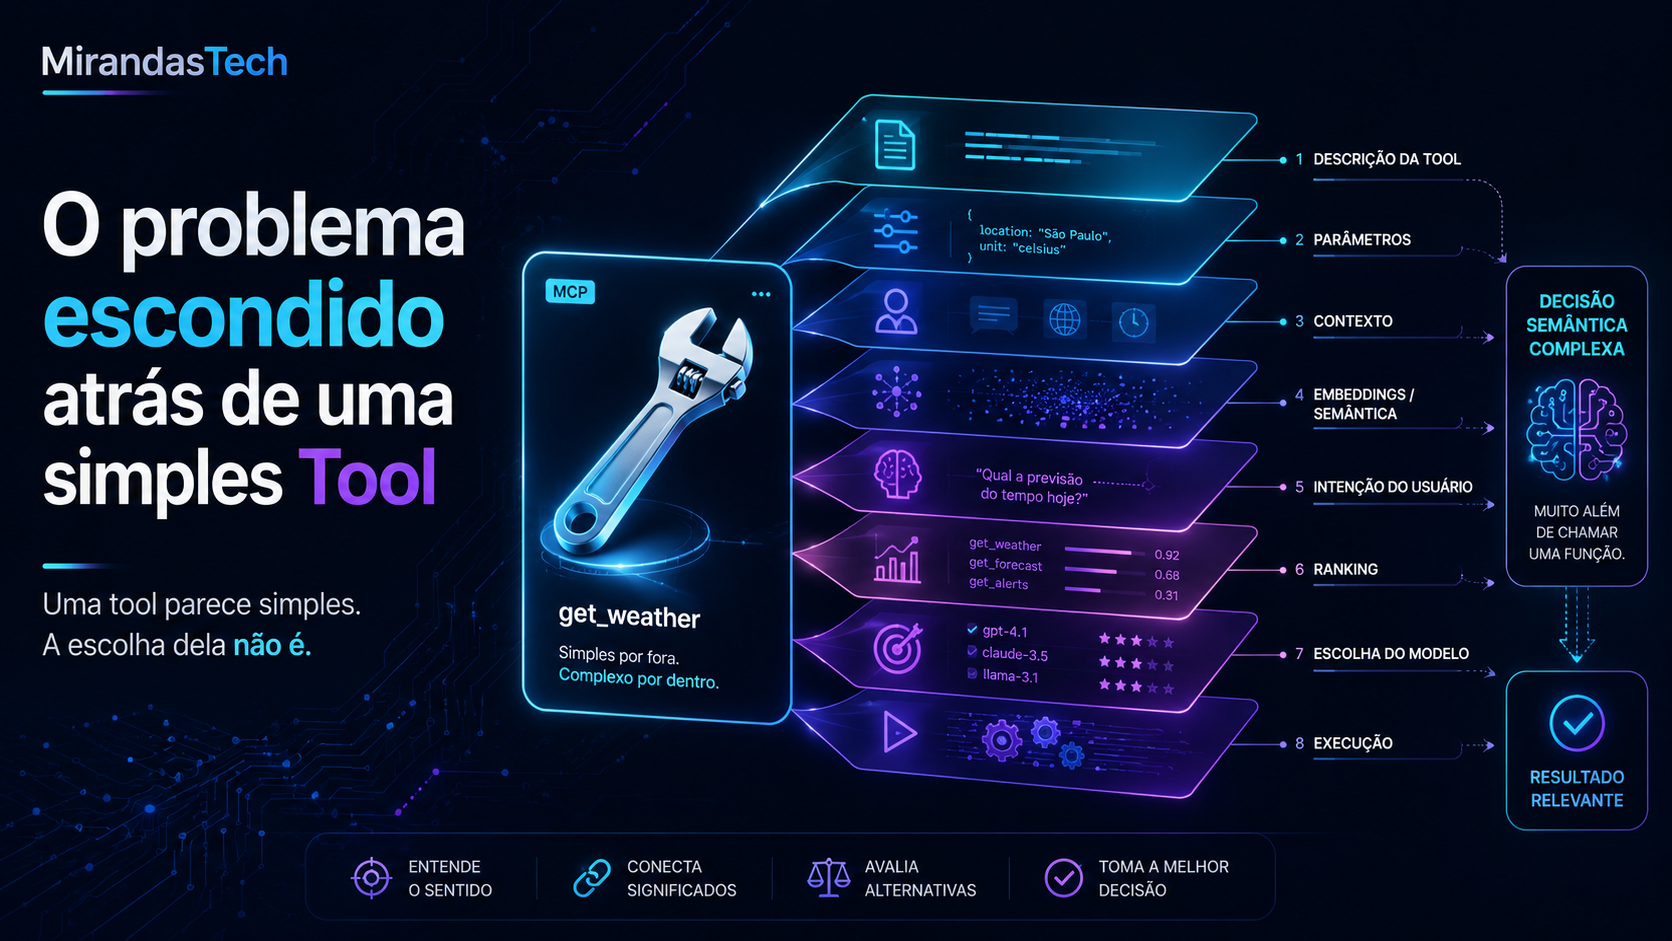
Imagine um agente de inteligência artificial conectado a dezenas de ferramentas:
search_web
search_documents
query_database
get_company
get_financial_statement
get_historical_stock_prices
find_file
read_file
create_issue
update_issue
O usuário não diz:
“Execute a funçãoget_historical_stock_pricescomticker=PETR4.”
Ele diz algo como:
“Quero entender como as ações da empresa se comportaram no mês anterior à divulgação do último balanço.”
O agente precisa transformar uma intenção expressa em linguagem natural em uma sequência de decisões: é necessário utilizar uma ferramenta? Qual ferramenta é relevante? Uma única ferramenta é suficiente? Quais argumentos devem ser utilizados? Em qual ordem as ferramentas devem ser executadas? O resultado é suficiente ou uma nova chamada é necessária?
Nada disso é resolvido simplesmente pelo fato de a ferramenta estar conectada por MCP. O MCP fornece o protocolo de interação. A decisão sobre como utilizar as capacidades expostas continua sendo responsabilidade da aplicação e, frequentemente, do próprio modelo. A especificação caracteriza Tools como capacidades controladas pelo modelo e estabelece que uma ferramenta pode possuir name, description, inputSchema, outputSchema e outras informações auxiliares. A própria especificação reconhece que a descrição pode ajudar o LLM a compreender as ferramentas disponíveis (MODEL CONTEXT PROTOCOL, 2026a).
Para o modelo, uma ferramenta não é inicialmente o seu código. É uma representação da ferramenta colocada em seu contexto.
[FIGURA SUGERIDA 1 — O que o modelo realmente enxerga?]
Ferramenta real → camada MCP →name + description + schema→ contexto do LLM → decisão. A imagem deve contrastar a implementação real — API, banco de dados e código — com a representação semântica que chega ao modelo.
2. O MCP conecta ferramentas. Mas quem escolhe a ferramenta?
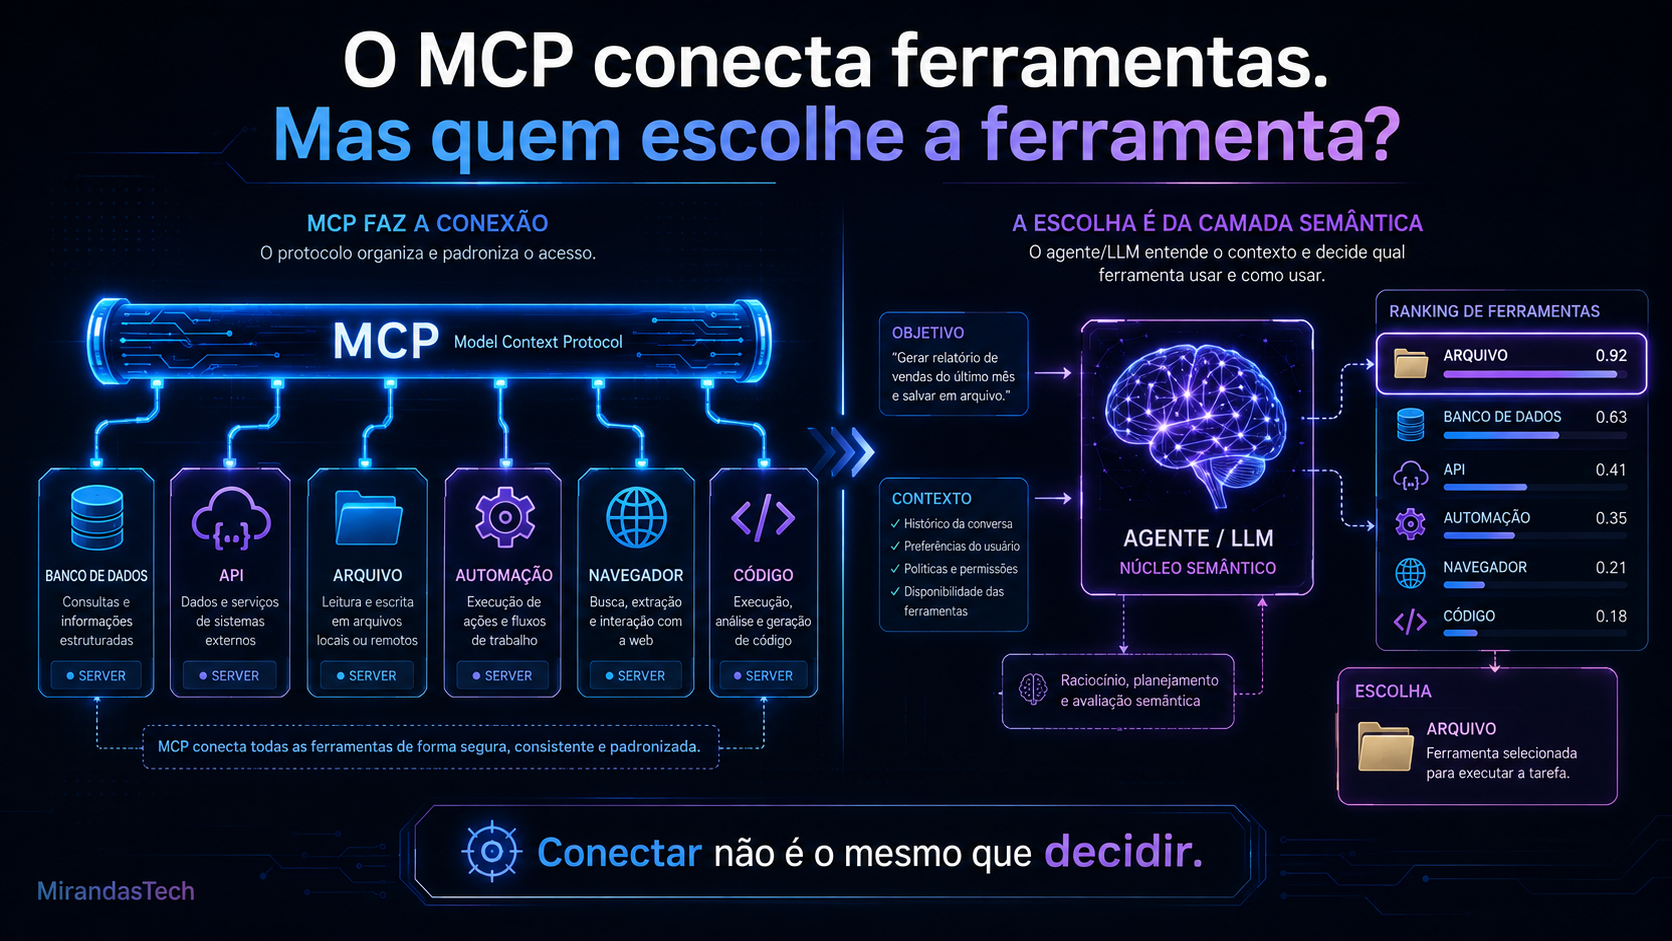
O MCP especifica mecanismos para exposição, descoberta e invocação de Tools, mas não define algo como:
if semantic_similarity > 0.82:
    execute(tool_x)
Nem existe no protocolo uma função universal chamada:
choose_best_tool(user_prompt)A escolha pode ser realizada diretamente pelo LLM, por um mecanismo de recuperação anterior ao modelo, por um router, por regras da aplicação ou pela combinação dessas estratégias. O protocolo define o que pode ser disponibilizado ao agente; não padroniza o mecanismo interno de raciocínio empregado para escolher entre essas possibilidades (MODEL CONTEXT PROTOCOL, 2026a; HASAN et al., 2026).
No fluxo estudado por Hasan et al. (2026), a interação pode ser resumida em quatro etapas: o cliente obtém os metadados das ferramentas; esses metadados são apresentados ao modelo junto com a solicitação do usuário; o modelo planeja uma solução e formula uma chamada; por fim, a ferramenta é executada e seu resultado retorna ao contexto para geração da resposta ou continuidade do raciocínio.
Usuário
  ↓
Contexto + metadados das Tools
  ↓
LLM / Planner
  ↓
Usar ferramenta?
  ├─ não → responder
  └─ sim → selecionar Tool
             ↓
         gerar argumentos
             ↓
          executar
             ↓
           resultado
             ↓
      atualizar contexto
             ↺
Uma ferramenta pode produzir informações que alteram o contexto e levam o modelo a escolher uma segunda ferramenta. Portanto, tool selection não é necessariamente uma única decisão: em sistemas agentivos, ela pode fazer parte de um processo iterativo de planejamento, execução, observação e replanejamento. Benchmarks contemporâneos de MCP foram desenvolvidos justamente porque tarefas reais frequentemente exigem múltiplas etapas e ferramentas (LUO et al., 2025; BANDI et al., 2026).
3. Uma formalização simples da decisão
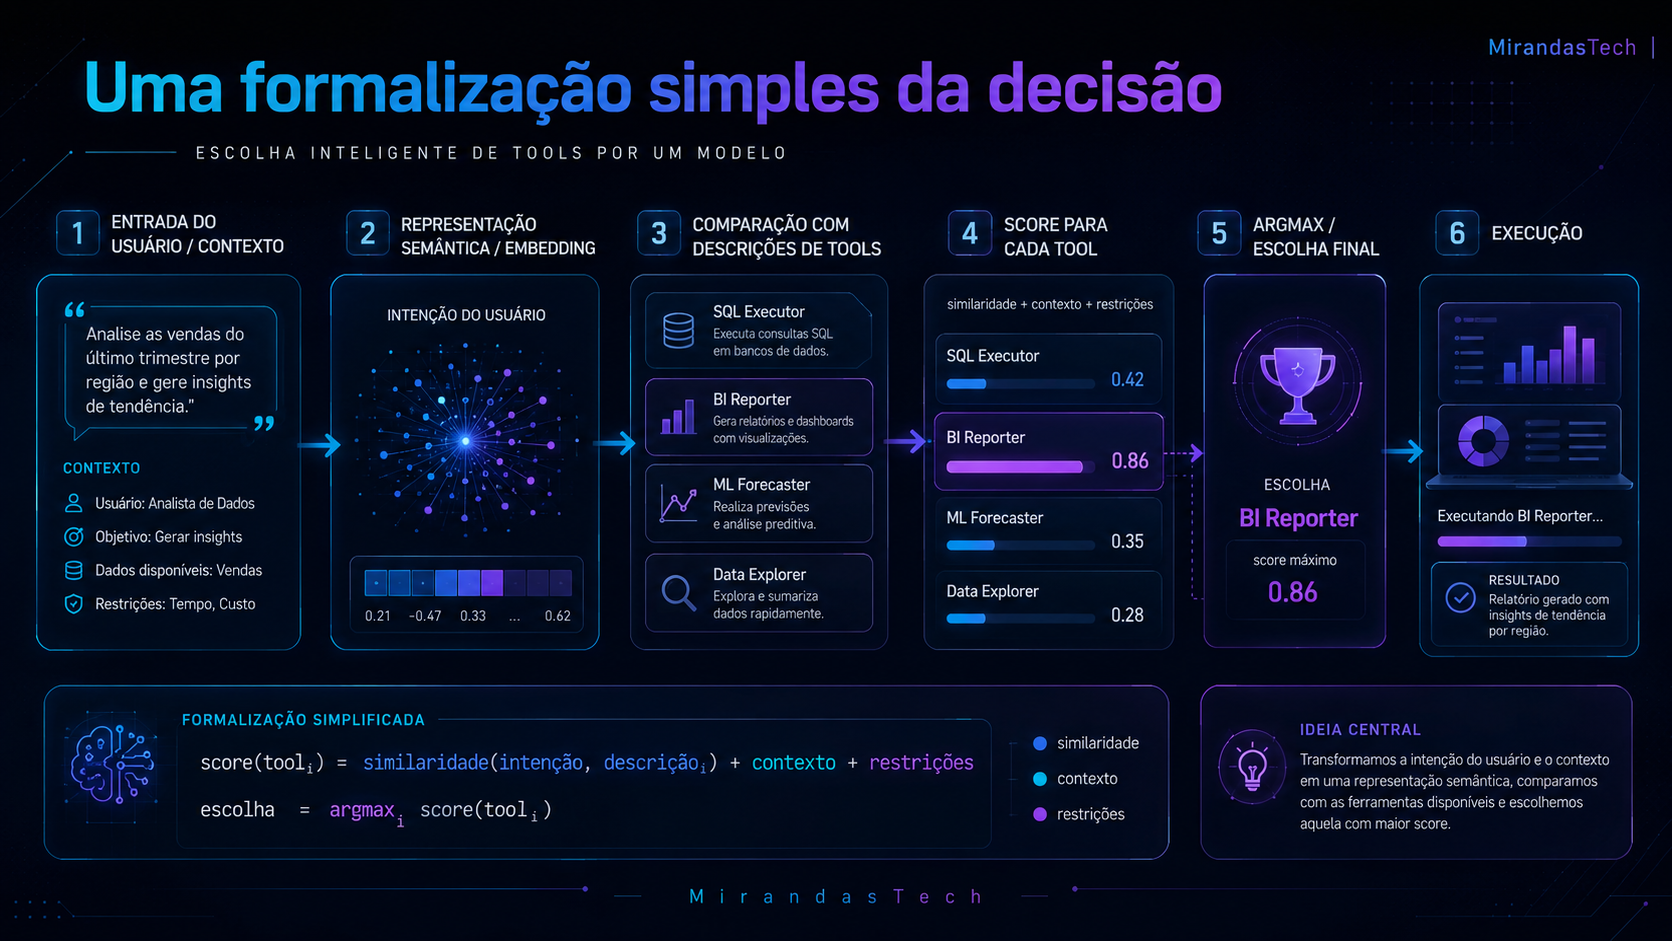
Podemos representar uma ferramenta Tᵢ por seus metadados:
Mᵢ = {nᵢ, dᵢ, sᵢ, oᵢ, aᵢ}onde nᵢ é o nome da ferramenta, dᵢ sua descrição textual, sᵢ o schema de entrada, oᵢ o schema de saída e aᵢ anotações e outros metadados.
Considere ainda:
q = solicitação do usuário
C = contexto disponível ao modelo
Uma representação didática da escolha poderia ser:
T̂ = fθ(q, C, M₁, M₂, ..., Mₖ)ou, em termos probabilísticos:
T̂ = argmax Pθ(Tᵢ | q, C, M₁, ..., Mₖ)Depois de selecionar a ferramenta, existe outro problema:
 = argmax Pθ(A | T̂, q, C, sT̂)em que A representa os argumentos da chamada.
Essas equações são uma abstração didática, não um algoritmo prescrito pelo MCP. Elas ajudam, contudo, a mostrar algo essencial: mudar a descrição, o schema, o contexto ou mesmo as ferramentas concorrentes pode alterar a distribuição de decisão do modelo.
Mesma pergunta + representação diferente da Tool → comportamento potencialmente diferente.
4. Tool description: documentação ou prompt?
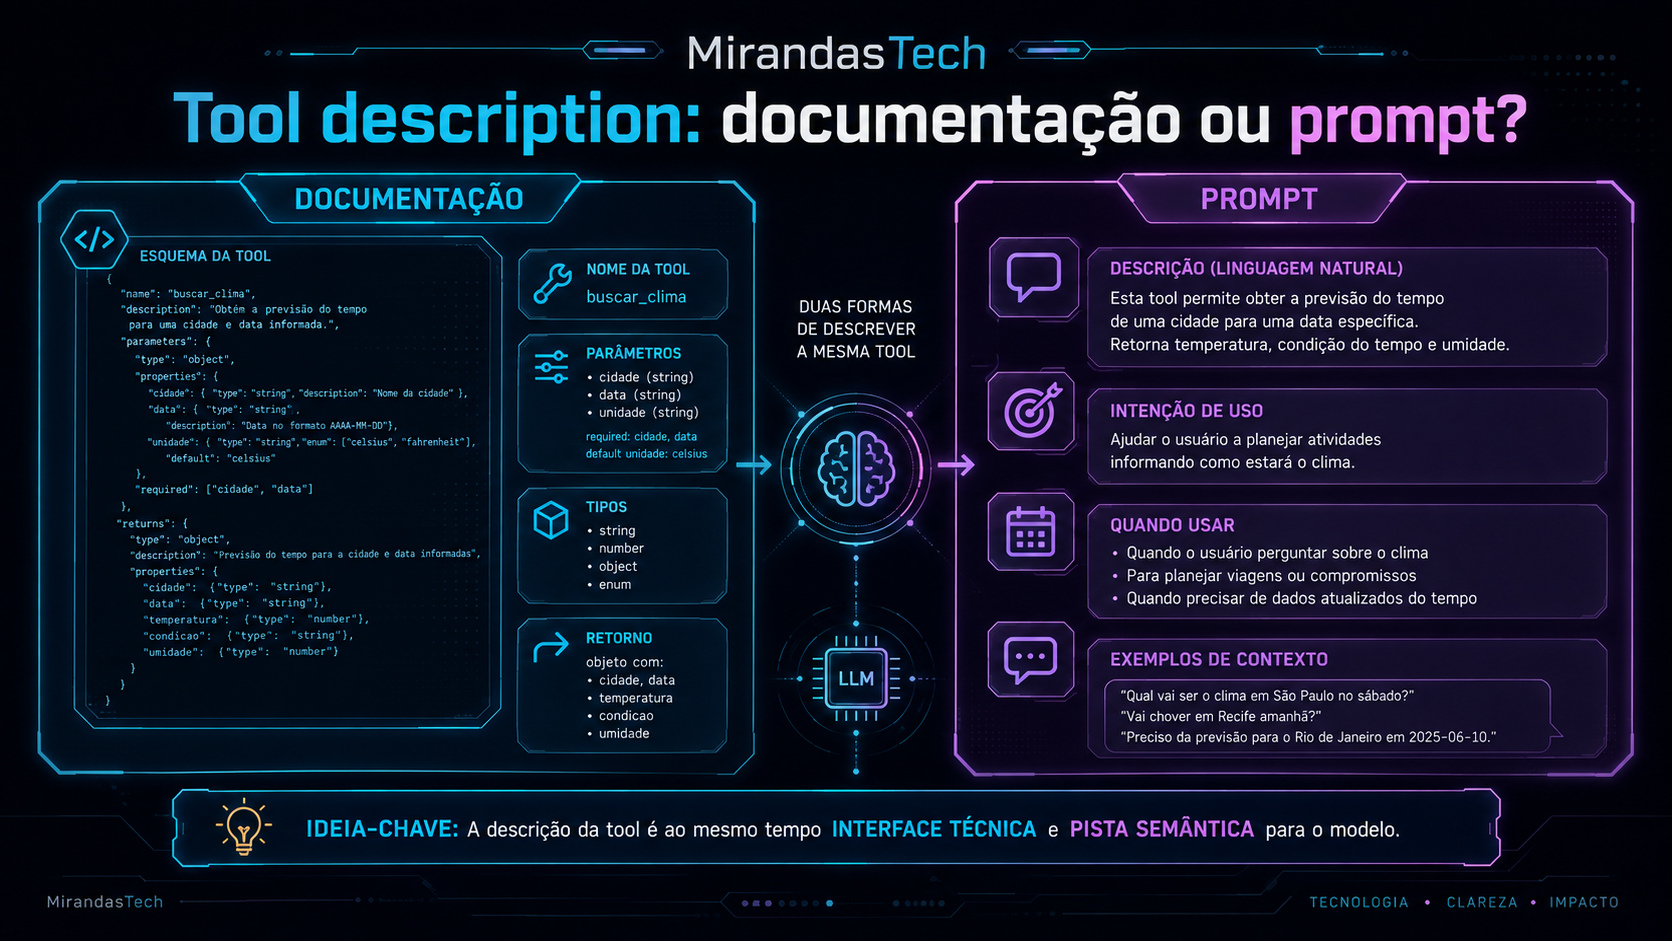
Aqui aparece uma característica incomum dos sistemas agentivos. Em software tradicional, uma descrição como “obtém o histórico de preços de uma ação” parece documentação. O programa que chama a função não precisa compreender essa frase: o código simplesmente executa a função correspondente.
Para um LLM, a situação é diferente. A descrição pode fazer parte da informação que o modelo utiliza para determinar se aquela função corresponde à intenção do usuário.
Hasan et al. (2026) propõem uma interpretação particularmente interessante. Os autores observam que os componentes de uma Tool Description desempenham dois papéis simultâneos. Alguns se comportam como uma especificação de requisitos, descrevendo o que a ferramenta faz, seus parâmetros e limitações. Outros funcionam como instruções semelhantes a prompts, influenciando a maneira pela qual o modelo interpreta e utiliza aquela ferramenta.
Tool Description = Specification + PromptEssa dualidade ajuda a explicar por que pequenas modificações textuais podem produzir mudanças operacionais. A descrição deixou de ser apenas texto destinado ao programador. Ela entrou no caminho de decisão da máquina.
[FIGURA SUGERIDA 2 — A Tool Description tem dupla natureza]
À esquerda: Engenharia de Software → requisitos, parâmetros, restrições, contrato. À direita: Prompt/Context Engineering → orientação, contexto, pistas semânticas. Os dois lados convergem em MCP Tool Description → decisão do LLM.
5. Sintaxe, semântica e pragmática: uma analogia útil
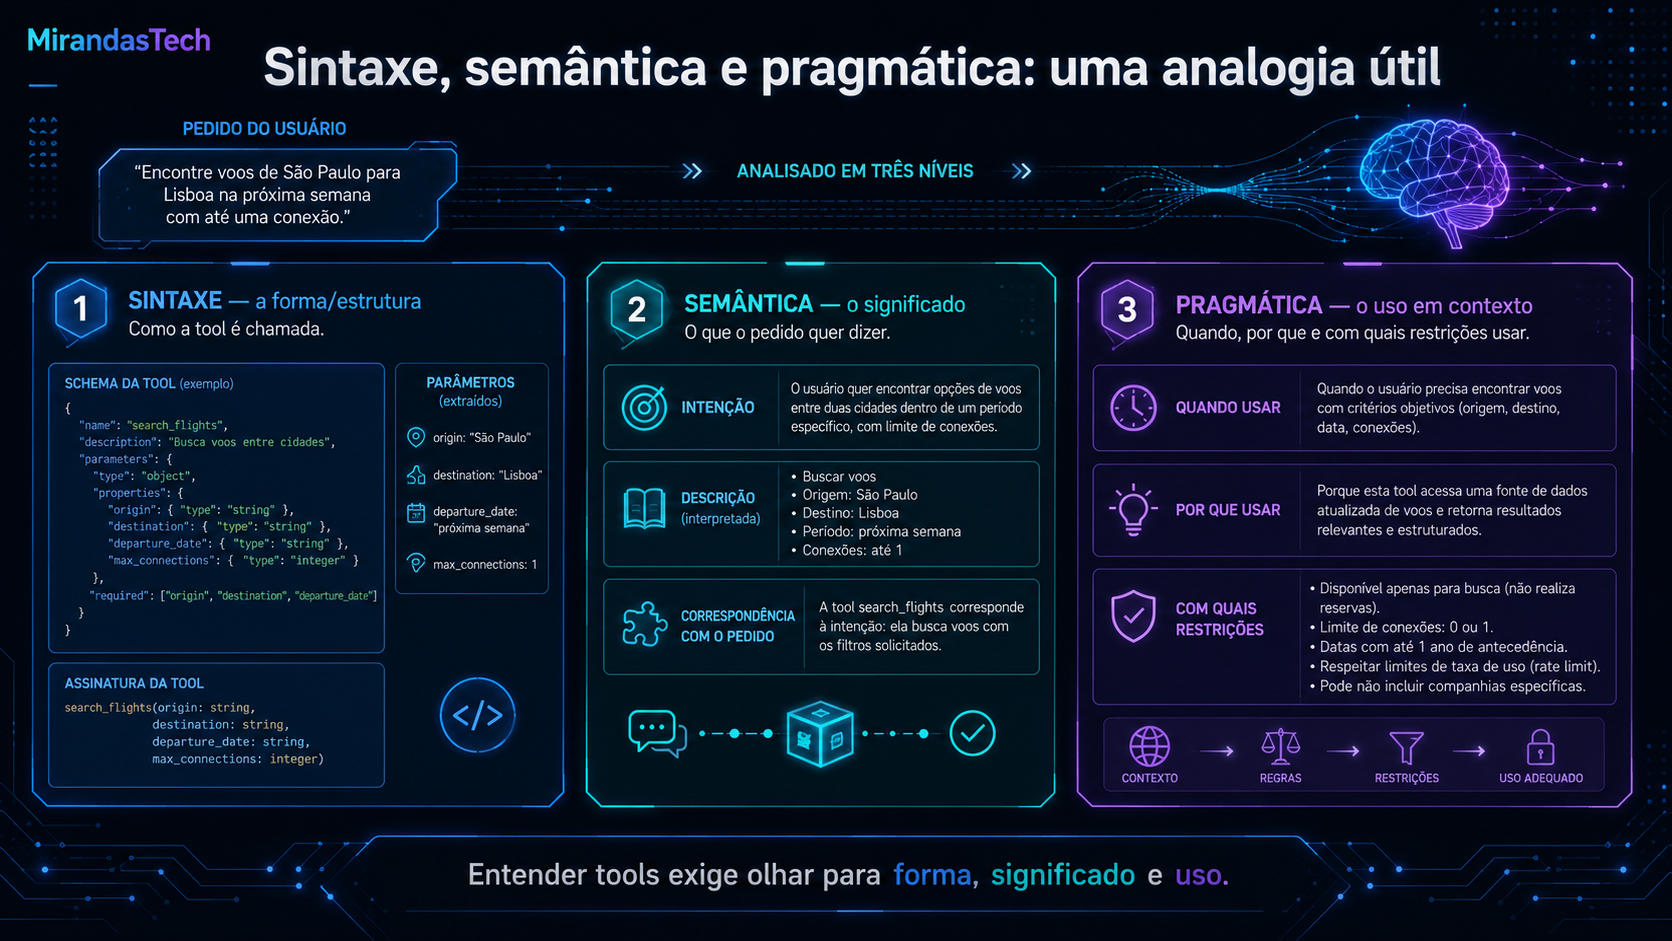
Sintaxe
Define a estrutura válida. No MCP, o inputSchema desempenha parte desse papel:
{
  "type": "object",
  "properties": {
    "ticker": {"type": "string"},
    "start_date": {"type": "string"},
    "end_date": {"type": "string"}
  },
  "required": ["ticker", "start_date", "end_date"]
}
O schema informa que existem três parâmetros e que eles são strings.
Semântica
Responde: o que esses parâmetros significam?
ticker:
símbolo negociado da empresa.

start_date:
primeiro dia do intervalo no formato YYYY-MM-DD.

end_date:
último dia do intervalo no formato YYYY-MM-DD.
Pragmática
Responde: em que situação essa ferramenta deve ser usada?
Use esta ferramenta quando a pergunta exigir
uma série histórica de preços.

Não a utilize para demonstrações financeiras,
receita, lucro ou fluxo de caixa.
O modelo necessita das três dimensões. O schema pode dizer que start_date é uma string, mas não necessariamente informa ao modelo qual intervalo é adequado ao objetivo do usuário. A descrição pode dizer o que a ferramenta faz, mas sem um schema apropriado o modelo pode não conseguir produzir argumentos válidos. E ambos podem ser insuficientes quando outra ferramenta semanticamente parecida está disponível.
6. Schema correto não significa intenção correta
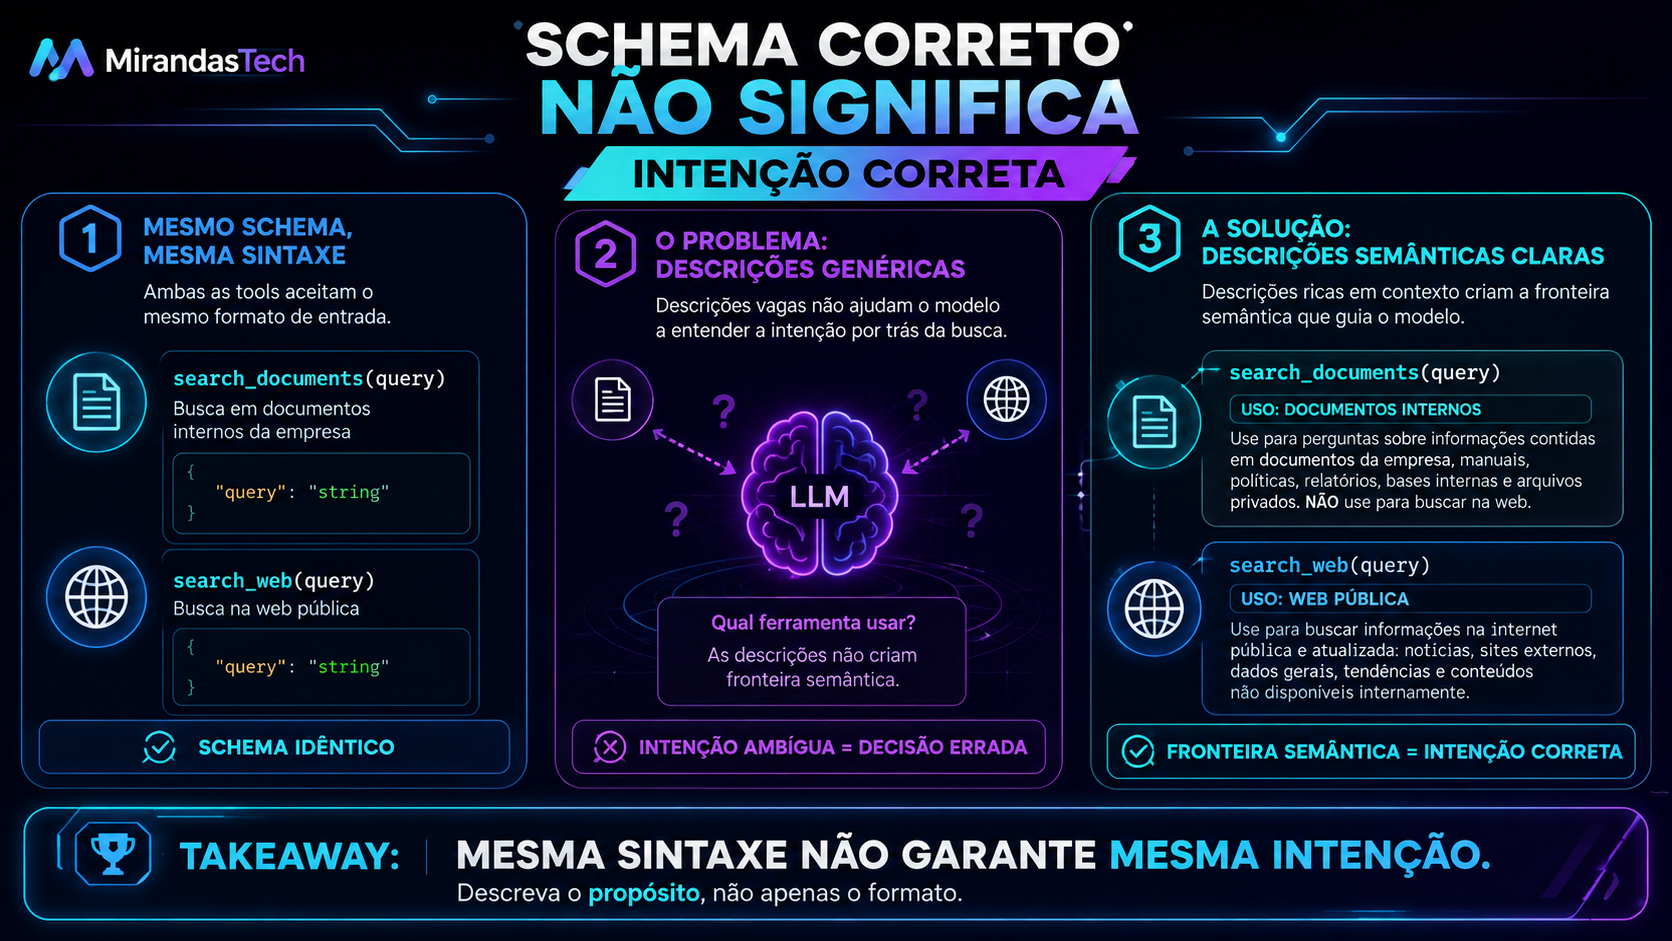
Considere duas ferramentas:
search_documents(query)
search_web(query)
Os schemas poderiam ser praticamente idênticos:
{"query": "string"}Do ponto de vista sintático, ambas aceitam a mesma coisa. Mas possuem funções semanticamente diferentes.
Se suas descrições forem:
search_documents: Search information.
search_web: Search information.
o modelo recebe pouca evidência para diferenciá-las. Agora considere:
search_documents:
Pesquisa documentos internos previamente indexados.
Use para políticas, manuais, relatórios e conhecimento
privado da organização. Não acessa a internet.

search_web:
Pesquisa informações públicas e atuais na Web.
Use quando a pergunta exigir informações externas,
recentes ou não presentes nos documentos internos.
A estrutura das funções não mudou. A implementação não mudou. O que mudou foi a fronteira semântica entre as ferramentas. Esse exemplo é hipotético, mas o fenômeno possui evidência experimental em pesquisas sobre function calling, recuperação de ferramentas e MCP (CHEN et al., 2024; LU et al., 2025; HASAN et al., 2026).
7. O estudo que colocou essa hipótese à prova
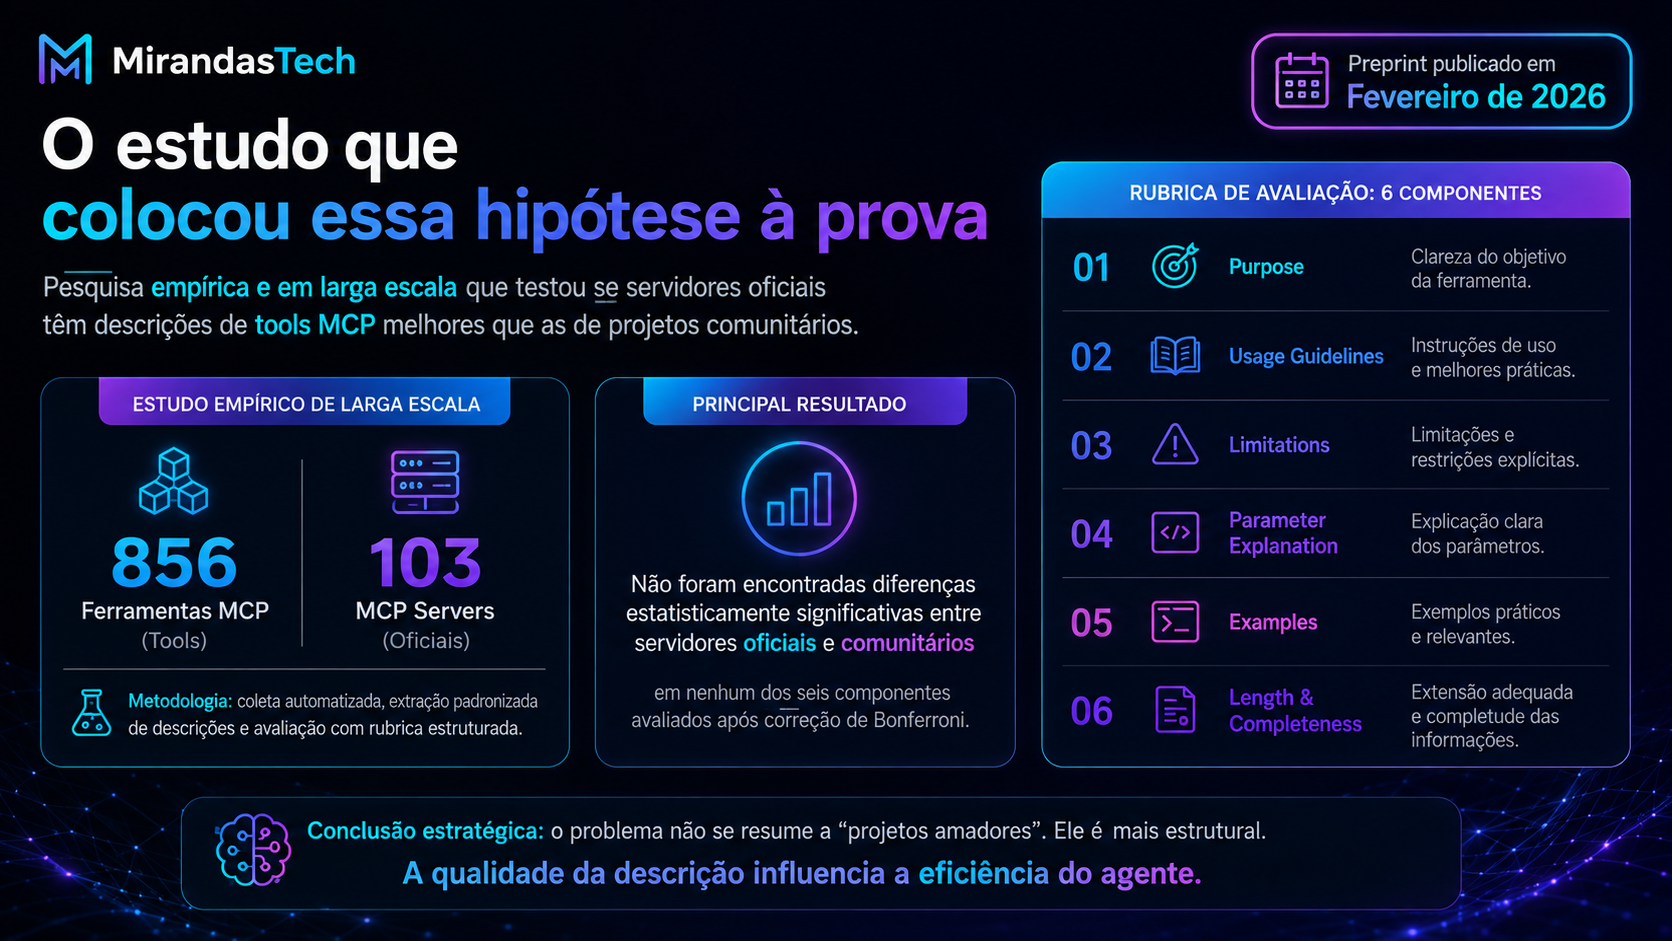
Em fevereiro de 2026, Mohammed Mehedi Hasan, Hao Li, Gopi Krishnan Rajbahadur, Bram Adams e Ahmed E. Hassan publicaram o preprint Model Context Protocol (MCP) Tool Descriptions Are Smelly! Towards Improving AI Agent Efficiency with Augmented MCP Tool Descriptions.
O trabalho realizou um estudo empírico em larga escala sobre a qualidade das descrições utilizadas no ecossistema MCP. Na primeira parte da investigação foram analisadas 856 ferramentas distribuídas em 103 MCP Servers (HASAN et al., 2026).
Os pesquisadores construíram uma rubrica baseada em seis componentes:
| Componente | Pergunta |
|---|---|
| Purpose | O que a ferramenta faz? |
| Usage Guidelines | Quando utilizar — e quando não utilizar? |
| Limitations | Quais são seus limites e restrições? |
| Parameter Explanation | O que significa cada parâmetro? |
| Examples | Existem exemplos de uso suficientemente representativos? |
| Length & Completeness | A descrição contém informação suficiente? |
Tabela 1 — Componentes utilizados para avaliar MCP Tool Descriptions. Fonte: Hasan et al. (2026).
Em vez de perguntar apenas se a descrição existia, os autores avaliaram se ela fornecia informação suficiente para orientar corretamente um modelo. Uma Tool pode estar formalmente documentada e ainda ser semanticamente pobre para um agente.
8. 97,1% das ferramentas apresentaram pelo menos um smell
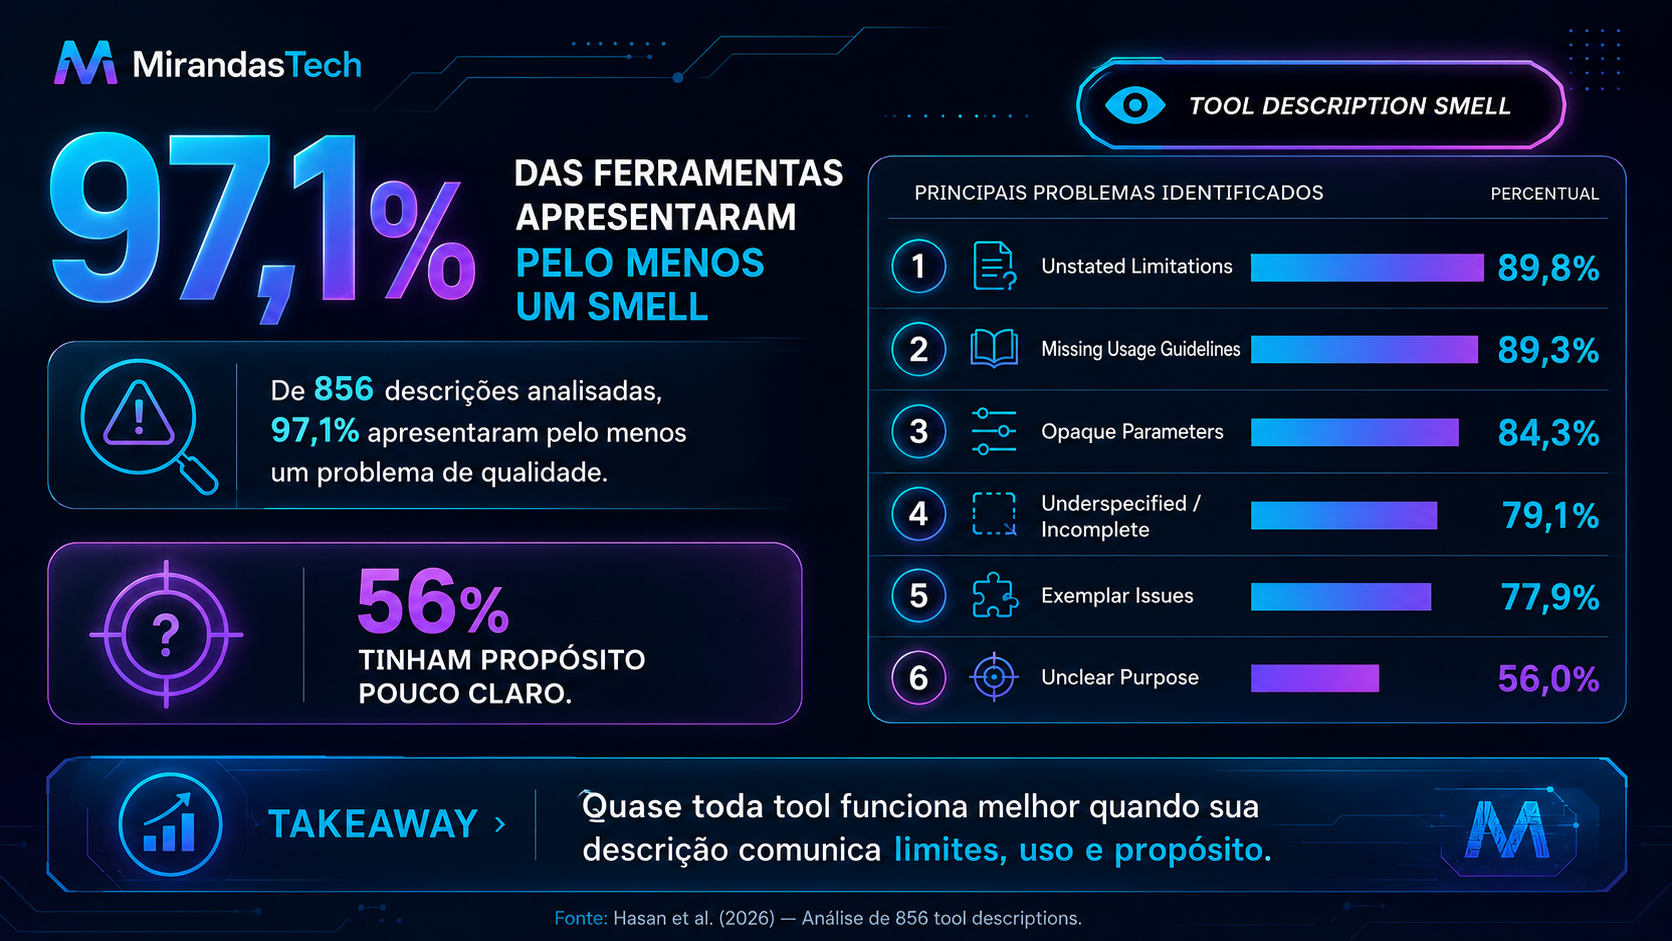
O resultado foi expressivo. 97,1% das 856 descrições analisadas apresentaram pelo menos um problema de qualidade, denominado pelos autores tool description smell. Além disso, 56% apresentavam um propósito considerado pouco claro (HASAN et al., 2026).
| Problema identificado | Percentual |
|---|---|
| Unstated Limitations — limitações não informadas | 89,8% |
| Missing Usage Guidelines — ausência de orientações de uso | 89,3% |
| Opaque Parameters — parâmetros insuficientemente explicados | 84,3% |
| Underspecified / Incomplete — descrição incompleta | 79,1% |
| Exemplar Issues — problemas com exemplos | 77,9% |
| Unclear Purpose — propósito pouco claro | 56,0% |
Tabela 2 — Frequência dos principais Tool Description Smells encontrados por Hasan et al. (2026).
Quando os autores passaram a exigir que Purpose + Guidelines + Limitations + Parameter Explanation + Examples fossem todos livres dos respectivos smells, apenas 2,9% das ferramentas atendiam ao critério (HASAN et al., 2026).
[GRÁFICO SUGERIDO 1 — Prevalência dos Tool Description Smells]
Gráfico de barras horizontal com: Unstated Limitations 89,8%; Missing Usage Guidelines 89,3%; Opaque Parameters 84,3%; Incomplete 79,1%; Exemplar Issues 77,9%; Unclear Purpose 56,0%. A legenda deve deixar claro que 97,1% significa “ao menos um smell de descrição”, e não “97,1% das ferramentas não funcionam”.
9. O problema não estava apenas nos servidores comunitários
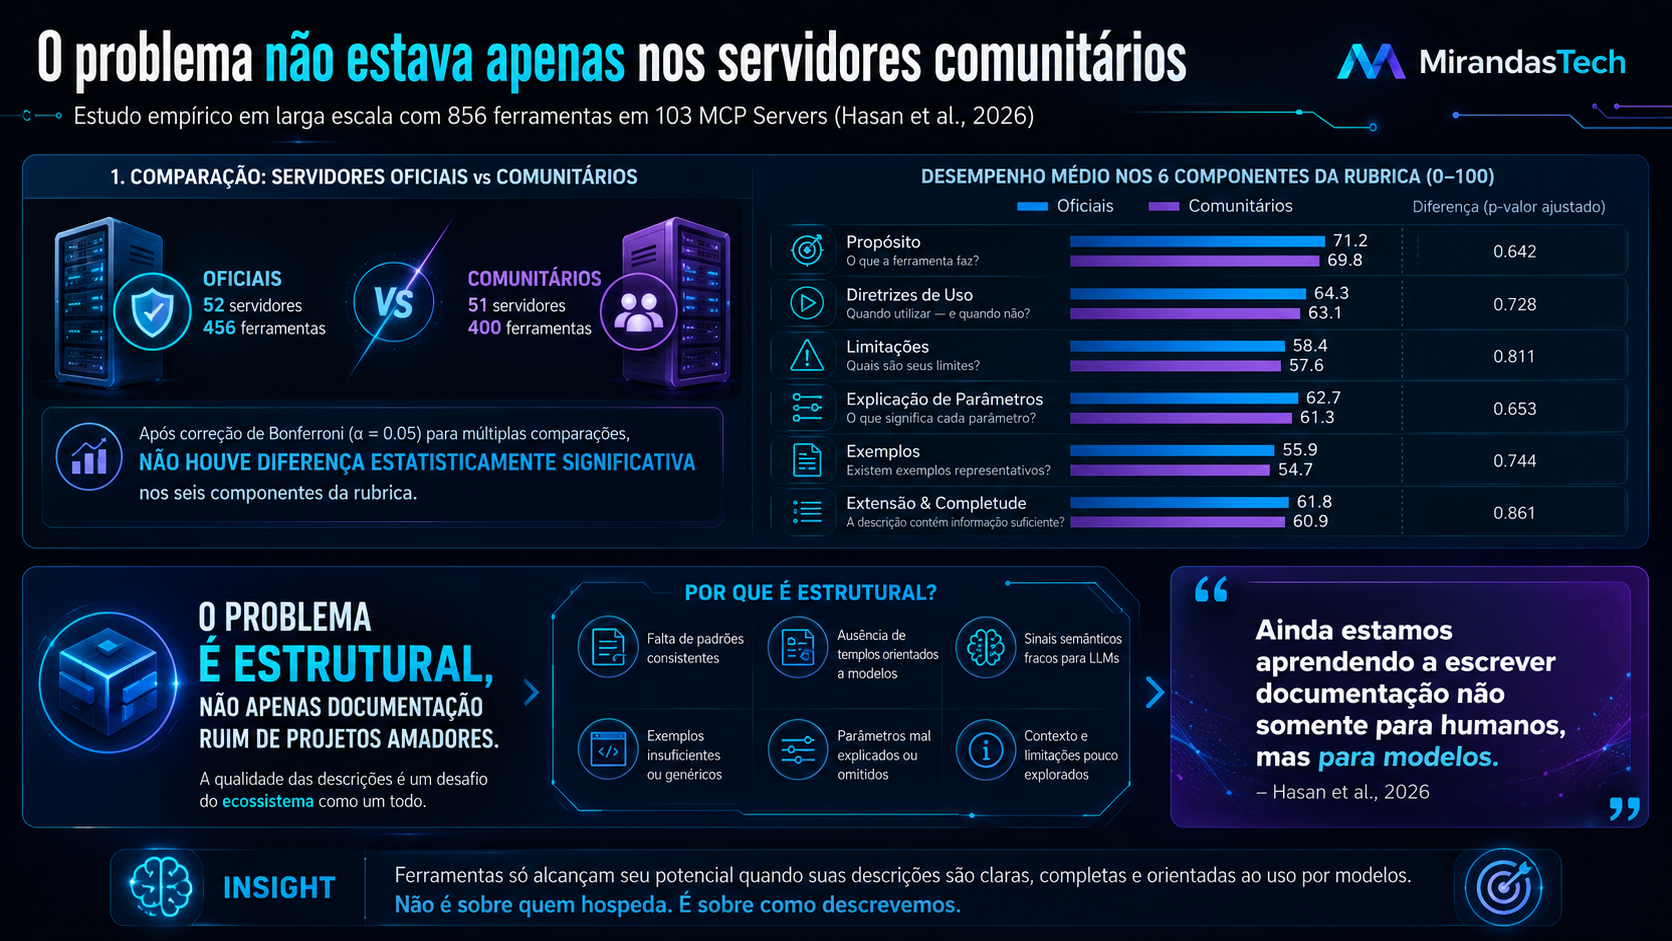
Pode parecer natural imaginar que servidores oficiais teriam descrições muito melhores que projetos comunitários. O estudo não encontrou evidência estatística dessa diferença. Ao comparar os componentes das descrições entre servidores oficiais e comunitários, os autores não encontraram diferenças estatisticamente significativas nos seis componentes depois da correção de Bonferroni (HASAN et al., 2026).
Essa observação é relevante porque sugere que o problema não deve ser interpretado apenas como “documentação ruim de projetos amadores”. Ele pode refletir algo mais estrutural:
Ainda estamos aprendendo a escrever documentação não somente para humanos, mas para modelos que utilizam a documentação como parte do próprio processo decisório.
10. Um exemplo: o modelo sabe que é uma data, mas não sabe qual data usar
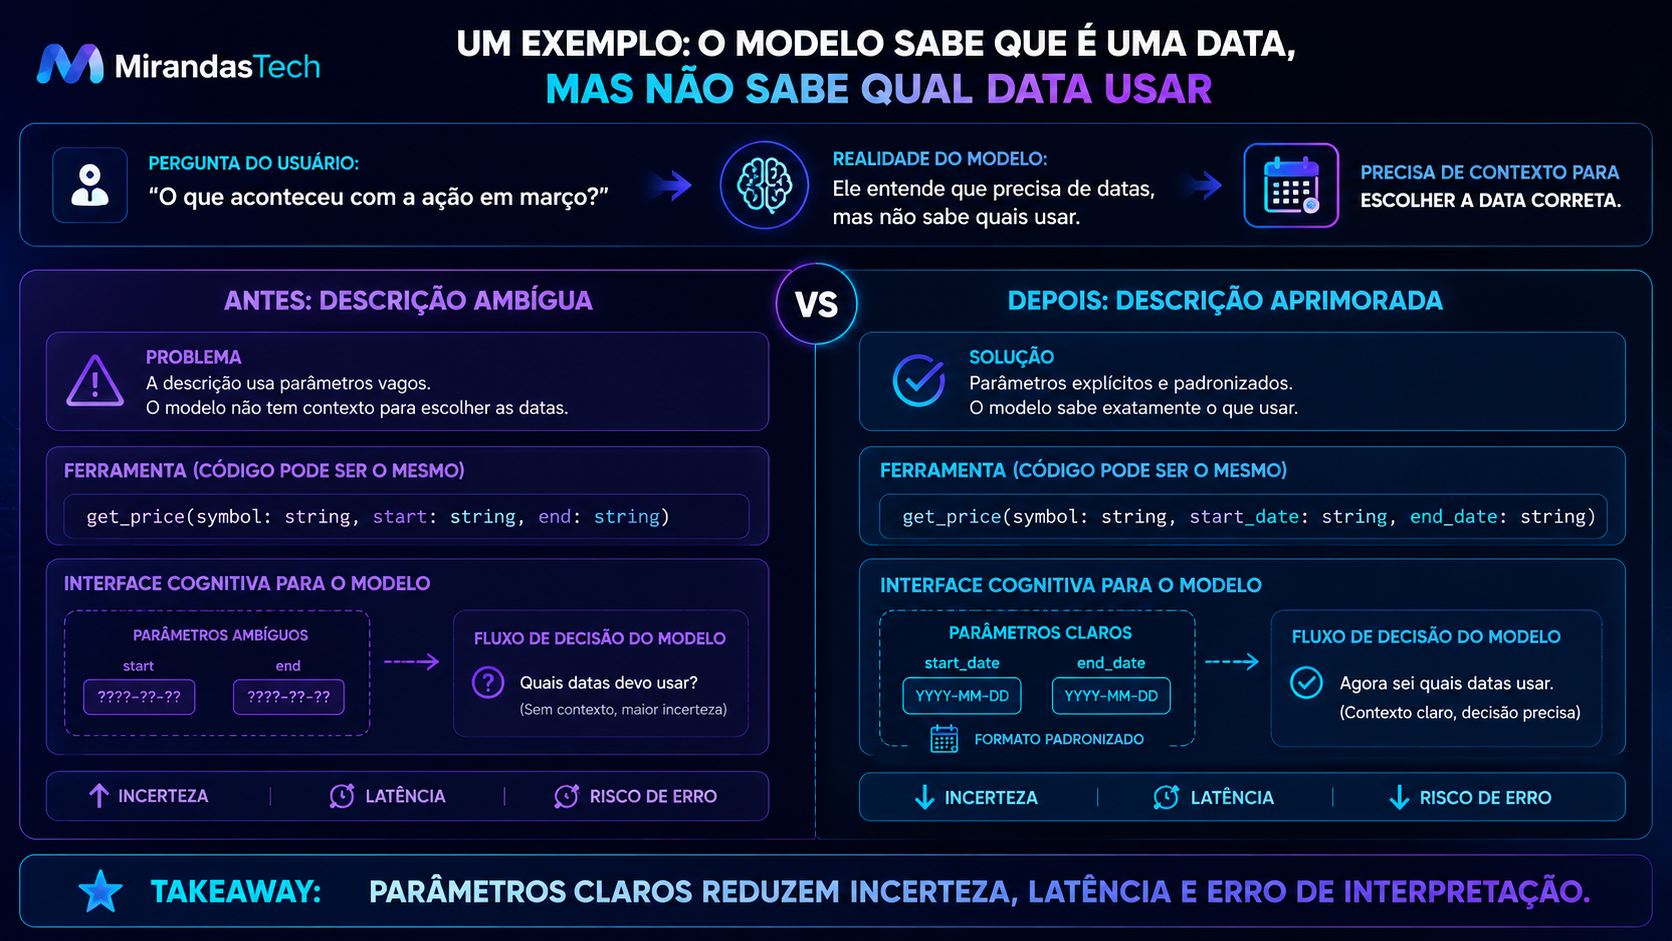
O artigo apresenta um caso didático envolvendo uma ferramenta de dados financeiros. Uma versão original da descrição de get_historical_stock_prices mencionava parâmetros relacionados a início e fim do período, mas fornecia orientação insuficiente sobre nomes e formatos. Uma versão aprimorada explicitava os argumentos start_date e end_date, inclusive com o formato de data esperado. Os autores argumentam que essa diferença pode alterar como o modelo delimita o intervalo solicitado, afetando volume de dados, latência e processamento subsequente (HASAN et al., 2026).
Imagine a pergunta: “O que aconteceu com a ação em março?” Se a descrição disser apenas start e end, o modelo precisa inferir mais coisas. Se informar start_date e end_date com formato YYYY-MM-DD, parte da incerteza desaparece.
O código da ferramenta pode ser exatamente o mesmo. Mas sua interface cognitiva com o modelo mudou.
11. Melhorar a descrição realmente melhora o agente?
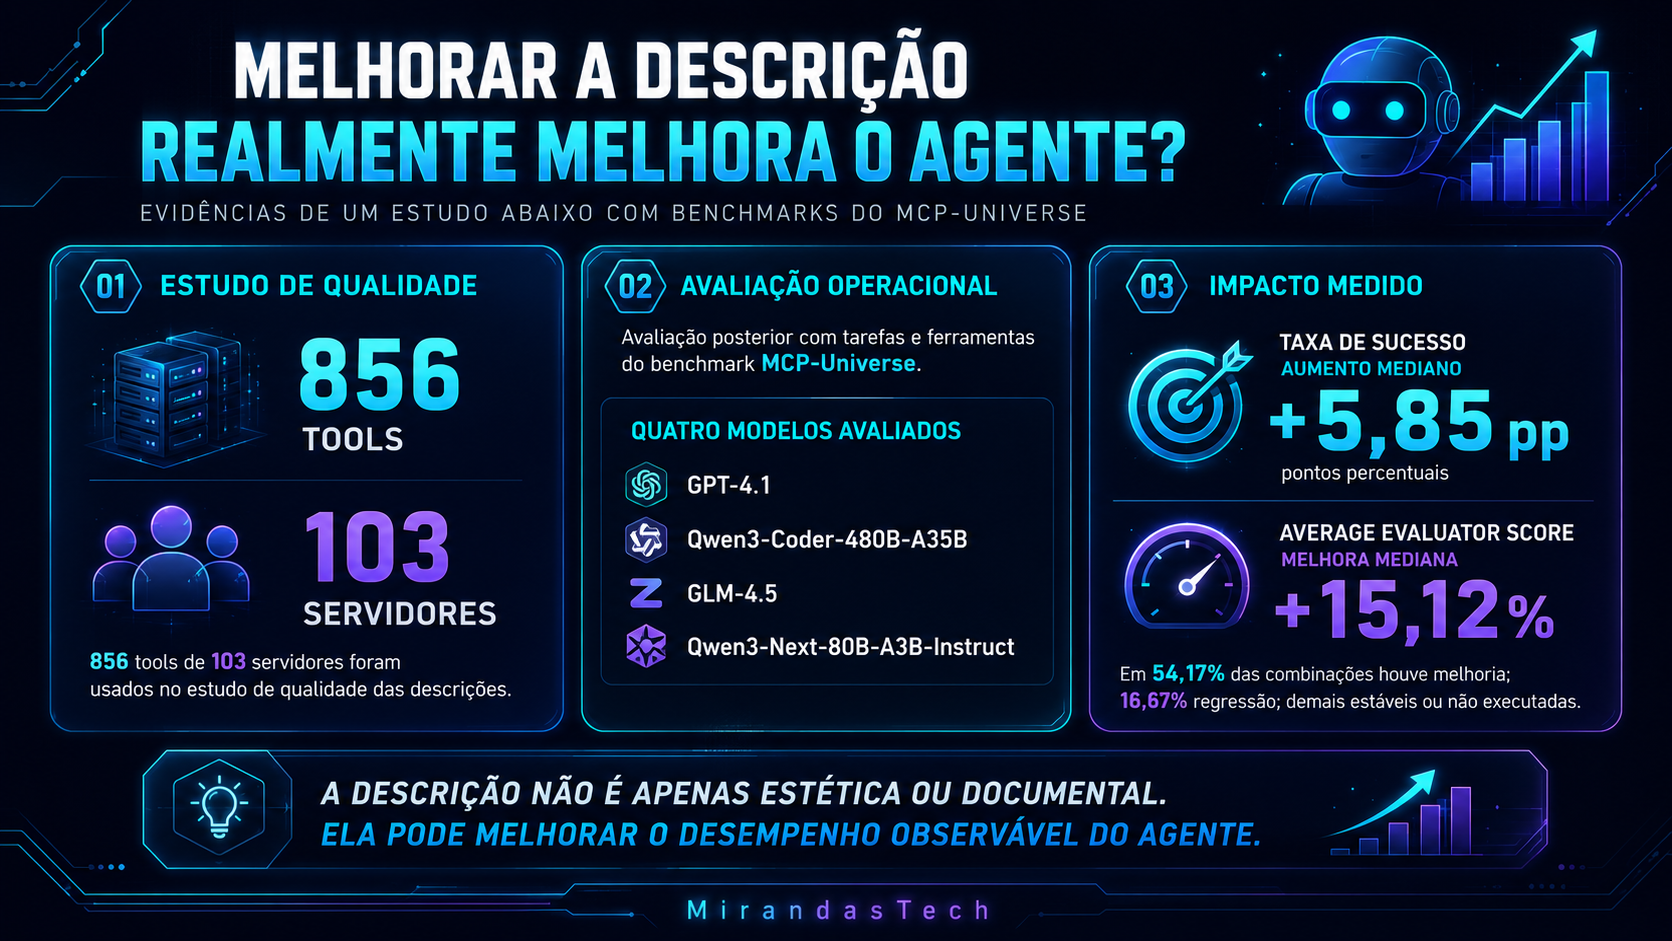
Essa foi a segunda parte importante do estudo. É preciso fazer uma distinção metodológica: os 856 Tools de 103 servidores foram utilizados para o estudo de qualidade das descrições. Para medir o impacto operacional das descrições aprimoradas, os autores utilizaram posteriormente tarefas e ferramentas do MCP-Universe, um benchmark de agentes que envolve diferentes domínios e MCP Servers (HASAN et al., 2026; LUO et al., 2025).
A avaliação contemplou quatro modelos:
- GPT-4.1;
- Qwen3-Coder-480B-A35B;
- GLM-4.5;
- Qwen3-Next-80B-A3B-Instruct.
As descrições enriquecidas elevaram a taxa de sucesso em uma mediana de 5,85 pontos percentuais entre as combinações de domínio e modelo. Em 54,17% das combinações houve melhoria; em 16,67% houve regressão; os demais casos permaneceram estáveis ou não puderam ser executados. O teste de McNemar apontou significância estatística para a melhoria agregada reportada pelos autores (HASAN et al., 2026).
Além do sucesso final, o Average Evaluator Score, utilizado como medida de satisfação parcial dos critérios da tarefa, apresentou melhoria mediana de 15,12%.
Δ Success Rate mediana = +5,85 pontos percentuais
Δ Average Evaluator mediana = +15,12%
Esses resultados fornecem evidência de que a descrição não é somente uma questão estética ou documental. Ela pode modificar o desempenho observável do agente.
12. O agente passou a trabalhar mais
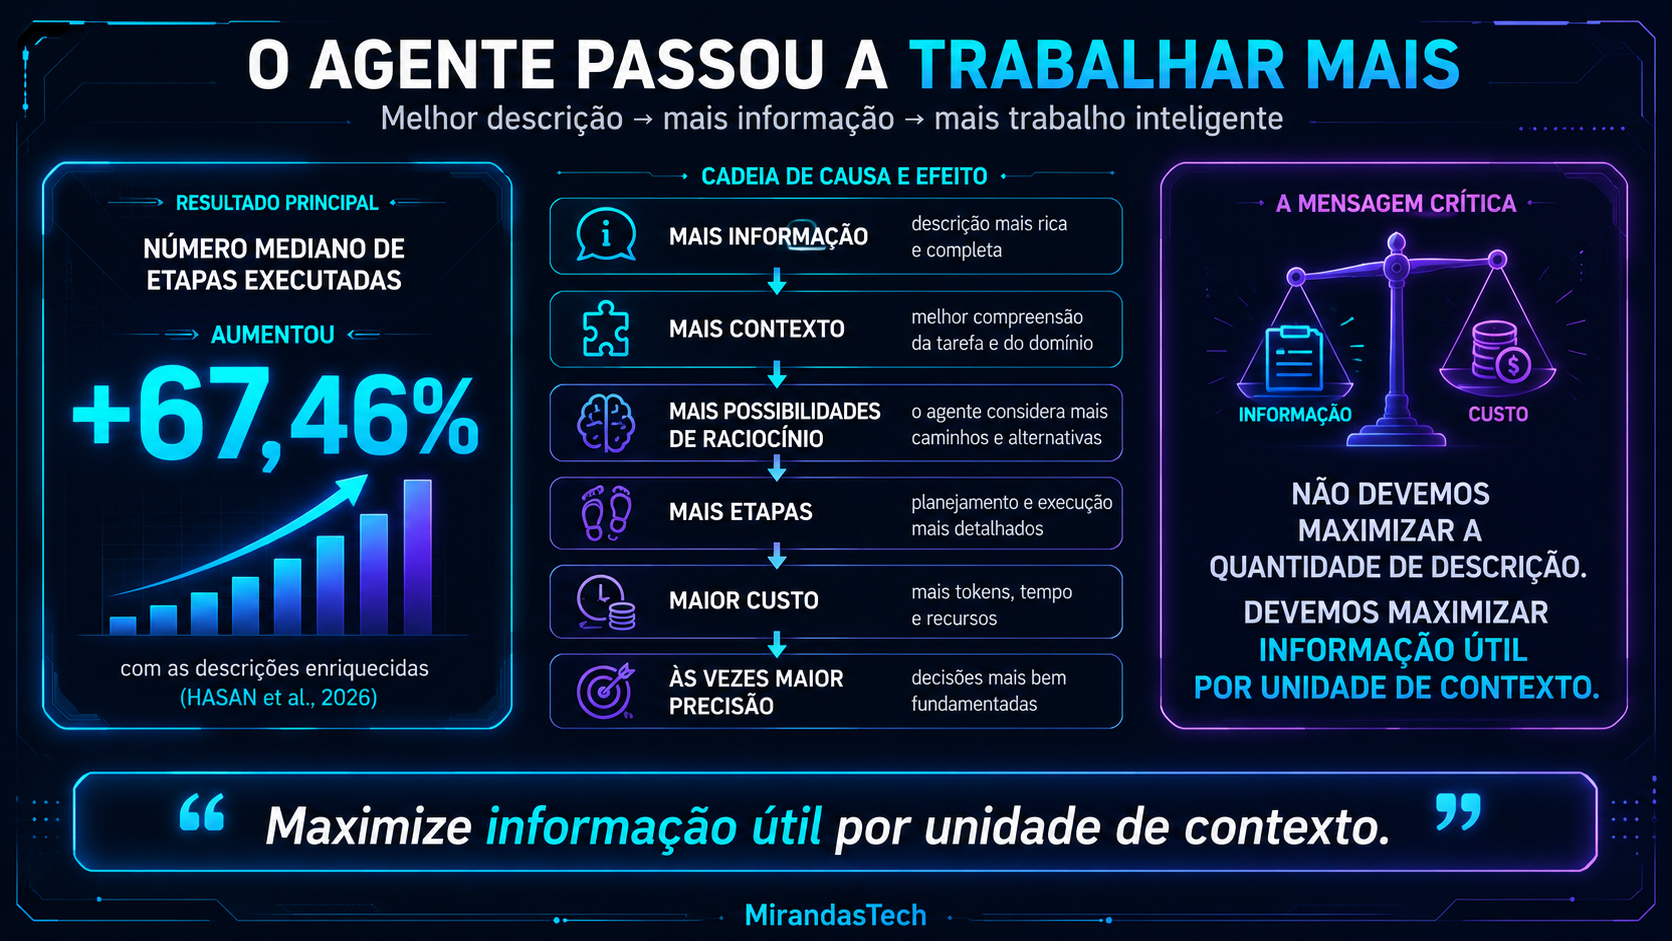
Melhor desempenho não veio gratuitamente. O número mediano de etapas executadas aumentou em:
+67,46%com as descrições enriquecidas (HASAN et al., 2026).
Esse resultado muda a interpretação. Poderíamos imaginar inicialmente:
mais informação → melhor decisãoMas o resultado sugere uma relação mais complexa:
mais informação
  ↓
mais contexto
mais possibilidades de raciocínio
mais etapas
maior custo
às vezes maior precisão
Para três dos quatro modelos avaliados, o estudo observou aumento estatisticamente significativo no número de etapas. O Qwen3-Next-80B-A3B-Instruct foi uma exceção interessante: reduziu o número médio de etapas enquanto melhorava outros indicadores (HASAN et al., 2026).
Não devemos maximizar a quantidade de descrição. Devemos maximizar informação útil por unidade de contexto.
[GRÁFICO SUGERIDO 2 — Precisão versus custo]
Eixo X: número de etapas/custo operacional. Eixo Y: sucesso/qualidade. Comparar descrição original, enriquecida e uma hipotética descrição compacta otimizada. Mensagem: “A melhor descrição não é necessariamente a maior descrição”.
13. Não existe uma descrição perfeita universal
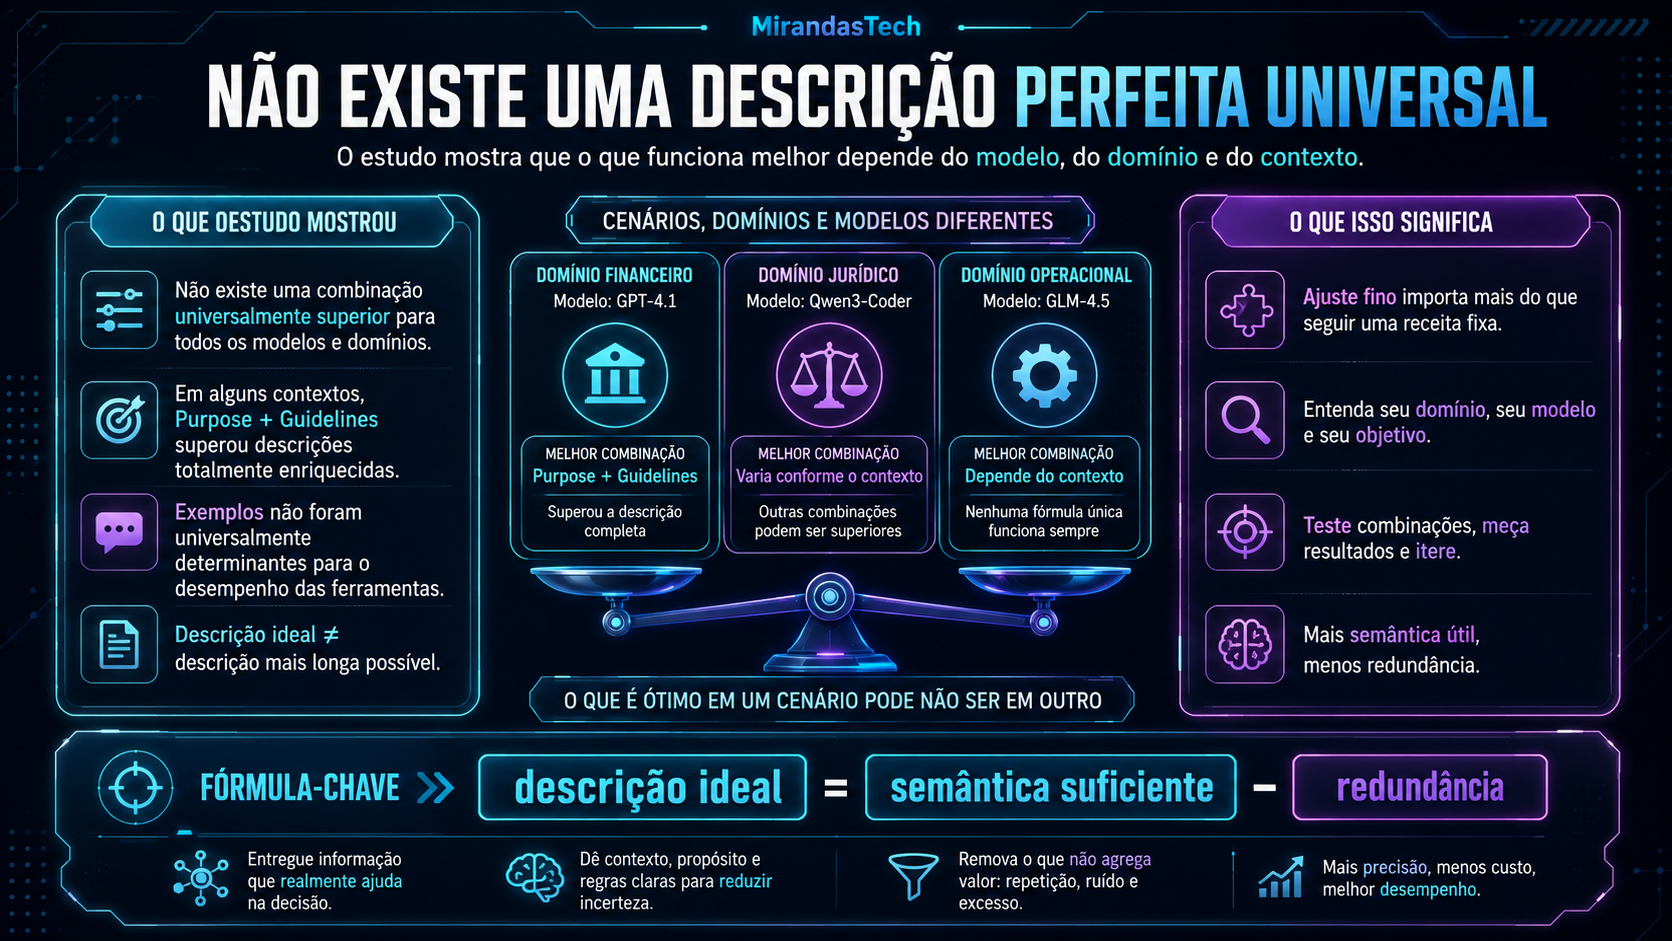
Os autores conduziram também um estudo de ablação para verificar quais componentes das descrições produziam os melhores resultados. E encontraram algo importante: não existe uma combinação universalmente superior para todos os modelos e domínios.
Em algumas condições, descrições contendo apenas determinados componentes superaram versões completamente enriquecidas. No domínio financeiro com GPT-4.1, por exemplo, a combinação Purpose + Guidelines apresentou o melhor resultado dentre as configurações testadas, superando inclusive a descrição completa (HASAN et al., 2026).
Outro resultado interessante envolveu exemplos. Embora exemplos sejam tradicionalmente importantes em few-shot prompting, removê-los das Tool Descriptions não produziu degradação significativa em diversas configurações analisadas. Os autores concluem que exemplos não foram universalmente determinantes para o desempenho das ferramentas testadas.
descrição ideal ≠ descrição mais longa possívelTalvez a formulação mais apropriada seja:
descrição ideal = semântica suficiente − redundância14. O contexto também muda a decisão
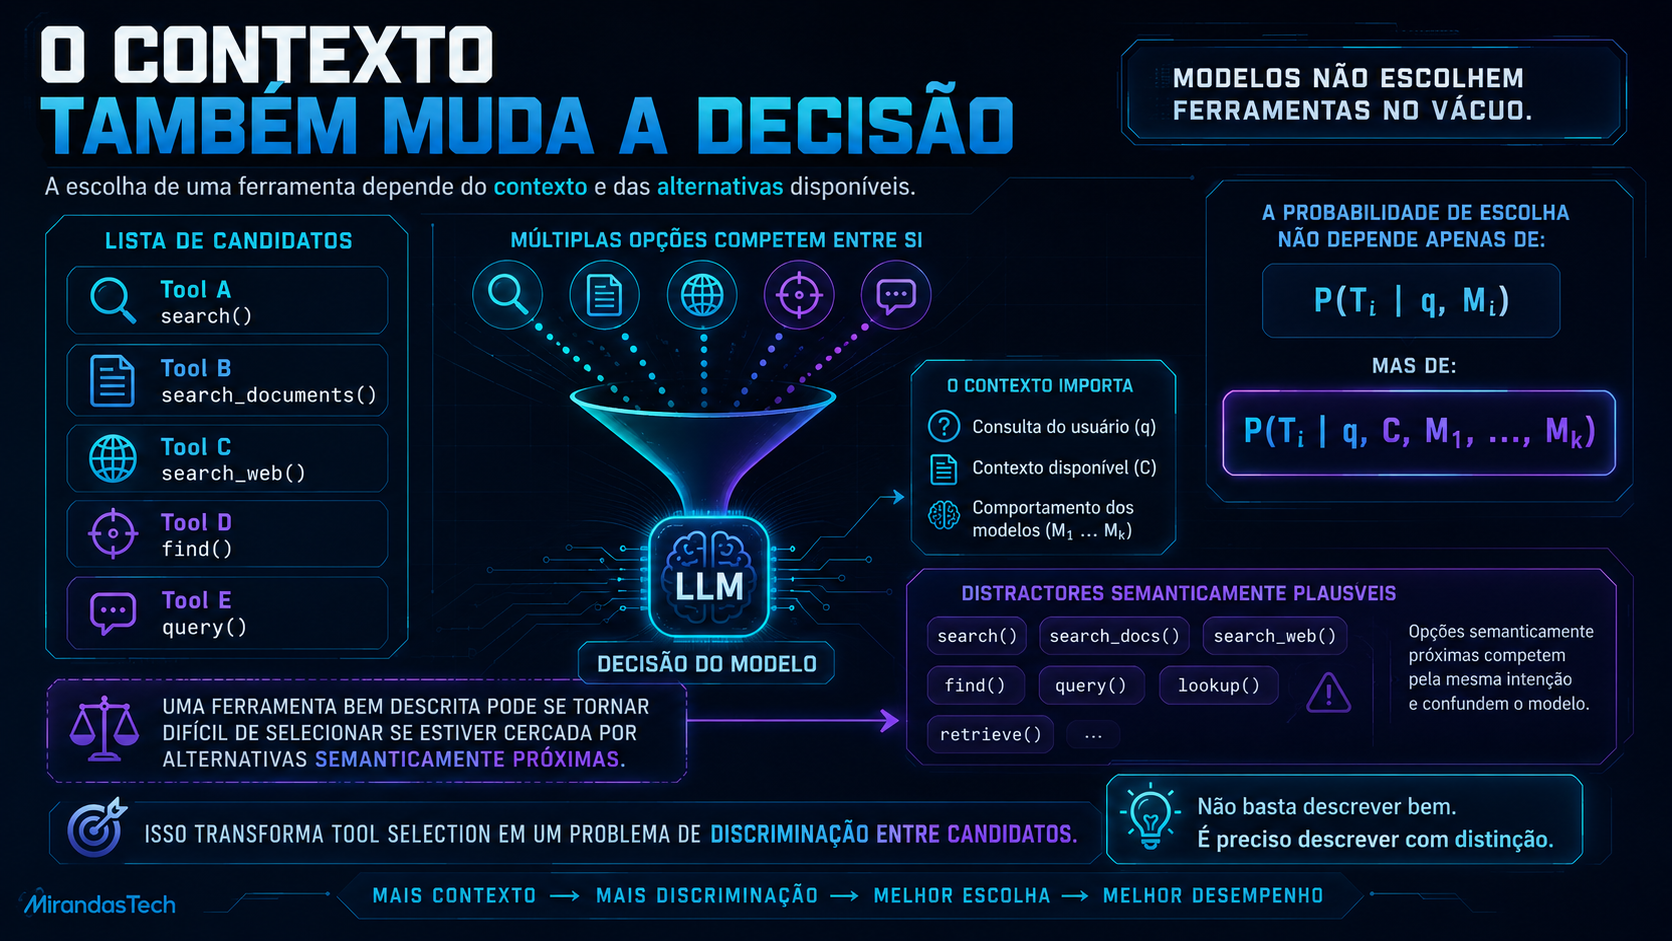
Até aqui analisamos uma ferramenta isoladamente. Mas modelos não escolhem ferramentas no vácuo.
Tool A: search()
Tool B: search_documents()
Tool C: search_web()
Tool D: find()
Tool E: query()
Mesmo uma Tool bem descrita pode se tornar difícil de selecionar se estiver cercada por muitas opções semanticamente próximas. Formalmente, não basta considerar P(Tᵢ | q, Mᵢ). É mais apropriado considerar:
P(Tᵢ | q, C, M₁, ..., Mₖ)A presença de uma ferramenta concorrente pode afetar a decisão sobre outra. Isso transforma tool selection também em um problema de discriminação entre candidatos.
Benchmarks recentes começaram a adicionar ferramentas semanticamente plausíveis, mas incorretas, para verificar se o modelo consegue identificar a capacidade realmente necessária. O MCP-Atlas, por exemplo, apresenta de 6 a 37 ferramentas por tarefa, das quais somente 2 a 8 são relevantes, exigindo que o agente discrimine ferramentas corretas de distractors semanticamente plausíveis (BANDI et al., 2026).
15. O problema do prompt bloat
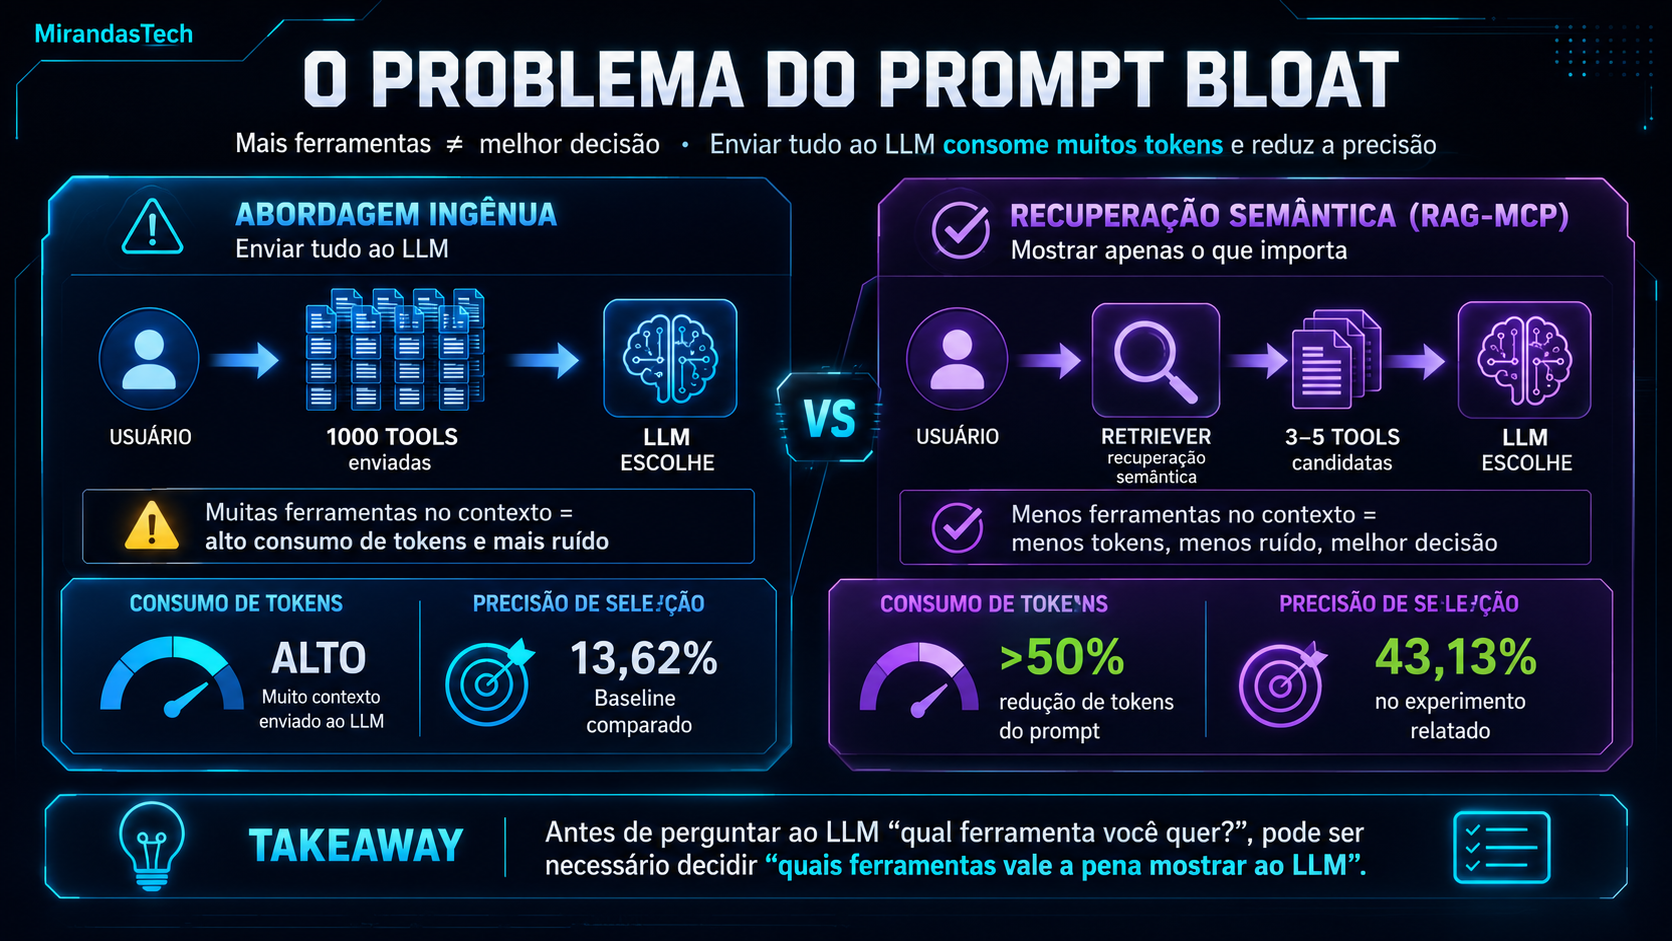
À medida que o número de ferramentas cresce, um segundo problema aparece. Imagine um servidor com 100 Tools, cada uma contendo nome, descrição, schema, parâmetros, exemplos e limitações. Enviar todas para o contexto do modelo em todas as solicitações pode consumir uma quantidade significativa de tokens.
Gan e Sun (2025) denominam esse problema prompt bloat e propõem o RAG-MCP: em vez de entregar todas as ferramentas ao LLM, um mecanismo de recuperação semântica seleciona inicialmente apenas aquelas mais relevantes para a consulta.
Abordagem ingênua:
Usuário → 1000 Tools → LLM escolhe

Recuperação semântica:
Usuário → Retriever → 3–5 Tools candidatas → LLM escolhe
No experimento apresentado pelos autores, o RAG-MCP reduziu o número de tokens do prompt em mais de 50% e atingiu 43,13% de precisão de seleção em determinado benchmark, contra 13,62% do baseline comparado. Esses números pertencem à configuração experimental do trabalho e não devem ser interpretados como garantia geral de desempenho (GAN; SUN, 2025).
Antes de perguntar ao LLM “qual ferramenta você quer?”, pode ser necessário decidir “quais ferramentas vale a pena mostrar ao LLM?”.
16. Tool selection começa a se parecer com um mecanismo de busca
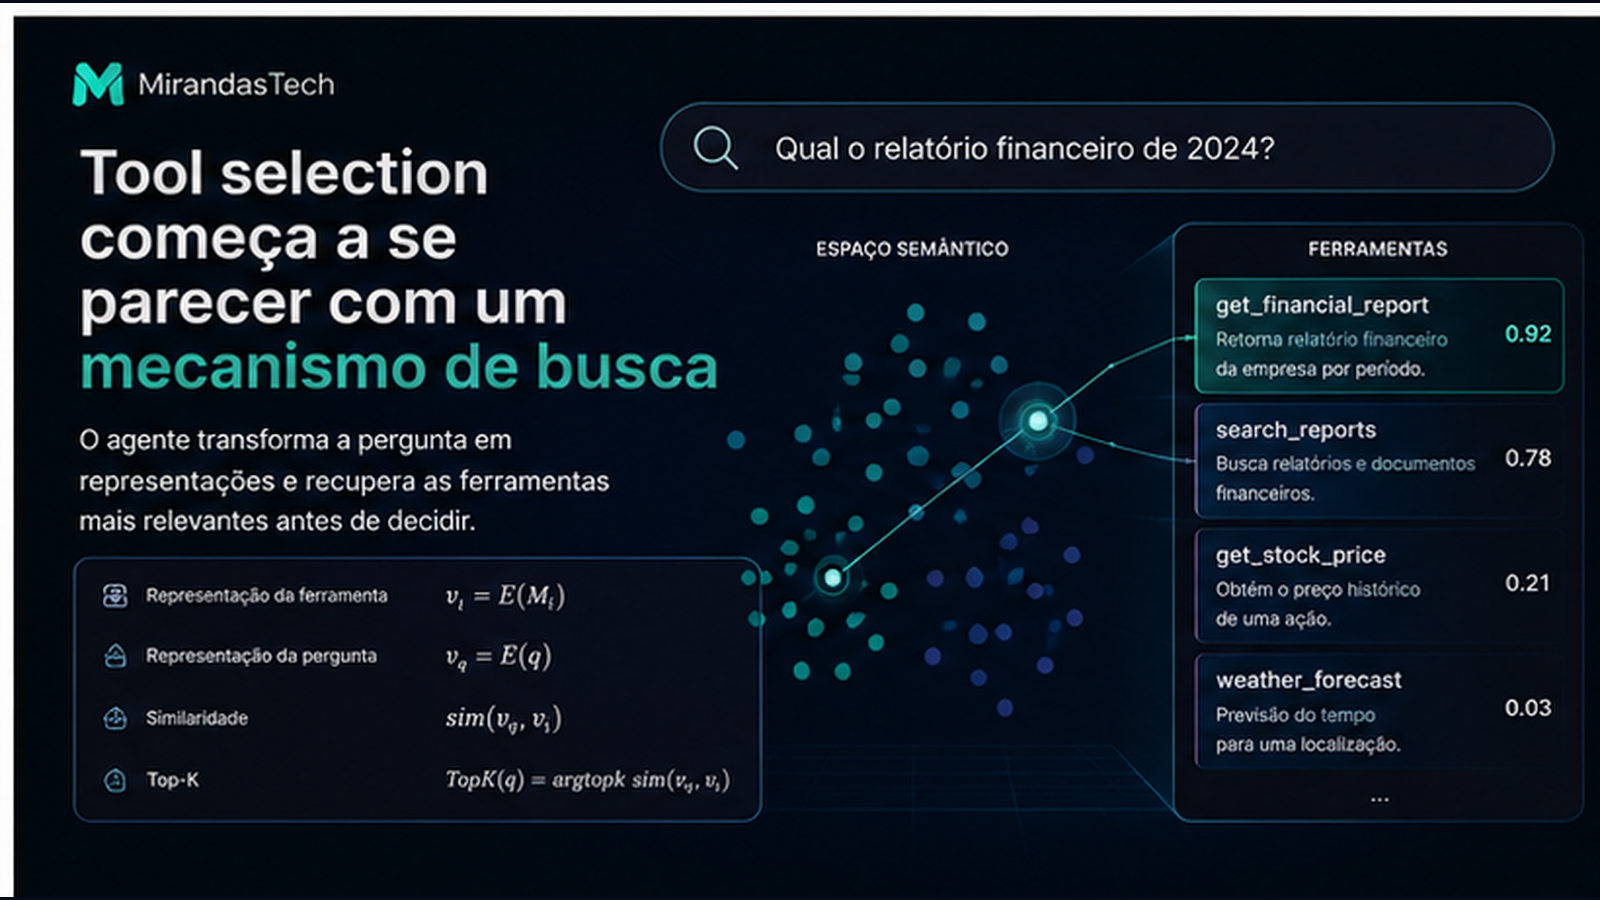
Essa abordagem aproxima tool discovery de Information Retrieval. Para cada ferramenta, pode-se gerar uma representação vetorial:
vᵢ = E(Mᵢ)E para a pergunta:
vq = E(q)Então calcula-se uma medida de similaridade e recuperam-se apenas as ferramentas mais próximas:
TopK(q) = argtopk sim(vq, vᵢ)Só depois dessa etapa o LLM recebe as candidatas.
Mudunuri et al. (2026) avaliaram uma arquitetura dessa natureza especificamente para seleção de MCP Tools. Em um benchmark composto por 140 consultas e 121 ferramentas provenientes de cinco servidores, a abordagem reportou hit rate de 97,1% em K=3, MRR de 0,91 e redução de 99,6% no consumo de tokens associados às ferramentas, com recuperação inferior a 100 ms no ambiente testado. Esses resultados são específicos ao experimento, mas ilustram o potencial de separar descoberta e raciocínio de execução.
Pergunta
  ↓
Embedding / recuperação semântica
  ↓
Catálogo de Tools
  ↓
Top-k candidatos
  ↓
LLM
  ↓
Seleção final
  ↓
Argumentos
  ↓
MCP Tool
17. Mas busca semântica também depende da descrição
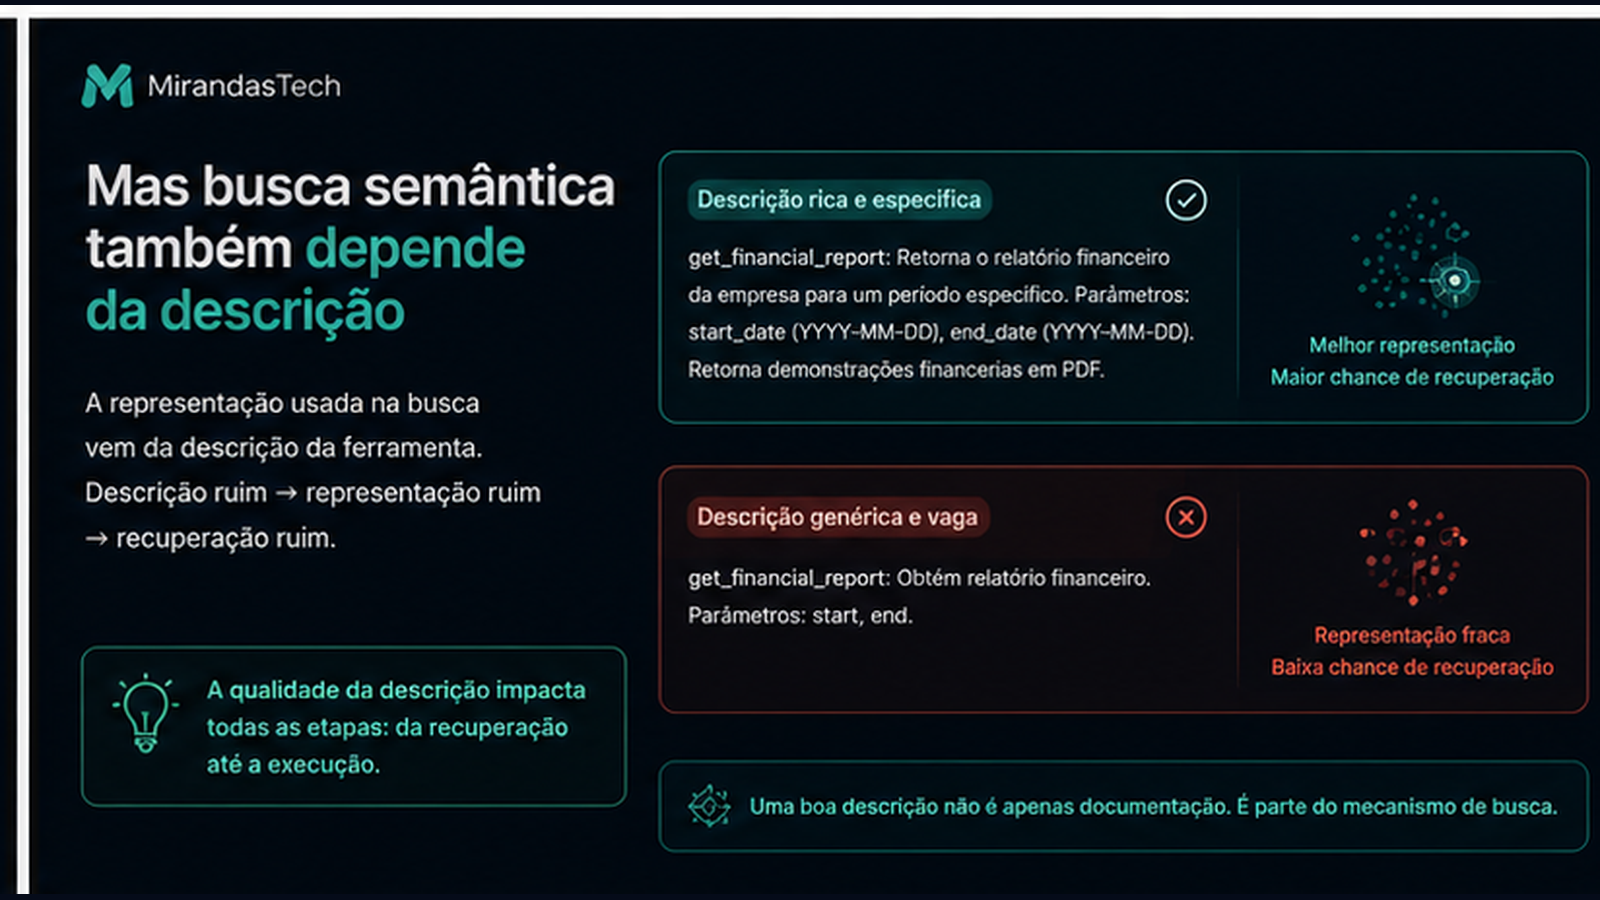
Surge então uma consequência interessante. Se o Retriever utiliza uma representação vetorial da Tool Description para encontrar ferramentas semanticamente relacionadas à pergunta, uma descrição ruim passa a prejudicar não apenas o LLM final, mas também a etapa de recuperação que deveria ajudá-lo.
Lu et al. (2025), no trabalho Tools are under-documented: Simple Document Expansion Boosts Tool Retrieval, estudaram justamente esse problema. Os autores argumentam que documentação incompleta e heterogênea limita a recuperação de ferramentas e propõem enriquecer documentos com campos estruturados antes de realizar retrieval e reranking. Seus experimentos mostraram ganhos em benchmarks de recuperação de ferramentas com perfis documentais enriquecidos.
Descrição
  ↓
Representação semântica
  ↓
Recuperação
  ↓
Seleção
  ↓
Argumentação
  ↓
Execução
Um erro no início pode propagar-se pelas etapas seguintes.
18. Essa discussão começou antes do MCP
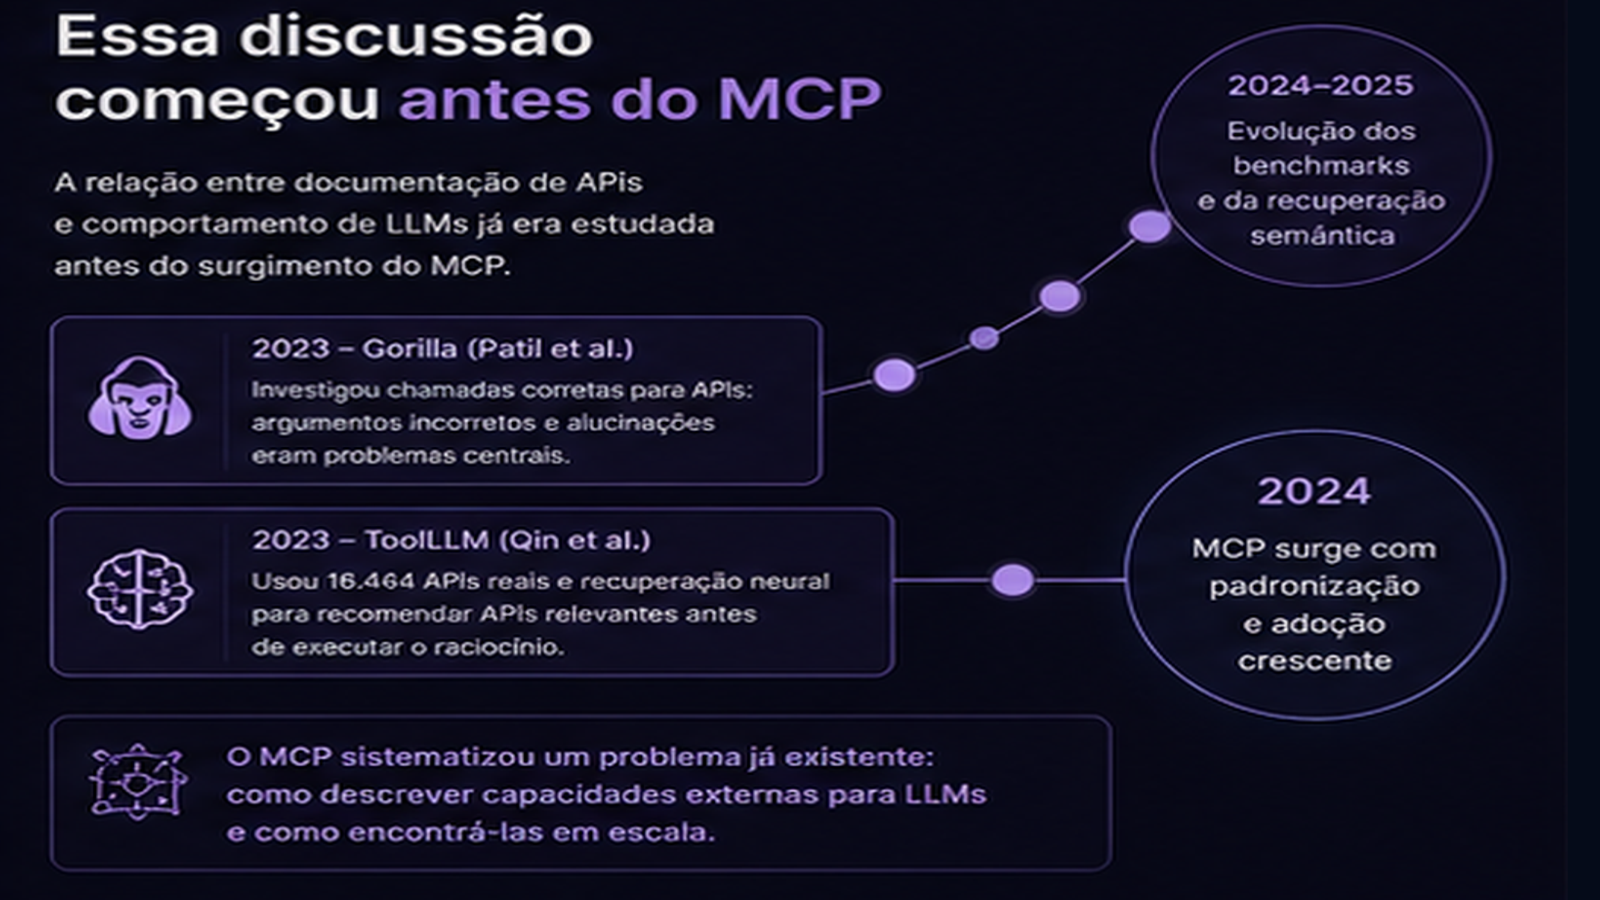
O MCP tornou o problema mais visível, mas a relação entre documentação de APIs e comportamento de LLMs é anterior ao protocolo.
O trabalho Gorilla, de Patil et al. (2023), investigou a capacidade de modelos de linguagem produzirem chamadas corretas para APIs. Os autores identificaram como problemas centrais a geração de argumentos incorretos e a alucinação de usos de APIs e demonstraram que incorporar recuperação de documentação aumentava a adaptação a mudanças nas APIs e reduzia alucinações no ambiente experimental analisado.
O ToolLLM, de Qin et al. (2023), ampliou essa perspectiva ao construir um conjunto envolvendo 16.464 APIs REST reais e utilizar um mecanismo neural de recuperação para recomendar APIs relevantes antes de executar o raciocínio de utilização.
Esses trabalhos anteciparam duas questões que se tornaram centrais no ecossistema MCP: como descrever uma capacidade externa para um LLM e como encontrar a capacidade correta em um conjunto muito grande.
19. Até o local onde colocamos a descrição pode importar
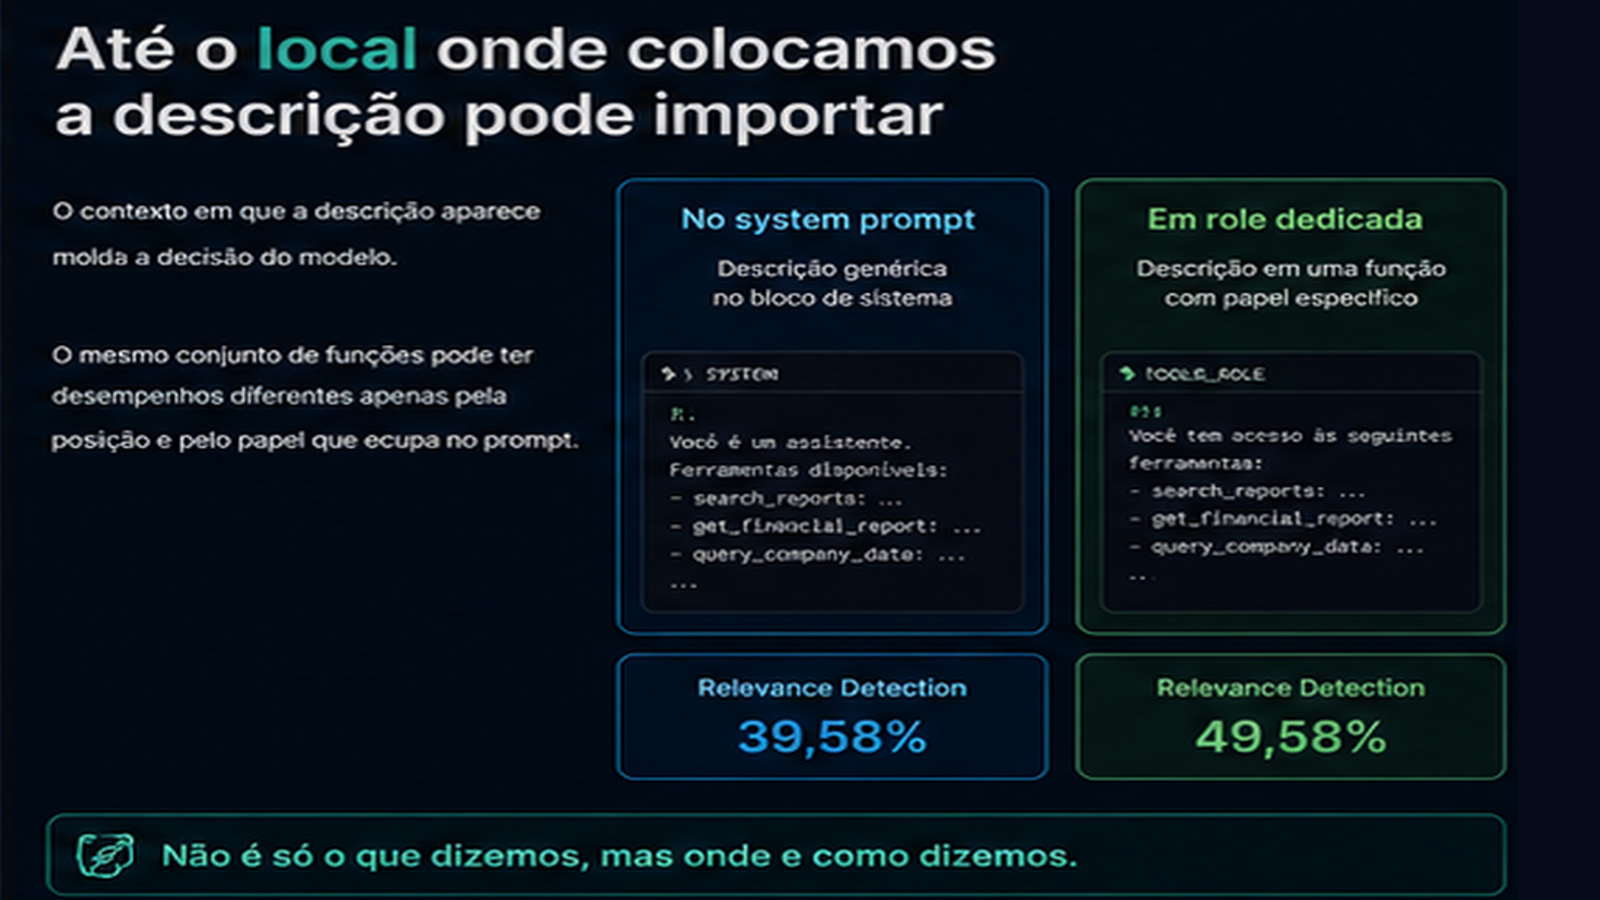
Não é apenas o que dizemos sobre uma função. Onde e como essa informação aparece no contexto também pode importar.
Chen et al. (2024) investigaram diferentes formatos de function calling. Entre os experimentos, compararam fornecer descrições de funções em uma função/role dedicada versus inseri-las no system prompt. A precisão geral das chamadas foi semelhante em algumas configurações, mas a capacidade de detectar se uma função era ou não relevante apresentou diferenças. Com a mesma combinação de dados de treinamento reportada na tabela principal, a configuração em role dedicada obteve 49,58 em relevance detection, contra 39,58 quando as funções estavam no system role.
Esses valores não devem ser transferidos diretamente para qualquer MCP Client. O experimento envolve uma arquitetura específica de treinamento e function calling. Mas ele demonstra um princípio importante:
comportamento = f(conteúdo, posição, formatação, contexto)Não basta pensar apenas na ferramenta como objeto isolado. É necessário pensar em context engineering.
20. A mesma Tool pode parecer diferente dependendo de suas vizinhas
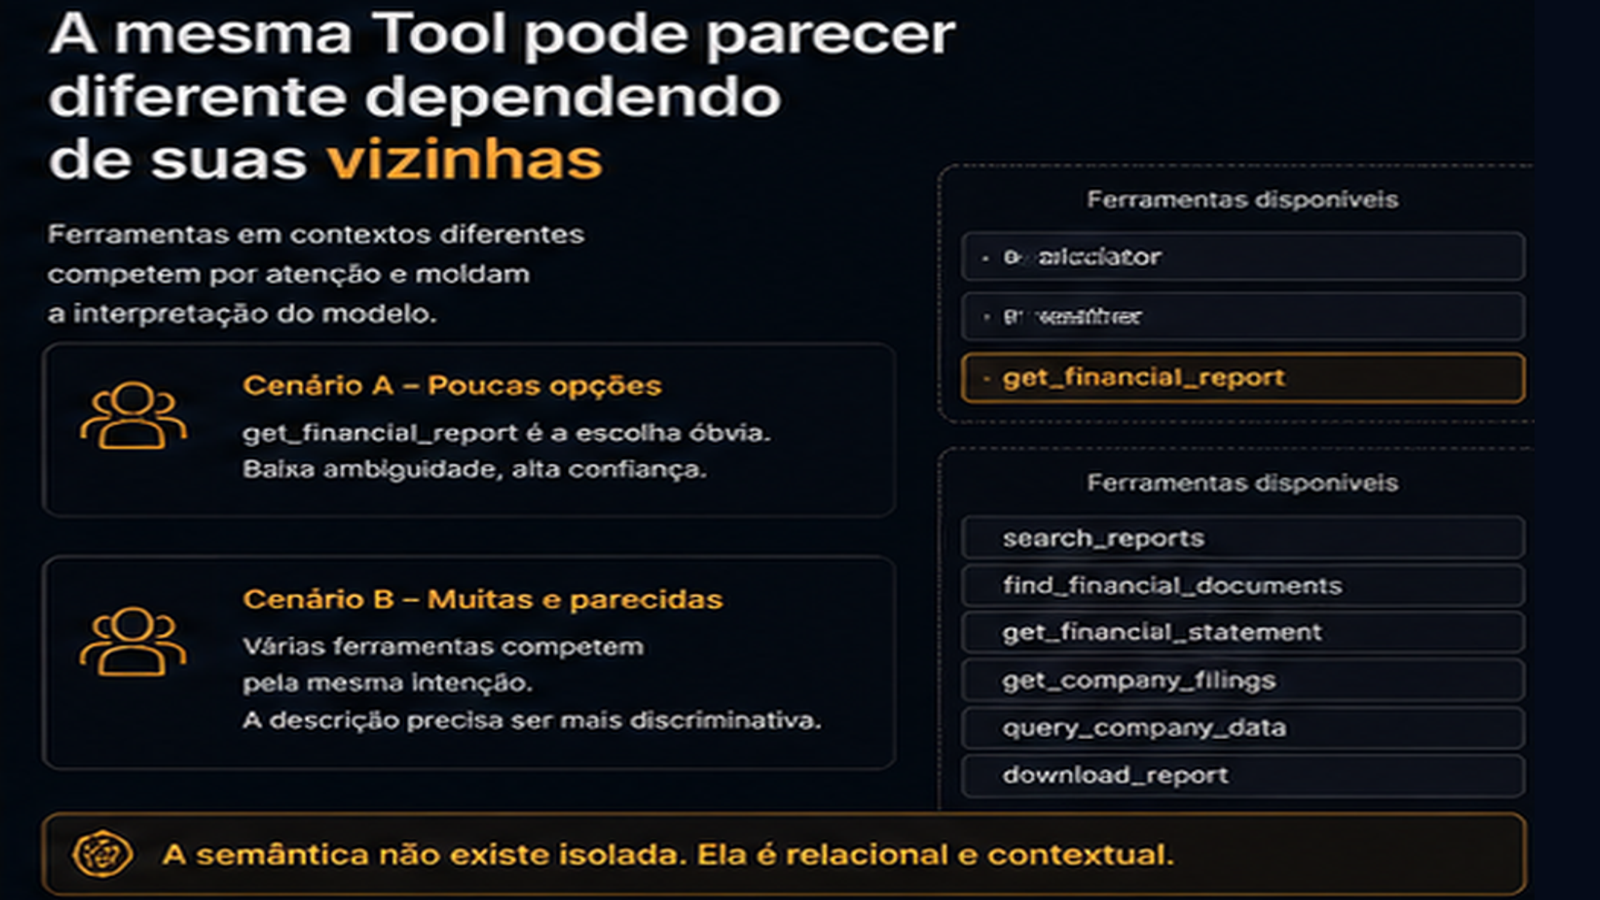
Considere a pergunta: “Encontre o relatório anual da empresa.”
Cenário A
calculator
weather
get_financial_report
A escolha parece simples.
Cenário B
search_reports
find_financial_documents
get_financial_statement
get_company_filings
search_sec_documents
query_company_data
download_report
Agora o problema mudou. A semântica de cada Tool precisa ser suficientemente discriminativa para responder: relatório ou demonstração financeira? Documento local ou remoto? SEC ou qualquer órgão regulador? Procurar ou baixar? Empresa identificada pelo nome ou ticker? Informação atual ou arquivo histórico?
Uma Tool Description precisa responder não apenas “o que eu faço?”, mas também “por que eu sou a escolha correta em vez das outras ferramentas disponíveis?”.
21. O MCP-Universe mostrou o desafio das ferramentas desconhecidas
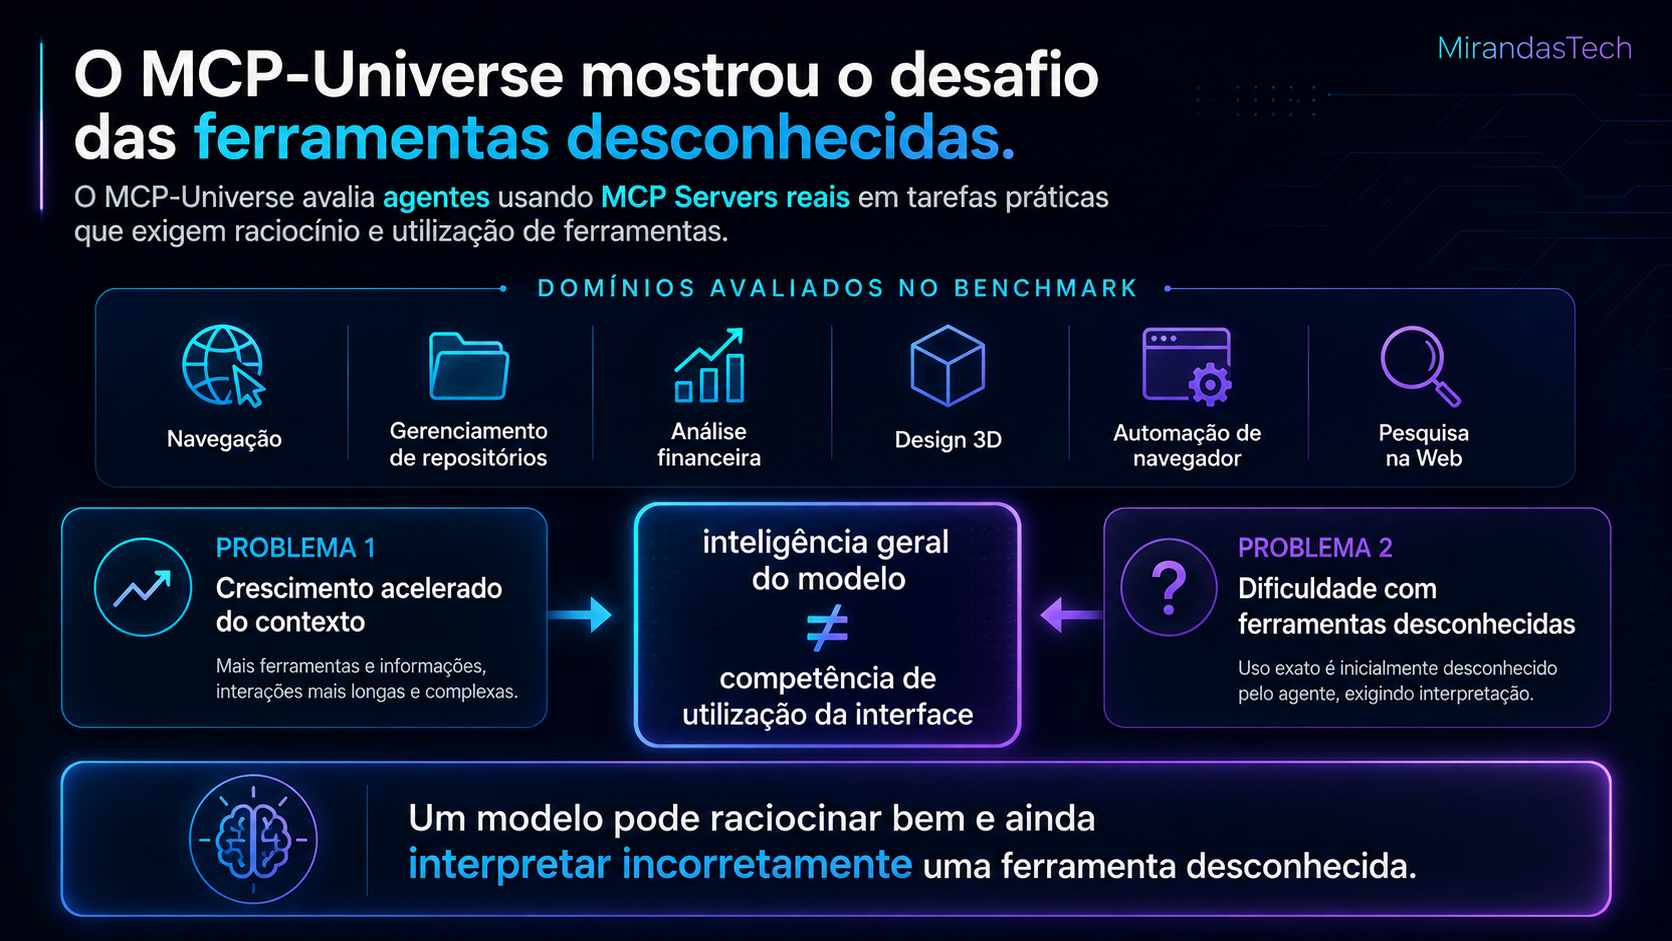
O MCP-Universe foi desenvolvido para avaliar agentes utilizando MCP Servers reais em tarefas que exigem raciocínio e utilização prática de ferramentas. O benchmark inclui domínios como navegação, gerenciamento de repositórios, análise financeira, design 3D, automação de navegador e pesquisa na Web. Os autores destacam dois problemas relevantes: crescimento acelerado do contexto durante interações e dificuldade dos agentes em lidar com ferramentas cujo uso exato lhes é inicialmente desconhecido (LUO et al., 2025).
Essas observações ajudam a separar:
inteligência geral do modelo
≠
competência de utilização da interface
Um modelo pode possuir grande capacidade de raciocínio e ainda interpretar incorretamente uma ferramenta desconhecida.
22. MCP-Atlas: escolher a ferramenta é apenas uma parte do problema
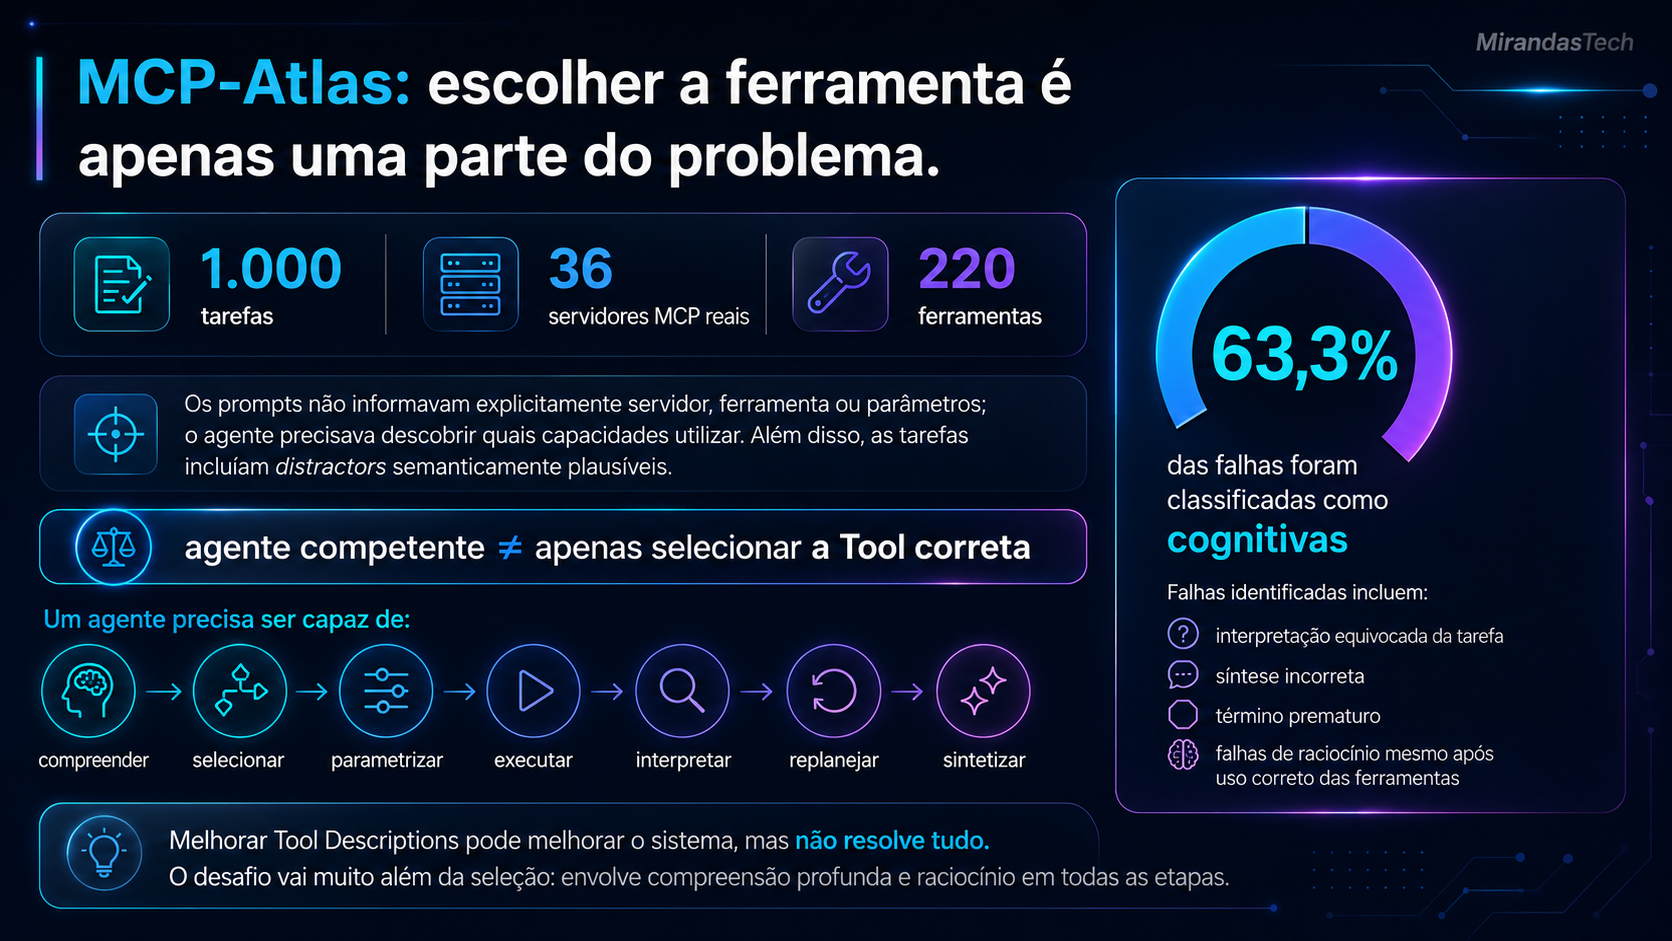
O MCP-Atlas avaliou 1.000 tarefas utilizando 36 servidores MCP reais e 220 ferramentas. Os prompts não informavam explicitamente servidor, ferramenta ou parâmetros; o agente precisava descobrir quais capacidades utilizar. Além disso, as tarefas incluíam distractors semanticamente plausíveis (BANDI et al., 2026).
Entretanto, os resultados revelaram uma nuance importante. Entre as falhas diagnosticadas no benchmark, 63,3% foram classificadas como cognitivas, e não diretamente relacionadas às mecânicas da chamada de ferramentas. Os autores identificaram problemas como interpretação equivocada da tarefa, síntese incorreta, término prematuro e falhas de raciocínio mesmo depois de ferramentas terem sido utilizadas corretamente.
Isso evita uma conclusão simplista. Melhorar Tool Descriptions pode melhorar o sistema, mas:
agente competente ≠ apenas selecionar a Tool corretaUm agente precisa compreender, selecionar, parametrizar, executar, interpretar, replanejar e sintetizar.
23. Três problemas diferentes que frequentemente chamamos de “tool use”
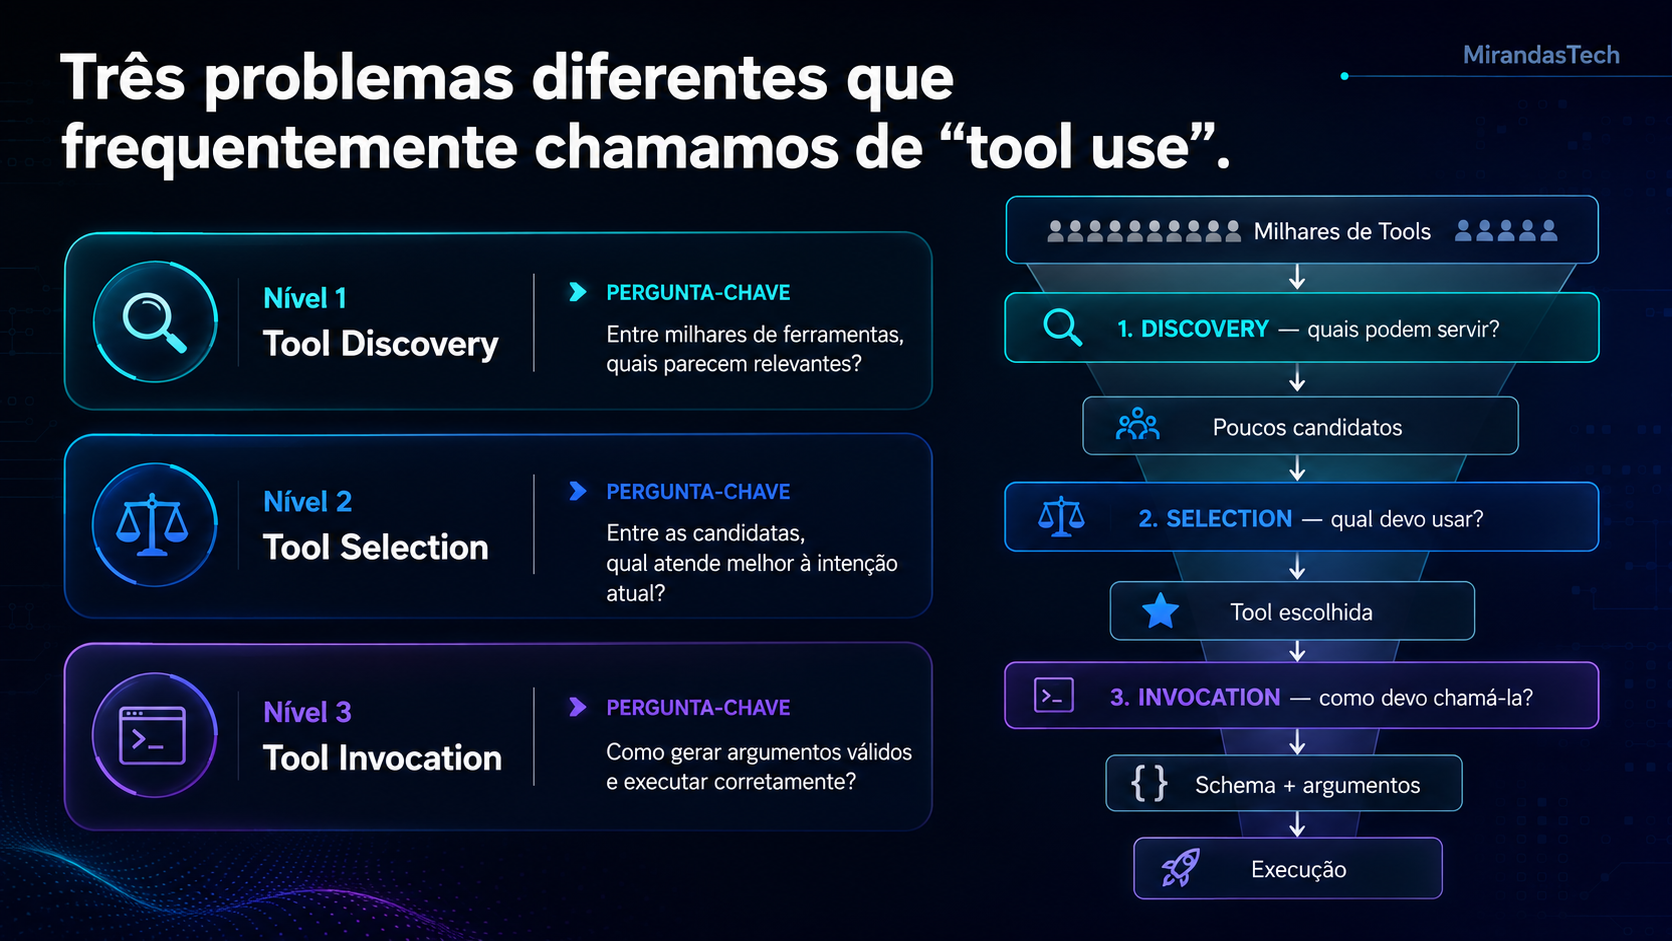
Nível 1 — Tool Discovery
Entre milhares de ferramentas existentes, quais parecem relevantes? É um problema semelhante a recuperação de informação. Pesquisas relevantes incluem ToolLLM, RAG-MCP, Semantic Tool Discovery e Tool-DE (QIN et al., 2023; GAN; SUN, 2025; LU et al., 2025; MUDUNURI et al., 2026).
Nível 2 — Tool Selection
Entre as candidatas, qual atende melhor à intenção atual? É um problema de decisão semântica contextual. Pesquisas sobre qualidade de descrição e formato de function calling atingem diretamente esse nível (CHEN et al., 2024; HASAN et al., 2026).
Nível 3 — Tool Invocation
Como gerar argumentos válidos e executar corretamente? Nesse nível entram schemas, restrições, formatos, validação e tratamento do retorno. A especificação MCP utiliza JSON Schema para expressar os parâmetros esperados de Tools.
24. Description e Schema resolvem problemas diferentes
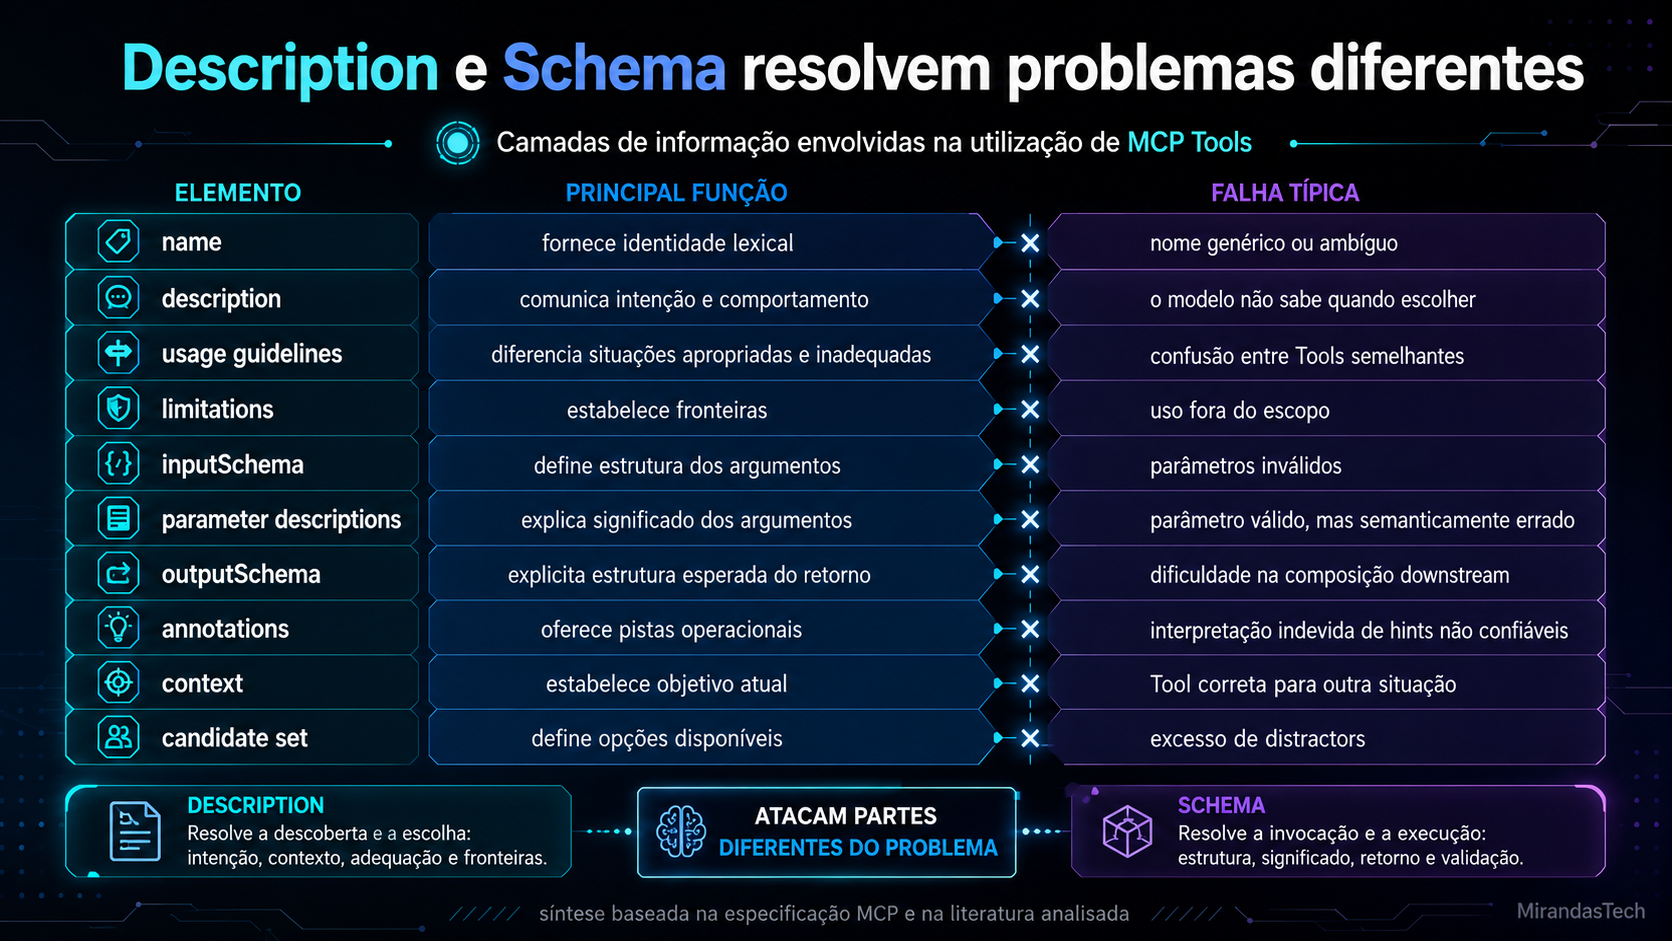
| Elemento | Principal função | Falha típica |
|---|---|---|
| name | fornece identidade lexical | nome genérico ou ambíguo |
| description | comunica intenção e comportamento | modelo não sabe quando escolher |
| usage guidelines | diferencia situações apropriadas e inadequadas | confusão entre Tools semelhantes |
| limitations | estabelece fronteiras | modelo utiliza Tool fora do escopo |
| inputSchema | define estrutura dos argumentos | parâmetros inválidos |
| parameter descriptions | explica significado dos argumentos | parâmetro válido, mas semanticamente errado |
| outputSchema | explicita estrutura esperada do retorno | dificuldade na composição downstream |
| annotations | oferece pistas operacionais | interpretação indevida de hints não confiáveis |
| context | estabelece objetivo atual | Tool correta para outra situação |
| candidate set | define opções disponíveis | excesso de distractors |
Tabela 3 — Camadas de informação envolvidas na utilização de MCP Tools. Síntese baseada na especificação MCP e na literatura analisada.
25. Tool Description como um contrato semântico
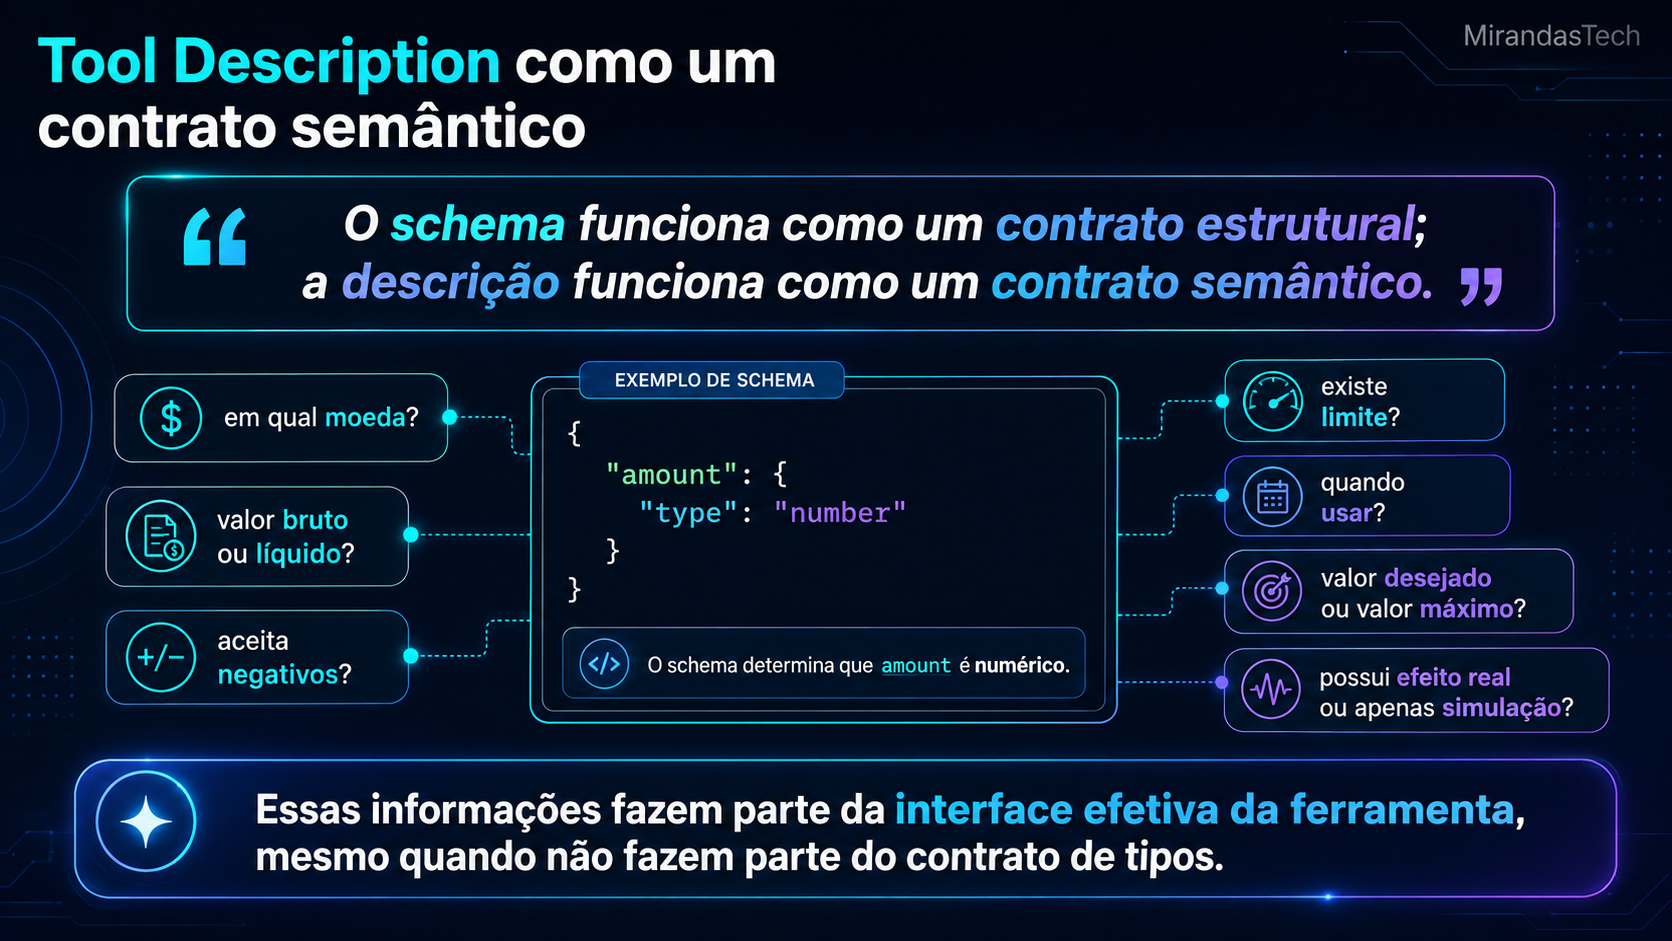
A partir dos estudos analisados, é possível propor uma interpretação útil:
O schema funciona como um contrato estrutural; a descrição funciona como um contrato semântico.
Considere:
{
  "amount": {
    "type": "number"
  }
}
O schema determina que amount é numérico. Mas não responde: em qual moeda? Valor bruto ou líquido? Aceita negativos? Existe limite? Quando esse parâmetro deve ser utilizado? Refere-se ao valor desejado ou ao valor máximo? Possui efeito real ou apenas simulação?
Essas informações precisam aparecer em outro lugar. Se forem necessárias para o comportamento correto do modelo, passam a fazer parte da interface efetiva da ferramenta, mesmo que não façam parte do seu contrato de tipos.
[FIGURA SUGERIDA 3 — Contrato estrutural × contrato semântico]
Schema: “Consigo chamar?” — tipos, obrigatoriedade, estrutura, enum, formato e restrições. Description: “Devo chamar?” — propósito, quando usar, quando não usar, significado, limites e comportamento. Os dois convergem no Contexto: “Devo chamar agora?”.
26. Como deveríamos escrever uma boa MCP Tool Description?
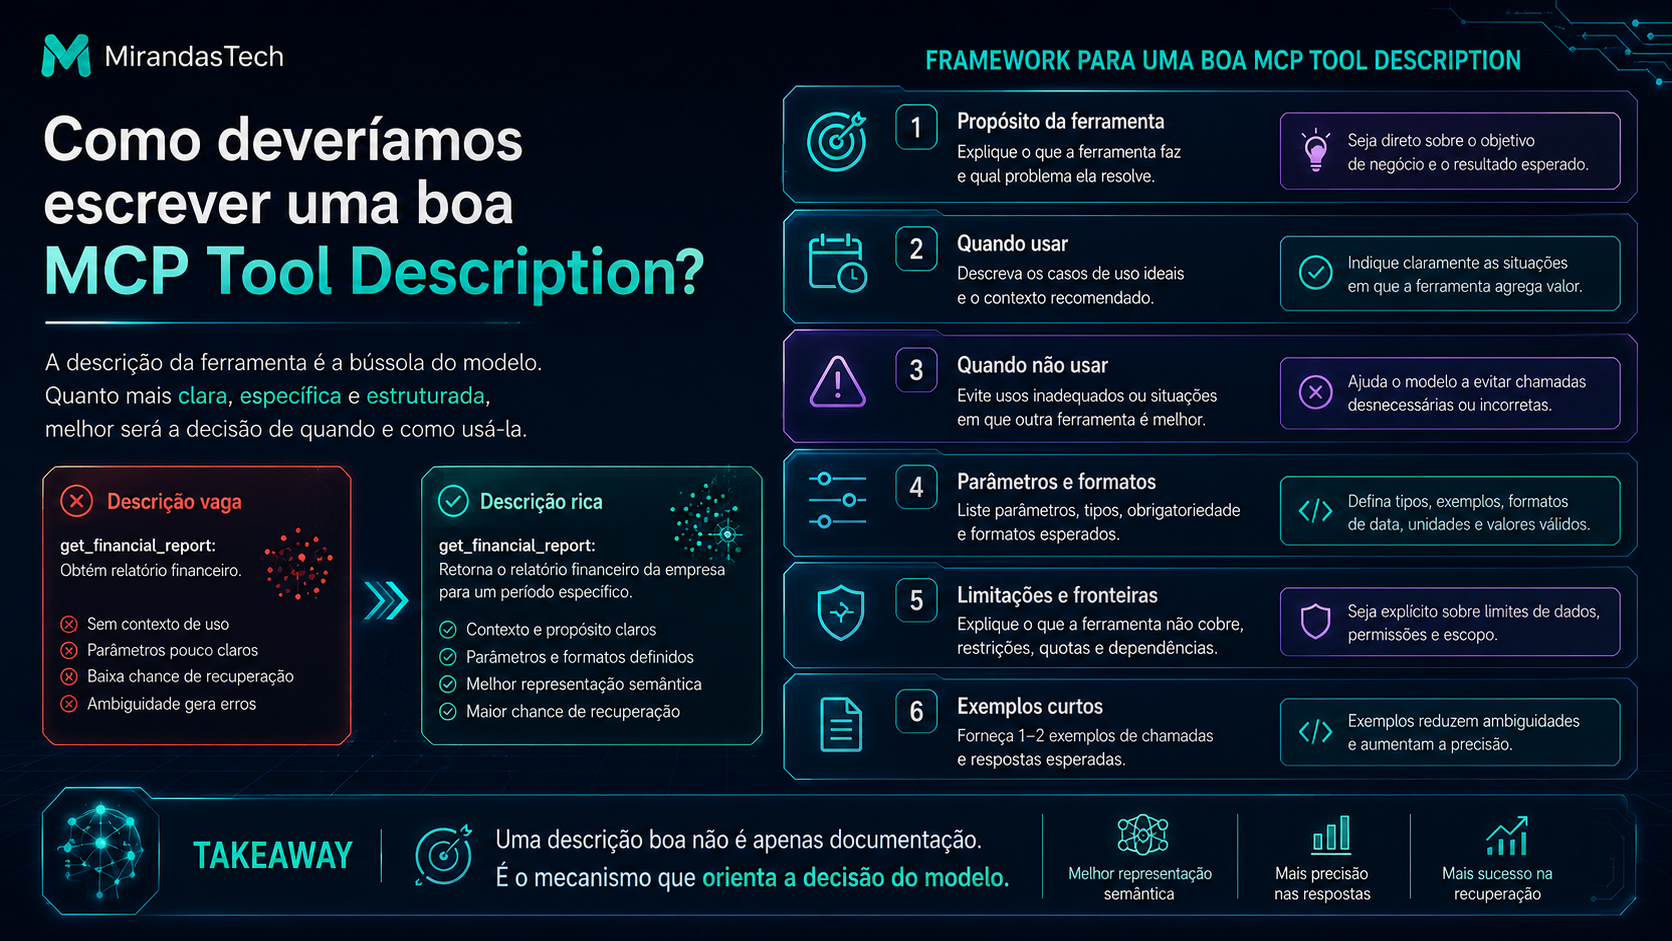
Os resultados disponíveis não sustentam uma “receita perfeita” universal. Hasan et al. (2026) explicitamente encontram variações por domínio e modelo. Ainda assim, os componentes identificados permitem construir um padrão de engenharia razoável.
Considere uma ferramenta get_historical_stock_prices. Uma descrição pobre seria:
Gets historical stock prices.Uma representação mais útil poderia ser:
Purpose:
Obtém preços históricos de mercado para um único ativo
em um intervalo explícito de datas.

Use when:
Use quando a pergunta exigir preços ou comportamento
histórico de um ativo durante um período definido.

Do not use when:
Não use para receita, lucro, balanço patrimonial ou
outros dados contábeis. Para isso, utilize
get_financial_statement.

Parameters:
ticker: símbolo do ativo usado pelo provedor.
start_date: início do intervalo no formato YYYY-MM-DD.
end_date: fim do intervalo no formato YYYY-MM-DD.

Limitations:
Requer um intervalo de datas válido.
Intervalos muito grandes podem retornar elevado volume de dados.
Observe que a descrição não tenta ensinar todo o domínio financeiro. Ela procura estabelecer fronteiras de decisão.
27. Uma estrutura prática para autores de MCP Servers
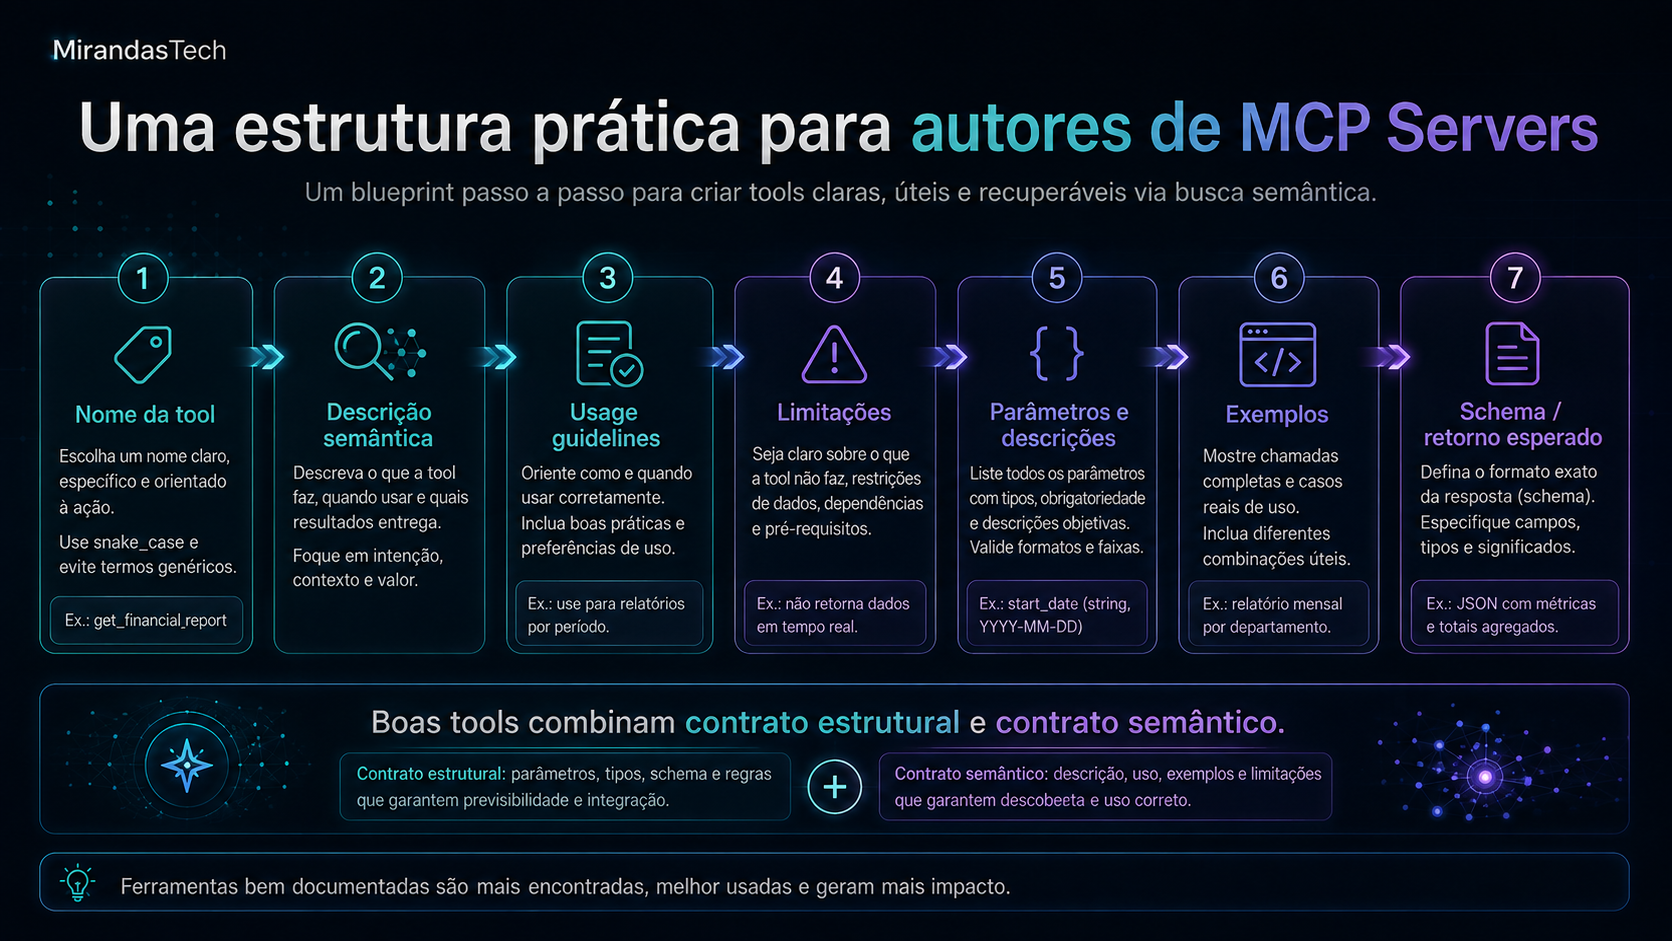
A evidência atual sugere que vale verificar pelo menos estas perguntas:
- Purpose: em uma frase, o modelo consegue descobrir o que esta Tool faz?
- Discrimination: existe outra Tool parecida? Minha descrição explica a diferença?
- When to use: o texto oferece pistas sobre quando essa Tool é apropriada?
- When not to use: está claro qual problema ela não resolve?
- Parameters: os parâmetros possuem significado, não apenas tipo?
- Limits: existem fronteiras, pressupostos ou efeitos importantes?
- Output: o agente sabe que tipo de resultado esperar?
- Concision: todas essas informações são necessárias durante a etapa atual de decisão?
O último item tornou-se especialmente importante diante dos resultados de Hasan et al. (2026) e de trabalhos sobre prompt bloat.
28. Talvez nem toda a descrição deva ser carregada imediatamente
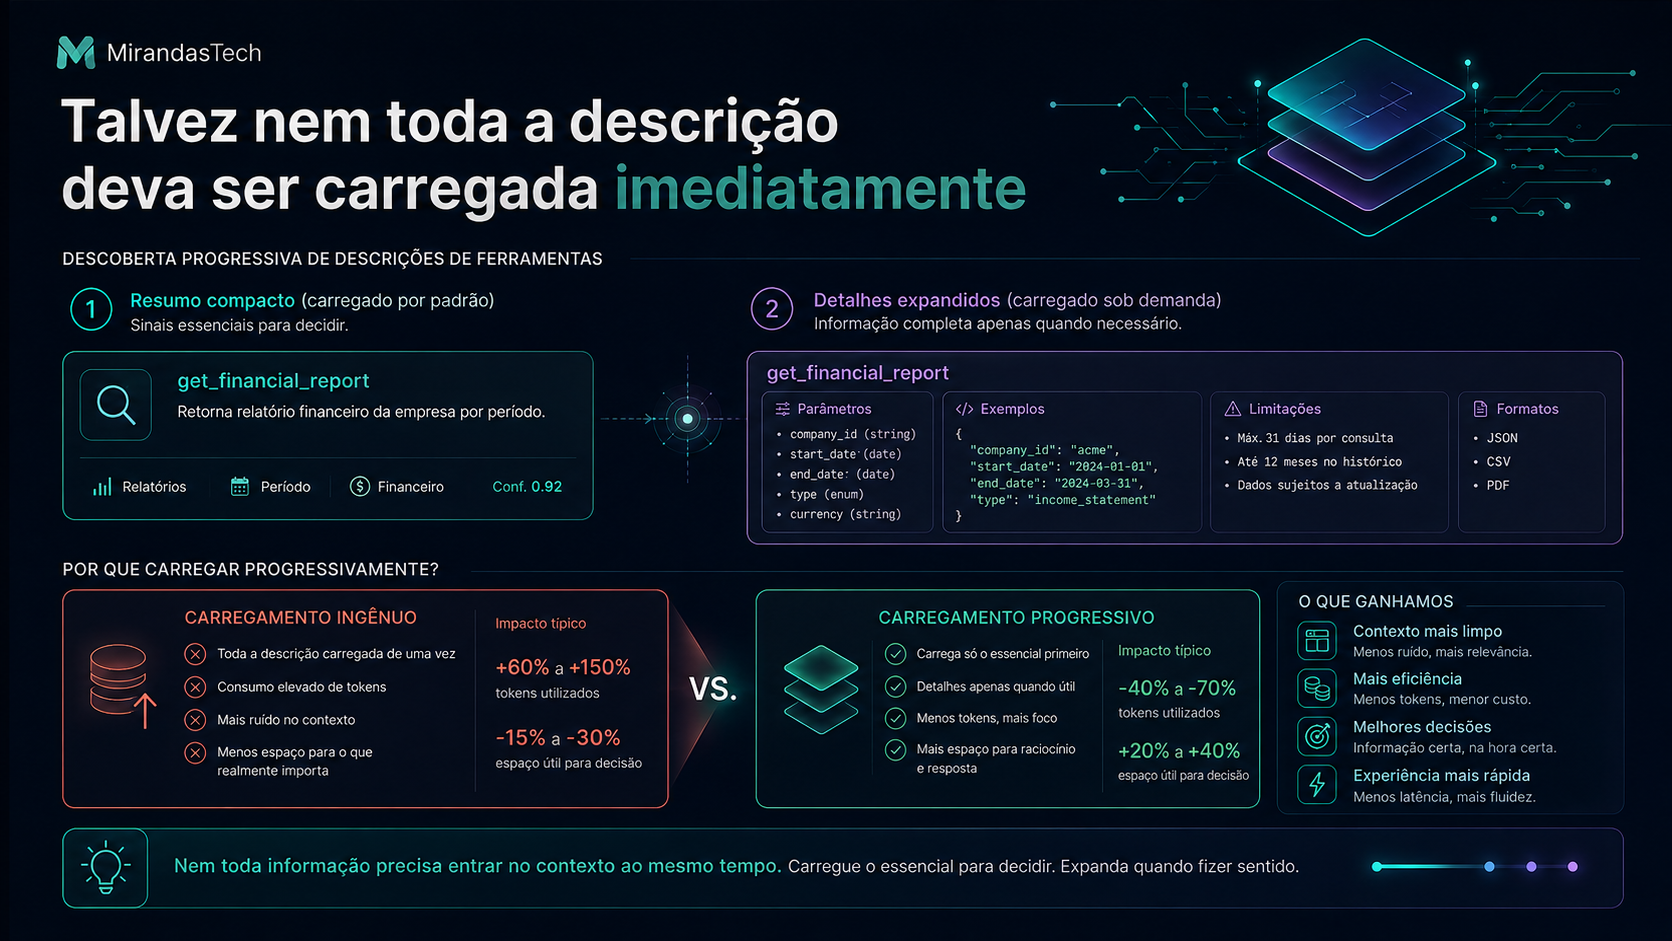
Hasan et al. fazem uma sugestão arquitetural particularmente interessante. A especificação atualmente concentra grande parte das informações semânticas em uma descrição textual. Os autores argumentam que componentes como Purpose, Guidelines, Limitations, Parameter Explanation e Examples poderiam ser representados de maneira mais estruturada, permitindo carregamento seletivo.
Isso possibilitaria algo semelhante a progressive disclosure:
Estágio 1 — descoberta:
name + purpose

Estágio 2 — seleção:
guidelines + limitations

Estágio 3 — execução:
inputSchema + parameter explanations + exemplos necessários
Essa abordagem procura resolver simultaneamente dois problemas: semântica insuficiente e contexto excessivo. A ideia é conceitualmente compatível com os resultados de recuperação seletiva obtidos por RAG-MCP e Semantic Tool Discovery (GAN; SUN, 2025; MUDUNURI et al., 2026; HASAN et al., 2026).
29. Surge uma nova disciplina: Context Engineering para Tools
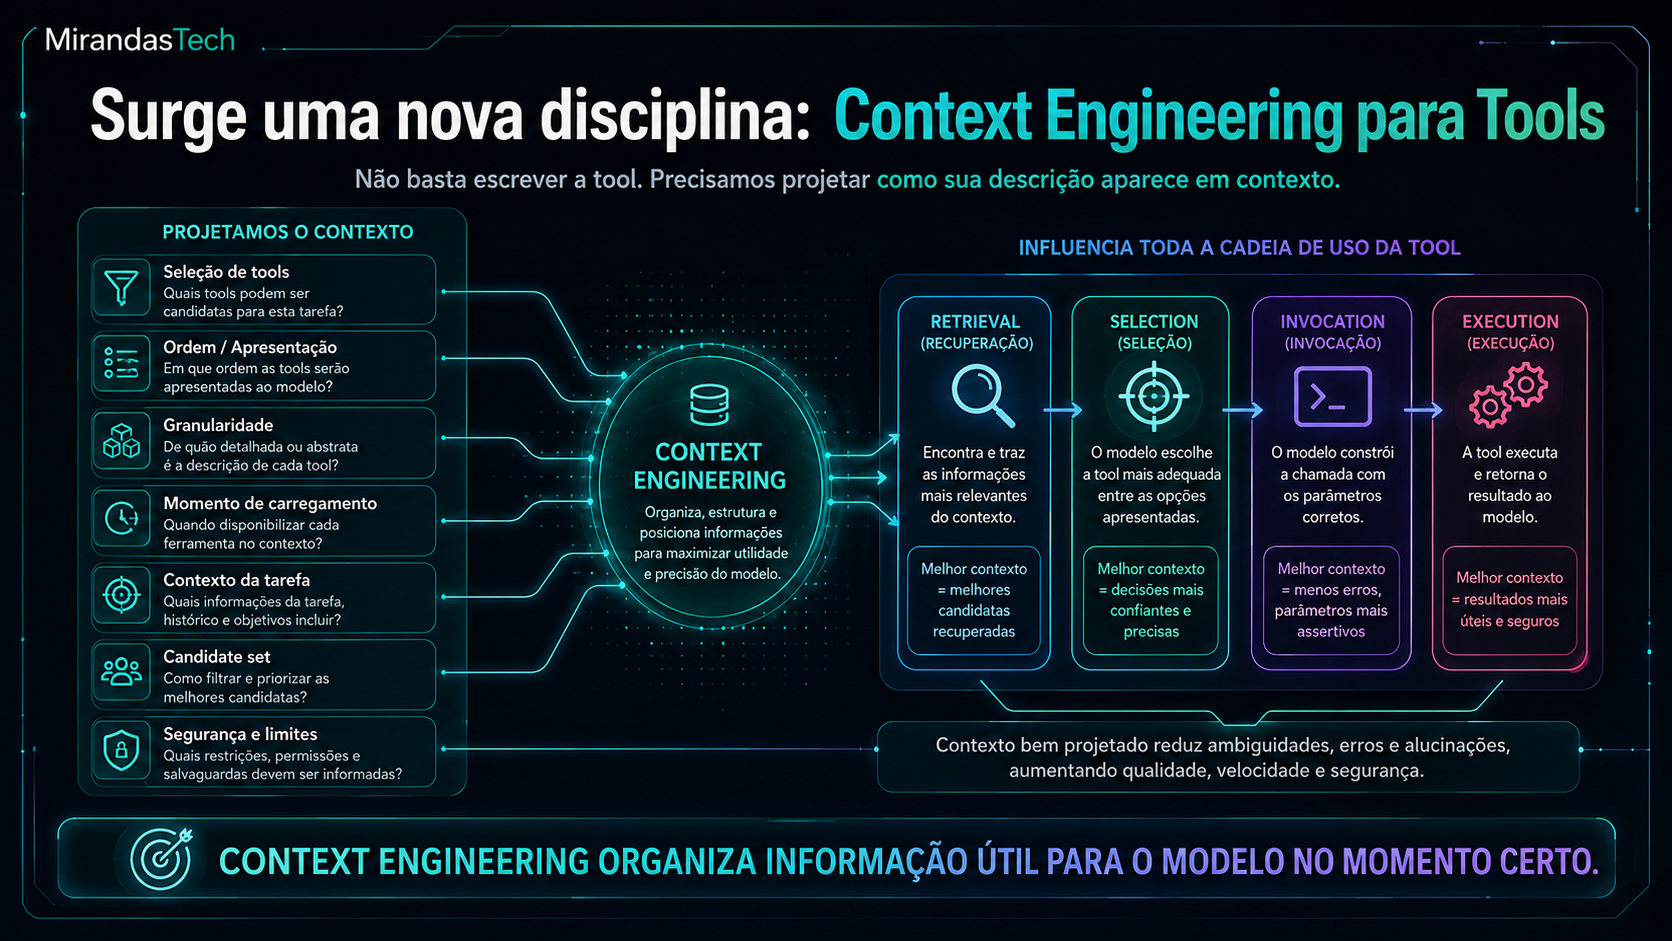
Durante muito tempo, a atenção esteve concentrada em prompt engineering: “Como escrever uma boa instrução para o modelo?”. Em agentes com centenas ou milhares de capacidades, outra pergunta passa a ser igualmente importante:
Quais informações sobre o ambiente e as ferramentas devem estar no contexto quando o modelo precisar decidir?
Isso inclui:
C = {
  system instructions,
  user query,
  conversation,
  tool metadata,
  retrieved data,
  prior tool results,
  state
}
Tool descriptions passam a ser apenas uma parte desse sistema. Consequentemente, tool engineering e context engineering começam a se sobrepor.
30. A semântica também possui implicações de segurança
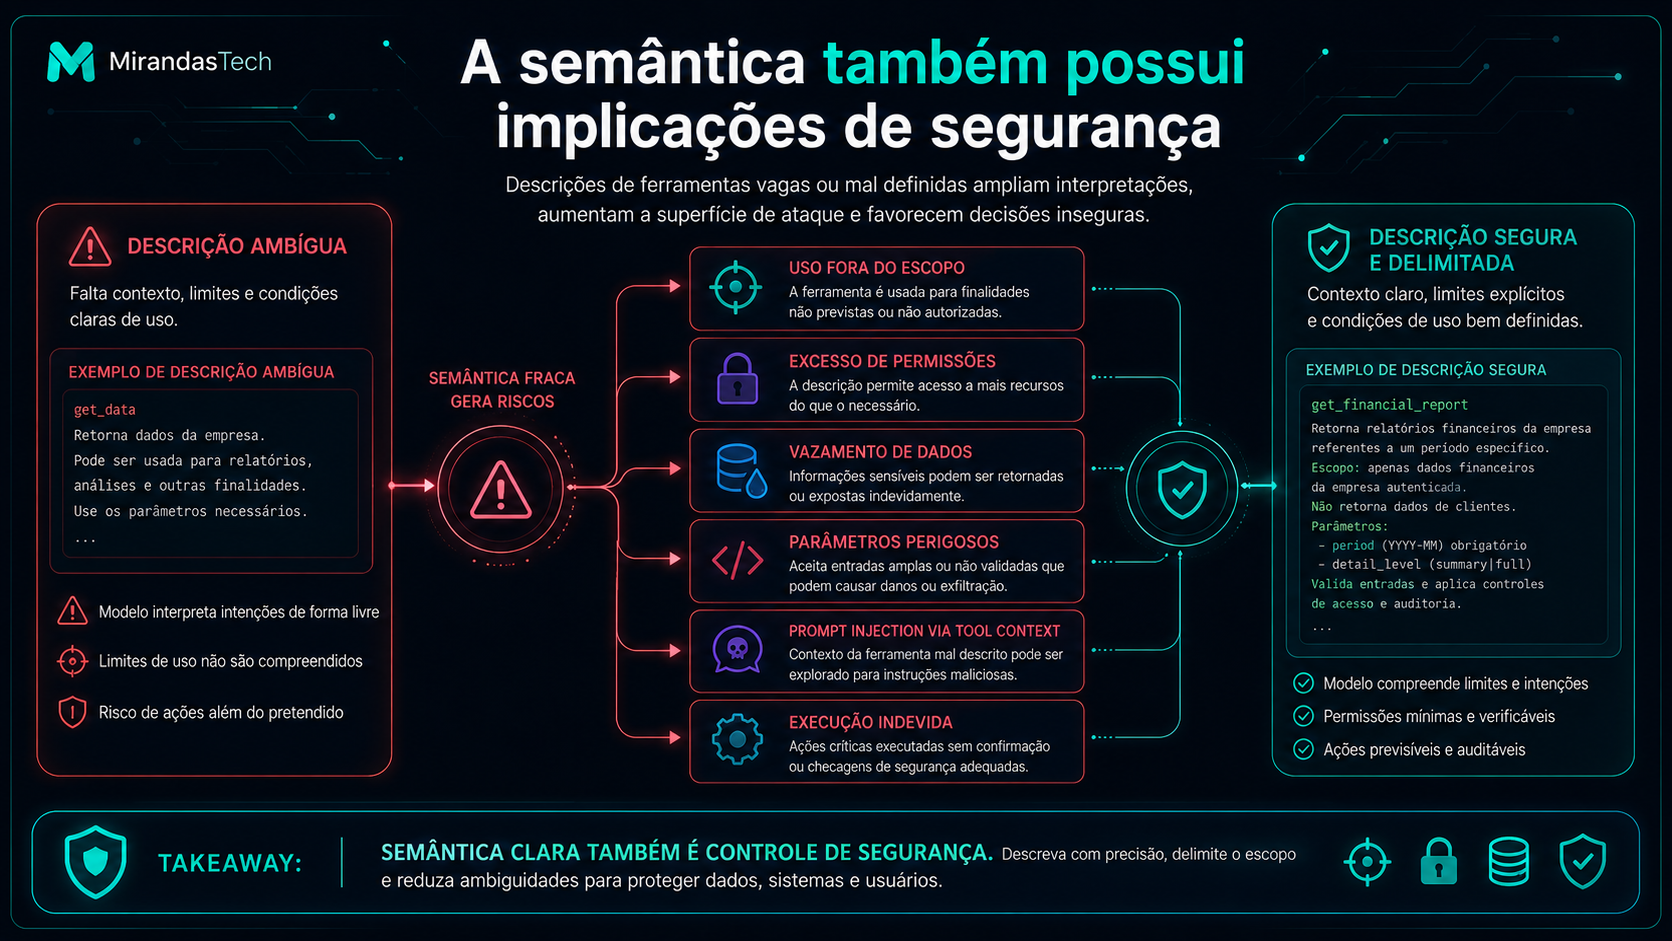
Existe ainda uma consequência importante. Se a Tool Description interfere no raciocínio do modelo, ela deixa de ser apenas documentação e passa a integrar uma superfície que pode influenciar comportamento.
As Tool Annotations são tratadas pela especificação como informação não necessariamente confiável quando provenientes de servidores não confiáveis. A documentação do protocolo recomenda que clientes não tomem decisões de segurança assumindo que esses hints correspondam necessariamente ao comportamento real da ferramenta (MODEL CONTEXT PROTOCOL, 2026c).
“A descrição diz que a Tool faz X”
≠
“A Tool está tecnicamente impedida de fazer algo além de X”
Semântica orienta decisão. Autorização e políticas devem impor limites. Confundir as duas coisas seria tratar documentação como mecanismo de segurança.
31. O modelo não escolhe uma Tool. Ele escolhe uma representação da Tool.
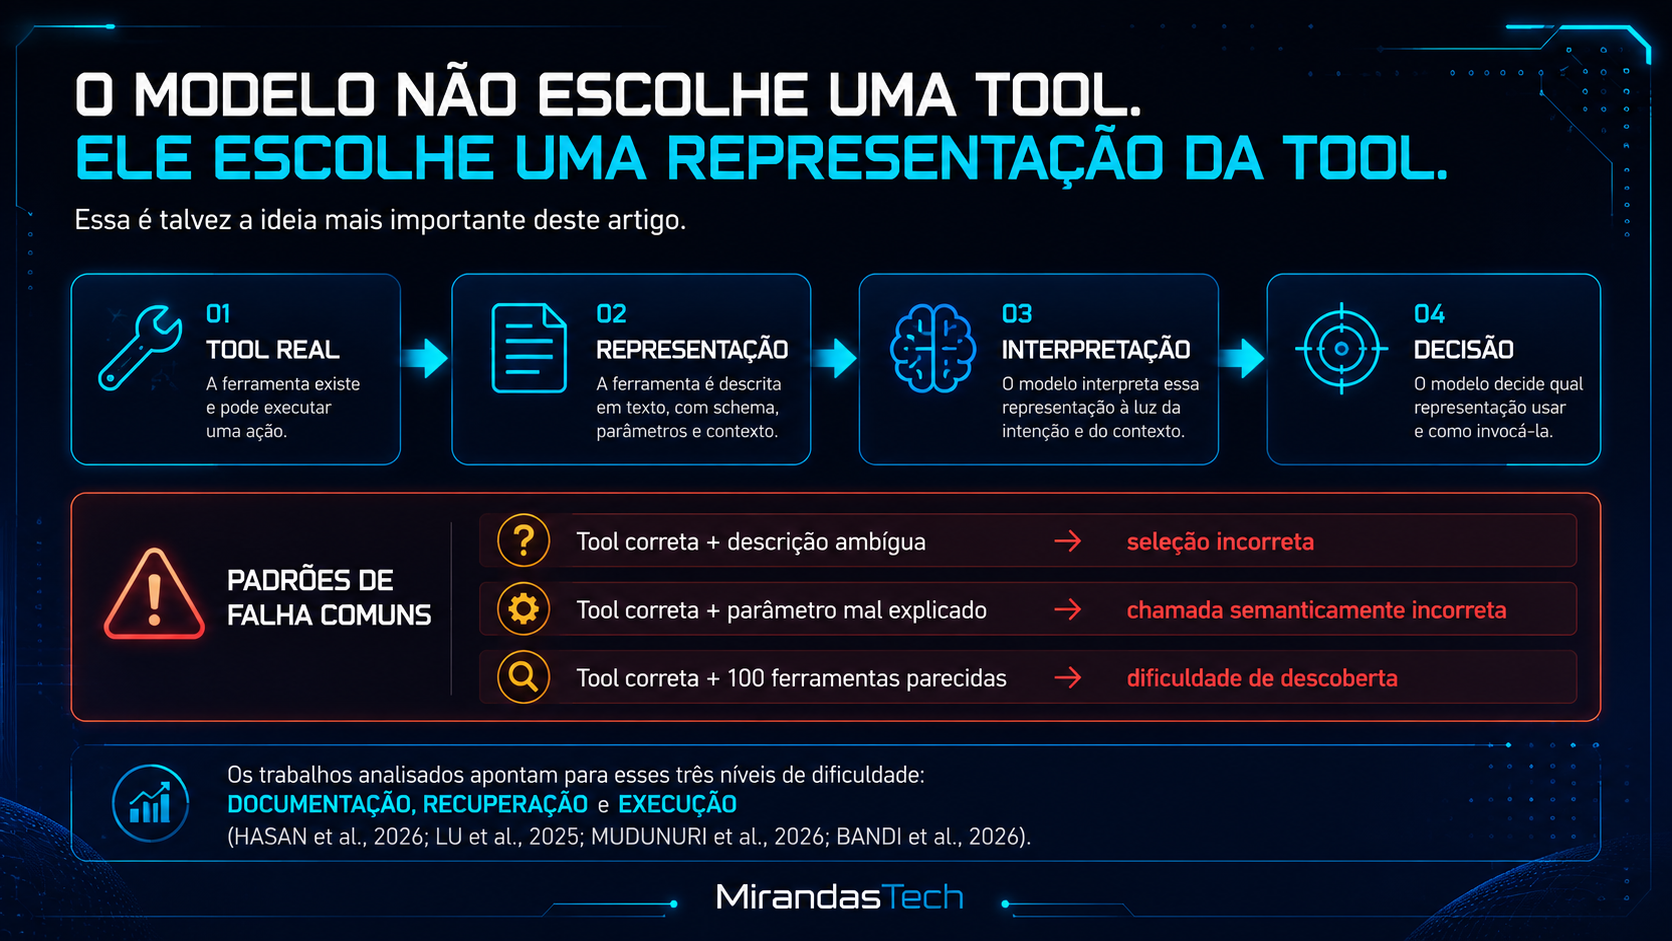
Essa é talvez a ideia mais importante deste artigo.
Tool real
  ↓
Representação
  ↓
Interpretação
  ↓
Decisão
A ferramenta real pode ser perfeita. Mas se sua representação for ruim:
Tool correta + descrição ambígua → seleção incorreta

Tool correta + parâmetro mal explicado → chamada semanticamente incorreta

Tool correta + 100 ferramentas parecidas → dificuldade de descoberta
Os trabalhos analisados apontam para esses três níveis de dificuldade: documentação, recuperação e execução (HASAN et al., 2026; LU et al., 2025; MUDUNURI et al., 2026; BANDI et al., 2026).
32. Uma arquitetura moderna de Tool Selection
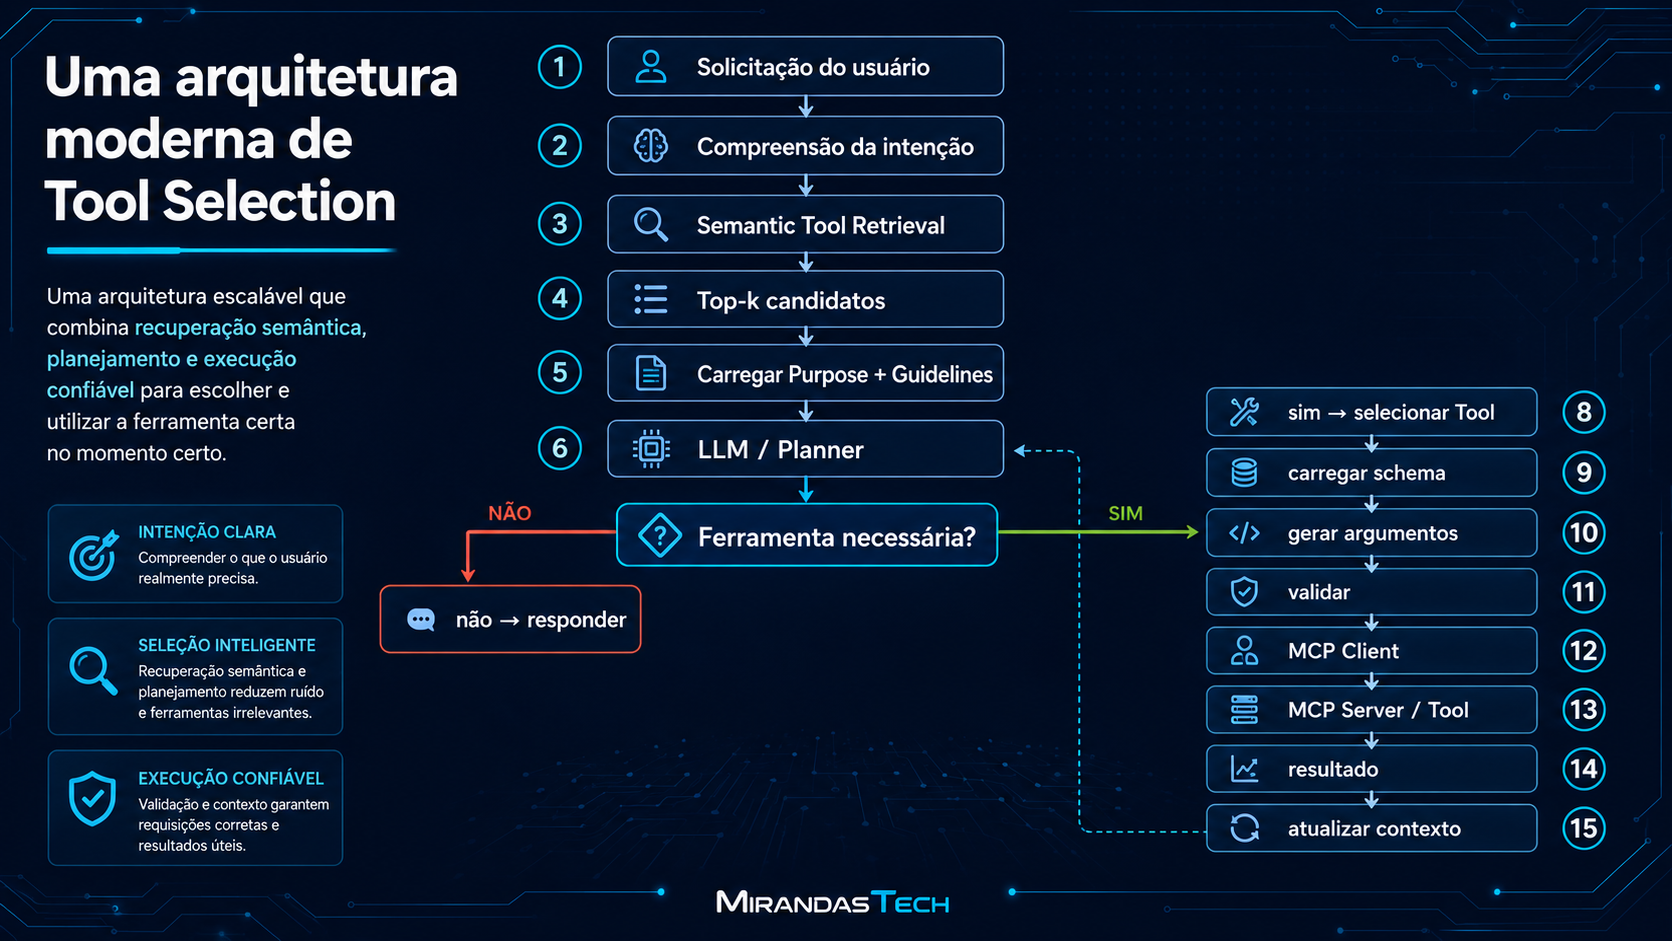
Combinando os resultados recentes, podemos representar uma arquitetura escalável de seleção de ferramentas da seguinte maneira:
Solicitação do usuário
  ↓
Compreensão da intenção
  ↓
Semantic Tool Retrieval
  ↓
Top-k candidatos
  ↓
Carregar Purpose + Guidelines
  ↓
LLM / Planner
  ↓
Ferramenta necessária?
  ├─ não → responder
  └─ sim → selecionar Tool
             ↓
       carregar schema
             ↓
       gerar argumentos
             ↓
          validar
             ↓
        MCP Client
             ↓
      MCP Server / Tool
             ↓
          resultado
             ↓
      atualizar contexto
             ↺
Essa arquitetura não é definida pelo MCP e tampouco representa uma implementação obrigatória. Ela sintetiza uma direção observada na literatura:
Não mostrar tudo ao modelo; mostrar a informação certa, sobre as ferramentas certas, no momento certo.
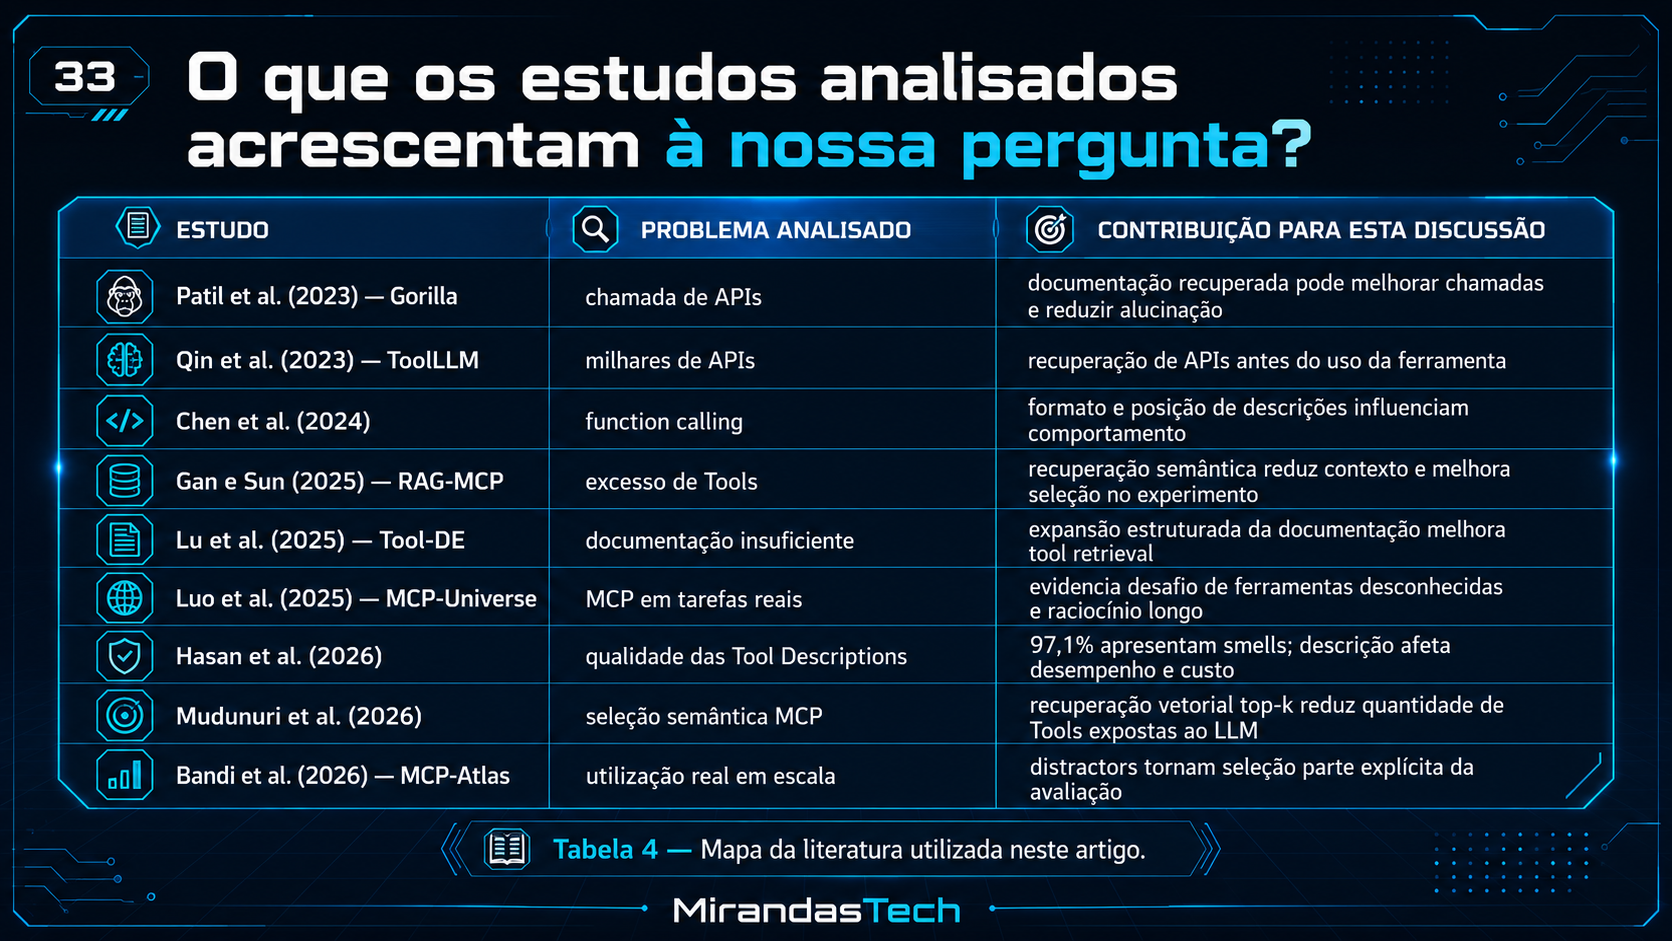
33. O que os estudos analisados acrescentam à nossa pergunta?
34. Um ponto metodológico importante
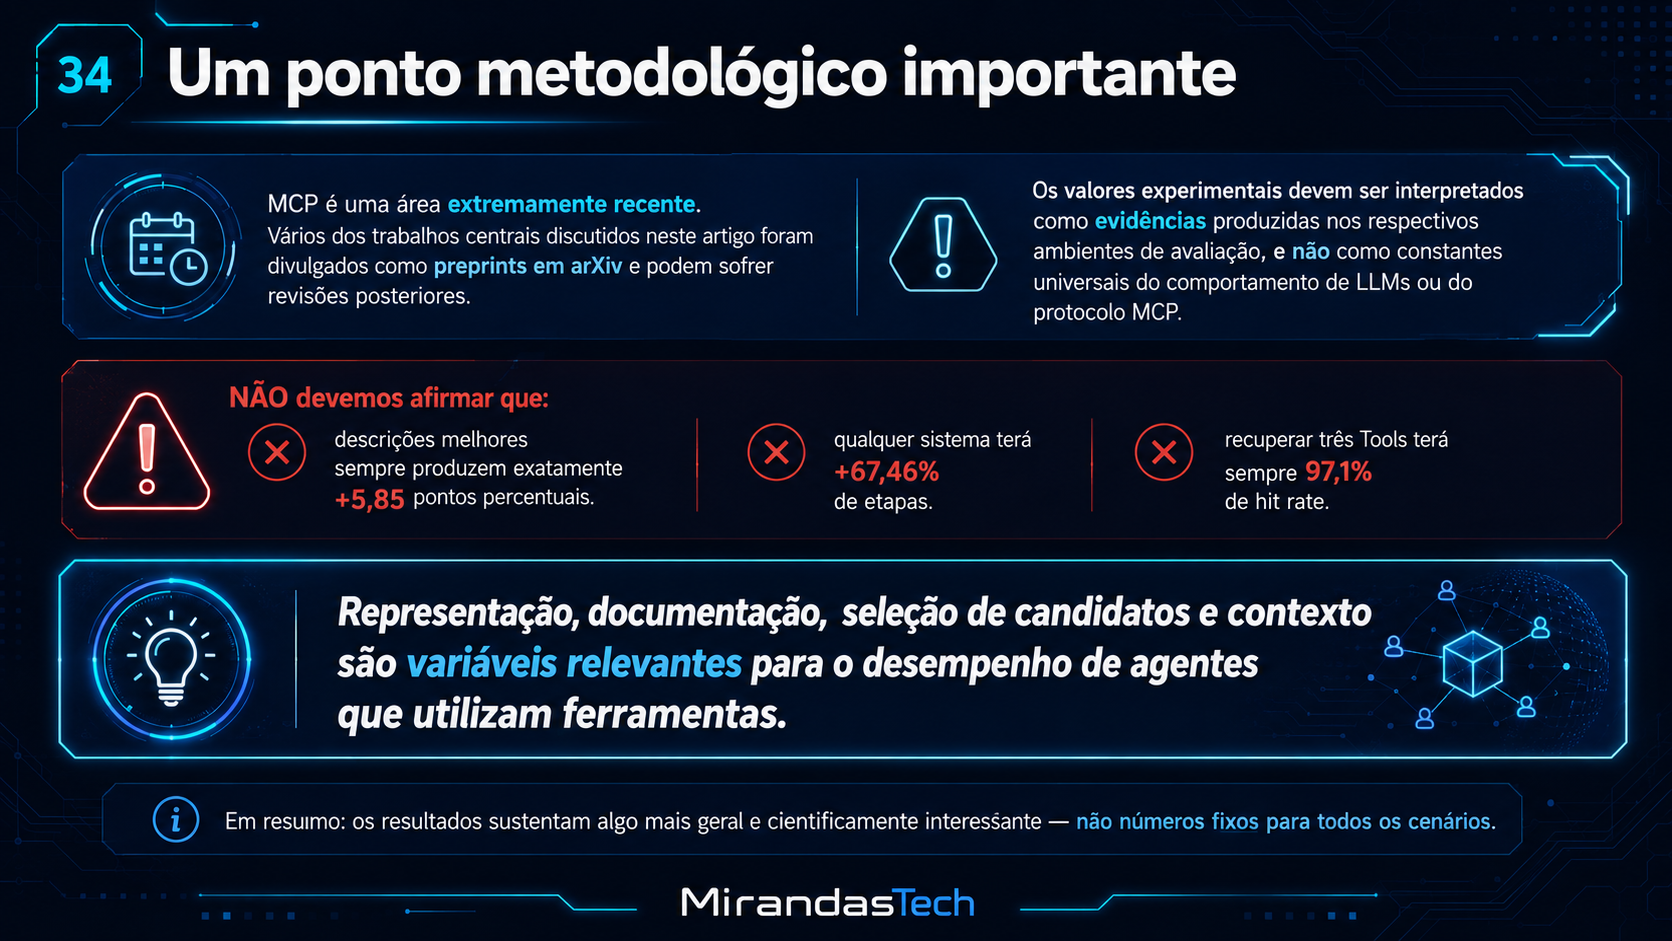
MCP é uma área extremamente recente. Vários dos trabalhos centrais discutidos neste artigo foram divulgados como preprints em arXiv e podem sofrer revisões posteriores. Os valores experimentais devem, portanto, ser interpretados como evidências produzidas nos respectivos ambientes de avaliação, e não como constantes universais do comportamento de LLMs ou do protocolo MCP.
Por exemplo, não podemos afirmar que descrições melhores sempre produzem exatamente +5,85 pontos percentuais; que qualquer sistema terá +67,46% de etapas; ou que recuperar três Tools terá sempre 97,1% de hit rate.
O que os resultados sustentam é algo mais geral e cientificamente interessante:
Representação, documentação, seleção de candidatos e contexto são variáveis relevantes para o desempenho de agentes que utilizam ferramentas.
35. O que muda para quem desenvolve MCP Servers?
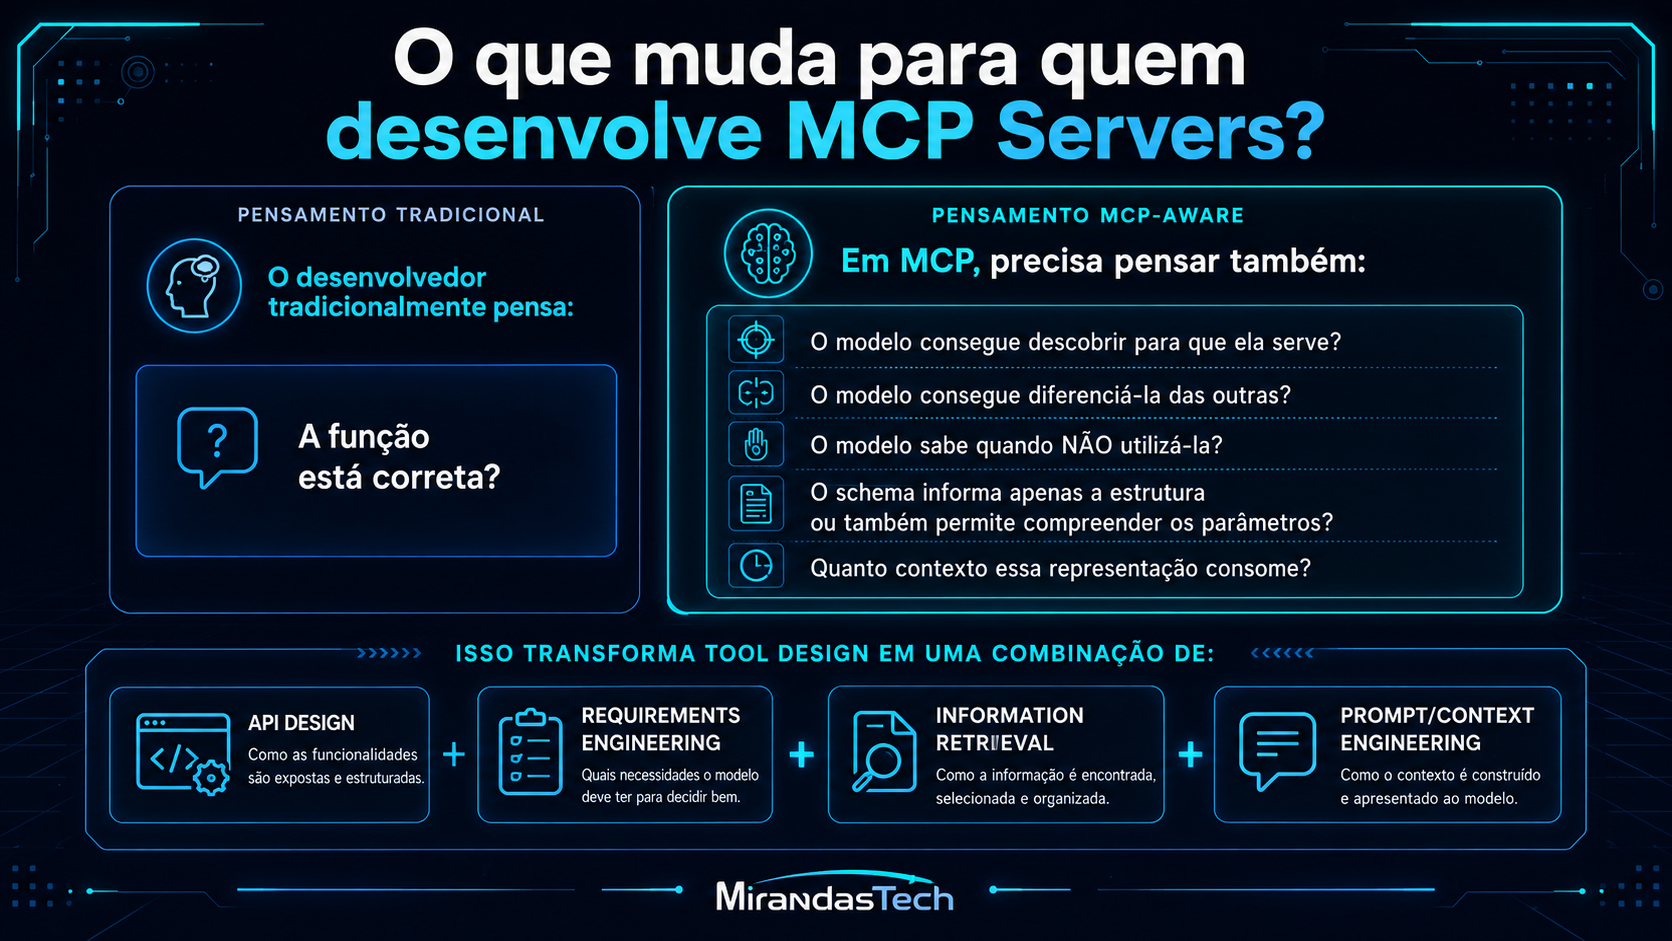
A consequência prática é profunda. Ao construir uma Tool, o desenvolvedor tradicionalmente pensa:
A função está correta?Em MCP, precisa pensar também:
O modelo consegue descobrir para que ela serve?
O modelo consegue diferenciá-la das outras?
O modelo sabe quando NÃO utilizá-la?
O schema informa apenas a estrutura ou também permite
compreender os parâmetros?
Quanto contexto essa representação consome?
Isso transforma Tool Design em uma combinação de:
API Design
+ Requirements Engineering
+ Information Retrieval
+ Prompt/Context Engineering
36. A nova interface não é somente máquina–máquina
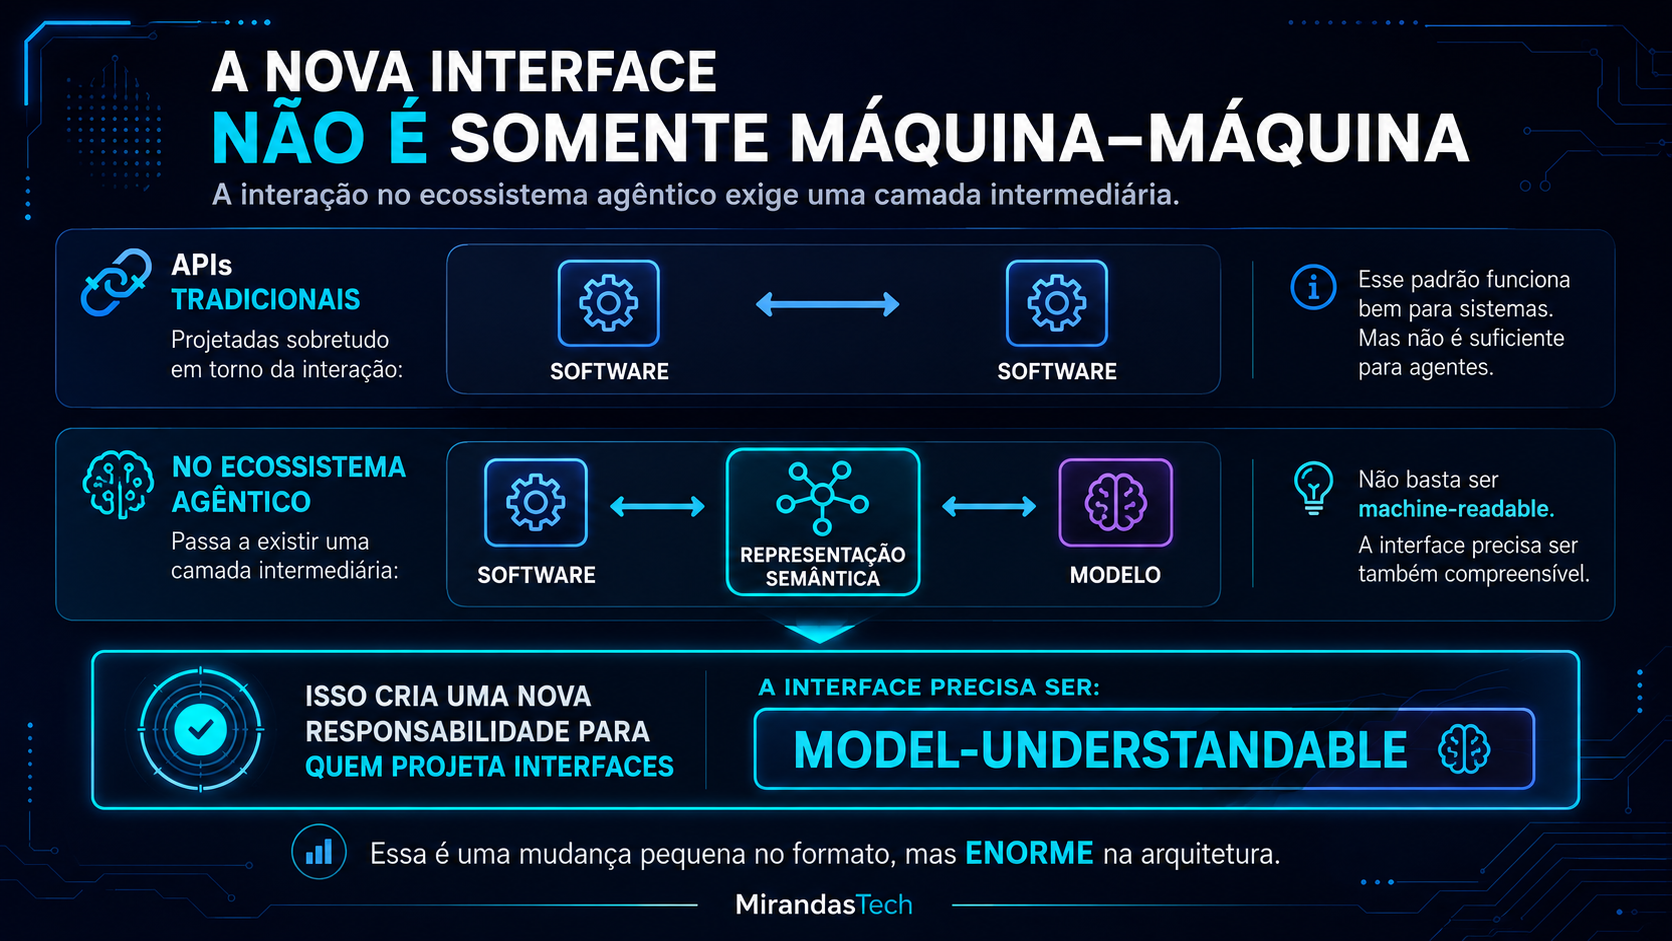
APIs tradicionais foram projetadas sobretudo em torno da interação:
software ↔ softwareNo ecossistema agentivo passa a existir uma camada intermediária:
software ↔ representação semântica ↔ modeloIsso cria uma nova responsabilidade para quem projeta interfaces. Não basta ser machine-readable. Em muitos casos, a interface precisa ser também:
model-understandableEssa é uma mudança pequena no formato, mas enorme na arquitetura.
37. Conclusão
MCP resolveu uma parte importante do problema de interoperabilidade entre inteligência artificial e sistemas externos: padronizou como aplicações podem descobrir e invocar capacidades fornecidas por servidores. O protocolo, entretanto, não elimina o problema cognitivo de decidir qual capacidade usar.
Essa decisão depende da representação disponibilizada ao modelo. Nome, descrição, schema, parâmetros, ferramentas concorrentes, histórico da conversa e demais elementos do contexto passam a interferir no comportamento do agente. A especificação MCP reconhece explicitamente a descrição como informação que pode auxiliar o LLM a compreender Tools, enquanto pesquisas recentes demonstram empiricamente que a qualidade dessa informação pode afetar desempenho (MODEL CONTEXT PROTOCOL, 2026a; HASAN et al., 2026).
O estudo de Hasan et al. oferece uma evidência particularmente significativa: 97,1% das 856 ferramentas analisadas apresentavam pelo menos um problema em suas descrições. Em experimentos posteriores com o MCP-Universe, descrições enriquecidas produziram melhoria mediana de 5,85 pontos percentuais na taxa de sucesso, mas também elevaram em 67,46% o número mediano de etapas e provocaram regressões em parte das configurações.
O resultado sugere que o objetivo não deve ser escrever descrições cada vez maiores. A questão mais importante passa a ser:
Qual é a menor quantidade de contexto capaz de transmitir a semântica necessária para a decisão correta?
Ao mesmo tempo, trabalhos sobre RAG-MCP, Tool-DE e Semantic Tool Discovery sugerem que, em grandes ecossistemas, talvez o modelo nem deva receber todas as Tools disponíveis. Recuperar semanticamente um pequeno conjunto de candidatas antes da decisão pode reduzir o contexto e tornar o problema mais tratável (GAN; SUN, 2025; LU et al., 2025; MUDUNURI et al., 2026).
Isso aponta para uma arquitetura agentiva em que três problemas são tratados separadamente:
Discovery → Selection → InvocationE talvez essa seja a principal mudança conceitual trazida pelos agentes de IA. Durante décadas, documentamos funções para que programadores soubessem como chamá-las. Agora começamos a documentá-las também para que modelos possam decidir se devem chamá-las.
A Tool Description deixou de ser apenas documentação. Ela passou a fazer parte do comportamento do sistema.
Referências
BANDI, Chaithanya et al. MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers. arXiv preprint arXiv:2602.00933, 2026. Disponível em: https://arxiv.org/abs/2602.00933.
CHEN, Yi-Chang; HSU, Po-Chun; HSU, Chan-Jan; SHIU, Da-shan. Enhancing Function-Calling Capabilities in LLMs: Strategies for Prompt Formats, Data Integration, and Multilingual Translation. arXiv preprint arXiv:2412.01130, 2024. Disponível em: https://arxiv.org/abs/2412.01130.
GAN, Tiantian; SUN, Qiyao. RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation. arXiv preprint arXiv:2505.03275, 2025. Disponível em: https://arxiv.org/abs/2505.03275.
HASAN, Mohammed Mehedi; LI, Hao; RAJBAHADUR, Gopi Krishnan; ADAMS, Bram; HASSAN, Ahmed E. Model Context Protocol (MCP) Tool Descriptions Are Smelly! Towards Improving AI Agent Efficiency with Augmented MCP Tool Descriptions. arXiv preprint arXiv:2602.14878, 2026. Disponível em: https://arxiv.org/abs/2602.14878.
LU, Xuan et al. Tools are under-documented: Simple Document Expansion Boosts Tool Retrieval. arXiv preprint arXiv:2510.22670, 2025. Disponível em: https://arxiv.org/abs/2510.22670.
LUO, Ziyang et al. MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers. arXiv preprint arXiv:2508.14704, 2025. Disponível em: https://arxiv.org/abs/2508.14704.
MODEL CONTEXT PROTOCOL. Tools — Model Context Protocol Specification. 2026a. Disponível em: https://modelcontextprotocol.io/specification/2025-06-18/server/tools.
MODEL CONTEXT PROTOCOL. The 2026-07-28 MCP Specification Release Candidate. 2026b. Disponível em: https://blog.modelcontextprotocol.io/posts/2026-07-28-release-candidate/.
MODEL CONTEXT PROTOCOL. Tool Annotations as Risk Vocabulary: What Hints Can and Can't Do. Model Context Protocol Blog, 16 mar. 2026c. Disponível em: https://blog.modelcontextprotocol.io/posts/2026-03-16-tool-annotations/.
MUDUNURI, Sarat; WAN, Jian; QIN, Ally; MANOHARAN, Srinivasan. Semantic Tool Discovery for Large Language Models: A Vector-Based Approach to MCP Tool Selection. arXiv preprint arXiv:2603.20313, 2026. Disponível em: https://arxiv.org/abs/2603.20313.
PATIL, Shishir G.; ZHANG, Tianjun; WANG, Xin; GONZALEZ, Joseph E. Gorilla: Large Language Model Connected with Massive APIs. arXiv preprint arXiv:2305.15334, 2023. Disponível em: https://arxiv.org/abs/2305.15334.
QIN, Yujia et al. ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs. arXiv preprint arXiv:2307.16789, 2023. Disponível em: https://arxiv.org/abs/2307.16789.
Este artigo faz parte da Série MCP do MirandasTech.




